
AI Humanizer для шведских исследователей, пишущих на английском
AI humanizer для шведских исследователей. Снижайте число ложных срабатываний детекторов ИИ для английского с шведскими языковыми влияниями: сохраняйте смысл и цитирования, и честно раскрывайте использование.

Швеция живёт на английском. Докторские диссертации в Каролинском институте (Karolinska Institutet) пишут и защищают на нём, статьи из Лунда (Lund) и Уппсалы (Uppsala) также готовят на нём, и страна год за годом держится near top EF English Proficiency Index. Поэтому, когда шведский PhD-студент узнаёт, что детектор ИИ отметил главу, которую она написала сама, реакция обычно предельно простая — недоверие.
Такая реакция оправданна. AI humanizer для шведских исследователей существует потому, что аккуратный, стандартный и беглый шведско-английский — это именно тот тип прозы, который эти детекторы систематически считывают неверно. Отличный английский не гарантирует защиты. Иногда проблема — в нём.
Механизм становится неприятно очевидным, когда вы его видите. Детекторы вознаграждают неожиданный выбор слов и штрафуют за предсказуемый. Авторы, которые учились писать ясно — использовать общеупотребительные слова и чистую структуру предложений, — создают текст с низкой перплексностью. А низкая перплексность — как раз то, что детектор оценивает как машинно написанный.
Так шведские исследователи могут humanize AI-текст для публикации на английском
Наш humanizer помогает шведским исследователям humanize AI-текст в собственных черновиках, чтобы корректный и хорошо написанный шведско-английский не отмечался как маскировка, генерируемая ИИ, при этом сохраняются смысл, терминология и ссылки.
По-простому: инструмент берёт ваш черновик с ИИ-помощью и меняет его ритм и выбор слов так, чтобы чистый шведско-английский с меньшей вероятностью был неверно истолкован ведущими детекторами. Он сохраняет ваши цитирования, вашу техническую лексику и вашу аргументацию неизменными. Он не пишет вашу статью за вас и не создан, чтобы скрывать что-либо.
Пишете на шведском? Он определяется автоматически и humanize-ется нативно
Шведские исследователи часто сначала набрасывают текст на родном языке, прежде чем переходить к английскому, и humanizer поддерживает этот подход. Вставьте шведский текст — ProofreaderPro сам определит язык, затем обработает его с помощью модели, учитывающей шведский, сохраняя буквы å, ä и ö, вашу терминологию и ваши цитирования точно на своих местах. Для humanize AI-текста вы можете начать с шведского черновика: он будет переписан так же легко, как и английский. То же обнаружение работает более чем для шестидесяти языков — каждый текст humanize-ется “в своём голосе”.
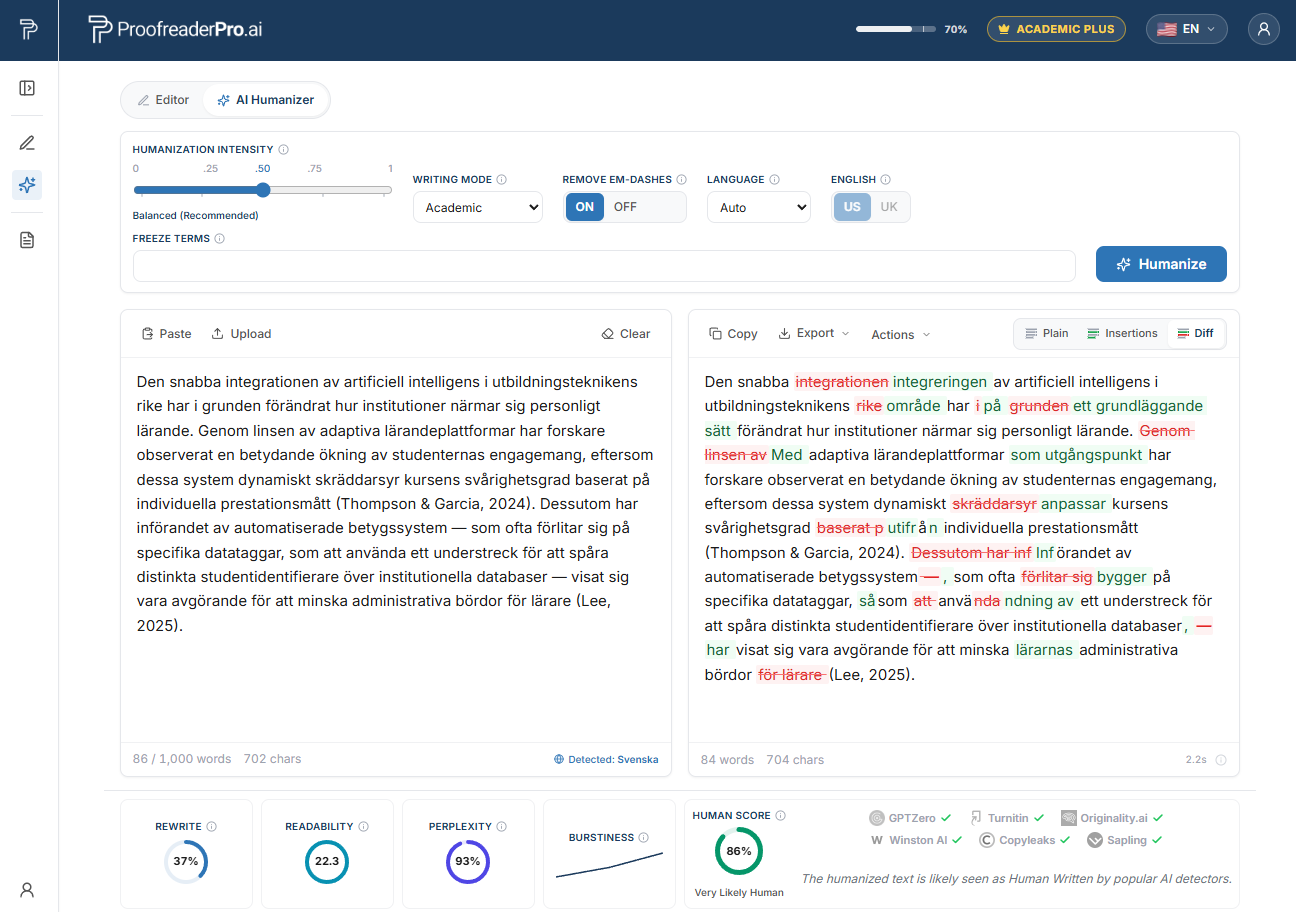
ProofreaderPro AI Humanizer переписывает шведский академический текст. Разница “до и после” сохраняет смысл и цитирования, а проверки детектора подтверждают естественное, человеческое прочтение.
Почему шведских исследователей отмечают AI-детекторы
Начнём с исследования, которое привело цифры по проблеме. В 2023 году команда Стэнфорда под руководством Лянга (Liang) и коллег опубликовала в журнале Cell Press Patterns работу "GPT detectors are biased against non-native English writers".
Авторы взяли эссе с TOEFL, написанные людьми, и прогнали их через семь широко используемых детекторов.
Результаты были резкими. В среднем около 61% эссе не носителей английского языка были помечены как ИИ, тогда как для носителей английского — примерно 5%. Почти каждый пятый текст не носителей (около 19,8%) был помечен единогласно каждым детектором в панели. Каждое эссе было написано человеком.
Почему это происходит? Многие детекторы оценивают перплексность — показатель того, насколько “неожиданным” является следующий элемент текста для языковой модели. Аккуратный автор второго языка тянется к наиболее употребительному слову и стандартной конструкции: это действительно качественное письмо. Но при этом получается предсказуемый текст с низкой перплексностью. Те привычки, которые делают шведско-английский ясным, — это те привычки, на которые эти системы обучались. Мы подробнее разбираем механизм в why AI detectors flag non-native English.
Ставки не абстрактны. Исследователи, не являющиеся носителями, уже сталкиваются с отказами примерно в 2,5 раза чаще, чем носители, тратят на написание своих статей примерно на 51% больше времени и получают существенно больше запросов на правки, связанные с качеством формулировок и языком. Ложный флаг падает поверх барьера, который и так высок.
Шведские паттерны первого языка, лежащие в основе ложных срабатываний
Шведский академический английский имеет узнаваемую форму — и в ней нет ничего неправильного. Это корректные, аккуратные, стандартные конструкции. Их “стандартность” и становится ловушкой: для детектора стандарт читается как низкая перплексность.
Классический признак — “ложные друзья”. "Aktuell" значит current или relevant, а не "actual"; "eventuellt" — возможно, а не "eventually"; "kontrollera" — проверять, а не "to control". Шведский автор, который пишет "we controlled the temperature" в значении “мы проверили это”, использует точную, осознанную лексику — ту, которую модель предсказывает довольно легко.
Передаётся и порядок слов. Шведский — язык со вторым местом для глагола (verb-second), поэтому конечный глагол хочет стоять во второй позиции. Эта привычка даёт выверенные, слегка формальные предложения. А после редактуры ("Therefore the model is robust") остаётся ровность, которую детектор считывает как “машинный” ритм.
Есть и артикли. Шведский маркирует определённость суффиксом, а не отдельным словом — поэтому в английском артикли либо выпадают, либо удваиваются: "the research show", "result was significant". Когда корректор вычищает такие места, текст становится регулярным и аккуратным, а регулярность — это ровно то, что детектор оценивает как низкую перплексность.
Несколько более “мелких” признаков встречаются постоянно: "since" используется для "for" при обозначении длительностей, часто применяются составные существительные и слово "respective", а также встречается сдержанный стиль, который некоторые рецензенты принимают за “плоский”. Каждое из решений по отдельности можно защитить. Но вместе они формируют прозу — гладкую, ровную и такую, которую модели легко предвосхищают.
Контекст AI-детектирования и Turnitin в Швеции
Диссертации и рукописи в Швеции проверяют в плановом порядке. Проверка на сходство — стандартная практика по всему сектору, и многие шведские университеты исторически опирались на собственные системы Urkund и Ouriginal, которые теперь входят в Turnitin. Индикаторы ИИ всё чаще размещаются рядом с оценками сходства в тех же отчётах.
Рекомендации догоняют реальность. Ассоциация шведских высших учебных заведений (SUHF) и отдельные университеты выпустили руководство по generative-AI, а финансирующие организации и журналы всё чаще просят чётко указать, как именно использовался ИИ. Направление движения — к раскрытию, а не к запретам.
Одна вещь, которую стоит помнить: оценка детектора — это заявление, а не приговор. Сам Turnitin подавляет низкие значения, а не показывает число, и предупреждает, что его оценку нельзя использовать в одиночку, чтобы принимать решения по вопросам добросовестности. Ряд университетов за рубежом, включая Vanderbilt, полностью отключили AI detector из‑за ложных срабатываний и смещений против авторов, не являющихся носителями. Пометка — это то, что нужно оспаривать, а не признание.
Защитите ваш шведско-английский перед подачей
«Оcочеловечьте» свой собственный черновик, подготовленный с помощью ИИ, сохраните ваши цитаты и смысл, затем раскройте ваше использование ИИ. Попробуйте на одном абзаце вашей диссертации и посмотрите разницу.
Попробуйте бесплатный HumanizerТоп-университеты Швеции и где появляются проверки ИИ
Те же инструменты скрининга встречаются во ведущих учреждениях Швеции — от медицинских школ до технических университетов:
- Karolinska Institutet (KI), Стокгольм (медицина)
- Uppsala universitet, Уппсала
- Lunds universitet, Лунд
- Kungliga Tekniska högskolan (KTH), Стокгольм
- Stockholms universitet (SU), Стокгольм
- Göteborgs universitet (GU), Гётеборг
- Chalmers tekniska högskola, Гётеборг
- Linköpings universitet (LiU), Линчёпинг
- Umeå universitet, Умео
- Sveriges lantbruksuniversitet (SLU), Уппсала
- Örebro universitet, Эребру
- Linnéuniversitetet, Векшё и Кальмар
Каждое из этих учреждений проверяет диссертации и рукописи на сходство, а всё чаще — параллельно взвешивает и индикаторы ИИ в рамках того же рабочего процесса. Суть не в том, что кто-то из них заведомо враждебен. Суть в том, что ложный флаг может оказаться на аккуратной работе в любом из них, поэтому разумный шаг — защитить собственное письмо до подачи.
Как работает AI humanizer для шведских исследователей
Процесс честный и простой — и начинается он с вашего собственного черновика.
Сначала пишите. Многие шведские исследователи сначала делают черновик на шведском — так мысль формируется быстрее, — затем переводят. Другие сразу пишут по‑английски. В любом случае слова и аргументы — ваши.
Отредактируйте грамматику. Исправьте ложных друзей, выпавшие артикли, перенос verb-second и другие типичные сбои. Наш AI proofreader правит механику, не уплощая ваш смысл, а когда грамматика выведена в порядок, можно переходить к humanizer.
Затем humanize-те собственный текст с ИИ-помощью. Именно здесь AI humanizer for Swedish researchers меняет ритм и выбор слов, разрывает ровное “дыхание” и убирает повторяющиеся паттерны и случайные длинные тире (em dashes), из‑за которых детекторы “спотыкаются”. По нашим собственным тестам это существенно снижает частоту, с которой аккуратный, стандартный шведско-английский читается как машинный ведущими детекторами (Turnitin, Originality.ai, GPTZero и аналогичными), при этом сохраняются ваш смысл, терминология и цитирования. Мы описываем это как то, что увидели в тестах, а не как обещание. Детекторы переобучаются каждые несколько месяцев, и ни один честный инструмент не может гарантировать “100% недетектируемость”.
Работают и неанглоязычные черновики. Humanizer поддерживает более 60 языков и прогоняет неанглоязычный текст через язык-ориентированную модель, которая сохраняет структуру предложений и смысл — это особенно важно, если вы сначала humanize-те шведский черновик до перевода. Этот материал — один из узлов в нашем multilingual AI humanizer hub, и он находится рядом с global academic editing hub для работы с целыми рукописями.
Потом — раскрывайте. Humanizing собственного письма — это не то же самое, что скрывать. Укажите, как вы использовали ИИ, в том формате, который требуют ваш департамент и целевой журнал, и вы останетесь в рамках правил добросовестности — одновременно защищая свою работу от ложного флага.
Локальные финансирующие организации, журналы и ожидания по раскрытию использования ИИ
Финансирующие организации в Швеции всё чаще ожидают прозрачности относительно использования ИИ. Vetenskapsrådet (Swedish Research Council, VR) — основной публичный фонд, а Фонд Кнута и Алисы Валленберг (Knut and Alice Wallenberg Foundation, KAW) — один из крупнейших частных. Forte (health, working life, welfare), Formas (environment and agriculture) и Vinnova (innovation) финансируют свои собственные направления; шведские группы регулярно получают гранты ERC, а доступ open access требуется везде.
Со стороны публикаций шведские исследователи нацеливаются на журналы, индексируемые в Web of Science и Scopus, и регистрируют результаты в SwePub. Эти журналы всё чаще и чаще требуют отдельную явную заметку об AI assistance. Короткое и честное раскрытие сейчас уместно в обычном разделе методов или acknowledgements, и сделать это правильно проще, чем многим кажется. См. наше руководство по написанию AI disclosure statement, а если флаг всё же пришёл, несмотря на аккуратную и раскрытую работу, то appeal playbook подсказывает, как отвечать.
Главная линия здесь — справедливость. Вы проводили исследование, вы писали статью, и оценка перплексности не должна отменять этот факт.
Часто задаваемые вопросы
Q: Поможет ли AI humanizer, если мой английский и так очень хорош?
Часто — да, и это контринтуитивная часть. Детекторы отмечают тексты с низкой перплексностью, а отполированный, стандартный шведско-английский по своей природе имеет низкую перплексность. Humanizer меняет ваш ритм и формулировки так, что чистое письмо реже считывается неверно — без изменения того, что вы действительно сказали.
Q: Нарушает ли правила humanize AI-текст в моей собственной диссертации?
Humanize собственного черновика и последующее раскрытие использования ИИ обычно не противоречат правилам большинства университетов. Что действительно важно для правил — не выдавать сфабрикованную или незадекларированную работу за свою. Когда вы сохраняете смысл и цитирования и ясно указываете, как вы применяли ИИ, вы остаётесь внутри рамок добросовестности.
Q: Может ли какой-либо инструмент гарантировать, что моя работа пройдёт Turnitin или GPTZero?
Нет, и будьте осторожны с теми, кто говорит обратное. Детекторы меняют модели каждые несколько месяцев, поэтому ни один честный инструмент не может обещать конкретный результат или заявлять о 100% недетектируемости. Что мы можем сказать: в наших тестах humanizer заметно снижает количество ложных флагов для аккуратных текстов не носителей — и это отличается от гарантии.
Q: Humanizer меняет мои цитирования или технические термины?
Нет. Он создан так, чтобы сохранять цитирования, техническую терминологию и сущность вашей аргументации, при этом корректируя ритм и выбор слов. Список литературы, ваши формулы и терминология по области остаются такими, как вы их написали.
Q: Я сначала писал на шведском. Это важно?
Нет. Humanizer поддерживает более 60 языков и обрабатывает неанглоязычный текст с помощью язык-ориентированной модели, которая защищает структуру предложений и смысл. Поэтому вы можете работать на шведском и переводить, либо humanize-ить после перевода на английский.
Снижайте число ложных срабатываний ИИ на аккуратном тексте на не родном английском, сохраняя смысл, терминологию и цитаты. Создано для исследователей, публикующих работы на английском.

Мо — инженер NLP с PhD в области обработки естественного языка. Его исследования охватывают компьютерную лингвистику, анализ текста и машинное обучение, и они напрямую используются в моделях редактирования и гуманизации, лежащих в основе ProofreaderPro. Он пишет о той части процесса, которую большинство людей никогда не видит: о том, как языковая модель читает предложение, оценивает его и решает, что изменить.


