
AI Humanizer для испанских исследователей, пишущих на английском
AI humanizer для испанских исследователей. Уменьшает число ложных срабатываний ИИ-детекторов для англоязычных текстов, написанных с влиянием испанского: сохраняет смысл и цитирования, а также честно раскрывает использование ИИ.

Испания — один из крупнейших исследовательских производителей в Европе: стабильно входит в топ-10–12 стран мира по объёму публикаций. Почти вся эта работа доходит до читателей на английском языке — втором языке для большинства тех, кто пишет эти тексты. Именно этот разрыв — между мышлением на испанском и публикацией на английском — и является той точкой, где AI humanizer для испанских исследователей действительно находит своё место.
Проблема, которую никто не планировал. Сейчас детекторы ИИ встроены в инструменты, которые проверяют диссертации и подаваемые рукописи в журналы. Их создавали, чтобы выявлять машинный текст, однако они регулярно помечают аккуратное, корректное человеческое письмо авторов, для которых английский не является родным. Проблема не в вашем стиле как таковом. Проблема в его предсказуемости.
Исследователь в Мадриде или Барселоне, который сначала набрасывает текст на испанском, переводит и затем доводит до чистого академического английского, может в итоге выглядеть более «машинно», чем небрежный носитель языка, который вообще не пользовался языковыми инструментами. Этот материал — о том, как открыто закрыть этот разрыв: улучшить собственный черновик, сохранить смысл и цитирования и раскрыть использование ИИ так, как этого ожидают ваш университет и ваш журнал.
Un humanizador de texto de IA para investigadores españoles
Наш AI humanizer помогает испанским исследователям публиковаться на английском языке так, чтобы их аккуратно написанные тексты не путали с текстом, сгенерированным машиной. Он сохраняет ваш смысл, вашу техническую терминологию и ваши цитирования, а также варьирует ритм и выбор слов, которые детектор интерпретирует как автоматические.
Если говорить простыми словами, инструмент перерабатывает ритм и выбор слов в вашем собственном черновике так, чтобы аккуратная проза второго языка реже воспринималась неверно, а ваша аргументация и ваши ссылки оставались ровно там, где вы их разместили. Он создан для реальной работы реальных авторов, а не для сокрытия чего-либо.
Также «humanize» ваш испанский напрямую — не только ваш английский
Вам не нужно переходить на английский, прежде чем «humanize» вашу работу. Вставьте фрагмент на испанском — ProofreaderPro распознаёт язык автоматически, а затем направляет текст через модель, учитывающую специфику испанского, которая сохраняет акценты, терминологию и цитирования ровно в том виде, в каком они написаны. Как un humanizador de texto de IA, он работает с вашим испанским черновиком так же, как и с английским: сохраняет смысл, а формулировки читаются естественно. Детектирование покрывает более шестидесяти языков, поэтому испанский переписывается как испанский — без «сглаживания» в английский.
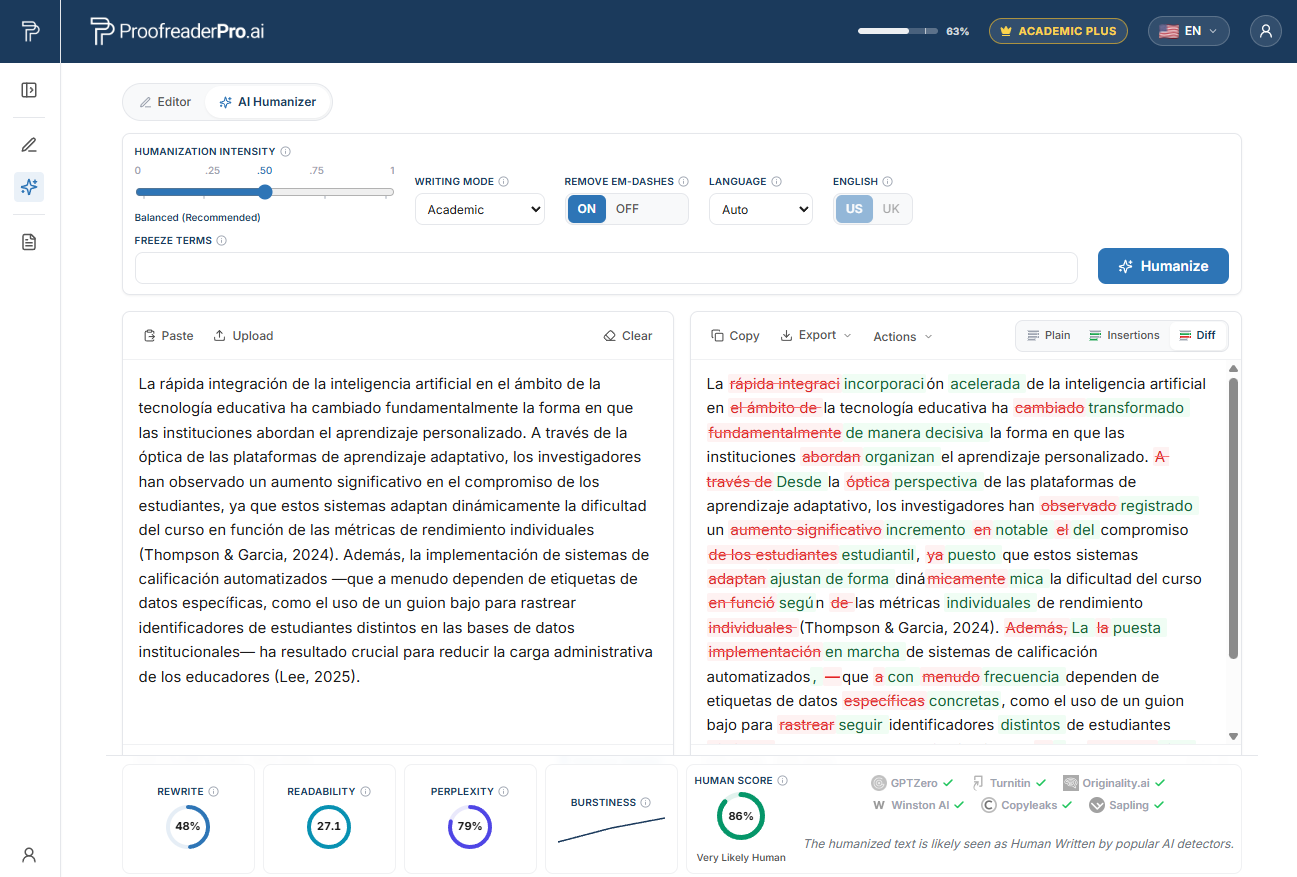
AI Humanizer от ProofreaderPro переписывает академический текст на испанском. Разница «до/после» сохраняет смысл и цитирования, а проверки детектора подтверждают естественное, человеческое чтение.
Почему испанских исследователей помечают ИИ-детекторы
Самые наглядные доказательства приводит исследование Стэнфордского университета 2023 года от Liang и соавторов, опубликованное в журнале Cell Press Patterns под названием "GPT detectors are biased against non-native English writers." Команда прогнала эссе по TOEFL, написанные людьми, через семь широко используемых детекторов.
Результат должен тревожить всех, кто публикуется на втором языке. В среднем около 61% неговорящих как родной язык эссе были помечены как ИИ, тогда как для носителей английского эта доля составляла примерно 5%. Почти каждое пятое эссе, написанное не носителями, около 19,8%, было помечено единогласно всеми детекторами. При этом все эссе были написаны людьми.
Механизм называется перплексией: это показатель того, насколько «неожиданным» оказывается каждый вариант словосочетания для языковой модели. Авторы, пишущие на втором языке, выбирают наиболее распространённые слова и стандартные, предсказуемые формулировки — из-за этого перплексия оказывается низкой, а детектор считывает текст как машинный. Те самые привычки, которые делают английский испанских исследователей ясным и корректным, и есть те привычки, на выявление которых эти инструменты были обучены. Мы подробно разбираем весь механизм в нашем руководстве: почему ИИ-детекторы помечают авторов, для которых английский не родной.
Испанские закономерности первого языка, стоящие за ложными срабатываниями
Испанский — романский язык, и его паттерны переносятся на английский таким образом, что это вполне корректно, но при этом крайне регулярно. Именно эта регулярность и становится ловушкой. Ниже перечислены наиболее заметные закономерности, которые мы видим в рукописях испанских авторов.
Ложные друзья переводчика (false cognates). «Actual» и «actually» используются для смысла «current» и «currently» (испанское "actual" означает «текущий»), «realize» подменяет «carry out» (realizar), «assist» — «attend» (asistir), а «sensible» — «sensitive». Каждая замена является стандартной, её легко выучить — и именно поэтому текст звучит предсказуемо.
Чрезмерное употребление артиклей с абстрактными существительными. В испанском определённые артикли ставятся перед обобщёнными существительными, поэтому «the research shows», «the science» и «the society» появляются там, где в английском артикль опускают. Это устойчивый, регламентированный правилами паттерн, а устойчивость и регулярность — то, что снижает перплексию.
Длинные предложения с множеством зависимых конструкций. Романский академический стиль тяготеет к длинным периодическим предложениям с «наслаиванием» придаточных. С грамматической точки зрения всё корректно, но ровная, «клаузула-за-клаузулой» ритмика выглядит для детектора слишком гладкой — машинной.
Перенос управления предлогами. "Depend of" (depender de), "consist on" (consistir en), "different to" и "in relation with" напрямую перенесены из испанского управления предлогами. Аккуратно и системно — а значит, легко предсказуемо для модели.
Сильная номинализация и порядок слов. Конструкции вроде «the realization of the analysis of» складывают абстрактные существительные в фиксированную форму. Добавьте перегруз придаточными с «which» и заимствованный «On the other hand» в начале многих предложений — и текст станет заметно регулярным.
Ни одна из этих особенностей не является ошибкой мышления. Это корректные, аккуратные, стандартные конструкции — и именно их стандартность детектор оценивает как низкую перплексию, а низкая перплексия, в свою очередь, маркируется как машинный текст.
Контекст выявления ИИ и Turnitin в Испании
Продвижение по карьерной лестнице испанских академиков зависит от sexenios de investigación — шестилетней оценки исследований через ANECA и CNEAI, где вознаграждаются публикации в журналах, включённых в Journal Citation Reports (Web of Science) и Scopus. Такая система формирует постоянный стимул для испанских исследователей публиковаться в англоязычных журналах с высокой цитируемостью, где детекторы теперь и «ожидают» рукописи.
Диссертации в Испании размещаются в институциональных репозиториях, таких как TDX, а также в национальном реестре TESEO, и проверка на заимствования с помощью Turnitin или iThenticate является стандартной процедурой на этом этапе. Всё чаще те же платформы показывают индикатор ИИ наряду с оценкой сходства.
Важно сохранять этот индикатор в разумных пределах. В 2023 году Vanderbilt отключил AI-детектор Turnitin, сославшись на ложные срабатывания и предвзятость к авторам, для которых английский не родной. Аналогичную позицию занимают Michigan State, UT Austin, Northwestern, Pittsburgh, SMU и Waterloo. Turnitin подавляет оценки в диапазоне 1–19% и предупреждает не полагаться на один лишь показатель при принятии решений об академической добросовестности. Пометка детектора — это повод для оспаривания, а не окончательный вердикт; фондирующие организации и журналы всё чаще просят простое раскрытие того, как именно использовался ИИ, а не угадываемый процент.
Защитите ваш аккуратный английский от ложной отметки о применении ИИ
Сделайте свой черновик, созданный с помощью ИИ, более естественным, сохранив каждую ссылку и технический термин на месте, затем укажите ваше использование ИИ так, как требует ваш журнал.
Попробуйте бесплатный HumanizerТОП-испанских университетов и где появляются проверки на ИИ
Испанские исследования распределены по сильной системе государственных университетов, и эти учреждения проверяют диссертации и рукописи на сходство — обычно с помощью Turnitin — а всё чаще оценивают и индикаторы ИИ:
- Universitat de Barcelona (UB), Barcelona
- Universidad Autónoma de Madrid (UAM), Madrid
- Universidad Complutense de Madrid (UCM), Madrid
- Universitat Autònoma de Barcelona (UAB), Barcelona
- Universitat de València (UV), Valencia
- Universidad de Granada (UGR), Granada
- Universidad Politécnica de Madrid (UPM), Madrid
- Universitat Politècnica de València (UPV), Valencia
- Universidad de Sevilla (US), Seville
- Universidad del País Vasco / Euskal Herriko Unibertsitatea (UPV/EHU), Bilbao
- Universidad de Salamanca (USAL), Salamanca
- Universitat Pompeu Fabra (UPF), Barcelona
- Universidad de Navarra (UNAV), Pamplona
- Universidad de Zaragoza (UNIZAR), Zaragoza
Независимо от того, где окажется ваша диссертация — в UB, UAM или UNIZAR — этап проверки устроен во многом одинаково, а значит, одинаков и риск того, что аккуратный английский второго языка будет прочитан неверно.
Как работает AI humanizer для испанских исследователей
Процесс прост — и он не выводит вас за рамки правил. Сначала подготовьте черновик статьи так, как вам проще думать: часто лучше начать с испанского, затем выполнить перевод. Исправьте грамматику, чтобы смысл был точным; если вам нужен второй проход именно по английскому тексту, наше руководство AI proofreading для испанских исследователей подробно описывает этот этап. Только после этого «humanize» ваш собственный текст с поддержкой ИИ так, чтобы аккуратное письмо с низкой перплексией реже распознавалось неверно.
Именно этот последний шаг делает наш AI humanizer. Он сохраняет ваш смысл, вашу техническую терминологию и ваши цитирования, а также варьирует ритм и выбор слов — то, что детектор воспринимает как машинную каденцию. Поддерживается более 60 языков: неанглоязычный текст направляется через модель, учитывающую язык, сохраняя структуру предложений и смысл.
Мы осторожны в том, что именно утверждаем. Humanizer переписывает текст, созданный ИИ, в более естественную человеческую форму — это снижает «ИИ-сигнал» и повышает шансы против сложных детекторов; инструмент тестировался на основных детекторах. Он также обеспечивает более 96% по грамматике для академических текстов. Это результаты тестирования, а не гарантии. Детекторы переобучаются каждые несколько месяцев, поэтому мы никогда не обещаем конкретное число или способ «обойти» что-либо.
Затем вы раскрываете информацию. Добавьте заявление об использовании ИИ в формате, который требует ваш университет и целевой журнал: так инструмент защищает аккуратное письмо, не скрывая того, как оно было создано. Этот материал расположен в нашем многоязычном хабе AI humanizer и дополняется нашим глобальным хабом академического редактирования, если вы хотите наложить человеческий слой редактуры.
Местное финансирование, журналы и ожидания по раскрытию использования ИИ
Конкурентное финансирование в Испании проходит через Agencia Estatal de Investigación (AEI) и el Ministerio de Ciencia, Innovación y Universidades, а Consejo Superior de Investigaciones Científicas (CSIC) — крупнейшая государственная исследовательская организация страны. Академические должности аккредитуются через ANECA, а FECYT присуждает испанским научным журналам знак качества, так что и индексация, и качество языка имеют реальный вес для испанской научной карьеры.
Со стороны публикаций испанские исследователи ориентируются на журналы, индексируемые Web of Science (JCR) и Scopus; в некоторых областях важны как национальные, так и дисциплинарные индексы, а диссертации достигают TDX и реестра TESEO. Во всех этих структурах раскрытие использования ИИ смещается от «по желанию» к «ожидается». Безопасная позиция одинакова везде: используйте инструменты на собственных работах, сохраняйте цитирования без изменений и прямо указывайте, как именно ИИ помогал. Пропустите финальный проход через humanizer — и вы защитите текст, не искажая фактов.
Часто задаваемые вопросы
В: Считается ли использование AI humanizer для испанских исследователей обманом?
Нет, если вы используете его для собственного черновика с поддержкой ИИ, а затем раскрываете это. Инструмент перестраивает ритм письма, который вы уже подготовили, сохраняя ваш смысл и цитирования, так что аккуратный английский второго языка не считывается как машинный текст. Раскрытие использования ИИ в формате, который требует ваш журнал или университет, и удерживает весь процесс в рамках правил академической добросовестности.
В: Изменит ли un humanizador de texto de IA мои цитирования или технические термины?
Нет. Humanizer создан для сохранения технической терминологии, ссылок и структуры вашей аргументации, при этом он варьирует выбор слов и каденцию. Ваши ключи цитирований, рисунки и специализированная лексика остаются ровно там, где вы их разместили: если их менять, пропадёт сам смысл процесса.
В: Почему мой корректный английский вообще помечают как ИИ?
Потому что многие детекторы оценивают перплексию — то, насколько предсказуемы ваши варианты слов. Испанские авторы, пишущие аккуратно, выбирают распространённые слова и стандартные формулировки, что даёт низкую перплексию; в итоге это читается как машинный текст. В исследовании Стэнфорда около 61% негатива на английском у человеко-написанных эссе было помечено, в сравнении с примерно 5% для носителей, поэтому пометка вашего текста — частая и оспариваемая ситуация.
В: Какие проценты успешности действительно достигал humanizer?
Проверенный на основных детекторах, инструмент переписывает текст, созданный ИИ, в более естественную человеческую форму — это снижает «ИИ-сигнал» и улучшает шансы против сложных детекторов, при этом сохраняя высокую точность грамматики для академических текстов. Это результаты тестирования, а не гарантии. Детекторы переобучаются часто, поэтому мы описываем то, что измерили, а не обещаем фиксированный результат.
В: Мою диссертацию в университете проверят с помощью Turnitin. Что мне делать?
Относитесь к индикатору ИИ как к одному из сигналов, а не как к вердикту. Пишите на том языке, в котором вам легче всего мыслить, редактируйте ради точности, «humanize» собственный черновик, чтобы снизить вероятность ложной пометки, и прикрепите понятное раскрытие использования ИИ. Если пометка всё же появится, у вас будут доказательства вашего собственного процесса подготовки текста, с которыми можно это оспорить.
Языково-ориентированный humanizer, который сохраняет ваш смысл, терминологию и ссылки, одновременно снижая количество ложных отметок об ИИ, с которыми сталкиваются внимательные авторы, пишущие на испанском.

Мо — инженер NLP с PhD в области обработки естественного языка. Его исследования охватывают компьютерную лингвистику, анализ текста и машинное обучение, и они напрямую используются в моделях редактирования и гуманизации, лежащих в основе ProofreaderPro. Он пишет о той части процесса, которую большинство людей никогда не видит: о том, как языковая модель читает предложение, оценивает его и решает, что изменить.


