
AI Humanizer для швейцарских исследователей, пишущих на английском
AI Humanizer для швейцарских исследователей. Снижайте количество ложных срабатываний AI-детекторов на англоязычных текстах с влиянием немецкого и французского языков: сохраняйте смысл и цитирования, а также соблюдайте честное раскрытие использования.

Швейцария располагает одной из самых плотных исследовательских экономик в мире. Если измерять показатели на душу населения, то немногие страны публикуют больше материалов или привлекают больше цитирований, а домен ETH находится почти в самом верху в большинстве значимых рейтингов. Почти вся эта работа выходит в печать на английском — независимо от того, является ли родным языком автора немецкий, французский, итальянский или ретороманский.
Именно здесь и начинается современная проблема. AI Humanizer для швейцарских исследователей существует потому, что аккуратный, нормативный английский, написанный носителем немецкого или французского, все чаще ошибочно воспринимается детекторами как машинный текст. Фразы написаны человеком. Система считает иначе, и такое расхождение может остановить подачу еще до того, как первый рецензент прочитает хоть одно слово.
Представьте постдока в Universität Bern, который готовит раздел «Методология» на ясном, академическом английском. Ничего не копируется. Ничего не выдумывается. Тем не менее детектор возвращает оценку «AI-generated», и теперь на исследователе лежит необходимость доказать отрицательное. Этот гайд посвящен устранению такой несправедливости честно — без скрытия реального использования ИИ.
KI-Text humanisieren: так публикуют швейцарские исследователи уверенно на английском
Наш Humanizer помогает исследователям в ETH, EPFL и везде между ними делать английские рукописи более естественными — без потери смысла или источников. Pour les chercheurs romands, l'objectif est identique : humaniser un texte IA tout en gardant le sens et les références intacts.
Говоря прямо: пишет ли вы на стандартном немецком в Цюрихе или на французском в Лозанне, инструмент меняет ритм вашего английского так, чтобы аккуратная «вторая» языковая манера реже воспринималась как машинная. Ваши технические термины и цитирования остаются ровно такими, как вы их задали, а выстроенная вами аргументация — вашей.
Пишете на немецком, французском или итальянском? Humanizer определяет каждый вариант
Швейцарские исследования пишутся на нескольких языках, и Humanizer распознает любой из них, который вы вставляете в текст. Дайте ему немецкий, французский или итальянский — ProofreaderPro автоматически определит язык, а затем пропустит текст через языково-ориентированную модель, сохраняя ваши термины и цитирования в точности на своих местах. Через KI-Text humanisieren немецкий черновик «очеловечивается» так же легко, как и английский, без предварительного перевода. То же автоматическое распознавание распространяется более чем на шестьдесят языков — каждый текст переписывается в соответствующем регистре.
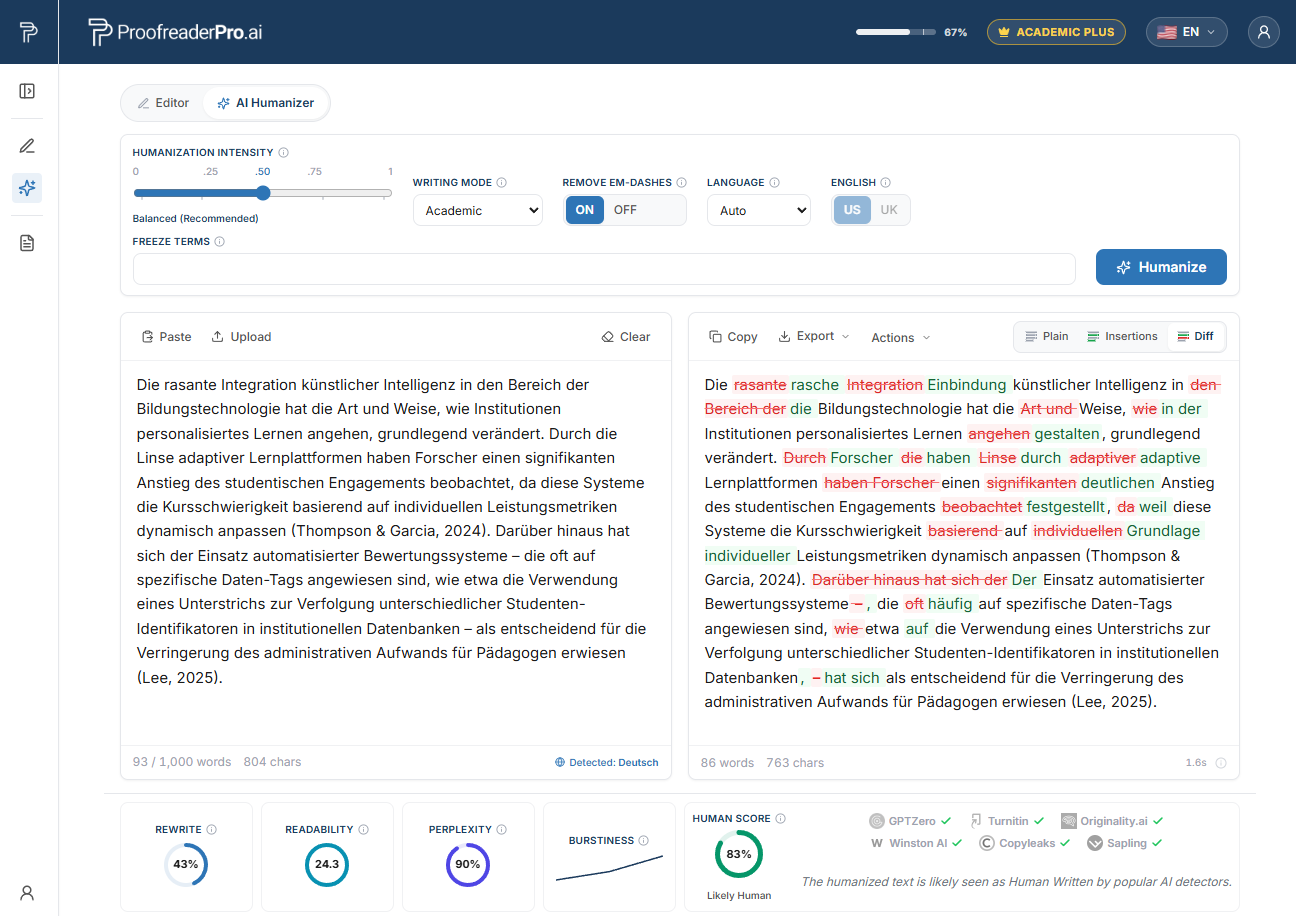
ProofreaderPro AI Humanizer переписывает немецкий академический текст. Различия до и после сохраняют смысл и цитирования, а проверки детектора подтверждают естественное восприятие человеком.
Почему швейцарских исследователей отмечают AI-детекторы
Самое убедительное свидетельство — это исследование Stanford за 2023 год от Liang и коллег, опубликованное в журнале Cell Press Patterns под заголовком «GPT detectors are biased against non-native English writers». Команда прогнала эссе, написанные людьми, через семь широко используемых детекторов и посмотрела, что вернется обратно.
Результаты должны насторожить любого, кто пишет на английском как на втором или третьем языке. В среднем около 61% эссе не носителей языка было помечено как AI, тогда как для эссе носителей английского этот показатель составлял примерно 5%. Почти каждый пятый — около 19,8% — был помечен единогласно каждым детектором из набора. И каждое из этих эссе было написано человеком.
Почему это происходит? Большинство детекторов оценивают нечто под названием perplexity — меру того, насколько «неожиданным» является следующее слово для языковой модели. Авторы, которые выбирают распространенную лексику и стандартные, предсказуемые формулировки, получают текст с низкой perplexity, а низкая perplexity — это как раз то, что подобные системы читают как машинно написанный. Привычки, благодаря которым швейцарский английский звучит ясно и корректно, — те же самые привычки, из‑за которых детектор «спотыкается». Механизм мы разбираем подробнее в почему AI-детекторы отмечают авторов, не являющихся носителями языка.
Языковые паттерны немецкого и французского как родных языков, лежащие в основе ложных срабатываний
Швейцарский английский несет следы первого языка автора — и эти следы верны, аккуратны и соответствуют норме. В этом и заключается жестокость ситуации. Нормативность считывается детектором как низкая perplexity, поэтому та самая беглость, к которой вы стремились, может сыграть против вас.
Носители немецкого часто привносят false friends, которые грамматически корректны, но статистически «плоские». «Aktuell» превращается в «actual», когда автор имеет в виду «актуальный»; «eventuell» — в «eventually», когда смысл «возможно»; «also» приходит со значением «также» или «таким образом»; «bekommen» смещается к «become» вместо «receive». Каждый выбор осознан и последователен, а последовательность воспринимается как предсказуемость.
Далее — структура предложений. Порядок слов в немецком подталкивает к конструкциям вроде «Therefore is the effect stronger», а любовь языка к длинным существительным‑компаундам и номинализации переносит это в английский как плотную, упорядоченную манеру изложения. Немецкоязычный автор может также тянуться к «since», когда английскому нужно «for» для обозначения длительности. И все это не является ошибкой мышления. Это просто регулярность, а регулярность выглядит механически для ПО.
Носители французского сталкиваются со своими false friends. «Actuel» проскальзывает вместо «current», «éventuellement» — вместо «possibly», «sensible» — вместо «sensitive», а «important» часто используется вместо «large»; некоторые пишут «assist to», когда имеется в виду «attend». И снова — аккуратность и нормативность, а это и есть весь подвох.
Французский академический стиль также предпочитает длинные периодические предложения со «слоистыми» относительными придаточными, частую номинализацию, частое «which», а также обороты вроде «permit to» и «in the case where». Английские рецензенты читают это как плотную прозу. Детектор воспринимает ровность как низкую perplexity. Текст написан человеком. Просто его ритм слишком аккуратен — не по вкусу машине.
Защитите ваше аккуратное английское письмо от ложного сигнала
«Оcочеловечьте» свой собственный черновик, подготовленный с помощью ИИ, сохраните каждую цитату и технический термин, затем с уверенностью раскройте ваше использование ИИ.
Попробуйте бесплатный HumanizerКонтекст AI-детектирования в Швейцарии и Turnitin
Здесь проверка — рутина. Диссертации и журнальные подачки в швейцарских институтах обычно проходят через Turnitin или iThenticate для выявления совпадений, а AI‑индикаторы все чаще располагаются рядом с этими показателями схожести. Исследователь в Базеле или Женеве должен исходить из того, что в какой‑то момент будет выполнена автоматизированная проверка.
Институциональный настрой скорее вдумчивый, чем карательный. ETH Zürich, EPFL и другие университеты публиковали рекомендации по generative‑AI для студентов и сотрудников, и направление движения — в раскрытии, а не в запрете. Финансирующие организации и журналы все чаще просят авторов указывать, где и как они использовали AI‑инструменты. Рассматривайте оценку детектора как утверждение, на которое можно ответить, а не как приговор, который нужно принимать.
Крупнейшие швейцарские университеты и где встречаются AI‑проверки
Та же логика скрининга действует по всей швейцарской системе. Эти учреждения проверяют диссертации и рукописи на схожесть и, все чаще, на AI‑индикаторы:
- ETH Zürich (Eidgenössische Technische Hochschule Zürich), в Цюрихе
- EPFL (École polytechnique fédérale de Lausanne), в Лозанне
- Universität Zürich (UZH), в Цюрихе
- Université de Genève (UNIGE), в Женеве
- Universität Basel, в Базеле
- Universität Bern, в Берне
- Université de Lausanne (UNIL), в Лозанне
- Université de Fribourg / Universität Freiburg, во Фрибурге
- Università della Svizzera italiana (USI), в Лугано
- Universität St. Gallen (HSG), в Санкт‑Галлене
- Universität Luzern, в Люцерне
- Université de Neuchâtel, в Невшателе
По всей немецкоязычной северной и восточной части и по французскоязычному западу картина сохраняется. Аккуратный английский авторами, не являющимися носителями, — норма, и именно такой английский чаще всего и ошибочно читают как машинный.
Как работает AI humanizer для швейцарских исследователей
Ниже — честный пошаговый процесс AI humanizer для швейцарских исследователей. Начните с того места, где вы пишете лучше всего. Многие исследователи сначала готовят черновик на родном языке — на немецком или французском — а затем переводят; другие пишут напрямую на английском с помощью AI. В любом случае исходный черновик — ваш, и так и должно остаться.
Далее исправьте грамматику и терминологию, чтобы наука была точной. Затем пропустите ваш собственный текст, поддержанный AI, через humanizer. Он меняет длину предложений и выбор слов, разрывает повторяющуюся ритмику, убирает механический темп и случайные «em dash» — то, что замечают и рецензенты, и детекторы, при этом сохраняя ваш смысл, вашу техническую лексику и каждое цитирование на месте. Вы можете попробовать humanizer бесплатно на одном разделе, прежде чем решите сделать полный проход.
Чего можно ожидать? По нашим собственным тестам humanizer существенно снижает частоту, с которой аккуратный нормативный английский не носителей ошибочно распознается основными детекторами — Turnitin, Originality.ai, GPTZero и другими — при сохранении академического смысла. Мы описываем это как то, что наблюдали, а не как обещание. Детекторы переобучаются каждые несколько месяцев, и ни один честный инструмент не может обещать 100% нераспознаваемость.
Последний шаг обязателен: раскрытие. Укажите использование AI в формате, который требует ваш институт и целевой журнал. Именно сочетание — сначала «очеловечить» собственный текст, а затем раскрыть использование — помогает оставаться в рамках требований академической добросовестности и одновременно защищает реальную работу от ложного срабатывания. Инструмент встроен в наш более широкий global academic editing hub, а это один из «лучей» multilingual AI humanizer hub, который охватывает десятки языков.
Локальные органы финансирования, журналы и ожидания по раскрытию использования AI
Швейцарские исследования опираются на хорошо известную инфраструктуру. SNSF (Swiss National Science Foundation; Schweizerischer Nationalfonds, SNF; Fonds national suisse, FNS) — главный государственный фонд, Innosuisse поддерживает инновации и прикладные проекты, а швейцарские группы получают заметную долю грантов Европейского исследовательского совета. SNSF также требует open access, поэтому ваша работа предназначена для максимально широкого прочтения.
Эта реальность публикаций определяет, куда вы подаете материалы. Здесь исследователи нацелены на журналы, индексируемые в Web of Science и Scopus, и рано присоединились к open access в рамках Plan S. Скрининг на схожесть с Turnitin или iThenticate стандартен и на этапе подачи — это еще одна причина, чтобы ваш английский звучал естественно.
Ожидания по раскрытию растут вместе с инструментами. Фонды и журналы все чаще просят авторов указывать, как они использовали AI, поэтому ведите короткую честную запись того, что вы применяли и где. Если вам нужны готовые формулировки, наши шаблоны заявления о раскрытии использования AI дадут точку старта. А если пометка все же появится на тексте, написанном человеком, относитесь к этому как к предмету для обсуждения и подготовьте спокойный, подтвержденный фактами ответ вместо панического переписывания.
Часто задаваемые вопросы
В: Считается ли использование AI humanizer для швейцарских исследователей мошенничеством?
Нет, если вы используете его честно. Вы «очеловечиваете» собственный текст, поддержанный AI, чтобы защитить аккуратный английский от ложного срабатывания, а не выдумываете результаты или скрываете метод. Правило, которое сохраняет вам безопасность, — раскрытие: укажите ваше использование AI так, как этого требуют ваш институт и журнал.
В: Изменит ли humanizer мои цитирования или технические термины?
Нет. Он сохраняет ваши источники, числа и терминологию предметной области, а меняет только ритм и выбор слов, чтобы текст читался естественно. Ваши методы остаются вашими, а библиография не трогается.
В: Можете ли вы гарантировать, что моя статья пройдет AI-детектор?
Нет, и будьте осторожны с теми, кто утверждает обратное. Детекторы переобучаются регулярно, поэтому ни один честный инструмент не может пообещать 100% нераспознаваемость. Что мы можем сказать: по нашим тестам humanized-тексты отмечаются гораздо реже, а смысл при этом сохраняется.
В: Работает ли это и для носителей немецкого, и для носителей французского?
Да. Humanizer учитывает язык и поддерживает более 60 языков, так что независимо от того, немецкий, французский, итальянский или ретороманский — ваш первый язык, инструмент работает с вашим английским черновиком, уважая структуру, которую вы задумали.
В: Я писал статью сам на аккуратном английском. Почему ее отметили?
Потому что детекторы оценивают perplexity, а аккуратный нормативный английский как второй язык по природе будет иметь низкую perplexity. Результаты Stanford показывают: эссе, написанные людьми, отмечаются с высокой вероятностью просто из‑за того, как читается текст — как предсказуемый. Пометка — это статистическая гипотеза о вашем стиле, а не доказательство неправомерных действий.
Языково-осознанная «дегуманизация» для швейцарских исследователей, пишущих на английском: она сохраняет смысл, терминологию и цитаты, одновременно выравнивая ровный ритм, который детекторы часто неверно интерпретируют.

Мо — инженер NLP с PhD в области обработки естественного языка. Его исследования охватывают компьютерную лингвистику, анализ текста и машинное обучение, и они напрямую используются в моделях редактирования и гуманизации, лежащих в основе ProofreaderPro. Он пишет о той части процесса, которую большинство людей никогда не видит: о том, как языковая модель читает предложение, оценивает его и решает, что изменить.


