Marca d’água da OpenAI, SynthID e Claude: comparação de marcas d’água de texto
A OpenAI marca o texto, existe um verificador público de marca d’água da OpenAI e como se diferenciam a SynthID e a marca d’água da Claude, com comparação para quem escreve academicamente.
A OpenAI, a Google e a Anthropic desenvolveram tudo a mesma tecnologia: uma marca d’água estatística para textos gerados por IA. A OpenAI manteve sua versão em sigilo por anos e começou a distribuí-la, como textGrain, em outubro de 2026. A Google incorporou a SynthID no Gemini e publicou o método. A Anthropic tornou a marca d’água da Claude obrigatória para todos os usuários em agosto de 2026. Se você escreve com assistência de IA de qualquer forma, essas três decisões agora determinam como seus documentos são avaliados.
O watermarking saiu do universo acadêmico e virou notícia mainstream em 11 de agosto de 2026, quando a Anthropic anunciou que cada novo modelo da Claude marca a saída de texto. Nós analisamos esse anúncio em detalhes no nosso explicador de marca d’água da Claude. Este guia mostra o panorama completo: o que é uma marca d’água de texto, como cada um dos três grandes laboratórios a implementou ou deixou de implementar e o que cada sistema prova sobre um texto.
O que é uma marca d’água de texto de IA?
Uma marca d’água de texto de IA é um padrão estatístico oculto nas escolhas de palavras de um texto gerado, inserido no momento da geração para que um detector com a chave correta possa, posteriormente, verificar que o texto veio de um sistema de IA específico. Não é um rótulo visível, não é um caractere oculto e não é metadado anexado a um arquivo. A marca existe nas próprias palavras.
Essa distinção importa, porque o termo "marca d’água" é usado de forma ampla para três coisas diferentes:
| O que é | Onde ela fica | Sobrevive ao copiar e colar? | |
|---|---|---|---|
| Marca d’água estatística | Um viés no qual o modelo escolhe palavras | O próprio texto | Sim |
| Metadados do arquivo (C2PA) | Um rótulo de procedência assinado | O contêiner do arquivo | Não, a cópia em texto puro remove isso |
| Caracteres de largura zero | Unicode invisível inserido no texto | Entre os caracteres visíveis | Não, removido de forma trivial |
A marca d’água estatística é a única das três que sobrevive à cópia, colagem, reescrita e à conversão de formato em um novo documento. Por isso, os três grandes laboratórios convergiram para ela no texto, e por isso os "removedores de marca d’água" que eliminam caracteres invisíveis não fazem nada contra ela. Nossa página removedor de marca d’água de Claude documenta esse modo de falha com fontes.
Como a marca d’água estatística funciona de fato?
Em cada etapa da escrita de uma frase, um modelo de linguagem escolhe entre várias palavras quase equivalentes, e a marca d’água carrega discretamente esses dados. A receita fundamental foi publicada por Kirchenbauer e colegas na Universidade de Maryland em janeiro de 2023, em A Watermark for Large Language Models (ICML 2023). Funciona assim:
- Antes que cada palavra seja escolhida, uma chave secreta derivada das palavras anteriores divide o vocabulário em um conjunto preferido e em um conjunto neutro.
- O modelo direciona sua escolha para o conjunto preferido. "Suggest" em vez de "indicate". "Across" em vez de "among". Cada escolha individual parece completamente natural.
- Um detector que possui a chave conta com que frequência o texto cai nos conjuntos preferidos. A escrita humana atinge a taxa esperada por acaso. O texto marcado atinge isso com frequência muito maior, e um teste estatístico sinaliza a discrepância.
Nenhuma palavra isolada é evidência de qualquer coisa. O sinal só aparece ao longo de dezenas ou centenas de escolhas, por isso trechos mais longos são mais fáceis de testar do que curtos, e por isso a detecção é sempre probabilística, e não um carimbo de sim ou não.
O sistema de produção da Google DeepMind, publicado na Nature em outubro de 2024 como Marca d’água escalável para identificar as saídas de modelos de linguagem de grande porte, refinou isso com uma técnica chamada tournament sampling, que preserva a qualidade do texto o suficiente para rodar silenciosamente dentro de um produto de consumo em escala. Esse artigo importa além da Google: é a base publicada que a Anthropic aponta para a implementação do Claude.
A principal fraqueza foi publicada antes da maioria das implantações. Em março de 2023, Krishna e colegas mostraram em Paráfrases conseguem burlar detectores de texto gerado por IA (NeurIPS 2023) que regenerar a redação de um trecho derruba a detecção de todos os métodos, inclusive a marca d’água. O sinal vive na sequência exata de tokens e em lugar nenhum, então qualquer coisa que reescreva a sequência, inclusive um editor humano, reescreve a evidência para longe. Todo fornecedor que lança uma marca d’água hoje afirma essa limitação na própria documentação.
OpenAI: a empresa que a inventou e lançou por último
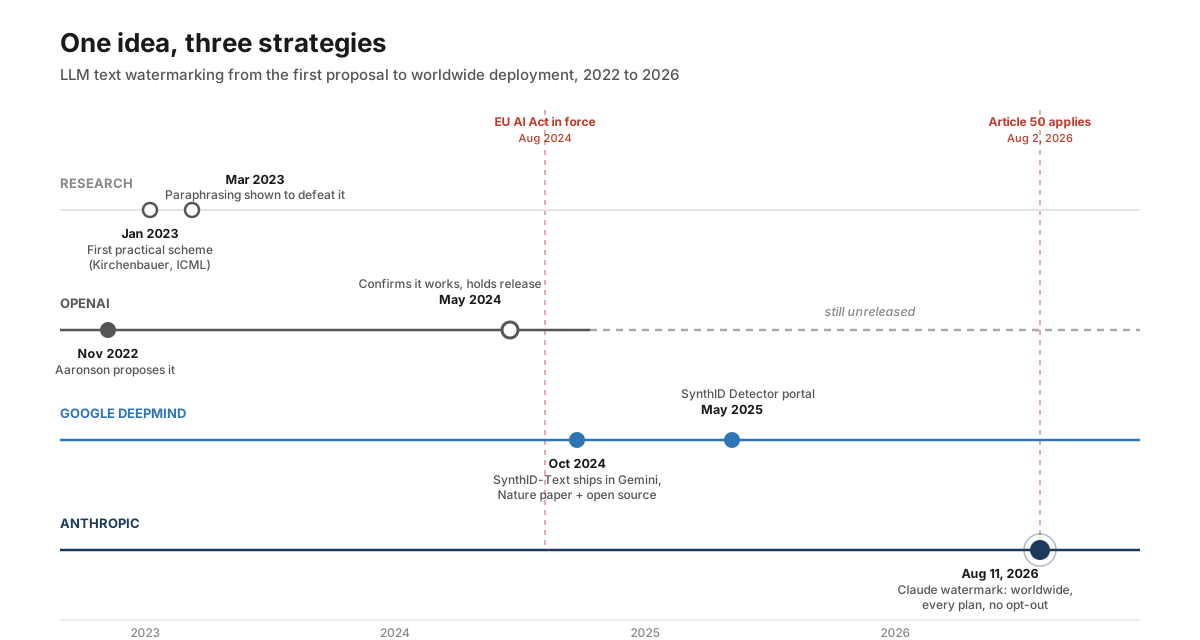
A OpenAI tinha uma marca d’água de texto funcionando por anos e decidiu não divulgá-la até outubro de 2026. Scott Aaronson, então trabalhando com segurança na OpenAI, descreveu a ideia publicamente pela primeira vez em uma palestra de novembro de 2022. O método viesa as escolhas do modelo entre palavras quase equivalentes com uma função criptográfica secreta, então o próprio texto mostra de onde veio. Essa palestra é mais antiga do que todos os sistemas implantados.
Em maio de 2024, a OpenAI descreveu o estado do projeto na sua atualização de proveniência, Compreendendo a origem do que vemos e ouvimos na internet. A empresa disse que o seu método de marca d'água textual era preciso e eficaz em pequenas edições, mas que estava segurando o lançamento enquanto avaliava os trade-offs. Dois dos riscos que a OpenAI apontou importam diretamente para quem escreve em contexto acadêmico:
- Fácil contorno. Reescrever ou traduzir o texto remove a marca, exatamente como a pesquisa de 2023 previu. Uma marca d'água que quase só captura pessoas que não sabem que ela existe é um instrumento fraco de aplicação.
- Impacto desproporcional em falantes não nativos de inglês. A OpenAI afirmou que a marca d'água poderia estigmatizar o uso legítimo de IA como apoio à escrita por pessoas que escrevem em um segundo idioma. Nosso texto sobre por que detectores de IA sinalizam escritores não nativos aborda o mesmo problema pelo lado dos detectores.
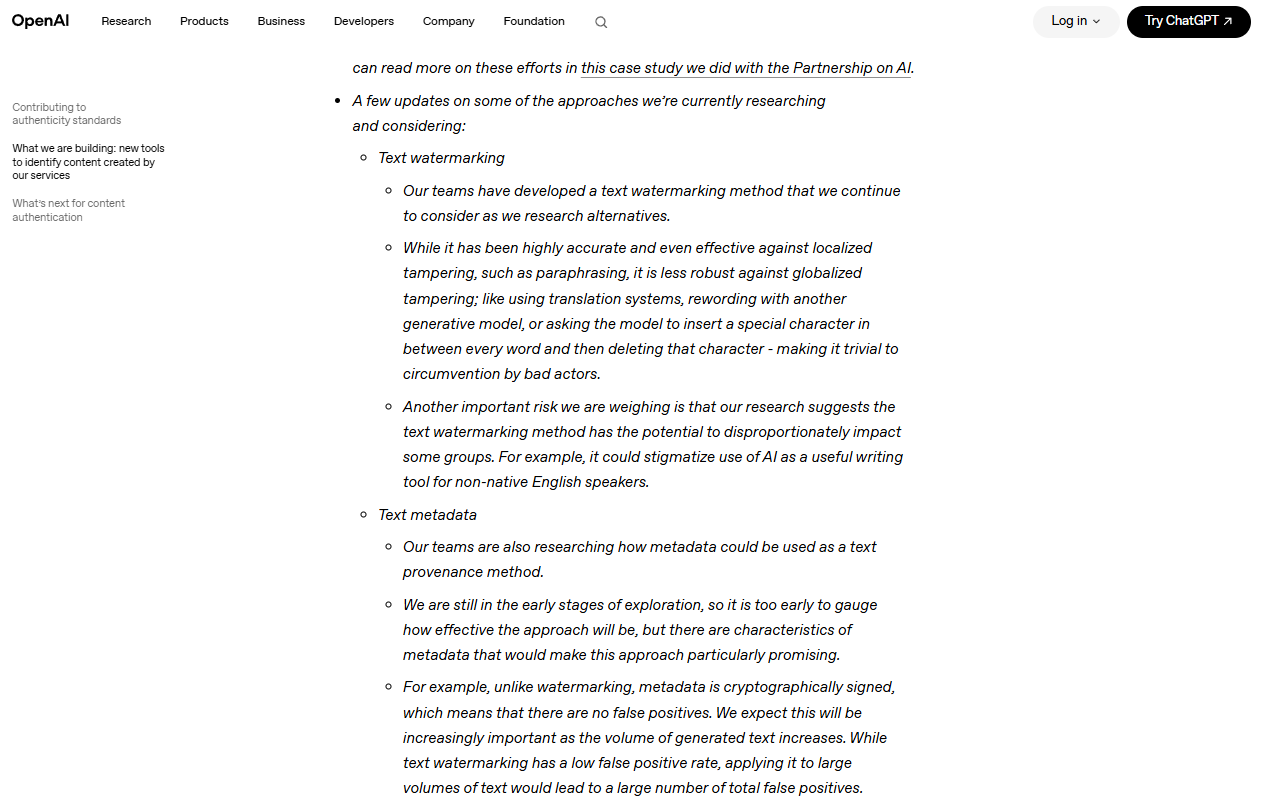
Atualização de proveniência da OpenAI de 2024: o método funciona, e a empresa lista os motivos pelos quais o manteve em espera na época.
Para imagens e áudio, a OpenAI seguiu por outro caminho: metadados de proveniência C2PA nos resultados do DALL-E e do Sora, ou seja, um rótulo no nível do arquivo, e não uma marca no conteúdo. Para texto, a saída do ChatGPT não tinha marca d'água até outubro de 2026. A empresa que propôs a tecnologia foi a última das três a implementá-la.
A OpenAI já marca texto com marca d'água?
Sim, a OpenAI começou a aplicar marca d'água a alguns textos em 5 de outubro de 2026, em resposta à Lei de IA da União Europeia (EU AI Act). Seu anúncio apresenta uma marca d'água de texto chamada textGrain, que adiciona um sinal estatístico invisível às escolhas de palavras do modelo. A implantação tem três partes, e a marca d'água não é um padrão global:
- Clientes da API em qualquer lugar podem ativar a saída com marca d'água para modelos selecionados. Ela fica desativada por padrão.
- Nas semanas seguintes, saídas de texto elegíveis do ChatGPT e do Codex na União Europeia recebem a marca d'água, em todos os planos.
- Pesquisadores aprovados e organizações especializadas podem solicitar acesso ao detector de marca d'água de texto.
A OpenAI afirma que o textGrain atingiu ou superou os outros métodos que testou, incluindo o SynthID da Google para texto. A empresa também publicou onde a detecção fica mais fraca. Com taxa de falso positivo de 1%, o detector identificou a marca d'água em cerca de 80% de passagens com 200 tokens e cerca de 95% de passagens com 400 tokens em conteúdos de psicologia. A detecção foi bem menor para matemática, onde há menos liberdade nas escolhas de palavras.
A edição enfraquece o sinal rapidamente. Em passagens com 400 tokens, substituir 10% das palavras por sinônimos reduziu a detecção de cerca de 92% para 66%, e substituir 25% reduziu para 17%.
A OpenAI também verificou se a marca d'água altera a qualidade das respostas na Astra, seu modelo mais recente, e diz que não viu diferença significativa. Aqui estão quatro dos benchmarks que ela publicou:
| Benchmark | Sem marca d'água (Astra) | Com marca d'água (Astra) |
|---|---|---|
| Artificial Analysis Intelligence Index | 49.57 pontos | 49.76 pontos |
| GPQA Diamond | 94.44% | 93.94% |
| HealthBench Professional | 64.27% | 64.60% |
| BrowseComp | 87.92% | 87.35% |
Para estudantes, a data importa. O texto do ChatGPT escrito antes da implantação, ou fora da UE sem a configuração da API, não tem marca d'água da OpenAI. Nosso guia para Turnitin Clarity explicada explica como as escolas estão definindo as próprias políticas de uso de IA, por enquanto.
Existe um verificador público de marca d'água da OpenAI?
Ainda não existe um verificador público de watermark da OpenAI para texto. A ferramenta gratuita de verificação da OpenAI verifica arquivos de imagem e áudio quanto a credenciais de Conteúdo C2PA e quanto a um watermark SynthID, que a OpenAI incorpora em imagens e áudios compatíveis. A OpenAI afirma que a ferramenta não suporta texto.
Para texto, a OpenAI oferece acesso ao detector caso a caso a pesquisadores aprovados e organizações especializadas, por meio do seu formulário do Content Provenance API. Ela diz que não vai disponibilizar o detector de texto no lançamento porque há risco de watermarks perdidos e falsos positivos. O detector informa se encontra um watermark da OpenAI, e não identifica o usuário nem mostra seus prompts.
| O que você quer verificar | Ferramenta | Quem pode usar |
|---|---|---|
| Um arquivo de imagem ou áudio da OpenAI | Ferramenta de verificação da OpenAI | Qualquer pessoa, grátis |
| Saída de texto da OpenAI (textGrain) | Detector de watermark de texto da OpenAI | Pesquisadores aprovados e organizações especializadas, mediante solicitação |
| Saída de texto do Claude | Detector de Watermark do Claude | Organizações elegíveis, mediante solicitação (veja nosso guia de watermark do Claude) |
A OpenAI também é clara sobre o que um resultado não consegue lhe dizer. Um watermark detectado não mede quanto uma pessoa contribuiu, e não identifica quem escreveu ou usou o texto. A ausência de watermark também não prova autoria humana, porque o texto pode estar curto demais, ter sido editado, traduzido, ou ter vindo de um modelo não suportado.
Google: primeiro a lançar, depois abriu a receita
A DeepMind do Google lançou primeiro, publicou totalmente e depois abriu o método. O seu sistema, SynthID, começou como um watermark de imagem em 2023 e se expandiu para texto em 2024. Quando o artigo da Nature apareceu em outubro de 2024, o SynthID-Text já estava em execução dentro do Gemini em produção, o que o tornou o primeiro watermark estatístico de texto implantado em escala de consumo.
O SynthID cobre texto, imagens, áudio e vídeo, e está ativo na saída de texto do Gemini desde outubro de 2024.
Em seguida, o Google publicou a implementação como código aberto no Hugging Face, permitindo que qualquer desenvolvedor aplique o mesmo esquema de watermarking aos seus próprios modelos. Em maio de 2025, anunciou o SynthID Detector, um portal de verificação em que o conteúdo pode ser checado quanto a marcas do SynthID em texto, imagens, áudio e vídeo.
Há uma limitação de escopo importante: o SynthID só marca e só detecta conteúdo proveniente dos próprios modelos do Google. Ele não diz nada sobre a saída do ChatGPT ou do Claude, e uma varredura limpa do SynthID não significa que o texto tenha sido escrito por humanos. Isso significa apenas que os modelos do Google não o escreveram, o que é uma afirmação bem mais restrita.
Anthropic: por último a mover, política mais rígida
A Anthropic fez a implantação mais recente, com a cobertura obrigatória mais ampla. Cada modelo Claude lançado em ou após 2 de agosto de 2026 incorpora um watermark estatístico na sua saída de texto, em todo o mundo, em todos os planos, sem opção de exclusão. A empresa descreve o mecanismo no seu explicador, Como o watermark de texto do Claude funciona, e o escopo da política no artigo do centro de ajuda, Como o Claude marca conteúdo gerado por IA: a API do Claude, claude.ai, Claude Code, Claude Cowork e Claude Tag estão todos incluídos. Modelos lançados antes do corte estão em um período de transição, e a Anthropic diz que está adicionando suporte de marcação também para eles. Junto com a marca estatística, arquivos gerados pelo Claude também incluem metadados C2PA, um segundo sistema separado que a cópia em texto simples remove.
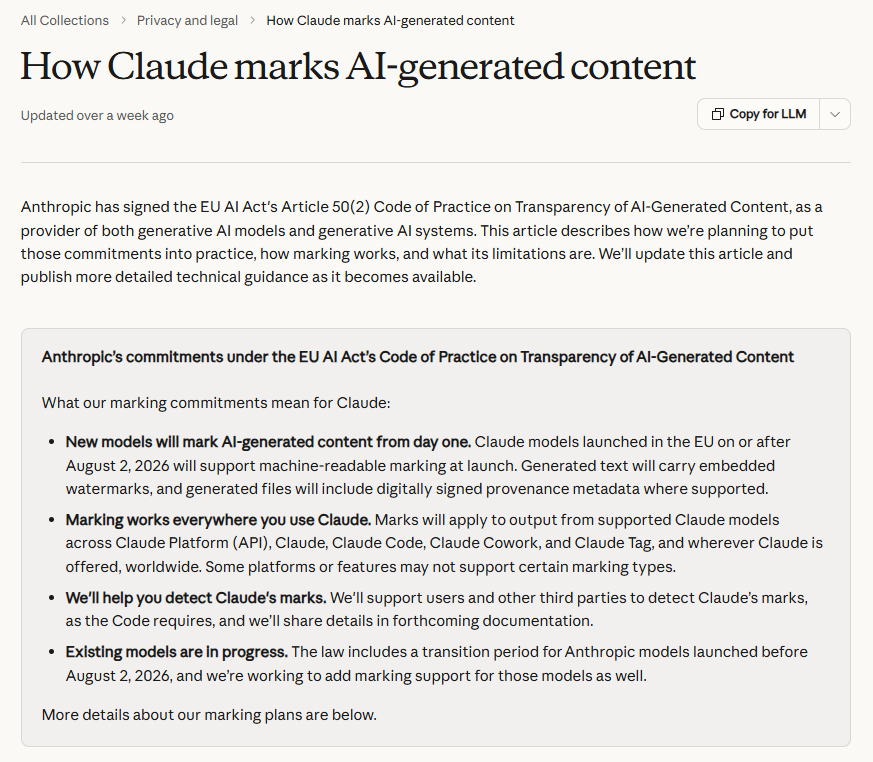
A política nas próprias palavras da Anthropic: todo novo modelo, toda plataforma, mundialmente, com modelos mais antigos sendo adicionados.
A documentação da Anthropic afirma os limites de forma direta. A detecção é probabilística. A marca não consegue distinguir um documento que a Claude escreveu de um documento escrito por um humano e levemente editado pela Claude. Uma reescrita completa elimina isso. Passamos por tudo isso, incluindo o que uma detecção positiva realmente comprova e o que fazer se o seu próprio texto for marcado, no guia dedicado de marca d’água da Claude.
O cronograma segue a regulamentação. A Anthropic assinou o Código de Prática do Artigo 50(2) sobre Transparência de Conteúdo Gerado por IA sob o EU AI Act, o que exige que os fornecedores de sistemas de IA generativa garantam que as saídas sejam "marcadas em um formato legível por máquina e detectáveis como geradas artificialmente". Essas obrigações de transparência passaram a ser aplicáveis em 2 de agosto de 2026: a data de corte exata na política de modelos da Anthropic, nove dias antes do anúncio público. A Anthropic optou por cumprir globalmente, em vez de manter comportamentos separados para o tráfego da UE. O Google já estava em conformidade por design. A saída de texto sem marca da OpenAI é a questão de conformidade aberta para 2027.
As três abordagens, lado a lado
| OpenAI | Google DeepMind | Anthropic | |
|---|---|---|---|
| Marca de texto implantada? | Sim (textGrain, implantação na UE a partir de 5 de outubro de 2026) | Sim (Gemini, desde outubro de 2024) | Sim (modelos Claude a partir de 2 de agosto de 2026) |
| Técnica | textGrain, um sinal estatístico nas escolhas de palavras | Amostragem por torneio SynthID | Marca por amostragem estatística, estilo SynthID |
| Cobertura | Texto elegível do ChatGPT e Codex na UE; ativação opcional na API em todo o mundo | Modelos do Google apenas | Todos os novos modelos da Claude; modelos mais antigos em transição |
| Exclusão (opt-out) | Desativada por padrão na API | Não | Não |
| Detector público | Não | Portal do SynthID Detector (2025) | Planejado, ainda não lançado |
| Esquema publicado? | Apenas palestras conceituais | Artigo da Nature + código aberto | Explicação, baseada em trabalhos publicados |
| Metadados do arquivo (C2PA) | Sim, imagens e áudio | Sim, em mídias diferentes | Sim, em arquivos gerados |
| Limitações declaradas | Contorno, estigma para ESL | Escopo limitado a seus próprios modelos | Probabilístico, edições borram a autoria |
O padrão nas colunas: a OpenAI trata a marca d'água de texto como um problema de política ainda não resolvido, o Google a trata como infraestrutura a ser padronizada e a Anthropic a trata como uma obrigação de conformidade a ser implementada integralmente.
O que isso significa para pesquisadores e autores acadêmicos
As consequências práticas dependem de quais ferramentas tocam seu texto. Se você rascunha com ChatGPT, seu texto não carrega uma marca d'água hoje. Se você rascunha com Gemini, ele carrega uma marca SynthID, que apenas o detector do Google consegue ler. Se você rascunha ou edita com um modelo atual da Claude, ele carrega a marca da Anthropic, e não há uma configuração que permita desligá-la.
Três coisas que autores acadêmicos devem saber:
Uma marca d'água identifica uma ferramenta, não um autor. Todo fornecedor afirma isso na própria documentação, e vale a pena repetir porque as políticas institucionais nem sempre fazem essa distinção. O texto pode ser marcado porque uma IA o rascunhou, porque uma IA fez revisão de cópia em duas frases dele, ou porque um parágrafo marcado foi citado. Se sua instituição realiza verificações de marca d'água, o que a verificação prova é que um modelo específico tocou o texto em algum momento, e nada além disso. Nosso guia sobre como apelar uma falsa sinalização de detecção de IA explica como fazer esse argumento quando isso importa.
Marcas d'água e detectores de IA são tecnologias diferentes, com modos de falha diferentes. Detectores como Turnitin ou GPTZero estimam a partir do estilo estatístico, com os problemas de precisão que documentamos. A detecção de marca d'água é um teste baseado em chaves, com uma taxa muito baixa de falso positivo em texto humano não marcado. A assimetria se inverte para os falsos negativos: uma verificação de marca d'água deixa passar qualquer texto de IA de um modelo que não marca, o que hoje inclui todos os textos do ChatGPT.
A divulgação continua sendo sua melhor posição. Marcação d'água torna o uso silencioso de IA mais arriscado e o uso de IA divulgado mais seguro, porque um fluxo divulgado não tem nada a temer de uma marca positiva. A maioria das revistas e universidades agora tem políticas explícitas de uso de IA; nossa política de uso de IA explica como traçamos esses limites entre as nossas próprias ferramentas, e é um modelo razoável do que parece um uso transparente.
O que remove uma marca d'água de texto e o que não remove
Reescrever remove; reformatar não. Copiar, colar, mudar fontes, converter entre formatos de arquivo e remover caracteres invisíveis deixam uma marca d'água estatística totalmente intacta, porque a marca está nas escolhas de palavras. O que remove é qualquer coisa que regenere o texto: uma edição humana profunda, uma tradução ou uma paráfrase genuína, como o estudo de robustez NeurIPS 2023 estabeleceu antes de qualquer um desses sistemas ser lançado.
As duas direções importam aqui. O marcador desaparecer não faz o texto ser seu, e o marcador continuar não faz o texto deixar de ser seu. Um rascunho de IA reescrito ainda é um documento com assistência de IA ao qual as regras de divulgação da sua instituição se aplicam. Nosso humanizer de IA reescreve rascunhos assistidos por IA para um registro acadêmico natural e, como esse processo regenera a sequência de tokens, marcas estatísticas não sobrevivem a ele. Para o texto do Claude especificamente, o removedor gratuito de marca d'água do Claude reexpressa cada frase em uma redação nova, mantendo fatos, números e citações inalterados. O que nenhuma ferramenta consegue mudar é o que você deve ao seu leitor: a transparência sobre como o documento foi feito.
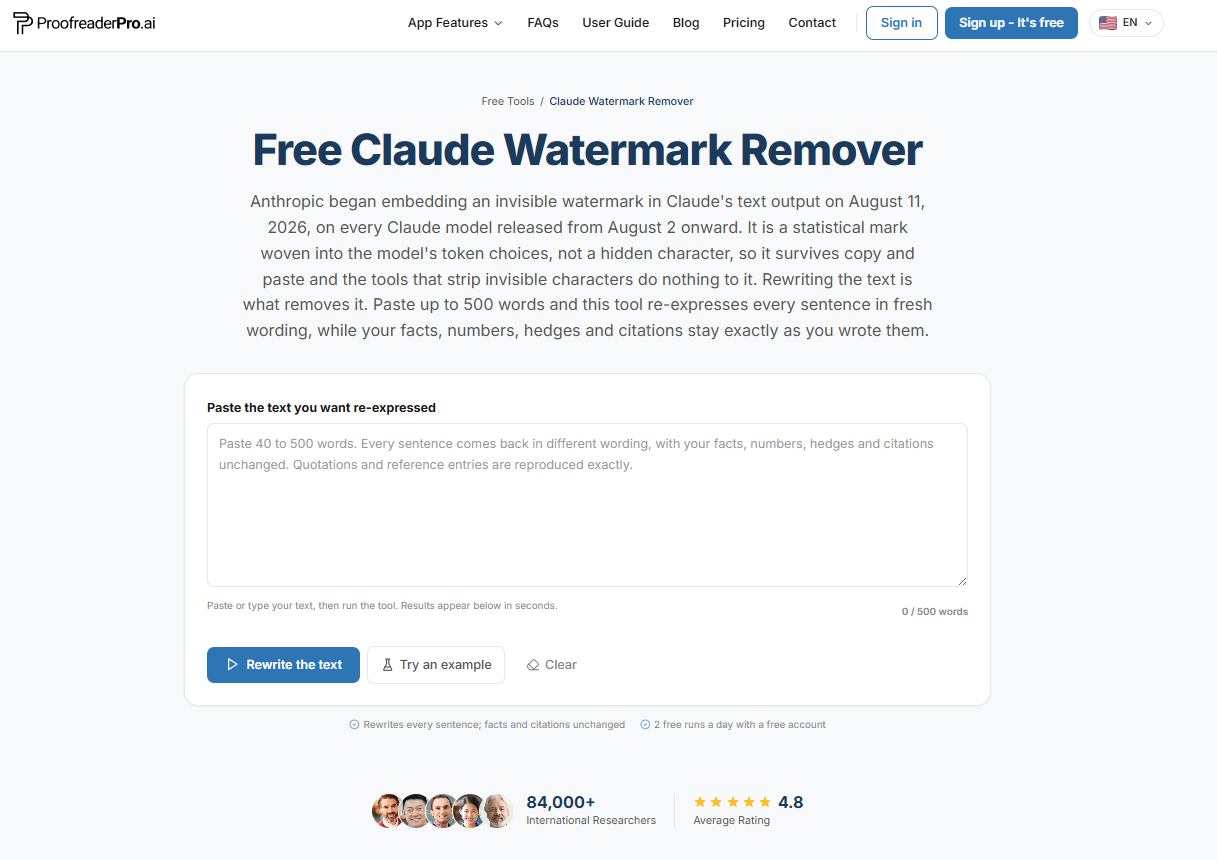
Reescrever é a única operação que remove uma marca estatística, e é exatamente o que esta ferramenta faz, frase por frase.
Para onde isso vai a seguir
Acompanhe três pontos até 2027. Primeiro, se a OpenAI leva o textGrain além da EU: começou por lá porque a aplicação europeia do Artigo 50 exige marcadores legíveis por máquina em textos de IA. Segundo, se os detectores convergem. Se cada grande laboratório marcar com um esquema publicado, as universidades podem verificar chaves em vez de adivinhar a partir do estilo da escrita, o que melhoraria o detecção propensa a falsos positivos de hoje. Terceiro, se as marcas se tornam compatíveis. Hoje, três laboratórios usam três marcas diferentes, e nenhuma verificação única cobre todas. O C2PA preenche essa lacuna para arquivos; ainda não há nada que preencha isso para texto bruto.
O ChatGPT marca sua escrita com marca d'água?
Sim, em parte, desde 5 de outubro de 2026. A OpenAI começou a adicionar sua marca d'água textGrain ao texto elegível do ChatGPT e do Codex na União Europeia, e clientes da API em qualquer lugar podem ativá-la. A marca d'água é um sinal estatístico nas escolhas de palavras, sem caracteres ocultos. A OpenAI também aplica metadados de proveniência C2PA a arquivos de mídia do DALL-E e do Sora, um sistema separado, em nível de arquivo.
O Google Gemini marca sua escrita com marca d'água?
Sim. A saída do Gemini vem carregando a marca d'água SynthID-Text da Google DeepMind desde outubro de 2024. É uma marca estatística nas escolhas de palavras, invisível para os leitores e verificável via o Detector SynthID da Google. Ela só se aplica aos modelos próprios da Google, então um resultado negativo do SynthID não diz nada sobre texto de outros sistemas de IA.
O Claude marca sua escrita com marca d'água?
Sim. Cada modelo do Claude lançado em ou após 2 de agosto de 2026 incorpora uma marca d'água estatística na saída de texto, em todas as plataformas e planos, sem opção de cancelamento, e arquivos gerados pelo Claude também carregam metadados C2PA. Modelos lançados antes dessa data ainda não marcam sua saída; a Anthropic diz que está adicionando suporte à marcação para eles durante um período de transição. Os detalhes completos estão no nosso explicador de marca d'água do Claude.
As universidades conseguem detectar marcas d'água de IA?
Somente com a cooperação do fornecedor, porque a detecção requer a chave do fornecedor. A Google oferece um portal público de detector para conteúdo SynthID. A Anthropic afirma que planeja suporte à detecção para usuários e terceiros, mas ainda não lançou um detector público. Nenhum conjunto de ferramentas mainstream de verificação de plágio consegue atualmente validar marcas d'água estatísticas de qualquer laboratório, então a chamada "detecção de IA" institucional ainda significa, hoje, apenas adivinhação baseada em estilo, e não verificação de marca d'água.
A marcação d'água de IA é exigida por lei?
Na UE, sim, em vigor. O artigo 50.º, n.º 2, do AI Act da UE exige que os provedores de IA generativa garantam que as saídas sejam marcadas em um formato legível por máquina e que possam ser detectadas como artificialmente geradas, com obrigações de transparência aplicáveis a partir de 2 de agosto de 2026. A Anthropic assinou o Código de Prática relacionado e optou por conformidade em escala global. A questão a acompanhar em 2027 é como os reguladores vão tratar a marca d'água de texto da OpenAI, que ainda não foi lançada.
As marcas d'água de IA sobrevivem à tradução?
Não. Uma marca d'água estatística vive na sequência exata de palavras que o modelo escolheu, e a tradução substitui cada palavra. O mesmo vale para paráfrases profundas e edições humanas pesadas. Essa limitação é documentada na literatura revisada por pares e reconhecida por todo fornecedor que comercializa uma marca d'água.
Existe um verificador público de marca d'água da OpenAI para texto?
Não. A ferramenta pública de verificação da OpenAI só verifica arquivos de imagem e áudio, para metadados C2PA e marcas d'água SynthID. A OpenAI afirma que não oferece suporte a texto. O detector de marca d'água de texto está aberto apenas para pesquisadores aprovados e organizações especializadas, caso a caso.
O que é textGrain?
textGrain é a marca d'água de texto da OpenAI, anunciada em 5 de outubro de 2026. Ela adiciona um sinal estatístico invisível às escolhas de palavras do modelo, de modo que a marca faz parte das palavras, sem caracteres ocultos nem metadados do arquivo. A OpenAI diz que correspondeu ou superou os outros métodos que testou, incluindo SynthID para texto, e que a edição o enfraquece.
Pesquisadores podem solicitar acesso ao detector de marca d'água de texto da OpenAI?
Sim. Pesquisadores aprovados e organizações especializadas podem se candidatar pelo formulário da OpenAI para a Content Provenance API. A OpenAI concede acesso caso a caso sob o Código de Prática da UE. Ela afirma que revisará uma abertura mais ampla conforme a tecnologia e as evidências evoluírem.
Fontes
- Anthropic, Como a marca d'água de texto da Claude funciona, agosto de 2026
- Anthropic Help Center, Como a Claude marca conteúdo gerado por IA, 2026
- OpenAI, Entendendo a origem do que vemos e ouvimos online, maio de 2024
- Google DeepMind, SynthID
- Dathathri et al., Watermarking escalável para identificar as saídas de grandes modelos de linguagem, Nature, outubro de 2024
- Google, Anúncio do detector SynthID, maio de 2025
- Hugging Face, Introduzindo SynthID Text, outubro de 2024
- Kirchenbauer et al., Uma marca d'água para grandes modelos de linguagem, ICML 2023
- Krishna et al., A paráfrase evita detectores de texto gerado por IA, NeurIPS 2023
- Scott Aaronson, Minha aula de segurança de IA para a UT de Effective Altruism, novembro de 2022
- União Europeia, AI Act, Artigo 50
- C2PA, Coalizão para Proveniência e Autenticidade do Conteúdo
Dana é criadora de conteúdo na ProofreaderPro, onde dirige o blog diário e escreve. Ela escreve artigos sobre como funciona a plataforma de edição online e lida com as mensagens dos clientes todos os dias, com uma pontuação de satisfação de cinco estrelas para mostrar isso.