
KI-Humanizer für italienische Forschende, die auf Englisch schreiben
KI-Humanizer für italienische Forschende. Reduzieren Sie fälschliche KI-Detektionswarnungen bei englischen Texten, die von italienischen Sprachmustern beeinflusst sind, behalten Sie Bedeutung und Zitationen bei und legen Sie Ihre Nutzung ehrlich offen.

Italien zählt zu den weltweit führenden acht bis zehn Ländern hinsichtlich der Forschungsleistung, doch fast keine dieser Arbeiten erreicht ihre Leserinnen und Leser auf Italienisch. Hier verfassen und durchdenken Akademikerinnen und Akademiker ihre Texte in einer Sprache und publizieren in einer anderen, weil eine italienische Forschungskarriere über indizierte englischsprachige Journals läuft. Die VQR-Bewertung der Forschungsqualität sowie die ASN nationale Qualifikation für die Professur stützen sich dabei auf bibliometrische Schwellenwerte in Scopus und Web of Science – damit ist ein englischer Beitrag im richtigen Journal keine Option.
Der Druck kollidiert nun mit einem neueren Problem. Ein KI-Humanizer für italienische Forschende existiert, weil korrektes, sorgfältiges Englisch als Zweitsprache genau die Art von Prosa ist, die KI-Detektoren für maschinelles Schreiben halten. Ihre Kollegin bzw. Ihr Kollege hat die Arbeit geleistet, jedes Wort verfasst – und wurde dennoch markiert.
Dieser Leitfaden geht es um Fairness, nicht um Verkleidung. Ziel ist es, Ihren eigenen, mit KI unterstützten Entwurf zu humanisieren, Ihre Bedeutung und Zitationen intakt zu halten und anschließend Ihre KI-Nutzung so offenzulegen, wie es Ihre Institution und Ihr Journal verlangen.
Ein umanizzatore di testo IA für italienische Forschende, die in englischer Sprache publizieren
Unser KI-Textumanizer hilft italienischen Forschenden dabei, auf Englisch zu publizieren, ohne dass eine korrekte Schreibweise als von einer Maschine generierter Text verwechselt wird. Er bewahrt die Bedeutung, die technische Terminologie und die Zitationen und variiert Rhythmus sowie lexikalische Entscheidungen.
Ganz einfach: Sie schreiben die Wissenschaft, und das Tool glättet das statistische Profil, das dafür sorgt, dass nicht-muttersprachliche Standardprosa wie synthetischer Text wirkt. Nichts an Ihrer Argumentation, Ihren Daten oder Ihren Referenzen verändert sich. Was sich ändert, ist die gleichmäßige, vorhersehbare Kadenz, die manche Detektoren als maschinelles Signal interpretieren.
Entwurf auf Italienisch? Der Humanizer erkennt ihn und schreibt ihn direkt um
Sie können einen italienischen Entwurf humanisieren, ohne ihn zunächst ins Englische zu übersetzen. Fügen Sie Ihren Text ein, und ProofreaderPro erkennt die Sprache automatisch; anschließend wird er über ein für Italienisch sensibilisiertes Modell geleitet, das Akzente, Terminologie und Zitationen an Ort und Stelle belässt. Als umanizzatore di testo IA variiert er den Rhythmus Ihrer italienischen Prosa, während jede Feststellung und jede Referenz erhalten bleibt. Die automatische Erkennung erstreckt sich über mehr als sechzig Sprachen, sodass Italienisch als Italienisch behandelt wird – statt in englische Fassung umgeformt zu werden.
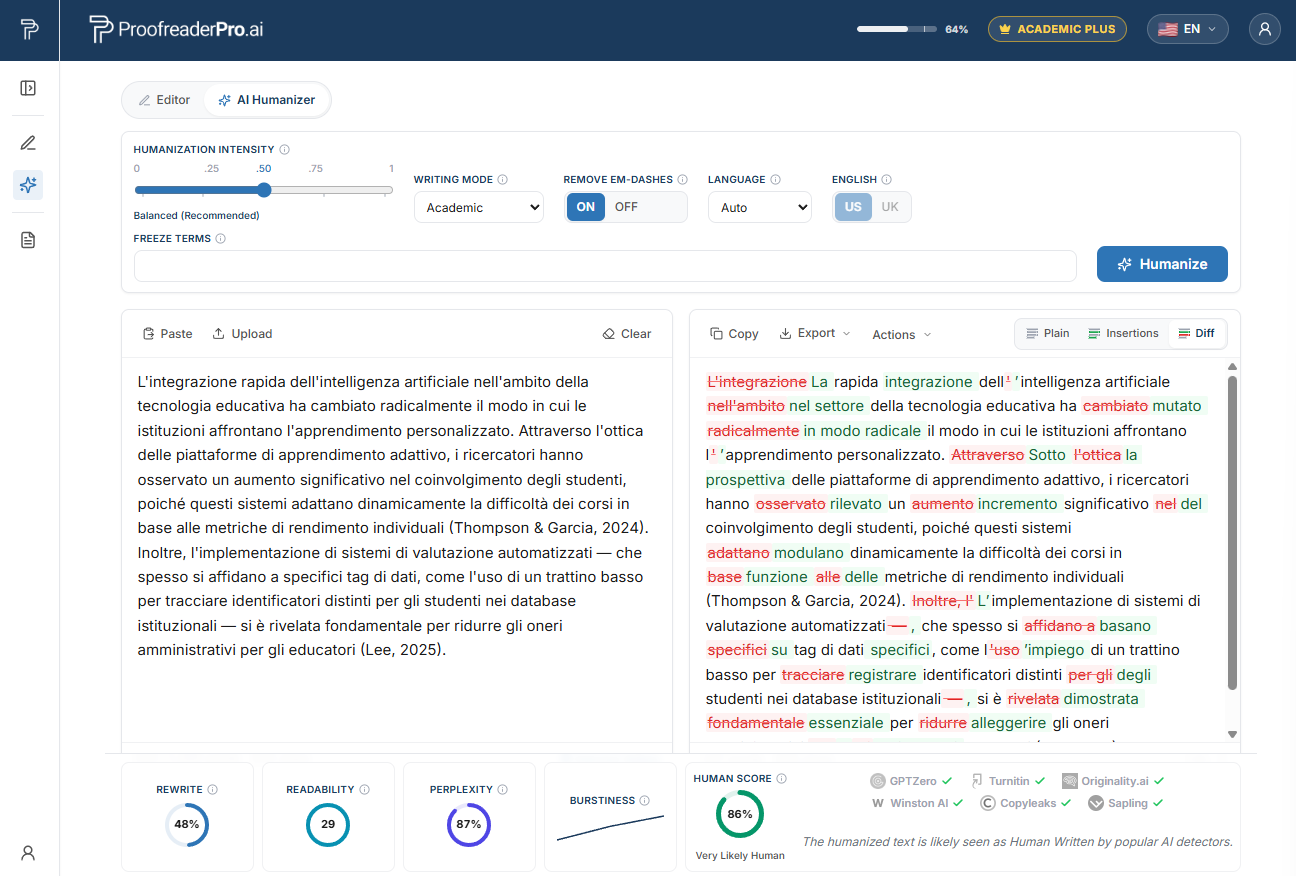
Der ProofreaderPro AI Humanizer beim Umschreiben italienischer wissenschaftlicher Texte. Der Unterschied zwischen „vorher“ und „nachher“ behält Bedeutung und Zitationen bei, und die Detektor-Checks bestätigen eine natürliche, menschliche Leseweise.
Warum italienische Forschende von KI-Detektoren markiert werden
2023 veröffentlichte ein Stanford-Team unter Leitung von Liang und Kolleginnen und Kollegen eine Studie im Cell-Press-Journal Patterns mit einem deutlichen Titel: GPT-Detektoren sind gegenüber Autorinnen und Autoren mit nicht-muttersprachlichem Englisch voreingenommen. Sie ließen von Menschen geschriebene TOEFL-Aufsätze über sieben weit verbreitete Detektoren laufen.
Das Ergebnis sollte alle beunruhigen, die in einer Zweitsprache publizieren. Im Durchschnitt wurden etwa 61% der nicht-muttersprachlichen Aufsätze als KI markiert – im Vergleich zu rund 5% bei muttersprachlichen Schreibenden. Fast jede bzw. jeder Fünfte, also etwa 19,8%, wurde von jedem Detektor einstimmig markiert. Jeder dieser Aufsätze stammte von einer realen Person.
Der Mechanismus heißt „Perplexität“. Detektoren messen, wie überraschend jede Wortwahl für ein Sprachmodell ist. Sorgfältige Autorinnen und Autoren, die Englisch als Zweitsprache schreiben, greifen auf gebräuchliche Wörter und standardisierte, vorhersehbare Formulierungen zurück – das erzeugt eine geringe Perplexität und liest sich wie maschineller Text. Die Gewohnheiten, die Ihr Englisch klar machen, sind dieselben Gewohnheiten, die diese Tools darauf trainiert wurden, zu bestrafen. Wir gehen in warum KI-Detektoren nicht-muttersprachliches Schreiben markieren noch genauer darauf ein.
Die italienischsprachigen Muster als Ursache für fälschliche Markierungen
Keines der folgenden Muster ist ein Fehler. Es sind die sorgfältigen, lehrbuchartigen Konstruktionen, zu denen eine italienische Wissenschaftlerin bzw. ein italienischer Wissenschaftler greift – und gerade diese sehr regelmäßige Struktur ist es, was ein Detektor als geringe Perplexität erkennt.
Lange hypotaktische Sätze. Der italienische akademische Stil bevorzugt lange Perioden mit mehreren verschachtelten Nebensätzen. Ins Englische übertragen bleiben sie zwar grammatikalisch, werden aber dichter, und ihr gleichmäßiger, überqualifizierter Rhythmus wirkt für ein Modell vorhersehbar.
Artikel mit abstrakten Substantiven. Zu schreiben „die Natur“, „die Wissenschaft“ oder „die Gesellschaft“, wobei Englisch typischerweise den Artikel weglässt, ist eine direkte und konsequente Übertragung aus dem Italienischen. Genau diese Konstanz ist das Signal, das Detektoren mit einer niedrigen Bewertung honorieren.
Präpositionstransfer. „Depend from“ statt „dipendere da“ oder „on the basis of“ statt „based on“ sind systematische, regelgeleitete Entscheidungen. Systematische Entscheidungen sind definitionsgemäß mit niedriger Perplexität verbunden.
Nominalisierung und latinisierte Diktion. Starke Nominalphrasen wie „die Realisierung der Analyse“ sowie eine beständige Präferenz für latinisierte Wortschätze sind ein Standard für den formellen Stil. Genau das markieren diese Tools.
„Calqued“ Konnektoren. Häufige satzanfängliche Konnektoren wie „Moreover“, „Furthermore“ und „In fact“, die aus italienischen Diskursmarkern gespiegelt werden, fügen eine regelmäßige, repetitive Kadenz hinzu, die wie „maschinell glatt“ wirkt.
False friends. „Attualmente“ wird im Englischen in Richtung „actually“ statt „currently“ geschoben, oder „eventualmente“ in Richtung „eventually“ statt „possibly“ – das sind Korrekturen, die eine sorgfältige Schreibweise zugunsten des standardmäßigsten und damit am ähnlichsten wirkenden Wortes vornimmt. Das standardmäßigste Wort ist zugleich das am wenigsten überraschende.
Italiens Kontext zur KI-Detektion und zu Turnitin
Italienische Abschlussarbeiten und Manuskripte werden routinemäßig auf Textähnlichkeit geprüft, am häufigsten mit Turnitin oder iThenticate. Diese Tools machen zunehmend KI-Indikatoren neben dem vertrauten Ähnlichkeitswert sichtbar. Ein Ähnlichkeitsreport ist an Promotionsschulen und in redaktionellen Arbeitsabläufen gängige Praxis und sagt für sich genommen nichts über Ihre Integrität.
Zwei Punkte lohnt es sich, im Blick zu behalten. Erstens: Ein KI-Indikator ist eine Behauptung, kein Urteil. Turnitin selbst unterdrückt Werte im Bereich von 1 bis 19% und warnt, dass diese Zahl nicht allein über einen Integritätsfall entscheiden sollte. Mehrere Universitäten, darunter Vanderbilt, Michigan State und UT Austin, deaktivierten den KI-Detektor vollständig mit der Begründung von False Positives und einer Benachteiligung nicht-muttersprachlicher Schreibender.
Zweitens: Die Richtung der Entwicklung in Italien, wie andernorts, geht hin zur Offenlegung. Geldgeber und Journals fordern Sie zunehmend auf anzugeben, wo und wie Sie KI eingesetzt haben. Diese Erwartung ist Ihr Schutz: Vollständige Offenlegung – nicht ein makelloser Detektorwert – ist das, was Sie innerhalb der Regeln hält.
Schützen Sie Ihr eigenes Schreiben vor einem Fehlalarm
Machen Sie Ihren KI-gestützten Entwurf in wenigen Minuten menschlicher, behalten Sie jede Quellenangabe bei, und legen Sie dann offen. Für sorgfältiges akademisches Englisch von Nicht-Muttersprachlern entwickelt.
Testen Sie den Humanizer kostenlosTop-Universitäten in Italien und wo KI-Checks auftauchen
Die oben beschriebene Prüfung findet in ganz Italiens führenden Institutionen statt. Promotionsschulen und Redaktionseinrichtungen dieser Universitäten lassen Abschlussarbeiten und Manuskripte über Ähnlichkeitschecks laufen und gewichten zunehmend auch KI-Indikatoren:
- Sapienza Università di Roma, in Rom
- Università di Bologna (Alma Mater Studiorum), in Bologna
- Politecnico di Milano und Università degli Studi di Milano (Statale), in Mailand
- Università degli Studi di Padova, in Padua
- Università degli Studi di Napoli Federico II, in Neapel
- Politecnico di Torino und Università degli Studi di Torino, in Turin
- Università di Pisa, Scuola Normale Superiore, und Scuola Superiore Sant'Anna, in Pisa
- Università degli Studi di Firenze, in Florenz
- Università degli Studi di Trento, in Trient
- Università Cattolica del Sacro Cuore, in Mailand
An jeder dieser Einrichtungen ist eine Markierung der Start eines Gesprächs über Ihre Methoden – nicht das Ende als Urteil über Ihre Ehrlichkeit. Zu wissen, dass diese Checks Routine sind, ist ein Grund zur Vorbereitung, nicht zur Panik.
So funktioniert der KI-Humanizer für italienische Forschende
Hier ist der Ablauf – und die Reihenfolge ist entscheidend.
Zuerst: Formulieren Sie Ihren Argumentationsentwurf. Schreiben Sie auf Italienisch, wenn dort Ihr Denken am klarsten ist; übersetzen Sie es dann oder verfassen Sie direkt auf Englisch. In beiden Fällen stammen die Ideen und die Daten von Ihnen.
Zweitens: Korrigieren Sie die Grammatik. Beheben Sie die „false friends“, die Präpositionen und die Artikelrutscher, sodass die Sprache sauber ist, bevor etwas anderes daran ansetzt. Unsere Korrektur-Tools sind genau dafür gebaut, und Sie können den Schwester-Workflow in KI-Korrektur für italienische Akademikerinnen und Akademiker sehen.
Drittens: Humanisieren Sie Ihre eigene Prosa. Lassen Sie Ihren mit KI unterstützten Entwurf über den KI-Textumanizer laufen. Er variiert Rhythmus und Wortwahl und entfernt die repetitive, niedrig-perplexe Kadenz, die Detektoren aus dem Tritt bringt, während Bedeutung, technische Terminologie und Zitationen erhalten bleiben.
Der Humanizer wird gegen die wichtigsten Detektoren getestet. Er überarbeitet KI-Text in eine natürlichere menschliche Form, die sich bei Turnitin, Originality.ai und GPTZero als menschlich liest – und hält zugleich die Grammatikgenauigkeit bei wissenschaftlichen Texten hoch. Die Ergebnisse stammen aus Tests, nicht aus Versprechen. Wir versprechen nicht, irgendetwas zu umgehen, denn Detektoren retrainieren alle paar Monate.
Viertens: Legen Sie Ihre Nutzung offen. Geben Sie Ihre KI-Nutzung im Format an, das Ihre Institution und das Zieljournal verlangen. Dieser letzte Schritt unterscheidet faire Absicherung echter Arbeit von Verkleidung.
Dieser Beitrag ist ein Zwischenstopp in unserem multilingualen KI-Humanizer-Hub, der denselben Workflow für Forschende abdeckt, die aus anderen Erstsprachen schreiben. Wenn Ihr größerer Bedarf eher in vollständiger sprachlicher Bearbeitung liegt als in Fairness gegenüber Detektoren, starten Sie bei unserem globalen Hub für wissenschaftliches Editing.
Lokale Förderstellen, Journals und Erwartungen an die KI-Offenlegung
Italienische Forschungsförderung und -bewertung laufen über eine Handvoll Stellen, und jede einzelne erhöht die Einsatzhöhe dafür, wo Ihre Arbeit veröffentlicht wird.
Das MUR (Ministero dell'Università e della Ricerca) finanziert Universitäten und nationale Förderprogramme. PRIN (Progetti di Ricerca di Rilevante Interesse Nazionale) ist das wichtigste wettbewerbliche nationale Programm. Das CNR (Consiglio Nazionale delle Ricerche) ist die größte öffentliche Forschungseinrichtung des Landes. ANVUR organisiert sowohl die VQR-Bewertung als auch die ASN-Qualifikation und unterhält die Listen für Journals der Klasse A, die in den Geistes- und Sozialwissenschaften echtes Gewicht tragen.
Für die Platzierung bedeutet das: Scopus- und Web-of-Science-Indizierung sowie ANVUR-Klasse-A-Status in nicht-bibliometrischen Disziplinen. Manuskripte, die für diese Journals vorgesehen sind, werden mit Turnitin oder iThenticate geprüft, und eine wachsende Zahl von Journals und Förderern verlangt eine explizite Erklärung zur KI-Nutzung. Bereiten Sie diese Erklärung frühzeitig vor – und behandeln Sie einen Report, falls ein Detektor einmal saubere Arbeit markiert, als anfechtbares Beweismittel und nicht als Urteil. Ein finaler Durchgang über den KI-Textumanizer vor der Einreichung ermöglicht eine fairere Lesart für sorgfältige nicht-muttersprachliche Prosa, und Ihre Offenlegung hält den gesamten Prozess transparent.
Häufig gestellte Fragen
F: Ist die Nutzung eines KI-Humanizers für italienische Forschende eine Form des Betrugs?
Nein, nicht wenn Sie ihn für Ihre eigene Arbeit verwenden. Sie haben die Forschung verfasst; das Tool variiert lediglich Rhythmus und Wortwahl einer sorgfältigen nicht-muttersprachlichen Prosa, sodass sie weniger wahrscheinlich als maschineller Text fehlgelesen wird. Die Regel, die dabei Transparenz sicherstellt, ist die Offenlegung: Sie teilen weiterhin Ihrer Institution und dem Journal mit, wie Sie KI verwendet haben.
F: Wird der Humanizer meine Zitationen oder Fachbegriffe ändern?
Nein. Er bewahrt Ihre Referenzen, Ihre Daten und die Terminologie Ihrer Disziplin. Er zielt auf die niedrig-perplexe Kadenz, auf die Detektoren reagieren, nicht auf den Inhalt Ihrer Argumentation.
F: Können Sie garantieren, dass mein Paper Turnitin oder GPTZero besteht?
Nein – und seien Sie vorsichtig bei jedem Tool, das solche Garantien verspricht. In unserem Testing überarbeitet der Humanizer KI-Text in eine natürlichere menschliche Form. Das senkt das KI-Signal und verbessert die Chancen gegenüber anspruchsvollen Detektoren, aber Detektoren retrainieren ständig. Daher berichten wir getestete Ergebnisse statt Garantien.
F: Warum wird mein korrektes Englisch überhaupt markiert?
Weil Detektoren bewerten, wie vorhersehbar Ihre Wortwahl ist. Standardisierte, lehrbuchartige Konstruktionen von Italienisch ins Englische – vom Artikelgebrauch bis zur latinisierte Diktion – sind sehr vorhersehbar. Das wird als geringe Perplexität gelesen, die manche Tools als Zeichen für KI werten. Es handelt sich um eine dokumentierte Verzerrung gegenüber sorgfältigem Schreiben als Zweitsprache, nicht um ein Urteil über Ihre Arbeit.
F: Was soll ich tun, wenn ein Komitee oder ein Journal mein Schreiben markiert?
Bleiben Sie ruhig und behandeln Sie die Markierung als eine Behauptung, die es zu beantworten gilt – nicht als Urteil. Halten Sie Ihre Entwürfe und Notizen bereit, weisen Sie auf die dokumentierte Verzerrung gegenüber nicht-muttersprachlichen Schreibenden hin und teilen Sie Ihre Offenlegung zur KI-Nutzung. Ein Detektor-Score ist anfechtbares Beweismittel, niemals ein Beweis.
Sorgen Sie für eine fairere Lesbarkeit Ihres sorgfältigen akademischen Englisch von Nicht-Muttersprachlern. Bewahren Sie Bedeutung und Zitate, reduzieren Sie Fehlalarme zu KI, und legen Sie dann mit Sicherheit offen.

Moe ist ein NLP-Ingenieur mit einem PhD in der Verarbeitung natürlicher Sprache. Seine Forschung umfasst Computerlinguistik, Textanalyse und maschinelles Lernen und floss direkt in die Bearbeitungs- und Humanisierungsmodelle hinter ProofreaderPro ein. Er schreibt über den Teil des Prozesses, den die meisten Menschen nie sehen: wie ein Sprachmodell einen Satz liest, ihn bewertet und entscheidet, was geändert werden soll.


