
Bộ AI Humanizer cho nhà nghiên cứu Thụy Sĩ viết tiếng Anh
Bộ AI humanizer cho nhà nghiên cứu Thụy Sĩ. Giảm cảnh báo dương tính giả từ các công cụ phát hiện AI đối với tiếng Anh chịu ảnh hưởng của tiếng Đức và tiếng Pháp, đồng thời giữ nguyên ý nghĩa và trích dẫn, không che giấu sự thật và công bố một cách minh bạch.

Thụy Sĩ vận hành một trong những nền kinh tế nghiên cứu dày đặc nhất trên thế giới. Tính theo bình quân đầu người, ít quốc gia công bố nhiều hơn hoặc thu hút nhiều trích dẫn hơn, và hệ miền ETH nằm gần vị trí cao nhất trong hầu hết mọi bảng xếp hạng đáng quan tâm. Gần như toàn bộ công trình đó được xuất bản bằng tiếng Anh, bất kể ngôn ngữ mẹ đẻ của tác giả là tiếng Đức, tiếng Pháp, tiếng Ý hay tiếng Romansh.
Chính tại đây, một vấn đề hiện đại bắt đầu nảy sinh. Một AI humanizer dành cho nhà nghiên cứu Thụy Sĩ tồn tại bởi tiếng Anh chuẩn mực, được viết cẩn thận bởi người nói tiếng Đức hoặc tiếng Pháp, ngày càng bị các bộ phát hiện tự động hiểu nhầm là đầu ra của máy móc. Câu chữ là của con người. Phần mềm không đồng ý, và một sự bất đồng như vậy có thể làm chậm một bài nộp ngay cả trước khi bất kỳ người phản biện nào đọc qua một chữ.
Hãy hình dung một nghiên cứu sinh sau tiến sĩ tại Universität Bern đang soạn phần phương pháp bằng tiếng Anh rõ ràng, đúng kiểu giáo trình. Không sao chép. Không bịa đặt. Thế nhưng bộ phát hiện vẫn trả về một điểm số “AI-generated”, và bây giờ gánh nặng lại đè lên vai nhà nghiên cứu, phải chứng minh điều ngược lại. Hướng dẫn này nhằm khắc phục sự bất công đó một cách trung thực, mà không che giấu việc sử dụng AI thực sự.
KI-Text humanisieren: so publizieren Schweizer Forschende sicher auf Englisch
Công cụ humanizer của chúng tôi hỗ trợ các nhà nghiên cứu tại ETH, EPFL và mọi nơi ở giữa, giúp bản thảo tiếng Anh của họ tự nhiên hơn mà không làm mất ý nghĩa hay nguồn trích. Pour les chercheurs romands, l'objectif est identique: humaniser un texte IA tout en gardant le sens et les références intacts.
Nói thẳng ra, dù bạn viết bằng tiếng Đức chuẩn ở Zürich hay tiếng Pháp ở Lausanne, công cụ sẽ thay đổi nhịp điệu của tiếng Anh để văn phong tiếng Anh học thuật, được viết cẩn thận nhưng là ngôn ngữ thứ hai, ít có khả năng bị nhầm là sản phẩm của máy móc hơn. Thuật ngữ kỹ thuật và trích dẫn của bạn vẫn giữ nguyên đúng như bạn đặt, và lập luận bạn đã xây dựng vẫn là của bạn.
Soạn thảo bằng tiếng Đức, tiếng Pháp hay tiếng Ý? Humanizer nhận diện từng ngôn ngữ
Nghiên cứu ở Thụy Sĩ được viết bằng nhiều ngôn ngữ, và humanizer nhận diện bất kỳ ngôn ngữ nào bạn dán vào. Chỉ cần cung cấp tiếng Đức, tiếng Pháp hoặc tiếng Ý, ProofreaderPro sẽ tự động nhận diện ngôn ngữ, rồi chuyển văn bản qua một mô hình “có nhận thức ngôn ngữ” để giữ nguyên chính xác thuật ngữ và trích dẫn của bạn. Thông qua KI-Text humanisieren, bản thảo tiếng Đức của bạn được “humanize” dễ dàng như tiếng Anh, mà không cần dịch trước. Cơ chế nhận diện tự động tương tự mở rộng trên hơn sáu mươi ngôn ngữ, mỗi ngôn ngữ được viết lại theo đúng “sổ tay” ngữ vực riêng.
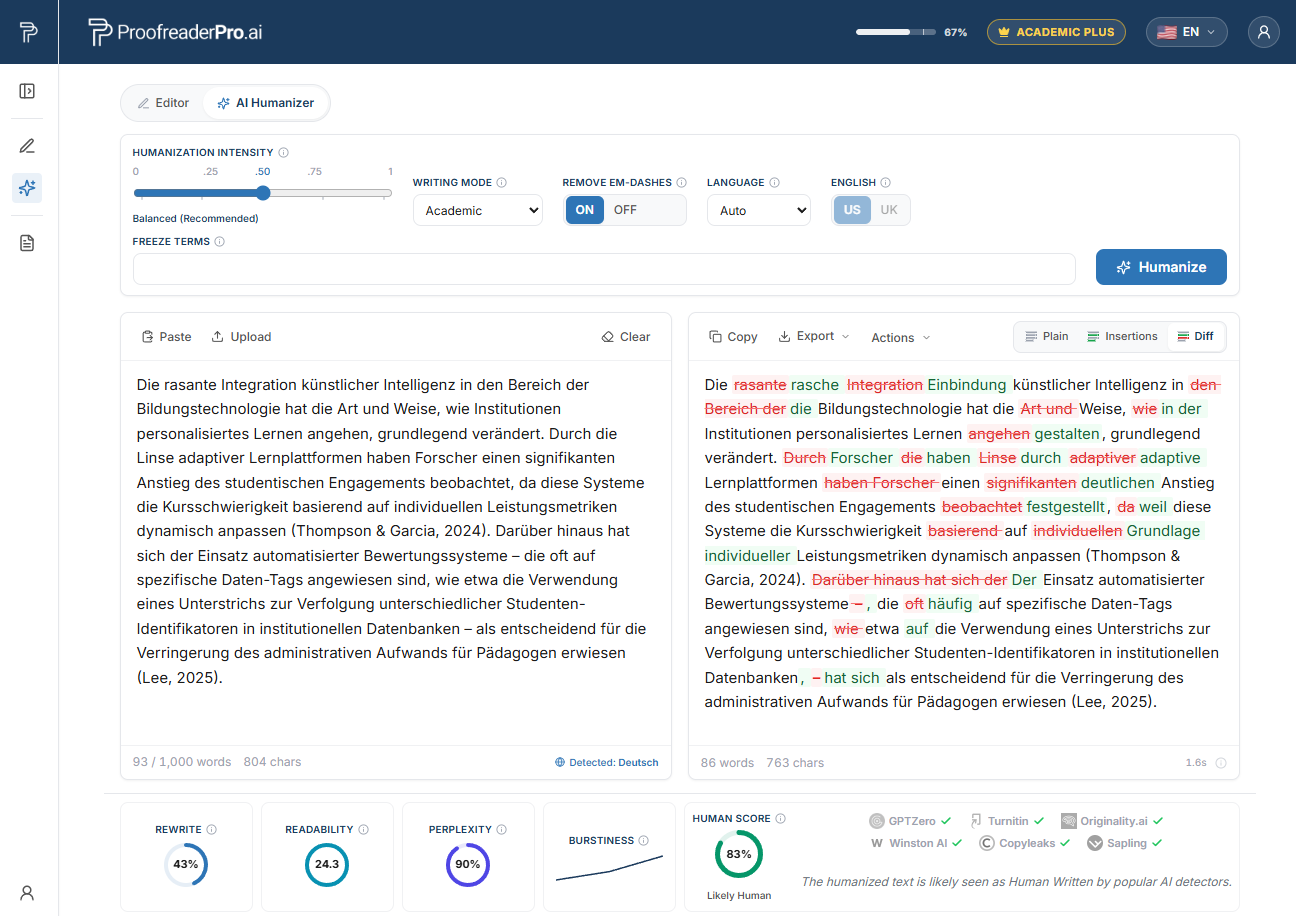
Bộ ProofreaderPro AI Humanizer viết lại văn bản học thuật tiếng Đức. Phần chênh lệch trước–sau (diff) giữ nguyên ý nghĩa và trích dẫn, còn các kiểm tra từ bộ phát hiện xác nhận văn phong tự nhiên, đúng kiểu đọc của con người.
Vì sao nhà nghiên cứu Thụy Sĩ bị bộ phát hiện AI gắn cờ
Bằng chứng rõ ràng nhất đến từ một nghiên cứu năm 2023 của Stanford do Liang và cộng sự thực hiện, được công bố trên tạp chí Patterns của Cell Press với tiêu đề “GPT detectors are biased against non-native English writers.” Nhóm tác giả đưa các bài luận TOEFL do con người viết vào bảy bộ phát hiện được dùng phổ biến, sau đó quan sát kết quả trả về.
Kết quả đáng lo ngại cho bất kỳ ai viết tiếng Anh như ngôn ngữ thứ hai hoặc thứ ba. Trung bình, khoảng 61% các bài viết không phải của người bản ngữ bị gắn cờ là AI, so với xấp xỉ 5% ở nhóm người viết bản ngữ. Gần một trong năm, tức khoảng 19,8%, bị mọi bộ phát hiện trong tập dữ liệu gắn cờ một cách đồng nhất. Tất cả những bài luận đó đều được viết bởi con người.
Vì sao điều này xảy ra? Phần lớn bộ phát hiện chấm một đại lượng gọi là “perplexity”, mức độ bất ngờ của từng từ tiếp theo đối với một mô hình ngôn ngữ. Những người viết sử dụng từ vựng phổ biến và cách diễn đạt chuẩn mực, dễ dự đoán thường tạo ra văn bản có độ perplexity thấp; và độ perplexity thấp chính là thứ các hệ thống này “đọc” như thể văn bản do máy viết. Những thói quen giúp tiếng Anh của người Thụy Sĩ trở nên rõ ràng và đúng chuẩn cũng chính là những thói quen khiến bộ phát hiện “vấp”. Chúng tôi giải thích cơ chế chi tiết hơn trong tại sao bộ phát hiện AI gắn cờ người viết không phải bản ngữ.
Những đặc điểm tiếng mẹ đẻ của người Đức và người Pháp đứng sau các cảnh báo sai
Tiếng Anh ở Thụy Sĩ mang dấu vết của ngôn ngữ mẹ đẻ người viết, và những dấu vết đó là đúng đắn, cẩn trọng, thuộc chuẩn mực. Đó chính là phần tàn nhẫn. Tính “chuẩn” là điều mà bộ phát hiện đọc như perplexity thấp, nên chính sự trôi chảy mà bạn dày công đạt được lại có thể trở thành bất lợi.
Người nói tiếng Đức thường “mang” vào các false friends (từ trông giống nhưng nghĩa khác) sao cho đúng về mặt ngữ pháp nhưng lại phẳng về mặt thống kê. “Aktuell” trở thành “actual” khi người viết muốn nói “hiện tại”; “eventuell” thành “eventually” khi ý nghĩa là “có khả năng”; “also” xuất hiện với nghĩa “so or thus”; “bekommen” trôi về “become” thay vì “receive”. Mỗi lựa chọn đều có chủ đích và nhất quán, và sự nhất quán đó bị đọc như thể có tính dự đoán.
Sau đó là cấu trúc câu. Trật tự từ trong tiếng Đức đẩy những cấu trúc như “Therefore is the effect stronger,” và thói quen của ngôn ngữ này dùng nhiều cụm danh từ ghép dài, cùng hiện tượng danh từ hoá (nominalisation), lại đi vào tiếng Anh dưới dạng câu chữ dày và gọn gàng, theo trật tự. Một người viết tiếng Đức cũng có thể chọn “since” trong khi tiếng Anh cần “for” để đánh dấu thời lượng. Không có gì trong số này là lỗi suy nghĩ. Đó chỉ là sự đều đặn, và sự đều đặn trông “cơ học” đối với phần mềm.
Người nói tiếng Pháp gặp các false friends riêng của họ. “Actuel” lẻn vào thay cho current, “éventuellement” thay cho possibly, “sensible” thay cho sensitive, và “important” đôi khi đứng thay cho large; một số người viết “assist to” khi họ thực ra muốn nói attend. Một lần nữa là sự cẩn thận và đúng chuẩn, đó là cả cái bẫy.
Văn phong học thuật tiếng Pháp cũng thường ưu tiên các câu dài dạng định kỳ (periodic sentences) với nhiều mệnh đề quan hệ xếp chồng, danh từ hoá dày đặc, tần suất cao của “which”, và các cụm kiểu “permit to” và “in the case where.” Người phản biện tiếng Anh đọc nó như văn phong dày. Bộ phát hiện lại coi độ “đều” đó là perplexity thấp. Văn bản do con người viết. Nhịp điệu của nó đơn giản là quá gọn gàng so với “gu” của máy móc.
Bảo vệ tiếng Anh cẩn trọng của quý vị khỏi một thông báo sai
Nhân hoá bản nháp được hỗ trợ bởi AI của chính quý vị, giữ nguyên mọi trích dẫn và thuật ngữ kỹ thuật, sau đó công bố việc sử dụng AI của quý vị một cách tự tin.
Thử Humanizer miễn phíBối cảnh phát hiện AI và Turnitin tại Thụy Sĩ
Khâu sàng lọc ở đây là thường quy. Luận văn và bài nộp tạp chí tại nhiều cơ sở ở Thụy Sĩ thường đi qua Turnitin hoặc iThenticate để kiểm tra mức độ tương đồng, và các chỉ báo AI ngày càng xuất hiện song song với các điểm số tương đồng đó. Một nhà nghiên cứu ở Basel hoặc Geneva nên hiểu rằng cuối cùng chắc chắn sẽ có một bước kiểm tra tự động nào đó được chạy.
Bầu không khí học thuật mang tính suy xét hơn là trừng phạt. ETH Zürich, EPFL và các trường đại học khác đã công bố hướng dẫn về generative-AI cho sinh viên và nhân sự, và hướng đi là minh bạch (disclosure) thay vì cấm đoán. Các nhà tài trợ và tạp chí ngày càng yêu cầu tác giả nêu rõ họ đã dùng công cụ AI ở đâu và như thế nào. Hãy xem điểm số từ bộ phát hiện như một tuyên bố mà bạn có thể phản hồi, chứ không phải một phán quyết bạn buộc phải chấp nhận.
Các trường đại học hàng đầu ở Thụy Sĩ và nơi xuất hiện các kiểm tra AI
Logic sàng lọc tương tự áp dụng xuyên suốt hệ thống Thụy Sĩ. Tất cả các cơ sở này đều kiểm tra luận văn và bản thảo về độ tương đồng, đồng thời ngày càng kiểm tra thêm các chỉ báo AI:
- ETH Zürich (Eidgenössische Technische Hochschule Zürich), ở Zürich
- EPFL (École polytechnique fédérale de Lausanne), ở Lausanne
- Universität Zürich (UZH), ở Zürich
- Université de Genève (UNIGE), ở Geneva
- Universität Basel, ở Basel
- Universität Bern, ở Bern
- Université de Lausanne (UNIL), ở Lausanne
- Université de Fribourg / Universität Freiburg, ở Fribourg
- Università della Svizzera italiana (USI), ở Lugano
- Universität St. Gallen (HSG), ở St. Gallen
- Universität Luzern, ở Lucerne
- Université de Neuchâtel, ở Neuchâtel
Trên dải phía bắc và phía đông nói tiếng Đức, cũng như phía tây nói tiếng Pháp, mô hình vẫn giữ nguyên. Tiếng Anh không phải bản ngữ được viết cẩn thận là chuẩn mực, và chính thứ tiếng Anh không phải bản ngữ viết cẩn thận đó lại là điều bị hiểu nhầm.
Cách AI humanizer cho nhà nghiên cứu Thụy Sĩ hoạt động
Dưới đây là quy trình “trung thực” đứng sau AI humanizer cho nhà nghiên cứu Thụy Sĩ, từng bước một. Bắt đầu từ nơi bạn viết tốt nhất. Nhiều nghiên cứu sinh soạn thảo bằng ngôn ngữ đầu, tiếng Đức hoặc tiếng Pháp, rồi mới dịch; những người khác viết trực tiếp bằng tiếng Anh với sự hỗ trợ của AI. Dù theo cách nào, bản thảo gốc là của bạn và nên vẫn giữ như vậy.
Tiếp theo, chỉnh ngữ pháp và thuật ngữ để khoa học được chính xác. Sau đó, chạy phần văn phong được hỗ trợ bởi AI của bạn qua humanizer. Công cụ sẽ thay đổi độ dài câu và lựa chọn từ, làm gián đoạn nhịp điệu lặp lại, và loại bỏ nhịp điệu “cơ học” cùng các dấu gạch dài lạc chỗ (em dashes) mà cả người phản biện lẫn bộ phát hiện đều nhận ra, đồng thời vẫn giữ nguyên ý nghĩa, vốn từ kỹ thuật và mọi trích dẫn của bạn. Bạn có thể thử humanizer miễn phí trên một phần văn bản trước khi quyết định chạy toàn bộ.
Bạn có thể kỳ vọng điều gì? Qua thử nghiệm của chính chúng tôi, humanizer làm giảm đáng kể việc các bộ phát hiện lớn; Turnitin, Originality.ai, GPTZero và các bộ khác, gắn nhầm tiếng Anh không phải bản ngữ viết cẩn thận, chuẩn mực, trong khi vẫn bảo toàn ý nghĩa học thuật. Chúng tôi mô tả điều đó như những gì chúng tôi đã quan sát được, không phải như một lời hứa. Các bộ phát hiện được huấn luyện lại vài tháng một lần, và không có công cụ trung thực nào có thể hứa rằng sẽ “không thể phát hiện” 100%.
Bước cuối cùng là không thể bỏ qua: công bố (disclose). Nêu rõ việc dùng AI theo đúng định dạng mà cơ sở của bạn và tạp chí mục tiêu yêu cầu. Việc humanize bài viết của chính bạn rồi công bố nó là sự kết hợp giúp bạn tuân thủ các quy tắc liêm chính, đồng thời bảo vệ công việc thật khỏi bị gắn cờ nhầm. Công cụ nằm trong cụm trung tâm biên tập học thuật toàn cầu của chúng tôi, và là một nhánh của trung tâm multilingual AI humanizer bao phủ hàng chục ngôn ngữ.
Các cơ quan tài trợ địa phương, tạp chí và kỳ vọng về công bố việc dùng AI
Nghiên cứu ở Thụy Sĩ vận hành trên những “cỗ máy” quen thuộc. SNSF (Swiss National Science Foundation; Schweizerischer Nationalfonds, SNF; Fonds national suisse, FNS) là nhà tài trợ công chính, Innosuisse hỗ trợ đổi mới và các dự án ứng dụng, và các nhóm ở Thụy Sĩ giành được một phần đáng kể trong các khoản tài trợ của Hội đồng Nghiên cứu Châu Âu. SNSF cũng quy định truy cập mở, nên công trình của bạn được thiết kế để được đọc rộng rãi nhất có thể.
Thực tế xuất bản đó định hình nơi bạn nộp bài. Các nghiên cứu sinh ở đây nhắm tới các tạp chí được lập chỉ mục trên Web of Science và Scopus, và là những người áp dụng sớm mô hình truy cập mở theo Plan S. Việc sàng lọc độ tương đồng bằng Turnitin hoặc iThenticate cũng là chuẩn ở giai đoạn nộp bài, và đó là thêm một lý do để tiếng Anh của bạn được đọc tự nhiên.
Kỳ vọng về công bố đang tăng cùng nhịp với các công cụ. Các nhà tài trợ và tạp chí ngày càng yêu cầu tác giả nêu rõ cách họ đã sử dụng AI, vì vậy hãy lưu một hồ sơ ngắn gọn nhưng trung thực về bạn đã dùng gì và ở đâu. Nếu bạn cần câu chữ làm sẵn, các mẫu câu công bố việc dùng AI của chúng tôi sẽ cung cấp điểm khởi đầu. Và nếu một cảnh báo vẫn xảy ra với bài viết của con người, hãy coi đó là việc có thể tranh luận và chuẩn bị phản hồi bình tĩnh, dựa trên bằng chứng, thay vì viết lại trong hoảng loạn.
Câu hỏi thường gặp
Q: Sử dụng AI humanizer cho nhà nghiên cứu Thụy Sĩ có bị coi là gian lận không?
Không, nếu bạn dùng một cách trung thực. Bạn đang humanize bản thảo do AI hỗ trợ của chính bạn để bảo vệ tiếng Anh cẩn thận khỏi bị gắn cờ nhầm, chứ không phải bịa đặt kết quả hay che giấu phương pháp. Quy tắc giúp bạn an toàn nằm ở chỗ công bố: nêu rõ việc bạn dùng AI theo đúng cách mà cơ sở và tạp chí của bạn yêu cầu.
Q: Humanizer có thay đổi trích dẫn hoặc thuật ngữ kỹ thuật của tôi không?
Không. Công cụ giữ nguyên các tham chiếu, số liệu và thuật ngữ miền (domain terminology) của bạn, đồng thời chỉ thay đổi nhịp điệu và lựa chọn từ để văn bản đọc tự nhiên hơn. Phương pháp của bạn vẫn là phương pháp của bạn, và phần thư mục được giữ nguyên.
Q: Bạn có thể đảm bảo bài viết của tôi sẽ vượt qua bộ phát hiện AI không?
Không, và hãy thận trọng với bất kỳ ai tuyên bố điều ngược lại. Các bộ phát hiện được huấn luyện lại thường xuyên, nên không có công cụ trung thực nào có thể hứa 100% sẽ không thể bị phát hiện. Điều chúng tôi có thể nói là, trong thử nghiệm của mình, văn viết đã được humanize ít bị gắn nhầm hơn rất nhiều, trong khi ý nghĩa vẫn được bảo toàn.
Q: Nó có hoạt động cho cả người nói tiếng Đức và người nói tiếng Pháp không?
Có. Humanizer có nhận thức về ngôn ngữ và hỗ trợ hơn 60 ngôn ngữ, vì vậy dù ngôn ngữ đầu tiên của bạn là tiếng Đức, tiếng Pháp, tiếng Ý hay tiếng Romansh, công cụ vẫn hoạt động dựa trên bản thảo tiếng Anh của bạn và tôn trọng cấu trúc bạn đã định.
Q: Tôi tự viết bài bằng tiếng Anh cẩn thận. Vì sao lại bị gắn cờ?
Vì các bộ phát hiện chấm độ perplexity, và tiếng Anh cẩn thận, đúng chuẩn ở trình độ ngôn ngữ thứ hai vốn dĩ có độ perplexity thấp. Các phát hiện của Stanford cho thấy các bài viết của con người bị gắn cờ với tỷ lệ cao chỉ vì việc bị đọc như thể mang tính dự đoán. Một cờ gắn nhầm chỉ là đoán định thống kê về phong cách của bạn, không phải bằng chứng về hành vi sai phạm.
Nhân hoá theo ngữ cảnh ngôn ngữ dành cho các nhà nghiên cứu tại Thụy Sĩ viết bằng tiếng Anh: nó vẫn bảo toàn ý nghĩa, thuật ngữ và trích dẫn, đồng thời làm mượt nhịp điệu đều mà các công cụ phát hiện thường đọc sai.

Moe là một kỹ sư NLP với PhD trong xử lý ngôn ngữ tự nhiên. Nghiên cứu của ông bao gồm ngôn ngữ học tính toán, phân tích văn bản và học máy, đồng thời được đưa trực tiếp vào các mô hình chỉnh sửa và nhân bản hóa đằng sau ProofreaderPro. Anh ấy viết về một phần của quá trình mà hầu hết mọi người không bao giờ thấy: cách một mô hình ngôn ngữ đọc một câu, chấm điểm và quyết định những gì cần thay đổi.


