
ИИ-уманизатор для итальянских исследователей, пишущих на английском
ИИ-уманизатор для итальянских исследователей. Снижает число ложных срабатываний ИИ-детекторов для английского, на который повлиял итальянский язык: сохраняет смысл и цитирования, честно раскрывает факт использования ИИ.

Италия входит в число восьми—десяти ведущих стран мира по объёму научных публикаций, однако почти ни одна из этих работ не доходит до читателей на итальянском языке. Здесь академики формулируют мысли и пишут на одном языке, а публикуют — на другом: итальянская исследовательская карьера проходит через индексируемые англоязычные журналы. Оценка качества исследований VQR и национальная квалификация ASN для профессуры опираются на библиометрические пороги в Scopus и Web of Science, поэтому англоязычная статья в «правильном» журнале — не опция.
Теперь этот прессинг сталкивается с более новой проблемой. ИИ-уманизатор для итальянских исследователей существует потому, что аккуратный, корректный английский как второй язык — это именно тот тип текста, который ИИ-детекторы ошибочно принимают за машинное письмо. Коллега проделал работу, написал каждое слово, и всё равно получил пометку.
Это руководство про справедливость, а не про маскировку. Цель — «уманизировать» ваш собственный черновик с помощью ИИ, сохранив смысл и цитирования, а затем раскрыть использование ИИ так, как требуют ваш университет и целевой журнал.
Уманизатор ИИ-текста для итальянских исследователей, публикующих на английском
Наш ИИ-у manizzatore di testo IA помогает итальянским исследователям публиковать материалы на английском, не допуская, чтобы корректное письмо воспринималось как сгенерированный машиной текст. Он сохраняет смысл, техническую терминологию и цитирования, а также варьирует ритм и лексический выбор.
Проще говоря: наука пишется вами, а инструмент сглаживает «статистический отпечаток», из‑за которого стандартная речь неносителей читается как синтетическая. Ничего не меняется в вашем аргументе, ваших данных или ваших ссылках. Меняется лишь ровная, предсказуемая каденция, которую некоторые детекторы принимают за машинный «сигнатурный» признак.
Черновик на итальянском? Уманизатор определяет и переписывает напрямую
Вы можете «уманизировать» итальянский черновик без предварительного перевода на английский. Вставьте текст: ProofreaderPro автоматически определит язык, затем пропустит его через модель, учитывающую итальянский язык. Как umanizzatore di testo IA он варьирует ритм вашего итальянского письма, сохраняя каждую находку и каждую ссылку. Автоматическое определение охватывает более шестидесяти языков, поэтому итальянский обрабатывается именно как итальянский, а не «перекраивается» в английский.
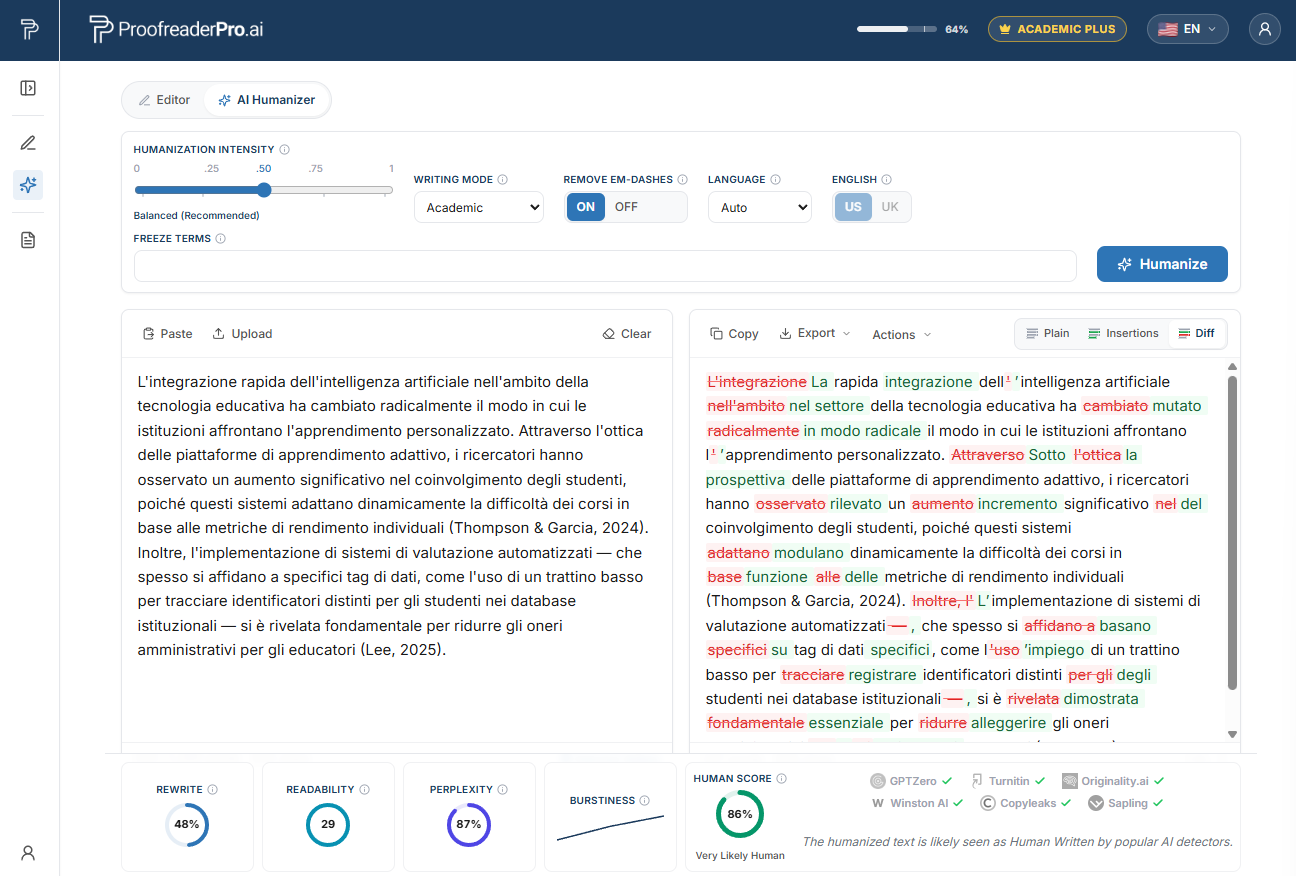
ИИ-уманизатор ProofreaderPro переписывает итальянский академический текст. Разница «до и после» сохраняет ваш смысл и цитирования, а проверки детектора подтверждают естественное, человеческое чтение.
Почему итальянских исследователей помечают ИИ-детекторы
В 2023 году команда из Стэнфорда под руководством Ляна и соавторов опубликовала исследование в журнале Cell Press Patterns с прямолинейным названием: GPT detectors are biased against non-native English writers. Они пропустили эссе TOEFL, написанные людьми, через семь широко используемых детекторов.
Результат должен насторожить всех, кто публикуется на втором языке. В среднем около 61% не носительских эссе было помечено как ИИ — против примерно 5% у носителей. Почти каждое пятое, то есть около 19,8%, было помечено единогласно всеми детекторами. И каждое из этих эссе написал человек.
Механизм называется перплексностью. Детекторы оценивают, насколько «неожиданным» выбор каждого слова выглядит для языковой модели. Осторожные авторы со вторым языком выбирают распространённые слова и стандартные, предсказуемые формулировки — это даёт низкую перплексность и воспринимается как машинный текст. Привычки, которые делают ваш английский ясным, — это те же привычки, которым эти инструменты обучались «наказывать». Мы разберём это подробнее в why AI detectors flag non-native writing.
Итальянские модели первого языка, лежащие в основе ложных пометок
Ни одна из моделей ниже не является ошибкой. Это аккуратные, «учебниковые» конструкции, к которым обращается итальянский учёный, и именно их чрезмерная регулярность детектор читает как низкую перплексность.
Длинные гипотаксические предложения. В итальянском академическом стиле предпочитаются длинные периоды с несколькими вложенными придаточными. При переносе в английский они остаются грамматически корректными, но становятся более плотными, а их ровный, «переквалифицированный» ритм выглядит предсказуемым для модели.
Артикли с абстрактными существительными. Написание «природы», «науки» или «общества», где в английском обычно опускается артикль, является прямым и последовательным переносом из итальянского. Именно эта последовательность — тот сигнал, за который детекторы «вознаграждают» низкий балл.
Перенос предлогов. depend from вместо dipendere da или on the basis of вместо based on — это систематические, подчинённые правилам выборы. Систематические выборы по определению дают низкую перплексность.
Номинализация и латинизированная лексика. Тяжеловесные именные группы вроде realization of the analysis и устойчивое предпочтение латинизированной лексики — стандартный формальный регистр. «Формально» и «стандартно» — это ровно то, что эти инструменты помечают.
Калькированные связки. Частые вводные Moreover, Furthermore и In fact, отражающие итальянские маркеры дискурса, добавляют регулярную повторяющуюся каденцию, которая читается как «машинно-гладкая».
Ложные друзья. Attualmente (настоящее время) — в сторону actually rather than currently, или eventualmente — в сторону eventually rather than possibly: такие правки аккуратный автор вносит к самым «стандартно выглядящим» словам. Самое стандартное слово — также и наименее неожиданное.
Контекст ИИ-детектирования в Италии и Turnitin
Итальянские диссертации и рукописи регулярно проверяются на текстовое сходство — чаще всего с помощью Turnitin или iThenticate; при этом инструменты всё чаще выявляют ИИ-индикаторы вместе с привычным показателем сходства. Отчёт о сходстве — нормальная практика в докторантских школах и редакционных процессах, и сам по себе он не говорит ничего о вашей добросовестности.
Есть две вещи, которые стоит держать в перспективе. Во‑первых, ИИ-индикатор — это утверждение, а не приговор. Сам Turnitin подавляет баллы в диапазоне 1–19% и предупреждает, что его число не должно решать дело о целостности само по себе. Ряд университетов, включая Vanderbilt, Michigan State и UT Austin, отключили ИИ-детектор полностью, ссылаясь на ложные срабатывания и предвзятость против авторов-неносителей.
Во‑вторых, направление движения в Италии, как и в других странах, — в сторону раскрытия информации. Финансирующие организации и журналы всё чаще просят указать, где и как вы использовали ИИ. Это ожидание — ваша защита: полное раскрытие, а не «безупречный» балл детектора, — то, что удерживает вас в рамках правил.
Защитите свое собственное письмо от ложного обвинения
Сделайте свой черновик, созданный с помощью ИИ, более естественным за несколько минут, сохраните каждую ссылку, затем укажите использование ИИ. Создано для внимательного академического английского у тех, для кого он не является родным.
Попробуйте бесплатный HumanizerТоп-итальянские университеты и где встречаются проверки ИИ
Описанная выше проверка проводится во многих ведущих институтах Италии. Докторантские школы и редакционные офисы в этих университетах пропускают диссертации и рукописи через проверки сходства, а всё чаще учитывают и ИИ-индикаторы:
- Sapienza Università di Roma, в Риме
- Università di Bologna (Alma Mater Studiorum), в Болонье
- Politecnico di Milano и Università degli Studi di Milano (Statale), в Милане
- Università degli Studi di Padova, в Падуе
- Università degli Studi di Napoli Federico II, в Неаполе
- Politecnico di Torino и Università degli Studi di Torino, в Турине
- Università di Pisa, Scuola Normale Superiore, и Scuola Superiore Sant'Anna, в Пизе
- Università degli Studi di Firenze, во Флоренции
- Università degli Studi di Trento, в Тренто
- Università Cattolica del Sacro Cuore, в Милане
В любой из этих организаций флажок — это начало разговора о ваших методах, а не вывод о вашей честности. Понимание того, что такие проверки рутинны, — это причина подготовиться, а не паниковать.
Как работает ИИ-уманизатор для итальянских исследователей
Ниже — рабочий процесс, и важен порядок шагов.
Сначала сформулируйте ваш аргумент. Пишите по‑итальянски — если именно там ваше мышление наиболее точное; затем переведите, или сразу оформляйте черновик на английском. В любом случае идеи и данные принадлежат вам.
Во‑вторых, исправьте грамматику. Уберите «ложных друзей», поправьте предлоги и соскальзывания с артиклями, чтобы язык был вычищен прежде, чем что‑то ещё коснётся текста. Наши инструменты редакторской проверки рассчитаны именно на это, и вы можете увидеть связанный рабочий процесс в AI proofreading for Italian academics.
В‑третьих, «уманизируйте» ваш собственный текст. Пропустите ваш черновик с поддержкой ИИ через AI text humanizer. Он варьирует ритм и выбор слов и убирает повторяющуюся каденцию с низкой перплексностью, которая «спотыкает» детекторы, сохраняя при этом ваш смысл, техническую терминологию и цитирования.
Уманизатор протестирован на основных детекторах: он перестраивает ИИ-текст в более естественную «человеческую» форму, которая читается как человеческая на Turnitin, Originality.ai и GPTZero, при этом сохраняя высокую точность грамматики в академическом тексте. Результаты основаны на тестировании, а не на обещаниях. Мы не обещаем обход чего‑либо, поскольку детекторы переобучаются каждые несколько месяцев.
В‑четвёртых, раскрывайте. Укажите использование ИИ в формате, который требуют ваш университет и целевой журнал. Этот финальный шаг и отделяет справедливую защиту реальной работы от маскировки.
Этот пост — одна остановка в нашем multilingual AI humanizer hub: там представлен тот же рабочий процесс для исследователей, пишущих на других языках как на первом. Если ваша более крупная потребность — полноценное языковое редактирование, а не справедливость в контексте детекторов, начните с нашего global academic editing hub.
Локальные структуры финансирования, журналы и ожидания относительно раскрытия использования ИИ
Итальянское финансирование и оценка исследований строятся вокруг нескольких организаций, и каждая из них повышает ставки в том, где публикуется ваша работа.
MUR (Ministero dell'Università e della Ricerca) финансирует университеты и национальные гранты. PRIN (Progetti di Ricerca di Rilevante Interesse Nazionale) — основная конкурентная национальная программа. CNR (Consiglio Nazionale delle Ricerche) — крупнейшая в стране публичная исследовательская организация. ANVUR проводит оценку VQR и квалификацию ASN и поддерживает списки журналов класса A, которые реально имеют вес в гуманитарных и социальных науках.
Для размещения это означает индексирование в Scopus и Web of Science, а также статус ANVUR класса A в областях, не являющихся библиометрическими. Рукописи, ориентированные на эти журналы, проверяются с помощью Turnitin или iThenticate, и всё большее число журналов и фондов просит указать явное заявление об использовании ИИ. Подготовьте это заявление заранее, и если детектор когда‑нибудь пометит чистую работу, воспринимайте отчёт как оспариваемое доказательство, а не как решение. Финальный проход через AI text humanizer перед подачей даёт внимательному письму неносителя более справедливое прочтение, а ваше раскрытие делает весь процесс прозрачным.
Часто задаваемые вопросы
Q: Является ли использование ИИ-уманизатора для итальянских исследователей формой мошенничества?
Нет, если вы используете его в отношении своей собственной работы. Вы написали исследование; инструмент лишь меняет ритм и выбор слов в аккуратной речи неносителя, чтобы текст с меньшей вероятностью был ошибочно принят за машинное письмо. Правило, обеспечивающее прозрачность, — раскрытие: вы по‑прежнему сообщаете своему университету и журналу, как вы использовали ИИ.
Q: Изменит ли уманизатор мои цитирования или технические термины?
Нет. Он сохраняет ваши ссылки, ваши данные и терминологию вашей дисциплины. Он нацелен на каденцию с низкой перплексностью, на которую реагируют детекторы, а не на содержание вашего аргумента.
Q: Можете ли вы гарантировать, что моя статья пройдёт Turnitin или GPTZero?
Нет, и будьте осторожны с любым инструментом, который обещает это. В наших тестах уманизатор переписывает ИИ-текст в более естественную «человеческую» форму, снижая ИИ-сигнал и повышая шансы против сложных детекторов, но детекторы постоянно переобучаются, поэтому мы сообщаем результаты тестирования, а не гарантии.
Q: Почему мой корректный английский вообще получает пометку?
Потому что детекторы оценивают, насколько предсказуемым выглядит ваш выбор слов. Стандартные, «учебниковые» конструкции итальянский → английский — от использования артиклей до латинизированной лексики — крайне предсказуемы. Это читается как низкая перплексность, а некоторые инструменты трактуют это как признак ИИ. Это документированная предвзятость к аккуратному письму со вторым языком, а не оценка вашей работы.
Q: Что мне делать, если комитет или журнал пометит моё письмо?
Сохраняйте спокойствие и воспринимайте пометку как запрос на ответ, а не как приговор. Держите у себя черновики и заметки, указывайте на документированную предвзятость по отношению к авторам-неносителям и делитесь раскрытием об использовании ИИ. Оценка детектора — это оспариваемое доказательство, но никогда не окончательное доказательство.
Дайте вашему внимательному английскому, для которого он не родной, более справедливое прочтение. Сохраняйте смысл и ссылки, уменьшайте количество ложных отметок об ИИ, затем укажите использование с уверенностью.

Мо — инженер NLP с PhD в области обработки естественного языка. Его исследования охватывают компьютерную лингвистику, анализ текста и машинное обучение, и они напрямую используются в моделях редактирования и гуманизации, лежащих в основе ProofreaderPro. Он пишет о той части процесса, которую большинство людей никогда не видит: о том, как языковая модель читает предложение, оценивает его и решает, что изменить.


