
AI-humanizer для эфиопских исследователей, пишущих на английском
AI-humanizer для эфиопских исследователей. Снижайте число ложных срабатываний при ИИ‑детекции для английского с влиянием амхарского: сохраняйте смысл и цитирования, честно раскрывайте использование.

Эфиопия опубликовала 10 614 научных работ, индексируемых Scopus, в 2023 году — это рост на 20,2%, который ставит страну среди наиболее быстро растущих производителей исследований в Африке. Индекс H находится на 77-м месте в мире — и это одна из всего трех стран с низкими доходами в глобальной топ-100 по показателю цитируемости. За этими цифрами стоят тысячи академиков, говорящих на амхарском, которые набрасывают текст, перерабатывают его и все чаще обращаются к ИИ‑инструментам, чтобы писать на втором языке.
Именно здесь и начинается проблема. AI-humanizer для эфиопских исследователей — это не попытка скрыть работу. Речь о том, чтобы защитить аккуратный, нормативный английский от детекторов, которые неверно его распознают.
Когда исследователь из Бахир-дара или Гондэра пишет ясный, предсказуемый академический текст, именно те качества, которые делают его читабельным, могут спровоцировать ложное срабатывание у ИИ‑детектора. В этом руководстве объясняется, почему так происходит, и как это исправить простыми шагами: «humanize» собственный черновик с помощью ИИ, сохраните смысл и цитирования, затем раскрывайте использование ИИ так, как этого требуют ваш вуз и журнал.
ሰላም: AI-humanizer, созданный для эфиопских исследователей, пишущих на английском
ሰላም (selam) означает «привет». Наш humanizer помогает эфиопским исследователям публиковаться на английском: он берет ваш собственный черновик с помощью ИИ и «сглаживает» механический ритм, не затрагивая ваш смысл, данные или цитирования. Он поддерживает более 60 языков, включая амхарский (አማርኛ), тигринья (tigrinya) и оромо (Oromo), поэтому работа, продуманная сначала на вашем рабочем языке, может перейти в академический английский и остаться вашей.
Неважно, пишете ли вы в Аддис-Абебе в столице или в региональном кампусе с ограниченной поддержкой английского. Использовать его можно откуда угодно при наличии интернет‑соединения. Это особенно важно для страны, где языковой разрыв между учреждениями значителен, а давление публикаций одинаково везде.
Пишете на амхарском? Детектируется автоматически и «humanize» выполняется нативно
Многие эфиопские исследователи сначала пишут черновик на амхарском, а уже затем оформляют текст на английском. В этом случае humanizer работает напрямую. Вставьте текст на амхарском (አማርኛ) — и ProofreaderPro самостоятельно распознает письменность гээз, после чего обрабатывает текст через языково‑ориентированную модель, сохраняя вашу терминологию и цитирования в точности как они указаны. Ваш амхарский черновик «humanize’ится» так же легко, как и английский — не нужно переводить ничего заранее. Тот же принцип детекции распространяется более чем на шестьдесят языков: каждый текст переписывается в собственной письменности.
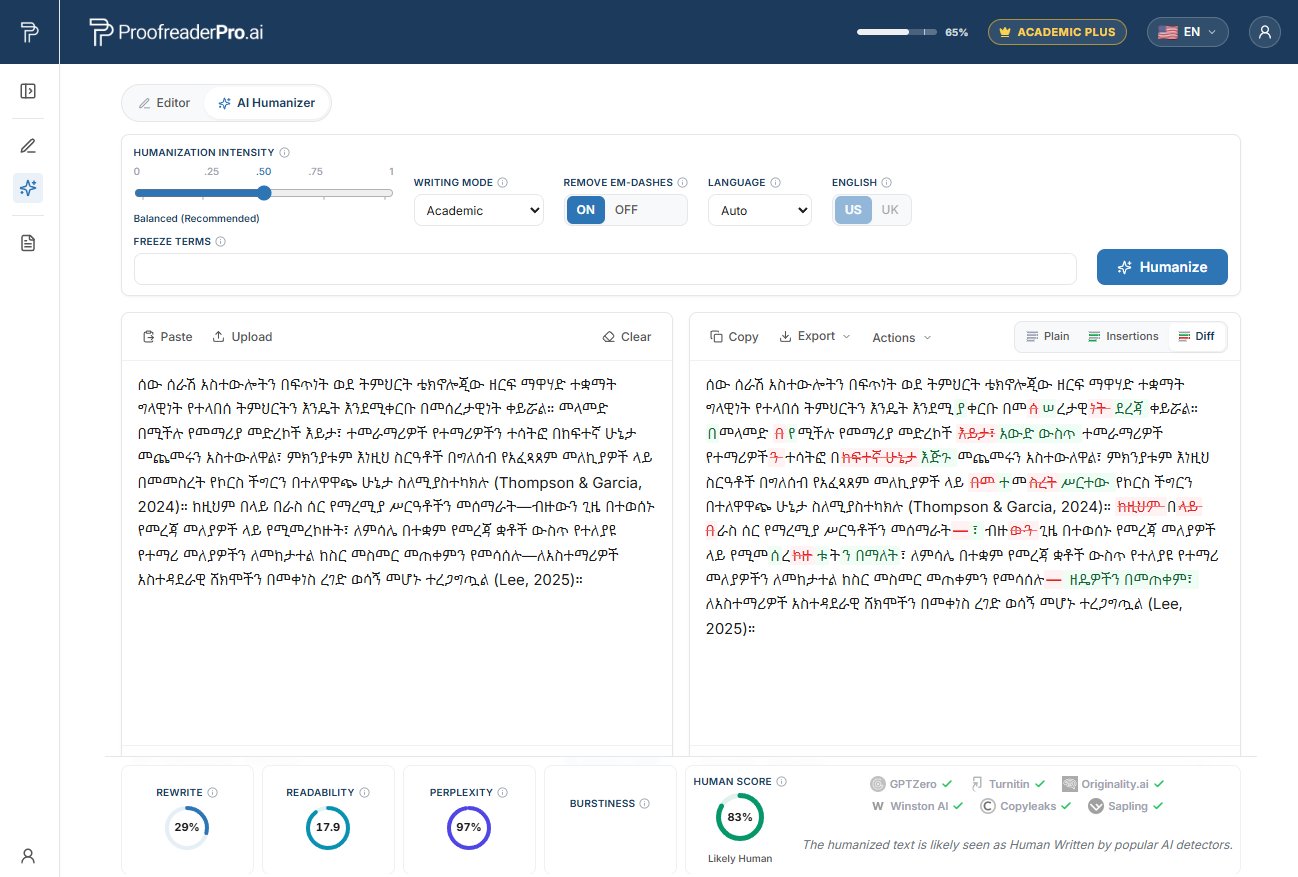
ProofreaderPro AI Humanizer переписывает амхарский академический текст. Сравнение «до и после» сохраняет ваш смысл и цитирования, а проверки детектора подтверждают естественное, «человеческое» чтение.
Почему эфиопских исследователей отмечают ИИ‑детекторы
В 2023 году исследование Стэнфордского университета под руководством Liang и соавторов, опубликованное в журнале Cell Press Patterns, вышло с прямолинейным названием: "GPT detectors are biased against non-native English writers." Команда прогнала эссе, написанные людьми, через семь наиболее распространенных ИИ‑детекторов. Во всех эссе был человеческий автор.
Детекторы отмечали около 61% не‑носительских эссе как сгенерированные ИИ — по сравнению примерно с 5% для эссе носителей английского. Почти каждый пятый (примерно 19,8%) получал единогласную отметку от каждого детектора в наборе. Ни одно не было написано машиной.
Механизм связан с перплексностью. Многие детекторы оценивают, насколько «неожиданным» является выбор каждого слова для языковой модели. Авторы академического текста как второго языка часто используют общеупотребительные слова и стандартные, предсказуемые формулировки — это дает низкую перплексность, из-за чего текст читается как машинный. Привычки, которые делают ясным английский текст у носителей амхарского, — это и есть то, на что эти инструменты обучены «сигналить». Полный разбор механизма приведен в почему ИИ‑детекторы помечают не‑носителей.
Амхарские паттерны родного языка, лежащие в основе ложных срабатываний
Амхарский — семитский язык, записываемый письменностью гээз; его грамматика системно расходится с английской. Исследования студенческого письма в Эфиопии показали: 55,6% студентов утверждают, что амхарский синтаксис напрямую влияет на их английский. Вот часть, которую детекторы не улавливают: если скорректировать эти паттерны, ваш текст становится «стандартно учебниковым», а учебниковая стандартность — это ровно то, что воспринимается как низкая перплексность.
Страдательный залог. Формальная письменная речь на амхарском часто предпочитает безличные конструкции, а более старые практики обучения английскому в Эфиопии учили страдательный залог как «более академичный». Примерно 32% рукописей сильно опираются на него. Такой текст грамматически корректен и последователен, а последовательность — еще один сигнал, который детектор читает как «машинный» ритм.
Времена глагола. Амхарский маркирует время, аспект и наклонение через согласные корни и модели гласных, которые не прямо соответствуют прошедшему, настоящему и будущему временам в английском. Около 28% рукописей переключают время внутри раздела. Если редактор «сглаживает» эти переключения до одного устойчивого времени, на выходе получается равномерный и предсказуемый текст.
Согласование подлежащего и сказуемого. В амхарском субъект кодируется внутри глагола, поэтому явное согласование, которое требует английский, может казаться избыточным. Около 23% рукописей содержат ошибки согласования со сложными подлежащими, например: "The analysis of the collected data from all three sites show." После исправления эти фрагменты становятся чистыми и регулярными — еще один низко‑«сюрпризный» сигнал.
Пропуск артиклей. В амхарском нет прямого аналога «a», «an» или «the», поэтому артикли часто опускаются: "Result was significant" вместо "The result was significant." Верните их так, как делает внимательный автор, — и отсылка станет точной и стандартной.
Порядок слов. В амхарском модификатор ставится перед опорным существительным в ином порядке, чем в английском, из-за чего возникают сочетания вроде "temperature increase rate" вместо "rate of temperature increase." Зафиксированные, они читаются как аккуратный технический английский.
Ничто из этого не является «жульничеством», и ничто не является слабостью. Это — аккуратное письмо, которое просто оказывается предсказуемым, а humanizer возвращает естественную вариативность, которую детектор ожидает увидеть.
Контекст ИИ‑детекции в Эфиопии и Turnitin
Turnitin или iThenticate — один из инструментов, применяемых для проверки совпадений в диссертациях и поданных в журналы работах в государственных университетах Эфиопии. Использование индикаторов ИИ становится повсеместным. Для академических продвижений требуется публикация в международно индексируемых журналах согласно согласованным директивам Министерства науки и высшего образования (MoSHE). Это означает, что все статьи будут проходить более тщательную проверку, а не менее.
Важно понимать, насколько «шаткими» могут быть эти ИИ‑оценки. В 2023 году Vanderbilt отключил ИИ‑детектор Turnitin из‑за ложных срабатываний и предвзятости к не‑носителям. Так же поступили Michigan State, UT Austin, Northwestern, Pittsburgh, SMU и Waterloo. Сам Turnitin подавляет значения в диапазоне 1–19% и предупреждает, что его число нельзя использовать в одиночку, чтобы решать вопросы о нарушении целостности.
Вывод для эфиопского исследователя прост: ИИ‑флаг — это утверждение, с которым вы можете спорить, а не приговор. Никто не «подавал в суд на Turnitin и выиграл»; реальные разногласия были с учебными заведениями о том, как именно использовали флаг. Ваша задача — держать письмо прямым (последовательным) и не позволять ему быть неверно прочитанным с самого начала.
Сделайте ваш черновик более «человечным», сохраните каждую цитату
Загрузите вашу статью с ИИ-помощью и позвольте гуманизатору восстановить естественное разнообразие, сохранив ваш смысл, терминологию и ссылки. Создан для исследователей, говорящих на амхарском, которые пишут на английском.
Попробуйте бесплатный HumanizerТоп‑университеты Эфиопии и где встречаются ИИ‑проверки
Система университетов Эфиопии выросла до более чем 47 государственных учреждений, и все сильнейшие исследовательские центры просматривают диссертации и рукописи на предмет совпадений и индикаторов ИИ. Если вы пишете в любом из этих университетов, применим следующий рабочий процесс:
- Аддис-Абебский университет (አዲስ አበባ ዩኒቨርሲቲ), старейший и наиболее ориентированный на исследования университет страны, в столице.
- Университет Джиммы (ጅማ ዩኒቨርሲቲ), сильные позиции в медицинских науках и общественном здравоохранении.
- Университет Бахир-дара (ባህር ዳር ዩኒቨርሲቲ), растущий инженерный, сельскохозяйственный и образовательный центр в регионе Амхара.
- Университет Гондэра (ጎንደር ዩኒቨርሲቲ), известный медициной и ветеринарными науками.
- Университет Хавассы (ሃዋሳ ዩኒቨርሲቲ), один из ведущих производителей в сельском хозяйстве и естественных науках.
- Университет Мекелле (መቀሌ ዩኒቨርሲቲ), крупный исследовательский университет в Тыграе с сильными направлениями в богарном земледелии и геонауках.
- Университет Адамы по науке и технологиям (አዳማ ሳይንስና ቴክኖሎጂ ዩኒቨርሲቲ), ориентирован на инжиниринг и технологии.
- Университет Харамия (ሀረማያ ዩኒቨርሲቲ), один из старейших, сильные позиции в сельском хозяйстве и ветеринарной медицине.
- Университет Арба-Минч (አርባ ምንጭ ዩኒቨርሲቲ), известный водными технологиями и экологическими исследованиями.
- Университет Дебре-Берган (ደብረ ብርሃን ዩኒቨርሲቲ), региональный университет с быстро развивающимся исследовательским потенциалом.
Здесь особенно заметна значимость разрыва в региональной языковой компетенции. Аддис-Абеба набирает 522 балла по EF English Proficiency Index, но регион Амхара — 436 (разница 86 баллов). Поэтому у исследователя из Бахир-дара или Гондэра порог выше, чем у коллеги в Аддис-Абебе. Но у них один и тот же набор правил и те же детекторы. Инструмент, который работает из любого соединения, помогает выровнять поле.
Как работает AI-humanizer для эфиопских исследователей
Ниже — рекомендуемый нами процесс, от начала до конца.
Сначала — черновик. Изложите свой аргумент на том языке, который для вас думается быстрее: амхарском, оромо, тигринья или английском. Если вы набросали текст на рабочем языке, наш AI переводчик переводит его в академический английский, сохраняя ваши термины и структуру.
Во‑вторых — вычитка. Запустите грамматическую проверку, которая исправляет вышеописанную плотность страдательного залога, «дрейф времен», ошибки согласования и пропущенные артикли. Чистый, корректный английский — это основа, а humanizer не заменяет ее.
В‑третьих — «humanize». Возьмите ваш собственный черновик с помощью ИИ и прогоните его через text humanizer. Он меняет ритм предложений и подбор слов, убирает повторяющуюся каденцию и «лишние» длинные тире (em dashes), а также восстанавливает естественную вариативность, которую ожидает детектор; при этом сохраняются ваш смысл, техническая терминология и цитирования.
Наш humanizer, протестированный на основных детекторах, перерабатывает ИИ‑текст в более естественный «человеческий» формат, который читается человеком в Turnitin, Originality.ai и GPTZero, сохраняя при этом высокую точность грамматики в академических текстах. Это результаты тестирования, а не гарантии. Детекторы переобучаются каждые несколько месяцев, и ни один серьезный инструмент не обещает «необнаружимость». Цель — справедливость реальной работы, а не маскировка.
В‑четвертых — раскрытие. Укажите использование ИИ в формате, который требуют ваш вуз и целевой журнал. «Humanize» собственного текста и раскрытие того, что вы использовали ИИ, не противоречат друг другу: вместе они помогают оставаться в рамках правил целостности и защищают аккуратный не‑носительский текст от ложного флага.
Этот шаг humanizer — аналог нашего академического редактирования для эфиопских исследователей и встроен в наш общий мультилингвальный хаб AI-humanizer, который охватывает исследователей, пишущих на десятках языков.
Местные финансирующие организации, журналы и ожидания по раскрытию ИИ
Эфиопское финансирование исследований поступает в основном от государства — через гранты университетам по линии MoSHE, а также через международные проекты развития и сотрудничество с НКО. Большинство средств направляется на здравоохранение, сельское хозяйство и инженерные дисциплины, где целевые журналы публикуются на английском языке. Национальный академический цифровой репозиторий Эфиопии (NADRE) требует открытого доступа к публикациям по результатам исследований, финансируемых из публичных источников. Открытый доступ означает публикацию на английском. Исследователям нужно публиковаться, чтобы получать продвижение и обеспечивать будущие финансирования.
Собственные индексируемые журналы страны принимают рукописи, соответствующие международным языковым стандартам:
- Ethiopian Journal of Health Sciences, индексируется в MEDLINE и Scopus.
- Ethiopian Journal of Health Development, индексируется в Scopus и Web of Science.
- Ethiopian Medical Journal — один из старейших медицинских журналов Африки.
- Ethiopian Journal of Education and Sciences, охватывает образование и педагогику.
- Ethiopian Journal of Agricultural Sciences, охватывает аграрные исследования Эфиопии.
Финансирующие организации и журналы все чаще просят авторов раскрывать использование ИИ, и это ожидание только растет. Безопасный сценарий одинаков везде: «humanize» собственный текст для справедливости, прогоните рукопись через text humanizer перед подачей, затем раскройте ровно то, как вы использовали ИИ. Если детектор все равно отмечает аккуратную, законную работу, вы имеете полное право оспорить этот флаг вместе с вашим редактором, а не принимать его как окончательный вердикт.
Часто задаваемые вопросы
В: Поможет ли AI-humanizer эфиопским исследователям пройти Turnitin справедливо?
Он помогает в практическом смысле: возвращает естественную вариативность вашему собственному аккуратному английскому, созданному с помощью ИИ, — поэтому детектор с меньшей вероятностью прочитает его неверно. В наших тестах humanizer переписывает ИИ‑текст в более «человеческий» формат, что снижает ИИ‑сигнал в Turnitin; однако детекторы переобучаются постоянно, и ни один инструмент не может обещать «необнаружимость». Рассматривайте любой флаг как основание для обсуждения, сохраняйте вашу работу искренней и раскрывайте использование ИИ.
В: Будет ли humanizer работать, если я сначала сделаю черновик на амхарском?
Да. Многие эфиопские исследователи думают быстрее на амхарском, оромо или тигринья. Вы можете набросать текст на рабочем языке, перевести его в академический английский, вычитать грамматику, затем «humanize» — и инструмент на каждом этапе сохранит ваш смысл и цитирования более чем на 60 языках.
В: Считается ли использование AI-humanizer «мошенничеством»?
Нет, не считается, если вы используете его для своей собственной работы и раскрываете это. «Humanize» — это сглаживание механического ритма черновика, который вы сами написали и по которому сами проводили исследование, при сохранении смысла. Мошенничество — это подача сфабрикованных материалов или чужой работы; раскрытие подлинной ИИ‑помощи — это прямо противоположно скрытию.
В: Почему даже аккуратно написанные и корректные англоязычные статьи все равно отмечают?
Потому что многие детекторы оценивают перплексность — насколько предсказуемы ваши варианты слов. Академическое письмо на втором языке обычно стандартно и мало «удивляет», и именно этот профиль инструментам обучали распознавать как «машинно‑написанный». В исследовании Стэнфорда примерно 61% не‑носительских эссе, написанных людьми, получали отметку как ИИ — это известная предвзятость, а не отражение вашей компетентности.
В: Изменит ли «humanize» мои цитирования или технические термины?
Нет. Humanizer сохраняет ваши цитирования, данные и терминологию, характерную для вашей предметной области, при этом меняя ритм предложений и выбор слов. Вы просматриваете все изменения, поэтому без вашего одобрения в ваших ссылках или выводах ничего не сдвинется.
Верните вашему собственному академическому английскому, созданному с ИИ-помощью, естественное разнообразие, сохраните каждое цитирование и раскройте использование с уверенностью. Создан для эфиопских исследователей, публикующихся в международных журналах.

Мо — инженер NLP с PhD в области обработки естественного языка. Его исследования охватывают компьютерную лингвистику, анализ текста и машинное обучение, и они напрямую используются в моделях редактирования и гуманизации, лежащих в основе ProofreaderPro. Он пишет о той части процесса, которую большинство людей никогда не видит: о том, как языковая модель читает предложение, оценивает его и решает, что изменить.


