Pangram AI 탐지기 리뷰(2026): 정확도와 오탐(거짓 양성)
Pangram의 AI 탐지기는 정확한가요? 99%+ 정확도와 10,000건 중 1건 수준의 오탐률을 주장합니다. 독립 연구 결과와 비교해 확인해 보세요.
Pangram은 Pangram Labs의 AI 탐지기이며, 회사는 정확도가 99% 이상이라고 말합니다. 또한 사람 텍스트를 잘못 표시하는 경우가 약 10,000건 중 1건이라고도 밝힙니다. Pangram은 시카고 대학교와 메릴랜드 대학교의 외부 연구를 근거로 제시하며, 유사한 결과가 나왔다고 주장합니다.
아래에서는 Pangram이 제시한 정확도와 오탐 수치, 그리고 독립 연구가 무엇을 발견했는지 살펴봅니다. 이어서 Pangram이 AI 텍스트를 감지하는 방식, GPTZero, Copyleaks, Turnitin과의 비교, 가격과 지원 언어도 다룹니다.
Pangram이 하는 일
Pangram은 사람의 글과 AI 글을 구분해야 하는 학교, 출판사, 로펌 등 다양한 조직을 위해 만든 AI 탐지 도구입니다. 텍스트를 붙여 넣거나 파일을 업로드하면 됩니다. Pangram은 Human, AI-Generated 또는 AI-Assisted로 예측을 반환하고, 문서에서 각 라벨에 해당하는 비중에 대한 점수도 함께 제공합니다.
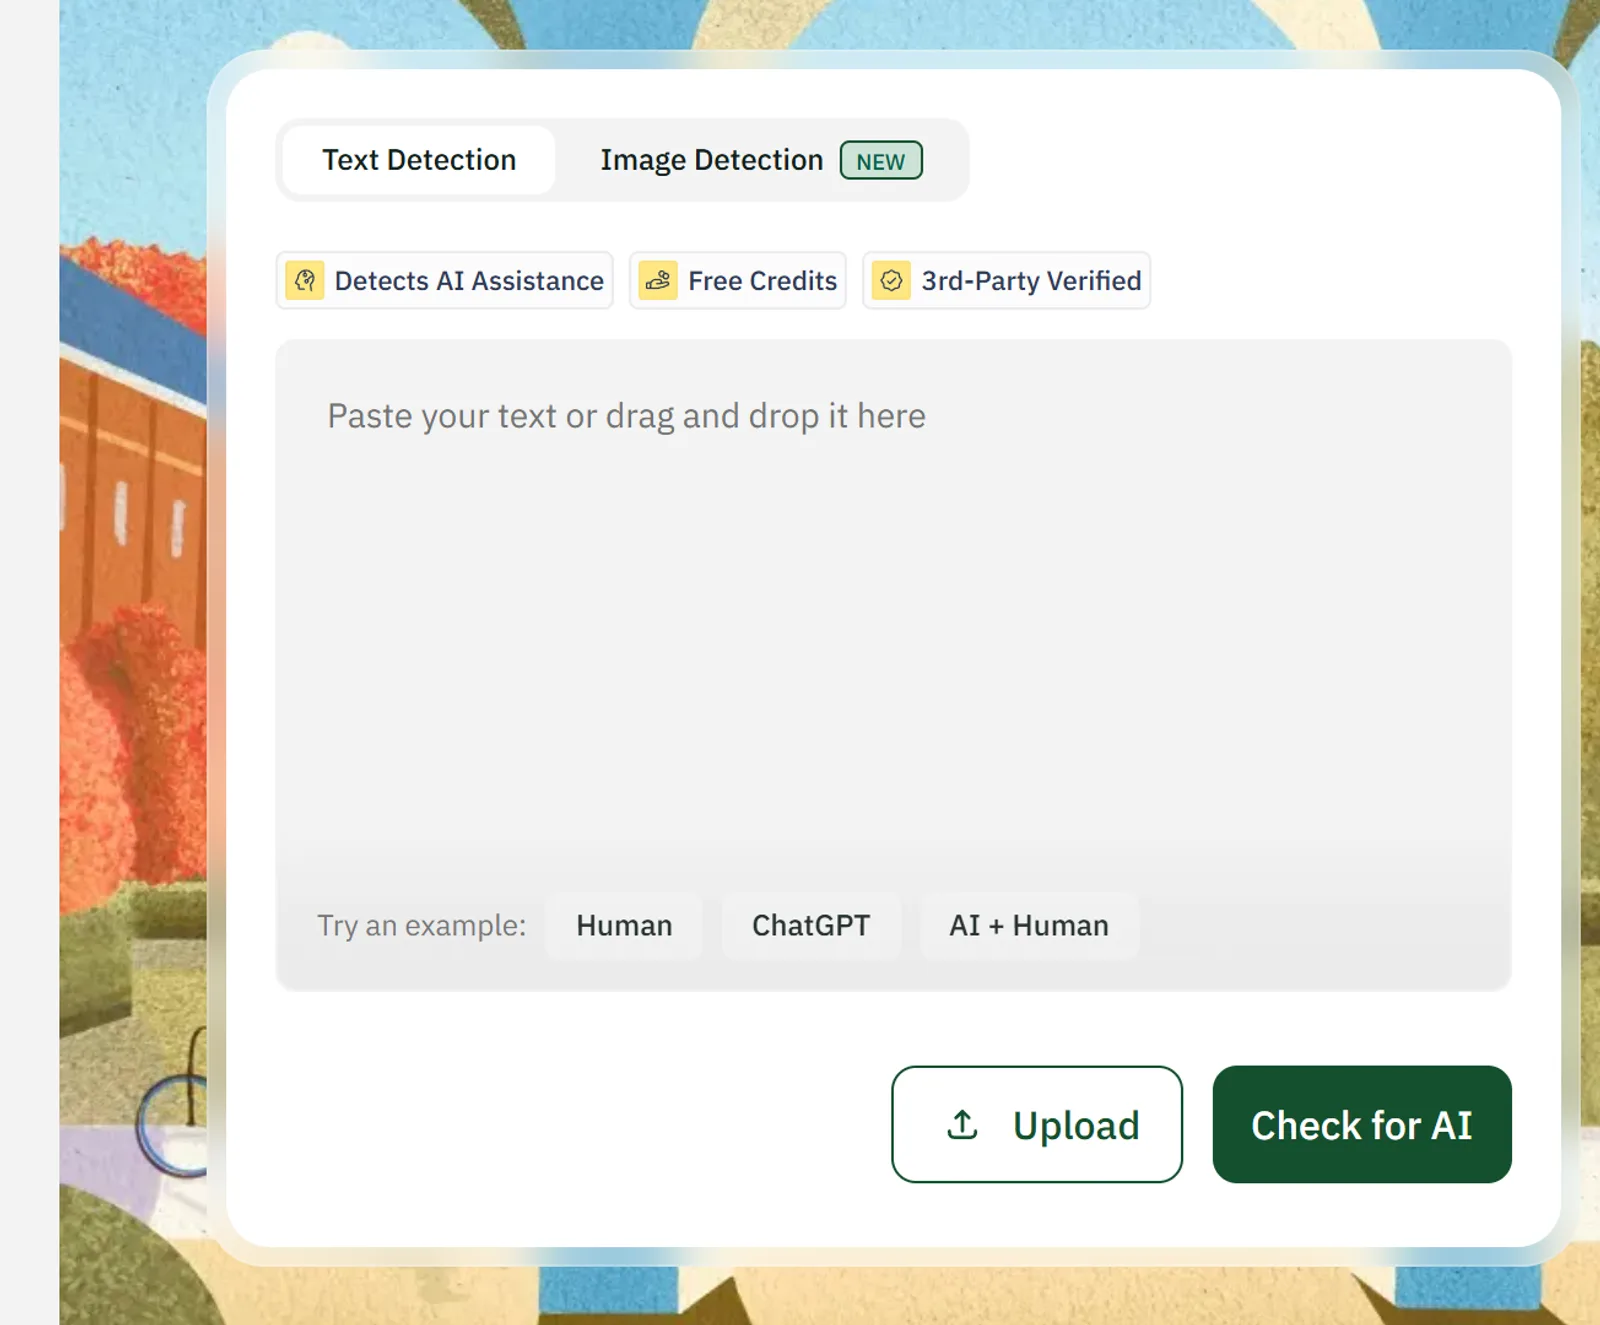
Pangram Labs는 2023년에 뉴욕 브루클린에서 시작되었습니다. 설립자들은 회사를 시작하기 전 Tesla와 Google에서 AI 연구를 수행했습니다. 현재 제품 라인에는 AI 탐지기와 함께 제공되는 표절 검사기, AI 이미지 탐지기, 브라우저 확장 프로그램이 포함됩니다. 또한 Gmail, Google Docs, Canvas, Moodle, Google Classroom, Brightspace 같은 학습 관리 시스템과도 연동됩니다. 개발자가 자신의 앱 안에 AI 탐지를 넣고 싶을 때 사용할 수 있는 API도 제공됩니다.
Pangram의 최신 모델인 Pangram 4는 입력 최소 50단어가 필요하며, 완전한 문장에 가장 잘 작동합니다. 짧은 답변과 불릿 포인트는 처리할 정보가 부족해 결과가 덜 정확할 수 있습니다. 각 결과에는 모델이 각 구간을 AI-Generated, AI-Assisted, Human으로 분류했는지 표시하는 하이라이트 구간과 함께 High, Medium, Low 신뢰도 수준이 포함됩니다.
AI-Assisted 라벨은 사람이 처음 작성한 글을 AI가 편집하거나 다듬었다고 Pangram이 판단했다는 의미입니다. 글의 일부에 문법 도구나 AI 리라이터를 사용했다면, 아이디어와 구조가 본인 것이라도 해당 라벨이 나타날 수 있습니다. 라벨을 문제로 판단하기 전에 학교나 고용주가 AI 편집 도구의 사용을 허용하는지 확인하세요.
Pangram이 정확도에 대해 주장하는 내용
Pangram의 FAQ에 따르면 탐지기는 99% 이상 정확하며, 오탐률은 약 10,000건 중 1건입니다. 이 수치는 수천만 개 문서를 포함하는 공개 데이터셋 전체에서 계산된 값이라고 설명합니다. 또한 Pangram은 자신의 모델을 26개 AI 시스템과 벤치마크하며, 그 AI 생성 샘플 그룹에 대해 모델을 99.7% 정확도로 보고합니다. 그리고 주요 모델이 출시될 때마다 재테스트를 진행합니다.
Pangram은 개별 모델에 대한 정확도 수치도 공개합니다:
| AI 모델 | Pangram이 보고한 정확도 | 테스트 완료 |
|---|---|---|
| Claude Opus 5 | 99.8% | 2026년 7월 |
| GPT-5.6 | 99.6% | 2026년 7월 |
| Gemini 3 | 99.5% | 2026년 7월 |
| Grok 4.3 | 99.4% | 2026년 7월 |
이는 Pangram이 자체적으로 측정한 수치입니다. Pangram 4 모델 카드에서는 수치를 더 세분화해 제공합니다. 26개 모델이 생성한 519,993개의 영어 AI 생성 샘플에서 Pangram 4는 0.34%를 놓쳤으며, 이는 핵심 요약 수치인 99.7%에 가깝습니다. 모델 카드에는 18개 언어를 포괄하는 다국어 세트에서의 1.24% 누락률도 함께 제시되어 있어, Pangram은 영어 외 언어에서는 AI 텍스트를 조금 덜 안정적으로 탐지한다는 뜻입니다.
Pangram의 오탐률, 도메인 및 언어별
Pangram의 FAQ는 오탐률을 전체 기준 1만 분의 1로 하나의 수치로 제시합니다. Pangram 4 모델 카드는 더 구체적인 수치를 보고합니다. FineWeb 데이터셋에서 영어 문서 1,000,000개를 대상으로 Pangram 4는 41건의 오탐을 보였고 이는 0.0041%로, 24,000분의 1에 가깝습니다. 104개 언어에 걸친 다국어 문서 996,273개에서는 오탐 14건, 즉 0.0014%를 기록했습니다.
도메인에 따라 비율이 달라집니다. Pangram의 모델 카드에는 다음 오탐률이 나열되어 있습니다:
| 도메인 | 오탐률 |
|---|---|
| 학술 글쓰기 (영어) | 0.019% |
| 뉴스 (다국어) | 0.003% |
| 창작 글쓰기, 장문 | 0.000% |
| 생의학 연구 논문 | 0.002% |
| 사용 방법 기사 (다국어) | 0.016% |
| 영화 대본 | 0.010% |
| 시 | 0.078% |
| 요리법 | 0.049% |
영어 학술 글쓰기에 대해서는 Pangram의 모델 카드가 오탐률 0.019%, 즉 약 5,000문서 중 1건을 제시합니다. 이는 전체 수치보다 높으며, 학생과 연구자에게 가장 중요한 값입니다. 공식적인 학술 산문은 정해진 패턴을 따르며, Pangram이 자체 데이터에서 보여주는 바에 따르면 조리법처럼 틀에 박힌 텍스트에서는 오탐이 더 늘어납니다.
Pangram의 오탐에 관한 블로그 글에서는, 레시피와 시처럼 짧거나, 완전한 문장으로 쓰이지 않았거나, 매우 형식적인 텍스트에서 오탐률이 상승한다고 말합니다. 또한 에세이, 리뷰, 보고서처럼 길고 독창적인 산문에서는 모델이 활용할 정보가 더 많아지기 때문에 오탐률이 낮게 유지된다고 설명합니다.
언어도 비율에 영향을 줍니다. Pangram의 모델 카드는 24개 언어에 대한 공식 지원을 나열합니다. 해당 언어는 영어, 스페인어, 프랑스어, 포르투갈어, 아랍어, 중국어, 일본어, 한국어, 러시아어, 튀르키예어, 헝가리어, 독일어, 네덜란드어, 스웨덴어, 루마니아어, 우크라이나어, 폴란드어, 이탈리아어, 체코어, 그리스어, 힌디어, 페르시아어, 우르두어, 베트남어입니다. 측정된 오탐률은 아랍어, 중국어, 일본어 같은 언어에서 0.0000%까지, 포르투갈어 0.0078%, 우크라이나어 0.0361%까지 범위가 있습니다. 그래도 모두 1,000분의 1보다 훨씬 낮습니다. Pangram은 또한 이 목록 밖의 언어에도 일반화할 수 있다고 말하며, 새로운 언어의 평가 요청을 받습니다.
Pangram은 다른 탐지기와의 비교도 함께 공개합니다. 브루클린에서의 University of Chicago 연구 사례인 제품 리뷰 데이터에서, 자체에 대해서는 0.5%, Originality.ai에 대해서는 1.7%, GPTZero에 대해서는 2.4%의 오탐률을 보고합니다. 이는 Pangram이 자체 블로그에서 가져온 수치입니다.
Pangram이 인용하는 해외 연구
2025 University of Chicago Booth 연구에서는 주요 AI 탐지기가 사람이 수정하지 않은 AI 텍스트의 90% 이상을 플래그했다고 밝혔습니다. 그중 대부분은 텍스트를 AI humanizer를 거친 뒤에는 절반 미만으로 플래그하는 데 그쳤습니다. Pangram은 GPTZero, Originality.ai, 오픈소스 탐지기 RoBERTa와 함께 테스트된 네 가지 탐지기 중 하나였습니다. Pangram은 여전히 AI 텍스트를 탐지하면서도 오탐률을 0.5% 미만으로 유지한 것은 자신이 유일했다고 말합니다.
Pangram은 2026년 6월 Vrije Universiteit Brussel의 연구도 인용합니다. 해당 연구에서는 영어가 모국어가 아닌 화자들이 쓴 160편의 학술 논문을 대상으로 Pangram, GPTZero, Turnitin, Copyleaks를 테스트했으며, 이를 사람 작성, AI 생성, 혼합, AI humanizer 처리 텍스트로 나눴습니다. Pangram은 그 연구에서 네 도구 모두 사람이 작성한 논문을 플래그하지 않았다고 말합니다.
2025년 연구: 전문가 인간 판독자를 상대로 한 Pangram
Jenna Russell, Marzena Karpinska, Mohit Iyyer가 2025년 발표한 논문 한 편이 ACL 2025에서 공개되었습니다. 이 연구는 AI 글쓰기 도구를 자주 사용하는 사람들이 자동 탐지기만큼이나 AI 생성 텍스트를 잘 식별할 수 있는지 시험했습니다. 자신의 글쓰기에 LLM을 자주 사용한다고 답한 5명의 주석자(annotator)가 300개의 영어 비(非)픽션 기사를 읽었습니다. 이 세트는 인간이 쓴 텍스트와 GPT-4o, Claude, o1-Pro의 텍스트를 섞었고, 그중 일부 기사는 humanizer를 거친 텍스트였습니다. 이 5명의 주석자 다수결 결과는 300편 중 단 1편만 잘못 분류했습니다.
이 논문은 해당 패널을 5가지 자동 탐지기인 Pangram, GPTZero, Binoculars, Fast-DetectGPT, RADAR와 비교했습니다. 연구진은 Pangram의 두 모델을 실행했는데, 기본 탐지기와 humanizer를 거친 텍스트를 탐지하도록 학습된 별도 모델인 Pangram Humanizers였습니다. Pangram Humanizers는 전문가 패널과 일치한 유일한 탐지기였으며, 테스트 세트 전체에서 평균 진양성률 99.3%, 오탐률 2.7%를 보였습니다. Pangram의 기본 모델은 같은 테스트에서 평균 진양성률 98.0%, 오탐률 2%에 도달했습니다.
오탐률 2.7%는 Pangram이 자체 평가에서 제시하는 10,000분의 1보다 높습니다. 이 시험은 Pangram이 다른 곳에서 인용하는 수백만 편이 아니라 훨씬 적은 기사 300편을 사용했습니다. 또한 논문은 Pangram을 Human과 AI-Generated 라벨만으로 점수화했으며, 중립적인 "Possibly AI" 라벨에는 어떤 가점도 주지 않았습니다. Pangram과 GPTZero는 연구진이 테스트를 실행할 수 있도록 각각 API 크레딧을 제공했습니다.
AI 플래그 표시된 부분을 내 목소리로 다시 쓰기
당사의 academic humanizer는 인용문, 기술 용어, 숫자는 사용자가 작성한 그대로 둔 채 AI 보조 구간을 다시 작성합니다.
ProofreaderPro.ai Free 사용해 보기Pangram은 AI 글쓰기를 어떻게 탐지하나요
Pangram은 자신들이 오래된 AI 탐지기가 주로 의존하는 두 가지 신호인 perplexity나 burstiness를 사용하지 않는다고 말합니다. Perplexity는 언어 모델에 대해 각 단어가 얼마나 예측 가능한지를 측정하고, burstiness는 문서 전반에서 그 예측 가능성이 얼마나 달라지는지를 측정합니다. 이 두 가지 모두 AI 탐지에서의 perplexity에 관한 우리 글에서 설명합니다.
Pangram은 perplexity 기반 탐지기가 언어 모델이 학습 중에 외워버린 어떤 텍스트에서도 오작동한다고 주장합니다. 여기에는 독립선언서(Declaration of Independence)와 Wikipedia의 상당 부분이 포함됩니다. 모델은 누가 썼는지와 무관하게 외워진 텍스트를 매우 낮은 perplexity로 예측하는 법을 학습합니다. Pangram은 또한 더 간단한 문장 구조 역시 더 예측 가능하기 때문에, perplexity 기반 방식이 비(非)원어민 영어 글쓰기에서 더 높은 오탐률을 보인다고 말합니다. 우리는 다른 탐지기들을 살펴보는 글에서 비(非)원어민 영어 작성자를 위한 오탐 패턴도 다룹니다.
대신 Pangram은 대규모의 인간 및 AI 텍스트 데이터에 직접 딥러닝 모델을 학습합니다. Pangram은 이 방법을 hard negative mining이라고 부르는데, AI 출력과 우연히 닮아 있는 인간 글쓰기를 찾아내는 방식입니다. Pangram은 토큰 수준에서 전체 문서를 처리합니다. 각 구간을 Human, AI-Assisted 또는 AI-Generated로 라벨링하고, 그 구간이 AI로 작성된 것처럼 보이는 정도에 대해 연속 점수를 부여합니다. Pangram은 더 많은 데이터로 학습할수록 모델이 향상된다고 말합니다.
Pangram vs GPTZero, Copyleaks, Turnitin
Pangram, GPTZero, Copyleaks는 누구나 가입하면 사용할 수 있습니다. Turnitin은 학교나 출판사 계정으로만 사용할 수 있으며, 개인 응시자는 보통 강의자가 결과를 전달해줘야 Turnitin 점수를 확인할 수 있습니다.
| 탐지기 | 접근 방식 | 업체의 자체 오탐 주장 | 무료 플랜 |
|---|---|---|---|
| Pangram | 가입 오픈 | 전체 기준 약 10,000분의 1 | 하루 2,000단어 |
| GPTZero | 가입 오픈 | 약 1% | 스캔당 10,000자 |
| Copyleaks | 가입 오픈 | 약 0.2% | 무료 스캔 횟수 제한 |
| Turnitin | 학교와 출판사만 | 학술 글쓰기에서 0.51% | 개인 사용자에게 제공되지 않음 |
이 글에서는 각 검출기를 따로 다루었습니다. GPTZero는 정확한가요? 독립 테스트가 보여주는 내용 (2026), Copyleaks는 AI를 감지하나요? 정확도와 대처 방법, 2026년에 Turnitin이 ‘휴머니즈된’ AI 텍스트를 감지할 수 있을까?. 표에 나온 오탐 수치는 각 회사가 Pangram 및 다른 벤더가 주장하는 내용입니다.
Pangram은 단독형 검출기입니다. Grammarly와 Scribbr는 글쓰기 도구의 일부로 AI 감지를 제공합니다. 우리는 Grammarly AI Detector와 Scribbr AI Detector를 각각 따로 살펴보았습니다.
가격 및 무료 요금제 한도
Pangram의 Free 요금제는 결제 수단이 필요 없습니다. 하루 텍스트 2,000단어를 스캔하고, 하루 이미지 탐지 3회까지 포함됩니다. 여기에는 OCR이 포함된 파일 업로드, 브라우저 확장 프로그램, Google Docs 연동, API 액세스가 포함되며 20개가 넘는 언어를 지원합니다.
| 요금제 | 가격 | 추가되는 항목 |
|---|---|---|
| Free | 월 US$0 | 하루 2,000단어, 하루 이미지 탐지 3회 |
| Individual | 월 US$20(연간 청구) | 월 300,000단어, 월 이미지 탐지 100회, 표절 감지, Gmail 연동 |
| Professional | 월 US$65(연간 청구) | Individual보다 단어와 이미지 스캔을 5배 제공하며, 월 API 크레딧 US$200이 추가됩니다 |
Individual 요금제는 월 US$20 청구가 시작되기 전 7일 무료 체험이 제공되며, 연간 청구를 선택하면 월 요금 대비 연간 US$60을 절약할 수 있습니다. Professional 요금제는 체험 기간 없이 바로 월 US$65로 청구되며, 연간 청구 시 연간 US$240를 절약할 수 있습니다. 또한 Pangram은 팀을 위한 별도 Business 요금제를 별도로 안내하며, 가격 페이지에서 Business 탭을 선택하면 표시됩니다.
누가 Pangram을 사용하나
학교와 대학이 Pangram의 최대 고객층입니다. LMS 연동은 Canvas, Moodle, Google Classroom, Brightspace에 직접 연결됩니다. 교사는 수업 플랫폼을 떠나지 않고도, 학생의 제출물 옆에서 Pangram 결과를 확인할 수 있습니다.
출판사, 로펌, HR 팀은 서로 다른 이유로 Pangram을 사용합니다. 제출된 원고 점검, 사건의 문서 검토, 지원자 자료 스크리닝 등이 그 예입니다. API를 통해 이러한 조직은 Pangram의 감지를 자사 내부 도구에 통합할 수 있습니다. Gmail 및 Google Docs 연동은 한 사람이 받은 편지함이나 문서에서 나가지 않고도 텍스트를 확인할 수 있게 해줍니다.
학생의 경우 대개 Pangram 점수가 선생님이 이미 성적과 피드백을 확인하는 것과 같은 대시보드 안에 표시됩니다. 사용자가 직접 요청하는 별도의 보고서는 아닙니다. 학교에서 Pangram을 LMS로 운영한다면, 수업 담당자나 부서에 어떤 점수가 우려 대상인지, 그다음에 어떤 절차가 진행되는지 문의해 보세요.
Pangram 결과가 글쓰기를 문제 삼는다면, 점수만 두고 논쟁하기보다 자신의 초안 작성 과정 기록이 더 큰 의미가 있습니다. 우리는 프로세스는 새로운 ‘증거’다와 오탐된 AI 탐지 판정에 이의 제기하는 방법(학생 및 연구자 실전 가이드)라는 별도 글에서 그 내용을 자세히 다룹니다.
AI가 논문 작성의 일부를 도왔다면, academic humanizer가 해당 구간을 사용자의 목소리로 다시 씁니다. 인용문, 기술 용어, 숫자는 사용자가 작성한 그대로 정확히 유지되며, 도구는 사용자가 건드리는 구간에서 AI 점수를 낮추도록 설계되어 있습니다.
자주 묻는 질문
Q: Pangram은 정확한가요?
Pangram은 99% 이상 정확하다고 말하며, 유사한 결과를 보인 외부 연구를 인용합니다. 자체 모델 카드에서는 50단어 미만 텍스트와 영어 이외 일부 언어에서의 정확도가 더 낮게 나타난다고 보여줍니다.
Q: Pangram의 오탐률은 얼마인가요?
Pangram의 FAQ는 전체 비율이 약 1만 분의 1이라고 밝힙니다. Pangram 4 모델 카드에서는 보다 구체적으로 0.0041% 또는 약 24,000분의 1이라고 보고하며, 1,000,000개의 영어 문서에서 측정했습니다. 이 비율은 도메인과 언어에 따라 달라집니다.
Q: Pangram은 GPTZero와 어떻게 비교되나요?
Pangram은 오탐률이 약 1만 분의 1이라고 말하고, GPTZero는 RAID 벤치마크에서 약 1%라고 말합니다. 두 서비스 모두 무료 플랜이 있고, 누구나 가입할 수 있습니다. 저희는 GPTZero 정확도 리뷰에서 GPTZero의 자체 수치를 다룹니다.
Q: Pangram은 Turnitin과 어떻게 비교되나요?
Turnitin은 학교 또는 퍼블리셔 계정으로만 사용할 수 있는 반면, 누구나 Pangram에 직접 가입할 수 있습니다. Pangram은 Turnitin의 자체 백서에서 발췌한 학술 글쓰기 기준 0.51% 오탐률을 인용하며, 자신에 대해서는 더 낮은 오탐률을 보고합니다.
Q: Pangram은 Copyleaks와 어떻게 비교되나요?
Copyleaks는 오탐률이 약 0.2%라고 말하며, Pangram은 자신에 대해 더 낮은 비율을 보고합니다. 둘 다 무료 스캔을 제공하고, 저희는 Copyleaks가 AI를 감지하나요에서 Copyleaks를 다룹니다.
Q: Pangram은 어떻게 AI 글쓰기를 감지하나요?
Pangram은 사람의 글과 AI 텍스트로 학습된 딥러닝 모델을 사용합니다. 많은 기존 탐지기가 의존하는 퍼플렉్స티와 버스트니스는 사용하지 않습니다. 문서의 각 구간을 Human, AI-Assisted 또는 AI-Generated로 라벨링하고, 그 결과에 대한 신뢰도 수준을 제공합니다.
Q: Pangram의 AI 탐지 기능은 무료로 사용할 수 있나요?
네, 무료 플랜은 결제 수단이 필요 없으며, 하루 2,000단어 텍스트 스캔과 3회 이미지 스캔을 포함합니다. 유료 플랜은 월 300,000단어 및 표절 탐지를 연 단위로 청구하며 월 US$20부터 시작합니다.
Q: Pangram은 humanizer를 거친 텍스트도 감지하나요?
Pangram은 그렇다고 말하며 근거로 2025년 Chicago Booth 연구를 제시합니다. 탐지기와 humanizer 모두 자주 업데이트되므로, humanizer를 거친 텍스트에서의 결과는 시간이 지남에 따라 달라질 수 있습니다.
Q: Pangram에 대해 메릴랜드 대학교 연구는 무엇을 발견했나요?
2025년 메릴랜드 대학교 논문에 따르면, Pangram의 humanizer-aware 모델인 Pangram Humanizers가 5명의 전문가 사람 판독자 패널과 일치한 유일한 자동 탐지기였습니다. 두 방식 모두 300개의 테스트 자료에서 평균 99.3%의 참양성률을 달성했습니다. 해당 특정 테스트에서 Pangram의 오탐률은 2.7%로, 자기 측정에서 보고하는 1만 분의 1보다 훨씬 높았습니다.
Q: Pangram은 누가 만들었나요?
Pangram Labs는 Pangram을 만든 회사로, 2023년 뉴욕 브루클린에서 Tesla와 Google 출신의 전 AI 연구원들이 설립했습니다. 이 회사는 텍스트 탐지기와 함께 표절 검사기, AI 이미지 감지기, 그리고 API 접근도 판매합니다.
AI-assisted 학술 초안을 사용자의 목소리로 다시 작성하되, 인용문, 기술 용어, 숫자는 사용자가 작성한 그대로 정확히 유지합니다.
Dana는 ProofreaderPro의 콘텐츠 제작자로서 매일 블로그를 운영하고 글쓰기 작업을 진행합니다. 그녀는 온라인 편집 플랫폼의 작동 방식에 대한 기사를 작성하고 매일 고객 메시지를 처리하며 이에 대한 만족도 점수는 별 5개입니다.