QuillBot의 AI 탐지기는 0%부터 100%까지 점수를 매기고 텍스트를 AI 생성, 사람이 작성, AI 다듬음 중 하나로 분류하는 무료 AI 검사기입니다. 무료 버전은 1회 스캔당 최대 1,200단어를 확인하고 하루에 여섯 번까지 스캔할 수 있습니다. 일반 및 패러프레이즈된 AI 텍스트를 표시하는 데는 거의 완벽에 가깝지만, 2025년의 독립 연구에 따르면 AI humanizer를 거친 뒤에는 정확도가 58%로 떨어집니다.
QuillBot은 가장 인기 있는 AI 패러프레이저 중 하나도 만들고 있으므로, 자체 탐지기는 다른 도구들이 만들어내는 바로 그 유형의 바꿔쓴 텍스트를 처리해야 합니다. 그래서 이 도구에서는 패러프레이징과 AI humanizer의 차이가 특히 자주 등장합니다.
QuillBot의 AI 탐지기는 무엇인가요?
QuillBot의 AI Detector는 QuillBot의 글쓰기 제품군에 포함된 도구로, 패러프레이저, 문법 검사기, 표절 검사기, AI humanizer와 나란히 있습니다. QuillBot은 GPT-6, Gemini, Claude, Llama 및 기타 모델에서 생성된 텍스트를 탐지하도록 학습되었으며, 영어, 스페인어, 프랑스어, 포르투갈어를 포함해 20개가 넘는 언어를 지원한다고 말합니다. 텍스트만 검사합니다. 이미지는 별도의 QuillBot AI Image Detector를 통해 처리됩니다.
QuillBot은 Learneo, Inc.가 소유하고 있으며, 탐지기는 교사, 편집자, SEO 팀, 출판사, 연구자들이 사용한다고 설명합니다. QuillBot은 결과를 어떻게 활용해야 하는지에 대해 분명히 안내합니다. 점수는 판결이 아니라 신호이며, 학업 또는 고용과 관련된 어떤 결정도 탐지기 점수만으로 내려서는 안 된다고 말합니다.
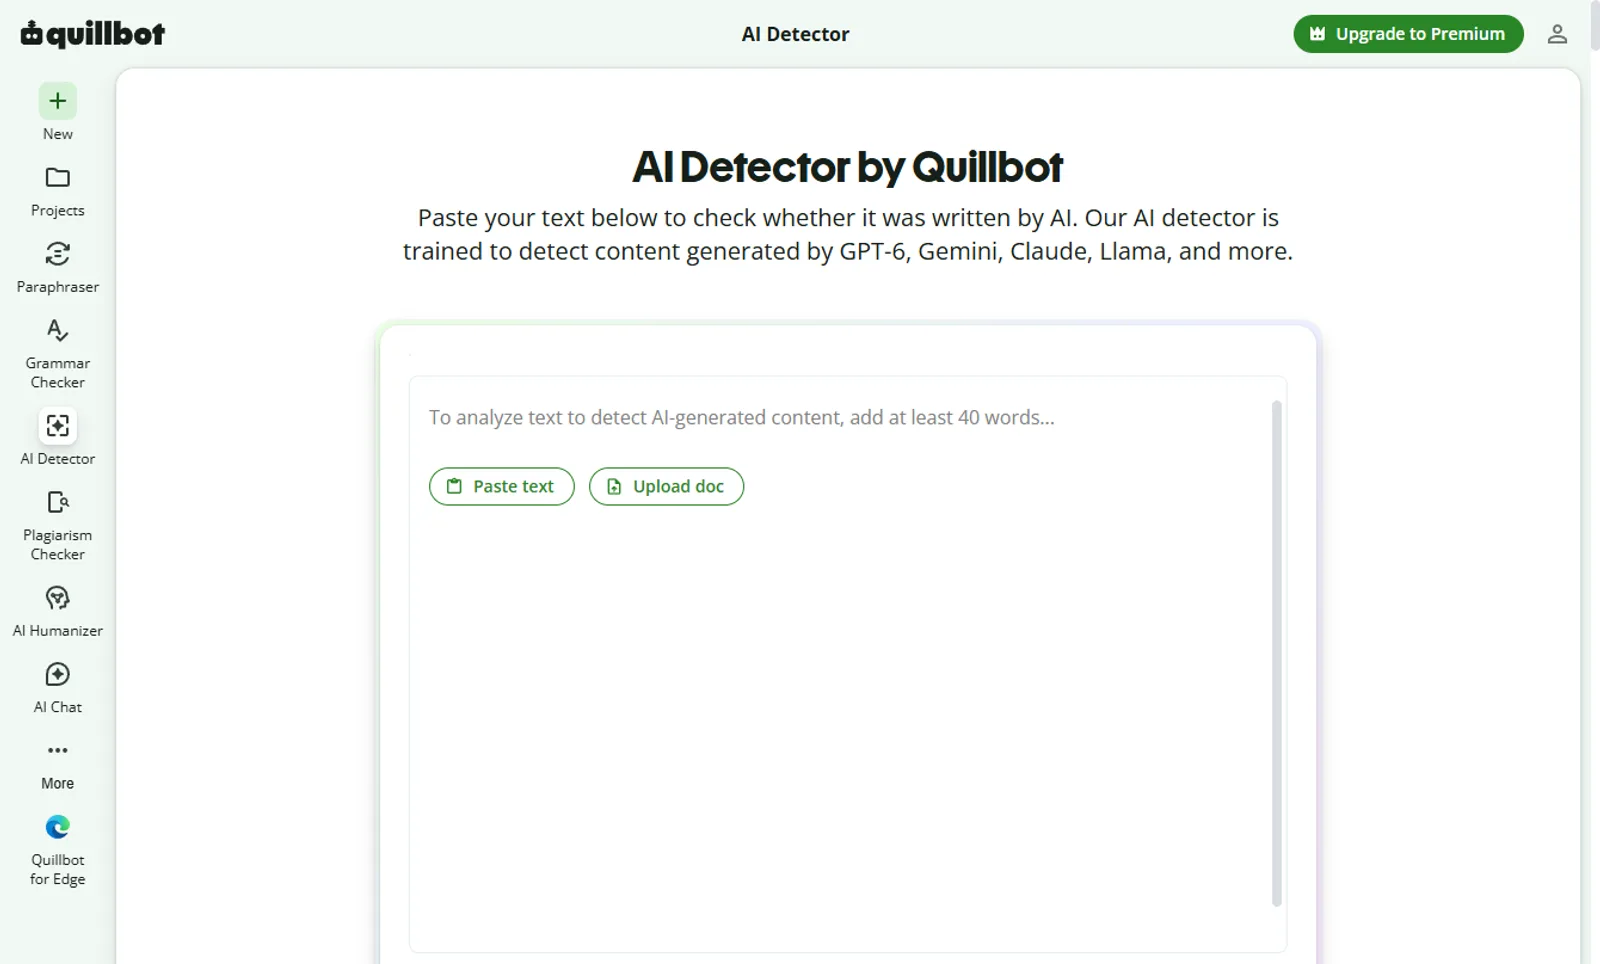
QuillBot의 AI 탐지기 사용 방법
- QuillBot의 AI Detector 페이지를 엽니다.
- 최소 80단어를 붙여넣거나 문서를 업로드하세요. QuillBot은 300단어 이상일 때 가장 신뢰할 수 있는 점수를 얻을 수 있다고 말합니다.
- AI를 탐지하기를 클릭하세요.
- 텍스트의 각 부분에 대한 전체 점수와 라벨을 읽어보세요.
- 표시된 문장 옆의 설명 카드(card)를 열어 왜 표시되었는지 확인하세요. 무료 플랜에서는 스캔당 카드가 1개 표시됩니다.
QuillBot은 전체 텍스트를 한 번에 스캔할 것을 권합니다. 문장을 문장 단위로 확인하며 더 긴 텍스트일수록 모델이 작업할 근거가 더 많기 때문입니다. 프리미엄 사용자는 전체 리포트를 다운로드해 공유할 수도 있습니다.
QuillBot의 탐지기가 텍스트에 라벨을 붙이는 방식
QuillBot 스캔은 0%부터 100%까지의 점수를 반환합니다. 또한 다음 세 가지 라벨 중 하나를 함께 반환합니다: AI 생성, 사람이 작성, AI 다듬음. QuillBot은 사람이 시작한 글에 대해 AI 도구가 편집하거나 패러프레이즈한 경우에 AI 다듬음 라벨을 사용합니다. 이는 모델이 처음부터 작성한 텍스트와는 다른 경우입니다. QuillBot은 어떤 경우든, 먼저 어떤 도구를 먼저 사용했는지에 상관없이 동일한 세 가지 라벨을 적용합니다.
실제로 세 라벨은 세 가지 흔한 상황에 대응됩니다. 손대지 않은 채로 그대로 붙여넣은 ChatGPT나 DeepSeek의 완성형 답변은 대개 AI 생성으로 라벨링됩니다. 문법만 수정한 정도의 사람 작성 초안은 문장 구조를 건드리지 않는 편집이므로 대개 사람이 작성으로 유지됩니다. 패러프레이저가 바꿔쓴 사람 초안이거나 AI humanizer로 다시 쓴 경우가 QuillBot이 AI 다듬음 라벨을 만들게 된 케이스입니다.
각 표시 문장 옆에 짧은 사유(예: 예측 가능한 표현 또는 비정상적으로 균일한 리듬)가 붙은 설명 카드가 표시됩니다. 이 두 신호인 예측 가능한 표현과 문장 리듬은, AI 탐지기가 한 가지 이름으로 부르든 다른 이름으로 부르든 대개 사용하는 척도인 ‘퍼플렉서티’와 ‘버스트니스’와 맞물립니다. 저희 AI 탐지에서 퍼플렉서티 이해하기에서는 이 작동 방식을 더 자세히 다룹니다.
QuillBot은 스캔에 최소 80단어가 필요하며, 정확도는 300단어 이상에서 가장 좋다고 말합니다. 맥락에서 떼어 낸 한 문단처럼 짧은 구절은 모델이 작업할 수 있는 정보가 훨씬 적어집니다. 결과가 불명확할 때 QuillBot은 자신의 모델이 해당 텍스트를 사람이 쓴 글로 라벨링할 가능성이 더 높다고 설명하며, 이는 오탐(거짓 양성) 비율을 낮춥니다. 문장 단위로 확인하기 때문에, AI로 다듬은 문단 하나만 포함된 긴 논문이 전체적으로 반드시 AI 생성 점수를 받는 것은 아닙니다.
이러한 라벨은 모두 영구적이지 않습니다. QuillBot은 수정 후 동일한 텍스트를 다시 스캔할 수 있으며, 표현이 바뀌면 라벨이 범주 간 이동할 수 있습니다. 단일 스캔에서 나온 점수는 그 문서의 해당 버전에만 적용됩니다. 문서가 어떤 방식으로 작성되었는지는 보여주지 않으며, QuillBot은 자사 탐지기가 텍스트가 인간이 작성했는지 또는 원본인지 여부를 검증할 수 없다고 말합니다.
사이트 운영자와 블로거도 발행된 페이지에 대해 QuillBot 인증서와 검증 배지를 요청할 수 있으며, 이를 통해 해당 페이지가 사람이 작성했음을 보여줄 수 있습니다. 이 기능은 메인 스캔 박스와는 별개이며, 라이브 페이지에서 저작자임을 증명하고자 하는 발행자들을 위한 것입니다.
2025년 연구: DeepSeek에서의 QuillBot, 의역 및 AI humanizer 처리 텍스트
Hulayyil Alshammari와 Praveen Rao의 2025년 연구는 arXiv에 게시되었으며, DeepSeek-v3의 텍스트에 대해 6가지 AI 탐지기를 시험했습니다. 이 6가지는 AI Text Classifier, Content Detector AI, Copyleaks AI Detector, QuillBot, GPT-2, GPTZero였습니다. 연구진은 LLM 시대 이전에 작성된 사람이 만든 질문과 답변 쌍 49개로 시작한 뒤, 동일한 질문들에 대해 DeepSeek-v3로 생성된 49개의 대응 답변을 만들었습니다. 이어서 AI 답변을 의역하고 AI humanizer 처리하여 196개의 추가 샘플을 더했고, 전체 세트에 대해 6가지 탐지기를 모두 평가했습니다.
DeepSeek-v3는 대부분의 공개 탐지기들이 튜닝되어 있는 모델들보다 더 새로운 모델이라서 이 연구가 유용한 한 가지 이유가 됩니다. ChatGPT-style 출력에 주로 맞춰 만들고 훈련한 탐지기는, 다른 모델이 같은 방식으로 작성했을 때를 자동으로 그대로 처리하지는 못합니다. 또한 대규모 언어 모델이 존재하기 전 실제 인간이 작성한 답변을 기준으로 시작하면, 인간 예시 자체가 AI의 영향을 받았을 가능성도 배제할 수 있습니다.
| 조건(DeepSeek-v3 텍스트) | 연구에서의 QuillBot 결과 |
|---|---|
| 원본, 편집되지 않음 | 거의 완벽 |
| 의역됨 | 거의 완벽 |
| AI humanizer 처리됨 | 58% 정확도 |
QuillBot과 Copyleaks는 원본 및 의역된 DeepSeek 텍스트에서 모두 거의 완벽했는데, 이는 해당 샘플들을 매우 거의 놓치지 않았다는 뜻입니다. 연구에 포함된 다른 도구들, 예를 들어 AI Text Classifier와 GPT-2는 같은 샘플에서 일관되지 않은 결과를 보였습니다. 여섯 가지 탐지기 전체에서 정확도에 가장 큰 영향을 준 변화는 텍스트를 AI humanizer 처리한 것이었습니다. Copyleaks는 71%로, QuillBot은 58%로, GPTZero는 52%로 각각 낮아졌습니다.
이 연구의 텍스트 세트는 디텍터 벤치마크 기준으로는 규모가 modest합니다. 원문 사람 답변 49개, 수정하지 않은 DeepSeek-v3 답변 49개, 그리고 그 AI 답변을 바탕으로 의역과 AI humanizer 처리로 추가 구성한 196개가 포함되어 있습니다. 여섯 가지 디텍터 전반에서 뚜렷한 패턴이 있음을 보여주기에 충분하지만, 더 큰 세트라면 백분율을 더 정확하게 산출할 수 있습니다. 이 논문은 전용 탐지 모델 대신 few-shot 예시와 chain-of-thought 프롬프트를 사용해 DeepSeek 자체도 디텍터로 테스트했습니다. 해당 부분은 DeepSeek의 자체 분류 능력에 관한 것이며 QuillBot 결과는 포함하지 않습니다.
작가에게 가장 중요한 결론은 간단합니다. 이번 테스트에서 의역은 QuillBot의 정확도를 낮추지 않았으므로, 단어 순서 재배치와 문장 구조 변경만으로는 결과를 바꾸지 못했습니다. 텍스트 AI humanizer 처리만이 QuillBot의 정확도를 떨어뜨렸으며, 그럼에도 QuillBot은 AI humanizer 처리된 샘플 대부분을 탐지했습니다.
학생에게 유용한 포인트는 의역과 재작성의 차이입니다. 의역은 단어와 일부 문장 순서를 바꿉니다. 반면 자신의 이해를 바탕으로 재작성하면 주장, 예시, 구조가 달라지며, 이것이 초고를 ‘자기 것’처럼 만드는 핵심입니다.
AI 디텍터는 QuillBot 의역을 탐지할 수 있나요?
네, 대개 그렇습니다. 위 2025년 연구에서 QuillBot 자체 디텍터와 Copyleaks는, 의역기 처리를 거친 DeepSeek 텍스트에 대해 거의 완벽에 가까운 성능을 보였습니다. Turnitin은 2024년 7월에 AI 의역 탐지를 추가했고, 2025년 8월에는 AI bypasser 탐지를 추가했는데, 이는 humanizers와 고강도 의역기에 의해 생성된 텍스트를 겨냥한 것입니다. QuillBot의 자체 FAQ는 강하게 의역된 텍스트가 어떤 디텍터로도 식별하기 더 어렵다고 말하므로, 결과는 의역기가 얼마나 크게 바꿨는지에 따라 달라집니다.
그 이유는 의역기는 주로 단어를 바꾸고 절의 위치를 재배치하기 때문입니다. 디텍터는 문장 전반에서 예측 가능한 표현, 고른 리듬 같은 패턴을 살피는데, 단어를 바꾼 뒤에도 이런 패턴은 상당 부분 그대로 남아 있는 경우가 많습니다. QuillBot의 AI-refined 라벨은 바로 이런 상황을 염두에 두고 설계되었습니다. 즉, 사람이 쓴 텍스트를 AI 도구가 편집하거나 의역한 경우입니다.
과제에서 출처를 의역해 사용한다면, 더 큰 쟁점은 보통 인용입니다. 의역된 아이디어라도, 어떤 도구가 표현을 바꿨든 그 개념의 출처에 대한 참조는 필요합니다. 의역과 표절의 차이 가이드에서 그 경계선이 어디인지 설명합니다.
QuillBot의 AI humanizer는 의역기와 같은가요?
아니요. QuillBot은 이를 두 가지 도구로 구분해 취급합니다. QuillBot의 의역기는 문단을 새로운 말로 바꾸며, 무료 요금제에서는 Standard와 Fluency 같은 모드가 제공되고 Premium에서는 9가지 모드가 제공됩니다. 반면 QuillBot의 AI Humanizer는 텍스트를 대체로 그대로 유지하면서 문장 구조, 문장 길이, 단어 선택을 바꿔 AI 텍스트를 쉽게 알아볼 수 있게 하는 패턴을 제거합니다. 이것이 QuillBot이 설명하는 두 기능의 차이입니다.
AI humanizer는 영어에서 US, UK, Australian, Canadian 방언을 지원하며, 스페인어, 프랑스어, 독일어, 포르투갈어에서도 동작합니다. 무료 요금제에서는 제한적인 사용과 함께 최대 125단어까지 AI humanizer 처리할 수 있습니다. Premium은 연간 청구 기준 월 US$4.95로, 전체 이용이 가능하며 더 깊은 재작성, 긴 텍스트, 그리고 이전 실행 내역까지 제공합니다. QuillBot은 AI humanizer가 글쓰기 향상을 위한 것이지 AI 탐지를 회피하는 도구가 아니라고 말합니다. 또한 소속 기관이나 고용주의 정책에 따라 AI 사용을 공개하도록 사용자에게 요청합니다.
학술 글쓰기에서 중요한 차이는 인용문과 분야 용어에 어떤 일이 일어나는지입니다. AI humanizer는 본문 내 인용, 참고문헌 형식, 고정된 용어를 사용자가 넣은 그대로 정확히 유지하도록 설계되어 있으며, 일반적인 리라이터는 이런 목적에 맞춰져 있지 않습니다. QuillBot Humanizer 대안 가이드에서는 Turnitin에 대해 두 가지를 비교하고, ProofreaderPro.ai 대 QuillBot 비교에서는 전체 구성 제품을 다룹니다.
구조를 단어와 함께 다시 쓰기
AI humanizer는 단어 선택뿐 아니라 문장 리듬과 구조도 바꿉니다. 그리고 인용문, 기술 용어, 숫자는 그대로 유지됩니다.
ProofreaderPro.ai 무료 사용 시도QuillBot이 정확도에 대해 말하는 내용
QuillBot은 RAID에서 99% 탐지율을 인용합니다. 이는 여러 대형 언어 모델을 포괄하는 독립 벤치마크입니다. 우리는 Grammarly의 AI detector 글에서 RAID가 무엇을 테스트하는지 설명하는데, 해당 글은 RAID 리더보드에서 1위를 차지합니다.
QuillBot의 FAQ는 정확도에 영향을 주는 세 가지 요소를 언급합니다. 300단어 이상 텍스트는 짧은 입력보다 더 신뢰할 수 있는 점수를 제공합니다. 과도하게 의역했거나 AI 편집이 약하게만 반영된 글은 어떤 탐지기든 식별하기가 더 어렵습니다. 학술 정의, 법률 문서 원문, 구조화된 템플릿 같은 정형화된 인간 글쓰기는 예상보다 더 높은 점수를 받을 수 있습니다. 또한 QuillBot은 어떤 AI detector도 100% 정확도에 도달하지 못하며, 결과는 더 넓은 검토 과정에서 하나의 입력으로 활용해야 하는 확률 추정치라고 말합니다.
위의 2025년 연구는 더 새로운 모델 DeepSeek-v3에 대한 독립 데이터 포인트를 추가했는데, 많은 탐지기는 원래 이를 위해 조정되지 않았습니다.
무료 vs 프리미엄
| 기능 | 무료 | 프리미엄 |
|---|---|---|
| 스캔 1회당 단어 제한 | 최대 1,200단어 | 단어 제한 없음 |
| 일일 스캔 횟수 | 최대 6회 | 무제한 |
| 설명 카드 | 스캔당 1개 | 전체 텍스트 기준 무제한 |
| 다운로드 가능한 보고서 | 아니요 | 예 |
| 가격 | US$0 | 월 US$4.95(연 단위 결제) |
QuillBot의 무료 AI Detector는 각 스캔을 1,200단어로 제한하고 하루 6회 스캔을 허용하며, 스캔당 설명 카드 1개를 제공합니다. 프리미엄은 두 가지 제한을 모두 없애고, 탐지된 각 문장마다 전체 설명을 추가합니다. 나머지 QuillBot 도구도 동일한 가격으로 포함되며, 연 단위 결제 시 월 US$4.95입니다. 여기에는 패러프레이저와 humanizer에 대한 전체 액세스, 그리고 월 25,000단어의 표절 검사 기능이 포함됩니다.
단 한 번의 짧은 과제를 확인하는 사람이 라면 무료 한도에 도달할 가능성은 낮습니다. 한 번의 스캔은 띄어쓰기 2배 간격 기준으로 약 4페이지 분량을 커버하기 때문입니다. 6,000단어 분량의 문헌고찰을 1,200단어 단위로 나누어 확인하면 무료 플랜에서 하루 6회 제한 안에서 총 5번 스캔하면 됩니다. 더 긴 학위논문 챕터를 한 자리에 앉아서 여러 차례 확인하는 경우가 일일 한도에 가장 쉽게 닿는 구간입니다. 프리미엄은 전체 보고서를 다운로드할 수 있게 해주기도 합니다. 이는 감독자나 편집자가 최종 백분율뿐 아니라 설명의 세부 정보를 확인하고 싶을 때 유용합니다.
QuillBot의 detector와 Turnitin
QuillBot의 AI Detector와 Turnitin은 서로 다른 두 회사가 만든 별도의 도구이며, 한 쪽의 점수는 다른 쪽 점수를 예측하지 못합니다. Turnitin은 AI 글쓰기 탐지를 학교, 대학, 출판사에 라이선스하므로, 대부분의 학생은 Turnitin 결과를 강의를 진행하는 담당자를 통해서만 확인하게 됩니다. Turnitin 점수 안내에서는 Turnitin이 자체 AI 수치와 유사도 수치를 어떻게 표시하는지 다룹니다.
2025년 8월, Turnitin은 AI bypasser detection이라는 기능을 추가했는데, 이는 AI humanizer를 거쳤거나 강도 높은 패러프레이저를 거친 텍스트를 대상으로 하는 일련의 모델입니다. 이 기능은 현재 영어만 지원합니다. QuillBot Humanizer 대안 가이드에서는 이번 업데이트가 QuillBot의 자체 humanizer에 대해 구체적으로 무엇을 의미하는지 살펴봅니다.
두 도구 간의 차이는 Turnitin-enabled 과정으로 제출하는 모든 사람에게 가장 중요합니다. QuillBot 점수가 설령 안심할 만하다고 해도, Turnitin의 자체 AI 작성 보고서가 낮은 점수를 표시할지 여부는 말해주지 않습니다. 두 도구는 서로 다른 학습 데이터와 서로 다른 임계값을 사용해요.
위의 DeepSeek 연구는 비슷한 분리를 보여줍니다. 단순 바꿔쓰기만으로는 QuillBot이나 Copyleaks의 정확도가 떨어지지 않았지만, humanizing은 정확도를 낮췄습니다. Turnitin의 2025 업데이트는 같은 간극을 겨냥합니다. 즉, 감지기가 측정할 수 있는 구조적 패턴을 그대로 갖고 있으면서도 읽는 방식이 충분히 달라진 문구를 목표로 한 거죠.
과정에서 Turnitin을 사용한다면, QuillBot 스캔은 자신의 초안을 점검하기 위한 기준으로만 취급하고, 결과는 메모와 함께 보관하세요. 나중에 지도교수가 Turnitin 결과에 의문을 제기한다면, 어떤 점수보다도 당신의 초안과 메모가 더 나은 증거가 됩니다. 이는 프로세스는 새로운 ‘증거’다에서 설명한 것과 같습니다.
Scribbr의 무료 AI Detector는 QuillBot의 자체 기술을 기반으로 동작합니다. Scribbr의 detector 페이지는 quillbot.scribbr.com에서 스캔을 불러오는데, 이는 Scribbr 사이트를 위해 마련된 QuillBot의 하위 도메인이고, Scribbr용 파트너 스크립트를 통해 로딩됩니다. 우리의 Scribbr AI Detector에서는 이것이 Scribbr의 자체 결과에 대해 무엇을 의미하는지 다룹니다.
AI 초안을 humanizing 했다면, 그 단 하나만 믿고 있는 것이라면 위 연구는 한 번 더 살펴볼 가치가 있습니다. 자신의 메모에서 내용을 다시 쓰되 자신의 예시와 자신의 구조로 바꾸면, 바꿔쓰기 도구가 바꾸는 것보다 글 전체에 더 큰 변화를 줍니다. 먼저 도구를 비교해보고 싶다면, QuillBot 대안 for academic writing에서 QuillBot이 학술 초안에서 어떤 위치를 차지하는지 확인할 수 있습니다.
어떤 경로를 택하든 QuillBot의 자체 안내는 그대로 적용됩니다. 검출 점수가 무엇이든, 과정이나 고용주의 정책에 따라 AI 지원 여부를 공개하세요. academic humanizer는 단어 선택뿐 아니라 문장 구조까지 바꿔 AI 검사에서 낮은 점수를 받도록 설계되었고, 인용문, 기술 용어, 숫자는 건드리지 않습니다.
자주 묻는 질문
Q: QuillBot의 AI Detector는 무료인가요?
네. 무료 버전은 한 번 스캔에서 최대 1,200단어까지 확인하고, 하루 최대 6번 스캔을 제공합니다. 스캔마다 설명 카드가 1장 포함됩니다. Premium은 US$4.95/월(연 단위 결제로 청구)로 해당 한도를 제거합니다.
Q: QuillBot의 AI Detector는 정확한가요?
QuillBot은 RAID 벤치마크에서 99% 검출률을 인용합니다. 2025년 연구에서는 편집하지 않은 상태와 바꿔쓰기한 DeepSeek 텍스트에서 거의 완벽했으며, humanized 텍스트에서는 58% 정확했습니다. 어떤 검출기든, 학술 정의처럼 정형화된 인간 글쓰기를 표시할 수 있습니다.
Q: QuillBot의 AI Detector는 자체 바꿔쓰기 결과를 탐지할 수 있나요?
네. 평범하게 바꿔 쓴 텍스트에서는 가능합니다. Alshammari와 Rao의 2025년 연구에 따르면, paraphraser를 거친 DeepSeek-v3 텍스트에서 QuillBot의 detector는 거의 완벽에 가까웠습니다. 같은 텍스트를 humanizing하면 더 큰 난관이 생겨, 그 연구에서 QuillBot의 정확도가 58%로 떨어졌습니다.
Q: AI Detector는 QuillBot 바꿔쓰기(패러프레이징)를 탐지할 수 있나요?
대개는 가능합니다. QuillBot의 detector와 Copyleaks는 2025년 연구에서 바꿔쓰기한 AI 텍스트에 대해 거의 완벽했으며, Turnitin은 2024년 7월부터 AI 바꿔쓰기 탐지를 해왔습니다. 바꿔쓰기 비중이 큰 텍스트는 QuillBot의 자체 설명에 따르면 탐지가 더 어렵습니다.
Q: QuillBot의 humanizer는 paraphraser와 같은 건가요?
아니오. QuillBot의 패러프레이저는 글을 새로운 표현으로 다시 쓰고, AI humanizer는 문장 구조, 길이, 단어 선택을 바꾸면서도 내용은 대체로 비슷하게 유지합니다. AI humanizer는 최대 125단어까지는 무료이며, Premium에서는 전체 이용이 가능합니다.
Q: QuillBot의 AI 탐지기는 DeepSeek 텍스트에서도 작동하나요?
네. 동일한 2025년 연구에서 QuillBot을 특히 DeepSeek-v3 출력물에 대해 테스트했으며, 원본과 패러프레이즈된 버전 모두에서 거의 완벽에 가까운 결과를 확인했습니다. 이 결과는 해당 테스트에서 Copyleaks의 성능과도 일치했습니다.
**Q: QuillBot에서 **"AI-refined"는 무엇을 의미하나요?
QuillBot에서 말하는 AI-refined는 한 사람이 직접 쓴 글을 시작으로, 그다음 AI 도구로 편집하거나 패러프레이즈한 글을 뜻합니다. QuillBot은 문장 단위로 점수를 매기므로, AI-refined 처리된 한 단락이 있다고 해서 문서 전체가 AI 생성 결과로 바뀌지는 않습니다.
Q: 무료로 확인할 수 있는 단어 수는 얼마인가요?
스캔 기준 최대 1,200단어까지 가능하며, QuillBot의 무료 플랜에서는 하루 최대 6번까지 스캔할 수 있습니다. Premium은 US$4.95/월로, 연 단위로 청구되며 이 두 제한 모두 제거됩니다.
Q: 검출기만을 위해 QuillBot Premium을 쓰는 게 가치가 있을까요?
사용 빈도와 문서 길이에 따라 달라집니다. Premium은 1,200단어 상한과 하루 6회 스캔 제한을 제거하고, 플래그된 각 문장에 대한 전체 설명을 추가하며 보고서를 다운로드할 수 있게 해줍니다. 나머지 QuillBot 도구들은 같은 가격에 포함됩니다.
Q: Turnitin은 QuillBot의 패러프레이징을 감지할 수 있나요?
대개는 가능합니다. Turnitin은 2024년 7월에 전용 AI-패러프레이징 탐지 기능을 추가했고, 2025년 8월에는 humanizer 또는 강력한 패러프레이저를 거친 텍스트를 대상으로 한 AI-bypasser 레이어를 추가했습니다. QuillBot 휴머니저 대안 가이드에서는 전체 흐름을 다룹니다.
Q: QuillBot의 탐지기는 다른 언어에서도 작동하나요?
네. QuillBot은 AI Detector가 영어, 스페인어, 프랑스어, 포르투갈어를 포함해 20개가 넘는 언어를 지원한다고 말합니다. 반면 AI Humanizer는 지원 언어가 더 적습니다. 스페인어, 독일어, 프랑스어, 포르투갈어, 그리고 영어 방언 4종입니다.
Q: QuillBot의 탐지기는 Scribbr의 것과 같은가요?
대체로 그렇습니다. Scribbr의 AI Detector 페이지는 quillbot.scribbr.com에서 스캔을 가져오는데, 이는 QuillBot의 하위 도메인입니다. 페이지에는 QuillBot 파트너 스크립트가 임베드되어 있어, 그 스크립트를 통해 스캔이 로드됩니다. Scribbr의 AI 탐지기를 살펴보기에서는 Scribbr이 같은 도구로 어떤 방식으로 자체 결과를 제시하는지 설명합니다.
인용문, 용어, 의미는 그대로 두고 AI 도움을 받은 학술 초안을 다시 작성하세요.
Dana는 ProofreaderPro의 콘텐츠 제작자로서 매일 블로그를 운영하고 글쓰기 작업을 진행합니다. 그녀는 온라인 편집 플랫폼의 작동 방식에 대한 기사를 작성하고 매일 고객 메시지를 처리하며 이에 대한 만족도 점수는 별 5개입니다.