
영어로 글을 쓰는 프랑스 연구자를 위한 AI 휴머니저
프랑스 연구자를 위한 AI 휴머니저입니다. 프랑스식 영향이 반영된 영어에서 발생하는 오탐(오인) AI 탐지 플래그를 줄이되, 의미와 인용문헌은 그대로 유지하며 정직하게 AI 사용을 공개하세요.

프랑스는 연간 약 62,200편의 Scopus 색인 논문을 발표하는데, 이는 세계에서 11번째로 큰 연구 성과 규모입니다. 프랑스의 연구 생산성은 국내총생산(GDP)의 약 2.2%에 해당하는 재정 지원과, CNRS, INSERM, INRIA, CEA를 포함한 촘촘한 대학·그랑제콜(Grandes Écoles)·국가 기관 네트워크에 뒷받침됩니다. 30만 명이 넘는 연구자들이 이 시스템을 가동하고 있으며, 그들 대부분이 영어로 출판합니다.
이제 많은 연구자들이 ChatGPT, Claude 또는 번역 도구의 도움을 받아 초안을 만든 뒤 결과물을 다듬습니다. 프랑스 연구자를 위한 AI 휴머니저는 바로 이 순간을 위해 존재합니다. 즉, 자신의 의미와 인용문헌을 그대로 보존하면서, 다듬은 글이 기계가 쓴 글로 오독될 가능성을 낮추기 위한 목적입니다. 이는 일상적인 학술 관행이며, 문제는 검출기가 신중하고 표준적인 영어를 읽고도 생성된 글이라고 판단할 때에서야 시작됩니다.
오탐은 드문 우연이 아닙니다. 프랑스 연구자들이 공들여 만들어내는 제2외국어 영어의 ‘정교함’은 탐지기가 가장 자주 잘못 판별하는 글의 유형과 정확히 맞닿아 있습니다.
프랑스 연구자·연구자 여성을 위한 AI 텍스트 휴머니저
우리 AI 텍스트 휴머니저는 프랑스어권 연구자들이 자신의 연구를 기계가 생성한 글로 부당하게 신호되는 일 없이, 영어로 출판할 수 있도록 돕습니다. 의미, 전문 용어, 인용문헌은 그대로 보존하면서 리듬과 어휘를 다양화하여 글을 더 자연스럽게 만듭니다.
간단히 말해, 이 휴머니저는 이미 사용자가 작성했거나(또는 AI 도움으로 초안을 작성한 뒤) 다시 다듬은 영어에 작동합니다. 새로운 발견을 만들어내지 않으며, AI를 사용했다는 사실을 숨기지도 않습니다. 탐지기가 달라붙는 평탄하고 반복적인 리듬을 완화해, 여러분의 정교한 글이 실제로 무엇인지, 즉, 인간 연구자의 작업, 로 읽히게 합니다.
프랑스어로 초안을 쓰나요? 휴머니저가 그것도 감지하고 처리합니다
모든 초안이 영어에서 시작되는 것은 아니며, 휴머니저도 이를 요구하지 않습니다. 프랑스어 텍스트를 붙여 넣으면 ProofreaderPro가 언어를 스스로 감지한 뒤, 악센트·용어·참조를 그대로 유지하는 ‘프랑스어 인지 모델’로 라우팅합니다. AI 텍스트 휴머니저로서 프랑스어 산문을 직접 재작성하므로, 번역 ‘후’가 아니라 번역 ‘전에’ 먼저 휴머니즈할 수 있습니다. 동일한 자동 감지는 60개가 넘는 언어에 적용되며, 각 언어는 해당 언어의 고유한 레지스터로 처리됩니다.
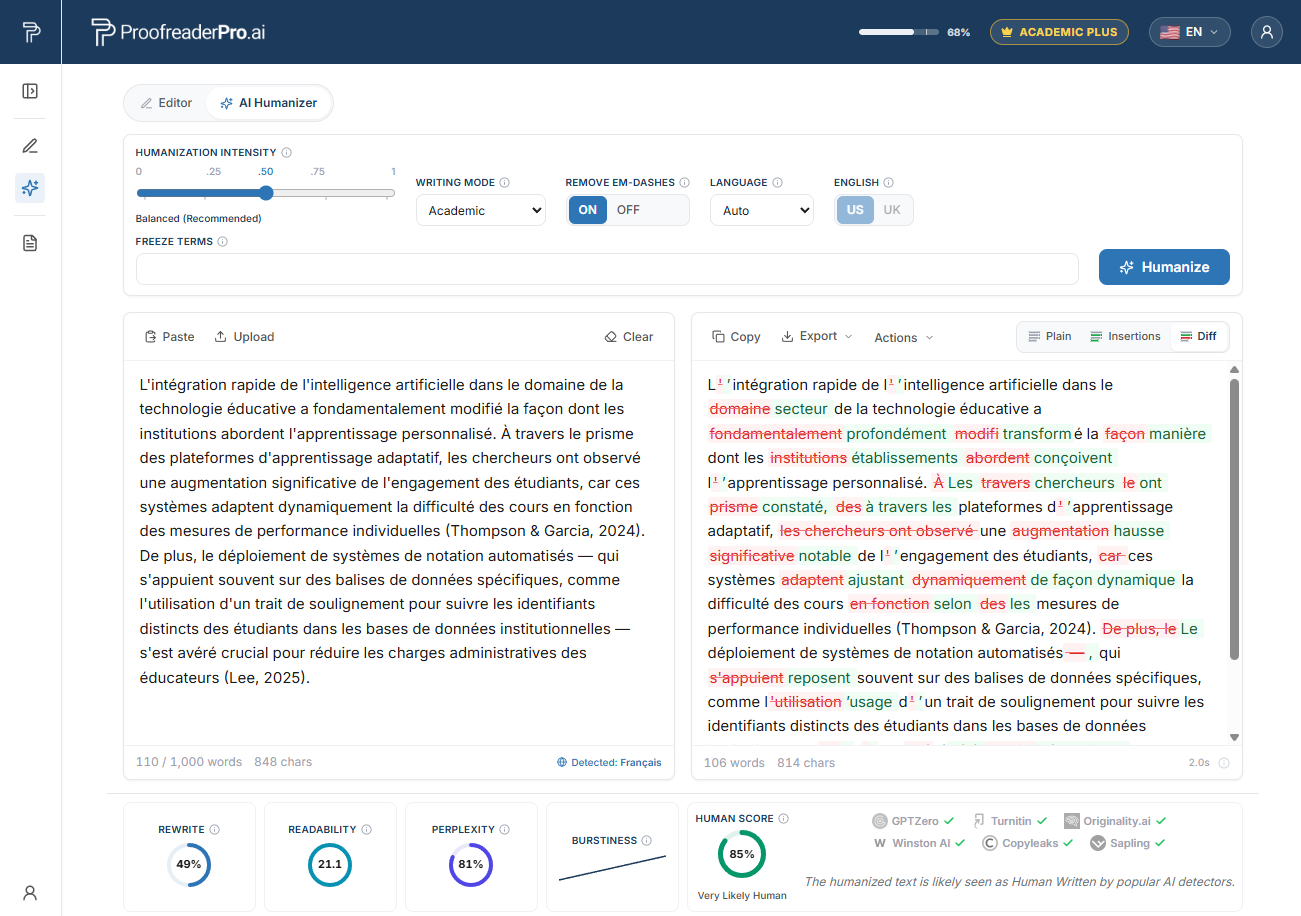
프랑스 학술 텍스트를 재작성하는 ProofreaderPro AI 휴머니저. before/after diff는 의미와 인용문헌을 그대로 유지하며, 검출기 체크는 자연스러운 인간의 읽기를 확인합니다.
왜 프랑스 연구자는 AI 탐지기에 걸리게 될까
가장 명확한 근거는 2023년 스탠퍼드 연구입니다. Liang과 동료들이 2023년 Cell Press 저널 Patterns에 「GPT detectors are biased against non-native English writers」라는 제목으로 발표했습니다. 연구진은 사람이 쓴 TOEFL 에세이를 일곱 가지 널리 사용되는 탐지기에 통과시켰습니다.
평균적으로 비원어민 에세이의 약 61%가 AI로 플래그 처리된 반면, 원어민 영어 글은 약 5%였습니다. 비원어민 에세이 가운데 거의 5분의 1, 즉 약 19.8%는 모든 탐지기가 만장일치로 플래그했습니다. 모든 에세이는 사람에 의해 작성되었습니다.
핵심 메커니즘은 ‘퍼플렉서티(perplexity)’입니다. 많은 탐지기는 각 단어 선택이 언어 모델에 얼마나 ‘놀랍게’ 나타나는지를 점수화합니다. 제2언어를 꼼꼼히 쓰는 연구자는 흔한 단어와 표준적이며 예측 가능한 문구를 선택하는 경향이 있는데, 그 결과 퍼플렉서티가 낮아지고 이는 기계가 쓴 텍스트처럼 읽힙니다. 비원어민 학술 산문을 명료하게 만드는 습관이야말로, 탐지기가 가장 믿지 않도록 훈련된 습관입니다. 우리는 왜 AI 탐지기가 비원어민을 플래그하는지에서 전체 메커니즘을 자세히 설명합니다.
오탐의 배경이 되는 프랑스어(모국어) 패턴
프랑스어와 영어는 수천 개의 단어를 공유하고, 수세기 동안의 교류를 통해 축적된 언어적 영향이 큽니다. 따라서 프랑스 연구자들은 큰 규모의 ‘수동적 영어 어휘’를 지니고 있습니다. 이 공유 어휘 내부의 함정을 피하려고, 그들은 방어적으로 글을 씁니다. 이러한 방어적 신중함은 좋은 학술 태도이기도 하며, 동시에 탐지기가 생성 글로 간주하는 낮은 퍼플렉서티의 문장 리듬을 만들어냅니다.
동의어 같아 보이는 ‘가짜 친구’는 가장 안전한 단어로 유도한다. False cognates(겉보기만 유사한 단어)가 가장 날카로운 함정입니다. 예를 들어 「actually」는 「actuellement」(현재)가 아니고, 「eventually」는 「eventuellement」(가능하게/아마)와 같지 않으며, 「experience」는 흔히 「experiment」(실험)를 뜻하는 용도로 사용됩니다. 경험 많은 프랑스어 저자들은 매번 가장 흔하고 위험이 가장 적은 영어 단어를 선택함으로써 이러한 함정을 정확히 피해갑니다. 탐지기가 기계 텍스트와 연관시키는 것은 바로 이런 ‘일상적인’ 어휘입니다.
불가산 명사는 과잉 교정을 부른다. 프랑스어는 영어가 단수로 유지하는 명사를 복수형으로 바꿉니다. 예컨대 「informations, researches, equipments, evidences, advices」처럼 쓰이곤 합니다. 교정이 끝난 뒤에는 연구자들이 간단한 교과서적 구성으로 문제를 ‘돌아가’ 글을 쓰는 경향이 생깁니다. 검토자 입장에서는 예측 가능함이 안전하지만, 탐지기 관점에서는 의심 신호가 됩니다.
추상 개념과 함께 쓰는 관사는 평탄하게 ‘훈련’된다. 프랑스어는 거의 모든 명사에 관사를 붙입니다(예: 「la science, le bonheur」). 그래서 신중한 글쓰기 습관을 가진 사람일수록 영어 일반화에서는 관사를 빼도록 스스로 훈련합니다. 그 결과는 깔끔하고 규칙에 정확히 맞춘 문장 표현이며, 이런 ‘규칙에 맞는 문장’이 퍼플렉서티 점수에서 자동화된 문장으로 읽힙니다.
부사 위치가 표준화된다. 프랑스어는 부사를 동사 뒤에 둡니다(예: 「We analyzed carefully the results」). 영어 규칙을 배운 저자들은 이를 관례적 위치로 옮깁니다(예: 「We carefully analyzed the results」). 문장이 매끄럽고 균일해지며, 문단 전체의 균일한 리듬은 퍼플렉서티를 낮춥니다.
전치사가 암기되어 동일하게 적용된다. 프랑스어는 전치사를 영어와 다르게 매핑합니다. 예컨대 「consist in, depend of, interested to, responsible of」처럼 말입니다. 신중한 저자들은 영어에서의 대응 관계를 학습하고, 이를 완전한 일관성으로 적용합니다. 완벽하게 일관된 문체는 또 하나의 ‘생성된 글’로 읽히는 요인이 됩니다.
긴 절(Clause) 연쇄는 짧게 잘린다. 프랑스 학술 문체는 하위 절을 쌓아 올린 긴 문장을 선호합니다. 영미권 독자는 더 짧은 문장을 선호한다는 말을 듣고, 프랑스 연구자들은 종종 자신의 글을 짧고 고른 선언문 단위로 잘라냅니다. 여러 문장에 걸친 ‘문장 길이의 균일성’은 탐지기가 사용하는 가장 강력한 신호 가운데 하나입니다.
이들 요소는 교정 이후에는 오류가 아닙니다. 그것은 성실한 비원어민 작가의 흔적이며, 바로 그 성실함이 오독의 원인이 됩니다.
프랑스의 AI 탐지와 Turnitin 맥락
대부분의 프랑스 박사 과정(écoles doctorales)과 학술지는 Turnitin 또는 iThenticate로 유사도를 검사하며, 많은 곳에서는 유사도 수치 옆에 AI 작성 표시 지표를 함께 노출하기 시작했습니다. 프랑스의 연구윤리(integrity) 환경도 그와 병행해 강화되었습니다. 대학은 referents integrite scientifique(연구윤리 담당관)를 임명하고, 연구비 지원자와 학술지는 저자들에게 AI 보조를 사용했는지 점점 더 자주 명시하도록 요구합니다.
그러나 이 모든 것이 AI 사용을 금지한다는 뜻은 아닙니다. 금지의 문제가 아니라 ‘완전한 공개’를 기대한다는 의미입니다. 위험은 공개가 아닙니다. 위험은 ‘주장’에 불과한 내용을 탐지기 점수가 ‘판결’처럼 취급하는 데 있습니다.
이러한 경계는 타당합니다. 2023년 Vanderbilt는 오탐과 비원어민에 대한 편향을 이유로 Turnitin의 AI 탐지기를 비활성화했으며, Michigan State, UT Austin, Northwestern, Pittsburgh, SMU, Waterloo도 유사한 조치를 취했습니다. Turnitin 자체도 1~19% 범위의 점수를 억제해 숫자 대신 별표를 표시하고, 그 점수만으로는 단독으로 윤리성 판단을 내리면 안 된다고 경고합니다. 플래그는 ‘자백’이 아니라, ‘이의 제기’의 대상입니다.
부정확한 AI 감지 오탐으로부터 신중하게 작성하신 영어를 보호하세요
몇 초 만에 자신의 AI 보조 초안을 자연스럽게 다듬으세요. 의미, 용어, 인용문을 그대로 유지한 뒤, 학술지에서 기대하는 방식대로 AI 사용 사실을 공개하세요. 영어로 투고하는 프랑스 연구자를 위해 설계되었습니다.
Humanizer를 무료로 사용해 보세요프랑스 주요 대학과 AI 점검이 나타나는 지점
프랑스는 대학, 그랑제콜, 그리고 국가 연구 조직을 기반으로 운영되며, 가장 강한 연구 생산자들도 이 세 범주에 모두 걸쳐 있습니다. 현재 이들 기관 전반에서 유사도와 AI 지표에 대한 심사는 일상적으로 수행됩니다.
- Sorbonne Universite (파리), UPMC와 파리-소르본(Paris-Sorbonne)에서 출범했으며 수학, 물리, 의학, 인문 분야에서 강점이 있고 CNRS와의 깊은 협업을 바탕으로 합니다.
- Universite Paris-Saclay (사클레(Saclay)와 오르세(Orsay)), 상하이 랭킹에서 세계 상위 15위권에 꾸준히 포함되며 주요 국가 연구소를 유치하고 있습니다.
- Universite PSL (Paris Sciences et Lettres) (파리), ENS, Dauphine, ESPCI, Mines Paris를 묶는 연합형 대학입니다.
- Universite Paris Cite (파리), 파리 데카르트(Paris Descartes)와 파리 디드로(Paris Diderot)에서 출발했으며 의학·생명과학 분야에서 INSERM과의 강력한 파트너십을 갖추고 있습니다.
- Universite Grenoble Alpes (그르노블(Grenoble)), 물리와 응집물질 분야의 거점이며 ESRF와 Institut Laue-Langevin의 소재지입니다.
- Aix-Marseille Universite (마르세유(Marseille)), 프랑스 최대 규모의 대학으로, 수십 개의 공동 CNRS 연구 단위를 운영합니다.
- Universite de Strasbourg (스트라스부르(Strasbourg)), 화학과 생명과학 분야의 강력한 거점이자 League of European Research Universities의 회원입니다.
- Universite de Bordeaux (보르도(Bordeaux)), 신경과학, 재료과학, 레이저 물리학에서 강점이 있습니다.
- Universite Claude Bernard Lyon 1 (리옹(Lyon)), 화학, 생물학, 물리학 분야에서 주요 연구 거점입니다.
- Ecole Polytechnique (팔레조(Palaiseau)), 프랑스에서 가장 권위 있는 과학·공학 그랑제콜이며 Institut Polytechnique de Paris의 일부입니다.
- Ecole Normale Superieure (ENS) (파리), PSL의 일부인 엘리트 그랑제콜로, 1인당 연구 산출이 비정상적으로 높습니다.
- Universite Toulouse III - Paul Sabatier (툴루즈(Toulouse)), 항공우주, 천체물리학, 화학 분야가 강합니다.
이들 기관 어디에서든 영어권 출판은 HDR 자격, Professeur des Universites로의 승진, 그리고 경쟁적인 CNRS 채용을 좌우합니다. 영어에서의 이해관계가 클수록, 단 하나의 오탐 AI 플래그가 치를 손실도 더 커질 수 있습니다.
프랑스 연구자를 위한 AI 휴머니저는 어떻게 작동하나
작업 흐름은 네 단계로 구성되며, 그 어느 단계에서도 사용자의 작업을 ‘숨기는’ 과정이 포함되지 않습니다.
첫째, 초안을 작성합니다. 영어로 초안을 작성하거나, 추론 흐름이 자연스러운 상태에서 프랑스어로 초안을 작성한 뒤 번역합니다. 어느 경우든 아이디어와 근거는 사용자의 것입니다. 둘째, 문법을 교정합니다. 그래서 가짜 친구, 전치사 실수, 관사 오류가 누군가 읽기 전에 사라집니다. 셋째, 사용자의 AI 보조가 들어간 영어에 AI 휴머니저를 실행합니다. 그러면 의미, 용어, 인용문헌은 사용자가 쓴 그대로 유지하면서도 평탄하고 반복적인 리듬이 끊깁니다. 넷째, 기관과 목표 저널이 요구하는 형식에 따라 AI 사용을 공개합니다.
주요 탐지기에 대해 테스트한 결과, 우리의 휴머니저는 AI 텍스트를 더 자연스러운 인간의 형태로 재작성합니다. 그로 인해 AI 신호는 낮아지고 까다로운 탐지기에서의 통과 가능성은 개선되며, 학술 텍스트에서 문법 정확도는 높은 수준으로 유지됩니다. 이는 보증이 아니라 테스트 결과입니다. 탐지기는 몇 달마다 재학습하므로 어떤 도구도 100% 보장이나 영구적 우회는 약속할 수 없습니다. 이 도구가 신뢰성 있게 수행하는 것은 사용자의 학술적 기여를 보존하면서, 오탐을 유발하는 기계 같은 패턴을 줄이는 일입니다.
이것은 ‘진짜 작업’에 대한 공정성이지, ‘위장’을 위한 것이 아닙니다. 이 오탐이 언어 전반에서 어떤 양상으로 나타나는지에 대한 근거를 원하신다면, 우리의 다국어 AI 휴머니저 허브를 참고하세요. 그리고 프랑스 연구자 관점에서 문법 측면을 깊이 있게 다룬 연구자를 위한 학술 편집 가이드도 확인할 수 있습니다.
프랑스의 지역 지원 기관, 학술지, 그리고 AI 공개 기대
프랑스에서의 출판 압력은 지원자금 제공자와 평가자들을 통해 작동합니다. ANR(Agence Nationale de la Recherche)은 경쟁형 프로젝트를 지원하고, 이를 고평가된 영어권 저널에 발표하는 실적을 기준으로 심사합니다. CNRS는 1,000개가 넘는 연구소에 걸쳐 3만 명이 넘는 연구자를 고용하며, Comite National은 승진(프로모션) 전반에서 출판 실적을 평가합니다. INSERM, CEA, CNES의 연구자들은 국제 학술지에 발표하는 일을 일상적으로 수행합니다. HCERES는 5년마다 연구 단위를 평가하고, CNU는 자격(qualification)을 처리하는데, 이때 출판 산출이 전면에 놓입니다.
프랑스 학술지라도, 해외로 보낼 때는 영어로 된 논문이 필요합니다. 대표적인 학술지로는 Comptes Rendus Mathematique, Comptes Rendus Physique, Comptes Rendus Chimie, Comptes Rendus Biologies (Academie des Sciences), Annales de l'Institut Fourier (그르노블), Annales de l'Institut Henri Poincare (수학 및 이론 물리), European Physical Journal (EDP Sciences와 공동 출판)이 있습니다.
이들 지원자금 제공자와 학술지에서는 이제 AI 사용에 관한 짧은 진술을 요구하는 경우가 점점 늘고 있습니다. 휴머니저가 인용문헌과 의미를 보존하기 때문에, 그 공개는 작성이 비교적 간단합니다. 즉, 사용자는 자신의 초안을 다듬기 위해 AI 보조와 휴머니저를 사용했으며, 연구 결과(발견)는 본인의 것이라고 밝히면 됩니다. 문구가 필요하다면 AI 공개 진술서 가이드를 확인하고, 이미 플래그가 찍힌 상황이라면 오탐 AI 탐지 플래그에 대한 이의제기 가이드가 대응 방식을 안내합니다.
자주 묻는 질문
Q: 프랑스 연구자를 위한 AI 휴머니저는 탐지기를 속이는 데 도움이 되나요?
아닙니다. 이 도구는 ‘탐지기를 속이기’ 위한 것이 아니라, 사용자의 AI 보조 초안을 사람답게 다듬는 데 목적이 있습니다. 허위로 만들거나 빌려온 작업을 위장하려는 용도가 아닙니다. 사용자의 의미와 인용문헌을 그대로 유지하면서, 오탐 플래그를 유발하는 낮은 퍼플렉서티 패턴도 줄여줍니다. 또한 사용자는 기관과 저널이 요구하는 방식 그대로 AI 사용을 공개해야 합니다.
Q: 휴머니저가 인용문헌이나 전문 용어를 바꾸나요?
아닙니다. 이 도구는 참고문헌, 분야별 전문 용어, 그리고 각 주장에 담긴 핵심 내용을 보존합니다. 리듬과 단어 선택을 다양화하고 반복적인 리듬을 제거하므로, 여러분이 쓴 논증은 그대로 살아 있고 기계 같은 질감만 완화됩니다.
Q: Turnitin이나 GPTZero를 통과할 수 있음을 보장하나요?
아닙니다. 신뢰할 수 있는 어떤 도구도 이를 보장할 수 없습니다. 테스트에서 휴머니저는 AI 텍스트를 더 자연스러운 인간의 형태로 재작성해 AI 신호를 낮추고, 문법 정확도는 높은 수준으로 유지하면서 까다로운 탐지기에서의 가능성을 개선했습니다. 이는 보증이 아니라 테스트 결과입니다. 탐지기는 자주 재학습하므로, 어떤 점수든 ‘이의 제기 가능한 주장’으로 취급하고 ‘판결’로 받아들이지 마세요.
Q: 프랑스어로 초안을 작성한 뒤 영어로 번역했습니다. 그래도 사용할 수 있나요?
네. 번역된 학술 산문은 대체로 특히 매끄럽고 표준적이어서, 바로 그 점 때문에 탐지기가 오독하는 경우가 많습니다. 번역된 영어를 휴머니저로 처리하면 의미는 유지하면서 자연스러운 변이를 복원할 수 있으며, 프랑스어뿐 아니라 60개가 넘는 다른 언어에서도 작동합니다.
Q: ANR 또는 CNRS의 무결성(Integrity) 규정에서 휴머니저 사용이 허용되나요?
자신의 글을 다듬고 AI 보조를 공개하는 것은 일반적인 윤리 기대와 부합합니다. 핵심은 정직함입니다. 진정으로 본인 것이어야 할 작업을 휴머니즈하고, 발견(결과)은 바꾸지 않으며, 지원자금 제공자나 저널이 요청할 때 AI 도구를 사용했음을 명시하세요. 이 조합은 규정을 위반하지 않으면서도 신중한 비원어민 글쓰기를 보호합니다.
인용문과 기술 용어는 그대로 유지하면서 반복적인 리듬의 감지기가 경고하지 못하도록 하세요. Turnitin, Originality.ai, GPTZero로 테스트했으며, 비원어민 학술 영어에 맞춰 최적화했습니다.

Moe는 자연어 처리 분야에 PhD를 갖춘 NLP 엔지니어입니다. 그의 연구는 컴퓨터 언어학, 텍스트 분석 및 기계 학습을 다루며 ProofreaderPro의 편집 및 인간화 모델에 직접 적용됩니다. 그는 대부분의 사람들이 전혀 보지 못하는 프로세스의 일부, 즉 언어 모델이 문장을 읽고 점수를 매기고 무엇을 변경할지 결정하는 방법에 대해 글을 씁니다.


