
영어로 작성하는 스웨덴 연구자를 위한 AI 휴머나이저
스웨덴 연구자를 위한 AI 휴머나이저입니다. 스웨덴식 영향이 반영된 영어에서 발생하는 오탐(거짓 AI 탐지) 경고를 줄이되, 의미와 인용은 그대로 유지하며, AI 사용을 정직하게 공개하세요.

스웨덴은 영어로 돌아갑니다. 카롤린스카 연구소(Karolinska Institutet)의 박사학위 논문은 영어로 작성되고 그 영어로 심사·방어되며, 룬드(Lund)와 웁살라(Uppsala) 출신 논문 초안도 영어로 작성됩니다. 또한 이 나라는 매년 EF 영어 능력 지표(EF English Proficiency Index) 상위권에 자리합니다. 그러니 스웨덴인 박사 과정 학생이 자신이 직접 쓴 한 장(챕터)이 AI 감지기에 의해 플래그 처리되었다는 사실을 알게 되면, 보통은 믿기 어렵다는 반응이 먼저 나옵니다.
그 반응은 타당합니다. 스웨덴 연구자를 위한 AI 휴머나이저가 존재하는 이유는, 신중하고 표준적이며 유창한 스웨덴식-영어(swedish-English)가 바로 이런 탐지기가 가장 잘못 읽는 유형의 문체이기 때문입니다. 훌륭한 영어는 당신을 보호해 주지 않습니다. 때로는, 그 점이 오히려 문제입니다.
이를 직접 보면 메커니즘이 불편할 정도로 명확합니다. 탐지기는 예측하기 어려운 단어 선택에는 점수를 주고, 너무 예측 가능한 선택에는 페널티를 줍니다. 명확하게 쓰도록 훈련받았고, 흔한 단어를 쓰며 문장 구조를 깔끔하게 유지하는 작가가 만든 텍스트는 ‘퍼플렉서티(perplexity)’가 낮아집니다. 그리고 낮은 퍼플렉서티는, 탐지기가 머신 작성으로 점수화하는 바로 그 특징입니다.
Så kan svenska forskare humanisera AI-text för publicering på engelska
저희 휴머나이저는 스웨덴 연구자가 자신의 원고 초안에서 AI 텍스트를 휴머나이즈하여, 정확하고 잘 쓰인 스웨덴식 영어가 ‘마스킹(masking)된 생성형’으로 잘못 플래그 처리되는 일을 줄이는 데 도움을 줍니다. 동시에 의미, 전문 용어, 그리고 인용(출처 표시)을 그대로 보존합니다.
쉽게 말해: 이 도구는 사용자가 작성한 AI 지원 초안을 바탕으로 리듬과 단어 선택을 조정하여, 깔끔한 스웨덴식 영어가 주요 탐지기에서 잘못 오독될 가능성을 낮춥니다. 인용문, 기술 용어, 그리고 논증의 핵심은 그대로 유지됩니다. 이 도구는 사용자의 논문을 대신 ‘써 주는’ 것이 아니며, 어떤 것을 숨기기 위해 설계된 것도 아닙니다.
스웨덴어로 작성하셨나요? 자동으로 감지되어 원어 수준으로 자연화됩니다
스웨덴 연구자들은 영어로 넘어가기 전에 대개 모국어로 먼저 초안을 작성하고, 그 다음 영어로 옮깁니다. 휴머나이저는 이를 지원합니다. 스웨덴어 텍스트를 그대로 붙여넣으면 ProofreaderPro가 언어를 자동으로 감지한 뒤, å, ä, ö와 전문 용어, 인용을 정확히 제자리에 둔 채 스웨덴어를 이해하는 모델을 통해 처리합니다. AI 텍스트를 휴머나이즈하려면 스웨덴어 초안을 출발점으로 삼을 수 있으며, 그 초안은 영어 초안만큼이나 자연스럽게 다시 씁니다. 또한 동일한 감지 범위는 60개가 넘는 언어에 적용되며, 각 언어는 그 언어 고유의 목소리로 휴머나이즈됩니다.
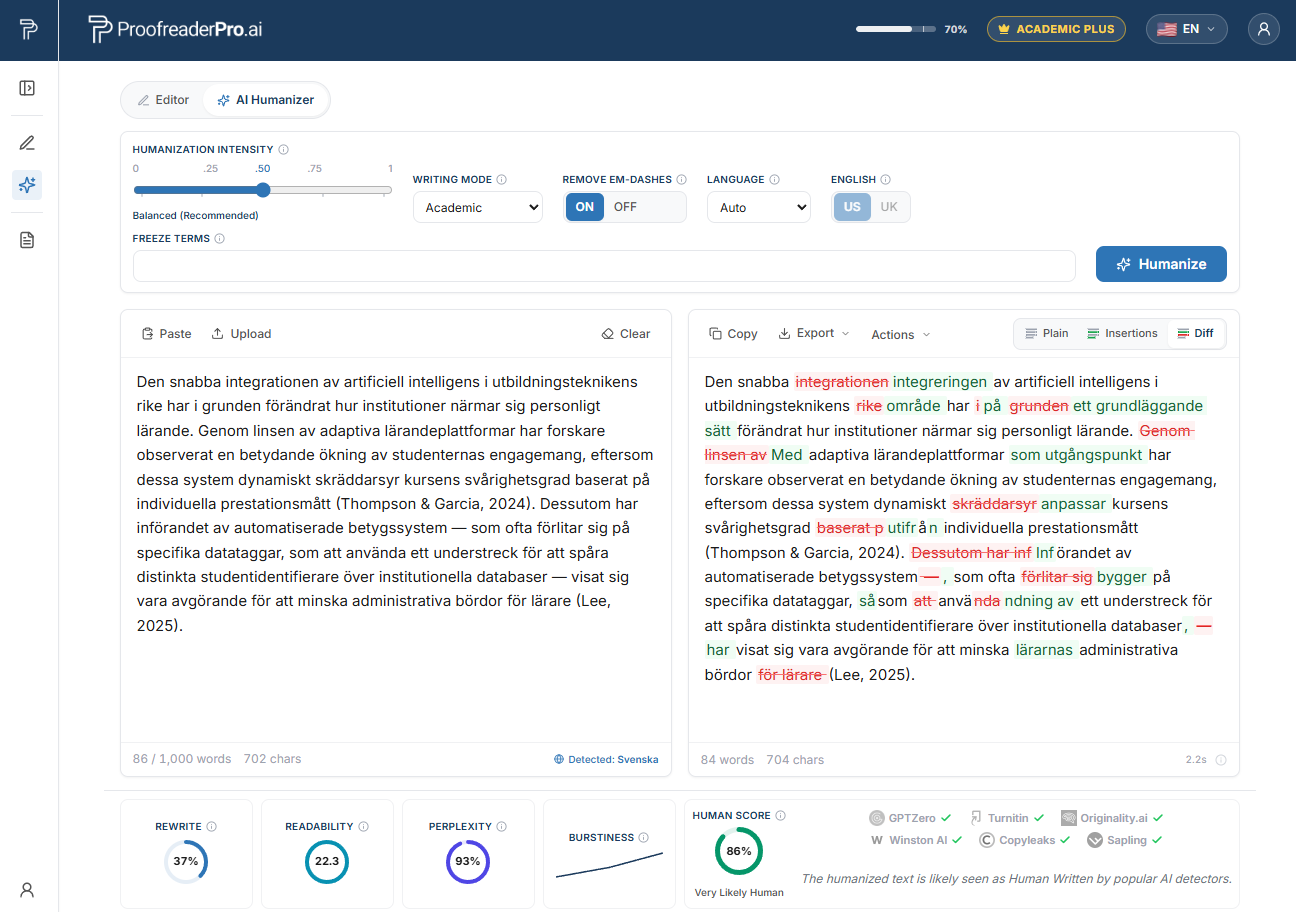
스웨덴어 학술 텍스트를 재작성하는 ProofreaderPro AI 휴머나이저. ‘전/후(diff)’ 비교는 의미와 인용을 그대로 유지하고, 탐지기 점검 결과는 자연스럽고 사람의 글처럼 읽힌다는 점을 확인해 줍니다.
Why Swedish researchers get flagged by AI detectors
먼저, 이 문제를 수치로 보여 준 연구부터 살펴보겠습니다. 2023년, 스탠퍼드(Stanford) 팀의 Liang과 동료들은 Cell Press 저널 Patterns에 "GPT detectors are biased against non-native English writers"를 발표했습니다. 연구진은 사람이 직접 쓴 TOEFL 에세이를 모은 뒤, 널리 사용되는 7가지 탐지기에 이를 통과시켰습니다.
결과는 선명했습니다. 평균적으로 비(非)원어민 에세이의 약 61%가 AI로 플래그 처리된 반면, 원어민 영어 작성자의 경우는 약 5% 수준이었습니다. 패널에 포함된 모든 탐지기가 만장일치로 플래그를 준 비(非)원어민 에세이도 거의 5분의 1, 약 19.8%에 달했습니다. 모든 에세이는 실제 사람이 작성한 것이었습니다.
왜 이런 일이 벌어질까요? 많은 탐지기가 퍼플렉서티(perplexity)를 사용하기 때문인데, 이는 다음 단어가 언어 모델에 얼마나 ‘놀랍게’ 등장하는지를 측정하는 값입니다. 꼼꼼한 제2언어 작가는 흔한 단어와 표준적인 구성(틀)을 선택합니다. 그것은 분명 좋은 글쓰기이지만, 동시에 예측 가능한 낮은 퍼플렉서티 텍스트를 만들어냅니다. 스웨덴식 영어를 명료하게 만드는 습관은, 역설적으로 바로 이러한 시스템이 ‘탐지’하도록 훈련된 습관과 같습니다. 작동 원리는 왜 AI 탐지기가 비(非)원어민 영어를 플래그 하는가에서 더 자세히 설명합니다.
중요성은 추상적이지 않습니다. 비(非)원어민 연구자는 이미 원어민에 비해 거절률이 약 2.5배 높고, 논문을 쓰는 데 약 51% 더 많은 시간을 쓰며, 언어 품질과 관련된 수정 요청도 훨씬 더 많이 받습니다. 잘못된 AI 플래그는, 이미 높은 장벽 위에 추가로 올라앉는 셈입니다.
The Swedish first-language patterns behind false flags
스웨덴 학술 영어에는 알아볼 수 있는 ‘형태’가 있고, 그중에는 틀린 것이 전혀 없습니다. 아래는 정확하고 신중하며 표준적인 구성들입니다. 함정은 ‘표준적’이라는 점입니다. 탐지기에서는 표준성이 낮은 퍼플렉서티로 읽히기 때문입니다.
‘false friends’(동형이의어/오역 유발 표현)도 대표적인 단서입니다. "Aktuell"은 ‘현재의’ 또는 ‘관련된’ 의미이지 "actual"(사실의/실제의)을 뜻하지 않습니다. "eventuellt"는 ‘가능성이 있는’ 의미이지 "eventually"(결국)는 아닙니다. "kontrollera"는 ‘확인하다’를 뜻하며 "to control"과는 다릅니다. 즉, 스웨덴어 저자가 "we controlled the temperature"라고 써서 실제 의도는 "we checked it"(우리는 온도를 확인했다)인 경우, 이는 모델이 예측하기 쉬운 정교하고 의도적인 어휘를 쓰고 있는 것입니다.
문장 어순도 그대로 이어집니다. 스웨덴어는 동사-둘째(verb-second) 언어이므로, 유한동사는 두 번째 자리를 원합니다. 이 습관은 측정된 느낌의 약간 격식 있는 문장을 만들고, 교정 후("Therefore the model is robust")에도 남아 있는 그 ‘고른(even) 상태’가 탐지기에서 기계적인 리듬으로 읽힐 수 있습니다.
여기에는 관사(articles)도 있습니다. 스웨덴어는 정(定)·부정(不定)을 별도의 단어가 아니라 접미사로 표시하므로, 영어 관사는 생략되거나 두 번 들어가기도 합니다. 예를 들어 "the research show", "result was significant" 같은 형태가 나올 수 있습니다. 교정자가 이를 정리하면 문장들은 다시 규칙적이고 단정해지는데, ‘규칙적’인 문체야말로 낮은 퍼플렉서티로 점수화되는 바로 그 특징입니다.
또한 몇 가지 작은 단서도 반복해서 나타납니다. 지속 시간에 대해 "since"를 "for"의 의미로 쓰는 경우, 복합 명사의 과도한 사용, 그리고 "respective"라는 단어, 그리고 일부 심사자가 평평하다고 오해할 수 있는 절제된 레지스터(문체 톤) 등이 그렇습니다. 각각의 선택은 그 자체로 충분히 방어 가능합니다. 하지만 함께 모이면 모델이 예측하기 쉬운, 매끄럽고 균질하며 리드가 쉬운 산문이 됩니다.
Sweden's AI-detection and Turnitin context
스웨덴에서는 학위논문과 원고를 일상적으로 스크리닝합니다. 유사도(표절) 검사는 업계 전반에서 표준적인 관행이며, 과거에는 많은 스웨덴 대학이 자체 개발 방식인 Urkund와 Ouriginal 시스템을 사용해 왔고, 이들은 현재 Turnitin의 일부가 되었습니다. AI 지표는 점차 유사도 점수와 함께 같은 보고서 안에 나란히 표시되고 있습니다.
가이던스(지침)도 따라잡는 중입니다. 스웨덴 고등교육기관 협회(Association of Swedish Higher Education Institutions, SUHF)와 개별 대학들은 생성형 AI에 관한 지침을 발행했으며, 지원 기관과 저널은 AI가 어떻게 사용되었는지에 대한 명확한 진술을 점점 더 자주 요구합니다. 이동 방향은 금지(prohibition)가 아니라 공개(disclosure)입니다.
한 가지 기억할 점: 탐지기 점수는 ‘판결’이 아니라 하나의 ‘주장’입니다. Turnitin 자체도 낮은 범위의 점수는 숫자로 보여 주기보다는 억제하며, 그 점수만을 무결성(integrity) 판단의 유일한 근거로 사용해서는 안 된다고 경고합니다. 해외의 여러 대학, 예컨대 Vanderbilt, 은 오탐과 비(非)원어민 작성자에 대한 편향을 이유로 AI 탐지기를 아예 비활성화하기도 했습니다. 플래그는 항변할 대상이지, 고백이 아닙니다.
제출하기 전에 스웨덴어-영어 글을 보호하십시오
자신의 AI 보조 초안을 자연스럽게 다듬고, 인용문과 의미를 그대로 유지한 다음 AI 사용 사실을 공개하십시오. 논문에서 단락 1개에 적용해 보고 차이를 확인해 보십시오.
Humanizer를 무료로 사용해 보세요Top Swedish universities and where AI checks appear
동일한 스크리닝 도구가 스웨덴의 주요 기관들 전반에서 의료 계열부터 공학 계열까지 다양하게 등장합니다:
- Karolinska Institutet (KI), 스톡홀름 (의학)
- Uppsala universitet, 웁살라
- Lunds universitet, 룬드
- Kungliga Tekniska högskolan (KTH), 스톡홀름
- Stockholms universitet (SU), 스톡홀름
- Göteborgs universitet (GU), 예테보리
- Chalmers tekniska högskola, 예테보리
- Linköpings universitet (LiU), 린셰핑
- Umeå universitet, 우메아
- Sveriges lantbruksuniversitet (SLU), 웁살라
- Örebro universitet, 외레브로
- Linnéuniversitetet, Växjö 및 칼마르
이들 모두는 학위논문과 원고를 유사도 기준으로 검사하며, 점점 더 AI 지표도 동일한 워크플로우 안에서 함께 가중치로 반영합니다. 핵심은 어느 한 기관이 적대적이라서가 아닙니다. 오히려 어느 기관에서든, 세심하게 작성한 작업에도 잘못된 플래그가 붙을 수 있다는 점입니다. 따라서 제출 전에 자신의 글을 보호하는 것이 합리적인 선택입니다.
스웨덴 연구자를 위한 AI 휴머나이저는 어떻게 작동하는가
워크플로우는 정직하고 단순하며, 사용자 자신의 초안부터 시작합니다.
먼저 작성하세요. 많은 스웨덴 연구자들은 생각이 가장 빠른 모국어인 스웨덴어로 먼저 초안을 쓰고, 그 다음 번역합니다. 반면 어떤 연구자는 처음부터 영어로 곧바로 초안을 작성합니다. 어느 경우든, 단어와 논증의 주체는 사용자 본인입니다.
문법을 교정하세요. false friends(오역 유발 표현), 생략된 관사, 동사-둘째 구조의 이어짐 같은 문제를 정리합니다. 저희 AI 교정기는 의미를 납작하게 만들지 않고 문법의 메커니즘을 다듬어 주며, 문법이 탄탄해지면 다음 단계로 휴머나이저를 사용합니다.
그다음, 사용자의 AI 지원 산문을 휴머나이즈하세요. 이 단계에서 스웨덴 연구자를 위한 AI 휴머나이저가 리듬과 단어 선택을 조정하고, 지나치게 고른 리듬을 끊어 주며, 탐지기를 걸리게 만드는 반복적인 패턴과 여기저기 튀어나온 ‘em 대시’ 등을 제거합니다. 저희 자체 테스트에서는, 이렇게 하면 세심하고 표준적인 스웨덴식 영어가 주요 탐지기(Turnitin, Originality.ai, GPTZero 및 유사 도구)에서 잘못 읽히는 빈도를 상당히 낮출 수 있었습니다. 동시에 의미, 용어, 인용은 그대로 유지됩니다. 이는 ‘약속’이 아니라, 테스트에서 저희가 관찰한 방식으로 설명한 것입니다. 탐지기는 몇 달마다 재학습하며, 어떤 정직한 도구도 100% 감지 불가를 주장할 수는 없습니다.
비(非)영어 초안도 처리됩니다. 휴머나이저는 60개가 넘는 언어를 지원하며, 비(非)영어 텍스트를 언어를 이해하는 모델을 통해 처리하여 문장 구조와 의미를 그대로 유지합니다. 이는 스웨덴어 초안을 휴머나이즈한 뒤 번역하려는 경우에도 중요합니다. 이 글은 저희 다국어 AI 휴머나이저 허브에서 하나의 노드이며, 전체 원고 작업을 위한 글로벌 학술 편집 허브와 나란히 구성되어 있습니다.
그 다음, 공개하세요. 자신의 글을 휴머나이즈하는 것은 숨기는 것과 같지 않습니다. 사용자가 AI를 어떻게 활용했는지, 소속 부서와 목표 저널이 요구하는 형식 그대로, 를 밝히면, 잘못된 플래그로부터 작업을 보호하면서도 무결성(integrity) 규칙의 범위 안에 정당하게 머무를 수 있습니다.
Local funding bodies, journals, and AI-disclosure expectations
스웨덴의 연구비 지원 기관들은 AI 사용에 대한 투명성을 점점 더 요구하고 있습니다. Vetenskapsrådet(스웨덴 연구위원회, VR)이 대표적인 공공 지원 기관이며, Knut and Alice Wallenberg Foundation(KAW)은 주요한 민간 지원 기관입니다. Forte(보건, 노동생활, 복지), Formas(환경 및 농업), Vinnova(혁신)는 각각 자체 분야를 지원하고, 스웨덴 내 연구팀이 정기적으로 ERC grants를 수상하며, 전반적으로 오픈 액세스가 요구됩니다.
출판 측면에서 스웨덴 연구자들은 Web of Science와 Scopus에 색인된 저널을 목표로 삼고, 산출물은 SwePub에 등록합니다. 해당 저널들은 AI 보조를 받았다는 점에 대한 명시적 메모를 점점 더 자주 요구하고 있습니다. 지금 당장 짧고 정직한 공개 문구를 일반적인 방법(methods) 또는 감사(a acknowledgements) 섹션에 포함시키는 것이며, 많은 사람이 생각하는 것보다 훨씬 쉽게 제대로 작성할 수 있습니다. AI를 공개하는 AI disclosure statement 작성 가이드를 참고하고, 만약 깨끗하게 작성하고 공개했는데도 플래그가 걸린 경우라면 이의제기 대응 플레이북이 어떻게 반응할지 안내합니다.
여기서 관통하는 원칙은 ‘공정성’입니다. 사용자는 연구를 했고, 논문을 직접 썼으며, 퍼플렉서티 점수가 그 사실을 뒤집도록 허용되어서는 안 됩니다.
Frequently asked questions
Q: Will an AI humanizer help if my English is already very good?
대개 그렇고, 이 부분이 직관과 다릅니다. 탐지기는 낮은 퍼플렉서티 텍스트를 플래그 처리하며, 잘 다듬어진 표준 스웨덴식 영어는 애초에 낮은 퍼플렉서티를 보이기 쉽습니다. 휴머나이저는 사용자의 실제 문장을 바꾸지 않으면서 리듬과 표현을 다양화해, 깔끔한 글이 잘못 읽힐 가능성을 낮춥니다.
Q: Is it against the rules to humanise AI-text in my own thesis?
자신의 초안을 휴머나이즈한 뒤 AI 사용을 공개하는 행위는 대부분의 기관에서 규정 위반에 해당하지 않습니다. 기관들이 진짜로 문제 삼는 것은, 만들어낸(조작된) 작업이나 비공개된 작업을 자신의 것처럼 제출하는 행위입니다. 의미와 인용을 유지하고, AI를 어떻게 사용했는지 명확히 밝힌다면 무결성(integrity) 프레임워크 안에 머무르게 됩니다.
Q: Can any tool guarantee my paper passes Turnitin or GPTZero?
아니요. 그렇게 말하는 도구에는 주의해야 합니다. 탐지기는 몇 달마다 모델을 바꾸므로, 어떤 정직한 도구도 결과를 보장하거나 100% 감지 불가를 주장할 수는 없습니다. 저희가 말할 수 있는 것은, 테스트에서 휴머나이저가 세심하게 작성한 비(非)원어민 문장에서 ‘잘못된 플래그’를 의미 있게 줄였다는 점이며, 이는 보장과는 다릅니다.
Q: Does the humanizer change my citations or technical terms?
아니요. 이 도구는 인용, 기술 용어, 그리고 논증의 핵심(내용)을 보존하도록 설계되어 있으며, 리듬과 단어 선택을 조정하더라도 참고문헌 목록, 수식(방정식), 그리고 해당 분야의 전문 어휘는 사용자가 작성한 그대로 유지됩니다.
Q: I drafted in Swedish first. Does that matter?
문제가 아닙니다. 휴머나이저는 60개가 넘는 언어를 지원하고, 언어를 이해하는 모델을 통해 비(非)영어 텍스트를 처리하여 문장 구조와 의미를 보호하므로, 스웨덴어로 작업한 뒤 번역하거나, 영어로 번역한 다음 휴머나이즈해도 됩니다.
의미, 용어, 인용문을 그대로 유지한 채 신중한 비원어 문장을 기준으로 잘못된 AI 플래그를 줄이십시오. 영어로 출판하는 연구자를 위해 제작되었습니다.

Moe는 자연어 처리 분야에 PhD를 갖춘 NLP 엔지니어입니다. 그의 연구는 컴퓨터 언어학, 텍스트 분석 및 기계 학습을 다루며 ProofreaderPro의 편집 및 인간화 모델에 직접 적용됩니다. 그는 대부분의 사람들이 전혀 보지 못하는 프로세스의 일부, 즉 언어 모델이 문장을 읽고 점수를 매기고 무엇을 변경할지 결정하는 방법에 대해 글을 씁니다.


