
영어로 집필하는 네덜란드 연구자를 위한 AI 휴머나이저
네덜란드 연구자를 위한 AI 휴머나이저입니다. 네덜란드 영향을 받은 영어에서의 오탐(거짓) AI 탐지 플래그를 줄이면서, 의미와 인용을 유지하고, AI 사용을 정직하게 공개하세요.

네덜란드는 지구상 거의 모든 국가보다 1인당 더 많은 고임팩트 연구를 발표하며, 그 거의 전부가 영어로 게재됩니다. 네덜란드 학자들은 매년 EF English Proficiency Index 상위권(또는 최상위권)에 자리하므로, 암스테르담이나 델프트에서 제출한 원고는 대개 깔끔하고 정확하며 문법적으로 교과서 같은 형태로 도착합니다. 그런데 바로 그 ‘잘 쓴’ 문장을 AI 탐지기가 읽고 높은 "AI-generated" 확률을 반환합니다. 그리고 손수 모든 문장을 작성한, 신중한 연구자는 갑자기 자신을 설명해야 하는 상황에 놓이게 됩니다. 네덜란드 연구자를 위한 AI 휴머나이저는 바로 이 문제를 해결하기 위해 설계되었습니다.
여기에는 불편한 역설이 있습니다. 영어 실력이 좋을수록 문장 표현은 더 표준적이고 예측 가능한 경향을 띠게 되며, ‘예측 가능한 문장’이야말로 현행 탐지기가 기계적 글쓰기로 간주하며 높은 점수를 주는 요소입니다. 탄탄한 네덜란드식 영어는 논문이 오탐 플래그를 받지 않도록 보호해 주지 못합니다. 어떤 면에서는 오히려 그 위험을 초대하기도 합니다.
이 가이드는 왜 이런 일이 벌어지는지, 네덜란드 모국어 화자의 어떤 습관이 이를 유발하는지, 네덜란드 대학에서 유사도 및 AI 스크리닝이 실제로 어떻게 작동하는지, 그리고 자신의 글을 정직하게 보호하는 방법을 설명합니다. 즉, 이미 작성해 둔 AI 보조 초안을 ‘휴머나이즈’하되 의미와 인용을 그대로 유지하고, 그다음 기관과 저널이 요구하는 방식에 따라 AI 사용을 투명하게 공개하면 됩니다.
영어로 출판하는 네덜란드 연구자를 위한 AI-tekst humaniseren
우리의 휴머나이저는 네덜란드 연구자들이 영어로 된 원고를, 세심하고 정확한 산문이 기계 글로 오인되어 잘못 분류되는 문제 없이 출판할 수 있도록 돕습니다. AI-tekst humaniseren의 목표는 간단합니다. 의미, 용어, 출처 표기는 그대로 유지하면서, 문장 리듬과 단어 선택을 더 자연스럽게 만드는 것입니다.
한마디로 plain English로 말하면, humanizer는 이미 작성했거나 AI 도움을 받아 작성한 초안에 적용됩니다. 문장 리듬을 변형하고, 반복되는 억양/리듬을 끊어 탐지기를 속이는 ‘티’를 제거하되, 논지, 데이터, 참고문헌에는 손을 대지 않습니다. 비영어 텍스트의 경우에는 언어 인식에 맞춰 처리하는 모델을 통해 60개가 넘는 언어 전반에서 구조와 의미를 보존합니다.
네덜란드어로 쓰나요? 자동 감지되어 바로 휴머나이즈됩니다
초안을 휴머나이즈하기 전에 영어로 번역할 필요는 없습니다. 네덴란드어 텍스트를 붙여넣으면 ProofreaderPro가 언어를 스스로 감지한 뒤, 네덜란드어를 이해하는 모델로 라우팅합니다. 이 과정에서 용어, 합성어, 인용은 현재 쓰신 그대로 정확하게 유지됩니다. 이는 ‘모국어’에 적용하는 AI-tekst humaniseren입니다. 네덜란드어 초안은 영어 초안과 마찬가지로 즉시 휴머나이즈됩니다. 동일한 감지 범위가 60개가 넘는 언어를 아우르므로, 네덜란드어는 영어로 평평하게(평탄화되어) 바뀌지 않고 네덜란드어 자체로 다시 작성됩니다.
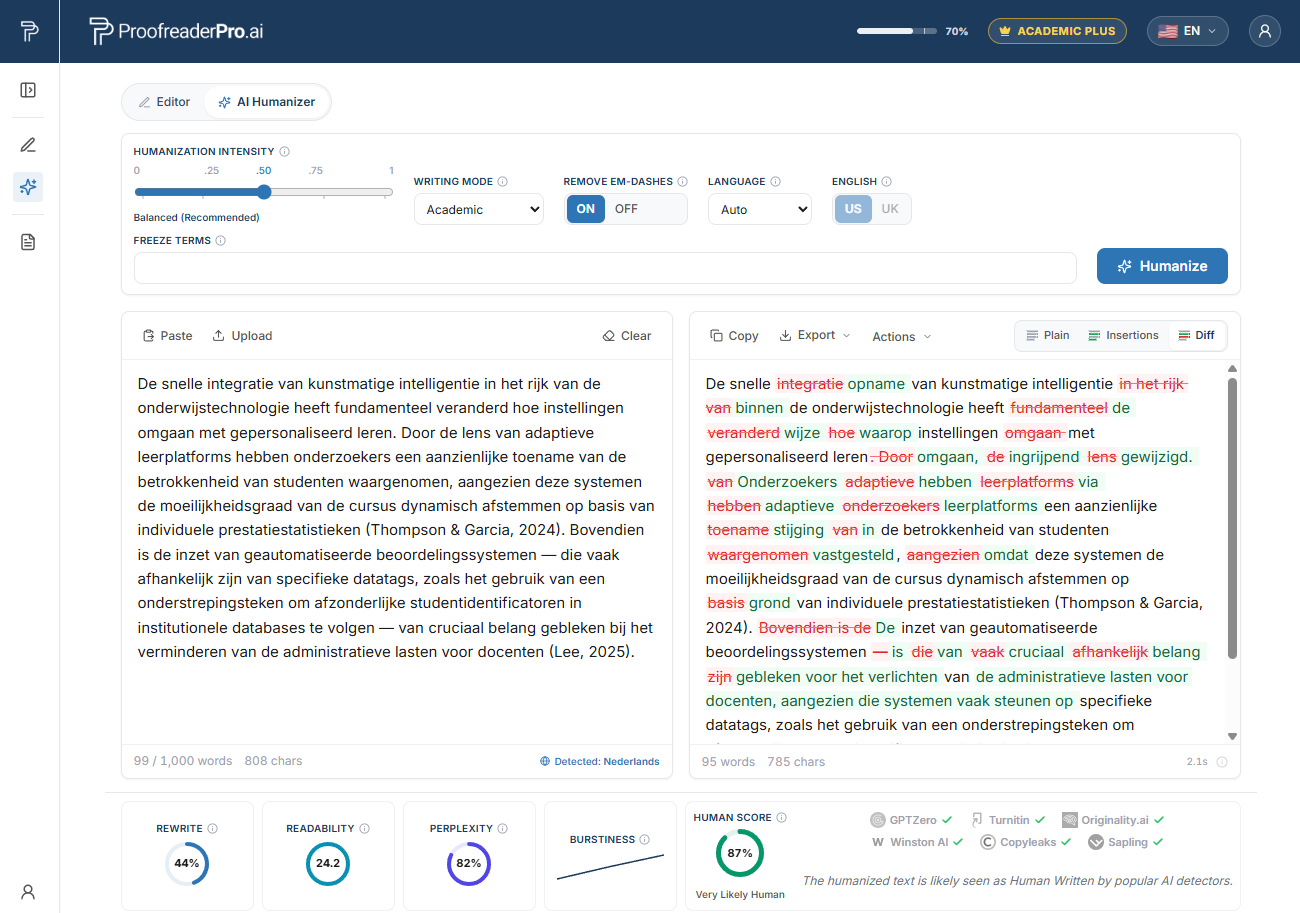
ProofreaderPro AI Humanizer가 네덜란드 학술 텍스트를 재작성한 화면입니다. before/after diff는 의미와 인용을 그대로 유지하며, 탐지기 점검은 자연스럽고 사람이 읽는 느낌을 확인합니다.
왜 네덜란드 연구자는 AI 탐지기에 걸리기 쉬울까
2023년, Weixin Liang이 이끄는 스탠퍼드 팀은 Cell Press 저널 Patterns에 다소 직설적인 제목의 연구를 발표했습니다: "GPT detectors are biased against non-native English writers." 연구진은 사람이 직접 쓴 TOEFL 에세이를 일곱 가지 널리 사용되는 AI 탐지기에 통과시켰습니다. 평균적으로 비원어민 에세이의 약 61%가 AI-generated로 플래그되었습니다. 반면 영어 원어민이 쓴 에세이의 해당 비율은 약 5%였습니다. 비원어민 에세이 가운데 약 5분의 1(대략 19.8%)은, 무려 모든 탐지기가 일치하여 플래그를 표시했습니다. 그 모든 글은 사람이 한 편도 빠짐없이 직접 쓴 것입니다.
이 메커니즘은 이해할 가치가 있습니다. 유창함이 방패가 되지 않는 이유를 설명해 주기 때문입니다. 대부분의 탐지기는 ‘퍼플렉서티(perplexity)’라는 지표를 점수화합니다. 이는 각 단어 선택이 언어 모델에 얼마나 ‘놀라운지(예측이 어려운지)’를 측정한 값입니다. 일반 단어를 표준적이고 예상 가능한 조합으로 사용하는 글은 퍼플렉서티가 낮고, 낮은 퍼플렉서티는 기계 글로 읽힙니다. 신중한 학술 글쓰기(특히 제2언어 환경에서 글을 쓰는 경우)는 안전하고 정확하기 때문에, 명확하고 관습적인 표현으로 기울기 마련입니다. 즉, 글을 읽기 쉽게 만드는 습관이야말로 탐지기가 처벌하도록 학습된 습관입니다.
네덜란드 연구자는 여기서 애매한 위치에 있습니다. 네덜란드의 영어 능력은 매우 뛰어나기 때문에, 네덜란드식 학술 영어는 평균적인 원어민 초안보다 더 깨끗하고 표준화된 경우가 흔합니다. 이러한 ‘광택’은 퍼플렉서티를 더 낮춥니다. 우리는 이 역동성에 대해 why AI detectors flag non-native writers에서 더 자세한 설명을 썼고, 네덜란드 연구에는 유난히 강한 힘으로 적용됩니다.
오탐 플래그 뒤에 있는 네덜란드 모국어 패턴
아래의 어떤 패턴도 오류가 아닙니다. 이는 맞고 신중하며 표준적인 구문이고, 바로 그 ‘표준성’이 탐지기가 낮은 퍼플렉서티와 기계적인 텍스트를 읽어내는 핵심입니다. 몇 가지 예가 네덜란드어 습관이 영어 산문에 어떤 식으로 영향을 주는지 보여줍니다.
네덜란드어와 영어는 어휘를 상당 부분 공유하므로, 그 결과 ‘믿기 쉬운 오해(영향을 주는 거짓 친구)’가 생기기 쉽습니다. "Actueel"은 ‘actual(실제의)’이 아니라 ‘current(현재의)’를 뜻합니다. "eventueel"은 ‘eventually(결국)’가 아니라 ‘possibly(아마도)’입니다. "controleren"은 ‘to control(통제하다)’이 아니라 ‘to check(확인하다)’를 뜻합니다. 이러한 함정을 피하도록 배운 네덜란드 연구자는 변화를 평평하게 만들 만큼 의도적이고 세심한 정밀함으로 글을 쓰곤 합니다. 그 결과는 일관적이고 정확합니다. 그리고 이러한 일관성은 퍼플렉서티 신호로 이어집니다.
또 다른 조용한 단서가 어순입니다. 네덜란드어는 절(clause)에서 한정 동사를 둘째에 배치하므로, 부사가 문두로 나오는 문장이 영어에서는 "Therefore is the result significant" 또는 "In this study investigate we the effect"처럼 나타날 수 있습니다. 대부분의 네덜란드어 저자는 제출 전에 이를 수정하지만, 그 수정은 탐지기가 생성된 텍스트와 연관 짓는 ‘정돈된(깔끔한) 전형적 문장 구조’를 만들어 냅니다.
그리고 관사(articles)가 있습니다. 네덜란드어는 일반적·추상적 명사 앞에 정관사를 허용하기 때문에, 초안에는 "the research shows," "the society," "the nature of the problem," 같은 구성이 들어가곤 하는데, 영어에서는 관사를 생략하는 경우가 많습니다. 이는 격식 있어 보이고 정밀해 보입니다. 동시에 아주 규칙적으로 읽히기도 합니다.
마지막으로 두 가지 습관이 이를 완성합니다. 네덜란드어는 명사구가 무겁고 명사화(nominalization)를 선호하여, "the realisation of the implementation of,"처럼 구성들이 연쇄적으로 쌓이는 경향이 있으며, "namely"(namelijk)와 "respectively"(respectievelijk) 같은 담화 표지(disourse marker)에 기대는 편입니다. 게다가 종종 리뷰어가 ‘간결하고 단정하게’ 느끼기도 하는 직접적이고 담백한 어조로 이어집니다. 이 모든 요소는 문법적으로 문제 없습니다. 다만 이 요소들이 함께 만들면, 탐지기가 당신을 상대로 점수화하는 ‘매끄럽고 놀라움이 적은’ 질감이 구축됩니다.
자신의 글을 직접 지키십시오, 정직하게
의미, 용어, 인용문을 그대로 유지하면서 AI 보조 초안을 자연스럽게 다듬고, 학술지가 요구하는 방식대로 AI 사용 사실을 공개하십시오.
Humanizer를 무료로 사용해 보세요네덜란드의 AI 탐지와 Turnitin 맥락
네덜란드의 네덜란드어 학위논문과 저널 투고는 대개 유사도 검사를 위해 정기적으로 스크리닝을 받습니다. 가장 흔한 도구는 Turnitin 또는 iThenticate이며, 기관들은 기존 표절 점검과 더불어 AI 지표의 비중도 점점 더 크게 두고 있습니다. 이는 이제 예외가 아니라 투고 파이프라인의 ‘정상적인’ 일부가 되었습니다.
네덜란드 대학(UNL)과 개별 기관들은 생성형 AI에 관한 가이드를 발행했으며, 큰 방향은 분명합니다. AI 도구는 많은 작업에 허용되지만, 숨기기보다는 사용 사실을 공개해야 합니다. 지원기관과 저널도 같은 방향으로 움직이며, 저자에게 AI가 어디에서, 어떻게 작업에 도움을 주었는지를 명시하도록 요구하고 있습니다.
탐지기 점수에 실제로 얼마나 큰 무게가 실리는지도 기억해 두는 것이 좋습니다. Turnitin은 1~19% 범위의 AI 점수를 억제하고, 이 숫자만 단독으로 무결성(integrity) 판단을 내리는 데 사용해서는 안 된다고 경고합니다. 여러 주요 기관은 여기서 한발 더 물러섰습니다. 예컨대 Vanderbilt는 2023년, 비원어민 작성자에 대한 편향과 오탐(false positives)을 이유로 Turnitin의 AI 탐지 기능을 비활성화했습니다. Michigan State, Northwestern, University of Pittsburgh도 이에 준하는 조치를 취했습니다. 탐지 플래그는 반박할 수 있는 주장이지, 확정된 ‘판결’이 아닙니다.
네덜란드 주요 대학과 AI 점검이 나타나는 지점
스크리닝은 네덜란드 전역의 시스템에서 이뤄집니다. 아래 기관들은 모두 학위논문과 원고를 유사도 기준으로 점검하며, 흔히 Turnitin 또는 iThenticate를 사용하고, 점점 더 AI 지표를 반영합니다:
- Universiteit van Amsterdam (UvA), Amsterdam
- Universiteit Utrecht, Utrecht
- Universiteit Leiden, Leiden
- Technische Universiteit Delft (TU Delft), Delft
- Erasmus Universiteit Rotterdam (EUR), Rotterdam
- Rijksuniversiteit Groningen (RUG), Groningen
- Wageningen University & Research (WUR), Wageningen
- Radboud Universiteit, Nijmegen
- Vrije Universiteit Amsterdam (VU), Amsterdam
- Technische Universiteit Eindhoven (TU/e), Eindhoven
- Universiteit Twente (UT), Enschede
- Universiteit Maastricht (UM), Maastricht
- Tilburg University, Tilburg
만약 Leiden에서 박사학위 논문을 방어하거나 WUR 연구실에서 투고한다면, 문서는 이런 유형의 점검을 통과하게 됩니다. 이를 미리 알면 최종 원고를 준비하는 방식이 달라질 수 있습니다.
네덜란드 연구자를 위한 AI 휴머나이저는 어떻게 작동하나
정직한 워크플로는 세 단계로 구성되며, 공개(disclosure)는 부차적인 옵션이 아니라 그 일부입니다.
첫째, 초안 작성. 영어로 쓰거나, 네덜란드어로 쓰고 번역하세요. 생각을 더 빠르게 정리하는 데 도움이 된다면 AI 지원을 활용해도 됩니다. 논지, 분석, 증거가 진정으로 본인 것인 한, AI 보조 초안은 전혀 문제가 되지 않습니다.
둘째, 교정 및 휴머나이즈. 문법을 깨끗하게 다듬은 뒤 AI humanizer로 초안을 통과시키세요. 문장 길이를 변형하고 기계 글 텍스트 신호가 되는 반복 리듬을 끊으며, 원치 않는 서식 ‘틱’도 제거하되, 의미, 기술 용어, 모든 인용은 사용자가 두신 그대로 정확히 유지합니다. 자체 테스트에서는, Turnitin, Originality.ai, GPTZero 같은 주요 탐지기들이 ‘세심한 비원어민 영어’를 오인하는 빈도를 상당히 줄이는 것으로 나타났습니다. 동시에 학술적 의미와 문법은 보존됩니다. 다만 이 표현은 ‘약속’이 아니라, 우리가 테스트에서 관찰한 바를 설명하는 방식입니다. 탐지기는 몇 달마다 다시 학습하며, 어떤 정직한 도구도 100% 미탐지된다고 주장할 수는 없습니다. 그것을 보장하는 도구는 무언가를 판매하는 겁니다.
셋째, 공개. 지도교수, 소속 기관, 그리고 투고하려는 목표 저널이 요구하는 형식에 맞춰 AI 사용을 기재하세요. 그게 전부입니다. 목표는 AI를 숨기거나 유사도 검사기를 속이는 것이 아닙니다. 세심하고 정확한 글이 오해받지 않도록 하면서, 그 과정에서 연구윤리(integrity) 규칙 안에 정당하게 머무르는 것이 목표입니다.
이 구성은 multilingual AI humanizer hub 안에 있으며, 수십 개 언어 배경의 연구자가 쓰는 동일한 워크플로를 다룹니다. 더 큰 필요가 ‘탐지 공정성’보다 라인 단위 언어 편집이라면, 우리의 global academic editing hub가 더 나은 출발점입니다.
지역 재원 제공 기관, 저널, 그리고 AI 공개 기대치
네덜란드의 경쟁력 있는 연구비는 주로 NWO (Nederlandse Organisatie voor Wetenschappelijk Onderzoek, the Dutch Research Council)를 통해 집행되며, 이 안에는 Talent 프로그램의 Veni, Vidi, Vici 장학/지원금이 포함됩니다. 보건 및 의료 분야의 연구는 ZonMw를 통해 지원되고, KNAW (Koninklijke Nederlandse Akademie van Wetenschappen, the Royal Netherlands Academy of Arts and Sciences)는 전국 연구 커뮤니티의 중심에 있습니다. 네덜란드 연구팀은 또한 유럽연합 집행위원회의 유럽연구위원회(European Research Council, ERC) 그랜트에서도 상당한 비중을 차지하며, Plan S에 따른 오픈 액세스 출판은 NWO 지원 성과에 대해 의무화되어 있습니다.
출판 측면에서 네덜란드 연구자는 Web of Science 및 Scopus에 색인된 저널을 목표로 하고, 성과를 기관 리포지터리에 예치하며, SURF와 대학들이 조율하는 국가 인프라를 활용합니다. 지원기관과 저널 전반에서 AI에 대한 기대는 동일한 원칙으로 수렴하고 있습니다. 즉, 사용 사실을 공개하고 숨기지 말라는 것입니다. AI가 초안 작성에 어떤 방식으로든 도움을 준 과정을 짧고 정직하게 기록해 두면, 그랜트 보고서나 투고 신청서에서 이를 물을 때 공개가 훨씬 쉬워집니다. 만약 본인이 직접 쓴 논문인데도 플래그가 찍힌다면, appealing a false AI detection flag 가이드가 어떻게 대응하는지 안내합니다.
자주 묻는 질문
Q: 내 논문에 AI 휴머나이저를 쓰면 부정행위(cheating)로 간주되나요?
우리가 설명하는 방식으로 사용한다면 그렇지 않습니다. 본인은 본인만의 AI 보조 초안을 휴머나이즈하는 것이며, 논지·데이터·인용을 그대로 유지한 다음, AI 사용을 기관과 저널에 공개합니다. 이는 무언가를 숨기는 것의 반대입니다. 이 도구가 해결하는 문제는 무결성(integrity) 문제가 아니라 기술적인 문제, 즉 세심하게 작성한 글이 기계 텍스트로 오인되는 문제입니다.
Q: 제 영어는 정말 훌륭합니다. 그런데 왜 탐지기는 내 글을 플래그하죠?
탐지기는 글의 ‘좋음’을 측정하지 않기 때문입니다. 대신 얼마나 ‘예측 가능한지’를 측정합니다. 강한 표준형(second-language) 영어는 대체로 매우 일관적이며, 그 일관성이 탐지기가 AI 텍스트로 연관 짓는 낮은 퍼플렉서티를 만들어냅니다. 스탠퍼드 연구에서는 사람의 손으로 쓴 비원어민 에세이가 원어민 에세이보다 훨씬 더 자주 플래그되었는데, 이는 유창한 네덜란드 연구자들이 흔히 마주치는 패턴입니다.
Q: 휴머나이저가 Turnitin이나 GPTZero를 통과하게 해줄 것을 보장하나요?
아니요. 그렇게 말하는 도구는 특히 조심해야 합니다. 탐지기는 몇 달마다 모델을 바꾸므로, 어떤 정직한 제품도 특정한 결과를 보장하거나 ‘100% 미탐지’를 주장할 수 없습니다. 우리가 말할 수 있는 것은, 테스트에서 휴머나이저가 세심한 비원어민 산문이 오탐 플래그를 받는 빈도를 상당히 줄이되, 의미와 인용은 건드리지 않는다는 점입니다.
Q: 휴머나이즈하면 인용, 용어, 데이터가 바뀌나요?
아니요. 휴머나이저는 기술 용어, 참고 마커(reference markers), 그리고 논지의 실질을 보존하도록 만들어졌습니다. 문장 리듬과 단어 선택은 더 자연스럽게 조정할 수 있지만, 사실·수치·인용한 출처는 변경하지 않습니다. 투고 전에는 언제나 편집 후의 결과를 다시 읽어보셔야 합니다. 다른 어떤 수정과 마찬가지로요.
Q: 저는 네덜란드어로 먼저 쓰고 번역합니다. 그래도 되나요?
네, 가능합니다. 네덜란드어로 초안을 작성한 다음 영어로 번역하고, 그 영어 버전을 휴머나이즈하면 됩니다. 이 도구는 비영어 및 번역 텍스트를 언어 인식에 기반한 모델로 라우팅해, 문장 구조와 의미가 안정적으로 유지되도록 합니다. 따라서 네덜란드 연구자들이 실제로 글을 쓰는 방식에 잘 들어맞습니다.
의미, 용어, 인용문을 그대로 유지한 채 신중한 비원어 영어에서 발생하는 잘못된 AI 플래그를 줄이십시오. 무료로 사용해 보실 수 있으며, 연구자를 위해 설계되었습니다.

Moe는 자연어 처리 분야에 PhD를 갖춘 NLP 엔지니어입니다. 그의 연구는 컴퓨터 언어학, 텍스트 분석 및 기계 학습을 다루며 ProofreaderPro의 편집 및 인간화 모델에 직접 적용됩니다. 그는 대부분의 사람들이 전혀 보지 못하는 프로세스의 일부, 즉 언어 모델이 문장을 읽고 점수를 매기고 무엇을 변경할지 결정하는 방법에 대해 글을 씁니다.


