Marca de agua de OpenAI, SynthID y Claude: comparación de marcas de agua de texto
¿OpenAI marca su texto, existe un verificador público de marcas de agua de OpenAI y en qué se diferencian SynthID y la marca de agua de Claude, comparado para escritores académicos?
OpenAI, Google y Anthropic han construido la misma tecnología: una marca de agua estadística para texto generado por IA. OpenAI mantuvo su versión en reserva durante años y empezó a implementarla, como textGrain, en octubre de 2026. Google incorporó SynthID dentro de Gemini y publicó el método. Anthropic hizo obligatoria la marca de agua de Claude para cada usuario en agosto de 2026. Si escribe con ayuda de IA de cualquier forma, ahora las tres decisiones determinan cómo se juzgan sus documentos.
El marcado de agua pasó de ser un tema de investigación a noticia general el 11 de agosto de 2026, cuando Anthropic anunció que cada modelo nuevo de Claude marca la salida de texto. Cubrimos ese anuncio con detalle en nuestro explicador de la marca de agua de Claude. Esta guía cubre el panorama completo: qué es una marca de agua de texto, cómo implementó o retuvo cada uno de los tres grandes laboratorios y qué demuestra cada sistema sobre un fragmento de escritura.
¿Qué es una marca de agua de texto con IA?
Una marca de agua de texto con IA es un patrón estadístico oculto en las opciones de palabras del texto generado, implantado en el momento de la generación para que un detector que tenga la clave adecuada pueda después verificar que el texto proviene de un sistema de IA específico. No es una etiqueta visible, no es un carácter oculto y no es metadato adjunto a un archivo. La marca vive dentro de las propias palabras.
Esa distinción importa, porque el término "marca de agua" se usa de forma laxa para tres cosas distintas:
| Qué es | Dónde reside | ¿Sobrevive al copiar y pegar? | |
|---|---|---|---|
| Marca de agua estadística | Un sesgo en el que el modelo elige palabras | El texto en sí | Sí |
| Metadatos del archivo (C2PA) | Una etiqueta firmada de procedencia | El contenedor del archivo | No, copiar en texto plano lo elimina |
| Caracteres de ancho cero | Unicode invisible insertado en el texto | Entre los caracteres visibles | No, se elimina de forma trivial |
El marcado de agua estadístico es el único de los tres que sobrevive al copiar, pegar, reescribir y convertir el formato a un documento nuevo. Por eso los tres grandes laboratorios convergieron en él para el texto, y por eso los "eliminadores de marcadores de agua" que eliminan caracteres invisibles no hacen nada frente a él. Nuestra página eliminador de marcador de agua de Claude documenta ese modo de fallo con fuentes.
¿Cómo funciona en realidad el marcado de agua estadístico?
En cada paso al escribir una frase, un modelo de lenguaje elige entre varias palabras casi equivalentes, y el marcado de agua carga discretamente esos dados. La receta base fue publicada por Kirchenbauer y sus colegas en la Universidad de Maryland en enero de 2023, en Un marcador de agua para modelos de lenguaje grandes (ICML 2023). Funciona así:
- Antes de elegir cada palabra, una clave secreta derivada de las palabras anteriores divide el vocabulario en un conjunto preferido y un conjunto neutral.
- El modelo inclina su elección hacia el conjunto preferido. "Suggest" en lugar de "indicate". "Across" en lugar de "among". Cada elección individual se ve completamente natural.
- Un detector que tiene la clave cuenta con qué frecuencia el texto cae en los conjuntos preferidos. La escritura humana alcanza la tasa esperada por azar. El texto con marcado de agua lo hace con mucha más frecuencia, y una prueba estadística marca la discrepancia.
Ninguna palabra por sí sola es evidencia de nada. La señal solo aparece a lo largo de decenas o cientos de elecciones, por eso los pasajes más largos se pueden analizar mejor que los cortos, y por eso la detección siempre es probabilística y no una marca de sí o no.
El sistema de producción de Google DeepMind, publicado en Nature en octubre de 2024 como Marcado de agua escalable para identificar salidas de modelos de lenguaje de gran tamaño, refinó esto con una técnica llamada muestreo tipo torneo, que preserva la calidad del texto lo bastante bien como para ejecutarse en silencio dentro de un producto de consumo a gran escala. Ese artículo importa más allá de Google: es la base publicada a la que Anthropic apunta para la implementación de Claude.
La principal debilidad se publicó antes de la mayoría de los despliegues. En marzo de 2023, Krishna y sus colegas mostraron en La reformulación elude los detectores de texto generado por IA (NeurIPS 2023) que regenerar la redacción de un pasaje colapsa la detección entre métodos, incluido el humanizer de IA. La señal vive en la secuencia exacta de tokens y en ninguna otra parte, así que cualquier cosa que reescriba la secuencia, incluido un editor humano, reescribe la evidencia. Cada proveedor que hoy entrega un humanizer de IA afirma esta limitación en su propia documentación.
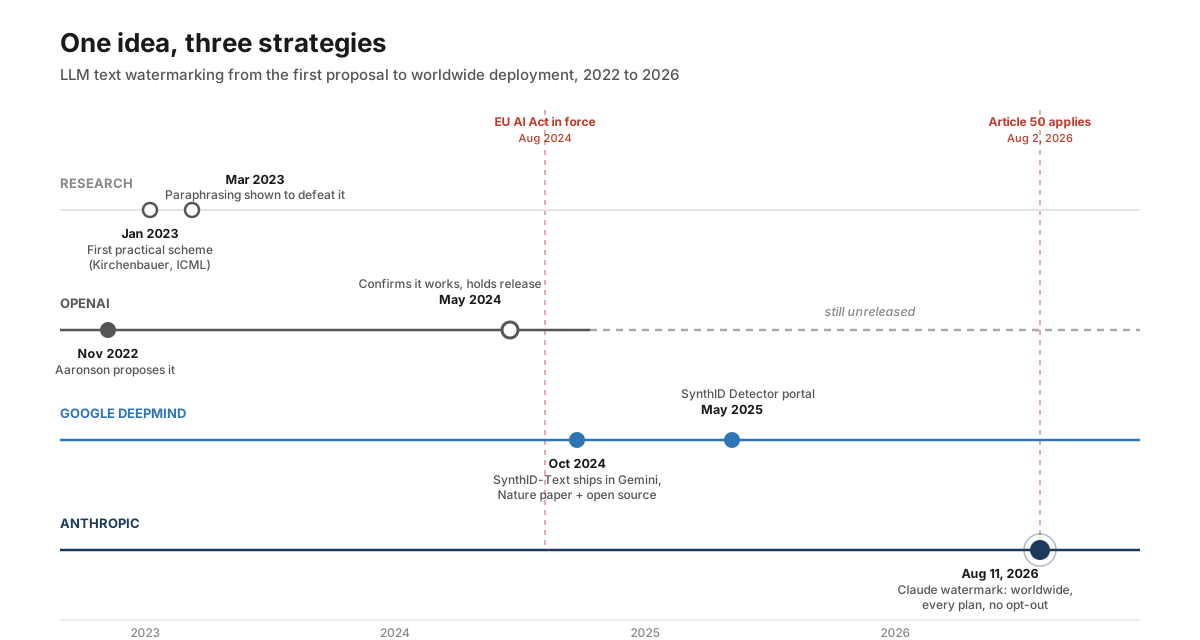
OpenAI: la empresa que lo inventó y lo envió por último
OpenAI llevaba años con un marcado de agua de texto funcional y decidió no publicarlo hasta octubre de 2026. Scott Aaronson, que entonces trabajaba en seguridad en OpenAI, describió primero la idea en público en una conferencia de noviembre de 2022. El método sesga las decisiones del modelo entre palabras casi equivalentes con una función criptográfica secreta, de modo que el propio texto muestra de dónde proviene. Esa conferencia es más antigua que cualquier sistema desplegado.
En mayo de 2024, OpenAI describió el estado del proyecto en su actualización de procedencia, Comprender el origen de lo que vemos y oímos en línea. La empresa dijo que su método de humanizer de IA para texto era preciso y efectivo en ediciones pequeñas, pero que estaba reteniendo el lanzamiento mientras evaluaba los pros y los contras. Dos de los riesgos que OpenAI nombró son importantes directamente para quienes escriben en el ámbito académico:
- Fácil elusión. Al parafrasear o traducir el texto se elimina la marca, tal como predijo la investigación de 2023. Una marca de agua que, en su mayor parte, solo detecta a quienes no saben que existe es una herramienta débil de cumplimiento.
- Impacto desproporcionado en hablantes no nativos de inglés. OpenAI indicó que el marcado con marca de agua podría estigmatizar el uso legítimo de la IA como apoyo para escribir de personas que escriben en un segundo idioma. Nuestro artículo sobre por qué los detectores de IA señalan a quienes no son nativos aborda el mismo problema desde el lado de los detectores.
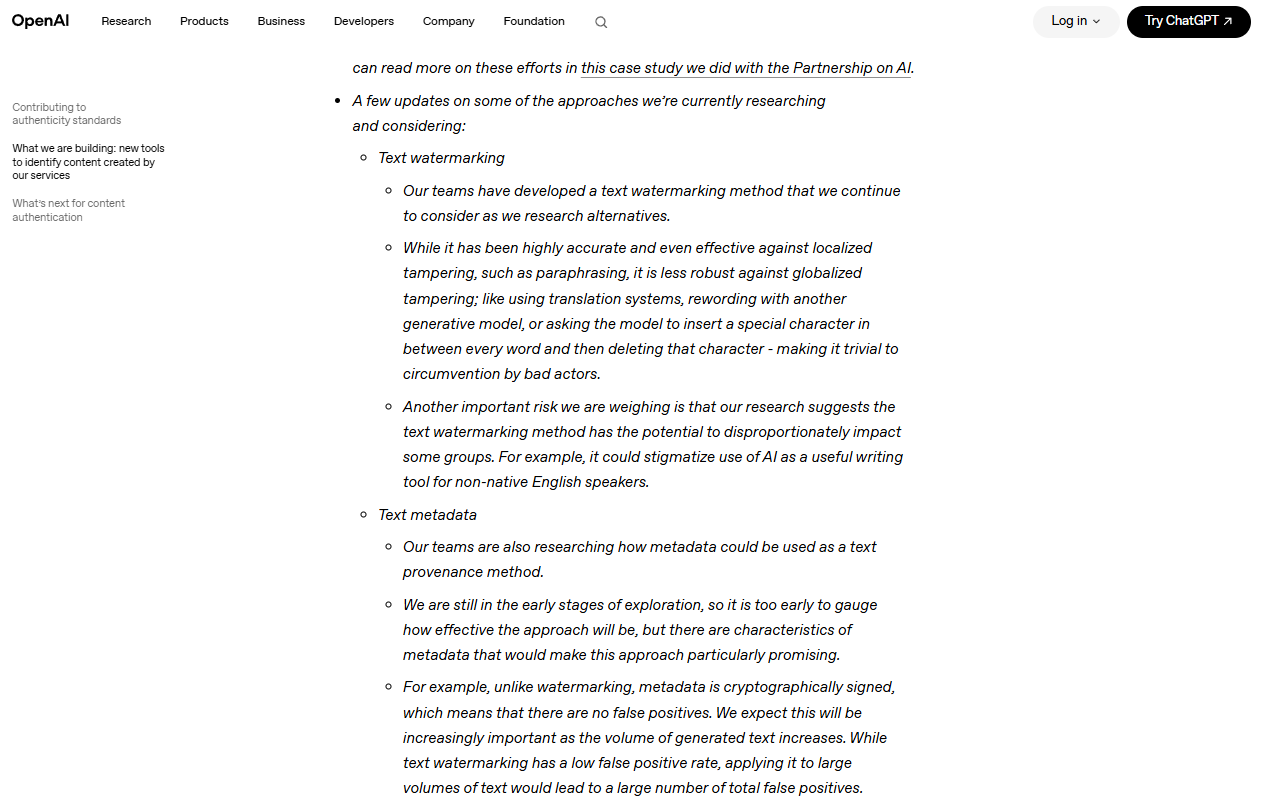
Actualización de procedencia de OpenAI de 2024: el método funciona, y la empresa enumera las razones por las que lo mantuvo en pausa en ese momento.
Para imágenes y audio, OpenAI siguió una ruta diferente: metadatos de procedencia C2PA en las salidas de DALL-E y Sora, que es una etiqueta a nivel de archivo y no una marca dentro del contenido. Para texto, la salida de ChatGPT no tuvo marca de agua hasta octubre de 2026. La empresa que propuso la tecnología fue la última de las tres en implementarla.
¿OpenAI marca con marca de agua el texto ahora?
Sí, OpenAI comenzó a marcar con agua algunos textos el 5 de octubre de 2026, en respuesta a la Ley de IA de la UE. Su anuncio presenta una marca de agua de texto llamada textGrain, que añade una señal estadística invisible a las elecciones de palabras del modelo. El despliegue tiene tres partes y la marca de agua no es una opción predeterminada global:
- Los clientes del API, en cualquier lugar, pueden activar la salida con marca de agua para modelos seleccionados. Se mantiene desactivada de forma predeterminada.
- En las semanas siguientes, la salida de texto apta de ChatGPT y Codex en la Unión Europea recibe la marca de agua, en todos los planes.
- Los investigadores aprobados y las organizaciones expertas pueden solicitar acceso al detector de marcas de agua de texto.
OpenAI afirma que textGrain coincidió o superó los otros métodos que probó, incluida la opción de Google SynthID para texto. También publicó en qué casos la detección se debilita. Con una tasa de falsos positivos del 1%, el detector identificó la marca de agua en aproximadamente el 80% de los pasajes de 200 tokens y cerca del 95% de los pasajes de 400 tokens sobre contenido de psicología. La detección fue mucho más baja en matemáticas, donde hay menos libertad para elegir palabras.
La edición debilita la señal rápidamente. En pasajes de 400 tokens, reemplazar el 10% de las palabras por sinónimos redujo la detección de aproximadamente 92% a 66%, y reemplazar el 25% la dejó en 17%.
OpenAI también comprobó si la marca de agua cambia la calidad de las respuestas en Astra, su modelo más reciente, y dice que no vio diferencias significativas. Estos son cuatro de los puntos de referencia que publicó:
| Punto de referencia | Sin marca de agua (Astra) | Con marca de agua (Astra) |
|---|---|---|
| Índice de inteligencia de Artificial Analysis | 49.57 puntos | 49.76 puntos |
| GPQA Diamond | 94.44% | 93.94% |
| HealthBench Professional | 64.27% | 64.60% |
| BrowseComp | 87.92% | 87.35% |
Para estudiantes, la fecha importa. El texto de ChatGPT escrito antes del despliegue, o fuera de la UE sin el ajuste del API, no tiene marca de agua de OpenAI. Nuestra guía sobre Turnitin Clarity Explicado explica cómo las escuelas están definiendo sus propias políticas de uso de IA mientras tanto.
¿Existe un verificador público de marcas de agua de OpenAI?
Todavía no hay un verificador público de OpenAI para texto. La herramienta gratuita de OpenAI herramienta de verificación comprueba archivos de imagen y audio en busca de credenciales de contenido C2PA y de un watermark de SynthID, que OpenAI incrusta en las imágenes y el audio compatibles. OpenAI indica que la herramienta no admite texto.
Para texto, OpenAI brinda acceso al detector caso por caso a investigadores aprobados y organizaciones expertas, a través de su formulario de la Content Provenance API. Afirma que no hará público el detector de texto en el lanzamiento por el riesgo de watermarks omitidos y falsos positivos. El detector informa si encuentra un watermark de OpenAI, y no identifica al usuario ni muestra sus indicaciones.
| Qué quieres comprobar | Herramienta | Quién puede usarla |
|---|---|---|
| Un archivo de imagen o audio de OpenAI | La herramienta de verificación de OpenAI | Cualquiera, gratis |
| Salida de texto de OpenAI (textGrain) | Detector de watermark de texto de OpenAI | Investigadores aprobados y organizaciones expertas, mediante solicitud |
| Salida de texto de Claude | Detector de watermark de Claude | Organizaciones elegibles, mediante solicitud (consulta nuestra La marca de agua de Claude de Anthropic, explicada (2026)) |
OpenAI también es claro sobre lo que un resultado no puede decirte. Un watermark detectado no mide cuánto aportó una persona, y no identifica quién escribió o usó el texto. Un watermark faltante tampoco prueba autoría humana, porque el texto puede ser demasiado corto, puede haber sido editado, traducido o provenir de un modelo no compatible.
Google: primero en salir y luego compartió la receta
Google DeepMind salió primero, lo publicó por completo y luego abrió el método. Su sistema, SynthID, comenzó como un watermark de imágenes en 2023 y se expandió a texto en 2024. Para cuando apareció el artículo de Nature en octubre de 2024, SynthID-Text ya estaba funcionando dentro de Gemini en producción, lo que lo convirtió en el primer watermark estadístico de texto desplegado a escala de consumo.
SynthID cubre texto, imágenes, audio y video, y está activo en la salida de texto de Gemini desde octubre de 2024.
Luego, Google publicó la implementación como open source en Hugging Face, permitiendo que cualquier desarrollador aplique el mismo esquema de watermarking a sus propios modelos. En mayo de 2025 anunció el SynthID Detector, un portal de verificación donde el contenido puede revisarse en busca de marcas de SynthID en texto, imágenes, audio y video.
Hay una limitación de alcance importante: SynthID solo marca y solo detecta contenido de los modelos propios de Google. No dice nada sobre la salida de ChatGPT o Claude, y un escaneo limpio de SynthID no significa que el texto esté escrito por humanos. Significa que los modelos de Google no lo escribieron, un reclamo mucho más acotado.
Anthropic: el último en moverse, con la política más estricta
Anthropic desplegó lo más reciente, con la cobertura obligatoria más amplia. Cada modelo de Claude lanzado el 2 de agosto de 2026 o después incrusta un watermark estadístico en su salida de texto, en todo el mundo, en todos los planes, sin opción de exclusión. La compañía describe el mecanismo en su explicador, Cómo funciona el watermark de texto de Claude, y el alcance de la política en el artículo de su centro de ayuda, Cómo Claude marca contenido generado por IA: la API de Claude, claude.ai, Claude Code, Claude Cowork y Claude Tag están cubiertos. Los modelos lanzados antes del corte están en un periodo de transición, y Anthropic indica que también está agregando soporte de marcado para ellos. Junto a la marca estadística, los archivos generados con Claude también incluyen metadatos C2PA, un segundo sistema, separado, que el copiado de texto plano elimina.
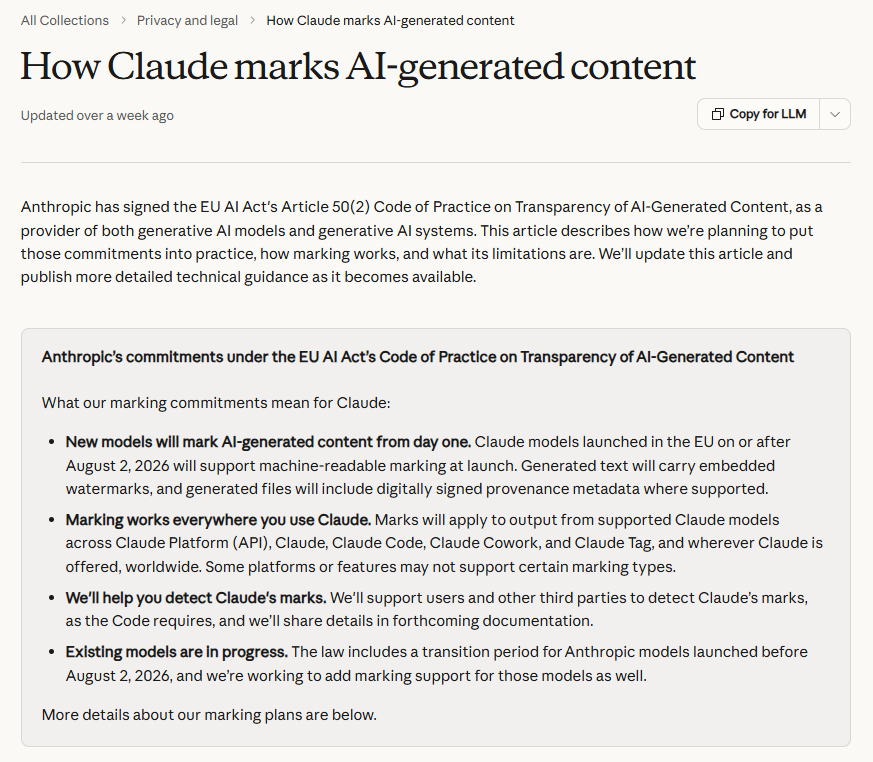
La política en palabras de Anthropic: cada modelo nuevo, cada plataforma, en todo el mundo, con los modelos anteriores que se van incorporando.
La documentación de Anthropic establece los límites de forma directa. La detección es probabilística. El marcado no puede distinguir un documento que Claude escribió de un documento que un humano escribió y Claude editó ligeramente. Una reescritura completa lo elimina. Revisamos todo esto, incluido qué prueba realmente una detección positiva y qué hacer si tu propio texto recibe el marcado, en la guía dedicada al watermark de Claude.
El calendario sigue la regulación. Anthropic ha firmado el Código de Buenas Prácticas del artículo 50(2) sobre Transparencia del Contenido Generado por IA bajo el Act de la UE sobre IA, que exige a los proveedores de sistemas de IA generativa garantizar que las salidas estén "marcadas en un formato legible por máquinas y sean detectables como generadas artificialmente". Estas obligaciones de transparencia se volvieron aplicables el 2 de agosto de 2026: la fecha exacta de corte en la política de modelos de Anthropic, nueve días antes del anuncio público. Anthropic eligió cumplir de forma global en lugar de mantener un comportamiento separado para el tráfico de la UE. Google ya cumplía por diseño. La salida de texto sin marcar de OpenAI es la cuestión abierta de cumplimiento para 2027.
Las tres aproximaciones, una al lado de la otra
| OpenAI | Google DeepMind | Anthropic | |
|---|---|---|---|
| ¿Se implementó un watermark de texto? | Sí (textGrain, despliegue en la UE desde el 5 de octubre de 2026) | Sí (Gemini, desde octubre de 2024) | Sí (modelos de Claude desde el 2 de agosto de 2026) |
| Técnica | textGrain, una señal estadística en las elecciones de palabras | Muestreo en torneos de SynthID | Marcado por muestreo estadístico, estilo SynthID |
| Cobertura | Texto elegible de ChatGPT y Codex en la UE; en la API, con opción de activación en todo el mundo | Solo modelos de Google | Todos los modelos nuevos de Claude; los modelos anteriores están en transición |
| Exclusión voluntaria | Desactivado por defecto en la API | No | No |
| Detector público | No | Portal del detector SynthID (2025) | Previsto, aún no lanzado |
| ¿Se publicó el esquema? | Solo conferencias conceptuales | Artículo de Nature + código abierto | Explicación, basada en trabajos publicados |
| Metadatos del archivo (C2PA) | Sí, imágenes y audio | Sí, en varios tipos de medios | Sí, en archivos generados |
| Limitaciones declaradas | Elusión, estigma en ESL | Alcance limitado a sus propios modelos | Probabilístico, las ediciones difuminan la autoría |
El patrón en las columnas: OpenAI trata el marcado de texto como un problema de política aún no resuelto, Google lo trata como infraestructura que estandarizar, y Anthropic lo trata como una obligación de cumplimiento que implementar en su totalidad.
Qué significa esto para investigadores y escritores académicos
Las consecuencias prácticas dependen de qué herramientas toquen tu texto. Si redactas con ChatGPT, tu texto no lleva marca de agua hoy. Si redactas con Gemini, lleva una marca SynthID que solo puede leer el detector de Google. Si redactas o editas con un modelo actual de Claude, lleva la marca de Anthropic, y no hay una configuración que la desactive.
Tres cosas que los escritores académicos deberían saber:
Una marca de agua identifica una herramienta, no un autor. Cada proveedor lo indica en su propia documentación, y vale la pena repetirlo porque las políticas institucionales no siempre hacen esa distinción. El texto puede estar marcado porque una IA lo redactó, porque una IA hizo la corrección de estilo de dos oraciones, o porque se citó un párrafo con marca. Si tu institución realiza comprobaciones de marcas de agua, lo que la revisión demuestra es que un modelo específico tocó el texto en algún momento, nada más. Nuestra guía sobre impugnar una bandera de detección falsa de IA explica cómo plantear ese argumento cuando importa.
Las marcas de agua y los detectores de IA son tecnologías diferentes con modos de fallo distintos. Detectores como Turnitin o GPTZero estiman a partir del estilo estadístico, con los problemas de precisión que hemos documentado. La detección de marcas de agua es una prueba basada en claves con una tasa de falsos positivos muy baja en texto humano no marcado. La asimetría se invierte para los falsos negativos: una comprobación de marca de agua pasa por alto cualquier texto de IA de un modelo que no marque, y hoy eso incluye a todo ChatGPT.
La divulgación sigue siendo tu postura más sólida. La marcación con marca de agua hace que el uso silencioso de IA sea más riesgoso y que el uso de IA divulgado sea más seguro, porque un flujo de trabajo divulgado no tiene nada que temer de una marca positiva. La mayoría de las revistas y universidades ya tienen políticas explícitas sobre el uso de IA; nuestra política de uso de IA explica cómo trazamos esas líneas en nuestras propias herramientas, y es un modelo razonable de lo que significa un uso transparente.
Qué elimina una marca de agua de texto y qué no
La reescritura lo elimina; el reformatado no. Copiar, pegar, cambiar fuentes, convertir entre formatos de archivo y eliminar caracteres invisibles dejan una marca de agua estadística plenamente intacta, porque la marca está en la elección de palabras. Lo que la elimina es cualquier cosa que regenere el enunciado: una edición humana profunda, una traducción o una paráfrasis genuina, como estableció el trabajo de solidez de NeurIPS 2023 antes de que cualquiera de estos sistemas se lanzara al mercado.
Ambas direcciones importan aquí. Que la marca desaparezca no hace que el texto sea tuyo, y que la marca permanezca no hace que el texto no sea tuyo. Un borrador de IA reescrito sigue siendo un documento asistido por IA al que se aplican las normas de divulgación de tu institución. Nuestro humanizer de IA reescribe borradores asistidos por IA en un registro académico natural y, dado que ese proceso regenera la secuencia de tokens, las marcas estadísticas no sobreviven. Para el caso específico de Claude, el removedor de marca de agua de Claude gratuito reexpresa cada frase con redacción nueva, manteniendo hechos, números y citas sin cambios. Lo que ninguna herramienta puede modificar es lo que le debes a tu lector: la transparencia sobre cómo se elaboró el documento.
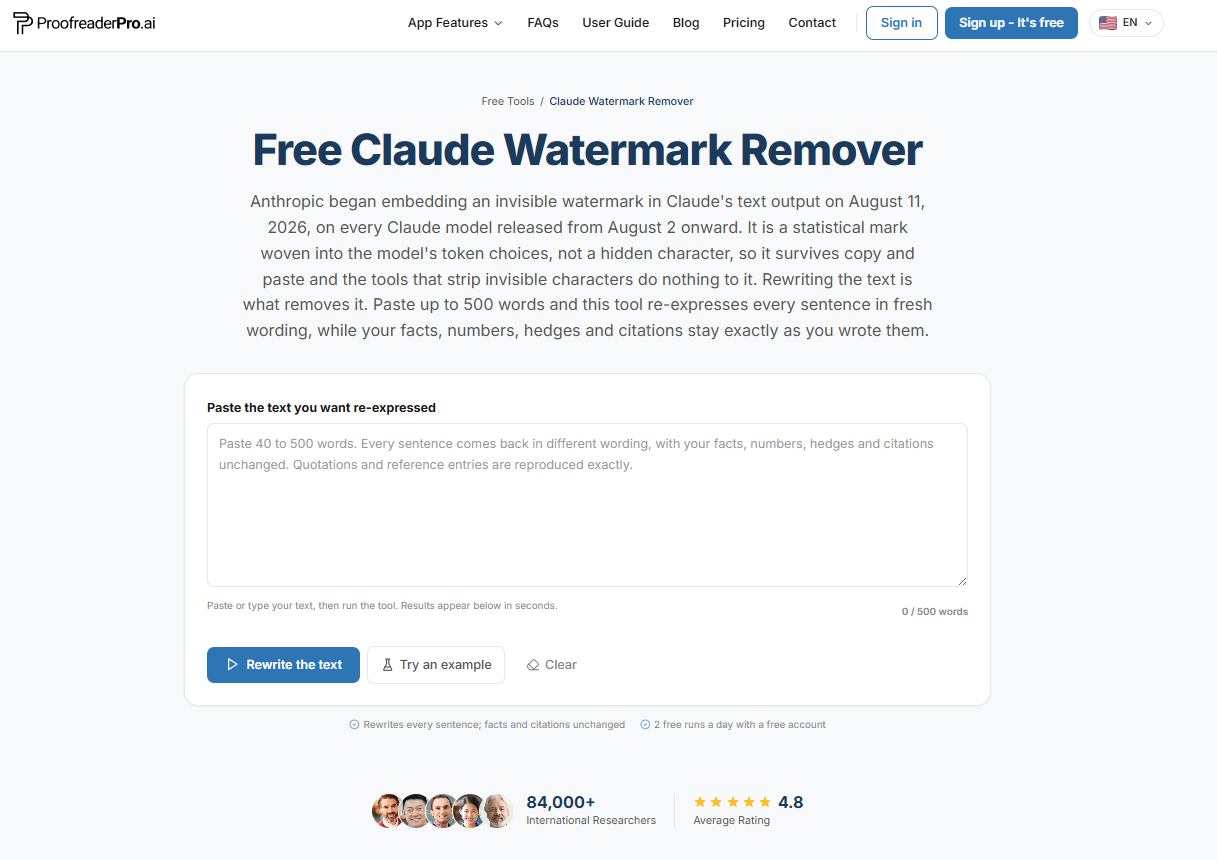
La reescritura es la única operación que elimina una marca estadística, y es exactamente lo que hace esta herramienta, frase por frase.
Adónde va después
Sigue tres aspectos hasta 2027. Primero, si OpenAI lleva textGrain más allá de la UE. Empezó allí porque la aplicación europea del artículo 50 exige marcas legibles por máquina en texto de IA. Segundo, si los detectores convergen. Si cada laboratorio importante marca con un esquema publicado, las universidades pueden comprobar claves en lugar de adivinar a partir del estilo de escritura, lo que mejoraría la detección propensa a falsos positivos. Tercero, si las marcas se vuelven compatibles. Hoy, tres laboratorios usan tres marcas distintas y ningún verificador único las cubre a todas. C2PA cubre ese vacío para archivos; todavía no existe nada que lo cubra para texto sin procesar.
¿ChatGPT marca con agua su texto?
Sí, en parte, desde el 5 de octubre de 2026. OpenAI empezó a añadir su marca textGrain a los textos elegibles de ChatGPT y Codex en la Unión Europea, y los clientes de la API en cualquier lugar pueden activarla. La marca de agua es una señal estadística en las elecciones de palabras, sin caracteres ocultos. OpenAI sí aplica metadatos de procedencia C2PA a los archivos de medios de DALL-E y Sora, que es un sistema separado a nivel de archivo.
¿Google Gemini marca con agua su texto?
Sí. La salida de Gemini ha incorporado la marca de agua SynthID-Text de Google DeepMind desde octubre de 2024. Se trata de una marca estadística en las elecciones de palabras, invisible para los lectores y verificable mediante el Detector de SynthID de Google. Solo se aplica a los modelos propios de Google, así que un resultado negativo de SynthID no dice nada sobre texto de otros sistemas de IA.
¿Claude marca con agua su texto?
Sí. Cada modelo de Claude lanzado en o después del 2 de agosto de 2026 incrusta una marca de agua estadística en la salida de su texto, en cada plataforma y plan, sin opción de exclusión, y los archivos generados por Claude además incluyen metadatos C2PA. Los modelos lanzados antes de esa fecha aún no marcan su salida. Anthropic afirma que está añadiendo compatibilidad con el marcado durante un periodo de transición. Los detalles completos están en nuestro explicador de la marca de agua de Claude.
¿Pueden las universidades detectar marcas de agua de IA?
Solo con la cooperación del proveedor, porque la detección requiere la clave del proveedor. Google ofrece un portal público de detección para contenido de SynthID. Anthropic dice que planea compatibilidad de detección para usuarios y terceros, pero todavía no ha publicado un detector público. Ninguna suite principal de antiplagio puede verificar actualmente marcas de agua estadísticas de ningún laboratorio, así que el supuesto "detección de IA" institucional de hoy sigue significando adivinanza basada en estilo, no verificación de marcas de agua.
¿La marca de agua de IA es obligatoria por ley?
En la UE, sí, con efecto. El artículo 50(2) del Reglamento de IA de la UE exige que los proveedores de IA generativa aseguren que las salidas estén marcadas en un formato legible para máquinas y sean detectables como generadas artificialmente, con obligaciones de transparencia aplicables desde el 2 de agosto de 2026. Anthropic firmó el Código de Prácticas relacionado y eligió cumplir en todo el mundo. La cuestión a vigilar en 2027 es cómo tratan los reguladores el supuesto marcador de texto de OpenAI que aún no se ha lanzado.
¿Sobreviven los marcadores de IA a la traducción?
No. Un marcador estadístico vive en la secuencia exacta de palabras que eligió el modelo, y la traducción reemplaza cada palabra. Lo mismo ocurre con la paráfrasis profunda y la edición humana intensa. Esta limitación está documentada en la bibliografía revisada por pares y reconocida por cada proveedor que comercializa un marcador.
¿Existe un verificador público de marcadores de OpenAI para texto?
No, la herramienta pública de verificación de OpenAI solo revisa archivos de imagen y audio, para metadatos de C2PA y para los marcadores SynthID. OpenAI afirma que no admite texto. Su detector de marcador de texto está abierto solo a investigadores aprobados y organizaciones expertas, caso por caso.
¿Qué es textGrain?
textGrain es el marcador de texto de OpenAI, anunciado el 5 de octubre de 2026. Añade una señal estadística invisible a las elecciones de palabras del modelo, de modo que la marca forma parte de las palabras, sin caracteres ocultos ni metadatos del archivo. OpenAI afirma que coincidió con los otros métodos que probó o los superó, incluido SynthID para texto, y que la edición lo debilita.
¿Los investigadores pueden solicitar acceso al detector de marcadores de texto de OpenAI?
Sí, los investigadores aprobados y las organizaciones expertas pueden solicitarlo mediante el formulario de la Content Provenance API de OpenAI. OpenAI concede acceso caso por caso bajo el Código de Prácticas de la UE. Afirma que revisará un acceso más amplio a medida que la tecnología y la evidencia se desarrollen.
Fuentes
- Anthropic, Cómo funciona el marcador de texto de Claude, agosto de 2026
- Centro de ayuda de Anthropic, Cómo Claude marca contenido generado por IA, 2026
- OpenAI, Comprender el origen de lo que vemos y oímos en línea, mayo de 2024
- Google DeepMind, SynthID
- Dathathri et al., Marcado escalable para identificar salidas de modelos de lenguaje a gran escala, Nature, octubre de 2024
- Google, Anuncio del Detector de SynthID, mayo de 2025
- Hugging Face, Presentación de SynthID Text, octubre de 2024
- Kirchenbauer et al., Un marcador para modelos de lenguaje a gran escala, ICML 2023
- Krishna et al., La paráfrasis elude detectores de texto generado por IA, NeurIPS 2023
- Scott Aaronson, Mi conferencia de seguridad de IA para UT Effective Altruism, noviembre de 2022
- Unión Europea, AI Act, artículo 50
- C2PA, Coalición para la Provisión de Contenidos y Autenticidad
Dana es creadora de contenidos en ProofreaderPro, donde dirige las operaciones diarias de redacción y blogs. Ella escribe artículos sobre cómo funciona la plataforma de edición en línea y maneja los mensajes de los clientes todos los días, con una puntuación de satisfacción de cinco estrellas como prueba.