
OpenAI, Google ve Anthropic hepsi aynı teknolojiyi geliştirdi: AI tarafından üretilen metin için istatistiksel bir damga. OpenAI kendi sürümünü yıllarca bekletti ve Ekim 2026'da textGrain adıyla yaymaya başladı. Google, Gemini içinde SynthID'i sundu ve yöntemi yayımladı. Anthropic, Ağustos 2026'da Claude'un damgasını her kullanıcı için zorunlu hale getirdi. Hangi biçimde olursa olsun AI yardımıyla yazıyorsanız, artık bu üç karar belgelerinizin nasıl değerlendirildiğini belirliyor.
Damgalama, 11 Ağustos 2026'da, Anthropic her yeni Claude modelinin metin çıkışını damgaladığını duyurduğunda araştırma konusundan ana akım haberlere geçti. Bu duyuruyu Claude damga açıklaması sayfamızda ayrıntılı biçimde ele aldık. Bu rehber, bütün resmi kapsar: metin damgası nedir, üç büyük laboratuvarın her biri bunu nasıl uyguladı ya da neden sakladı ve her sistemin bir yazı parçası hakkında neyi kanıtladığı.
AI metin damgası nedir?
AI metin damgası, üretilen metindeki kelime tercihlerinde saklanan istatistiksel bir desendir. Doğrudan üretim anında yerleştirilir; doğru anahtara sahip bir dedektör daha sonra metnin belirli bir AI sisteminden geldiğini doğrulayabilir. Bu, görünür bir etiket değildir, gizli bir karakter değildir ve bir dosyaya eklenmiş metadata değildir. Damga, kelimelerin bizzat içinde yaşar.
Bu ayrım önemlidir; çünkü "damga" terimi gevşek biçimde üç farklı şey için kullanılır:
| Nedir | Nerede yaşar | Kopyala-yapıştır korunur mu? | |
|---|---|---|---|
| İstatistiksel damga | Modelin seçtiği kelimelerdeki bir sapma | Metnin kendisi | Evet |
| Dosya metadata'sı (C2PA) | İmzalı bir köken bildirimi | Dosya kabı | Hayır, düz metin kopyalamak bunu söküp atar |
| Sıfır genişlikli karakterler | Metne gizlice eklenen görünmez Unicode | Görünen karakterlerin arasında | Hayır, basitçe ayıklanır |
Üçü arasında yalnızca istatistiksel damgalama kopyalama, yapıştırma, yeniden yazma ve yeni bir belgesete aktarım ya da biçim dönüştürme gibi işlemlerden sağ çıkıyor. Bu yüzden her üç büyük laboratuvar da metin için bunun üzerinde birleşti ve görünmez karakterleri ayıklayan "damga sökücüler" buna karşı hiçbir şey yapmıyor. Ücretsiz Claude damga sökücü sayfamız bu başarısızlık durumunu kaynaklarıyla birlikte belgeliyor.
İstatistiksel damgalama gerçekte nasıl çalışır?
Bir cümleyi yazmanın her adımında bir dil modeli, birbirine yakın birden fazla sözcük arasından seçim yapar ve damga sessizce bu zarların dağıtımını yükler. Temel tarif, Ocak 2023'te Maryland Üniversitesi'nde Kirchenbauer ve çalışma arkadaşları tarafından yayımlandı: Büyük Dil Modelleri için Bir Damga (ICML 2023). Şöyle çalışır:
- Her sözcük seçilmeden önce, önceki sözcüklerden türetilen gizli bir anahtar, sözlüğü tercih edilen bir küme ve nötr bir küme olarak ayırır.
- Model seçimini tercih edilen kümeye doğru hafifçe iter. "İndicate" yerine "suggest". "Among" yerine "across". Her tekil seçim tamamen doğal görünür.
- Anahtarı elinde tutan bir dedektör, metnin tercih edilen kümelere ne sıklıkla düştüğünü sayar. İnsan yazısı şansa bağlı olarak beklenen oranı yakalar. Damgalı metin ise bunu çok daha sık yakalar ve istatistiksel bir test tutarsızlığı işaretler.
Tek bir sözcük tek başına herhangi bir şeyin kanıtı değildir. Sinyal onlarca ya da yüzlerce seçim boyunca ancak ortaya çıkar; bu yüzden daha uzun bölümler kısa parçalardan daha kolay test edilir ve bu nedenle algılama her zaman evet/hayır damgası değil olasılıksaldır.
Google DeepMind'ın üretim sistemi, Ekim 2024'te Nature dergisinde Büyük dil modeli çıktıları belirleme için ölçeklenebilir damgalama adıyla yayımlandı. Bu çalışma, metin kalitesini yeterince iyi koruyarak, ölçek düzeyinde bir tüketici ürününün içinde sessizce çalıştırmaya izin veren tournament sampling adı verilen bir teknikle bunu daha da geliştirdi. Bu makale Google'ın ötesinde de önemlidir: Anthropic'in Claude'un uygulaması için işaret ettiği, yayımlanmış dayanak budur.
En büyük zayıflık, çoğu dağıtımdan önce yayımlanmış olmasıydı. Mart 2023'te Krishna ve çalışma arkadaşları Parafraz, AI tarafından üretilen metin dedektörlerinden kaçınır (NeurIPS 2023) çalışmasında, bir pasajın sözcüklerini yeniden üretmenin, damgalama dahil tüm yöntemlerde algılamayı çökerttiğini gösterdi. Sinyal yalnızca tam belirteç dizisinde yaşar, başka hiçbir yerde yaşamaz; bu yüzden diziyi yeniden yazan her şey, insan editör dahil, kanıtı da yeniden yazar ve ortadan kaldırır. Bugün damga kullanan her tedarikçi, bu sınırlamayı kendi dokümantasyonunda mutlaka belirtir.

OpenAI: bunu icat eden ve en son uygulayan şirket
OpenAI'ın yıllardır çalışan bir metin damgası vardı ve Ekim 2026'ya kadar yayımlamayı seçmedi. O dönemde OpenAI'da güvenlik üzerinde çalışan Scott Aaronson, fikri ilk kez kamuya açık olarak Kasım 2022 dersi ile anlattı. Bu yöntem, birbirine yakın eşdeğer sözcükler arasındaki model seçimlerini gizli bir kriptografik işlevle önyargılı hale getirir; böylece metnin kendisi, nereden geldiğini gösterir. Bu ders, dağıtılmış tüm sistemlerin her birinden daha eskidir.
2024 Mayıs ayında OpenAI, provenance güncellemesinde projenin durumuna ilişkin bilgileri paylaştı. Gördüklerimizi ve duyduklarımızı çevrim içi ortamda kaynağından anlama. Şirket, metin watermarking yönteminin küçük düzenlemelerde doğru ve etkili olduğunu söyledi ancak fayda ve maliyetleri tarttığı için yayımı erteledi. OpenAI'nin saydığı risklerden ikisi akademik yazarlar için doğrudan önem taşıyor:
- Kolay atlatma. Metni yeniden ifade etmek veya başka dile çevirmek işareti kaldırıyor; 2023'te yapılan araştırmanın öngördüğü şekilde. Varlığından haberi olmayan kişileri çoğunlukla yakalayan, genel geçer bir watermark, zayıf bir uygulama aracıdır.
- İkinci dil olarak İngilizce kullananlara orantısız etki. OpenAI, watermarking işleminin, ikinci bir dilde yazan kişiler için yazma desteği olarak kullanılan AI'nin meşru kullanımını damgalayabileceğini belirtti. AI dedektörlerinin ana dili İngilizce olmayan yazarları neden işaretlediği başlıklı çalışmamız, sorunu dedektör tarafında da aynı şekilde ele alıyor.
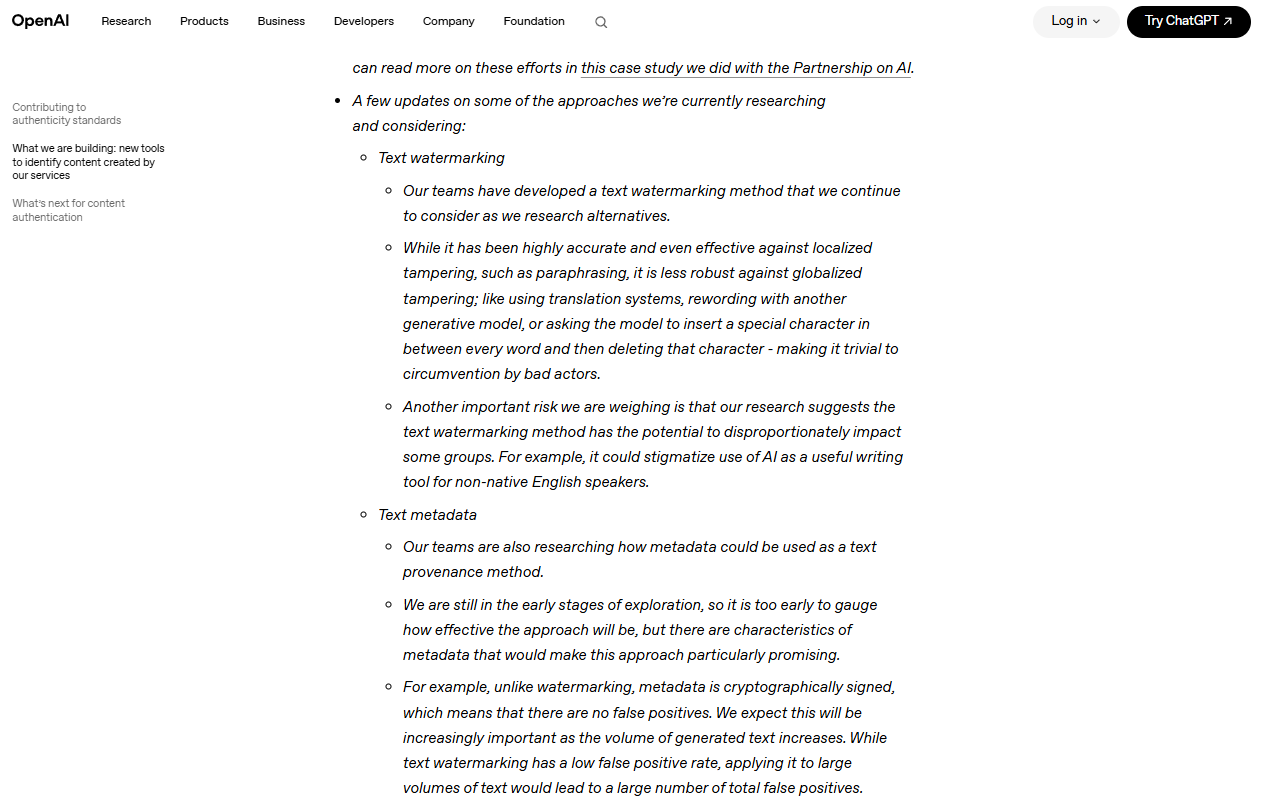
OpenAI'nin 2024 provenance güncellemesi: yöntem çalışıyor ve şirket o dönemde geri tutma nedenlerini listeliyor.
Görüntüler ve ses için OpenAI farklı bir yol izledi: DALL-E ve Sora çıktılarına C2PA provenance meta verileri eklendi. Bu, içerikte bir işaret değil, dosya düzeyinde bir etiket. Metin içinse ChatGPT çıktısında Ekim 2026'ya kadar watermark yoktu. Teknolojiyi öneren şirket, üçü içinde bunu devreye alan son kişi oldu.
OpenAI metni şimdi watermarklıyor mu?
Evet. OpenAI, AB'deki EU AI Act yanıt olarak 5 Ekim 2026'da bazı metinleri watermarklamaya başladı. Şirketin duyurusu, metin seçimlerine modele görünmez bir istatistiksel sinyal ekleyen textGrain adlı bir metin watermark'ı tanıtıyor. Açılım üç parçadan oluşuyor ve watermark küresel varsayılan değil:
- Her yerden API müşterileri, seçili modeller için watermark'lı çıktıyı açabiliyor. Varsayılan olarak kapalı.
- İzleyen haftalarda, Avrupa Birliği'ndeki uygun ChatGPT ve Codex metin çıktıları, tüm planlarda watermark'ı alıyor.
- Onaylı araştırmacılar ve uzman kuruluşlar, metin watermark dedektörüne erişim için başvurabilir.
OpenAI, denediği diğer yöntemlerle karşılaştırıldığında textGrain'ın eşleştiğini ya da geçtiğini söylüyor. Bu yöntemler arasında, metin için Google'ın SynthID'ı da var. Ayrıca algılamanın nerede zayıfladığını da paylaştı. Dedektör, %1 yanlış pozitif oranında, psikoloji içeriğindeki 200 kelimelik bölümlerde yaklaşık %80 ve 400 kelimelik bölümlerde yaklaşık %95 oranında watermark'ı tespit ediyor. Kelime seçiminde daha az esneklik bulunan matematikte algılama çok daha düşük.
Düzenleme sinyali hızla zayıflatır. 400 kelimelik bölümlerde, kelimelerin %10'unu eş anlamlılarla değiştirmek algılamayı yaklaşık %92'den %66'ya düşürdü ve %25'i değiştirmek %17'ye indirdi.
OpenAI ayrıca Astra adlı en yeni modelinde, watermark'ın yanıt kalitesini değiştirip değiştirmediğini kontrol ettiğini ve anlamlı bir fark görmediğini söylüyor. Paylaştığı dört kıyas ölçütü şunlar:
| Kıyas ölçütü | Watermark yok (Astra) | Watermark var (Astra) |
|---|---|---|
| Yapay Analiz Intelligence Index | 49.57 puan | 49.76 puan |
| GPQA Diamond | 94.44% | 93.94% |
| HealthBench Professional | 64.27% | 64.60% |
| BrowseComp | 87.92% | 87.35% |
Öğrenciler için tarih önemlidir. Yayımdan önce yazılmış ChatGPT metni ya da API ayarı olmadan AB dışında yazılmış metinlerde OpenAI watermark'ı yoktur. Bu arada okulların kendi AI kullanım politikalarını nasıl belirlediğini açıklayan Turnitin Clarity Açıklandı rehberimize göz atın.
Herkese açık bir OpenAI watermark kontrolcüsü var mı?
Şimdilik metin için herkese açık bir OpenAI damga doğrulama denetleyicisi yok. OpenAI’nin ücretsiz doğrulama aracı görüntü ve ses dosyalarını C2PA Content Credentials için ve OpenAI’nin desteklenen görüntü ve ses dosyalarına gömdüğü bir SynthID damgası için kontrol eder. OpenAI, aracın metni desteklemediğini söylüyor.
Metin için OpenAI, onaylı araştırmacılar ve uzman kuruluşlar için dedektör erişimini, Content Provenance API formu üzerinden es es vermektedir. Metin dedektörünü lansmanda kamuya sunmadığını, kaçırılan damgalar ve yanlış pozitif riski nedeniyle yapmadığını söylüyor. Dedektör, OpenAI damgası bulup bulmadığını bildirir ve kullanıcıyı tanımlamaz ya da istemlerini göstermez.
| Ne kontrol etmek istiyorsunuz | Araç | Kim kullanabilir |
|---|---|---|
| Bir OpenAI görüntü ya da ses dosyası | OpenAI’nin doğrulama aracı | Herkes, ücretsiz |
| OpenAI metin çıktısı (textGrain) | OpenAI metin su izi dedektörü | Başvuru ile onaylı araştırmacılar ve uzman kuruluşlar |
| Claude metin çıktısı | Claude Watermark Detector | Başvuru ile uygun kuruluşlar (bkz. Claude watermark kılavuzumuz) |
OpenAI ayrıca bir sonucun size ne söyleyemeyeceğini de açıkça belirtiyor. Tespit edilen bir damga, bir kişinin ne kadar katkı yaptığını ölçmez ve metni kimin yazdığını ya da kullandığını belirlemez. Eksik bir damga da insan tarafından yazarlığı kanıtlamaz; çünkü metin çok kısa olabilir, düzenlenmiş olabilir, çevrilmiş olabilir ya da desteklenmeyen bir modelden gelmiş olabilir.
Google: önce piyasaya sürdü, sonra tarifi açtı
Google DeepMind önce çıktı, ardından tamamen yayımladı ve yöntemi daha sonra herkesin kullanımına açtı. Sistemi, SynthID, 2023’te bir görüntü damgası olarak başladı ve 2024’te metne genişledi. Nature makalesi Ekim 2024’te yayınlandığında SynthID-Text, zaten üretimde Gemini içinde çalışıyordu. Bu da onu tüketici ölçeğinde ilk istatistiksel metin damgası yapan dağıtım haline getirdi.
SynthID metni, görselleri, sesi ve videoyu kapsar ve Ekim 2024’ten beri Gemini metin çıktısında kullanımdadır.
Google daha sonra uygulamayı Hugging Face’te açık kaynak olarak yayımladı ve böylece herhangi bir geliştirici, kendi modellerine aynı damgalama düzenini uygulayabildi. Mayıs 2025’te, içeriklerin metin, görseller, ses ve video boyunca SynthID işaretleri açısından kontrol edilebildiği bir doğrulama portalı olan SynthID Detector’ü duyurdu.
Önemli bir kapsam sınırlaması var: SynthID yalnızca Google’ın kendi modellerinden gelen içerikleri işaretler ve yalnızca onları tespit eder. ChatGPT ya da Claude çıktısı hakkında hiçbir şey söylemez ve temiz bir SynthID taraması, bir metnin insan tarafından yazıldığı anlamına gelmez. Bu, Google’ın modellerinin bunu yazmadığı anlamına gelir; bu da çok daha dar bir iddiadır.
Anthropic: en son hamle yapan, en katı politika
Anthropic en geç devreye aldı ve en geniş zorunlu kapsama sahip oldu. 2 Ağustos 2026 tarihinde ya da sonrasında piyasaya sürülen her Claude modeli, metin çıktısına istatistiksel bir damgayı, dünya genelinde, her plan için gömer ve vazgeçme seçeneği yoktur. Şirket, mekanizmayı anlatan açıklamasında Claude’nin metin damgası nasıl çalışır? başlığını kullanıyor ve politika kapsamını yardım merkezi makalesinde, Claude AI tarafından üretilen içerik nasıl işaretler? şeklinde yayımlıyor: Claude API, claude.ai, Claude Code, Claude Cowork ve Claude Tag hepsi kapsam altındadır. Kesim tarihinden önce piyasaya sürülen modeller geçiş dönemindedir ve Anthropic, onlara da işaretleme desteği eklediğini söylüyor. İstatistiksel işaretin yanı sıra, Claude tarafından üretilen dosyalar ayrıca, düz metin kopyalamayla silinen ikinci ve ayrı bir sistem olan C2PA meta verisi taşır.
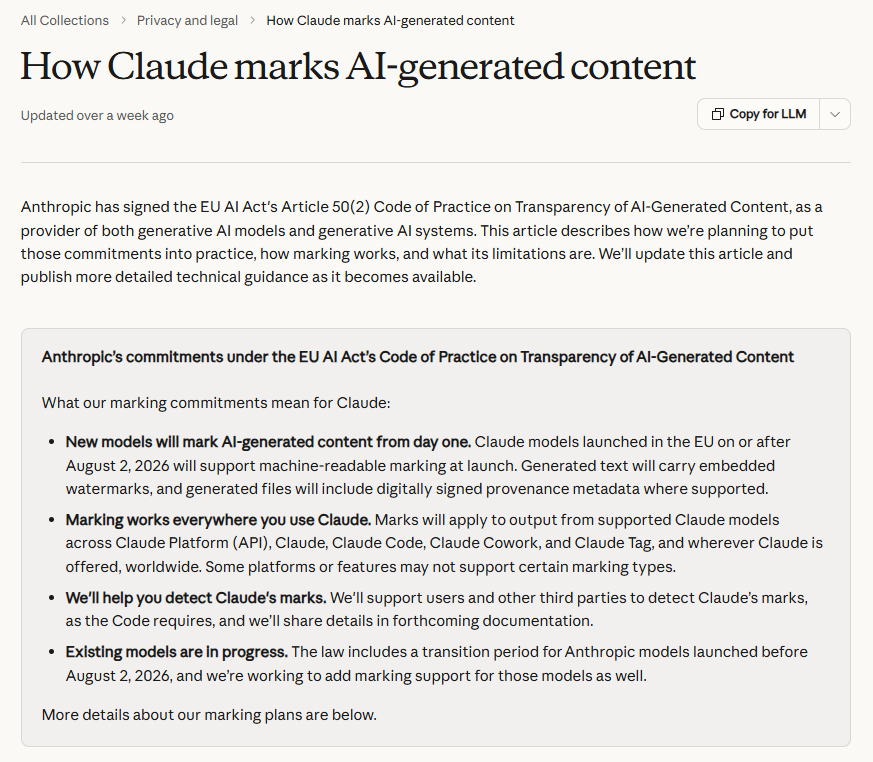
Anthropic'in kendi ifadeleriyle politika: her yeni model, her platform, dünya genelinde ve daha eski modellerin eklenmesi.
Anthropic'in dokümantasyonu sınırları doğrudan belirtiyor. Tespit olasılıksaldır. İşaretleme, Claude'ın yazdığı bir dokümanı bir insanın yazdığı ve Claude'ın sadece hafifçe düzenlediği bir dokümandan ayırt edemez. Tam bir yeniden yazım bunu ortadan kaldırır. Pozitif bir tespit neyi gerçekten kanıtlar ve kendi yazınız işaretlenirse ne yapmanız gerekir dahil olmak üzere bunların hepsini ayrılmış Claude watermark kılavuzunda adım adım ele aldık.
Zamanlama düzenlemeyi takip ediyor. Anthropic, EU AI Act kapsamında Yapay Zeka ile Üretilen İçerik Şeffaflığına ilişkin Madde 50(2) Uygulama Kodu'nu imzaladı. Bu kod, üretken yapay zeka sistemleri sağlayıcılarının çıktıları "makine tarafından okunabilir bir formatta işaretlemesini ve yapay olarak üretildiğinin tespit edilebilir olmasını" şart koşuyor. Bu şeffaflık yükümlülükleri 2 Ağustos 2026 tarihinde geçerli oldu. Bu tarih, kamuya duyurudan dokuz gün önce, Anthropic'in model politikasındaki kesin kesim tarihidir. Anthropic, AB trafiği için ayrı bir davranış sürdürmek yerine küresel olarak uyum sağlamayı seçti. Google ise tasarıma göre zaten uyumluydu. OpenAI'nin işaretsiz metin çıktısı 2027 için açık bir uyum sorusu.
Üç yaklaşım yan yana
| OpenAI | Google DeepMind | Anthropic | |
|---|---|---|---|
| Metin watermark'u dağıtıldı mı? | Evet (textGrain, 5 Ekim 2026'dan itibaren AB yayılımı) | Evet (Gemini, Ekim 2024'ten beri) | Evet (Claude modelleri, 2 Ağustos 2026'dan itibaren) |
| Teknik | Sözcük seçimlerinde istatistiksel bir sinyal olan textGrain | SynthID-Text turnuva örneklemesi | İstatistiksel örnekleme işareti, SynthID tarzı |
| Kapsam | AB içinde uygun olan ChatGPT ve Codex metni; API ile tüm dünyada isteğe bağlı | Yalnızca Google modelleri | Tüm yeni Claude modelleri; daha eski modeller geçişte |
| Opt-out | API'de varsayılan olarak kapalı | Hayır | Hayır |
| Genel tespit aracı | Hayır | SynthID Detector portalı (2025) | Planlandı, henüz yayımlanmadı |
| Şema yayımlandı mı? | Sadece konsept dersleri | Nature makalesi + açık kaynak | Yayınlanmış çalışmalara dayalı açıklama |
| Dosya meta verileri (C2PA) | Evet, görseller ve ses | Evet, medya türleri arasında | Evet, üretilmiş dosyalarda |
| Belirtilen sınırlılıklar | Aşma, ESL damgası | Kapsam kendi modelleriyle sınırlı | Olasılıksal, düzenlemeler yazarlığı bulanıklaştırır |
Sütunlar boyunca ortak desen şu: OpenAI metin watermarking yöntemini çözülememiş bir politika sorunu olarak görüyor; Google bunu standartlaştırılacak bir altyapı olarak görüyor; Anthropic ise eksiksiz uygulanması gereken bir uyum yükümlülüğü olarak ele alıyor.
Bunun araştırmacılar ve akademik yazarlar için anlamı
Pratik sonuçlar, metninizle hangi araçların etkileşime girdiğine bağlıdır. ChatGPT ile taslak yazarsanız, bugün metninizde bir watermark yoktur. Gemini ile taslak yazarsanız, metninizde yalnızca Google'ın algılayıcısının okuyabildiği bir SynthID işareti bulunur. Mevcut bir Claude modeliyle taslak yazarsanız veya düzenlerseniz, metninizde Anthropic'in işareti olur ve bunu kapatan bir ayar yoktur.
Akademik yazarların bilmesi gereken üç şey:
Bir watermark, bir aracı tanımlar; bir yazar değildir. Her sağlayıcı bunu kendi dokümantasyonunda belirtir ve kurum politikaları her zaman bu ayrımı yapmadığı için bunu tekrar etmek değerlidir. Metin işaretlenebilir çünkü bunu bir AI tasarlamıştır, çünkü bir AI bunun içindeki iki cümleyi kopya-düzeltme olarak düzenlemiştir ya da işaretli bir paragraf alıntılanmıştır. Kurumunuz watermark kontrolleri yapıyorsa, testin kanıtladığı şey belirli bir modelin metne bir noktada dokunmuş olduğudur, bundan fazlası değildir. Yanlış bir AI tespit uyarısına itiraz etme rehberimiz bunu gerektiğinde nasıl savunacağınızı anlatır.
Watermark'lar ve AI algılayıcıları farklı teknolojilerdir; farklı arıza türleri vardır. Turnitin ya da GPTZero gibi algılayıcılar istatistiksel stile bakarak tahmin yapar ve belgelendiğimiz doğruluk sorunlarına sahiptir. Watermark algılama, işaretli olmayan insan metninde çok düşük yanlış pozitif oranı olan anahtarlı bir testtir. Yanlış negatifler tarafında asimetri tersine döner: watermark oluşturmayan bir modelden çıkan herhangi bir AI metni kontrolü atlar; bu da günümüzde ChatGPT'nin tamamını kapsar.
Açıklama, güçlü konumunuz olmaya devam eder. Watermark'lama sessiz AI kullanım riskini artırır, açıklanmış AI kullanımı ise güvenli hale getirir çünkü açıklanmış bir iş akışının pozitif bir işaretten korkacak bir şeyi yoktur. Çoğu dergi ve üniversitenin artık açık AI kullanımı politikaları vardır. Kendi araçlarımız arasında bu çizgileri nasıl çizdiğimizi anlatan AI kullanım politikamız, şeffaf kullanımın nasıl göründüğüne dair makul bir şablondur.
Bir metin watermark'ını ne kaldırır ve ne kaldırmaz
Yeniden yazmak kaldırır; biçimlendirmek kaldırmaz. Kopyalama, yapıştırma, yazı tiplerini değiştirme, dosya biçimleri arasında dönüştürme ve görünmez karakterleri temizleme gibi işlemlerin tümü istatistiksel watermark'ı tamamen bozulmadan bırakır; çünkü işaret kelime seçimlerine gömülüdür. Kaldıran şey, metni yeniden üreten her şeydir: derin bir insan düzenlemesi, çeviri veya gerçek bir yeniden ifade (parafraz). Bu durum, NeurIPS 2023 sağlamlık çalışmasında bu sistemler herhangi birine çıkmadan önce gösterilmiştir.
İki yönde de önemli olan şeyler var. İşaretin kaybolması metni size ait yapmaz; işaretin kalması da metnin size ait olmadığı anlamına gelmez. Yeniden yazılmış bir yapay zeka taslağı, kurumunuzun açıklama kurallarının uygulandığı, AI destekli bir belgedir. AI text humanizer AI destekli taslakları doğal bir akademik üsluba yeniden yazar ve bu süreç belirteç dizisini yeniden ürettiği için istatistiksel işaretler korunmaz. Claude metni özelinde ise claude Filigran Kaldırıcı her cümleyi, bilgiler, sayılar ve atıflar değişmeden, taze bir ifade ile yeniden anlatır. Hiçbir aracın değiştiremeyeceği tek şey, okuyucuya karşı sorumluluğunuzdur: belgenin nasıl hazırlandığı konusunda şeffaf olmanız.
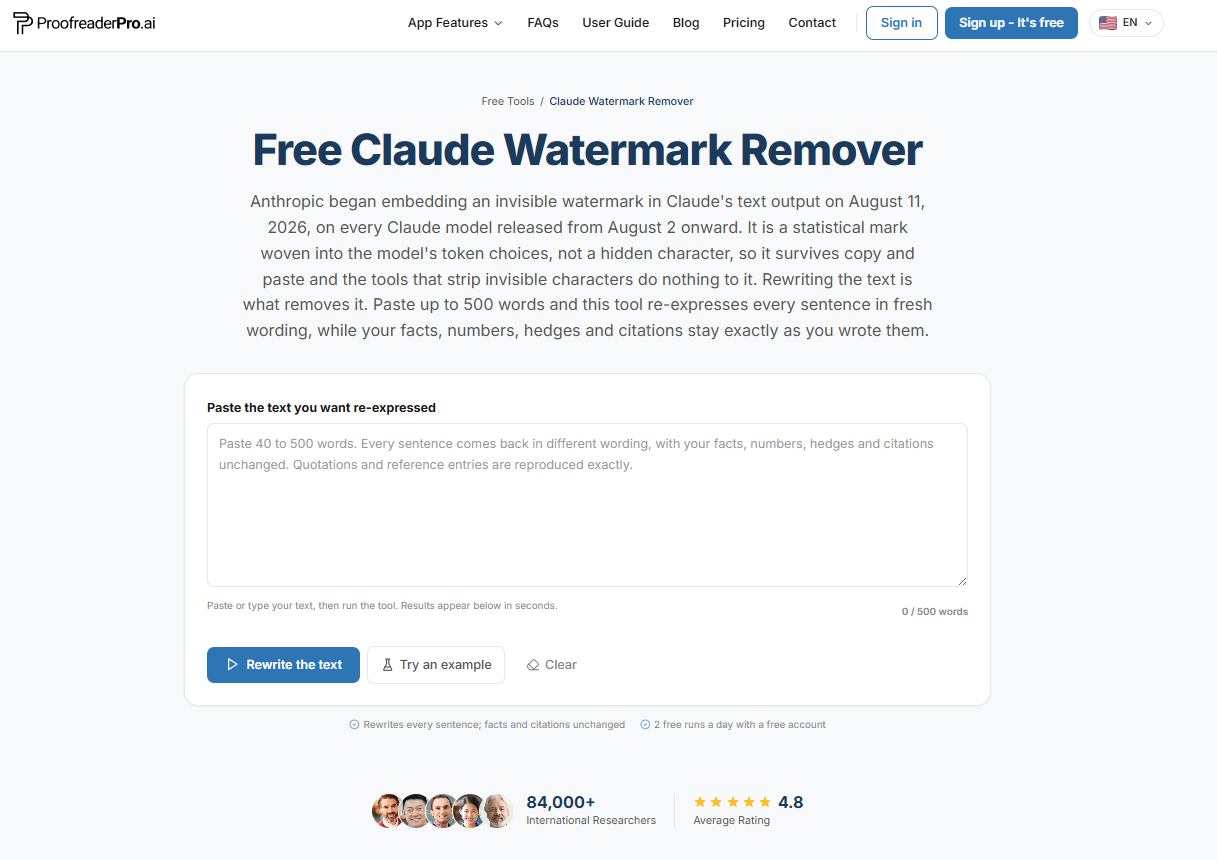
Yeniden yazma, istatistiksel bir işareti kaldıran tek işlemdir ve bu araç, cümle cümle bunu yapar.
Sıradaki adım neresi
2027’ye kadar üç şeyi izleyin. Birincisi, OpenAI’ın textGrain’i AB’nin dışına taşıyıp taşımadığı. Orada başladı; çünkü AB’de, Madde 50’nin uygulanması AI metninde makine tarafından okunabilir işaretler gerektiriyor. İkincisi, tespit sistemlerinin yakınsamayı sağlayıp sağlamadığı. Tüm büyük laboratuvarlar yayımlanmış bir şema ile işaretleme yaparsa, üniversiteler yazım stilinden tahmin yürütmek yerine anahtarları kontrol edebilir; bu da bugün yaşanan 2026'da YZ Dedektörleri Ne Kadar Doğru? Test Edilmiş Doğruluk ve Yanlış Pozitifler durumlarını azaltır. Üçüncüsü, işaretlerin birbirleriyle uyumlu hale gelip gelmediği. Bugün üç laboratuvarın her biri üç farklı işareti kullanıyor ve bunların hepsini tek bir kontrol kapsayamıyor. Dosyalar için C2PA bu boşluğu doldurur; ham metin içinse henüz hiçbir şey doldurmuyor.
ChatGPT metnini işaretler mi?
Evet, kısmen. 5 Ekim 2026’dan itibaren OpenAI, Avrupa Birliği’nde uygun ChatGPT ve Codex metinlerine textGrain işaretini eklemeye başladı ve API müşterileri dünyanın herhangi bir yerinden bunu açabilir. İşaret, kelime seçimlerinde istatistiksel bir sinyal olarak çalışır; gizli karakter içermez. OpenAI, DALL-E ve Sora medya dosyalarına ayrıca C2PA menşei (provenance) meta verisi uygular; bu, dosya düzeyinde ayrı bir sistemdir.
Google Gemini metnini işaretler mi?
Evet. Gemini çıktıları, Ekim 2024’ten beri Google DeepMind’ın SynthID-Text watermark’ünü taşır. Bu, okuyucuların göremediği, kelime seçimlerinde istatistiksel bir işarettir ve Google’ın SynthID Detector’ü aracılığıyla kontrol edilebilir. Yalnızca Google’ın kendi modelleri için geçerlidir; bu nedenle negatif bir SynthID sonucu, diğer AI sistemlerinden gelen metinler hakkında bir şey söylemez.
Claude metnini işaretler mi?
Evet. 2 Ağustos 2026 tarihinde ya da sonrasında piyasaya sürülen her Claude modeli, metin çıktısına her platformda ve her planda istatistiksel bir işaret gömer; bunun kapatılmasına izin yoktur ve Claude-generated dosyaları ayrıca C2PA meta verisi taşır. Bu tarihten önce piyasaya sürülen modeller henüz çıktısını işaretlemiyor. Anthropic, geçiş dönemi boyunca bunlara işaretleme desteği eklediğini söylüyor. Tam ayrıntılar Claude watermark açıklayıcımızda yer alıyor.
Üniversiteler AI watermark’lerini tespit edebilir mi?
Yalnızca satıcının iş birliğiyle, çünkü tespit için satıcının anahtarı gerekir. Google, SynthID içerikleri için herkese açık bir dedektör portalı sunar. Anthropic, kullanıcılar ve üçüncü taraflar için tespit desteğinin planlandığını ancak henüz herkese açık bir dedektör yayımlamadığını söylüyor. Günümüzde hiçbir yaygın intihal tespit paketi, herhangi bir laboratuvarın istatistiksel watermark’lerini doğrulayacak şekilde bunu kontrol edemez. Bu nedenle kurumsal "AI detection" bugün hâlâ yazım stiline dayalı tahmin demektir, watermark doğrulaması değil.
AI watermark’leme yasal olarak zorunlu mu?
AB'de evet, fiilen geçerli. AB Yapay Zeka Yasası'nın 50(2). maddesi, jeneratif AI sağlayıcılarının çıktıları makine tarafından okunabilir bir formatta işaretlemesini ve yapay olarak üretildiğinin tespit edilebilir olmasını şart koşuyor. Şeffaflık yükümlülükleri 2 Ağustos 2026'dan itibaren geçerli olacak. Anthropic ilgili Uygulama Kodu'nu imzaladı ve küresel uyumu seçti. Düzenleyicilerin OpenAI'nin yayımlanmamış metin watermark'üne yaklaşımı 2027'de merakla izlenecek konu.
AI watermark'leri çeviriden sağ çıkıyor mu?
Hayır. İstatistiksel bir watermark, modelin seçtiği kelimelerin tam diziliminde yaşar ve çeviri her kelimeyi değiştirir. Derin parafrazlarda ve yoğun insan düzenlemelerinde de durum aynıdır. Bu sınırlılık hakemli literatürde belgelenmiştir ve watermark sunan her satıcı tarafından kabul edilmektedir.
Metin için herkese açık bir OpenAI watermark kontrol aracı var mı?
Hayır, OpenAI'nin herkese açık doğrulama aracı yalnızca görüntü ve ses dosyalarını, C2PA meta verileri ile SynthID watermark'lerini kontrol eder. OpenAI metin için destek vermediğini söylüyor. Metin watermark'i tespit aracı yalnızca onaylı araştırmacılara ve uzman kuruluşlara, vaka bazında açıktır.
textGrain nedir?
textGrain, OpenAI'nin metin watermark'üdür ve 5 Ekim 2026'da duyurulmuştur. Modelin kelime seçimlerine görünmez bir istatistiksel sinyal ekler; bu nedenle işaret kelimelerin bir parçasıdır, gizli karakterler ya da dosya meta verileri içermez. OpenAI, test ettiği diğer yöntemleri, metin için SynthID de dahil olmak üzere eşleştirdiğini ya da geçtiğini ve düzenlemenin bunu zayıflattığını söylüyor.
Araştırmacılar OpenAI'nin metin watermark'i tespit aracına erişim için başvurabilir mi?
Evet. Onaylı araştırmacılar ve uzman kuruluşlar, OpenAI'nin Content Provenance API formu üzerinden başvurabilir. OpenAI, AB Uygulama Kodu kapsamında erişimi vaka bazında sağlar. Teknoloji ve kanıtlar geliştikçe daha geniş erişimi yeniden değerlendireceğini söylüyor.
Kaynaklar
- Anthropic, Claude'un metin watermark'i nasıl çalışır, Ağustos 2026
- Anthropic Help Center, Claude AI tarafından üretilen içeriği nasıl işaretler, 2026
- OpenAI, İnternette gördüğümüz ve duyduğumuz şeyin kaynağını anlamak, Mayıs 2024
- Google DeepMind, SynthID
- Dathathri ve diğerleri, Büyük dil modeli çıktılarının tanımlanması için ölçeklenebilir watermarkleme, Nature, Ekim 2024
- Google, SynthID Detector duyurusu, Mayıs 2025
- Hugging Face, SynthID Text'i tanıtma, Ekim 2024
- Kirchenbauer ve diğerleri, Büyük Dil Modelleri için bir Watermark, ICML 2023
- Krishna ve diğerleri, Parafraz, AI tarafından üretilmiş metnin dedektörlerinden kaçınır, NeurIPS 2023
- Scott Aaronson, UT Effective Altruism için benim AI Güvenlik Dersi, Kasım 2022
- Avrupa Birliği, AI Act, Madde 50
- C2PA, İçerik Kökeni ve Kimliği Doğrulama için Koalisyon
Dana, günlük blog ve yazma operasyonlarını yürüttüğü ProofreaderPro'de içerik yaratıcısıdır. Çevrimiçi düzenleme platformunun nasıl çalıştığına dair makaleler yazıyor ve her gün müşteri mesajlarını beş yıldızlı bir memnuniyet puanıyla ele alıyor.