
OpenAI, Google dan Anthropic semuanya membina teknologi yang sama: watermark statistik untuk teks yang dijana AI. OpenAI menahan versi mereka selama bertahun-tahun dan mula melancarkannya, sebagai textGrain, pada Oktober 2026. Google menyertakan SynthID dalam Gemini dan menerbitkan kaedah tersebut. Anthropic mewajibkan watermark Claude untuk setiap pengguna pada Ogos 2026. Jika anda menulis dengan bantuan AI dalam apa jua bentuk, ketiga-tiga keputusan ini kini menentukan cara dokumen anda dinilai.
Watermarking berpindah daripada topik penyelidikan kepada berita arus perdana pada 11 Ogos 2026, apabila Anthropic mengumumkan bahawa setiap model Claude baharu menandakan output teksnya. Kami membincangkan pengumuman itu secara terperinci dalam penerang cap air Claude. Panduan ini meliputi gambaran penuh: apa itu cap air teks, bagaimana setiap tiga makmal utama melaksanakannya atau menahannya, dan apa yang ditunjukkan oleh setiap sistem tentang sesuatu karya tulis.
Apakah cap air teks AI?
Cap air teks AI ialah corak statistik yang disembunyikan dalam pilihan kata bagi teks yang dijana, ditanam pada saat penjanaan supaya pemeriksa yang memiliki kunci yang betul kemudiannya dapat mengesahkan teks itu datang daripada sistem AI tertentu. Ini bukan label yang boleh dilihat, bukan aksara tersembunyi, dan bukan metadata yang dilekatkan pada fail. Tanda itu wujud pada kata-kata itu sendiri.
Perbezaan itu penting, kerana istilah "watermark" digunakan secara longgar untuk tiga perkara berbeza:
| Apa itu | Di mana ia berada | Adakah ia kekal selepas salin-tampal? | |
|---|---|---|---|
| Cap air statistik | Bias dalam pilihan kata yang dibuat oleh model | Teks itu sendiri | Ya |
| Metadata fail (C2PA) | Label provenance yang ditandatangani | Bekas fail | Tidak, penyalinan teks biasa menanggalkannya |
| Ciri-ciri lebar-sifar | Unicode yang tidak kelihatan disisipkan ke dalam teks | Antara aksara yang kelihatan | Tidak, hanya disingkirkan dengan mudah |
Penjejakan tanda air statistik adalah satu-satunya daripada tiga jenis yang masih bertahan apabila disalin, ditampal, ditaip semula ke dalam dokumen baharu, dan ditukar format. Sebab itulah ketiga-tiga makmal utama berkumpul padanya untuk teks, dan sebab itulah "pembuang tanda air" yang menyingkirkan aksara tak kelihatan tidak memberi apa-apa kesan terhadapnya. Halaman kami pembuang tanda air Claude percuma mendokumentasikan kegagalan ini dengan sumber.
Bagaimana penjejakan tanda air statistik sebenarnya berfungsi?
Pada setiap langkah ketika menulis satu ayat, sebuah model bahasa memilih antara beberapa perkataan yang hampir setara, dan tanda air itu diam-diam memuatkan dadu tersebut. Resipi asas diterbitkan oleh Kirchenbauer dan rakan-rakan di University of Maryland pada Januari 2023, dalam Tanda Air untuk Model Bahasa Skala Besar (ICML 2023). Cara ia berfungsi seperti ini:
- Sebelum setiap perkataan dipilih, sebuah kunci rahsia yang terhasil daripada perkataan sebelumnya akan membahagikan kosa kata kepada set pilihan dan set neutral.
- Model akan mengubah sedikit pilihannya ke arah set pilihan. "Suggest" dan bukan "indicate". "Across" dan bukan "among". Setiap pilihan individu nampak sepenuhnya semula jadi.
- Sebuah pengesan yang memegang kunci akan mengira kekerapan teks mendarat dalam set pilihan. Penulisan manusia mencapai kadar jangkaan secara kebetulan. Teks bertanda air mendarat jauh terlalu kerap, dan ujian statistik menandakan ketidakselarasan tersebut.
Tiada satu perkataan pun sebagai bukti apa-apa. Isyarat hanya muncul merentasi puluhan atau ratusan pilihan, sebab itu petikan yang lebih panjang lebih mudah diuji berbanding yang pendek, dan sebab itu pengesanan sentiasa bersifat kebarangkalian, bukan cap ya atau tidak.
Sistem pengeluaran Google DeepMind, yang diterbitkan dalam Nature pada Oktober 2024 sebagai Tanda air berskala untuk mengenal pasti keluaran model bahasa skala besar, menambah baiknya dengan teknik yang dipanggil tournament sampling, yang memelihara kualiti teks dengan cukup baik untuk berjalan senyap di dalam produk pengguna pada skala. Kertas ini penting melangkaui Google: ia adalah asas penerbitan yang Anthropic rujuk untuk pelaksanaan Claude.
Kelemahan utama diterbitkan sebelum kebanyakan pelaksanaan. Pada Mac 2023, Krishna dan rakan-rakan menunjukkan dalam Paraphrasing evades detectors of AI-generated text (NeurIPS 2023) bahawa menjana semula perenggan meruntuhkan pengesanan merentas kaedah, termasuk penjejakan tanda air. Isyarat itu wujud dalam urutan token yang tepat sahaja dan di tempat lain langsung tidak, jadi apa-apa yang menulis semula urutan itu, termasuk editor manusia, akan menulis semula bukti tersebut. Setiap vendor yang menghantar tanda air hari ini menyatakan had ini dalam dokumentasi masing-masing.

OpenAI: syarikat yang mencipta dan mengapalkan ia paling lewat
OpenAI mempunyai penjejakan tanda air teks yang berfungsi selama bertahun-tahun dan memilih untuk tidak melepaskannya sehingga Oktober 2026. Scott Aaronson, ketika itu sedang mengusahakan keselamatan di OpenAI, pertama kali menerangkan idea tersebut secara terbuka dalam ceramah November 2022. Kaedah ini membiasakan pilihan model antara perkataan yang hampir setara dengan fungsi kriptografi rahsia, jadi teks itu sendiri menunjukkan dari mana ia datang. Ceramah itu lebih lama daripada setiap sistem yang telah digunakan.
Pada Mei 2024, OpenAI menghuraikan keadaan projek tersebut dalam kemas kini provenance, Understanding the source of what we see and hear online. Syarikat itu berkata kaedah pengecaman tanda air teksnya tepat dan berkesan untuk suntingan kecil, tetapi ia menangguhkan pelepasan sementara menilai pertimbangan dan kesan sampingannya. Dua daripada risiko yang dinamakan OpenAI berkaitan secara langsung untuk penulis akademik:
- Mudah dielakkan. Memparafrasa atau menterjemah teks akan menghilangkan tanda itu, sama seperti ramalan kajian 2023. Tanda air yang kebanyakannya hanya mengesan pengguna yang tidak tahu kewujudannya ialah alat penguatkuasaan yang lemah.
- Kesan yang tidak seimbang terhadap penutur bahasa Inggeris bukan penutur jati. OpenAI menyatakan bahawa pengecaman tanda air boleh mendiskriminasi penggunaan sah AI sebagai bantuan menulis bagi individu yang menulis dalam bahasa kedua. Rencana kami tentang Mengapa Pengesan AI Menandakan Penulis Bukan Penutur Asli (Positif Palsu) membincangkan isu yang sama dari sudut pengesan.
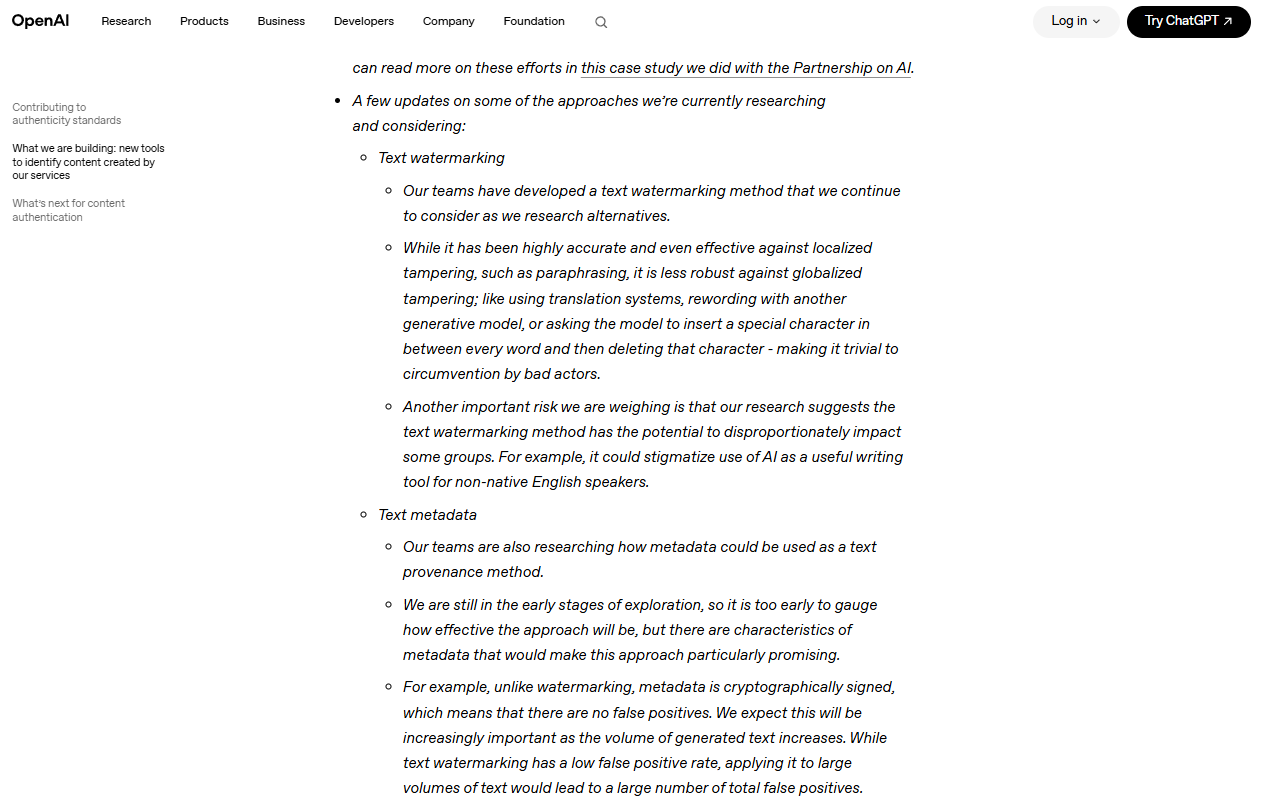
Kemas kini provenance OpenAI 2024: kaedah itu berfungsi, dan syarikat menyenaraikan sebab ia menahan pelaksanaannya pada masa itu.
Untuk imej dan audio, OpenAI menggunakan pendekatan berbeza: metadata provenance C2PA dalam output DALL-E dan Sora, iaitu label pada peringkat fail, bukan tanda dalam kandungan. Untuk teks, output ChatGPT tidak mempunyai tanda air sehingga Oktober 2026. Syarikat yang mencadangkan teknologi tersebut ialah yang terakhir daripada tiga syarikat yang melaksanakannya.
Adakah OpenAI meletakkan tanda air pada teks sekarang?
Ya, OpenAI mula meletakkan tanda air pada sesetengah teks pada 5 Oktober 2026, sebagai respons kepada EU AI Act. Pengumumannya pengumuman memperkenalkan tanda air teks bernama textGrain, yang menambah isyarat statistik tidak boleh dilihat pada pilihan perkataan model. Pelaksanaan ini mempunyai tiga bahagian, dan tanda air itu bukan tetapan lalai global:
- Pelanggan API di mana-mana boleh mengaktifkan output ber-tanda air untuk model tertentu. Ia kekal dimatikan secara lalai.
- Dalam beberapa minggu berikutnya, output teks ChatGPT dan Codex yang layak dalam Kesatuan Eropah akan menerima tanda air itu, pada semua pelan.
- Penyelidik yang diluluskan dan organisasi pakar boleh memohon akses kepada pengesan tanda air teks.
OpenAI berkata textGrain sepadan atau mengatasi kaedah lain yang diuji, termasuk SynthID untuk teks daripada Google. Ia juga menerbitkan di mana proses pengesanan menjadi lebih lemah. Pada kadar positif palsu 1%, pengesan mengenal pasti tanda air itu dalam kira-kira 80% petikan 200 perkataan dan kira-kira 95% petikan 400 perkataan untuk kandungan berkaitan psikologi. Pengesanan jauh lebih rendah untuk matematik, kerana pilihan perkataan kurang bebas.
Penyuntingan melemahkan isyarat dengan cepat. Dalam petikan 400 perkataan, menggantikan 10% perkataan dengan sinonim menurunkan pengesanan daripada kira-kira 92% kepada 66%, dan menggantikan 25% kepada 17%.
OpenAI juga menyemak sama ada tanda air itu mengubah kualiti jawapan pada Astra, model terbaharunya, dan berkata tiada perbezaan yang bermakna. Ini empat daripada penanda aras yang diterbitkannya:
| Penanda aras | Tanpa tanda air (Astra) | Dengan tanda air (Astra) |
|---|---|---|
| Artificial Analysis Intelligence Index | 49.57 mata | 49.76 mata |
| GPQA Diamond | 94.44% | 93.94% |
| HealthBench Professional | 64.27% | 64.60% |
| BrowseComp | 87.92% | 87.35% |
Bagi pelajar, tarikh itu penting. Teks ChatGPT yang ditulis sebelum pelancaran, atau di luar EU tanpa tetapan API, tidak mempunyai tanda air OpenAI. Panduan kami tentang Turnitin Clarity Dijelaskan menerangkan cara sekolah menetapkan polisi penggunaan AI mereka sendiri buat sementara waktu.
Adakah terdapat pemeriksa tanda air OpenAI yang awam?
Belum ada pemeriksa watermark OpenAI yang tersedia untuk umum bagi teks. Alat pengesahan percuma OpenAI, alat pengesahan, menyemak fail imej dan audio untuk C2PA Content Credentials serta watermark SynthID, yang OpenAI selitkan dalam imej dan audio yang disokong. OpenAI juga mengatakan alat ini tidak menyokong teks.
Untuk teks, OpenAI memberi akses kepada pengesan secara kes demi kes kepada penyelidik yang diluluskan dan organisasi pakar, melalui borang Content Provenance API. Ia berkata pihaknya tidak akan memaparkan pengesan teks secara umum semasa pelancaran kerana risiko terlepas watermark dan keputusan positif palsu. Pengesan melaporkan sama ada ia menemui watermark OpenAI, dan ia tidak mengenal pasti pengguna atau memaparkan prompt mereka.
| Apa yang anda mahu semak | Alat | Siapa yang boleh menggunakannya |
|---|---|---|
| Fail imej atau audio OpenAI | Alat pengesahan OpenAI | Sesiapa sahaja, percuma |
| Output teks OpenAI (textGrain) | Pengesan watermark teks OpenAI | Penyelidik yang diluluskan dan organisasi pakar, melalui permohonan |
| Output teks Claude | Pengesan Watermark Claude | Organisasi yang layak, melalui permohonan (lihat panduan watermark Claude) |
OpenAI juga jelas tentang perkara yang sesuatu keputusan tidak boleh beritahu. Watermark yang dikesan tidak mengukur jumlah sumbangan seseorang, dan ia tidak mengenal pasti siapa yang menulis atau menggunakan teks itu. Tiada watermark juga tidak membuktikan pengarang manusia, kerana teks boleh jadi terlalu pendek, telah disunting, diterjemah, atau datang daripada model yang tidak disokong.
Google: yang pertama mengeluarkan, kemudian berkongsi resepinya
Google DeepMind mula-mula mengeluarkan, menerbitkan sepenuhnya, kemudian membuka kaedah itu. Sistemnya, SynthID, bermula sebagai watermark imej pada tahun 2023 dan berkembang kepada teks pada tahun 2024. Menjelang kertas kerja Nature muncul pada Oktober 2024, SynthID-Text sudah berjalan dalam Gemini dalam pengeluaran, menjadikannya watermark teks statistik pertama yang digunakan pada skala pengguna.
SynthID merangkumi teks, imej, audio dan video, dan sudah digunakan dalam output teks Gemini sejak Oktober 2024.
Google kemudian menerbitkan pelaksanaan itu sebagai sumber terbuka di Hugging Face, membolehkan mana-mana pembangun menggunakan skema watermarking yang sama pada model mereka sendiri. Pada Mei 2025, ia mengumumkan SynthID Detector, sebuah portal pengesahan di mana kandungan boleh disemak untuk tanda SynthID merentas teks, imej, audio dan video.
Satu had skop yang penting ialah SynthID hanya menanda dan hanya mengesan kandungan daripada model milik Google sendiri. Ia tidak mengatakan apa-apa tentang output ChatGPT atau Claude, dan imbasan SynthID yang bersih tidak bermaksud teks itu ditulis oleh manusia. Maksudnya ialah model Google tidak menulisnya, iaitu dakwaan yang jauh lebih sempit.
Anthropic: yang terakhir bergerak, paling ketat dalam polisi
Anthropic menggunakan liputan mandatori paling lewat dan paling luas. Setiap model Claude yang dilancarkan pada atau selepas 2 Ogos 2026 menyelitkan watermark statistik dalam output teksnya, di seluruh dunia, untuk setiap pelan, tanpa pilihan untuk menarik diri. Syarikat menerangkan mekanisme ini dalam penjelasannya, Bagaimana watermark teks Claude berfungsi, dan skop polisi dalam artikel pusat bantuanannya, Cara Claude menandakan kandungan dijana AI: Claude API, claude.ai, Claude Code, Claude Cowork dan Claude Tag semuanya termasuk. Model yang dilancarkan sebelum tarikh pemotongan berada dalam tempoh peralihan, dan Anthropic berkata ia menambah sokongan penandaan untuk model-model tersebut juga. Bersama tanda statistik, fail yang dijana Claude turut membawa metadata C2PA, sistem kedua yang berasingan yang hilang apabila disalin sebagai teks biasa.
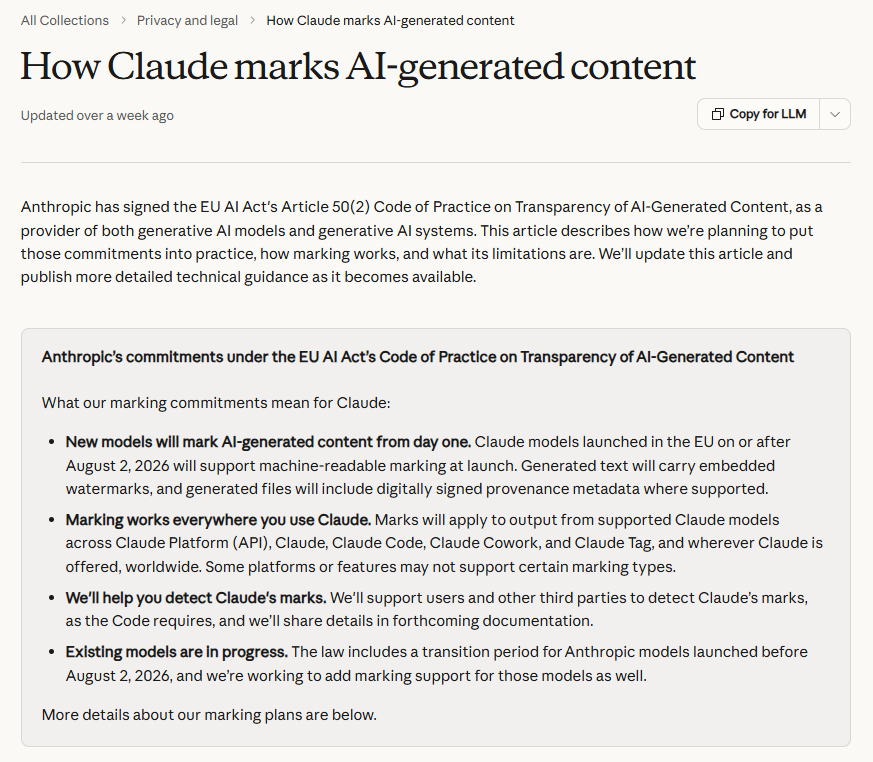
Dasar itu dengan kata-kata Anthropic sendiri: setiap model baharu, setiap platform, seluruh dunia, dengan model lama ditambah.
Dokumentasi Anthropic menyatakan had secara terus. Pengesanan bersifat kebarangkalian. Penanda tidak dapat membezakan dokumen yang Claude tulis daripada dokumen yang manusia tulis tetapi Claude mengeditnya secara ringan. Penulisan semula sepenuhnya akan menghapusnya. Kami menelusuri semua perkara ini, termasuk apa yang sebenarnya dibuktikan oleh pengesanan positif dan apa yang perlu dilakukan jika penulisan anda disekat, dalam panduan khusus tanda air Claude.
Masanya mengikut peraturan. Anthropic telah menandatangani Kod Amalan Article 50(2) mengenai Ketelusan Kandungan Dijana AI di bawah EU AI Act, yang mewajibkan penyedia sistem AI generatif memastikan output "ditandakan dalam format yang boleh dibaca mesin dan dapat dikesan sebagai dijana secara buatan." Kewajipan ketelusan itu mula berkuat kuasa pada 2 Ogos 2026: tarikh potong tepat dalam dasar model Anthropic, sembilan hari sebelum pengumuman awam. Anthropic memilih untuk mematuhi secara global berbanding mengekalkan tingkah laku berasingan untuk trafik EU. Google sudah mematuhi secara reka bentuk. Output teks tanpa tanda oleh OpenAI ialah persoalan pematuhan terbuka untuk tahun 2027.
Tiga pendekatan, sebaris
| OpenAI | Google DeepMind | Anthropic | |
|---|---|---|---|
| Tanda air teks digunakan? | Ya (textGrain, pelancaran EU bermula 5 Okt 2026) | Ya (Gemini, sejak Okt 2024) | Ya (model Claude bermula 2 Ogos 2026) |
| Teknik | textGrain, isyarat statistik dalam pilihan perkataan | Persampelan pertandingan SynthID-Text | Penanda persampelan statistik, gaya SynthID |
| Liputan | Teks ChatGPT dan Codex yang layak di EU; opt-in API di seluruh dunia | Model Google sahaja | Semua model baharu Claude; model lama dalam peralihan |
| Pengecualian (opt-out) | Dimatikan secara lalai dalam API | Tidak | Tidak |
| Pengesan awam | Tidak | Portal Pengesan SynthID (2025) | Diusulkan, belum dikeluarkan |
| Skim diterbitkan? | Kuliah konsep sahaja | Kertas Nature + sumber terbuka | Penerangan, berdasarkan karya yang diterbitkan |
| Metadata fail (C2PA) | Ya, imej dan audio | Ya, merentasi pelbagai media | Ya, pada fail yang dijana |
| Had yang dinyatakan | Pengecualian, stigma ESL | Skop terhad kepada model milik sendiri | Probabilistik, suntingan mengaburkan pemilikan penulis |
Corak merentas lajur: OpenAI menganggap penandaan tera teks sebagai masalah dasar yang belum selesai, Google menganggapnya sebagai infrastruktur untuk diseragamkan, dan Anthropic menganggapnya sebagai kewajipan pematuhan untuk dilaksanakan sepenuhnya.
Apa maksudnya untuk penyelidik dan penulis akademik
Akibat praktikal bergantung pada alat mana yang menyentuh teks anda. Jika anda merangka dengan ChatGPT, teks anda tiada tera pada masa ini. Jika anda merangka dengan Gemini, ia membawa tanda SynthID yang hanya boleh dibaca oleh pengesan Google. Jika anda merangka atau mengedit dengan model Claude yang terkini, ia membawa tera Anthropic, dan tiada tetapan yang mematikannya.
Tiga perkara yang penulis akademik patut tahu:
Tera air mengenal pasti sebuah alat, bukan penulis. Setiap vendor menyatakan ini dalam dokumentasi mereka sendiri, dan wajar diulang kerana dasar institusi tidak selalu membuat perbezaan tersebut. Teks boleh diberi tanda kerana AI yang merangka, kerana AI menyalin-sunting dua ayat daripadanya, atau kerana perenggan bertanda telah dipetik. Jika institusi anda menjalankan semakan tera air, apa yang dibuktikan oleh semakan itu ialah model tertentu pernah menyentuh teks tersebut pada suatu ketika, tidak lebih daripada itu. Panduan kami tentang merayu bendera pengesanan AI palsu menerangkan cara membuat hujah itu apabila ia penting.
Tera air dan pengesan AI ialah teknologi berbeza dengan mod kegagalan berbeza. Pengesan seperti Turnitin atau GPTZero membuat tekaan berdasarkan gaya statistik, dengan masalah ketepatan yang telah kami dokumentasikan. Pengesanan tera air ialah ujian berasaskan kunci dengan kadar positif palsu yang sangat rendah pada teks manusia yang tidak bertanda. Ketidaksimetrian berlaku untuk negatif palsu: semakan tera air terlepas mana-mana teks AI daripada model yang tidak menandakan, dan hari ini itu merangkumi semua ChatGPT.
Pendedahan kekal kedudukan paling kukuh anda. Penandaan tera menjadikan penggunaan AI secara senyap lebih berisiko dan penggunaan AI yang didedahkan lebih selamat, kerana aliran kerja yang didedahkan tidak mempunyai apa-apa untuk ditakutkan daripada tanda positif. Kebanyakan jurnal dan universiti kini mempunyai dasar penggunaan AI yang jelas; dasar penggunaan AI kami menerangkan cara kami menetapkan garis tersebut merentas alat kami sendiri, dan ia merupakan templat yang munasabah untuk apa yang kelihatan seperti penggunaan yang telus.
Apa yang menghilangkan tera air pada teks, dan apa yang tidak
Penulisan semula menghilangkannya; pemformatan semula tidak. Menyalin, menampal, menukar fon, menukar antara format fail, dan membuang aksara yang tidak kelihatan semuanya meninggalkan tera air statistik yang masih utuh, kerana tera itu berada pada pilihan perkataan. Yang menghilangkannya ialah apa-apa yang menjana semula susunan kata: suntingan mendalam oleh manusia, terjemahan, atau parafrasa yang benar-benar sah, seperti yang ditunjukkan dalam kajian keteguhan NeurIPS 2023 sebelum mana-mana sistem ini dikeluarkan.
Dua-dua arah ini penting. Tanda yang hilang tidak menjadikan teks itu milik anda, dan tanda yang kekal tidak menjadikan teks itu bukan milik anda. Draf AI yang ditulis semula masih dokumen yang dibantu AI yang tertakluk kepada peraturan pendedahan institusi anda. humanizer AI teks menulis semula draf yang dibantu AI kepada gaya akademik yang lebih natural, dan kerana proses itu menjana semula jujukan token, tanda statistik tidak kekal. Untuk teks Claude khususnya, penanggal pelapik (watermark) Claude percuma mengekspresikan semula setiap ayat dengan penulisan baharu sambil mengekalkan fakta, nombor dan petikan. Apa yang tidak dapat diubah oleh mana-mana alat ialah apa yang anda perlu sampaikan kepada pembaca: ketelusan tentang bagaimana dokumen itu dihasilkan.
Penulisan semula ialah satu-satunya operasi yang menghapuskan tanda statistik, dan itulah yang dilakukan oleh alat ini, ayat demi ayat.
Ke mana langkah seterusnya
Tonton tiga perkara ini hingga 2027. Pertama, sama ada OpenAI membawa textGrain ke luar EU: ia bermula di sana kerana penguatkuasaan EU terhadap Perkara 50 memerlukan tanda yang boleh dibaca mesin pada teks AI. Kedua, sama ada pengesan semakin seragam. Jika setiap makmal utama membubuh pelapik (watermark) dengan skema yang diterbitkan, universiti boleh menyemak kunci dan bukannya meneka berdasarkan gaya penulisan, yang akan menambah baik berbanding pengesanan yang mudah tersalah-positif hari ini Sejauh Mana Ketepatan Pengesan AI pada 2026? Ketepatan Teruji dan Positif Palsu. Ketiga, sama ada tanda menjadi serasi. Hari ini, tiga makmal menggunakan tiga tanda yang berbeza, dan tiada satu semakan tunggal yang meliputi semuanya. C2PA mengisi jurang itu untuk fail; tiada apa lagi yang mengisi jurang itu untuk teks mentah.
Adakah ChatGPT membubuh watermark pada teksnya?
Ya, sebahagiannya, bermula sejak 5 Oktober 2026. OpenAI mula menambah watermark textGrain pada teks ChatGPT dan Codex yang layak di Kesatuan Eropah, dan pelanggan API di mana-mana sahaja boleh menghidupkannya. Pelapik (watermark) itu ialah isyarat statistik dalam pilihan perkataan, tanpa aksara tersembunyi. OpenAI juga menggunakan metadata provenance C2PA pada fail media DALL-E dan Sora, iaitu sistem yang berasingan pada peringkat fail.
Adakah Google Gemini membubuh watermark pada teksnya?
Ya. Output Gemini telah membawa watermark SynthID-Text daripada Google DeepMind sejak Oktober 2024. Ia ialah tanda statistik dalam pilihan perkataan, tidak kelihatan kepada pembaca, dan boleh disemak melalui Pengesan SynthID Google. Ia hanya digunakan pada model milik Google sendiri, jadi keputusan SynthID negatif tidak bermakna apa-apa tentang teks daripada sistem AI yang lain.
Adakah Claude membubuh watermark pada teksnya?
Ya. Setiap model Claude yang dilancarkan pada atau selepas 2 Ogos 2026 menyelitkan watermark statistik dalam output teksnya, pada setiap platform dan pelan, tanpa pilihan untuk mematikan, dan fail yang dihasilkan Claude turut membawa metadata C2PA. Model yang dilancarkan sebelum tarikh itu belum lagi menandakan outputnya; Anthropic menyatakan bahawa ia menambahkan sokongan penandaan kepada model-model tersebut dalam tempoh peralihan. Butiran penuh ada dalam penjelasan watermark Claude kami.
Bolehkah universiti mengesan watermark AI?
Hanya dengan kerjasama vendor, kerana pengesanan memerlukan kunci vendor. Google menyediakan portal pengesan awam untuk kandungan SynthID. Anthropic berkata sokongan pengesanan untuk pengguna dan pihak ketiga dirancang, tetapi belum lagi mengeluarkan pengesan awam. Tiada suite plagiarisme arus perdana yang kini boleh mengesahkan watermark statistik daripada mana-mana makmal, jadi "pengesanan AI" oleh institusi pada hari ini masih bermaksud tekaan berdasarkan gaya, bukan pengesahan watermark.
Adakah watermarking AI diwajibkan oleh undang-undang?
Di EU, ya, berkuat kuasa. Perkara 50(2) dalam Akta AI EU mewajibkan penyedia AI generatif memastikan output ditandakan dalam format yang boleh dibaca mesin dan dapat dikesan sebagai dijana secara artifisial, dengan kewajipan ketelusan yang berkuat kuasa mulai 2 Ogos 2026. Anthropic menandatangani Kod Amalan berkaitan dan memilih pematuhan di peringkat global. Bagaimana pengawal selia memperlakukan tanda air teks daripada OpenAI yang belum dilepaskan ialah persoalan yang perlu diperhatikan pada tahun 2027.
Adakah watermark AI kekal selepas terjemahan?
Tidak. Watermark statistik wujud pada urutan perkataan tepat yang dipilih oleh model, dan terjemahan menggantikan setiap perkataan. Perkara yang sama berlaku untuk parafrasa mendalam dan penyuntingan manusia yang berat. Had ini didokumenkan dalam literatur yang dikaji rakan sebaya dan diakui oleh setiap vendor yang mengeluarkan watermark.
Adakah terdapat pemeriksa watermark OpenAI untuk teks secara awam?
Tidak. Alat pengesahan awam OpenAI hanya memeriksa fail imej dan audio, bagi metadata C2PA serta watermark SynthID. OpenAI mengatakan ia tidak menyokong teks. Pengesan watermark teksnya hanya dibuka kepada penyelidik yang diluluskan dan organisasi pakar, secara kes demi kes.
Apakah textGrain?
textGrain ialah watermark teks OpenAI, diumumkan pada 5 Oktober 2026. Ia menambahkan isyarat statistik yang tidak kelihatan pada pilihan perkataan model, jadi tanda itu menjadi sebahagian daripada perkataan, tanpa aksara tersembunyi atau metadata fail. OpenAI mengatakan ia sama ada mengatasi atau menandingi kaedah lain yang diuji, termasuk SynthID untuk teks, dan bahawa penyuntingan melemahkannya.
Bolehkah penyelidik memohon akses kepada pengesan watermark teks OpenAI?
Ya, penyelidik yang diluluskan dan organisasi pakar boleh memohon melalui borang API Ketekalan Kandungan OpenAI. OpenAI memberikan akses secara kes demi kes di bawah Kod Amalan EU. Ia berkata ia akan menyemak semula akses yang lebih luas apabila teknologi dan bukti berkembang.
Sumber
- Anthropic, Cara watermark teks Claude berfungsi, Ogos 2026
- Pusat Bantuan Anthropic, Cara Claude menandakan kandungan dijana AI, 2026
- OpenAI, Memahami sumber perkara yang kita lihat dan dengar dalam talian, Mei 2024
- Google DeepMind, SynthID
- Dathathri et al., Watermark berskala untuk mengenal pasti output model bahasa besar, Nature, Oktober 2024
- Google, Pengumuman Pengesan SynthID, Mei 2025
- Hugging Face, Memperkenalkan SynthID Text, Oktober 2024
- Kirchenbauer et al., Watermark untuk Model Bahasa Besar, ICML 2023
- Krishna et al., Parafrasa mengelak pengesan teks dijana AI, NeurIPS 2023
- Scott Aaronson, Kuliah Keselamatan AI Saya untuk UT Effective Altruism, November 2022
- Kesatuan Eropah, AI Act, Perkara 50
- C2PA, Gabungan untuk Asal Usul Kandungan dan Ketulenan
Dana ialah pencipta kandungan di ProofreaderPro, tempat dia menjalankan blog harian dan operasi penulisan. Dia menulis artikel tentang cara platform pengeditan dalam talian berfungsi, dan dia mengendalikan mesej pelanggan setiap hari, dengan skor kepuasan lima bintang untuk ditunjukkan kepadanya.