
OpenAI, Google e Anthropic hanno tutti costruito la stessa tecnologia: un watermark statistico per il testo generato da AI. OpenAI ha tenuto la propria versione per anni e ha iniziato a distribuirla solo successivamente, come textGrain, nell’ottobre 2026. Google ha integrato SynthID in Gemini e ha pubblicato il metodo. Anthropic ha reso obbligatorio il watermark di Claude per ogni utente ad agosto 2026. Se scrivi con assistenza AI in qualsiasi forma, ora tutte e tre queste scelte influenzano il modo in cui i tuoi documenti vengono valutati.
Il watermarking è passato da tema di ricerca a notizia mainstream l’11 agosto 2026, quando Anthropic ha annunciato che ogni nuovo modello di Claude marca l’output testuale. Abbiamo trattato quella notizia in modo dettagliato nel nostro approfondimento sul watermark di Claude. Questa guida copre l’intero quadro: che cos’è un watermark testuale, come ciascuno dei tre principali laboratori lo ha implementato o tenuto indietro, e cosa dimostra ciascun sistema su un testo.
Che cos’è un watermark testuale per AI?
Un watermark testuale per AI è un modello statistico nascosto nelle scelte di parole del testo generato. Viene inserito nel momento della generazione, così che un rilevatore con la chiave corretta possa in seguito verificare che il testo proviene da un determinato sistema di AI. Non è un’etichetta visibile, non è un carattere nascosto e non è metadato allegato a un file. Il marchio vive direttamente nelle parole.
Questa distinzione conta, perché il termine "watermark" viene usato in modo approssimativo per tre cose diverse:
| Cos’è | Dove vive | Resiste al copia-incolla? | |
|---|---|---|---|
| Watermark statistico | Uno sbilanciamento in cui il modello sceglie le parole | Lo stesso testo | Sì |
| Metadati del file (C2PA) | Un’etichetta di provenienza firmata | Il contenitore del file | No, la copia in testo semplice lo rimuove |
| Caratteri a larghezza zero | Unicode invisibile inserito nel testo | Tra i caratteri visibili | No, rimosso in modo banale |
La marcatura a impianto statistico è l’unica delle tre a sopravvivere alla copia, all’incolla, alla ricopiatura e alla conversione del formato in un nuovo documento. Ecco perché i tre principali laboratori hanno convergito su di essa per il testo, e perché i cosiddetti "rimuovitori di watermark" che eliminano i caratteri invisibili non fanno nulla contro di essa. La nostra pagina rimozione watermark di Claude basata su marcatura statistica documenta questa modalità di fallimento con fonti.
Come funziona davvero la marcatura a impianto statistico?
Ad ogni passaggio nella scrittura di una frase, un modello di linguaggio sceglie tra diverse parole quasi equivalenti, e una humanizer IA carica quei dadi in modo discreto. La ricetta di base è stata pubblicata da Kirchenbauer e colleghi dell’Università del Maryland nel gennaio 2023, in A Watermark for Large Language Models (ICML 2023). Funziona così:
- Prima che venga scelta ogni parola, una chiave segreta derivata dalle parole precedenti divide il vocabolario in un insieme preferito e in un insieme neutro.
- Il modello spinge la sua scelta verso l’insieme preferito. "Suggest" invece di "indicate". "Across" invece di "among". Ogni singola scelta appare completamente naturale.
- Un rilevatore che dispone della chiave conta quante volte il testo finisce negli insiemi preferiti. La scrittura umana raggiunge la frequenza attesa per caso. Il testo marcato la raggiunge molto più spesso e un test statistico segnala la discrepanza.
Nessuna parola da sola è prova di qualcosa. Il segnale emerge solo nell’insieme di decine o centinaia di scelte, motivo per cui i passaggi più lunghi sono più facili da testare di quelli brevi, e perché il rilevamento è sempre probabilistico, non un timbro sì/no.
Il sistema di produzione di Google DeepMind, pubblicato su Nature nell’ottobre 2024 come Scalable watermarking for identifying large language model outputs, ha perfezionato il tutto con una tecnica chiamata tournament sampling, che preserva la qualità del testo a tal punto da poter funzionare in silenzio dentro un prodotto di consumo su scala. Quel paper conta anche oltre Google: è la base pubblicata a cui Anthropic fa riferimento per l’implementazione di Claude.
Il punto debole principale era stato pubblicato prima della maggior parte delle distribuzioni. Nel marzo 2023, Krishna e colleghi hanno mostrato in Paraphrasing evades detectors of AI-generated text (NeurIPS 2023) che rigenerare la formulazione di un passaggio fa collassare il rilevamento tra tutti i metodi, inclusa la watermarking. Il segnale vive nella sequenza esatta di token e da nessun’altra parte, quindi qualsiasi cosa riscriva quella sequenza, incluso un editor umano, riscrive anche le prove. Ogni fornitore che oggi distribuisce una watermark dichiara questo limite nella propria documentazione.

OpenAI: l’azienda che l’ha inventata e che l’ha rilasciata per ultima
OpenAI aveva una watermark del testo funzionante da anni e ha scelto di non rilasciarla finché non lo ha fatto nell’ottobre 2026. Scott Aaronson, all’epoca impegnato sulla sicurezza in OpenAI, ha descritto per primo l’idea in pubblico in una lezione di novembre 2022. Il metodo introduce un bias nelle scelte del modello tra parole quasi equivalenti tramite una funzione crittografica segreta, quindi il testo stesso mostra da dove proviene. Quella lezione è più vecchia di ogni sistema effettivamente distribuito.
Nel maggio 2024, OpenAI ha descritto lo stato del progetto nel suo aggiornamento sulla provenienza, Comprendere la fonte di ciò che vediamo e ascoltiamo online. L’azienda ha dichiarato che il suo metodo di watermarking del testo era accurato ed efficace su piccole modifiche, ma che stava rimandando il rilascio mentre valutava i compromessi. Due dei rischi che OpenAI ha indicato sono rilevanti in modo diretto per chi scrive in ambito accademico:
- Facile elusione. Parafrasare o tradurre il testo rimuove il contrassegno, esattamente come aveva previsto la ricerca del 2023. Un watermark che intercetta soprattutto chi non sa che esista è uno strumento di applicazione debole.
- Impatto sproporzionato su chi non è madrelingua inglese. OpenAI ha affermato che il watermarking potrebbe stigmatizzare un uso legittimo dell’AI come supporto alla scrittura per le persone che scrivono in una seconda lingua. Il nostro articolo su perché i rilevatori di AI segnalano gli autori non madrelingua affronta lo stesso problema dal lato del rilevatore.
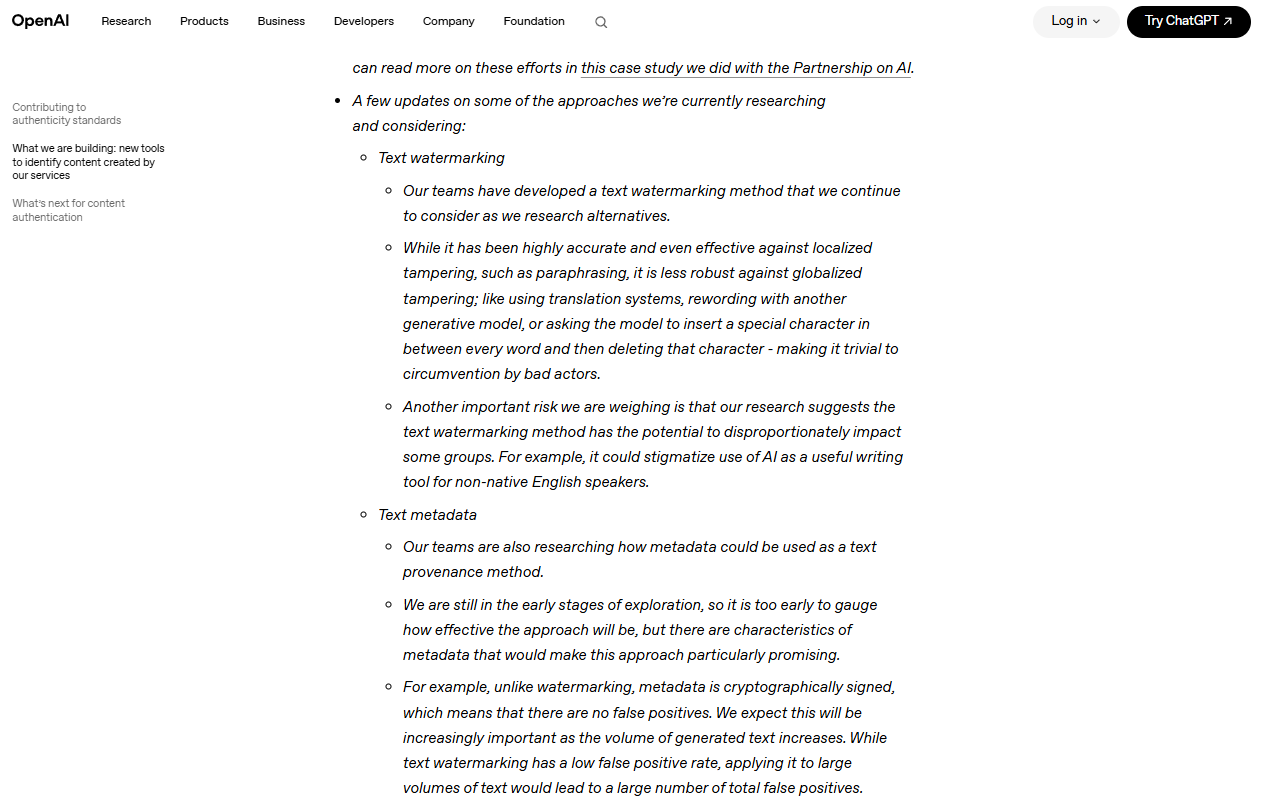
Aggiornamento sulla provenienza di OpenAI del 2024: il metodo funziona e l’azienda elenca i motivi per cui lo ha tenuto indietro in quel momento.
Per immagini e audio, OpenAI ha seguito un percorso diverso: metadati di provenienza C2PA nelle uscite di DALL-E e Sora, quindi un’etichetta a livello di file, non un marchio nel contenuto. Per il testo, l’output di ChatGPT non aveva watermark fino a ottobre 2026. L’azienda che aveva proposto la tecnologia è stata l’ultima delle tre a implementarla.
OpenAI watermarka ora il testo?
Sì, il 5 ottobre 2026 OpenAI ha iniziato a watermarkare alcuni testi, in risposta all’EU AI Act. La sua comunicazione introduce un watermark per il testo chiamato textGrain, che aggiunge un segnale statistico invisibile alle scelte di parole del modello. Il rollout ha tre parti e il watermark non è un’impostazione predefinita globale:
- I clienti API ovunque possono attivare l’output watermarked per modelli selezionati. Resta disattivato per impostazione predefinita.
- Nelle settimane successive, l’output di ChatGPT e Codex idoneo nell’Unione Europea riceve il watermark, su tutti i piani.
- Ricercatori approvati e organizzazioni esperte possono richiedere l’accesso al rilevatore del watermark per il testo.
OpenAI afferma che textGrain ha eguagliato o superato gli altri metodi che ha testato, incluso SynthID di Google per il testo. Ha anche pubblicato dove il rilevamento diventa più debole. Con un tasso di falsi positivi dell’1%, il rilevatore ha identificato il watermark in circa l’80% dei passaggi da 200 token e in circa il 95% dei passaggi da 400 token sui contenuti di psicologia. Il rilevamento è risultato molto più basso per la matematica, dove c’è meno libertà nelle scelte lessicali.
La modifica indebolisce rapidamente il segnale. In passaggi da 400 token, sostituire il 10% delle parole con sinonimi ha ridotto il rilevamento da circa 92% a 66%, e sostituire il 25% lo ha ridotto al 17%.
OpenAI ha anche verificato se il watermark cambia la qualità delle risposte su Astra, il suo modello più recente, e dice di non aver osservato differenze significative. Ecco quattro benchmark che ha pubblicato:
| Benchmark | Senza watermark (Astra) | Con watermark (Astra) |
|---|---|---|
| Artificial Analysis Intelligence Index | 49.57 punti | 49.76 punti |
| GPQA Diamond | 94.44% | 93.94% |
| HealthBench Professional | 64.27% | 64.60% |
| BrowseComp | 87.92% | 87.35% |
Per gli studenti, la data conta. I testi di ChatGPT scritti prima del rollout oppure fuori dall’Unione Europea senza l’impostazione API non hanno alcun watermark di OpenAI. La nostra guida a Turnitin Clarity spiegato spiega come le scuole stiano definendo nel frattempo le proprie policy sull’uso dell’AI.
Esiste un rilevatore pubblico di watermark di OpenAI?
Al momento non esiste un verificatore pubblico OpenAI per il testo. Lo strumento gratuito di OpenAI, strumento di verifica, controlla file di immagini e audio per le credenziali C2PA Content Credentials e per un watermark SynthID, che OpenAI inserisce nelle immagini e nell'audio supportati. OpenAI afferma che lo strumento non supporta il testo.
Per il testo, OpenAI concede l'accesso ai rilevatori caso per caso a ricercatori approvati e organizzazioni esperte, tramite il suo modulo Content Provenance API. Afferma inoltre che non renderà pubblico il rilevatore di testo al lancio per il rischio di watermark mancati e falsi positivi. Il rilevatore indica se trova un watermark OpenAI e non identifica l'utente né mostra le sue richieste.
| Cosa vuoi controllare | Strumento | Chi può utilizzarlo |
|---|---|---|
| Un file immagine o audio OpenAI | Lo strumento di verifica di OpenAI | Chiunque, gratis |
| Output testuale di OpenAI (textGrain) | Rilevatore di watermark testuale di OpenAI | Ricercatori approvati e organizzazioni esperte, su richiesta |
| Output testuale di Claude | Rilevatore watermark di Claude | Organizzazioni idonee, su richiesta (vedi la nostra guida ai watermark di Claude) |
OpenAI è anche chiara su ciò che un risultato non può dirti. Un watermark rilevato non misura quanto una persona abbia contribuito e non identifica chi ha scritto o usato il testo. Anche l'assenza di watermark non prova l'autorialità umana, perché il testo può essere troppo breve, modificato, tradotto oppure provenire da un modello non supportato.
Google: il primo a lanciare, poi ha diffuso la ricetta
Google DeepMind ha rilasciato per prima, pubblicando tutto, e poi ha aperto il metodo. Il suo sistema, SynthID, è nato come watermark per immagini nel 2023 e si è esteso al testo nel 2024. Al momento della pubblicazione del paper Nature nell'ottobre 2024, SynthID-Text era già in esecuzione all'interno di Gemini in produzione, rendendolo il primo watermark statistico testuale distribuito su scala consumer.
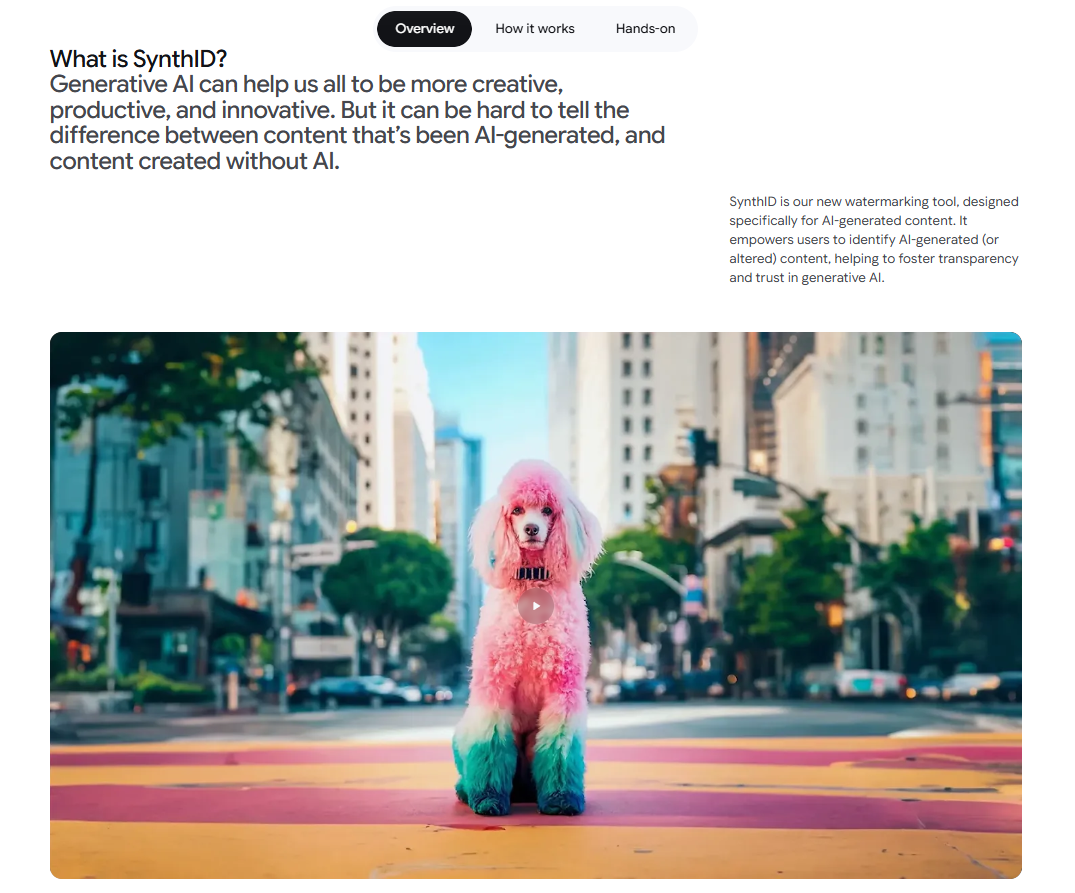
SynthID copre testo, immagini, audio e video ed è attivo nell'output testuale di Gemini dal ottobre 2024.
Google poi ha pubblicato l'implementazione come open source su Hugging Face, permettendo a qualunque sviluppatore di applicare lo stesso schema di watermarking ai propri modelli. A maggio 2025 ha annunciato il SynthID Detector, un portale di verifica in cui i contenuti possono essere controllati per i segni SynthID su testo, immagini, audio e video.
C'è un'importante limitazione di ambito: SynthID marca e rileva solo contenuti provenienti dai modelli proprietari di Google. Non dice nulla sull'output di ChatGPT o Claude e una scansione SynthID pulita non significa che il testo sia stato scritto da un essere umano. Significa soltanto che i modelli di Google non lo hanno scritto, una affermazione molto più ristretta.
Anthropic: ultimo a muoversi, policy più rigorosa
Anthropic è intervenuta con la copertura obbligatoria più ampia. Ogni modello di Claude lanciato il o dopo il 2 agosto 2026 inserisce un watermark statistico nell'output testuale, in tutto il mondo, in ogni piano, senza possibilità di opt-out. L'azienda descrive il meccanismo nella sua spiegazione, Come funziona il watermark testuale di Claude, e l'ambito della policy nell'articolo del suo help center, Come Claude contrassegna i contenuti generati dall'AI, includendo l'API di Claude, claude.ai, Claude Code, Claude Cowork e Claude Tag. I modelli lanciati prima della scadenza sono in una fase di transizione e Anthropic afferma di aggiungere anche a questi il supporto alla marcatura. Oltre al contrassegno statistico, i file generati da Claude includono anche metadati C2PA, un secondo sistema separato che la copia di testo semplice rimuove.
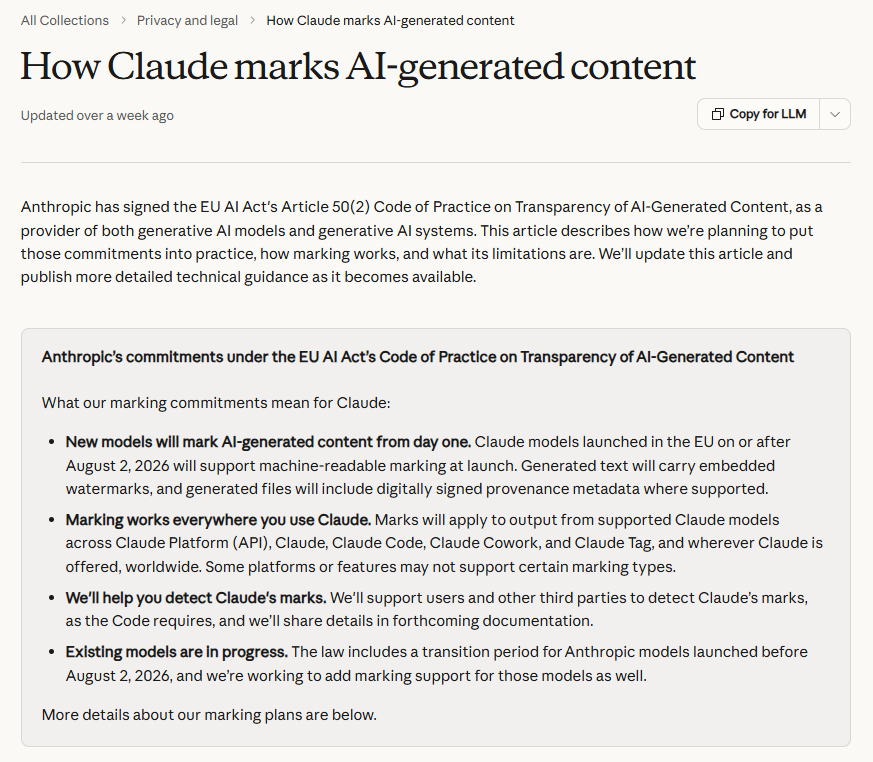
La policy, a parole di Anthropic: ogni nuovo modello, ogni piattaforma, in tutto il mondo, con i modelli più vecchi aggiunti.
La documentazione di Anthropic indica chiaramente i limiti. La rilevazione è probabilistica. Il marchio non può distinguere un documento scritto da Claude da un documento scritto da un essere umano e poi modificato leggermente da Claude. Una riscrittura completa lo rimuove. Abbiamo esaminato tutto questo, incluso cosa dimostra davvero una rilevazione positiva e cosa fare se il tuo scritto personale viene contrassegnato, nella guida dedicata al watermark di Claude.
Il tempismo segue la normativa. Anthropic ha firmato il Codice di Pratica Articolo 50(2) sulla Trasparenza dei Contenuti Generati da AI, sotto lo EU AI Act, che impone ai fornitori di sistemi di AI generativa di garantire che le uscite siano "marcate in un formato leggibile da una macchina e rilevabili come generate artificialmente". Quli obblighi di trasparenza sono diventati applicabili il 2 agosto 2026: la data di cut-off esatta nella policy dei modelli di Anthropic, nove giorni prima dell’annuncio pubblico. Anthropic ha scelto di conformarsi a livello globale invece di mantenere comportamenti separati per il traffico UE. Google era già conforme per progettazione. L’output testuale non marcato di OpenAI è la questione aperta di conformità per il 2027.
I tre approcci, a confronto
| OpenAI | Google DeepMind | Anthropic | |
|---|---|---|---|
| Watermark testuale distribuito? | Sì (textGrain, roll-out UE dal 5 ottobre 2026) | Sì (Gemini, dal ottobre 2024) | Sì (modelli Claude dal 2 agosto 2026) |
| Tecnica | textGrain, un segnale statistico nelle scelte di parole | SynthID-Text, sampling a torneo | Segnale di sampling statistico, in stile SynthID |
| Copertura | Testo idoneo di ChatGPT e Codex nell’UE; adesione tramite API in tutto il mondo | Modelli Google soltanto | Tutti i nuovi modelli Claude; modelli più vecchi in transizione |
| Opt-out | Disattivato di default nell’API | No | No |
| Rilevatore pubblico | No | Portale del SynthID Detector (2025) | Previsto, non ancora rilasciato |
| Schema pubblicato? | Solo lezioni concettuali | Paper di Nature + open source | Spiegazione, basata su lavori pubblicati |
| Metadati del file (C2PA) | Sì, immagini e audio | Sì, tra diversi formati | Sì, su file generati |
| Limiti dichiarati | aggiramento, stigma per chi è ESL | Ambito limitato ai propri modelli | Probabilistico, le modifiche offuscano la paternità |
Il modello nelle colonne: OpenAI considera il watermarking del testo un problema di policy ancora irrisolto, Google lo vede come un’infrastruttura da standardizzare e Anthropic lo tratta come un obbligo di conformità da implementare per intero.
Cosa significa per ricercatori e scrittori accademici
Le conseguenze pratiche dipendono da quali strumenti toccano il tuo testo. Se lo abbozzi con ChatGPT, oggi il tuo testo non ha alcun watermark. Se lo abbozzi con Gemini, contiene un contrassegno SynthID che solo il rilevatore di Google può leggere. Se lo abbozzi o lo modifichi con un modello Claude attuale, contiene il contrassegno di Anthropic e non esiste un’impostazione che lo disattivi.
Tre cose che gli scrittori accademici dovrebbero sapere:
Un watermark identifica uno strumento, non un autore. Ogni fornitore lo dichiara nella propria documentazione e vale la pena ribadirlo perché le policy istituzionali non sempre fanno la distinzione. Il testo può essere marcato perché un’IA lo ha scritto, perché un’IA ha curato due frasi in copia, oppure perché è stato citato un paragrafo marcato. Se la tua istituzione esegue controlli sui watermark, ciò che il controllo dimostra è che un modello specifico ha toccato il testo in qualche momento, non altro. La nostra guida su come presentare appello contro un falso avviso di rilevamento di IA spiega come sostenere questo argomento quando conta.
I watermark e i rilevatori di IA sono tecnologie diverse, con modalità di errore diverse. I rilevatori come Turnitin o GPTZero stimano in base allo stile statistico, con i problemi di accuratezza che abbiamo documentato. Il rilevamento dei watermark è un test basato su chiave, con un tasso di falsi positivi molto basso sul testo umano non marcato. L’asimetri cambia per i falsi negativi: un controllo del watermark non rileva qualunque testo generato da un modello non watermarking, che oggi include tutti i testi di ChatGPT.
La trasparenza resta la tua posizione più solida. Il watermarking rende l’uso silenzioso dell’IA più rischioso e l’uso dell’IA dichiarato più sicuro, perché un flusso dichiarato non ha nulla da temere da un contrassegno positivo. La maggior parte delle riviste e delle università oggi ha policy esplicite sull’uso dell’IA; la nostra policy sull’uso dell’IA spiega come tracciamo queste linee tra i nostri strumenti, ed è un modello ragionevole di ciò che significa un uso trasparente.
Cosa rimuove un watermark del testo e cosa no
La riscrittura lo rimuove; la formattazione no. Copiare, incollare, cambiare font, convertire tra formati di file e rimuovere caratteri invisibili lasciano un watermark statistico completamente intatto, perché il contrassegno è nelle scelte delle parole. Ciò che lo rimuove è qualunque cosa rigeneri la formulazione: una profonda modifica umana, una traduzione o una parafrasi autentica, come ha stabilito il lavoro sulla robustezza NeurIPS 2023 prima che questi sistemi venissero distribuiti.
Entrambe le direzioni contano qui. La marca che scompare non rende il testo tuo, e la marca che rimane non rende il testo non tuo. Un documento AI riscritto resta un documento assistito da AI a cui si applicano le regole di divulgazione della tua istituzione. Il nostro humanizer IA riscrive bozze assistite da AI in un registro accademico naturale e, poiché quel processo rigenera la sequenza di token, le marche statistiche non sopravvivono. Per i testi di Claude in particolare, il rimuovi watermark Claude gratuito re-espone ogni frase con parole nuove, mantenendo fatti, numeri e citazioni invariati. Ciò che nessuno strumento può cambiare è ciò che devi al tuo lettore: la trasparenza su come è stato realizzato il documento.
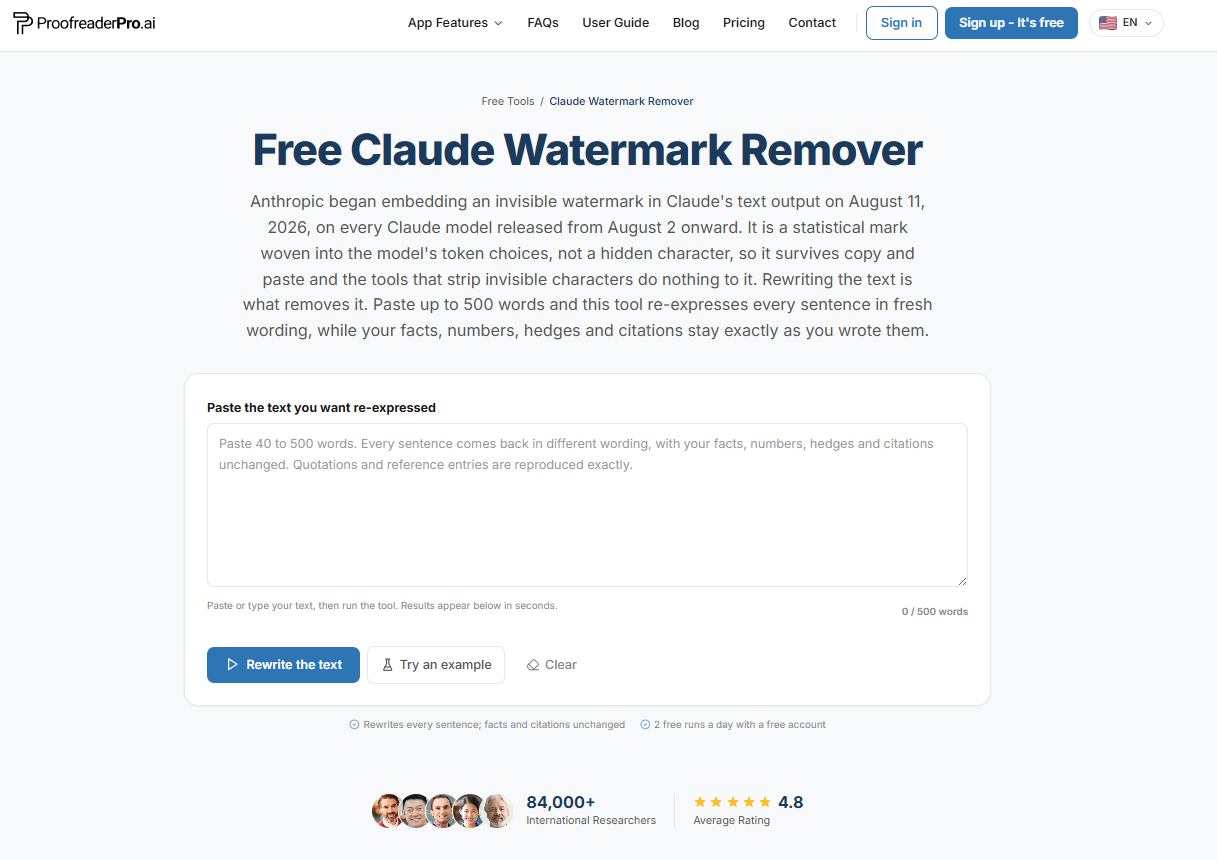
La riscrittura è l'unica operazione che rimuove una marca statistica ed è ciò che questo strumento fa, frase per frase.
Dove va da qui
Guarda tre cose fino al 2027. Prima: se OpenAI porta textGrain oltre l'UE. È partito da lì perché l'applicazione UE dell'Articolo 50 richiede marche machine-readable sul testo AI. Seconda: se i rilevatori convergono. Se ogni grande laboratorio watermark con uno schema pubblicato, le università possono verificare le chiavi invece di indovinare dallo stile di scrittura, migliorando rispetto all'oggi rilevazione soggetta a falsi positivi. Terza: se le marche diventano compatibili. Oggi, tre laboratori usano tre marche diverse e nessun controllo unico le copre tutte. C2PA colma quel vuoto per i file; per il testo grezzo, però, non c'è ancora nulla che lo faccia.
ChatGPT watermarka il suo testo?
Sì, in parte, a partire dal 5 ottobre 2026. OpenAI ha iniziato ad aggiungere il suo watermark textGrain al testo idoneo di ChatGPT e Codex nell'Unione Europea, e i clienti API ovunque possono attivarlo. Il watermark è un segnale statistico nelle scelte lessicali, senza caratteri nascosti. OpenAI applica anche metadati di provenienza C2PA ai file multimediali di DALL-E e Sora, ma si tratta di un sistema separato, a livello di file.
Google Gemini watermarka il suo testo?
Sì. L'output di Gemini porta il watermark SynthID-Text di Google DeepMind dall'ottobre 2024. È una marca statistica nelle scelte di parole, invisibile ai lettori e verificabile tramite il SynthID Detector di Google. Si applica solo ai modelli di proprietà di Google, quindi un risultato SynthID negativo non dice nulla sul testo proveniente da altri sistemi AI.
Claude watermarka il suo testo?
Sì. Ogni modello di Claude avviato il 2 agosto 2026 o dopo incorpora un watermark statistico nell'output testuale, su ogni piattaforma e piano, senza possibilità di rinuncia, e i file generati da Claude includono inoltre metadati C2PA. I modelli avviati prima di quella data non marcano ancora l'output; Anthropic afferma che sta aggiungendo il supporto alla marcatura per loro durante un periodo di transizione. I dettagli completi sono nel nostro approfondimento sul watermark di Claude.
Le università possono rilevare i watermark AI?
Solo con la collaborazione del fornitore, perché il rilevamento richiede la chiave del fornitore. Google offre un portale pubblico di rilevamento per i contenuti SynthID. Anthropic dice che il supporto al rilevamento per utenti e terze parti è pianificato, ma non ha ancora rilasciato un rilevatore pubblico. Nessuna suite mainstream di rilevamento del plagio può al momento verificare i watermark statistici da qualunque laboratorio, quindi l'odierna "rilevazione AI" istituzionale significa ancora indovinare basandosi sullo stile, non verificare i watermark.
Il watermarking dell'AI è richiesto per legge?
Nell'UE, sì, di fatto. L'articolo 50(2) dell'EU AI Act impone ai fornitori di AI generativa di garantire che gli output siano contrassegnati in un formato leggibile da una macchina e rilevabili come generati artificialmente, con obblighi di trasparenza applicabili a partire dal 2 agosto 2026. Anthropic ha firmato il Codice di Pratica collegato e ha scelto la conformità globale. La questione da tenere d'occhio nel 2027 è come i regolatori tratteranno il watermark testuale non ancora rilasciato di OpenAI.
I watermark AI sopravvivono alla traduzione?
No. Un watermark statistico vive nell'esatta sequenza di parole scelta dal modello, e la traduzione sostituisce ogni parola. Lo stesso vale per la parafrasi profonda e per una revisione umana intensa. Questo limite è documentato nella letteratura sottoposta a revisione paritaria e riconosciuto da ogni fornitore che distribuisce un watermark.
Esiste un verificatore pubblico di watermark di OpenAI per il testo?
No, lo strumento di verifica pubblico di OpenAI controlla solo file immagine e audio, per i metadati C2PA e i watermark SynthID. OpenAI afferma di non supportare il testo. Il suo rilevatore di watermark testuale è aperto solo a ricercatori approvati e a organizzazioni esperte, caso per caso.
Cos'è textGrain?
textGrain è il watermark testuale di OpenAI, annunciato il 5 ottobre 2026. Aggiunge un segnale statistico invisibile alle scelte di parole del modello, quindi il contrassegno fa parte delle parole, senza caratteri nascosti o metadati del file. OpenAI afferma di averlo ottenuto o superato rispetto agli altri metodi che ha testato, incluso SynthID per il testo, e che la modifica lo indebolisce.
I ricercatori possono richiedere l'accesso al rilevatore del watermark testuale di OpenAI?
Sì, i ricercatori approvati e le organizzazioni esperte possono fare domanda tramite il modulo dell'OpenAI Content Provenance API. OpenAI concede l'accesso caso per caso nell'ambito dell'EU Code of Practice. Dice che rivedrà un accesso più ampio man mano che tecnologia ed evidenze si svilupperanno.
Fonti
- Anthropic, Come funziona il watermark testuale di Claude, agosto 2026
- Anthropic Help Center, Come Claude contrassegna i contenuti generati dall'AI, 2026
- OpenAI, Comprendere l'origine di ciò che vediamo e ascoltiamo online, maggio 2024
- Google DeepMind, SynthID
- Dathathri et al., Watermarking scalabile per identificare gli output dei large language model, Nature, ottobre 2024
- Google, Annuncio del rilevatore di SynthID, maggio 2025
- Hugging Face, Introducing SynthID Text, ottobre 2024
- Kirchenbauer et al., Un watermark per grandi modelli linguistici, ICML 2023
- Krishna et al., La parafrasi aggira i rilevatori di testo generato dall'AI, NeurIPS 2023
- Scott Aaronson, La mia lezione di AI Safety per UT Effective Altruism, novembre 2022
- Unione europea, AI Act, articolo 50
- C2PA, Coalizione per la provenienza e l'autenticità dei contenuti
Dana è una creatrice di contenuti presso ProofreaderPro, dove gestisce il blog quotidiano e le operazioni di scrittura. Scrive articoli su come funziona la piattaforma di editing online e gestisce i messaggi dei clienti ogni giorno, con un punteggio di soddisfazione a cinque stelle da dimostrare.