
OpenAI, Google a Anthropic všechny vybudovaly stejnou technologii: statistický vodoznak pro text generovaný pomocí AI. OpenAI svou verzi léta zadržovalo a začalo ji postupně nasazovat jako textGrain v říjnu 2026. Google dodal SynthID přímo do Gemini a zveřejnil metodu. Anthropic učinilo vodoznak pro Claude povinným pro každého uživatele v srpnu 2026. Pokud píšete s jakoukoli asistencí od AI, všechna tři tato rozhodnutí nyní určují, jak budou vaše dokumenty posuzovány.
Vodoznakování se přesunulo z výzkumného tématu do mainstreamových zpráv 11. srpna 2026, kdy Anthropic oznámilo, že každý nový model Claude označuje výstupní text. Toto oznámení jsme podrobně rozebrali v našem Vodoznak Claude od Anthropic, vysvětleno (2026). Tato příručka shrnuje celý obraz: co je textový vodoznak, jak každá z těchto tří hlavních laboratoří jeho zavedení buď provedla, nebo zadržela, a co každé z těchto řešení vypovídá o daném textu.
Co je AI textový vodoznak?
AI textový vodoznak je statistický vzorec skrytý v volbě slov generovaného textu, vložený v okamžiku generování tak, aby jej mohl detektor s příslušným klíčem později ověřit, že text pochází z konkrétního systému AI. Nejde o viditelný štítek, ne o skrytý znak a ne o metadata připojená k souboru. Značka je přímo v samotných slovech.
Na tom záleží, protože pojem „vodoznak“ se volně používá pro tři různé věci:
| Co to je | Kde to žije | Přežije kopírování a vložení? | |
|---|---|---|---|
| Statistický vodoznak | Zkreslení, při kterém si model vybírá slova | Samotný text | Ano |
| Metadata souboru (C2PA) | Podepsaný štítek původu | Kontejner souboru | Ne, prosté kopírování to odstraní |
| Znaky s nulovou šířkou | Neviditelný Unicode vložený do textu | Mezi viditelnými znaky | Ne, triviálně odstranitelné |
Statistické vodoznakování je jediné ze tří, které přežije kopírování, vkládání, přepisování do nového dokumentu a převod formátu. Proto se na textu všechny tři hlavní laboratoře shodly právě na něm a proč "odstraňovače vodoznaků", které odstraňují neviditelné znaky, proti němu nic nezmohou. Naše stránka odstraňovače vodoznaku pro Claude zdarma dokumentuje tento způsob selhání s použitými zdroji.
Jak statistické vodoznakování ve skutečnosti funguje?
Při každém kroku psaní věty si jazykový model vybírá mezi několika téměř rovnocennými slovy a vodoznak tiše načítá tyto volby. Základní recept publikovali Kirchenbauer a kolegové z University of Maryland v lednu 2023 v Watermark for Large Language Models (ICML 2023). Funguje to takto:
- Než je zvoleno každé slovo, tajný klíč odvozený z předchozích slov rozdělí slovník na preferovanou množinu a neutrální množinu.
- Model svou volbu lehce posune směrem k preferované množině. „Suggest“ místo „indicate“. „Across“ místo „among“. Každá jednotlivá volba vypadá úplně přirozeně.
- Detektor, který má klíč, počítá, jak často text dopadne do preferovaných množin. Lidské psaní zasáhne očekávanou míru náhodou. Vodozroku označený text zasáhne tuto míru mnohem častěji a statistický test odhalí rozdíl.
Žádné jediné slovo není důkazem čehokoli. Signál se projeví až napříč desítkami nebo stovkami voleb, a proto jsou delší pasáže snáze testovatelné než krátké a také proto je detekce vždy pravděpodobnostní, nikoli razítko ano nebo ne.
Produkční systém společnosti Google DeepMind, publikovaný v Nature v říjnu 2024 jako Scalable watermarking for identifying large language model outputs, zdokonalil technikou zvanou tournament sampling, která uchová kvalitu textu tak dobře, že může potichu běžet uvnitř spotřebitelského produktu ve velkém měřítku. Ten článek je důležitý i mimo Google: je to zveřejněný podklad, na který Anthropic odkazuje pro implementaci u Claude.
Hlavní slabina byla publikována dřív, než proběhlo většině nasazení. V březnu 2023 Krishna a kolegové ukázali v Přeformulování obchází detektory textu generovaného AI (NeurIPS 2023), že regenerování formulací v rámci pasáže snižuje detekci napříč metodami, včetně vodoznakování. Signál existuje v přesné posloupnosti tokenů a nikde jinde, takže cokoliv, co tu posloupnost přepíše, včetně zásahu lidského editora, přepisuje i důkaz. Každý dodavatel, který dnes dodává vodoznaky, uvádí toto omezení ve své vlastní dokumentaci.

OpenAI: společnost, která to vymyslela a dodala to jako poslední
OpenAI mělo funkční textové vodoznakování po mnoho let a rozhodlo se ho neuvolnit až do října 2026. Scott Aaronson, tehdy pracující na bezpečnosti v OpenAI, poprvé popsal tuto myšlenku veřejně v přednášce z listopadu 2022. Metoda zvýhodňuje volby modelu mezi téměř rovnocennými slovy pomocí tajné kryptografické funkce, takže samotný text ukazuje, odkud pochází. Ta přednáška je starší než každý nasazený systém.
V květnu 2024 OpenAI popsala stav projektu ve svém aktualizačním příspěvku k provenienci, Porozumění zdroji toho, co vidíme a slyšíme online. Společnost uvedla, že její metoda textového watermarkingu je přesná a účinná u drobných úprav, ale zvažovala uvolnění, protože vyhodnocovala obchodní kompromisy. Dva z rizik, která OpenAI zmínila, jsou pro akademické autory přímo relevantní:
- Snadné obcházení. Přepsání nebo překlad text odstraní značku přesně tak, jak to předpověděl výzkum z roku 2023. Watermark, který hlavně zachytí lidi, kteří nevědí, že existuje, je slabý nástroj vynucování.
- Nepřiměřený dopad na rodilé nemluvčí angličtiny. OpenAI uvedla, že watermarkování může znevýhodnit legitímní využívání AI jako pomocníka při psaní pro osoby, které píší v druhém jazyce. Náš text o proč AI detektory označují nerodilé anglicky píšící autory řeší stejný problém i z pohledu detektoru.
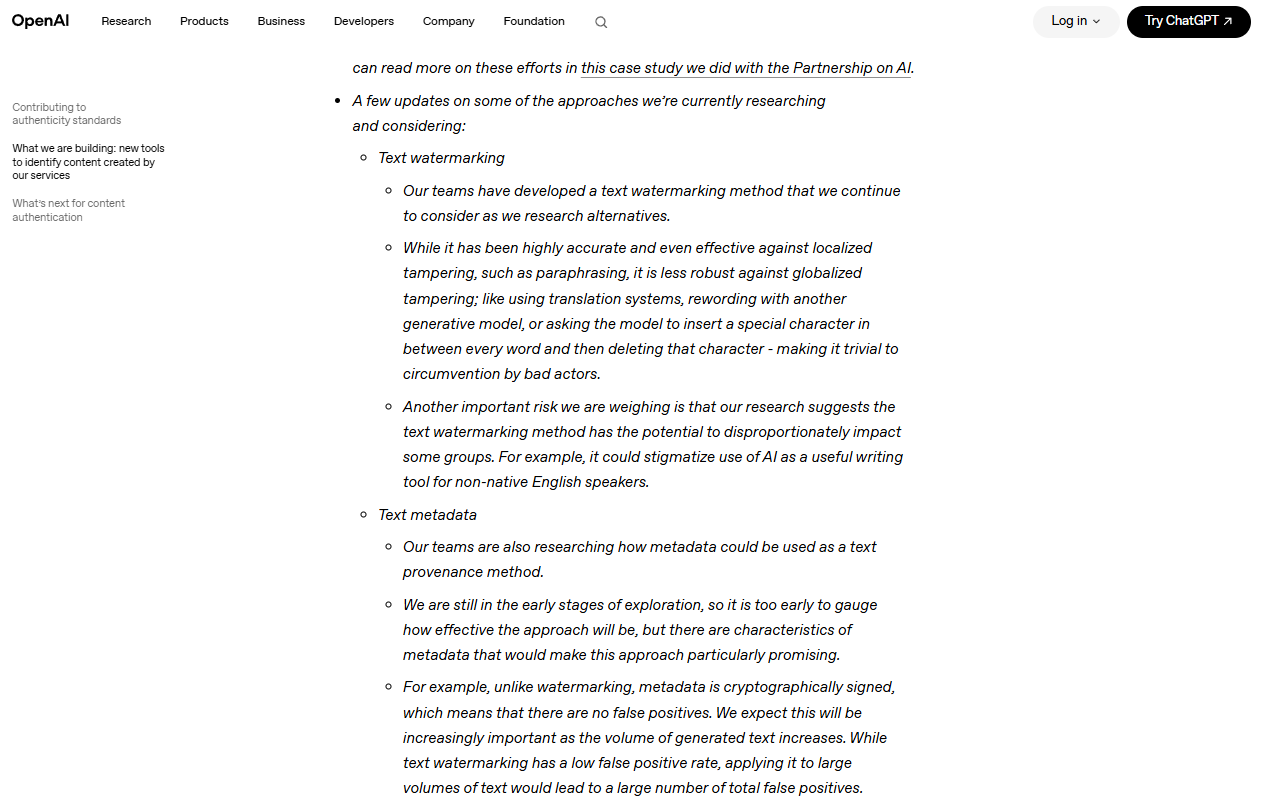
Aktualizace provenience OpenAI z roku 2024: metoda funguje a společnost uvádí důvody, proč ji tehdy zadržela.
U obrázků a audia zvolila OpenAI jiný přístup: C2PA provenienční metadata ve výstupech DALL-E a Sora, tedy štítek na úrovni souboru, nikoli značka přímo v obsahu. U textu výstup z ChatGPT neobsahoval watermark až do října 2026. Společnost, která technologii navrhla, byla poslední ze tří, kdo ji nasadil.
OpenAI dnes watermarkuje text?
Ano, OpenAI začala watermarkovat část textu 5. října 2026 jako reakci na EU AI Act. Její oznámení zavádí textový watermark s názvem textGrain, který přidává neviditelný statistický signál do voleb slov v modelu. Nasazení má tři části a watermark není výchozí globální nastavení:
- Zákazníci API odkudkoli na světě mohou zapnout watermarkovaný výstup pro vybrané modely. Ve výchozím nastavení je vypnutý.
- V následujících týdnech získá watermark vhodný výstup z ChatGPT a Codexu v Evropské unii, ve všech tarifech.
- Schválení výzkumníci a odborné organizace mohou požádat o přístup k detektoru textového watermarku.
OpenAI uvádí, že textGrain odpovídal nebo překonal ostatní metody, které testovala, včetně SynthID pro text od Googlu. Zároveň zveřejnila, kde je detekce slabší. Při 1% míře falešných pozitiv detektor identifikoval watermark u zhruba 80 % pasáží o 200 slovech a u zhruba 95 % pasáží o 400 slovech v psychologickém obsahu. U matematiky byla detekce výrazně nižší, protože je menší volnost v volbě slov.
Úpravy signál rychle oslabují. V pasážích o 400 slovech nahrazení 10 % slov synonymy snížilo detekci z přibližně 92 % na 66 % a nahrazení 25 % ji snížilo na 17 %.
OpenAI také ověřila, zda watermark mění kvalitu odpovědí na Astře, jejím nejnovějším modelu, a říká, že nezaznamenala žádný významný rozdíl. Tady jsou čtyři ze benchmarků, které zveřejnila:
| Benchmark | Bez watermarku (Astra) | S watermarkem (Astra) |
|---|---|---|
| Artificial Analysis Intelligence Index | 49.57 bodů | 49.76 bodů |
| GPQA Diamond | 94.44% | 93.94% |
| HealthBench Professional | 64.27% | 64.60% |
| BrowseComp | 87.92% | 87.35% |
Pro studenty je důležité, jaký je datum. Text z ChatGPT napsaný před uvedením do provozu, nebo mimo EU bez nastavení v API, nemá OpenAI watermark. Náš průvodce Turnitin Clarity vysvětleno vysvětluje, jak školy mezitím nastavují vlastní zásady pro využívání AI.
Existuje veřejná kontrola OpenAI watermarků?
Zatím neexistuje veřejný kontrolní nástroj OpenAI na watermarky pro text. OpenAIův bezplatný verifikační nástroj kontroluje obrázky a zvukové soubory z hlediska C2PA Content Credentials a watermarku SynthID, který OpenAI vkládá do podporovaných obrázků a zvuku. OpenAI uvádí, že nástroj nepodporuje text.
Pro text OpenAI poskytuje přístup k detektoru případ od případu schváleným výzkumníkům a odborným organizacím prostřednictvím formuláře pro Content Provenance API. Uvádí, že detektor textu při spuštění nezveřejní, protože hrozí riziko přehlédnutých watermarků a falešně pozitivních výsledků. Detektor hlásí, zda najde watermark OpenAI, a neidentifikuje uživatele ani nezobrazuje jeho prompty.
| Co chcete zkontrolovat | Nástroj | Kdo to může používat |
|---|---|---|
| Soubor s OpenAI obrázkem nebo zvukem | OpenAIův verifikační nástroj | Kdokoliv, zdarma |
| Textový výstup OpenAI (textGrain) | Detektor textových watermarků OpenAI | Schválení výzkumníci a odborné organizace, na základě žádosti |
| Textový výstup od Clauda | Detektor watermarků od Clauda | Způsobilé organizace, na základě žádosti (viz náš průvodce watermarky od Clauda) |
OpenAI je také jasné, co výsledek nedokáže. Detekovaný watermark neměří, jak moc se na textu podílel člověk, a nedokáže určit, kdo text napsal nebo použil. Chybějící watermark také nedokazuje lidské autorství, protože text může být příliš krátký, upravený, přeložený nebo pocházet z nepodporovaného modelu.
Google: nejdřív spustil, potom recept zveřejnil
Google DeepMind dodal řešení jako první, kompletně ho publikoval a následně metodu otevřel. Jeho systém SynthID začal jako image watermark v roce 2023 a v roce 2024 se rozšířil i na text. V době, kdy v říjnu 2024 vyšel článek Nature, už SynthID-Text běžel v produkčním nasazení v rámci Geminu, což z něj učinilo první statistický textový watermark nasazený v měřítku pro běžné uživatele.
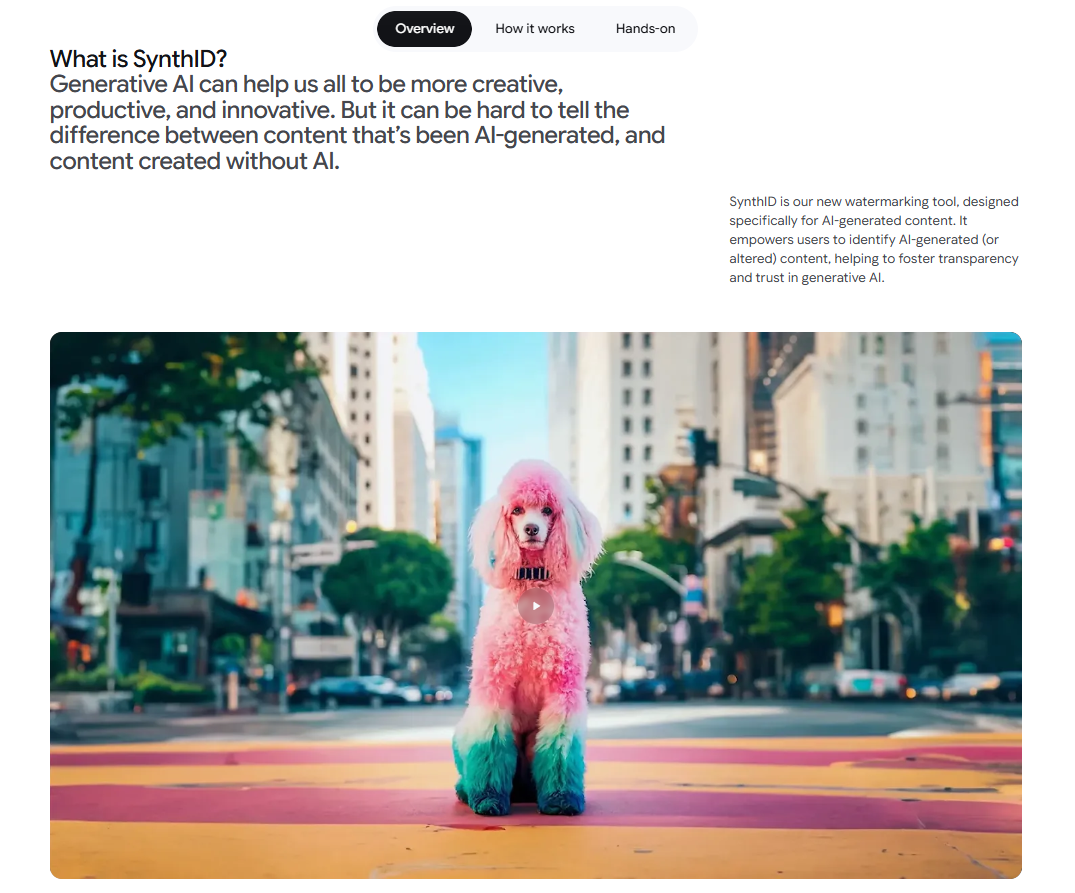
SynthID pokrývá text, obrázky, zvuk i video a v režimu výstupu textu v Geminu běží od října 2024.
Google pak publikoval implementaci jako open source na Hugging Face, což umožnilo každému vývojáři použít stejný watermarkovací postup na vlastní modely. V květnu 2025 oznámil SynthID Detector, verifikační portál, kde lze obsah zkontrolovat na přítomnost značek SynthID napříč textem, obrázky, zvukem a videem.
Je důležité si uvědomit jedno omezení: SynthID pouze označuje a pouze detekuje obsah z vlastních modelů společnosti Google. Neříká nic o výstupech ChatGPT nebo Claude a čistý sken SynthID neznamená, že je text napsaný člověkem. Znamená to jen, že to nenapsaly modely Googlu, což je mnohem užší tvrzení.
Anthropic: poslední, ale s nejpřísnější politikou
Anthropic nasadil řešení jako poslední a s nejširším povinným pokrytím. Každý model Clauda spuštěný 2. srpna 2026 nebo později vkládá do svého textového výstupu statistický watermark, celosvětově, v každém tarifu, bez možnosti vypnout. Společnost mechanismus popisuje v vysvětlujícím materiálu, Jak funguje textový watermark u Clauda, a rozsah politiky v článku v help centru Jak Claude označuje obsah vytvořený AI. Do pokrytí spadají Claude API, claude.ai, Claude Code, Claude Cowork i Claude Tag. Modely spuštěné před časovým mezníkem jsou v přechodném období a Anthropic uvádí, že podporu označování doplňuje i pro ně. Spolu se statistickou značkou nesou soubory vytvořené Claudem také metadata C2PA, tedy druhý samostatný systém, který běžné kopírování prostým textem odstraní.
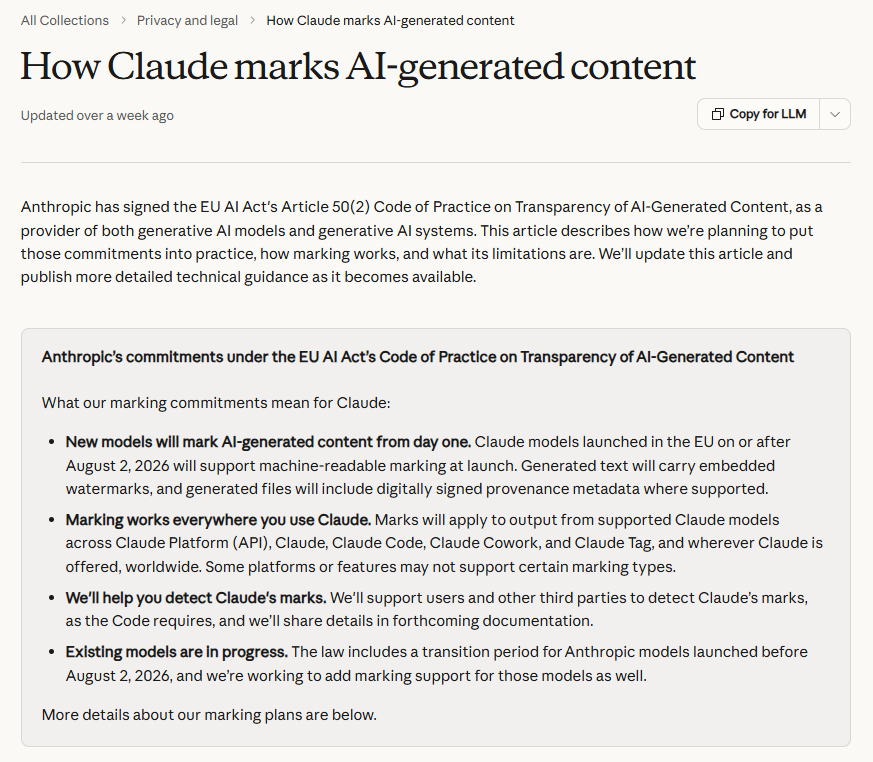
Zásady podle vlastních slov Anthropic: každý nový model, každá platforma, celosvětově, přičemž starší modely se přidávají postupně.
Dokumentace od Anthropic uvádí limity přímo. Detekce je pravděpodobnostní. Označení nedokáže rozlišit dokument, který napsal Claude, od dokumentu, který napsal člověk a Claude jej jen lehce upravil. Úplné přepracování jej odstraní. Prošli jsme to všechno, včetně toho, co ve skutečnosti dokládá pozitivní detekce a co dělat, když je vaše vlastní psaní označeno, v vyhrazeném průvodci značkami Claude.
Načasování navazuje na regulaci. Anthropic podepsala Článek 50(2) Kodexu postupů pro transparentnost obsahu generovaného umělou inteligencí podle EU AI Act, který vyžaduje poskytovatele systémů generativní AI, aby zajistili, že výstupy budou "označeny ve formátu čitelném pro stroje a detekovatelné jako uměle generované". Tyto povinnosti transparentnosti začaly platit 2. srpna 2026: přesné datum ukončení v modelové politice Anthropic, devět dní před veřejným oznámením. Anthropic se rozhodla dodržovat pravidla globálně místo udržování odděleného chování pro provoz v EU. Google už byl v souladu díky designu. Neoznačený textový výstup od OpenAI je otevřená otázka ohledně souladu pro rok 2027.
Tři přístupy vedle sebe
| OpenAI | Google DeepMind | Anthropic | |
|---|---|---|---|
| Nasazena textová watermark? | Ano (textGrain, nasazení v EU od 5. října 2026) | Ano (Gemini, od října 2024) | Ano (modely Claude od 2. srpna 2026) |
| Technika | textGrain, statistický signál v volbě slov | SynthID-Text turnajové vzorkování | Statistické vzorkování, značka ve stylu SynthID |
| Pokrytí | Způsobilý text pro ChatGPT a Codex v EU; celosvětově volitelně přes API | Modely Google pouze | Všechny nové modely Claude; starší modely v přechodu |
| Odhlášení | V API vypnuto jako výchozí | Ne | Ne |
| Veřejný detektor | Ne | Portál detektoru SynthID (2025) | Plánované, zatím neuvolněno |
| Publikováno schéma? | Pouze konceptuální přednášky | Nature článek + open source | Vysvětlení založené na publikovaných pracích |
| Metadata souboru (C2PA) | Ano, obrázky a audio | Ano, napříč médii | Ano, u vygenerovaných souborů |
| Uvedená omezení | Obcházení, stigmatizace ESL | Rozsah omezený na vlastní modely | Pravděpodobnostní, úpravy rozmazávají autorství |
Vzor napříč sloupci: OpenAI považuje textové watermarkování za nevyřešený problém politik, Google jej vnímá jako infrastrukturu k standardizaci a Anthropic jej bere jako povinnost plné shody implementovat.
Co to znamená pro výzkumníky a akademické autory
Praktické dopady závisí na tom, které nástroje se dotknou vašeho textu. Pokud svůj text dnes vytvoříte pomocí ChatGPT, text nebude mít watermark. Pokud text vytvoříte pomocí Gemini, nese značku SynthID, kterou dokáže přečíst pouze detektor Googlu. Pokud text vytvoříte nebo upravíte pomocí aktuálního modelu Claude, nese značku společnosti Anthropic a neexistuje nastavení, které by ji vypnulo.
Tři věci, které by si akademičtí autoři měli vědět:
Watermark identifikuje nástroj, ne autora. Každý dodavatel to uvádí ve svých vlastních dokumentech, a stojí za to to zopakovat, protože institucionální politiky někdy tento rozdíl nedělají. Text může být označen proto, že jej vytvořila AI, protože AI provedla jazykovou korekturu dvou vět, nebo protože byl označený odstavec ocitován. Pokud vaše instituce spouští kontroly watermarku, to, co kontrola prokazuje, je, že se konkrétní model v určitém bodě dotkl textu, nic víc. Náš průvodce na odvolání proti falešnému upozornění na AI detekci vysvětluje, jak tento argument použít, když na něm záleží.
Watermarky a detektory AI jsou různé technologie s různými režimy selhání. Detektory jako Turnitin nebo GPTZero odhadují podle statistického stylu, s problémy s přesností, které jsme zdokumentovali. Detekce watermarku je test na základě klíče s velmi nízkou mírou falešně pozitivních výsledků u lidského textu bez označení. Asymetrie se obrací u falešně negativních: kontrola watermarku přehlédne jakýkoli text vytvořený AI z modelu, který watermarkuje, což dnes zahrnuje všechny ChatGPT.
Zveřejnění zůstává vaše nejsilnější pozice. Watermarkování dělá tiché používání AI riskantnějším a zveřejněné používání AI bezpečnějším, protože zveřejněný postup nemá co riskovat při pozitivním označení. Většina časopisů a univerzit dnes má explicitní politiky pro používání AI; naše politika pro používání AI vysvětluje, kde mezi nimi u vlastních nástrojů kreslíme čáry, a je rozumnou šablonou toho, jak má vypadat transparentní používání.
Co odstraní textový watermark a co ne
Přepis ho odstraní; přeformátování ne. Kopírování, vkládání, změna fontů, převody mezi formáty souborů a odstranění neviditelných znaků zanechají statistický watermark plně nedotčený, protože značka je v volbě slov. Co jej odstraní, je cokoli, co znovu vygeneruje formulaci: hluboká lidská editace, překlad, nebo skutečná parafráze, jak práce o robustnosti NeurIPS 2023 ukázala ještě předtím, než se tyto systémy rozjely do provozu.
Oběma směry na tom záleží. To, že značka zmizí, neznamená, že text je váš, a to, že značka zůstane, neznamená, že text není váš. Přepsaný AI návrh je stále dokument s pomocí AI, na který se vztahují pravidla vašeho institucionálního oznamování. Náš AI text humanizer přepisuje návrhy s pomocí AI do přirozeného akademického rejstříku a protože tento proces znovu vygeneruje sekvenci tokenů, statistické značky v něm nepřežijí. Pro text od Claude konkrétně platí, že bezplatný odstraňovač vodoznaku pro Claude přeformuluje každou větu čerstvým způsobem, přičemž ponechá nezměněná fakta, čísla a citace. To, co žádný nástroj změnit nemůže, je to, co dlužíte svému čtenáři: transparentnost ohledně toho, jak byl dokument vytvořen.
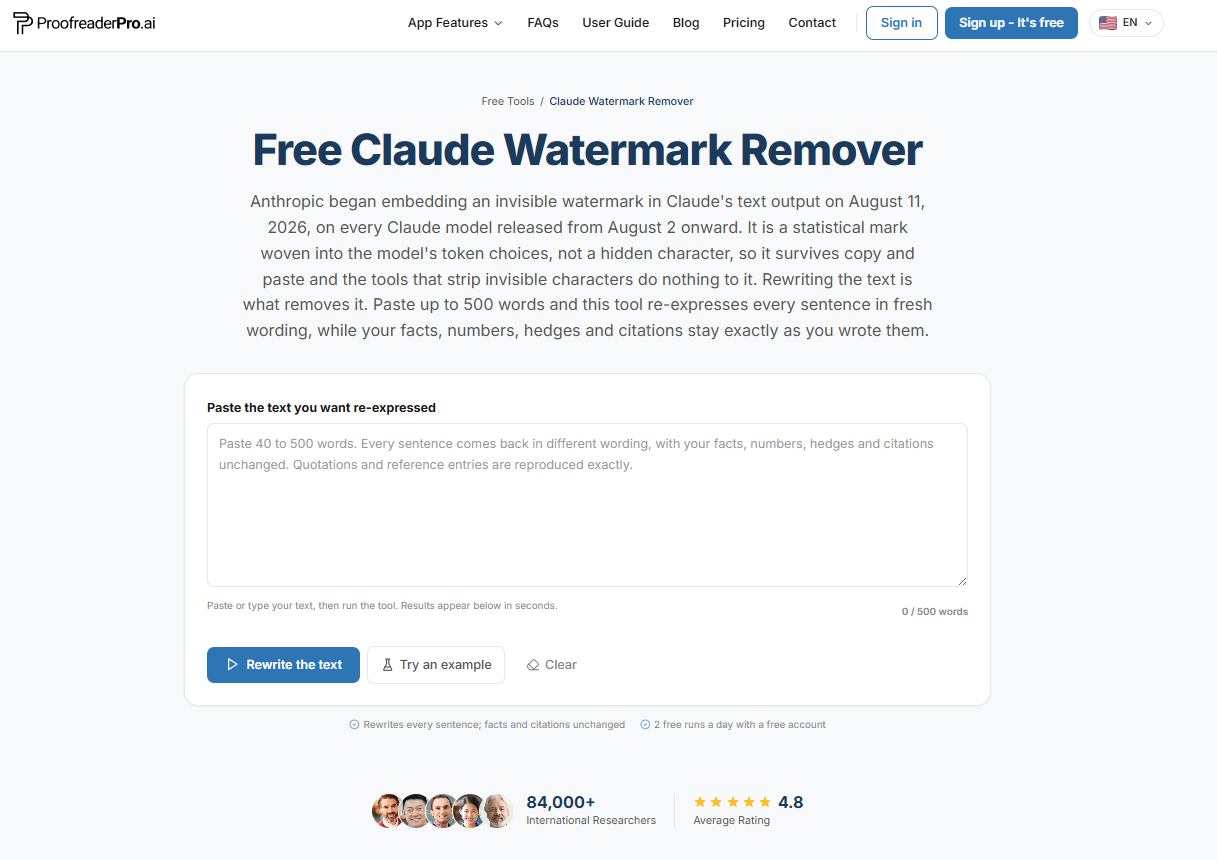
Přepis je jediná operace, která odstraní statistickou značku, a přesně to tento nástroj dělá, větu po větě.
Kam to půjde dál
Sledujte tři věci do roku 2027. Zaprvé, zda OpenAI posune textGrain za hranice EU: začalo tam, protože vynucování v EU podle článku 50 vyžaduje strojově čitelné značky v textu s AI. Zadruhé, zda se detektory sjednotí. Pokud každá významná laboratoř bude značkovat podle zveřejněného schématu, univerzity si mohou ověřovat klíče místo toho, aby hádaly ze stylu psaní, což by zlepšilo to, co dnes trpí na detekci náchylnou k falešným pozitivním výsledkům. Zatřetí, zda se značky stanou kompatibilními. Dnes používají tři laboratoře tři různé značky a neexistuje jedna kontrola, která by je pokryla všechny. C2PA zaplňuje tuto mezeru pro soubory; zatím ji nic nezaplňuje pro prostý, neupravený text.
Vkládá ChatGPT vodoznak do svého textu?
Ano, částečně, od 5. října 2026. OpenAI začalo přidávat svůj vodoznak textGrain do způsobilých textů v ChatGPT a Codexu v Evropské unii, a zákazníci API odkudkoli ho mohou zapnout. Vodoznak je statistický signál v volbě slov, bez skrytých znaků. OpenAI také aplikuje metadata C2PA o původu na mediální soubory z DALL-E a Sora, což je samostatný systém na úrovni souboru.
Vkládá Google Gemini vodoznak do svého textu?
Ano. Výstupy Gemini od října 2024 nesou vodoznak SynthID-Text od Google DeepMind. Je to statistická značka v volbě slov, pro čtenáře neviditelná, a ověřitelná prostřednictvím SynthID Detectoru od Google. Platí jen pro vlastní modely Googlu, takže negativní výsledek SynthID nic neříká o textu z jiných systémů s AI.
Vkládá Claude vodoznak do svého textu?
Ano. Každý model Claude spuštěný dne 2. srpna 2026 nebo později vkládá do výstupu textu statistický vodoznak, na každé platformě a v každém tarifu, bez možnosti vypnutí, a soubory vytvořené Claudem navíc obsahují metadata C2PA. Modely spuštěné před tímto datem zatím označování svého výstupu nedělají; Anthropic uvádí, že přidává podporu označování i pro ně během přechodného období. Kompletní podrobnosti jsou v našem vysvětlení vodoznaku u Claude.
Umějí univerzity detekovat AI vodoznaky?
Pouze s pomocí spolupráce dodavatele, protože detekce vyžaduje dodavatelský klíč. Google nabízí veřejný portál pro detekci obsahu SynthID. Anthropic uvádí, že podpora detekce pro uživatele a třetí strany se plánuje, ale zatím nevydala veřejný detektor. Žádná běžně dostupná sada pro odhalování plagiátů v současnosti nedokáže ověřit statistické vodoznaky z žádné laboratoře, takže dnešní institucionální „AI detekce“ stále znamená odhadování podle stylu, nikoli ověřování vodoznaků.
Je vodoznakování AI povinné ze zákona?
V EU ano, v praxi tedy ano. Článek 50(2) Nařízení EU o AI ukládá poskytovatelům generativní AI zajistit, aby výstupy byly označeny ve formátu čitelném strojem a aby bylo možné je rozpoznat jako uměle vytvořené, přičemž povinnosti transparentnosti se uplatní od 2. srpna 2026. Anthropic podepsal související Kodex postupů a zvolil globální dodržování předpisů. Otázkou, na kterou se bude v roce 2027 dívat, je, jak regulátoři posoudí neoznačené textové watermarky od OpenAI.
Přežijí AI watermarky překlad?
Ne. Statistický watermark žije v přesné sekvenci slov, kterou model zvolil, a překlad nahradí každé slovo. Totéž platí pro hluboké parafrázování a výrazné lidské úpravy. Toto omezení je popsáno v odborné literatuře recenzované kolegy a uznává je každý dodavatel, který watermark dodává.
Existuje veřejná kontrola watermarku OpenAI pro text?
Ne. Veřejný nástroj OpenAI pro ověřování kontroluje pouze obrazové a zvukové soubory, tedy metadatové údaje C2PA a watermarky SynthID. OpenAI uvádí, že text nepodporuje. Jeho detektor textových watermarků je k dispozici pouze schváleným výzkumníkům a odborným organizacím, případ od případu.
Co je textGrain?
textGrain je textový watermark od OpenAI, oznámený 5. října 2026. Přidává neviditelný statistický signál k volbám slov modelu, takže značka je součástí slov, bez skrytých znaků nebo metadat v souboru. OpenAI uvádí, že buď odpovídá, nebo překonává ostatní metody, které otestoval, včetně SynthID pro text, a že úpravy jej oslabují.
Mohou výzkumníci požádat o přístup k detektoru textových watermarků OpenAI?
Ano, schválení výzkumníci a odborné organizace mohou požádat prostřednictvím formuláře OpenAI pro Content Provenance API. OpenAI uděluje přístup případ od případu v rámci EU Kodexu postupů. Uvádí, že bude znovu posuzovat širší přístup, jak se budou vyvíjet technologie a důkazy.
Zdroje
- Anthropic, Jak funguje textový watermark u Claude, srpen 2026
- Anthropic Help Center, Jak Claude označuje obsah vytvořený AI, 2026
- OpenAI, Porozumění zdroji toho, co online vidíme a slyšíme, květen 2024
- Google DeepMind, SynthID
- Dathathri et al., Škálovatelné watermarkování pro identifikaci výstupů velkých jazykových modelů, Nature, říjen 2024
- Google, Oznámení detektoru SynthID, květen 2025
- Hugging Face, Představujeme SynthID Text, říjen 2024
- Kirchenbauer et al., Watermark pro velké jazykové modely, ICML 2023
- Krishna et al., Parafrázování se vyhýbá detektorům AI-vytvořeného textu, NeurIPS 2023
- Scott Aaronson, Moje přednáška o bezpečnosti AI pro UT Effective Altruism, listopad 2022
- Evropská unie, AI Act, článek 50
- C2PA, Koalice pro ověřitelnost a původ obsahu
Dana je tvůrcem obsahu ve společnosti ProofreaderPro, kde provozuje každodenní blog a psaní. Píše články o tom, jak funguje online platforma pro úpravy, a každý den zpracovává zprávy od zákazníků, což dokazuje pětihvězdičkové skóre spokojenosti.