Pangram হলো Pangram Labs-এর একটি AI detector, এবং কোম্পানির দাবি এটি 99% এরও বেশি নির্ভুল। তারা আরও বলে, এটি ভুলভাবে প্রায় ১০,০০০-এর মধ্যে ১টি মানব টেক্সটকে ফ্ল্যাগ করে। তাদের বর্তমান মডেল, Pangram 4.1, প্রকাশিত হয়েছে ১৯ অক্টোবর, ২০২৬। Pangram বলে তারা ইউনিভার্সিটি অব শিকাগো এবং ইউনিভার্সিটি অব মেরিল্যান্ডের বাইরে করা গবেষণার দিকে ইঙ্গিত করে, যেগুলো নাকি একই ধরনের ফল পেয়েছে।
Pangram-এর নির্ভুলতার বেশিরভাগ দাবিকে সমর্থন করে স্বাধীন পরীক্ষা, বিশেষত দীর্ঘ ইংরেজি টেক্সটে। ইউনিভার্সিটি অব শিকাগোর একটি কর্মপত্রে মাঝারি এবং দীর্ঘ অনুচ্ছেদে প্রায় শূন্য ত্রুটি পাওয়া গেছে। তবে ওই পরীক্ষায় ব্যবহৃত হয়েছিল Pangram-এর পুরনো মডেল এবং তাতে একাডেমিক লেখা ছিল না। তাছাড়া প্রায় ২,০০০টি মানব অনুচ্ছেদ ১০,০০০-এর মধ্যে ১-এর মতো কম হার নিশ্চিত করার জন্য যথেষ্ট নয়।
Pangram কী?
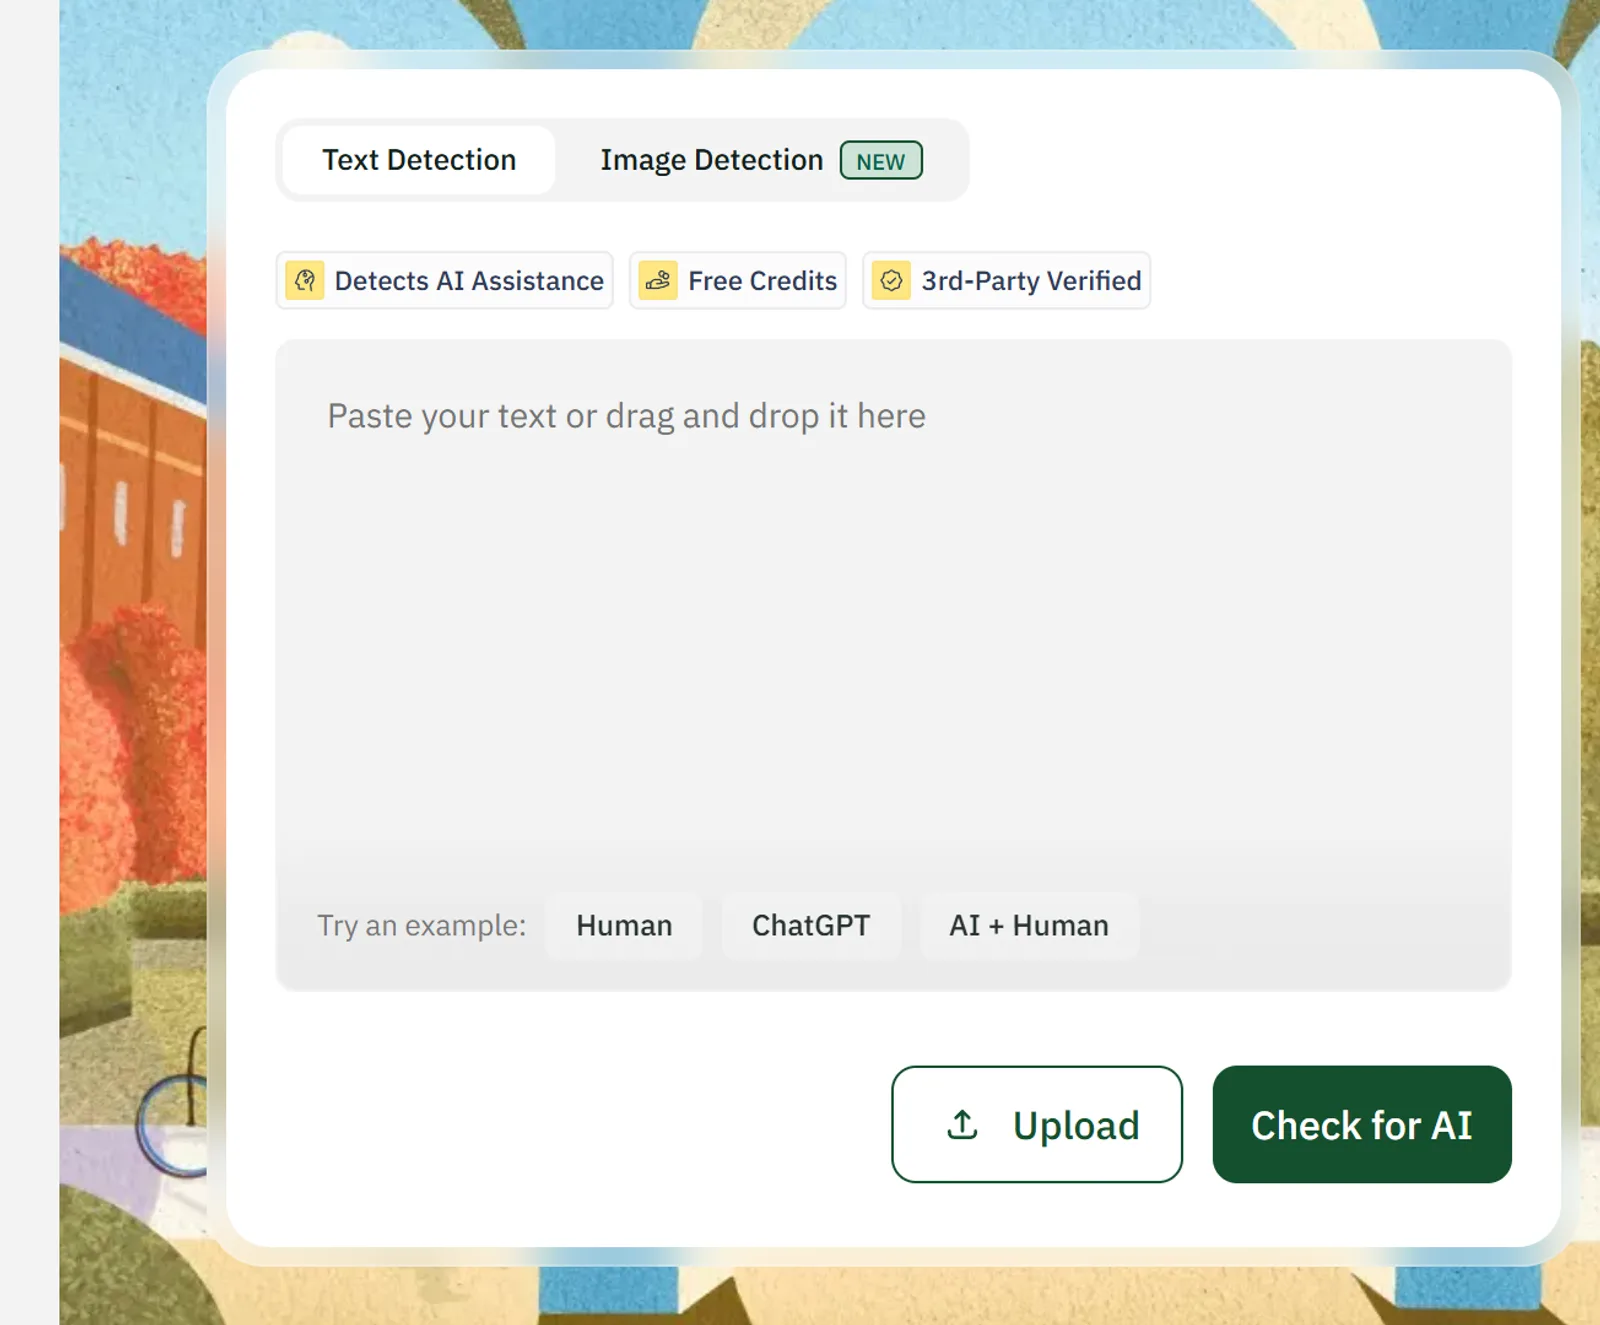
Pangram হলো স্কুল, প্রকাশক, আইন সংস্থা এবং অন্য এমন প্রতিষ্ঠানের জন্য তৈরি একটি AI detection টুল, যাদের দরকার মানুষের লেখা আর AI লেখা আলাদা করে বলা। আপনি টেক্সট পেস্ট করেন বা ফাইল আপলোড করেন। Pangram Human, AI-Generated অথবা AI-Assisted হিসেবে একটি পূর্বাভাস দেয়, এবং ডকুমেন্টের কত অংশ প্রতিটি লেবেলে পড়ে সেটির একটি স্কোরও দেয়। নামটি pangram শব্দের মতোই, যা এমন একটি বাক্য যা বর্ণমালার প্রতিটি অক্ষর ব্যবহার করে, যেমন "The quick brown fox jumps over the lazy dog"।
Pangram Labs প্রতিষ্ঠিত হয় ২০২৩ সালে নিউ ইয়র্কের Brooklyn-এ। কোম্পানির প্রতিষ্ঠাতারা শুরু করার আগে Tesla এবং Google-এ AI গবেষণায় কাজ করেছিল। টেক্সট ডিটেক্টরের পাশে Pangram বিক্রি করে প্ল্যাগিয়ারিজমের জন্য একটি Similarity Checker এবং Pangram Image 1.0 নামে AI ছবি ও ভিডিও ডিটেক্টর। তাদের আরও আছে একটি ব্রাউজার এক্সটেনশন, একটি MCP সার্ভার এবং একটি API। এটি Gmail, Google Docs এবং Canvas, Moodle, Google Classroom ও Brightspace-এর মতো লার্নিং ম্যানেজমেন্ট সিস্টেমের মধ্যেও কাজ করে।
Pangram 4.1 এর জন্য অন্তত ৫০টি শব্দের ইনপুট দরকার এবং সম্পূর্ণ বাক্যে ব্যবহার করলে সবচেয়ে ভালো কাজ করে। ছোট উত্তর এবং বুলেট পয়েন্ট দিলে কাজ করার মতো তথ্য কম পাওয়া যায়। প্রতিটি ফলাফলে প্রতিটি সেগমেন্টের জন্য High, Medium বা Low আস্থা স্তর থাকে, পাশাপাশি হাইলাইট করা অংশ থাকে যা মডেলটি AI-Generated, AI-Assisted নাকি Human হিসেবে লেবেল দিয়েছে তা চিহ্নিত করে।
AI-Assisted লেবেল মানে Pangram মনে করে AI সেই লেখা সম্পাদনা বা শাণিত করেছে, যা একজন ব্যক্তি শুরু করেছিলেন। আপনি যদি আপনার লেখার কিছু অংশে কোনো ব্যাকরণ টুল বা AI rewriter ব্যবহার করে থাকেন, তাহলে আপনার আইডিয়া ও কাঠামো নিজের হলেও এই লেবেল দেখা দিতে পারে। AI সম্পাদনা টুলের ক্ষেত্রে আপনার স্কুল বা নিয়োগকর্তা কী অনুমোদন করে তা আগে যাচাই করুন, তারপরই এটিকে সমস্যার প্রমাণ হিসেবে ধরুন।
কীভাবে Pangram-এর AI detector ব্যবহার করবেন
- pangram.com এ একটি বিনামূল্যের অ্যাকাউন্ট তৈরি করুন। বিনামূল্যের প্ল্যানে দিনে ২০টি করে চেক রয়েছে।
- আপনার টেক্সট পেস্ট করুন, অথবা সর্বোচ্চ একবারে ১০০টি করে PDF, DOCX বা RTF ফাইল আপলোড করুন। Pangram কাঁচা টেক্সট বা .docx ফাইল সুপারিশ করে, কারণ PDF রূপান্তর করলে টেক্সটে ভুল ঢুকে পড়তে পারে।
- স্ক্যান করার আগে হেডার, ফুটার, নির্দেশনা এবং রেফারেন্স তালিকা সরিয়ে দিন। Pangram রেফারেন্স লিস্ট, টেবিল অব কনটেন্টস এবং অন্যান্য সামনের ও পেছনের ম্যাটারকে এই স্কোপের বাইরে হিসেবে বিবেচনা করে।
- Check for AI এ ক্লিক করুন, তারপর লেবেল, শতাংশ এবং হাইলাইট করা সেগমেন্টগুলো পড়ুন।
- রিপোর্ট ডাউনলোড করতে বা পরের স্ক্যানের সাথে তুলনা করতে আপনার স্ক্যান হিস্ট্রি খুলুন।
Pangram-এর Similarity Checker
Pangram-এর Similarity Checker হলো এর প্ল্যাজিয়ারিজম টুল, এবং এটি AI detector-এর একই স্ক্যানে চলে। এটি আপনার টেক্সটকে বিলিয়ন বিলিয়ন ওয়েবপেজ, একাডেমিক পেপার, সংবাদ প্রবন্ধ এবং বইয়ের সাথে তুলনা করে। এটি সরাসরি মিলগুলো শনাক্ত করে এবং AI ফলাফলের পাশে তাদের উৎস দেখায়। paid প্ল্যানে প্রতিটি স্ক্যানে Similarity চেক অন্তর্ভুক্ত থাকে, আর বিনামূল্যের প্ল্যানটি শুধু AI detection কভার করে। শিক্ষকরা এটি Canvas এবং Google Classroom-এর ভেতরেও চালাতে পারেন।
দুইটি চেক ভিন্ন প্রশ্নের উত্তর দেয়। Pangram-এর AI detector কেবল আপনার জমা দেওয়া টেক্সটকেই দেখে। এটি অন্য জমাগুলোর সাথে বা ওয়েবের সাথে তুলনা করে না, এবং টেক্সট কীভাবে টাইপ করা হয়েছে তা রেকর্ডও করে না। Similarity Checker হলো সেই অংশ, যা কপি করা টেক্সট খোঁজে।
Pangram 4.1: কী বদলেছে
Pangram 4.1 হলো Pangram 4-এর উত্তরসূরি, যা ১৯ অক্টোবর, ২০২৬ এ প্রকাশিত হয়। Pangram বলছে এটি সামগ্রিক নির্ভুলতা এবং মডেলটি অনিশ্চিত হলে কীভাবে আচরণ করে তা উন্নত করেছে। ইনপুট, ট্রেনিং এবং লেবেলগুলো Pangram 4-এর মতোই।
ফলাফলে আপনি যা দেখেন তা প্রভাবিত করে তিনটি পরিবর্তন:
- ছোট সম্পাদনার পরে ভবিষ্যদ্বাণী কম বদলায়। ২৯,১০৩ জোড়া টেক্সটে, যেখানে ছোট সম্পাদনা করা হয়েছিল, সেখানে Pangram 4 থেকে verdict বদলানোর হার ছিল ১.০৮%, যা Pangram 4.1 এ নেমে এসেছে ০.১৫% এ।
- এখন প্রতিটি সেগমেন্ট ক্লাস সম্ভাবনাও দেখায়, যা Human, AI-Assisted এবং AI-Generated বিষয়ে মডেলের অনুমান।
- ড্যাশবোর্ডে ১৫০টির কম শব্দের টেক্সটের ক্ষেত্রে কম নিশ্চয়তা দেখায়।
Pangram তার প্রধান টেস্টও বদলেছে। এটি তার English টেস্ট সেট থেকে স্প্যাম, বিজ্ঞাপন এবং মেশিন-তৈরি পেজ পরিষ্কার করেছে, ফলে সেটটি আরও কঠিন হয়েছে। পরিষ্কার করা সেটের ৭৮১,৯৮১টি মানব ডকুমেন্টে, Pangram 4.1 ছিল ৭০টি false positive, বা ০.০০৯০%। এটি কোম্পানির ১০,০০০ টার্গেটের মধ্যে ১টির কাছাকাছি।
| Benchmark | Documents | Pangram 4.1 ফলাফল |
|---|---|---|
| English মানব ডকুমেন্ট, false positives | 781,981 | 0.0090% |
| ১০৪টি ভাষায় মানব ডকুমেন্ট, false positives | 1,000,000 | 0.0033% |
| ২৬টি মডেল থেকে আসা English AI ডকুমেন্ট, missed | 520,000 | 0.3652% |
| ১৮টি ভাষায় AI ডকুমেন্ট, missed | 190,149 | 1.99% |
এগুলো হলো Pangram-এর নিজস্ব Pangram 4.1 মডেল কার্ড থেকে নেওয়া সংখ্যা। Pangram এছাড়া University of Chicago স্টাডির ফুল-লেন্থ সেটটিও Pangram 4.1 দিয়ে আবার চালিয়েছে। এই ১৫,৯৩৬টি প্যাসেজে এটি কোনো false positive রিপোর্ট করেনি এবং কোনো missedও নেই।
একটি AI detector-এর ক্ষেত্রে “accurate” বলতে কী বোঝায়
একটি ডিটেক্টর দুই ধরনের ভুল করে, আর একটি শিরোনাম-শতকরা হার সেই পার্থক্যটা ঢেকে রাখে। ফলস পজিটিভ হলো মানুষের লেখা যা AI হিসেবে চিহ্নিত হয়। ফলস নেগেটিভ হলো AI লেখা যা মানুষ হিসেবে চিহ্নিত হয়। ফলস পজিটিভ রেট (FPR) হলো এমন হার, যেখানে মানুষের টেক্সট ভুলভাবে AI হিসেবে ধরা পড়ে, আর ফলস নেগেটিভ রেট (FNR) হলো এমন হার, যেখানে AI টেক্সট ভুলভাবে বাদ পড়ে যায় বা ধরা পড়ে না।
প্রতিটি ডিটেক্টরের একটি থ্রেশহোল্ড থাকে; এই স্কোরের উপরে হলে কোনো টেক্সটকে AI হিসেবে গণ্য করা হয়। থ্রেশহোল্ড বাড়ালে ফলস পজিটিভ কমে কিন্তু ফলস নেগেটিভ বাড়ে। থ্রেশহোল্ড কমালে উল্টোটা হয়। এমন একটি গবেষণা যা কেবল একটিই অজানা থ্রেশহোল্ডের "accuracy" দেখায়, কোন ভুলটা ডিটেক্টর বেশি করতে পছন্দ করে তা আপনি বুঝতে পারবেন না।
মানব নমুনার আকারও রেটের মতোই গুরুত্বপূর্ণ। ধরুন একটি পরীক্ষা প্রায় ২,০০০টি মানুষের পাঠ ব্যবহার করে এবং কিছুই ফ্ল্যাগ করে না। তখন পরিসংখ্যানগত "rule of three" সত্যিকারের ফলস পজিটিভ রেটকে প্রায় ০.১৫% এর নিচে, অর্থাৎ প্রায় ৬৭০ জনের মধ্যে ১ বলে ধরে। ১ ইন ১০,০০০ দাবি করতে হলে বহু লক্ষ মানুষের নথি দরকার, তাই Pangram বড় এবং স্বাধীন ল্যাবগুলোর এমন পরীক্ষার উদ্ধৃতি দেয় যা অধিকাংশ সময়ই তারা পুনরায় করতে পারে না বা পারেনি।
লেখকরা সবচেয়ে বেশি ফলস পজিটিভ রেট নিয়ে চিন্তিত, কারণ ফলস পজিটিভ মানে একটি অভিযোগ। হাজার হাজার সাবমিশন স্ক্যান করে এমন প্রতিষ্ঠানগুলো দুটো রেটই দেখে। নিচের প্রতিটি সংখ্যার ক্ষেত্রে এই পার্থক্যটা মাথায় রাখুন।
দেখে নেওয়ার মতো প্রমাণ
বেশির ভাগ প্রমাণ গড়ে তোলে এমন ছয়টি উৎস। এগুলোর মধ্যে কে পরীক্ষা চালিয়েছে, কোন টেক্সট ব্যবহার করা হয়েছে এবং AI মডেলগুলো কতটা সাম্প্রতিক ছিল সেই বিষয়গুলো আলাদা।
| উৎস | কে চালিয়েছে | তারিখ | কিসের ওপর পরীক্ষা |
|---|---|---|---|
| Pangram টেকনিক্যাল রিপোর্ট (Emi এবং Spero) | Pangram | ২০২৪ সালের ফেব্রুয়ারি, সংশোধন জুলাই ২০২৪ | ১,৯৭৬টি নথি, ১০টি ডোমেইন, ৮টি ভাষা মডেল, এবং সাথে তিনটি অ-নেটিভ ইংরেজি ডেটাসেট |
| RAID শেয়ার্ড টাস্ক ওভারভিউ (Dugan et al.) | শেয়ার্ড টাস্ক আয়োজকরা, যেখানে Pangram অংশ নেয় | ২০২৫ সালের জানুয়ারি | ৫% ফলস পজিটিভ রেট এ ধরা AI টেক্সট, আক্রমণসহ এবং আক্রমণ ছাড়া |
| Russell, Karpinska এবং Iyyer, ACL 2025 | মেরিল্যান্ড বিশ্ববিদ্যালয়ের গবেষকরা | ২০২৫ সালের জানুয়ারি পোস্ট করা, সংশোধন ২০২৫ সালের মে | মানুষ পড়েছে এমন ৩০০টি প্রবন্ধ এবং পাঁচটি ডিটেক্টর |
| Jabarian এবং Imas, NBER Working Paper 34223 | শিকাগো বিশ্ববিদ্যালয়, Booth | সেপ্টেম্বর ২০২৫ | ১,৯৯২টি মানুষের পাঠ, ৪টি AI মডেল, ৪টি ডিটেক্টর, StealthGPT আউটপুট |
| Pangram 4 টেকনিক্যাল রিপোর্ট এবং মডেল কার্ড | Pangram | জুলাই ২০২৬ | এক মিলিয়নেরও বেশি মানুষের নথি, ৫১৯,৯৯৩টি AI ডকুমেন্ট, ১০৪টি ভাষা |
| Pangram 4.1 মডেল কার্ড | Pangram | অক্টোবর ২০২৬ | ৭৮১,৯৮১টি ইংরেজি মানব নথি, ৫২০,০০০টি AI নথি, ১০৪টি ভাষা |
৬টির মধ্যে ২টি বিক্রেতার ওপর নির্ভরশীল নয়, এবং তাদের মধ্যে মাত্র ১টি হলো একই লেখায় কয়েকটি বাণিজ্যিক ডিটেক্টরকে নিয়ে নিয়ন্ত্রিত তুলনা। Chicago-র গবেষণাপত্রটি একটি working paper, এবং এর নিজস্ব কভার নোট বলে working papers “peer-reviewed হয়নি।”
Pangram তার নির্ভুলতা সম্পর্কে যা দাবি করে
Pangram-এর FAQ বলছে ডিটেক্টরটি ৯৯% এর বেশি নির্ভুল, আনুমানিক ১০,০০০টির মধ্যে ১টি false positive rate। এটি গণনা করা হয় প্রতি মিলিয়নের ডজন ডকুমেন্ট থাকা পাবলিক ডেটাসেট জুড়ে। Pangram আরও তার মডেলকে ২৬টি AI সিস্টেমের বিপরীতে বেঞ্চমার্ক করে, এবং হোমপেজে দেখায় যে AI-Generated নমুনার ওই দলভিত্তিক গ্রুপে ৯৯.৬% নির্ভুলতা। প্রতিটি বড় মডেল রিলিজের পর এটি নতুন করে পরীক্ষা চালায়।
Pangram আলাদা আলাদা মডেলের জন্যও নির্ভুলতার সংখ্যা প্রকাশ করে:
| AI মডেল | Pangram-এর রিপোর্ট করা নির্ভুলতা | পরীক্ষিত |
|---|---|---|
| Claude Haiku 5.5 | ৯৯.৭০% (২,৩৬৫ এর ২,৩৭২) | নভেম্বর ২০২৬ |
| Gemini 4 Argon | ৯৯.০২% (২,৩১৮ এর ২,৩৪১) | নভেম্বর ২০২৬ |
| GPT-6.1 Sol | ৯৮.৭৮% (২,১৮৮ এর ২,২১৫) | নভেম্বর ২০২৬ |
| Grok 4.3 | 99.3% | অক্টোবর ২০২৬ |
| Claude Opus 5 | 99.8% | জুলাই ২০২৬ |
| GPT-5.6 | 99.6% | জুলাই ২০২৬ |
| Gemini 3 | 99.5% | জুলাই ২০২৬ |
এগুলো Pangram-এর নিজস্ব সংখ্যা, যা তাদের নিজস্ব টেস্ট সেটে মাপা। তাদের মডেল কার্ড আরও বিস্তারিতভাবে সংখ্যা ভেঙে দেখায়। ২৬টি মডেল থেকে আসা ৫২০,০০০টি ইংরেজি AI-Generated নমুনায় Pangram ০.৩৭% মিস করেছে, যা মূল শিরোনামের সংখ্যার কাছাকাছি। মডেল কার্ডে আরও ১৮টি ভাষা কভার করা একটি multilingual সেটে ১.৯৯% miss rate তালিকাভুক্ত আছে, তাই ইংরেজির বাইরে AI টেক্সট শনাক্তকরণে Pangram কিছুটা কম নির্ভরযোগ্য।
Pangram-এর সর্বশেষ সংখ্যাগুলো
Pangram-এর নির্ভুলতা পৃষ্ঠায় বলা হয়েছে যে এর লক্ষ্য ফলস পজিটিভ হার হলো 0.01%, অর্থাৎ 10,000টির মধ্যে 1টি, এবং এটি ফলস negatives-কে ফলস positives-এর আগে ঘটানোর জন্য মডেলকে টিউন করে। এর একাডেমিক লেখার পরীক্ষায় 62,971টি মানব নথিতে ফলস পজিটিভ হার হলো 0.019%, এবং 48,443টি AI নথিতে ফলস নেগেটিভ হার হলো 0.000%। Pangram আরও বলে, নতুনতম মডেলগুলোর জন্য ছোট বেঞ্চমার্কে ফলস নেগেটিভ হার:
| AI মডেল | Pangram-এর রিপোর্ট করা ভুল-নেতিবাচক হার |
|---|---|
| GPT-6 Astra | 0.41% |
| Claude Fable 5.1 | 0.36% |
| Claude Opus 5.5 | 0.30% |
| Claude Sonnet 5.5 | 0.29% |
Pangram 4.1 মডেল কার্ডে, মডেলভেদে ভুল-নেতিবাচক হার ০.130% থেকে Claude Sonnet 5-এর ক্ষেত্রে এবং Llama 3.3 70B ও Grok 4.3-এর ক্ষেত্রে ০.720% পর্যন্ত ওঠানামা করে। এগুলো Pangram-এর নিজস্ব পরিসংখ্যান, যেগুলো ২০২৬ সালের অক্টোবর মাসে তাদের নিজস্ব পৃষ্ঠাগুলোতে রিপোর্ট করা হয়েছে।
Pangram-এর 2024 রিপোর্টেও Pangram-কে GPTZero, Originality.ai এবং DetectGPT-এর সঙ্গে তাদের নিজস্ব বেঞ্চমার্কে তুলনা করা হয়েছিল, এবং রিপোর্টে যে পেছনে সমস্যাগুলো বর্ণনা করা হয়েছে তার কারণে সেখানে Claude মডেলগুলো বাদ দেওয়া হয়। এরপর থেকে প্রতিদ্বন্দ্বী ডিটেক্টরগুলো পুনরায় প্রশিক্ষিত হয়েছে, তাই ওই ২০২৪ তুলনাগুলো দুই পক্ষের পুরোনো সংস্করণকে প্রতিফলিত করে।
Pangram-এর ভুল-সকারাত্মক হার ডোমেইন ও ভাষাভেদে
Pangram-এর FAQ-এ একটি একক সামগ্রিক false positive rate দেওয়া আছে, যা 10,000টির মধ্যে 1টি। এর মডেল কার্ডগুলোতে আরও নির্দিষ্ট সংখ্যা দেওয়া আছে। Pangram 4.1-এ FineWeb ডেটাসেটের 781,981টি ইংরেজি নথিতে 70টি false positive ছিল, অর্থাৎ 0.0090%, আনুমানিক 11,000টির মধ্যে 1টি। Pangram 4-এ ছিল 1,000,000 নথিতে 41টি, অর্থাৎ 0.0041%, ওই সেটের আগের সংস্করণে, যেখানে Pangram পরে স্প্যাম এবং মেশিন-তৈরি পেজ বাদ দেওয়ার আগে। 104টি ভাষা জুড়ে 1,000,000 নথিতে Pangram 4.1-এ ছিল 33টি false positive, অর্থাৎ 0.0033%।
হারটি ডোমেইন অনুযায়ী বদলায়। Pangram-এর accuracy পৃষ্ঠা এসব ভুল-সকারাত্মক হার তালিকাভুক্ত করে:
| ডোমেইন | মানব নথি | False positive rate |
|---|---|---|
| একাডেমিক লেখা (ইংরেজি) | 62,971 | 0.019% |
| বায়োমেডিক্যাল গবেষণাপত্র | 65,053 | 0.002% |
| নিউজ (বহুভাষিক) | 100,199 | 0.003% |
| কীভাবে করবেন (বহুভাষিক) | 166,194 | 0.016% |
| AWS ডকুমেন্টেশন | 11,652 | 0.017% |
| সৃজনশীল লেখা | 10,495 | 0.000% |
| Amazon রিভিউ (বহুভাষিক) | 10,425 | 0.000% |
| ভাষণ | 1,058 | 0.000% |
| মুভি স্ক্রিপ্ট | 9,989 | 0.010% |
| কবিতা | 12,769 | 0.078% |
| রেসিপি | 22,421 | 0.049% |
ইংরেজি একাডেমিক লেখার ক্ষেত্রে false positive rate হলো 0.019%, অর্থাৎ প্রায় 5,000টি নথির মধ্যে 1টি। এটি Pangram-এর সামগ্রিক সংখ্যার চেয়ে বেশি, এবং শিক্ষার্থী ও গবেষকদের জন্য এটিই সবচেয়ে গুরুত্বপূর্ণ। আনুষ্ঠানিক একাডেমিক গদ্যে নির্দিষ্ট ধাঁচ থাকে, আর ফর্মুলাভিত্তিক লেখা যেখানে Pangram-এর নিজস্ব ডেটা বেশি false positive দেখায়।
false positives নিয়ে Pangram-এর ব্লগ পোস্টে বলা হয়েছে, রেসিপি ও কবিতার মতো ছোট এবং পুরো বাক্য দিয়ে লেখা নয়, এমন বা অত্যন্ত ফর্মুলাভিত্তিক টেক্সটে এ হার বাড়ে। এটি আরও বলে যে প্রবন্ধ, রিভিউ এবং রিপোর্টের মতো দীর্ঘ, মৌলিক লেখায় হার কম থাকে, কারণ এই ধরনের লেখায় মডেলের কাজ করার জন্য বেশি উপাদান থাকে।
ভাষাও হারের পরিবর্তন ঘটায়। Pangram 4.1 আনুষ্ঠানিকভাবে 24টি ভাষা সমর্থন করে। এগুলো হলো ইংরেজি, স্প্যানিশ, ফরাসি, পর্তুগিজ, আরবি, চীনা, জাপানি, কোরিয়ান, রুশ, তুর্কি, হাঙ্গেরিয়ান, জার্মান, ডাচ, সুইডিশ, রোমানিয়ান, ইউক্রেনীয়, পোলিশ, ইতালীয়, চেক, গ্রিক, হিন্দি, ফার্সি, উর্দু এবং ভিয়েতনামি। Pangram 4.1-এর বহুভাষিক টেস্টে ভাষাভেদে false positive rate 0.0000% পর্যন্ত (চীনা, ডাচ, গ্রিক, জাপানি, ফার্সি, রোমানিয়ান, সুইডিশ ও উর্দু) থেকে 0.0157% পর্যন্ত (পর্তুগিজ) ওঠানামা করে। এগুলোর সবই 1,000টির মধ্যে 1টির চেয়েও অনেক কম। Pangram আরও বলে যে তারা ওই তালিকার বাইরের ভাষাতেও কাজ করতে পারে এবং নতুন কোনো ভাষা মূল্যায়নের অনুরোধ গ্রহণ করে।
ইংরেজির বাইরে AI টেক্সট মিস হওয়ার হার বাড়ে। Pangram 4.1-এ 18টি ভাষায় false negative rate হলো 1.99%, যেখানে ইংরেজির জন্য 0.37%। Pangram 4 মডেল কার্ডে মিসগুলো সবচেয়ে বেশি ছিল উর্দুতে (5.32%) এবং ফার্সিতে (3.17%)। মেশিন ট্রান্সলেশন, যার মধ্যে Google Translate-এর আউটপুটও আছে, Pangram-এর মতে এর আওতার বাইরে।
Pangram আরও অন্যান্য ডিটেক্টরের সঙ্গে তুলনামূলক তথ্য প্রকাশ করে। ইউনিভার্সিটি অব শিকাগোর গবেষণাভিত্তিক পণ্য পর্যালোচনায় এটি নিজের জন্য 0.5% false positive rate, Originality.ai-এর জন্য 1.7% এবং GPTZero-এর জন্য 2.4% রিপোর্ট করে। এগুলো Pangram-এর নিজস্ব সাইট থেকে নেওয়া সংখ্যা।
সংক্ষিপ্ত লেখা
Pangram ৫০ শব্দ বা তার বেশি গদ্যের জন্য নকশা করা হয়েছে, এবং টেক্সট যত ছোট হয় ফলস নেগেটিভ হার তত বাড়ে। Pangram 4.1-এর ড্যাশবোর্ডে ১৫০ শব্দের কম টেক্সটের ক্ষেত্রেও কম নিশ্চিততার ইঙ্গিত দেখায়। Pangram-এর নির্ভুলতা পেজে দৈর্ঘ্যভেদে এই পরিসংখ্যানগুলো দেওয়া আছে।
| দৈর্ঘ্য | False positive rate | False negative rate |
|---|---|---|
| ৫০ থেকে ৯৯ শব্দ | 0.02% | 1.29% |
| ১০০ থেকে ২৪৯ শব্দ | 0.009% | 0.41% |
| ২৫০ থেকে ৪৯৯ শব্দ | 0.004% | 0.21% |
বেশিরভাগ সংক্ষিপ্ত-টেক্সট ত্রুটি আসলে false negative, অর্থাৎ “মানুষের লেখা” হিসেবে শনাক্ত করতে না পারা। Pangram এই দিকেই টিউন করে, তাই একটি ছোট অনুচ্ছেদ যা human বলে স্কোর করে, সেটি সাধারণত একটি বড় টেক্সটের তুলনায় কম নিশ্চিততার ইঙ্গিত দেয়।
শিকাগো পেপারটি ৫০ শব্দের কম এমন কিছু অংশ পরীক্ষা করেছে, যা Pangram-এর নিজের ঘোষিত সীমার বাইরে। সেখানে রেস্তোরাঁ রিভিউগুলিতে Pangram-এর ফলস পজিটিভ হার ছিল বেশিরভাগ সময় শূন্য এবং সর্বোচ্চ ২.৫%। ডিটেক্টর তবুও প্রতিটি ছোট টুকরো (ছোট অংশ) স্কোর করেছে, এবং এর AUROC ছিল 0.963 থেকে 1.000-এর মধ্যে। Originality.ai কিছু stub-কে দৈর্ঘ্য ফিল্টার ত্রুটির কারণে প্রত্যাখ্যান করেছিল, তাই লেখকেরা ওই টেস্টে সেটিকে স্কোর করতে পারেননি।
একজন গবেষকের জন্য ব্যবহারিক বিষয় হলো একটি সারসংক্ষেপ (abstract) বা এক প্যারাগ্রাফের উত্তর Pangram-এর নিম্ন সীমার খুব কাছাকাছি। মডেল কার্ডেও রেফারেন্স সেকশন, টেবিল অব কনটেন্টস, কোড এবং বেশি কোড ও গণিতনির্ভর টেক্সটকে এর মূল পরিধির বাইরে বা বেশি ত্রুটিপ্রবণ বলে তালিকাভুক্ত করা হয়েছে। হাতে কপি করা রেফারেন্স তালিকা একটি দুর্বল পরীক্ষা।
যেসব লেখকের ইংরেজি স্থানীয় নয়
যারা ইংরেজি দ্বিতীয় ভাষা হিসেবে শিখেছেন, তাদের ক্ষেত্রে আগের প্রমাণ আসে অন্যান্য ডিটেক্টর থেকে। Liang প্রমুখ, ২০২৩ সালে Patterns জার্নালে লিখে দেখিয়েছেন যে সাতটি ডিটেক্টর AI হিসেবে প্রায় ৬১% প্রবন্ধকে চিহ্নিত করেছিল, যা ইংরেজি-অভিযোজিত নয় এমন বক্তাদের লেখা। Pangram-এর ২০২৪ রিপোর্টে একই TOEFL-এর ৯১টি প্রবন্ধ পরীক্ষা করা হয় এবং কোনো false positive পাওয়া যায়নি, এবং ৮ম থেকে ১২ম শ্রেণির শিক্ষার্থীদের লেখা ৩,৯০৭টি ELLIPSE প্রবন্ধেও কোনোটি পাওয়া যায়নি। এদিকে এশিয়ার বিশ্ববিদ্যালয়ের স্নাতক পর্যায়ের শিক্ষার্থীদের ৫,৬০০টি ICNALE প্রবন্ধে হার ছিল ০.০৯%। এগুলো Pangram-এর পরীক্ষা, এবং রিপোর্টে বলা হয়েছে TOEFL প্রবন্ধগুলো ট্রেনিং থেকে আলাদা করে রাখা হয়েছিল।
Pangram-এর নতুনতম পরীক্ষা আরও বড়। ২০২৬ সালের অক্টোবর মাসে এটি ইংরেজি অতিরিক্ত ভাষা হিসেবে ব্যবহার করেন এমন স্নাতক এবং স্নাতকোত্তর শিক্ষার্থীদের লেখা ১৫,৪২০টি প্রবন্ধ ও গবেষণাপত্র স্ক্যান করে। এগুলো নয়টি গবেষণা কর্পাস থেকে নেওয়া হয়, যেগুলো ১৬টি দেশের বিশ্ববিদ্যালয়গুলিতে সংগ্রহ করা হয়েছে, এবং লেখকদের ৫১টি ভিন্ন প্রথম ভাষা ছিল। Pangram 4.1 এদের কোনোওটাকেই ফ্ল্যাগ করেনি, এবং একই সেটে Pangram 4-ও কোনো false positive দেয়নি। টেক্সটগুলোর দৈর্ঘ্য ছিল ৫২ থেকে ১০,৯১৬ শব্দের মধ্যে। এতে কানাডার বিশ্ববিদ্যালয়ে অধ্যয়নরত স্নাতক শিক্ষার্থীদের সাহিত্য পর্যালোচনা এবং ইউনিভার্সিটি অব মিশিগানের শিক্ষার্থীদের A-গ্রেডেড পেপারও অন্তর্ভুক্ত রয়েছে।
Pangram আরও জানায় যে PERSUADE কর্পাসের ২৫,৯৯৬টি স্কুল প্রবন্ধে এটি শূন্য false positive পেয়েছে। এই কর্পাসে লেখকদের প্রতিবন্ধকতার অবস্থা, জাতিগত পরিচয়, অর্থনৈতিক পটভূমি এবং ইংরেজি শিক্ষার্থী হিসেবে অবস্থা নথিভুক্ত থাকে। ১৪৩,৭৫৫টি নথির ওপর করা একটি পৃথক গবেষণায়, যার মধ্যে ৮৫,৮৮৭টি ছিল অটিস্টিক লেখকদের লেখা, Pangram 4-এর জন্য ২০২২ সালের আগে লেখা ৮৯,৯০৩টি নথিতে false positive rate ছিল ০.০০১১%। Pangram বলে যে এই স্টাডিটি স্বাধীনভাবে করা হয়েছিল।
শিকাগো কর্পাসে একাডেমিক বা স্থানীয় নয় এমন লেখকদের কোনো আলাদা শ্রেণি নেই, তাই এই গোষ্ঠীর ক্ষেত্রে Pangram-এর নিজস্ব পরীক্ষাই প্রধান প্রমাণ। আমাদের পোস্ট কেন AI ডিটেক্টর অ-স্থানীয় লেখকদের চিহ্নিত করে (ভুল পজিটিভ) আগের ডিটেক্টরগুলোর ব্যর্থতার পেছনের প্রক্রিয়া ব্যাখ্যা করে।
স্বাধীন পরীক্ষায় ProofreaderPro AI ডিটেকশন কতটা নির্ভুল?
শিকাগো বিশ্ববিদ্যালয়ের কর্মপত্রে, Pangram মাঝারি এবং দীর্ঘ অংশে কার্যত কোনো false positive এবং false negative দেয়নি। চারটি ডিটেক্টরের মধ্যে একমাত্র সেটি নির্ভুলতা হারানো ছাড়াই কঠোর 0.5% false positive সীমা পূরণ করতে পেরেছিল।
প্রবন্ধটি, একটি 2025 University of Chicago Booth গবেষণা, জানিয়েছে যে শীর্ষস্থানীয় AI ডিটেক্টরগুলো সম্পাদনা ছাড়া AI টেক্সটের 90% এরও বেশি অংশকে শনাক্ত করেছিল। এগুলোর বেশিরভাগই টেক্সটটি AI humanizer-এর মধ্য দিয়ে গেলে অর্ধেকেরও কম ক্ষেত্রে শনাক্ত করতে পেরেছে। Pangram দাবি করে, false positive হার 0.5% এর নিচে রেখেও এটি AI টেক্সট শনাক্ত করতে সক্ষম একমাত্র।
ব্রায়ান জাবারিয়ান এবং অ্যালেক্স ইমাস 1,992টি মানুষের লেখা অংশে Pangram, Originality.ai, GPTZero এবং RoBERTa নামে একটি ওপেন সোর্স ডিটেক্টর পরীক্ষা করেন। তারা প্রতিটি অংশের সঙ্গে GPT-4.1, Claude Opus 4, Claude Sonnet 4 এবং Gemini 2.0 Flash থেকে তৈরি AI টেক্সট মিলিয়ে দেখেন।
ধরণগুলো ছিল সংবাদ, ব্লগ, Amazon রিভিউ, রেস্টুরেন্ট রিভিউ, উপন্যাসের অংশ এবং রেজিউমের অংশ। উপন্যাস এবং রেজিউমকে দীর্ঘ ধরা হয়েছে, সংবাদ ও ব্লগকে মাঝারি, এবং রিভিউগুলোকে স্বল্প। প্রবন্ধটিতে একাডেমিক লেখালেখি অন্তর্ভুক্ত ছিল না।
প্রতিটি ডিটেক্টরের সেরা threshold-এ, যা সবার জন্য একইভাবে বেছে নেওয়া হয়েছিল, ফলাফল ধরণ ও মডেলভেদে এভাবে পরিসর দেখিয়েছে।
| পরিমাপ | Pangram | Originality.ai | GPTZero |
|---|---|---|---|
| মানব টেক্সটে false positives | 0% থেকে 0.75% | 0% থেকে 2.18% | 0% থেকে 2.38% |
| AI টেক্সট মিস করা, সম্পাদনা ছাড়া | 0% থেকে 2% | 0% থেকে 4.5% | 0% থেকে 7% |
| StealthGPT-এর পর AI টেক্সট মিস করা | 0% থেকে 5% | 2.3% থেকে 20.7% | 25.5% থেকে 77.3% |
| 50 শব্দের কম অংশ (AUROC) | 0.963 থেকে 1.000 | স্কোর করা হয়নি | 0.778 থেকে 1.000 |
তিনটি ডিটেক্টরই তাদের সবচেয়ে বেশি false positives করেছে স্বল্প রিভিউতে। রেস্টুরেন্ট রিভিউতে Pangram-এর সর্বোচ্চ false positive হার ছিল 0.75%। Amazon রিভিউতে GPTZero-এর ছিল 2.38%, এবং রেস্টুরেন্ট রিভিউতে Originality.ai-এর ছিল 2.18%।
সম্পাদনা ছাড়া AI টেক্সটে Pangram এবং দুইটি বাণিজ্যিক প্রতিদ্বন্দ্বীর মধ্যে ব্যবধান খুব বেশি নয়। বিশেষ করে GPTZero খুব কম দীর্ঘ AI টেক্সট মিস করেছে, এবং প্রবন্ধটি বলে যে সব threshold মিলিয়ে সামগ্রিক false positive হার প্রায় 0.7%। বড় পার্থক্যগুলো দেখা যায় স্বল্প অংশে এবং AI humanizer করা টেক্সটে।
প্রবন্ধটির ব্যয় তুলনা একটি পার্শ্ব ফলাফল। এটি ঠিকভাবে শনাক্ত করা AI অংশপ্রতি ফি হিসাব করে দেখেছে, এবং Pangram-এর ফল ছিল প্রায় US$0.023, যেখানে Originality.ai-এর জন্য US$0.042 এবং GPTZero-এর জন্য US$0.057। হাজার হাজার স্ক্যান চালানো প্রতিষ্ঠানগুলোর ক্ষেত্রে বিষয়টি গুরুত্বপূর্ণ, একক কোনো লেখকের জন্য নয়।
শিকাগো প্রবন্ধটি যা আপনাকে জানাতে পারে না
তিনটি সীমাবদ্ধতা প্রযোজ্য, এবং লেখকেরা নিজেরাই প্রথমটি উল্লেখ করেছেন। AI মডেলগুলো ছিল মধ্য-2025-এর রিলিজ, এবং লেখকেরা লিখেছেন যে ডিটেক্টর, ভাষা মডেল এবং humanizerগুলোতে পরিবর্তন চলতে থাকায় ফলাফল একই থাকবে বলে তারা আশা করেন না। ডিটেক্টর ভার্সন ছিল Pangram-এর মে 2025-এর API, যেটি Pangram বলেছে ছিল Pangram 3।
দ্বিতীয় সীমা হল মানব নমুনা। প্রায় ২,০০০টি অনুচ্ছেদ দেখাতে পারে যে একটি ডিটেক্টর খুব ভালো, তবে এগুলো ১০,০০০ এর মধ্যে ১টি (১ in 10,000) ভুল ধরা এবং ১,০০০ এর মধ্যে ১টি (১ in 1,000) ভুল ধরার মধ্যে পার্থক্য আলাদা করে দেখাতে পারে না। Pangram-এর নিজস্ব বড় আকারের পরিসংখ্যান এই ফাঁকটি পূরণ করে, এবং সেগুলো আসে বিক্রেতা প্রতিষ্ঠান থেকে।
তৃতীয়টি হল টেক্সটের ধরন। একটি জার্নাল আর্টিকেল, থিসিসের একটি অধ্যায় বা একটি মেথডস বিভাগ সংবাদ প্রতিবেদন বা কোনো উপন্যাসের অংশ থেকে আলাদা। সেক্ষেত্রে, Pangram-এর নিজস্ব একাডেমিক লেখার ফিগার ০.০১৯% সবচেয়ে নিকটতম নির্দেশনা।
Pangram-এর নতুন স্বাধীন পরীক্ষার আহ্বান
Pangram বলছে, Chicago-এর অধ্যয়নটি এখনও তাদের সবচেয়ে বড় তৃতীয় পক্ষের মূল্যায়ন, এবং এটি Pangram 3-এর উপর এক বছরের বেশি আগে চালানো হয়েছিল। ৬ নভেম্বর, ২০২৬ তারিখে Pangram গবেষকদের নতুন স্বাধীন পরীক্ষার অনুরোধ জানায়। এটি কোন কোন প্রশ্নের উত্তর চায়, যেমন নতুনতম AI মডেলগুলো ডিটেক্টর কীভাবে সামলায়, মানুষ এবং AI-এর মিশ্র লেখালেখি, অন্য ভাষা এবং টেকনিক্যাল রাইটিং। এটি প্রকাশনার কোনো শর্ত ছাড়াই ক্রেডিট গ্রান্ট দেয়, তাই গবেষকরা Pangram-এর পক্ষপাত থাকুক বা না থাকুক, তাদের ফলাফল প্রকাশ করতে পারেন।
Pangram-এর ৪.১ মডেল কার্ডেও Van Vassalaer এবং সহকর্মীদের ২০২৬ সালের একটি গবেষণার কথা রয়েছে। ৩৯টি সম্পূর্ণ AI-Generated ডকুমেন্টের তাদের পাবলিক সাবসেটে Pangram ৪.১ কোনওটিই মিস করেনি।
Vrije Universiteit Brussel-এর গবেষণা
Pangram আরও ২০২৬ সালের জুন মাসের Vrije Universiteit Brussel-এর একটি অধ্যয়নের কথা উল্লেখ করে। তারা ১৬০টি একাডেমিক পেপার (ইংরেজি মাতৃভাষা নয় এমন লেখক) উপর Pangram, GPTZero, Turnitin এবং Copyleaks পরীক্ষা করে। পেপারগুলোকে ভাগ করা হয়েছিল মানব-লেখা, AI-Generated, হাইব্রিড এবং humanized টেক্সটে। Pangram বলছে, ওই গবেষণায় চারটি টুলই মানুষ-লেখা পেপারগুলোকে কেউই ফ্ল্যাগ করেনি।
RAID বেঞ্চমার্ক
RAID হলো Liam Dugan এবং সহকর্মীরা ACL ২০২৪-এ যে বেঞ্চমার্কটি উপস্থাপন করেন, এবং Pangram-এর ফল আসে তার পরের ফলো-আপ শেয়ার্ড টাস্ক থেকে, যেখানে তাদের টেস্ট সেট ব্যবহার করা হয়েছিল। ১৫ জানুয়ারি, ২০২৫ তারিখে পোস্ট করা শেয়ার্ড টাস্কের সারাংশ নির্দিষ্ট ৫% ফলস পজিটিভ rate-এ AI টেক্সট ধরা পড়ার ভাগের ভিত্তিতে ডিটেক্টরগুলোর র্যাঙ্কিং দেখায়। Pangram ৯৯.৩% স্কোর করেছে, যেখানে প্রতিকূল আক্রমণ ছিল না, এবং এটি Leidos এন্ট্রির (৯৯.৪%) পরে দ্বিতীয়। প্রতিকূল আক্রমণ থাকলে তাদের স্কোর ছিল ৯৭.৭%, যা Leidos-এর সাথে শীর্ষ স্কোরে সমান।
এটি কীভাবে পড়তে হবে, তার দুটি বিশদ বদলে দেয়। প্রথমত, ৫% false positive rate হলো এমন একটি বেঞ্চমার্ক সেটিং, যা একই স্কেলে ডিটেক্টর তুলনা করতে সাহায্য করে। কোনো স্কুল ২০ জন সৎ শিক্ষার্থীর মধ্যে ১ জনকে ফ্ল্যাগ করা গ্রহণ করবে না। দ্বিতীয়ত, ওই ফলাফল দেখায় যে ওই সেটিংয়ে একটি ডিটেক্টর কত ভালোভাবে AI-কে মানুষের টেক্সট থেকে আলাদা করে। বিক্রেতার ডিফল্ট থ্রেশহোল্ডে একজন ব্যবহারকারী যে false positive rate দেখেন, সেটি আরেকটি সংখ্যা। একই টেবিলে Binoculars গবেষণার বেসলাইন দেখানো হয়েছে ৭৯.০% এবং ৭১.৩%।
Pangram-এর জন্য RAID ফলাফল একটি নির্দিষ্ট সংকীর্ণ দাবিকে সমর্থন করে। তার ক্লাসিফায়ার আক্রমণের মধ্যেও খুব নির্ভরযোগ্যভাবে AI টেক্সটকে মানুষের টেক্সটের ওপরে র্যাঙ্ক করে।
AI-চিহ্নিত অংশটি আপনার নিজের ভঙ্গিতে লিখে নিন
আমাদের academic humanizer উদ্ধৃতি, প্রযুক্তিগত শব্দ এবং সংখ্যা ঠিক যেমন আপনি লিখেছেন তেমনই রেখে AI-assisted সেকশনগুলো পুনর্লিখন করে।
ProofreaderPro.ai ফ্রি চেষ্টা করুন২০২৫ সালের একটি গবেষণা: বিশেষজ্ঞ মানব পাঠকদের বিরুদ্ধে Pangram
Jenna Russell, Marzena Karpinska এবং Mohit Iyyer-এর ২০২৫ সালের একটি প্রবন্ধ ACL ২০২৫-এ প্রকাশিত হয়। তারা পরীক্ষা করে দেখেছিল, যারা প্রায়ই AI লেখার টুল ব্যবহার করেন তারা AI-Generated টেক্সট কতটা ভালোভাবে শনাক্ত করতে পারেন, যা স্বয়ংক্রিয় ডিটেক্টরগুলোর সমান কি না। পাঁচজন এনোটেটর, যারা বলেছেন তারা নিজেদের লেখার জন্য প্রায়ই LLM ব্যবহার করেন, তারা ৩০০টি নন-ফিকশন ইংরেজি আর্টিকেল পড়েন। সেটিতে মানুষ-লেখা টেক্সট মেশানো ছিল, সাথে GPT-4o, Claude এবং o1-Pro থেকে নেওয়া টেক্সট, এবং কিছু আর্টিকেল humanizer দিয়ে চালানো ছিল। এই পাঁচজন এনোটেটরের সংখ্যাগরিষ্ঠ মতামত ৩০০টি আর্টিকেলের মধ্যে মাত্র ১টি ভুলভাবে শ্রেণিবদ্ধ করেছে।
পত্রিকাটি ওই প্যানেলটি পাঁচটি স্বয়ংক্রিয় ডিটেক্টরের সঙ্গে তুলনা করেছে: Pangram, GPTZero, Binoculars, Fast-DetectGPT এবং RADAR। গবেষকেরা Pangram-এর দুটি মডেল চালান: তার বেস ডিটেক্টর এবং Pangram Humanizers নামে একটি পৃথক মডেল, যা এমন টেক্সট সনাক্ত করতে প্রশিক্ষিত যেগুলো AI humanizer-এর মধ্য দিয়ে চালানো হয়েছে। Pangram Humanizers-ই একমাত্র ডিটেক্টর ছিল যা বিশেষজ্ঞ প্যানেলের সঙ্গে মিলে যায়। পরীক্ষার সেটজুড়ে গড় true positive হার ছিল 99.3% এবং false positive হার ছিল 2.7%। একই পরীক্ষায় Pangram-এর বেস মডেল গড়ে 98.0% true positive হার এবং 2% false positive হার অর্জন করে।
2.7% false positive হার, Pangram যে 10,000-এর মধ্যে 1 অর্থাৎ 1 in 10,000 সংখ্যাটি তাদের নিজস্ব মূল্যায়ন থেকে বলে, তার চেয়ে বেশি। এই পরীক্ষা Pangram যে অন্যত্র কোটি কোটি নিবন্ধ উদ্ধৃত করে তার তুলনায় অনেক ছোট একটি সেট ব্যবহার করেছে। সেখানে ছিল 300টি নিবন্ধ, যেখানে Pangram দাবি করে অন্যত্র মিলিয়নগুলোর কথা। পত্রিকাটি Pangram-কে শুধু তাদের Human এবং AI-Generated লেবেল দিয়ে স্কোর করেছে, এবং তাদের নিরপেক্ষ "Possibly AI" লেবেলের জন্য কোনো ক্রেডিট দেয়নি। Pangram এবং GPTZero উভয়ই গবেষকদের টেস্ট চালানোর জন্য API credits দিয়েছে।
humanized subset-এ ডিটেক্টরগুলোর পার্থক্য স্পষ্ট হয়। o1-Pro টেক্সটকে মানবিক করার প্রম্পটের মধ্য দিয়ে চালালে Pangram 90.0% নিবন্ধ শনাক্ত করেছে, এবং false positive হার ছিল 6.7%। humanizer-aware ভ্যারিয়েন্টটি 96.7% শনাক্ত করেছে, কিন্তু false positive হার ছিল 10%। ওই subset-এ GPTZero শনাক্ত করেছে 46.7%, এবং false positive হার ছিল 3.3%। তবে তাদের সামগ্রিক হার ছিল মাত্র 0.7%। প্রতিটি শর্তে ছিল 30টি Human এবং 30টি AI নিবন্ধ। ফলে প্রতি একটি নিবন্ধের মান 3.3 শতাংশ পয়েন্ট, এবং false positive হারগুলো ওঠানামা করতে পারে। এই গবেষণায় আরও কেবল 1,000 শব্দের কম দৈর্ঘ্যের আমেরিকান ইংরেজি নন-ফিকশনই অন্তর্ভুক্ত করা হয়েছে।
Humanized এবং সম্পাদিত টেক্সট
StealthGPT AI humanizer-এর মধ্য দিয়ে চালানো টেক্সটে Chicago পরীক্ষায় Pangram AI প্যাসেজের 0% থেকে 5% পর্যন্ত মিস করেছে, এবং GPTZero মিস করেছে 25.5% থেকে 77.3% পর্যন্ত। লেখকেরা StealthGPT-এর ডিফল্ট rewrite endpoint দিয়ে প্রতিটি AI প্যাসেজ চালান এবং পরে সেটিকে আবার স্কোর করেন। তারা বলেন, ওই rewrite-এর পর GPTZero প্রায় পুরোপুরি AI টেক্সট শনাক্ত করার সক্ষমতা হারিয়ে ফেলে। অধিকাংশ ক্ষেত্রে miss rate ছিল প্রায় 50% বা তারও বেশি। Originality.ai-ও আংশিকভাবে প্রভাবিত হয়, যেখানে ছোট টেক্সটে মিস প্রায় 21% পর্যন্ত পৌঁছায়।
একই পত্রিকায় unedited টেক্সটের ক্ষেত্রে GPTZero-এর নিজস্ব ফলও শক্তিশালী ছিল, তাই এই পতনটি কেবল ইনপুটের একটি নির্দিষ্ট ধরনে প্রযোজ্য। গবেষণায় একটিমাত্র AI humanizer, একটিমাত্র ডিফল্ট সেটিং এবং প্রতিটি টুলের ২০২৫ সালের মধ্যভাগের সংস্করণ পরীক্ষা করা হয়েছে। আমাদের পোস্ট AI humanizers কাজ করে কি না বড় গবেষণাগুলো কী বলে তা কভার করে।
হালকা সম্পাদনা এবং ভারী সম্পাদনা
Pangram-এর নির্ভুলতা পেজে এমন টেক্সটের ফল দেখানো হয়, যেগুলো শুরুতে মানুষের লেখা ছিল এবং AI দিয়ে সম্পাদনা করা হয়েছে।
| সম্পাদনার ধরন | ডকুমেন্ট | লেবেলকৃত Human | লেবেলকৃত মিশ্র | লেবেলকৃত AI |
|---|---|---|---|---|
| Proofreading বা polishing | 11,363 | 99.45% | 0.54% | 0.0088% |
| বড় মাত্রার AI সম্পাদনা | 14,990 | 41.37% | 55.01% | 3.62% |
| WildChat-উৎপন্ন সম্পাদনা | 4,826 | 27.85% | 65.17% | 6.98% |
Pangram-এর মতে, হালকা proofreading সাধারণত Human লেবেলই রাখে, কিন্তু প্রস্তাবিত বাক্য পরিবর্তনগুলো সাধারণত "AI-Assisted" অর্জন করে এবং বড় ধরনের rewrite "AI-Generated" অর্জন করতে পারে। Pangram আরও বলে যে টেক্সট যদি মিশ্র হয়, তাহলে মডেলটি সেটিকে Human হিসেবে লেবেল দেওয়ার সম্ভাবনা বেশি। মাঝের সারির 41.37% সংখ্যাটিও দেখায় যে বড় মাত্রার AI edits প্রায়ই মিস হয়ে যায়, যা Pangram-এর নিজস্ব সংজ্ঞা অনুযায়ী একটি false negative।
Pangram কি কোনো humanizer আছে?
না। Pangram কেবল শনাক্তকরণ বিক্রি করে, এবং এটি এমন কোনো টুল দেয় না যা টেক্সট rewrite করে। তার ডিটেক্টর humanized টেক্সট খোঁজে। প্রতিটি সেগমেন্টের জন্য Pangram 4.1 আউটপুটে থাকে একটি humanizer score এবং একটি ফ্ল্যাগ যে সেগমেন্টটি humanized দেখায় কি না। Pangram-এর হোমপেজে বলা আছে, humanizer-এর মধ্য দিয়ে চালানোর পর এটি AI-generated টেক্সট শনাক্ত করতে পারে।
ওই দাবির বাইরে প্রমাণ হলো ওপরের দুটি গবেষণা। শিকাগো পেপারে StealthGPT সেগুলো নতুন করে লেখার পর Pangram AI-লেখা অনুচ্ছেদগুলোর 0% থেকে 5% পর্যন্ত মিস করেছে। মেরিল্যান্ড গবেষণায় মানবিকরণ করা টেক্সটে ট্রেন করা একটি Pangram মডেল বিশেষজ্ঞ মানব পাঠকদের একটি প্যানেলের সাথে মিলিয়েছে। উভয় পরীক্ষাই ২০২৫ সালের মাঝামাঝি সংস্করণের টুল ব্যবহার করেছে, এবং AI humanizer-রা যতবার detector বদলায়, ততবারই বদলায়।
Pangram কীভাবে AI লেখা শনাক্ত করে
Pangram বলে এটি perplexity বা burstiness ব্যবহার করে না, যেসব সংকেতের ওপর পুরনো অনেক AI detector ভর করে। Perplexity হলো একটি ভাষা মডেলের কাছে প্রতিটি শব্দ কতটা পূর্বানুমেয় তা মাপা, এবং burstiness মাপে একটি নথির মধ্যে সেই পূর্বানুমেয়তা কতটা বদলায়। আমাদের নিজস্ব পোস্টে AI সনাক্তকরণে perplexity সম্পর্কে আমরা দুটিই ব্যাখ্যা করেছি।
Pangram যুক্তি দেয় যে perplexity-ভিত্তিক detectorগুলো যেকোনো সেই টেক্সটে ভুল করে যেখানে প্রশিক্ষণের সময় কোনো ভাষা মডেল আগে থেকেই মুখস্থ করে ফেলেছে। এর মধ্যে আছে স্বাধীনতার ঘোষণাপত্র এবং উইকিপিডিয়ার বড় অংশ। মডেলগুলো মুখস্থ করা টেক্সট ভবিষ্যদ্বাণী করতে শিখে খুব কম perplexity দিয়ে, লেখক কে ছিল তা নির্বিশেষে। Pangram আরও বলে, perplexity-ভিত্তিক পদ্ধতিগুলো অ-মাতৃভাষার ইংরেজি লেখার ক্ষেত্রে ভুল শনাক্তের হার বেশি রাখে, কারণ সহজ বাক্য কাঠামোও বেশি পূর্বানুমেয়। অ-মাতৃভাষার ইংরেজি লেখকদের জন্য এই একই ভুল-ধনাত্মক ধরন আমরা অন্য detector নিয়ে লেখা একটি পোস্টে কভার করেছি।
তার বদলে, Pangram বড় পরিসরের মানব ও AI টেক্সটের ওপর সরাসরি একটি ডিপ লার্নিং মডেল ট্রেন করে। তারা এটি যে পদ্ধতি বলে hard negative mining, তার মাধ্যমে এমন মানব লেখা খুঁজে নেয় যেটা AI আউটপুটের সাথে অদ্ভুতভাবে মিলে যায়। Pangram পুরো ডকুমেন্ট টোকেন-স্তরে প্রক্রিয়া করে। প্রতিটি সেগমেন্টকে Human, AI-Assisted বা AI-Generated হিসেবে লেবেল দেয় এবং সেগমেন্টটি কতটা AI-লেখার মতো দেখায় তার জন্য একটি ধারাবাহিক স্কোর দেয়। Pangram বলে, আরও বেশি ডেটায় ট্রেনিং হওয়ার সাথে সাথে মডেলটি উন্নত হয়।
একটি Pangram ফল মানে কী
Pangram শতাংশ হলো ডকুমেন্টের সেই অংশের অনুপাত যা AI-generated বা AI-assisted বলে মনে হয়। Pangram-এর ব্যাখ্যামূলক পেজ, তারিখ ১৭ মার্চ ২০২৬, বলছে ১০ পাতার একটি পেপারে ৩০% স্কোর থাকলে প্রায় তিন পাতা এমন প্যাটার্ন দেখায় যা সাধারণত AI-এর মতো। এই স্কোর তৈরি হয় ডকুমেন্ট জুড়ে সেগমেন্ট-ওয়াইজ পূর্বাভাস থেকে।
Pangram তিনটি লেবেল ব্যবহার করে। Human হলো মানুষের লেখা টেক্সট। AI-Assisted হলো এমন মানব লেখা যা AI দিয়ে সম্পাদিত। AI-Generated হলো এমন টেক্সট যা একটি AI মডেল তৈরি করেছে। প্রতিটি সেগমেন্ট আরও পায় High, Medium বা Low নামে একটি confidence লেভেল, এবং মডেল কার্ড বলে এই লেভেলটি ক্যালিব্রেটেড সম্ভাবনা নয়। Pangram 4.1 প্রতিটি লেবেলের জন্য ক্লাস প্রোবাবিলিটি যোগ করে, যা দেখায় প্রতিটি লেবেল নিয়ে মডেলটি কতটা নিশ্চিত।
Pangram-এর ব্যাখ্যায় এমন ডকুমেন্টের উদাহরণ আছে যেগুলো হাইব্রিড। এর মধ্যে আছে Grammarly ব্যবহার করা, কোনো ভাষা মডেলকে দিয়ে একটি প্যারাগ্রাফ আরও মসৃণ করতে বলা, এবং মাতৃভাষা থেকে ইংরেজিতে অনুবাদ করা। এতে বলা হয় ২০% এর নিচের স্কোর অনেক সময় স্বাভাবিক ডিজিটাল লেখালেখির সহায়তা নির্দেশ করে, আর ৬০% এর উপরের স্কোর প্রায়ই এমন সীমা যেখানে স্বচ্ছতা বিষয়ে কথোপকথন প্রয়োজন হতে পারে। এছাড়া এটি বলে যে কোনো সর্বজনীন সংখ্যাই পদক্ষেপ নিতে বাধ্য করে না, এবং একজন রিভিউয়ারকে প্রতিষ্ঠানের নিজস্ব AI নীতির সাথে মিল রেখে একটি থ্রেশহোল্ড ঠিক করা উচিত।
Pangram-এর নিজস্ব বর্ণনা অনুযায়ী, একটি পালিশ করা ড্রাফটে AI-Assisted লেবেল থাকা একটি প্রত্যাশিত আউটপুট। এটি বলে টেক্সটটি কীভাবে সম্পাদনা করা হয়েছে, এবং অসদাচরণ নিয়ে কিছু বলে না।
Pangram বনাম GPTZero, Copyleaks এবং Turnitin
Pangram, GPTZero এবং Copyleaks সবার জন্য উন্মুক্ত, যারা সাইন আপ করে। Turnitin কেবল স্কুল বা প্রকাশকের অ্যাকাউন্টের মাধ্যমে কাজ করে, এবং একজন ব্যক্তি পরীক্ষার্থী সাধারণত কেবল তখনই Turnitin স্কোর দেখে যখন কোনো শিক্ষক সেটা ফরওয়ার্ড করেন।
| Detector | Access | বিক্রেতার নিজস্ব ভুল-ধনাত্মক দাবী | Free plan |
|---|---|---|---|
| Pangram | Open signup | মোটের মধ্যে আনুমানিক ১ জনের মধ্যে ১০,০০০ | প্রতিদিন ২০টি চেক |
| GPTZero | Open signup | আনুমানিক ১% | প্রতি স্ক্যানে ১০,০০০ অক্ষর |
| Copyleaks | সহজে ওপেন সাইনআপ | প্রায় ০.২% | সীমিত ফ্রি স্ক্যান |
| Turnitin | শুধু স্কুল এবং প্রকাশকরা | একাডেমিক লেখায় ০.৫১% | ব্যক্তিদের জন্য উপলব্ধ নয় |
আমরা প্রতিটি ডিটেক্টর আলাদাভাবে কভার করেছি: দেখুন GPTZero কি সঠিক? স্বাধীন পরীক্ষাগুলো কী দেখায় (2026), Copyleaks AI Detector এবং ২০২৬ সালে Turnitin কি মানবিকৃত (humanized) AI লেখা শনাক্ত করতে পারে?। টেবিলের ভুল-ধরা (false positive) পরিসংখ্যানগুলো প্রতিটি কোম্পানির নিজস্ব দাবি, যেমন Pangram এবং অন্য বিক্রেতারাও তা জানিয়েছে।
একই গবেষণাগুলিতে Pangram কীভাবে তুলনায় এসেছে
সংক্ষিপ্ত টেক্সট এবং humanized টেক্সটে Chicago পেপারে Pangram এগিয়ে ছিল, আর দুইটি বাণিজ্যিক প্রতিদ্বন্দ্বী কাছাকাছি ছিল। Russell পেপারে humanized অংশে Pangram এগিয়ে ছিল। RAID শেয়ার্ড টাস্কে এটি দ্বিতীয় ছিল এবং পরে প্রথমের সঙ্গে সমানতায় (tie) যায়। Winston AI এবং Sapling ওই গবেষণাগুলোর মধ্যে ছিল না, এবং Winston AI Detector ও Sapling-এর AI ডিটেক্টর কতটা নির্ভুল? বিষয়ক আমাদের পোস্টগুলো সেগুলো কভার করে।
এই সব ডিটেক্টর মূলত ইংরেজি গদ্যভিত্তিকভাবে মূল্যায়িত হয়েছে, এবং নির্দিষ্ট কোনো নথি কে লিখেছে তা নিশ্চিতভাবে প্রমাণ করতে এদের কারওই ক্ষমতা নেই। Pangram-এর ব্যাখ্যাতেও তার নিজস্ব স্কোর সম্পর্কে একই কথা বলা আছে, এবং প্রতিটি ডিটেক্টরের ক্ষেত্রে সেটাই সঠিক মানদণ্ড।
Pangram বনাম Grammarly-এর AI detector
Grammarly-এর AI detector হলো Grammarly-এর লেখার স্যুটের ভেতরে একটি ফ্রি স্ক্যানার, আর Grammarly Pro, প্রতি মাসে US$12, একটি AI Detector এজেন্ট যোগ করে যা অনুচ্ছেদ চিহ্নিত করে এবং পুনর্লিখনের প্রস্তাব দেয়। Grammarly বলছে, RAID বেঞ্চমার্কে তার ডিটেক্টর মানের দিক থেকে প্রথম। Pangram হলো একটি স্ট্যান্ডঅ্যালোন ডিটেক্টর, যার Similarity Checker, LMS ইন্টিগ্রেশন এবং একটি API আছে, তাই এটি বহু নথি স্ক্যান করে এমন শিক্ষক এবং প্রতিষ্ঠানগুলোর জন্য উপযোগী। Grammarly-এর ডিটেক্টর সেই লেখকের জন্য, যিনি ইতিমধ্যে ব্যাকরণ যাচাইয়ের জন্য Grammarly ব্যবহার করেন এবং একই জায়গায় দ্রুত চেক চান।
Scribbr-ও তার লেখার টুলগুলোর অংশ হিসেবে AI detection দেয়। আমরা আলাদাভাবে দেখেছি Grammarly AI Detector এবং Scribbr AI Detector।
দাম এবং ফ্রি প্ল্যানের সীমা
আপনি সাইন আপ করার পর Pangram-এর ফ্রি প্ল্যানে দিনে ২০টি চেক পাবেন, যার মধ্যে AI-assisted টেক্সট সনাক্তকরণও আছে, এবং কোনো পেমেন্ট পদ্ধতি লাগে না। Plagiarism চেক এবং বেশি সীমার জন্য একটি পেইড প্ল্যান দরকার। ৮ নভেম্বর ২০২৬ তারিখে Pangram-এর দাম ছিল:
| প্ল্যান | মাসিক বিল | বার্ষিক বিল | এটাতে যা যুক্ত |
|---|---|---|---|
| ফ্রি | US$0 | US$0 | দিনে ২০টি চেক |
| ব্যক্তিগত | US$20 প্রতি মাস | US$15 প্রতি মাস (US$180 বছরে) | প্রতি মাসে ৩,০০,০০০ শব্দ, ৬০০টি ছবি বা ৫০ মিনিটের ভিডিও, প্রতি স্ক্যানে একটি similarity check, OCRসহ ফাইল আপলোড, Google Docs এবং Gmail, এবং প্রতি মাসে US$10 API ক্রেডিট |
| পেশাদার | মাসে US$65 | মাসে US$45 (প্রতি বছর US$540) | Individual-এর তুলনায় ৫ গুণ বেশি স্ক্যান, সাথে প্রতি মাসে US$200 API ক্রেডিট |
| দল | ২টি সিটের জন্য মাসে US$40 | ২টি সিটের জন্য মাসে US$30 (প্রতি বছর US$360) | প্রতি সিটের জন্য আলাদা Individual ফিচার, একটি অ্যাডমিন ড্যাশবোর্ড এবং একটি বিল |
Individual এবং Team প্ল্যান ৭ দিনের বিনামূল্যের ট্রায়াল দিয়ে শুরু হয়, আর আপনি কিনলে Professional-এর বিল করা হবে। ডেভেলপাররাও API-এর মাধ্যমে ধাপে ধাপে যত ব্যবহার করবেন ততই পেমেন্ট করতে পারেন। Pangram 4.1 টেক্সটের খরচ প্রতি ১০০ শব্দে US$0.05, ছবি প্রতি US$0.25 এবং ভিডিও প্রতি সেকেন্ডে US$0.05, এবং বাল্ক টেক্সটে ২০% ছাড় আছে। স্কুল, প্রকাশক এবং অন্যান্য সংস্থাগুলোর জন্য Pangram-এর pricing পেজের Organizational ট্যাবে আলাদা মূল্য নির্ধারণ করা থাকে।
কোনরা Pangram ব্যবহার করেন
স্কুল ও বিশ্ববিদ্যালয়ই Pangram-এর সবচেয়ে বড় গ্রাহকভিত্তি। এর LMS ইন্টিগ্রেশন সরাসরি Canvas, Moodle, Google Classroom এবং Brightspace-এর সাথে যুক্ত হয়। একজন শিক্ষক প্ল্যাটফর্ম ছাড়াই, যেখানে তিনি ইতিমধ্যে মূল্যায়ন করেন, সেখানে শিক্ষার্থীর জমার পাশে Pangram-এর একটি ফলাফল দেখতে পারেন।
প্রকাশক, আইন সংস্থা এবং HR টিম বিভিন্ন কারণে Pangram ব্যবহার করে: জমা দেওয়া পাণ্ডুলিপি যাচাই, কোনো মামলার নথি পর্যালোচনা, অথবা আবেদনকারীর উপকরণ বাছাই। API-এর মাধ্যমে এসব প্রতিষ্ঠানের যে কেউ Pangram-এর ডিটেকশনকে তাদের নিজস্ব অভ্যন্তরীণ টুলের মধ্যে যুক্ত করতে পারে। Gmail এবং Google Docs ইন্টিগ্রেশন একজন ব্যক্তিকে ইনবক্স বা ডকুমেন্ট ছাড়াই টেক্সট যাচাই করতে দেয়।
একজন শিক্ষার্থীর জন্য এর মানে সাধারণত হলো Pangram স্কোরটি একই ড্যাশবোর্ডে দেখা যায় যেখানে আপনার শিক্ষক ইতিমধ্যে গ্রেড ও ফিডব্যাকের জন্য ব্যবহার করেন। আপনি নিজে আলাদা কোনো রিপোর্ট অনুরোধ করেন না। যদি আপনার স্কুল LMS-এর মাধ্যমে Pangram চালায়, তাহলে আপনার প্রশিক্ষক বা ডিপার্টমেন্টকে জিজ্ঞেস করুন কোন স্কোরকে উদ্বেগজনক ধরা হয় এবং এরপর কী হয়।
Pangram যদি আপনার নিজের কাজকে AI-চিহ্নিত করে
প্রথমে আপনার খসড়া তৈরির ইতিহাস সংগ্রহ করুন, কারণ নিজের খসড়া প্রক্রিয়ার রেকর্ড শুধু স্কোর নিয়ে তর্ক করার চেয়ে বেশি মূল্য রাখে। Google Docs বা Word-এর ভার্সন ইতিহাস, আগের খসড়া, নোট, একটি রেফারেন্স ম্যানেজার লাইব্রেরি এবং ট্র্যাকড চেঞ্জগুলো সবই দেখায় টেক্সটটি কীভাবে তৈরি হয়েছে। Pangram-এর নিজস্ব ব্যাখ্যায় রিভিউয়ারদের বলা হয় লেখককে তার খসড়া তৈরির প্রক্রিয়া ব্যাখ্যা করতে বলতে। প্রক্রিয়াই নতুন প্রমাণ বিষয়ক আমাদের গাইডে কী কী রাখা উচিত তা তালিকাভুক্ত আছে।
তারপর দেখুন আপনি কোন লেবেলটি পেয়েছেন। আপনি যে লেখা ব্যাকরণ টুল দিয়ে সম্পাদনা করেছেন, সেখানে AI-Assisted ফলাফল আসলে Pangram যা বলে ওই লেবেলটির মানে, তার সাথে মিলে যায়। আপনার প্রতিষ্ঠান যদি এ ধরনের সহায়তা অনুমোদন করে, তাহলে তা উল্লেখ করুন। আপনার পাণ্ডুলিপির জন্য কীভাবে একটি এআই-ব্যবহার প্রকাশের বিবৃতি লিখবেন নিয়ে আমাদের পোস্টে প্রচলিত পরিস্থিতিগুলোর জন্য প্রস্তুত ভাষা আছে।
আপনার লেখা নিজের তৈরি হলেও যদি টেক্সটে AI-Generated দেখায়, তাহলে শুধু শতাংশ নয়, হাইলাইট করা অংশসহ পুরো রিপোর্ট এবং confidence level চেয়ে নিন। চিহ্নিত অংশগুলো ছোট, ফর্মুলামূলক নাকি রেফারেন্স এবং টেমপ্লেটেড টেক্সট দিয়ে তৈরি, তা যাচাই করুন, কারণ Pangram-এর নিজস্ব স্কোপ নোটে এগুলোই তুলনামূলক দুর্বল দিক। আমাদের ভুল AI-ডিটেকশন ফ্ল্যাগে আপিল কীভাবে করবেন (শিক্ষার্থী ও গবেষকের নির্দেশিকা) এ একটি আনুষ্ঠানিক অনুরোধের ধাপগুলো আছে।
যদি আপনার প্রবন্ধের কোনো অংশ লেখায় AI সহায়তা করে থাকে, তাহলে আমাদের academic humanizer সেটি আপনার নিজের ভঙ্গিতে পুনর্লিখন করবে। আপনি যেমন লিখেছেন ঠিক তেমনই উদ্ধৃতি, প্রযুক্তিগত শব্দ এবং সংখ্যা থাকবে, এবং টুলটি এমনভাবে তৈরি যে এটি যেসব সেকশনে ছোঁয়া লাগে সেগুলোর AI স্কোর কমিয়ে আনতে সহায়তা করে।
প্রায়শই জিজ্ঞাসিত প্রশ্ন
Q: Pangram কি নির্ভুল?
Pangram বলছে এটি ৯৯% এরও বেশি নির্ভুল, এবং এটি বাইরের গবেষণার কথা উল্লেখ করে যেগুলোর ফলাফলও মিল আছে। ইউনিভার্সিটি অব শিকাগোর একটি ওয়ার্কিং পেপারে, যেখানে Pangram-এর আগের একটি মডেল পরীক্ষা করা হয়েছিল, সেখানে ইংরেজির মাঝারি ও দীর্ঘ অনুচ্ছেদে সব ধরনের লেখায় ফালস পজিটিভ রেট ছিল ০% থেকে ০.৭৫%। তাদের নিজস্ব মডেল কার্ডে ৫০ শব্দের কম টেক্সটে এবং ইংরেজি ছাড়া কিছু ভাষায় কম নির্ভুলতার কথা বলা হয়েছে।
Q: Pangram 4.1 কী?
Pangram 4.1 হল Pangram-এর বর্তমান টেক্সট ডিটেকশন মডেল, যা ১৯ অক্টোবর, ২০২৬ এ প্রকাশিত হয়েছে। এটি Pangram 4-কে প্রতিস্থাপন করেছে, ছোটখাটো সম্পাদনার পর আরও স্থিতিশীল ফল দেয় এবং প্রতিটি অংশে ক্লাস প্রোবাবিলিটি যোগ করে। Pangram এ জন্য ৭৮১,৯৮১টি ইংরেজি নথিতে ০.০০৯০% ফালস পজিটিভ রেট রিপোর্ট করেছে।
Q: Pangram-এর ফালস পজিটিভ রেট কত?
Pangram-এর FAQ অনুযায়ী মোট হার প্রায় ১০,০০০-এ ১। তাদের Pangram 4.1 মডেল কার্ডে ০.০০৯০%, অর্থাৎ প্রায় ১১,০০০-এ ১ দেখানো হয়েছে, যা ৭৮১,৯৮১টি ইংরেজি নথিতে মাপা হয়েছে; ডোমেইন ও ভাষাভেদে হার বদলায়। শিকাগোর পরীক্ষায় প্রায় ২,০০০টি মানব লেখায় genre অনুযায়ী ০% থেকে ০.৭৫% পাওয়া গেছে, যা ১০,০০০-এ ১-এর মতো কম হারের সত্যতা নিশ্চিত করার জন্য খুব ছোট নমুনা।
Q: Pangram কীভাবে GPTZero-এর সাথে তুলনা করে?
Pangram বলছে এর ফালস পজিটিভ রেট প্রায় ১০,০০০-এ ১, আর GPTZero বলছে RAID বেঞ্চমার্কে প্রায় ১%। উভয়েরই ফ্রি প্ল্যান আছে এবং সবার জন্য ওপেন সাইনআপ। আমরা আমাদের GPTZero কি সঠিক? স্বাধীন পরীক্ষাগুলো কী দেখায় (2026) এ GPTZero-এর নিজস্ব সংখ্যাগুলো কভার করেছি।
Q: Pangram কীভাবে Turnitin-এর সাথে তুলনা করে?
Turnitin কেবল স্কুল বা প্রকাশকের অ্যাকাউন্টের মাধ্যমেই কাজ করে, কিন্তু যে কেউ সরাসরি Pangram-এ সাইন আপ করতে পারে। Pangram তাদের নিজস্ব হোয়াইটপেপার থেকে Turnitin-এর ০.৫১% ফালস পজিটিভ রেটের উল্লেখ করে এবং নিজেদের ক্ষেত্রে এর চেয়ে কম হার রিপোর্ট করে।
Q: Pangram কীভাবে Copyleaks-এর সাথে তুলনা করে?
Copyleaks বলছে এর ফালস পজিটিভ রেট প্রায় ০.২%, এবং Pangram নিজেদের ক্ষেত্রে এর চেয়ে কম রেট রিপোর্ট করে। উভয়ই ফ্রি স্ক্যান অফার করে, এবং আমরা Copyleaks AI Detector এ Copyleaks কভার করেছি।
Q: Pangram কীভাবে AI writing সনাক্ত করে?
Pangram মানুষের লেখা এবং AI টেক্সট দিয়ে প্রশিক্ষিত একটি ডিপ লার্নিং মডেল ব্যবহার করে। এটি পারপ্লেক্সিটি এবং বার্স্টিনেস ব্যবহার করে না, যেগুলো অনেক পুরনো ডিটেক্টরের নির্ভরযোগ্য মাপকাঠি। এটি একটি ডকুমেন্টের প্রতিটি অংশকে Human, AI-Assisted বা AI-Generated হিসেবে লেবেল করে এবং ফলাফলের জন্য একটি confidence level দেয়।
Q: Pangram-এর AI detector কি ব্যবহার করতে ফ্রি?
হ্যাঁ। ফ্রি প্ল্যানে আপনি সাইন আপ করার পর প্রতিদিন ২০টি চেক পাবেন, কোনো পেমেন্ট মেথড ছাড়াই। পেইড প্ল্যানগুলোর দাম মাসে US$20 থেকে শুরু, অথবা বছরে বিল করা হলে মাসে US$15, এবং এতে প্রতি মাসে ৩০০,০০০ শব্দ এবং প্লেজিয়ারিজম চেক যুক্ত হয়।
Q: Pangram কি humanizer আছে?
না। Pangram শুধু AI টেক্সট শনাক্ত করে। তাদের মডেল প্রতিটি অংশে humanizer ব্যবহার হয়েছে কি না তার লক্ষণ দেখে স্কোর দেয়, এবং Pangram বলছে humanized করার পর AI টেক্সট শনাক্ত করতে পারে।
Q: Pangram কি প্লেজিয়ারিজম চেক করে?
হ্যাঁ, পেইড প্ল্যানগুলোতে। Pangram-এর Similarity Checker AI detector-এর একই স্ক্যানে চলে এবং আপনার টেক্সটকে বিলিয়ন বিলিয়ন ওয়েবপেজ, একাডেমিক পেপার, নিউজ আর্টিকেল এবং বইয়ের সাথে তুলনা করে।
Q: humanizer দিয়ে চালানো টেক্সট কি Pangram সনাক্ত করে?
Pangram বলছে এটি করে, এবং সেটার সমর্থন হিসেবে ২০২৫ সালের Chicago Booth স্টাডির কথা উল্লেখ করে। ওই পরীক্ষায় StealthGPT রিরাইটিংয়ের পর AI অনুচ্ছেদের মধ্যে এটি ০% থেকে ৫% পর্যন্ত মিস করেছে, যেখানে GPTZero-এর জন্য ছিল ২৫.৫% থেকে ৭৭.৩% এবং Originality.ai-এর জন্য ২.৩% থেকে ২০.৭%। ডিটেক্টর এবং humanizer দুটোই প্রায়ই আপডেট হয়, তাই humanized টেক্সটে ফলাফল সময়ের সাথে বদলাতে পারে।
Q: ইউনিভার্সিটি অব মেরিল্যান্ডের স্টাডি Pangram সম্পর্কে কী পেয়েছে?
মেরিল্যান্ড বিশ্ববিদ্যালয়ের একটি ২০২5 সালের গবেষণায় দেখা গেছে, Pangram-এর humanizer-aware মডেল Pangram Humanizers হল পাঁচজন বিশেষজ্ঞ মানব পাঠকের একটি প্যানেলের সঙ্গে মেলাতে সক্ষম একমাত্র স্বয়ংক্রিয় শনাক্তকারী। ৩০০টি পরীক্ষামূলক প্রবন্ধ জুড়ে উভয়ই গড়ে ৯৯.৩% সত্যিকারের পজিটিভ হার অর্জন করেছে। ওই নির্দিষ্ট পরীক্ষায় Pangram-এর মিথ্যা পজিটিভ হার ছিল ২.৭%, যা তার নিজস্ব বৃহত্তর মূল্যায়ন থেকে জানানো ১০,০০০-এ ১ হারের তুলনায় অনেক বেশি।
Q: Pangram কে তৈরি করে?
Pangram Labs হল Pangram-এর পেছনের প্রতিষ্ঠান। এটি ২০২৩ সালে নিউ ইয়র্কের ব্রুকলিনে প্রতিষ্ঠিত হয়, এবং এর প্রতিষ্ঠাতা ছিলেন Tesla ও Google-এর সাবেক AI গবেষকরা। প্রতিষ্ঠানটি একটি Similarity Checker-ও বিক্রি করে, পাশাপাশি টেক্সট শনাক্তকারীর সঙ্গে AI ছবি ও ভিডিও শনাক্তকারী এবং API অ্যাক্সেসও দেয়।
Q: Pangram কি ছোট লেখা নিয়ে কাজ করে?
হ্যাঁ, তবে মিস রেট বেশি হয়। Pangram এমন গদ্যর জন্য ডিজাইন করা, যাতে কমপক্ষে ৫০ শব্দ থাকে। ৫০ থেকে ৯৯ শব্দে তার ফালস নেগেটিভ রেট ১.২৯%, এবং ২৫০ থেকে ৪৯৯ শব্দে ০.২১%। শিকাগো পরীক্ষায় ৫০ শব্দের কমের অংশ দেখা হয়, এবং সেখানে সর্বোচ্চ ২.৫% ফালস পজিটিভ রেট পাওয়া যায়।
Q: Pangram কি অ-নেটিভ ইংরেজি লেখকদের বিরুদ্ধে পক্ষপাতী?
Pangram-এর নিজস্ব পরীক্ষায় কোনো পক্ষপাত পাওয়া যায়নি। Pangram 4.1-এ ১৫,৪২০টি প্রবন্ধ ও গবেষণাপত্রে শূন্য ফালস পজিটিভ ছিল, যা বিশ্ববিদ্যালয়ের এমন শিক্ষার্থীরা লিখেছিল যারা অতিরিক্ত ভাষা হিসেবে ইংরেজি কথা বলে। Pangram-এর ২০২৪ সালের রিপোর্টে TOEFL-এর ৯১টি প্রবন্ধে কোনোটি পাওয়া যায়নি। এগুলো বিক্রেতার পরীক্ষার ফলাফল।
Q: Pangram-এ an AI-Assisted লেবেল মানে কী?
এটির মানে হল এমন মানুষের লেখা টেক্সট, যা AI দিয়ে সম্পাদনা করা হয়েছে। Pangram-এর মডেল কার্ড এটিইভাবে সংজ্ঞা দেয়, এবং ব্যাখ্যায় Grammarly উদাহরণ হিসেবে দেখানো হয়েছে। সেখানে উদাহরণগুলোতে বলা আছে, একটি মডেলকে একটি অনুচ্ছেদ মসৃণ করতে বলা এবং তা ইংরেজিতে অনুবাদ করা। এটি কীভাবে টেক্সটটি সম্পাদিত হয়েছে তা বর্ণনা করে, কিন্তু লেখক নিজেই এটি তৈরি করেছেন বলে বলে না।
Q: Pangram কি ইংরেজি ছাড়া অন্য ভাষায় কাজ করে?
এটি ২৪টি ভাষা সমর্থন করে, এবং ভাষাভিত্তিকভাবে Pangram 4.1-এর ফালস পজিটিভ রেট ০.০০০০% থেকে ০.০১৫৭% এর মধ্যে। ইংরেজির বাইরে AI-লেখা শনাক্ত করতে এটি বেশি মিস করে, ১৮টি ভাষায় ফালস নেগেটিভ রেট ১.৯৯%। মেশিন-অনুবাদ করা টেক্সট এর আওতার বাইরে।
Q: Pangram-এর একটি স্কোর কি গ্রেড বা সিদ্ধান্ত নির্ধারণ করা উচিত?
না। Pangram-এর ব্যাখ্যায় বলা আছে, এমন কোনো সর্বজনীন সংখ্যা নেই যা পদক্ষেপ নেওয়ার প্রয়োজনীয়তা নির্দেশ করে, এবং স্কোরটিকে ডায়াগনস্টিক টুল হিসেবে বর্ণনা করা হয়েছে। একজন পর্যালোচককে হাইলাইট করা অংশগুলো, আত্মবিশ্বাসের মাত্রা এবং লেখকের খসড়া তৈরির ইতিহাস দেখতে উচিত।
Q: আমার লেখা যদি Pangram ফ্ল্যাগ করে, তাহলে আমার কী করা উচিত?
আপনার খসড়া, সংস্করণ ইতিহাস এবং নোটগুলো সংগ্রহ করুন, তারপর পূর্ণ রিপোর্ট চেয়ে নিন এবং প্রতিষ্ঠান কীভাবে AI-Assisted লেবেলকে বিবেচনা করে তা জিজ্ঞেস করুন। আমাদের আপিল গাইড ধাপগুলো কভার করে, এবং প্রসেস প্রমাণ গাইড কী রাখতে হবে তা কভার করে।
আপনার নিজস্ব ভঙ্গিতে AI-সহায়তাপ্রাপ্ত একাডেমিক খসড়াগুলো পুনর্লিখন করে, আপনি যেমন লিখেছেন ঠিক তেমনভাবেই উদ্ধৃতি, প্রযুক্তিগত পরিভাষা এবং সংখ্যাগুলো অপরিবর্তিত রাখে।
ডানা ProofreaderPro-এর একজন বিষয়বস্তু নির্মাতা, যেখানে তিনি দৈনিক ব্লগ এবং লেখার কাজ চালান। অনলাইন এডিটিং প্ল্যাটফর্ম কীভাবে কাজ করে সে বিষয়ে তিনি নিবন্ধগুলি লেখেন এবং তিনি প্রতিদিন গ্রাহকের বার্তাগুলি পরিচালনা করেন, এটি দেখানোর জন্য একটি ফাইভ-স্টার সন্তুষ্টি স্কোর সহ।