OpenAI Watermark, SynthID і Claude: Порівняння текстових водяних знаків
Чи водяний знак OpenAI для тексту, чи є публічний перевірник водяних знаків OpenAI, і чим відрізняються SynthID та водяний знак Claude для академічних авторів, порівняно?
OpenAI, Google і Anthropic створили одну й ту саму технологію: статистичний водяний знак для AI-генерованого тексту. OpenAI роками тримала свою версію в резерві та почала її поступово впроваджувати як textGrain у жовтні 2026 року. Google вбудувала SynthID у Gemini та опублікувала метод. Anthropic зробила водяний знак Claude обов’язковим для кожного користувача в серпні 2026 року. Якщо ви пишете з будь-якою формою допомоги від AI, усі ці три рішення тепер впливають на те, як оцінюватимуть ваші документи.
Водяне маркування перейшло з теми досліджень у мейнстрімні новини 11 серпня 2026 року, коли Anthropic оголосила, що кожна нова модель Claude позначає свій текстовий вивід. Ми детально розібрали це оголошення в нашому поясненні водяного знака Claude. У цьому гайді показано повну картину: що таке текстовий водяний знак, як кожна з трьох ключових лабораторій його реалізувала або приховала, і що кожна система доводить про конкретний текст.
Що таке AI-текстовий водяний знак?
AI-текстовий водяний знак це статистичний шаблон, прихований у виборі слів генеративного тексту. Його вбудовують у момент створення, щоб згодом детектор із правильним ключем міг підтвердити, що текст походить від певної AI-системи. Це не видима позначка, не прихований символ і не метадані, прикріплені до файлу. Позначка «живе» в самих словах.
Ця різниця важлива, тому що термін «watermark» використовують досить вільно для трьох різних речей:
| Що це | Де воно знаходиться | Чи переживає копіювання-вставку? | |
|---|---|---|---|
| Статистичний водяний знак | Зміщення, у якому модель обирає слова | Сам текст | Так |
| Метадані файлу (C2PA) | Підписана мітка походження | Контейнер файлу | Ні, звичайне копіювання втрачає це |
| Символи нульової ширини | Невидимий Unicode вставляється в текст | Між видимими символами | Ні, це легко видаляється |
Статистичне водяне маркування є єдиним із трьох, що витримує копіювання, вставлення, повторне введення та конвертацію формату в новий документ. Саме тому всі три провідні лабораторії зійшлися на ньому для тексту, і тому так звані «знищувачі водяних знаків», які прибирають невидимі символи, не мають проти нього жодного ефекту. Наша сторінка видалення водяного знака Claude описує цей сценарій невдачі з посиланнями на джерела.
Як саме працює статистичне водяне маркування?
На кожному кроці написання речення мовна модель обирає між кількома майже еквівалентними словами, і водяний знак непомітно «заряджає» ці кидки кубика. Базовий рецепт опублікували Kirchenbauer та колеги з Університету штату Меріленд у січні 2023 року в Водяний знак для великих мовних моделей (ICML 2023). Ось як це працює:
- Перед вибором кожного слова прихований ключ, виведений з попередніх слів, ділить словниковий запас на набір із преференцією та нейтральний набір.
- Модель злегка підштовхує свій вибір у бік преференційного набору. «Suggest» замість «indicate». «Across» замість «among». Кожен окремий вибір виглядає цілком природно.
- Детектор, який має ключ, підраховує, як часто текст потрапляє в преференційні набори. Людське письмо потрапляє в очікувану частоту випадково. Водяномаркований текст потрапляє в неї надто часто, і статистичний тест позначає невідповідність.
Жодне окреме слово не є доказом чогось. Сигнал проявляється лише сукупно: через десятки або сотні виборів. Тому довші фрагменти тестувати легше, ніж короткі, і тому детекція завжди є імовірнісною, а не «так або ні» за штампом.
Виробнича система Google DeepMind, опублікована в Nature у жовтні 2024 року як Масштабоване водяне маркування для ідентифікації результатів великих мовних моделей, вдосконалила це технікою під назвою tournament sampling. Вона зберігає якість тексту настільки добре, що дозволяє непомітно працювати в споживчому продукті в масштабі. Ця стаття важлива не лише для Google: це опублікована база, на яку Anthropic посилається для реалізації Claude.
Головна слабкість була опублікована до більшості розгортань. У березні 2023 року Krishna та колеги показали в Перефразування обходить детектори тексту, згенерованого ШІ (NeurIPS 2023), що перегенерація формулювань у фрагменті «змиває» детекцію між методами, включно з водяними знаками. Сигнал живе в точній послідовності токенів і більше ніде, тож будь-яке переписування послідовності, зокрема робота редактора-людини, переносить докази геть. Кожен вендор, який сьогодні постачає водяний знак, у власній документації зазначає це обмеження.
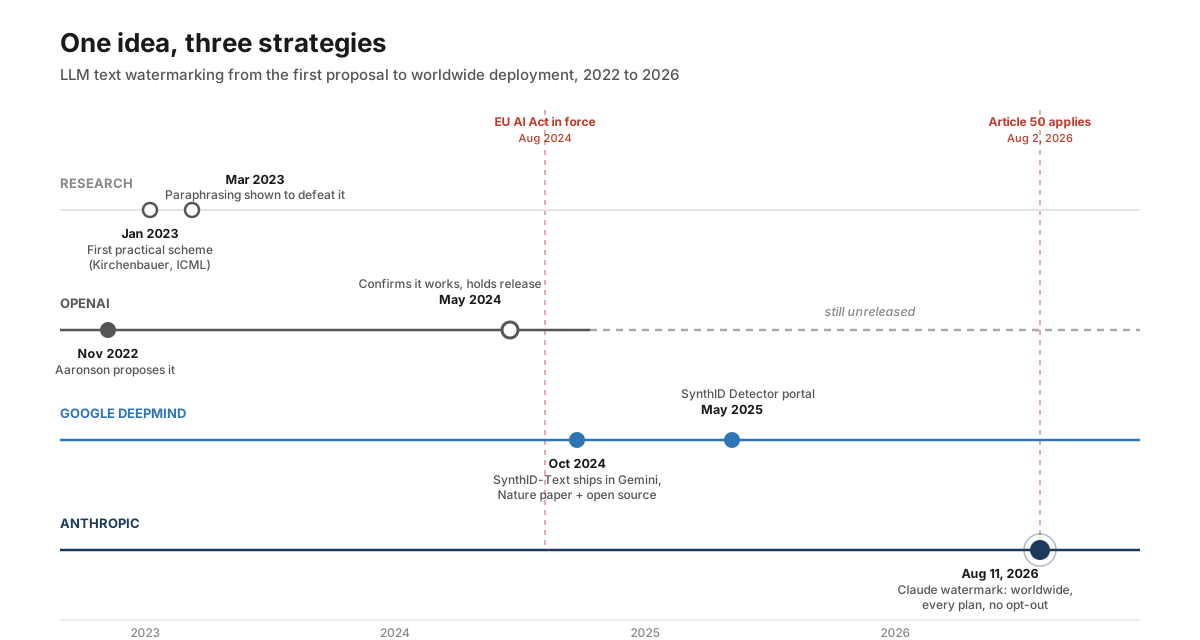
OpenAI: компанія, яка це винайшла і випустила останньою
У OpenAI був робочий текстовий водяний знак роками, але компанія вирішила не випускати його до жовтня 2026 року. Scott Aaronson, який тоді працював над безпекою в OpenAI, уперше описав ідею публічно в November 2022 lecture. Цей метод зміщує вибори моделі між майже еквівалентними словами за допомогою таємної криптографічної функції, тож сам текст показує, звідки він походить. Ця лекція старіша за будь-яку систему, яку вже розгорнули.
У травні 2024 року OpenAI описала стан проєкту в оновленні щодо походження матеріалів, Розуміння джерела того, що ми бачимо і чуємо онлайн. Компанія заявила, що її метод текстового водяного знака є точним і ефективним для невеликих змін, але вона затримала реліз, зважуючи компроміси. Два з ризиків, які назвала OpenAI, безпосередньо стосуються авторів академічних текстів:
- Легке обходження. Перефразування або переклад тексту прибирає мітку, точно так, як прогнозувало дослідження 2023 року. Водяний знак, який здебільшого виявляє тих, хто не знає про його існування, є слабким інструментом примусового застосування.
- Невідповідний вплив на носіїв англійської як другої мови. OpenAI зазначила, що водяні знаки можуть стигматизувати законне використання AI як допоміжного інструменту для людей, які пишуть англійською як другою мовою. Наша публікація про Чому AI-детектори позначають роботу іншомовних авторів (хибні спрацювання) розглядає ту саму проблему з боку детекторів.
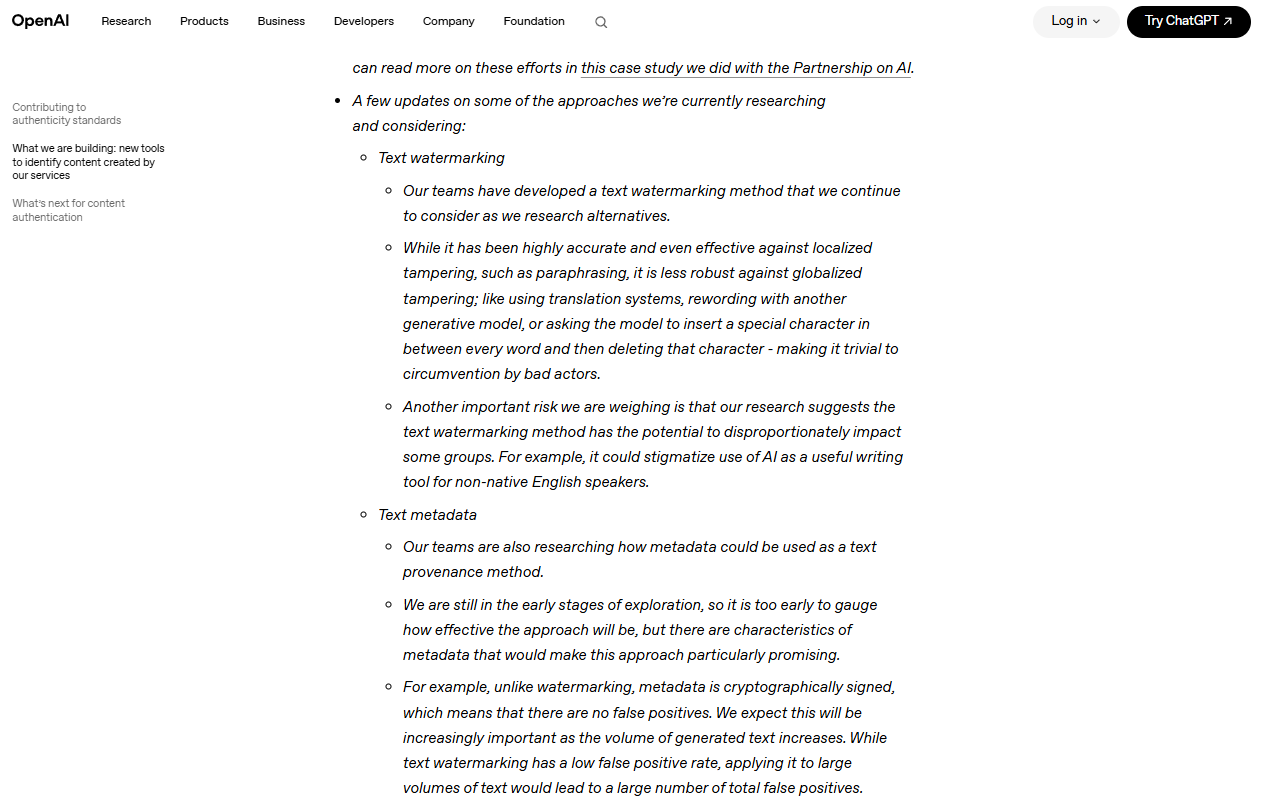
Оновлення щодо походження матеріалів OpenAI за 2024 рік: метод працює, і компанія наводить причини, чому відкладала його впровадження в той час.
Для зображень і аудіо OpenAI пішла іншим шляхом: метадані C2PA про походження в результатах DALL-E та Sora, які є міткою рівня файлу, а не позначкою вмісту. Для тексту вивід ChatGPT не мав водяного знака аж до жовтня 2026 року. Компанія, що запропонувала технологію, була останньою з трьох, хто її розгорнув.
OpenAI зараз водяно позначає текст?
Так, OpenAI почала водяно позначати деякі тексти 5 жовтня 2026 року у відповідь на EU AI Act. Її оголошення представляє текстовий водяний знак під назвою textGrain, який додає невидимий статистичний сигнал до вибору слів у моделі. Розгортання має три частини, і водяний знак не є глобальним налаштуванням за замовчуванням:
- Клієнти API будь-де можуть увімкнути водяно позначений вивід для вибраних моделей. За замовчуванням він вимкнений.
- Протягом наступних тижнів відповідний вивід тексту ChatGPT і Codex у Європейському Союзі отримує водяний знак, на всіх тарифних планах.
- Затверджені дослідники та експертні організації можуть подати заявку на доступ до детектора текстового водяного знака.
OpenAI стверджує, що textGrain відповідав або перевершував інші методи, які вона тестувала, зокрема Google's SynthID для тексту. Також вона опублікувала, де під час детекції точність знижується. За частоти хибнопозитивних спрацювань 1% детектор виявляв водяний знак приблизно у 80% фрагментів по 200 токенів і приблизно у 95% фрагментів по 400 токенів у психологічному контенті. Для математики детекція була значно нижчою, де менше свободи у виборі слів.
Редагування швидко послаблює сигнал. У фрагментах на 400 токенів заміна 10% слів синонімами знизила детекцію приблизно з 92% до 66%, а заміна 25% знизила її до 17%.
OpenAI також перевірила, чи змінює водяний знак якість відповідей на Astra, її останній моделі, і каже, що суттєвої різниці не побачила. Ось чотири бенчмарки, які вона опублікувала:
| Бенчмарк | Без водяного знака (Astra) | З водяним знаком (Astra) |
|---|---|---|
| Artificial Analysis Intelligence Index | 49.57 бала | 49.76 бала |
| GPQA Diamond | 94.44% | 93.94% |
| HealthBench Professional | 64.27% | 64.60% |
| BrowseComp | 87.92% | 87.35% |
Для студентів важлива дата. Текст ChatGPT, написаний до розгортання, або поза Європейським Союзом без налаштування API, не має водяного знака OpenAI. Наш гід до Пояснення Turnitin Clarity пояснює, як школи в тимчасовий період встановлюють власні політики щодо використання AI.
Чи є публічний перевіряльник водяних знаків OpenAI?
Поки що немає публічної перевірки водяних знаків OpenAI для тексту. Безплатний інструмент перевірки від OpenAI перевіряє зображення та аудіофайли на наявність C2PA Content Credentials і водяний знак SynthID, який OpenAI вбудовує у підтримувані зображення та аудіо. OpenAI зазначає, що інструмент не підтримує текст.
Для тексту OpenAI надає доступ до детектора за принципом «у кожному випадку окремо» для схвалених дослідників і експертних організацій через своє заявкове подання для Content Provenance API. Вона каже, що не робить текстовий детектор публічним на старті через ризик пропуску водяних знаків і хибнопозитивних результатів. Детектор повідомляє, чи виявляє водяний знак OpenAI, і не ідентифікує користувача та не показує його запити.
| Що саме ви хочете перевірити | Інструмент | Хто може ним користуватися |
|---|---|---|
| Файл зображення або аудіо OpenAI | Інструмент верифікації OpenAI | Будь-хто, безплатно |
| Текстовий вивід OpenAI (textGrain) | Детектор текстових водяних знаків OpenAI | Схвалені дослідники та експертні організації, за заявкою |
| Текстовий вивід Claude | Детектор водяного знака Claude | Підходящі організації, за заявкою (див. нашу інструкцію щодо водяних знаків Claude) |
OpenAI також чітко пояснює, чого результат не може вам сказати. Виявлений водяний знак не вимірює, скільки саме людина внесла у створення, і не визначає, хто написав або використав текст. Відсутність водяного знака теж не доводить людське авторство, тому що текст може бути занадто коротким, відредагованим, перекладеним або створеним на базі непідтримуваної моделі.
Google: перші з випуском, а потім поділилися рецептом
Google DeepMind спершу випустила рішення, повністю опублікувала, а потім відкрила метод. Її система SynthID спочатку була водяним знаком для зображень у 2023 році, а в 2024 році розширилася на текст. На момент появи статті Nature у жовтні 2024 року SynthID-Text уже працював у Gemini в продакшені, що зробило його першим статистичним текстовим водяним знаком, розгорнутим у масштабі споживчих продуктів.
SynthID охоплює текст, зображення, аудіо та відео, і працює в текстовому виводі Gemini з жовтня 2024 року.
Потім Google опублікувала реалізацію як open source на Hugging Face, що дозволяє будь-якому розробнику застосувати ту саму схему водяного маркування до власних моделей. У травні 2025 року вона оголосила про SynthID Detector, портал верифікації, де контент можна перевірити на наявність позначок SynthID у тексті, зображеннях, аудіо та відео.
Є важливе обмеження: SynthID лише позначає і лише виявляє контент із моделей самої Google. Він не говорить нічого про вивід ChatGPT або Claude, а чисте сканування SynthID не означає, що текст написано людиною. Це означає лише, що моделі Google його не створювали, що є значно вужчою заявою.
Anthropic: останні, але найжорсткіша політика
Anthropic розгорнули пізніше, але з найширшим обов’язковим покриттям. Кожна модель Claude, запущена 2 серпня 2026 року або пізніше, вбудовує статистичний водяний знак у свій текстовий вивід, по всьому світу, у кожному тарифі, без можливості відмови. Компанія описує механізм у своєму пояснювальному матеріалі Як працює текстовий водяний знак Claude, а межі політики у статті довідкового центру Як Claude позначає AI-генерований контент. Під покриття підпадають Claude API, claude.ai, Claude Code, Claude Cowork і Claude Tag. Моделі, запущені до граничної дати, перебувають у перехідному періоді, і Anthropic каже, що також додає їм підтримку позначок. Поряд зі статистичною позначкою, файли, згенеровані Claude, також містять C2PA-метадані, другу окрему систему, яку «прибирає» звичайне копіювання звичайним текстом.
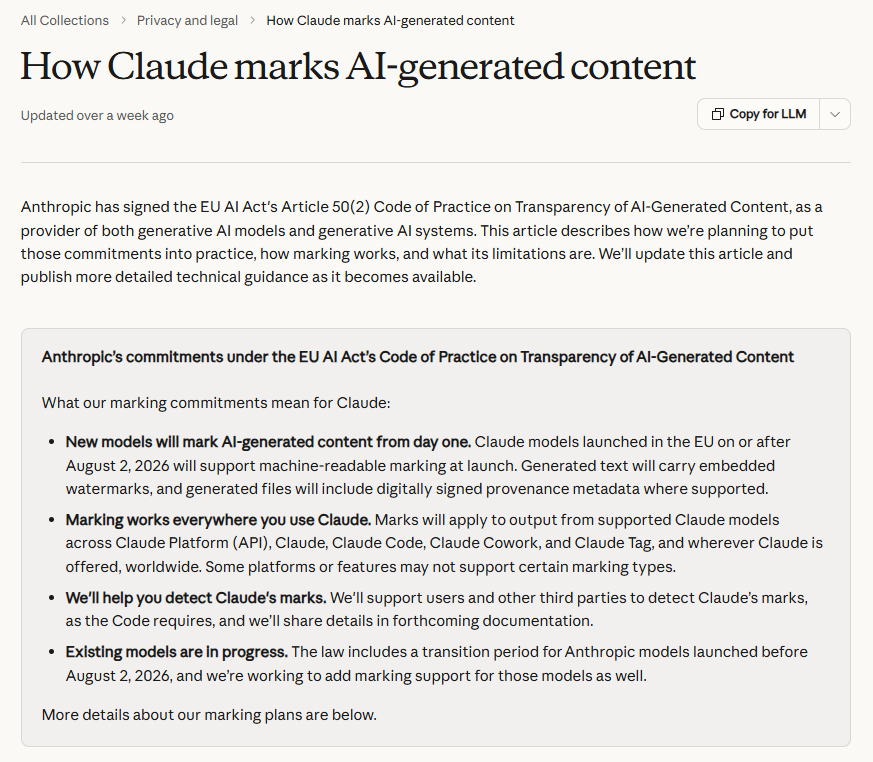
Політика у власних формулюваннях Anthropic: кожна нова модель, кожна платформа, у всьому світі, а старіші моделі додаються.
У документації Anthropic межі описані напряму. Виявлення є імовірнісним. Маркування не може відрізнити документ, який написав Claude, від документа, який написала людина, а Claude лише трохи відредагував. Повне перероблення прибирає його. Ми пройшли через усе це, включно з тим, що саме доводить позитивне виявлення, та що робити, якщо ваш власний текст позначили, у спеціальному гіді з watermark для Claude.
Строки відповідають регулюванню. Anthropic підписала Статтю 50(2) Кодексу практик щодо прозорості контенту, створеного ШІ, під EU AI Act, який вимагає від постачальників систем генеративного ШІ забезпечити, щоб результати були "позначені у машиночитному форматі та виявлялися як штучно згенеровані". Ці зобов’язання щодо прозорості набули чинності 2 серпня 2026 року: це точна дата відсічення у політиці моделей Anthropic, за дев’ять днів до публічного оголошення. Anthropic вирішила виконати вимоги глобально, а не підтримувати різну поведінку для трафіку в ЄС. Google уже дотримувався вимог за задумом. Невідмічений текстовий вивід OpenAI це відкрите питання щодо дотримання вимог у 2027 році.
Три підходи, пліч-о-пліч
| OpenAI | Google DeepMind | Anthropic | |
|---|---|---|---|
| Текстове watermark розгорнуто? | Так (textGrain, запуск у ЄС з 5 жовтня 2026 року) | Так (Gemini, починаючи з жовтня 2024) | Так (моделі Claude з 2 серпня 2026 року) |
| Техніка | textGrain це статистичний сигнал у виборі слів | SynthID-Text турнірне вибіркове моделювання | Маркування через статистичну вибірку, у стилі SynthID |
| Покриття | Правомірний текст для Eligible ChatGPT та Codex у ЄС; опція opt-in через API у всьому світі | Тільки моделі Google | Усі нові моделі Claude; старіші моделі у перехідному періоді |
| Відмова від опції | Вимкнено за замовчуванням в API | Ні | Ні |
| Публічний детектор | Ні | Портал SynthID Detector (2025) | Заплановано, але ще не випущено |
| Схема опублікована? | Лише концептуальні лекції | Стаття Nature + відкритий код | Пояснення на основі опублікованих матеріалів |
| Метадані файлу (C2PA) | Так, зображення та аудіо | Так, для різних медіа | Так, для згенерованих файлів |
| Оголошені обмеження | Обхід, стигма щодо ESL | Діапазон обмежено власними моделями | Ймовірнісний характер, редагування розмиває авторство |
Збіг у колонках такий: OpenAI розглядає текстове водяне маркування як невирішену політичну проблему, Google розглядає його як інфраструктуру, яку потрібно стандартизувати, а Anthropic розглядає це як зобов’язання щодо дотримання вимог, яке потрібно реалізувати повністю.
Що це означає для дослідників і академічних авторів
Практичні наслідки залежать від того, які інструменти торкаються вашого тексту. Якщо ви створюєте чернетку за допомогою ChatGPT, сьогодні ваш текст не має водяного маркування. Якщо ви створюєте чернетку за допомогою Gemini, він містить позначку SynthID, яку може прочитати лише детектор Google. Якщо ви створюєте або редагуєте за допомогою актуальної моделі Claude, текст містить позначку Anthropic, і немає налаштування, яке б це вимикало.
Три речі, які академічні автори мають знати:
Водяний знак ідентифікує інструмент, а не автора. Кожен постачальник це зазначає у своїй документації, і про це варто повторити, адже інституційні політики не завжди роблять цю різницю. Текст може бути позначений, тому що його створила AI, тому що AI стилістично відредагувала в ньому два речення, або тому що позначений абзац було процитовано. Якщо ваша установа запускає перевірки водяних знаків, то те, що доводить перевірка, це те, що певна модель торкнулася тексту колись, не більше. Наш гід про оскарження хибного прапорця AI-виявлення пояснює, як побудувати цю аргументацію, коли це справді важливо.
Водяні знаки та AI-детектори це різні технології з різними сценаріями відмов. Детектори на кшталт Turnitin або GPTZero роблять припущення за статистичним стилем, з проблемами точності, які ми задокументували. Виявлення водяного знака це тест на основі ключа з дуже низькою частотою хибнопозитивних спрацювань на немаркованому людському тексті. Нерівність змінюється для хибнонегативних: перевірка водяного знака пропускає будь-який AI-текст від моделі, яка не використовує водяні знаки, а сьогодні це включає всі тексти від ChatGPT.
Розкриття залишається вашою найсильнішою позицією. Водяне маркування робить безшумне використання AI ризикованішим, а розкритий використання AI безпечнішим, адже розкритий робочий процес не має чого боятися позитивної позначки. Більшість журналів і університетів зараз мають чіткі політики щодо використання AI; наш політика використання AI пояснює, як ми проводимо ці межі для власних інструментів, і це розумний шаблон того, як має виглядати прозоре використання.
Що прибирає текстове водяне маркування і що не прибирає
Переписування прибирає його; форматування не прибирає. Копіювання, вставляння, зміна шрифтів, перетворення між форматами файлів і вилучення невидимих символів залишають статистичне водяне маркування повністю незмінним, бо позначка знаходиться у виборі слів. Прибирає його будь-що, що заново генерує формулювання: глибоке редагування людиною, переклад або справді автентичний перефраз. Це показано у роботі з надійності NeurIPS 2023, ще до того, як ці системи були запущені.
Тут важливі обидва напрямки. Зникнення позначки не робить текст вашим, а збереження позначки не робить текст не вашим. Переписаний AI-зразок все одно є документом, створеним за допомогою AI, і на нього поширюються правила розкриття інформації вашої установи. Наш AI text humanizer переписує AI-згенеровані чернетки в природний академічний стиль, і оскільки під час цього процесу відновлюється послідовність токенів, статистичні позначки через нього не зберігаються. Для Claude зокрема видалення водяного знака Claude переосмислює кожне речення у свіжих формулюваннях, залишаючи факти, числа та посилання без змін. Те, що жоден інструмент не може змінити, це те, що ви маєте надати читачеві: прозорість щодо того, як було підготовлено документ.
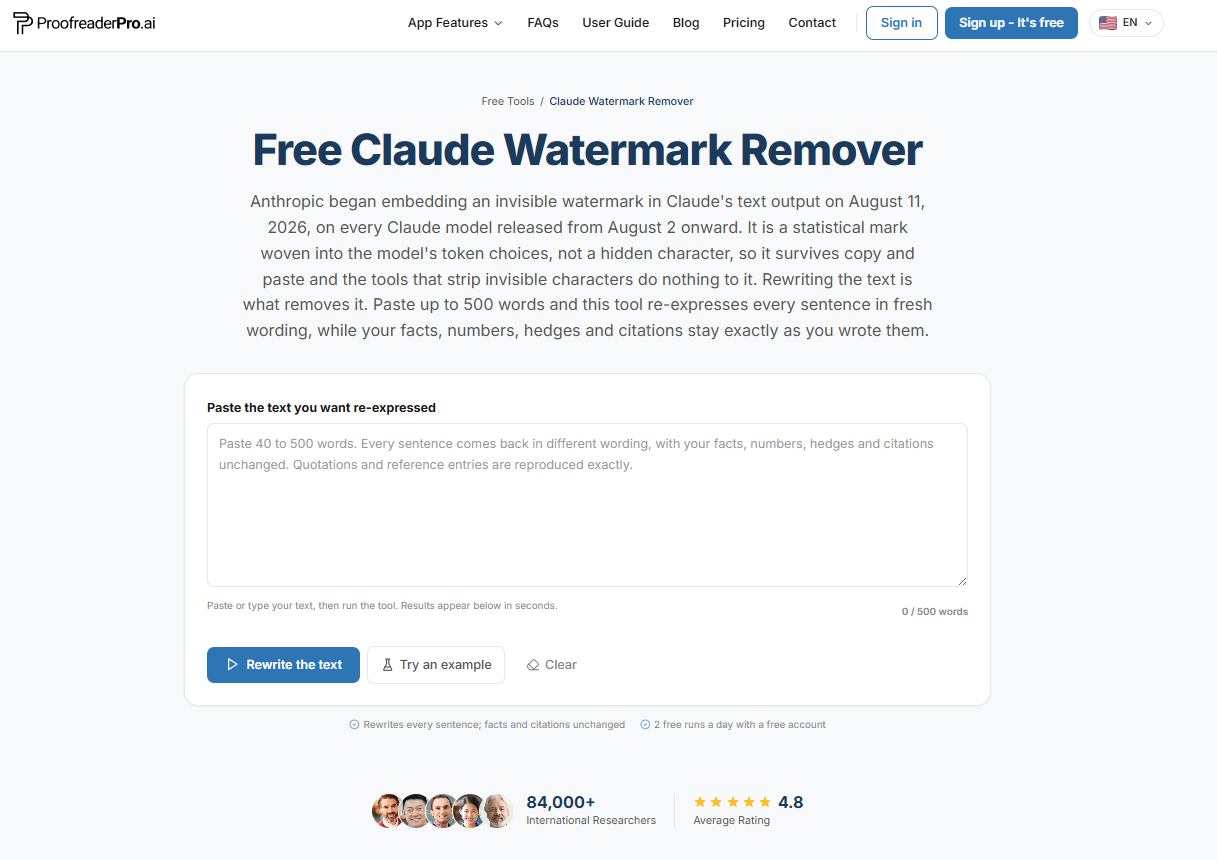
Переписування є єдиною операцією, яка видаляє статистичну позначку, і саме це робить цей інструмент, речення за реченням.
Куди це піде далі
Слідкуйте за трьома речами до 2027 року. По-перше, чи OpenAI виведе textGrain за межі ЄС: це почалося звідти, оскільки в ЄС виконання статті 50 вимагає машинозчитуваних позначок в AI-тексті. По-друге, чи збігаються підходи детекторів. Якщо кожна велика лабораторія водяними знаками покриває за опублікованою схемою, університети зможуть перевіряти ключі замість того, щоб гадати за стилем письма, що покращить те, як працює нинішнє Наскільки точні AI-детектори у 2026 році? Перевірена точність і хибні спрацювання. По-третє, чи стануть позначки сумісними. Сьогодні три лабораторії використовують три різні позначки, і жодна єдина перевірка не охоплює їх усі. C2PA заповнює цю прогалину для файлів, але для звичайного тексту поки що нічого подібного немає.
Чи ставить ChatGPT водяний знак на свій текст?
Так, частково, починаючи з 5 жовтня 2026 року. OpenAI почав додавати водяний знак textGrain до відповідного тексту ChatGPT та Codex у Європейському Союзі, а клієнти API будь-де можуть увімкнути цю функцію. Водяний знак є статистичним сигналом у виборі слів і не містить прихованих символів. OpenAI також застосовує метадані C2PA про походження до медіафайлів DALL-E та Sora, але це окрема система на рівні файлів.
Чи ставить Google Gemini водяний знак на свій текст?
Так. Вихідні дані Gemini мають водяний знак SynthID-Text від Google DeepMind з жовтня 2024 року. Це статистична позначка у виборі слів, невидима для читачів і перевіряється через детектор SynthID від Google. Вона застосовується лише до власних моделей Google, тож від’ємний результат SynthID нічого не говорить про текст від інших AI-систем.
Чи ставить Claude водяний знак на свій текст?
Так. Кожна модель Claude, запущена в день або після 2 серпня 2026 року, вбудовує статистичний водяний знак у свій текстовий вивід на кожній платформі та в кожному тарифі, без можливості відмови, а файли, створені Claude, додатково містять метадані C2PA. Моделі, запущені до цієї дати, ще не позначають свій вивід; Anthropic каже, що додає підтримку маркування для них у перехідний період. Повні деталі викладено в нашому пояснювачі щодо водяного знака Claude.
Чи можуть університети виявляти AI-водяні знаки?
Лише за співпраці з постачальником, бо для детекції потрібен ключ постачальника. Google пропонує публічний портал детектора для контенту SynthID. Anthropic каже, що підтримка детекції для користувачів і сторонніх організацій планується, але ще не оприлюднила публічний детектор. Жоден поширений програмний пакет для перевірки плагіату наразі не може верифікувати статистичні водяні знаки від жодної лабораторії, тож сьогодні «AI detection» на рівні установи все ще означає здогад за стилем, а не верифікацію водяного знака.
Чи вимагає законодавство AI-водянoго маркування?
У ЄС, так, фактично. Стаття 50(2) Закону ЄС про ІШ (AI Act) зобов’язує постачальників генеративного ШІ забезпечувати, щоб результати були позначені у машинозчитуваному форматі та розпізнавалися як штучно згенеровані, а також щоб діяли зобов’язання щодо прозорості, починаючи з 2 серпня 2026 року. Anthropic підписала відповідний Кодекс практик і обрала дотримання вимог у всьому світі. Те, як регулятори ставитимуться до непоширеного водяного знака тексту OpenAI, є ключовим питанням, на яке варто звернути увагу у 2027 році.
Чи переживають AI-водяні знаки переклад?
Ні. Статистичний водяний знак існує в точній послідовності слів, яку обрав модель. Переклад замінює кожне слово. Те саме стосується глибокого перефразування та інтенсивного редагування людиною. Це обмеження зафіксовано в рецензованій літературі та визнається кожним постачальником, який випускає рішення з водяним знаком.
Чи є публічний інструмент перевірки водяного знака OpenAI для тексту?
Ні, публічний інструмент перевірки OpenAI перевіряє лише зображення та аудіофайли, а також метадані C2PA і водяні знаки SynthID. OpenAI стверджує, що не підтримує текст. Її детектор текстового водяного знака доступний лише для схвалених дослідників та експертних організацій, у кожному випадку окремо.
Що таке textGrain?
textGrain це текстовий водяний знак OpenAI, оголошений 5 жовтня 2026 року. Він додає невидимий статистичний сигнал до вибору слів моделлю, тож позначка є частиною слів без прихованих символів і без метаданих файлу. OpenAI повідомляє, що цей підхід або відповідав, або перевершував інші методи, які вона тестувала, зокрема SynthID для тексту, і що редагування послаблює його.
Чи можуть дослідники подати заявку на доступ до детектора текстового водяного знака OpenAI?
Так, схвалені дослідники та експертні організації можуть подати заявку через форму OpenAI для Content Provenance API. OpenAI надає доступ у кожному випадку окремо згідно з Європейським кодексом практик. Вона також зазначає, що перегляне ширший доступ, коли розвиватимуться технологія та докази.
Джерела
- Anthropic, Як працює текстовий водяний знак Claude, серпень 2026
- Anthropic Help Center, Як Claude позначає контент, згенерований ШІ, 2026
- OpenAI, Розуміння джерела того, що ми бачимо і чуємо онлайн, травень 2024
- Google DeepMind, SynthID
- Dathathri та ін., Масштабоване водяний знак для ідентифікації результатів великих мовних моделей, Nature, жовтень 2024
- Google, Оголошення про SynthID Detector, травень 2025
- Hugging Face, Introducing SynthID Text, жовтень 2024
- Kirchenbauer та ін., Водяний знак для великих мовних моделей, ICML 2023
- Krishna та ін., Перефразування обходить детектори тексту, згенерованого ШІ, NeurIPS 2023
- Scott Aaronson, Моя лекція з безпеки ШІ для UT Effective Altruism, листопад 2022
- Європейський Союз, AI Act, стаття 50
- C2PA, Коаліція за підтвердження походження та автентичності контенту
Дана є творцем контенту в ProofreaderPro, де вона веде щоденний блог і пише. Вона пише статті про те, як працює онлайн-платформа редагування, і щодня обробляє повідомлення клієнтів, отримавши за це п’ять зірок.