
AI Humanizer สำหรับนักวิจัยชาวยูเครนที่เขียนภาษาอังกฤษ
AI humanizer สำหรับนักวิจัยชาวยูเครน ช่วยลดสัญญาณแจ้งเตือนการตรวจจับ AI ที่ผิดพลาดในภาษาอังกฤษซึ่งได้รับอิทธิพลจากยูเครนและรัสเซีย โดยคงความหมายและการอ้างอิงไว้ พร้อมเปิดเผยการใช้งานอย่างตรงไปตรงมา

ยูเครนยังคงสร้างผลงานวิทยาศาสตร์ที่จริงจังภายใต้เงื่อนไขที่ทำให้ระบบการวิจัยส่วนใหญ่สะดุดหยุดลง นักฟิสิกส์ นักคณิตศาสตร์ นักวิทยาศาสตร์ด้านวัสดุ และวิศวกรยังคงส่งผลงาน และนโยบายระดับประเทศยังคงผลักดันให้ทุกคนมุ่งไปที่วารสารซึ่งถูกจัดทำดัชนีใน Web of Science และ Scopus ในทางปฏิบัติ นั่นหมายถึงสิ่งเดียว: คุณต้องเขียนเป็นภาษาอังกฤษ ไม่ว่าภาษาที่คุณคิดในใจจะเป็นภาษาใดก็ตาม
AI humanizer สำหรับนักวิจัยชาวยูเครนมีอยู่เพื่อรับมือกับกับดักนี้โดยเฉพาะ นักวิชาการที่ใส่ใจจะเขียนภาษาอังกฤษให้สะอาด ถูกต้องเป็นมาตรฐาน จากนั้นนำร่างไปตรวจด้วยเครื่องมือเช็ก AI และพบว่ากลับมาพร้อมสถานะว่าเขียนด้วยเครื่อง ทั้งที่ไม่มีการ “แต่ง” อะไรขึ้นมา เพียงแต่ภาษามันถูกต้องเกินไป เครื่องมือนี้จะคงความหมาย ศัพท์เฉพาะ และการอ้างอิงไว้ครบถ้วน ขณะเดียวกันทำให้การเขียนที่ตั้งใจอย่างละเอียดสำหรับผู้พูดไม่ใช่เจ้าของภาษาอ่านออกมาดู “เหมือนที่มนุษย์เขียนจริง ๆ” นักวิทยาศาสตร์ชีวภาพและแพทย์ก็เจออุปสรรคแบบเดียวกัน
นักวิจัยชาวยูเครนส่วนใหญ่เป็นสองภาษา คือสลับไปมาระหว่างยูเครนและรัสเซีย และทั้งสองภาษาทิ้ง “รอยพิมพ์” แบบเดียวกันไว้บนร้อยแก้วภาษาอังกฤษ รอยเหล่านี้ไม่ใช่ข้อผิดพลาด แต่เป็นร่องรอยของผู้เขียนที่เรียนรู้ภาษาอังกฤษผ่านไวยากรณ์แบบสลาฟ และยิ่งน่าแปลกใจคือ ยิ่งคุณทำให้ภาษาอังกฤษ “สะอาดขึ้น” เท่าใด ตัวตรวจจับก็ยิ่งมีแนวโน้มจะอ่านผิดพลาดว่าเป็นงานจากเครื่อง
การทำให้ข้อความ AI มีความเป็นมนุษย์สำหรับนักวิจัยชาวยูเครน
การทำให้ข้อความ AI มีความเป็นมนุษย์ของเรา ช่วยให้นักวิทยาศาสตร์ชาวยูเครนสามารถตีพิมพ์ได้อย่างมั่นใจเป็นภาษาอังกฤษ โดยคงเนื้อหาและการอ้างอิงไว้ When your first language is Ukrainian or Russian, the goal is the same: prose that keeps your argument exactly as you meant it, but no longer trips a detector trained mostly on native English.
เราออกแบบ humanizer สำหรับนักวิจัยที่ทำงานจริง และเพียงต้องการให้มันถูกอ่านอย่างเป็นธรรม คุณร่างเนื้อหาทางวิทยาศาสตร์ เครื่องมือนี้จะปรับจังหวะและการเลือกคำ ทำให้ “ท่วงทำนอง” ที่เครื่องมักตกหลุมไปอยู่กับสิ่งที่เครื่องสร้างได้อย่างสม่ำเสมอ และส่งมอบงานเขียนที่ยังคงบอกสิ่งที่คุณตั้งใจจะสื่ออย่างแม่นยำ เพียงแต่ถ้อยคำถูกถ่ายทอดด้วยน้ำเสียงที่อ่านแล้วเหมือนมนุษย์
เขียนเป็นภาษายูเครนหรือไม่? ตรวจจับอัตโนมัติและทำให้เป็นมนุษย์ในลักษณะที่เป็นธรรมชาติ
นักวิจัยชาวยูเครนจำนวนมากร่างเป็นภาษายูเครนก่อน แล้วจึงค่อยเขียนสรุปเป็นภาษาอังกฤษ และ humanizer ก็จัดการกับขั้นตอนนี้โดยตรง วางข้อความภาษายูเครนลงไป แล้ว ProofreaderPro จะจดจำอักษรซีริลลิกและแยกจากรัสเซีย จากนั้นจึงประมวลผลด้วยโมเดลที่รับรู้ภาษา โดยคงคำศัพท์เฉพาะและการอ้างอิงของคุณไว้ตามที่เขียนอย่างแท้จริง ผ่าน гуманізація AI-тексту ร่างภาษายูเครนของคุณจะถูกทำให้เป็นมนุษย์ได้อย่างลื่นไหลพอ ๆ กับภาษาอังกฤษ โดยไม่มีการแปลมาก่อน ความสามารถด้านการตรวจจับนี้ครอบคลุมมากกว่าหกสิบภาษา โดยแต่ละภาษาเขียนใหม่ด้วย “เสียง” ของตัวเอง
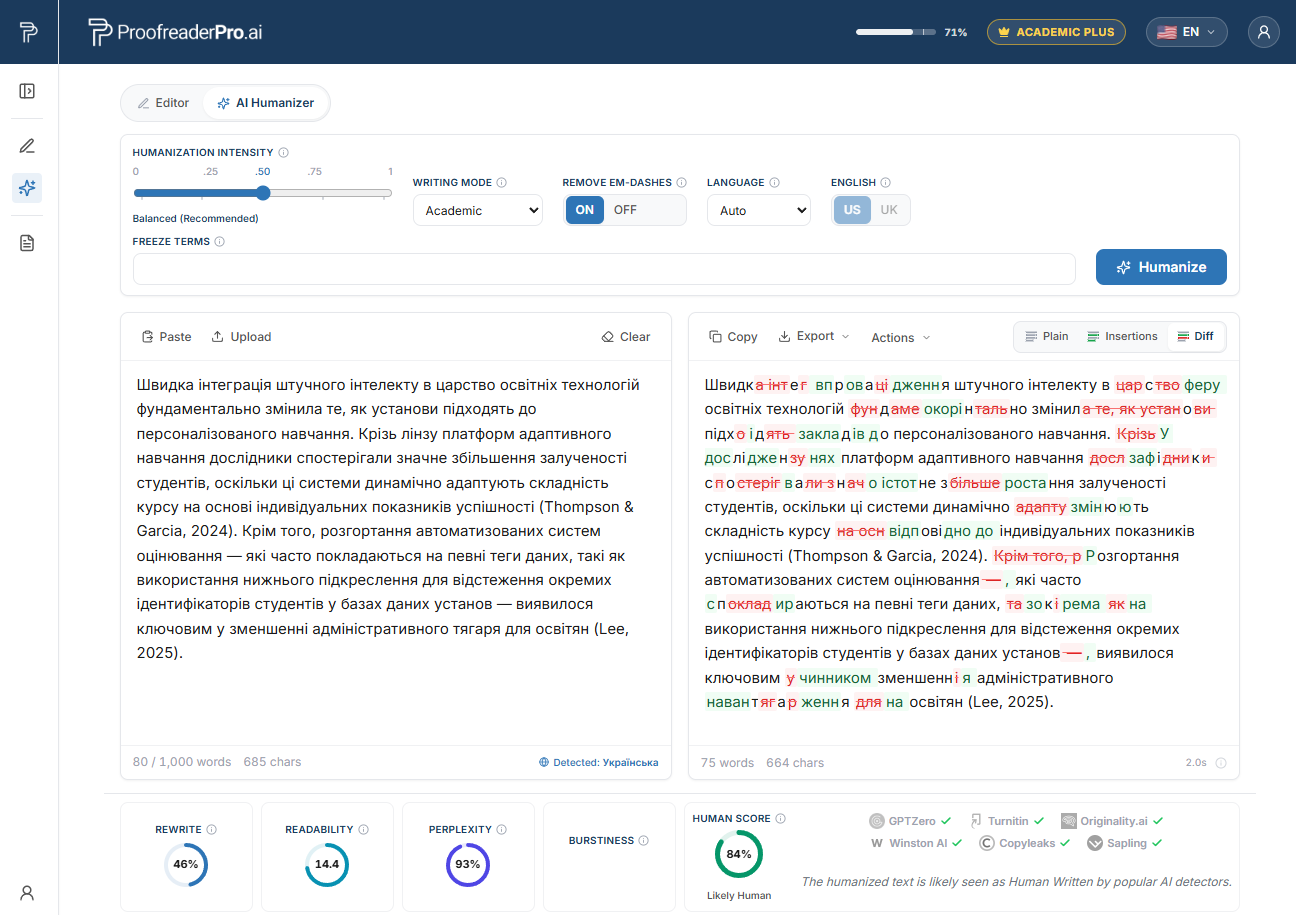
ProofreaderPro AI Humanizer ที่เขียนใหม่เพื่อทำให้ข้อความวิชาการภาษายูเครนเป็นมนุษย์ ความแตกต่างก่อนและหลังช่วยคงความหมายและการอ้างอิงไว้ และการตรวจจากตัวตรวจจับยืนยันว่าอ่านแล้วเป็นธรรมชาติแบบมนุษย์
เหตุใดนักวิจัยชาวยูเครนจึงถูกแฟล็กโดยเครื่องตรวจจับ AI
หลักฐานที่ชัดที่สุดมาจากงานศึกษาของ Stanford ในปี 2023 นำโดย Weixin Liang และทีม ซึ่งตีพิมพ์ในวารสาร Cell Press เรื่อง Patterns ทีมงานนำเรียงความ TOEFL ที่เขียนโดยมนุษย์ไปผ่านเครื่องตรวจจับ AI ที่ใช้อยู่แพร่หลาย 7 ชนิด โดยเฉลี่ยแล้ว ประมาณ 61% ของเรียงความที่ไม่ใช่เจ้าของภาษาถูกแฟล็กว่าเป็นงานที่สร้างด้วย AI เทียบกับราว 5% สำหรับผู้เขียนภาษาอังกฤษโดยกำเนิด เกือบหนึ่งในห้า หรือประมาณ 19.8% ของเรียงความที่ไม่ใช่เจ้าของภาษา ถูกแฟล็กอย่างเป็นเอกฉันท์โดยเครื่องตรวจจับทุกตัว ทุกเรียงความถูกเขียนโดยบุคคล
ทำไมจึงเป็นเช่นนั้น เครื่องตรวจจับจำนวนมากให้คะแนนสิ่งที่เรียกว่า “perplexity” ซึ่งวัดว่าคำถัดไปแต่ละคำในประโยคมีความ “น่าประหลาดใจ” ต่อโมเดลภาษาเพียงใด เมื่อคุณเขียนอย่างรอบคอบในภาษาที่สอง คุณมักเลือกใช้คำที่พบบ่อยและถ้อยคำที่ปลอดภัย คาดเดาได้ นั่นทำให้เกิด perplexity ต่ำ และ perplexity ที่ต่ำคือสิ่งที่เครื่องตรวจจับอ่านว่าเป็นงานจากเครื่องอย่างพอดิบพอดี พฤติกรรมที่ทำให้ภาษาอังกฤษแบบยูเครน-อังกฤษชัดเจน ถูกต้อง เป็น “นิสัยเดียวกัน” กับที่ระบบเหล่านี้ถูกฝึกให้ไม่ไว้ใจ
ดังนั้น สัญญาณแฟล็กไม่ใช่ข้อสรุปต่อความซื่อสัตย์ของคุณ มันเป็นผลจากลักษณะเชิงสถิติของวิธีการทำงานของเครื่องมือ และเราอธิบายกลไกให้ลึกขึ้นใน why AI detectors flag non-native writing การรู้เช่นนี้ช่วยปรับวิธีที่คุณควรรับมือกับคะแนนสีแดง: มองว่าเป็นข้อกล่าวอ้างที่ต้องโต้แย้งด้วยเหตุผล ไม่ใช่เป็นคำสารภาพที่จะต้องยอมรับ
รูปแบบจากภาษายูเครนและรัสเซียที่เป็น “ต้นเหตุ” ของ false flags
ไวยากรณ์แบบสลาฟต่างจากอังกฤษในเชิงโครงสร้างอยู่ไม่กี่จุด และแต่ละจุดจะดันภาษาอังกฤษของคุณไปสู่ “สำนวนเรียบ ๆ คาดเดาได้” ซึ่งตัวตรวจจับลงโทษ ไม่มีจุดใดเหล่านี้เป็นความผิดพลาด แต่เป็นโครงสร้างที่พิถีพิถัน และความ “เป็นมาตรฐาน” ของมันเองคือปัญหา
No articles. ทั้งยูเครนและรัสเซียไม่มี "the" หรือ "a" ดังนั้นคำนำหน้านามในอังกฤษจึงถูกตัดออก เพิ่ม หรือสลับหน้าที่ใหม่ ("result was significant", "we studied the influence of the temperature") เมื่อบรรณาธิการทำความสะอาดส่วนเหล่านี้ ประโยคที่ถูกแก้จะลื่นไหลขึ้นและกลายเป็นสำนวนทั่วไป ซึ่งอ่านได้ว่า perplexity ต่ำ
Aspect instead of tense. ไวยากรณ์แบบสลาฟสร้างขึ้นบนแนวคิดเรื่องกิริยาเชิงสมบูรณ์ (perfective) และไม่สมบูรณ์ (imperfective) แทนระบบกาลเวลาในอังกฤษ ดังนั้นการเลือกใช้ perfect กับ simple past จึงออกมาไม่สม่ำเสมอ การแก้ไขเรื่องนี้มักทำให้ได้ประโยคสั้น กระชับ และ “ตรงแบบตำรา”
Flexible word order. ตอนจบคำนามในระบบกรณี (case endings) ช่วยกำหนดความหมายในยูเครนและรัสเซีย ทำให้ลำดับคำเคลื่อนย้ายได้อย่างยืดหยุ่น เมื่อนำโครงสร้างแบบนั้นไปสู่ภาษาอังกฤษ โครงสร้างข้อมูลจะลงตัวค่อนข้างประหลาด และวิธีแก้ที่ปลอดภัยที่สุดคือการจัดลำดับที่เป็นแบบแผนมากที่สุด ซึ่งก็คือแบบที่ “เหมือนเครื่อง” มากที่สุด
Countable and uncountable nouns. รูปแบบอย่าง "informations", "researches", "an equipment" และ "evidences" เป็นไปตามธรรมชาติจากภาษาต้นทาง เมื่อแก้ไขแล้วจะกลายเป็นรูปแบบนามวลีแบบ “mass-noun” ที่เป็นมาตรฐาน ซึ่งปรากฏในตัวอย่างการฝึกนับล้านครั้ง
Preposition transfer and the missing auxiliary. บุพบทถูกแมป (map) แตกต่างกันระหว่างภาษา และคำช่วยในอังกฤษอย่าง "do/does" ไม่มีคู่เทียบโดยตรง ดังนั้นทั้งสองอย่างจึงมักถูกทำให้เป็นมาตรฐานระหว่างการบรรณาธิการอีกครั้ง นำไปสู่รูปแบบที่เรียบง่ายที่สุด
Transliteration. ชื่อและคำศัพท์เชิงเทคนิคที่นำมาจากอักษรซีริลลิกจะถูกทำให้เป็นรูปแบบการสะกดตามธรรมเนียมภาษาอังกฤษ ซึ่งเป็นอีกขั้นเล็ก ๆ ที่ทำให้เกิดความสม่ำเสมอ เมื่อรวมทั้งหมดนี้ คุณจะได้ร้อยแก้วที่สะอาด ถูกต้อง มีความแปรปรวนน้อย: ซึ่งเป็นโปรไฟล์ที่ตัวตรวจจับให้คะแนนว่าเป็น “งานประดิษฐ์”
บริบทการตรวจจับ AI ในยูเครนและ Turnitin
การคัดกรองความคล้ายคลึงเป็นเรื่องปกติในสถาบันอุดมศึกษาของยูเครน และการตรวจจับ AI ก็กำลังเข้ามาเสริมจากนั้น มหาวิทยาลัยจำนวนมากใช้ Unicheck ซึ่งเป็นระบบที่สร้างขึ้นในยูเครนและปัจจุบันเป็นส่วนหนึ่งของ Turnitin ขณะที่บางแห่งใช้ StrikePlagiarism หากคุณส่งวิทยานิพนธ์หรือฉบับต้นฉบับ ให้ถือไว้ก่อนว่าเอกสารจะถูกผ่านหนึ่งในกระบวนการเหล่านี้ก่อนที่มนุษย์จะอ่านอย่างละเอียด
กระทรวงศึกษาธิการและวิทยาศาสตร์ (MES) รวมถึงสถาบันแต่ละแห่ง ได้ออกแนวทางด้านความซื่อสัตย์ทางวิชาการและ AI และทิศทางโดยรวมคือการเปิดเผยข้อมูล มากกว่าห้ามใช้ ผู้ให้ทุนและวารสารต่าง ๆ ขอให้คุณระบุว่าคุณใช้ AI เมื่อใดและอย่างไรในการเตรียมบทความมากขึ้นเรื่อย ๆ
บรรยากาศเช่นนี้จัดการได้ หากคุณเข้าหาด้วยความซื่อสัตย์ เป้าหมายของการทำให้งานเป็นมนุษย์ไม่ใช่เพื่อปิดบังการใช้ AI หรือเพื่อหลอก Unicheck เป้าคือหยุด “ช่องว่างเรื่องความเป็นธรรม” ในเครื่องมือที่ไปลงโทษงานจริง จากนั้นจึงเปิดเผยการใช้ AI ของคุณอย่างตรงตามที่มหาวิทยาลัยและวารสารเป้าหมายกำหนด
เผยแพร่งานวิจัยยูเครนของคุณเป็นภาษาอังกฤษที่เป็นธรรม
ทำให้ร่างที่ช่วยด้วย AI ของคุณเป็นมนุษย์, รักษาความหมายและการอ้างอิงไว้, และเปิดเผยการใช้งาน AI ของคุณด้วยความมั่นใจ
ลองใช้ Humanizer ฟรีมหาวิทยาลัยชั้นนำในยูเครนและจุดที่ปรากฏการตรวจด้วย AI
สถาบันต่าง ๆ ด้านล่างทำการคัดกรองวิทยานิพนธ์และต้นฉบับเพื่อความคล้ายคลึง และเริ่มให้ค่าน้ำหนักกับตัวชี้วัดที่เกี่ยวกับ AI มากขึ้น หากคุณทำงานหรือศึกษาอยู่ที่ใดที่หนึ่งในกลุ่มนี้ การตรวจความคล้ายคลึงและ AI จะเป็นส่วนหนึ่งของเส้นทางปกติสู่การสอบ/ปกป้องวิทยานิพนธ์ หรือการส่งบทความ
- Київський національний університет імені Тараса Шевченка (Taras Shevchenko National University of Kyiv), Kyiv
- Національний технічний університет України «Київський політехнічний інститут імені Ігоря Сікорського» (Igor Sikorsky Kyiv Polytechnic Institute, KPI), Kyiv
- Харківський національний університет імені В. Н. Каразіна (V. N. Karazin Kharkiv National University), Kharkiv
- Львівський національний університет імені Івана Франка (Ivan Franko National University of Lviv), Lviv
- Національний університет «Львівська політехніка» (Lviv Polytechnic National University), Lviv
- Сумський державний університет (Sumy State University), Sumy
- Національний університет «Києво-Могилянська академія» (National University of Kyiv-Mohyla Academy), Kyiv
- Дніпровський національний університет імені Олеся Гончара (Oles Honchar Dnipro National University), Dnipro
ในทุกมหาวิทยาลัยเหล่านี้ เวิร์กโฟลว์คล้ายกัน: ร่างของคุณจะผ่านการตรวจแบบอัตโนมัติก่อนที่จะถูกส่งต่อให้คณะกรรมการทำการพิจารณา การเข้าใจว่าการตรวจนั้นวัดอะไรจริง ๆ คือสิ่งที่ช่วยให้คุณตอบสนองต่อแฟล็กอย่างสงบแทนที่จะตื่นตระหนก
วิธีทำงานของ AI humanizer สำหรับนักวิจัยชาวยูเครน
เวิร์กโฟลว์ที่ซื่อสัตย์มี 4 ขั้นตอน และการเปิดเผยเป็นส่วนหนึ่งของมัน ไม่ใช่เรื่องทีหลัง
ขั้นแรก ร่างเนื้อหาทางวิทยาศาสตร์ของคุณ นักวิจัยชาวยูเครนจำนวนมากคิดผ่านข้อโต้แย้งเป็นภาษายูเครนหรือรัสเซียก่อน แล้วค่อยแปล ซึ่งทำได้อย่างสมบูรณ์แบบ สิ่งสำคัญคือทำให้เหตุผลถูกต้องก่อน แล้วค่อยกังวลเรื่องว่ามันอ่านออกมาอย่างไร
ขั้นที่สอง อ่านทานไวยากรณ์ให้ถูกต้อง เพื่อให้ภาษาอังกฤษถูกต้องและศัพท์เฉพาะของคุณสอดคล้องกัน ไวยากรณ์ที่สะอาดกับน้ำเสียงที่เป็นธรรมชาติเป็นคนละเรื่องกัน และคุณต้องการทั้งสองอย่าง
ขั้นที่สาม นำงานเขียนที่ได้รับความช่วยเหลือจาก AI ของคุณไปผ่าน text humanizer มันจะปรับจังหวะประโยคและการเลือกคำ ลบจังหวะที่ซ้ำซากซึ่งเครื่องมักมีร่วมกับข้อความที่ถูกแก้ไขอย่างหนักในภาษาที่สอง และตัดเครื่องหมาย em dash ที่หลุดไป ขณะเดียวกันยังคงความหมาย คำศัพท์เชิงเทคนิค และการอ้างอิงทุกรายการของคุณไว้ เพราะ humanizer ของเรารองรับมากกว่า 60 ภาษา ข้อความที่ไม่ใช่ภาษาอังกฤษจึงถูกส่งผ่านโมเดลที่รับรู้ภาษา ซึ่งคงโครงสร้างประโยคและความหมายเอาไว้ได้โดยไม่ทำให้เพี้ยนหรือเสียรูป
ผลลัพธ์จะเป็นอย่างไร คุณคาดหวังอะไรได้บ้าง จากการทดสอบของเราเอง การทำให้งานเป็นมนุษย์ช่วยลดอย่างมีนัยสำคัญว่า “บ่อยครั้งแค่ไหน” ที่ภาษาอังกฤษสำหรับผู้ไม่ใช่เจ้าของภาษาที่รอบคอบและเป็นมาตรฐานถูกอ่านผิดโดยเครื่องตรวจจับหลัก ๆ รวมถึง Turnitin, Originality.ai และ GPTZero ขณะที่ความหมายทางวิชาการของคุณยังคงเดิม เราอธิบายสิ่งนี้ในฐานะสิ่งที่พบจากการทดสอบ ไม่ใช่คำสัญญา เครื่องตรวจจับถูกฝึกใหม่ทุกไม่กี่เดือน และไม่มีเครื่องมือที่ซื่อสัตย์ใดสามารถอ้างได้ว่าจะ “ไม่ถูกตรวจพบ 100%” ผู้ใดรับประกันอย่างอื่นเท่ากับขาย “ความมั่นใจ” ที่ไม่มีอยู่จริงให้คุณ
ขั้นที่สี่ เปิดเผย เพิ่มคำชี้แจงการใช้งาน AI ในรูปแบบที่สถาบันและวารสารของคุณต้องการ เพื่อให้งานของคุณอยู่ภายใต้กฎความซื่อสัตย์อย่างชัดเจน นี่คือประเด็นทั้งหมด: คุณกำลังปกป้องงานวิจัยที่เป็นจริงจากเครื่องมือที่ลำเอียง ไม่ใช่การปิดบังอะไรเลย ยูเครนคืออีกหนึ่งจุดบน multilingual AI humanizer hub ของเรา และหากบทความของคุณต้องการการแก้ภาษาแบบครบด้านด้วย ที่ global academic editing hub จะพาคุณไปดูขั้นตอนอีกฝั่งของกระบวนการนั้น
หน่วยงานให้ทุนท้องถิ่น วารสาร และความคาดหวังด้านการเปิดเผยการใช้ AI
งานวิจัยของยูเครนได้รับการสนับสนุนและจัดการผ่านหน่วยงานส่วนกลางไม่กี่แห่ง The National Research Foundation of Ukraine (NRFU, Національний фонд досліджень України) ดำเนินทุนสนับสนุนแบบแข่งขัน The National Academy of Sciences of Ukraine (NAS, НАН України) กำกับดูแลสถาบันระดับชาติ และกระทรวงศึกษาธิการและวิทยาศาสตร์ (MES) กำหนดนโยบายด้านการวิจัยและการตีพิมพ์ รวมถึงการผลักดันให้ได้ผลงานที่ถูกจัดทำดัชนี
แรงผลักดันนั้นเป็นรูปธรรม นโยบายระดับชาติให้รางวัลกับการตีพิมพ์ในวารสารที่ถูกจัดทำดัชนีใน Web of Science และ Scopus ซึ่งทำให้แรงกดดันให้เขียนเป็นภาษาอังกฤษยังคงสูงต่อเนื่องปีแล้วปีเล่า เมื่อคุณมุ่งเป้าวารสารเหล่านี้ ให้คาดหวังการคัดกรองความคล้ายคลึงเป็นเรื่องปกติ และคาดหวังจำนวนวารสารที่เพิ่มขึ้นเรื่อย ๆ ที่จะขอให้คุณเปิดเผยการใช้ AI ตอนส่งต้นฉบับ
ตอบสนองต่อความคาดหวังนี้โดยตรง บอกให้ชัดว่าคุณใช้สิ่งใด เก็บบันทึกให้สะอาด และปล่อยให้ร่างที่ทำให้เป็นมนุษย์พาความคิดโต้แย้งของคุณไปด้วยน้ำเสียงที่เป็นธรรมชาติ หากคุณเคยได้รับแฟล็กที่คุณเชื่อว่าไม่ถูกต้อง ให้ถือว่าเป็น “ข้อกล่าวอ้างที่คุณโต้แย้งได้ด้วยหลักฐาน” และกลับไปใช้ text humanizer ก่อนการส่งครั้งถัดไป แทนที่จะรอหลังจากถูกปฏิเสธ
คำถามที่พบบ่อย
ถาม: การใช้ AI humanizer สำหรับนักวิจัยชาวยูเครนถือเป็นการโกงหรือไม่?
ไม่ ไม่ใช่เมื่อคุณใช้อย่างซื่อสัตย์ คุณกำลังทำให้ร่างที่ได้รับความช่วยเหลือจาก AI ของคุณเป็นงานที่เป็นมนุษย์ เพื่อปกป้องการเขียนอย่างตั้งใจของผู้ไม่ใช่เจ้าของภาษาไม่ให้ถูกเครื่องตรวจจับที่ลำเอียงลงโทษ ไม่ได้เป็นการแต่งผลลัพธ์หรือปิดบังความเป็นเจ้าของงาน คุณคงความหมายและการอ้างอิงไว้ จากนั้นจึงเปิดเผยการใช้ AI ในรูปแบบที่มหาวิทยาลัยและวารสารของคุณต้องการ
ถาม: humanizer จะเปลี่ยนศัพท์เทคนิคหรือการอ้างอิงของฉันหรือไม่?
ไม่ เครื่องมือนี้ถูกออกแบบมาเพื่อคงความหมายเชิงวิชาการ ศัพท์เทคนิค และการอ้างอิงทุกฉบับไว้ตามที่คุณเขียนอย่างเคร่งครัด มันปรับจังหวะและการเลือกคำรอบเนื้อหาของคุณ ดังนั้นวิธีการ คำศัพท์ และเลขจำนวนการอ้างอิงของคุณจึงยังคงเดิม
ถาม: กระบวนการ гуманізація AI-тексту ใช้ได้กับนักวิจัยชาวยูเครนที่พูดภาษารัสเซียด้วยหรือไม่?
ได้ ยูเครนและรัสเซียมีลักษณะทางไวยากรณ์ร่วมกันจำนวนมากที่ทิ้งรอยพิมพ์แบบเดียวกันไว้บนร้อยแก้วภาษาอังกฤษ เช่น การขาดคำนำหน้านาม และกริยาแบบเน้นแง่มุม เมื่อ humanizer ส่งข้อความที่ไม่ใช่ภาษาอังกฤษและไม่ใช่ภาษาเจ้าของผ่านโมเดลที่รับรู้ภาษา ก็ช่วยได้ไม่ว่าภาษาของคุณจะเป็นภาษายูเครนหรือรัสเซียเป็นหลัก
ถาม: มีเครื่องมือใดรับประกันได้ว่าบทความของฉันจะผ่านการตรวจจับ AI หรือไม่?
ไม่มี และคุณควรไม่เชื่อใครก็ตามที่อ้างว่าสามารถทำได้ เครื่องตรวจจับถูกฝึกใหม่ตลอดเวลา และไม่มีเครื่องมือที่ซื่อสัตย์ใดรับประกันได้ว่าจะ “ไม่ถูกตรวจพบ 100%” สิ่งที่เราพอพูดได้คือ ในการทดสอบของเรา การทำให้งานเป็นมนุษย์ช่วยลดอย่างมีนัยสำคัญว่าภาษาอังกฤษของผู้ไม่ใช่เจ้าของภาษาที่รอบคอบและเป็นมาตรฐานจะถูกอ่านผิดบ่อยแค่ไหน ซึ่งเป็นคำกล่าวอ้างที่ต่างกันมาก และซื่อสัตย์กว่า “การรับประกัน”
ถาม: ถ้าวิทยานิพนธ์ของฉันถูกแฟล็กโดย Unicheck หรือ Turnitin ในมหาวิทยาลัย จะทำอย่างไร?
ให้มองคะแนนเป็นข้อกล่าวอ้างที่ต้องโต้แย้ง ไม่ใช่ข้อสรุปต่อความจริงของงาน เก็บร่างต้นฉบับและบันทึกของคุณไว้เป็นหลักฐานของกระบวนการ ทำให้งานเขียนของคุณเป็นมนุษย์เพื่อให้อ่านได้เป็นธรรมชาติ และเปิดเผยการใช้ AI ตามนโยบายของสถาบันคุณ แฟล็กจากเครื่องตรวจจับคือจุดเริ่มต้นของการสนทนา ไม่ใช่จุดจบ
ตัวช่วยทำให้งานดูเป็นมนุษย์ที่เข้าใจภาษา โดยยังคงความหมาย, คำศัพท์, และการอ้างอิงของคุณไว้ พร้อมช่วยให้ภาษาอังกฤษที่ไม่ใช่เจ้าของภาษาที่รอบคอบอ่านได้เหมือนงานของมนุษย์

Moe เป็นวิศวกร NLP ที่มี PhD ในการประมวลผลภาษาธรรมชาติ งานวิจัยของเขาครอบคลุมภาษาศาสตร์เชิงคำนวณ การวิเคราะห์ข้อความ และการเรียนรู้ของเครื่อง และป้อนโดยตรงไปยังโมเดลการแก้ไขและการทำให้มีมนุษยธรรมที่อยู่เบื้องหลัง ProofreaderPro เขาเขียนเกี่ยวกับส่วนหนึ่งของกระบวนการที่คนส่วนใหญ่ไม่เคยเห็นมาก่อน เช่น วิธีที่โมเดลภาษาอ่านประโยค ให้คะแนน และตัดสินใจว่าจะเปลี่ยนแปลงอะไร


