
AI Humanizer สำหรับนักวิจัยชาวเช็กที่เขียนภาษาอังกฤษ
AI humanizer สำหรับนักวิจัยชาวเช็ก ช่วยลดการตั้งค่าสัญญาณเตือนว่าเป็นข้อความที่สร้างโดย AI อย่างผิดพลาดจากภาษาอังกฤษที่ได้รับอิทธิพลจากภาษาเช็ก โดยคงความหมายและการอ้างอิงไว้ และเปิดเผยการใช้ AI อย่างตรงไปตรงมา

เช็กเกีย (Czechia) ทำผลงานเกินขนาดของตัวเอง ประเทศขนาดเล็กที่มีฐานการวิจัยขนาดใหญ่ ทำให้ประเทศมีสถานะความเป็นนานาชาติที่แท้จริงในฟิสิกส์ เคมี วิทยาศาสตร์วัสดุ และวิทยาศาสตร์ชีวภาพ ซึ่งส่วนใหญ่เป็นรากฐานจากสถาบันวิชาการแห่งเช็ก (Czech Academy of Sciences) งานเกือบทั้งหมดถูกส่งไปสู่โลกในภาษาอังกฤษ แม้ว่าจะคิดและร่างตั้งต้นเป็นภาษาเช็กแทบทั้งหมดก็ตาม
ช่องว่างระหว่างภาษาที่คุณใช้คิดกับภาษาที่คุณตีพิมพ์ คือจุดที่ปัญหาเริ่มต้นพอดี AI humanizer สำหรับนักวิจัยชาวเช็กมีอยู่ด้วยเหตุผลที่ตรงไปตรงมา กล่าวคือ ภาษาอังกฤษที่เขียนอย่างระมัดระวังและถูกต้องโดยนักวิจัยชาวเช็กในปัจจุบันกลับถูกมองว่าเป็นข้อความของเครื่องจักรโดยระบบตรวจจับอัตโนมัติ และสัญญาณเตือนที่ผิดพลาดเพียงครั้งเดียวในบทความที่สะอาดปราศจากข้อสงสัย อาจทำให้คุณเสียโอกาสการส่งผลงาน เสียเกรด หรือกระทบชื่อเสียงที่คุณใช้เวลาหลายปีกว่าจะสร้างขึ้นมา
ส่วนที่ทำให้ไม่สบายใจคือ สิ่งที่ทำให้ “เช็ก-อังกฤษ” ชัดเจนพอจะตีพิมพ์ได้ สำนวนมาตรฐาน คำศัพท์ที่พบบ่อย และโครงสร้างประโยคที่คาดเดาได้ กลับเป็นนิสัยแบบเดียวกับที่ตัวตรวจจับ AI ถูกฝึกให้มองว่า “น่าสงสัย”
Humanizace AI textu pro české výzkumníky publikující v angličtině
Humanizace AI textu ของเราช่วยนักวิจัยชาวเช็กตีพิมพ์เป็นภาษาอังกฤษได้ โดยไม่ให้ผลงานที่เขียนอย่างพิถีพิถันถูกตรวจจับอย่างไม่เป็นธรรมว่าเป็นงานเขียนด้วยเครื่อง จุดมุ่งหมายคือการคงความหมาย คงศัพท์เทคนิค และคงการอ้างอิงให้ครบถ้วน
พูดให้เข้าใจง่าย: เครื่องมือของเราทำงานกับภาษาอังกฤษที่คุณเขียนไว้แล้วหรือร่างไว้โดยใช้ความช่วยเหลือจาก AI คงข้อโต้แย้งและเอกสารอ้างอิงของคุณไว้โดยไม่เปลี่ยน และปรับจังหวะของถ้อยคำให้ตัวตรวจจับมีโอกาส “อ่านผิด” น้อยลง เครื่องมือนี้ออกแบบมาเพื่อใช้กับงานวิจัยจริง ไม่ใช่เพื่อปลอมแปลงงานที่คุณไม่ได้ทำ คุณสามารถลองใช้ our humanizer ด้วยย่อหน้าที่คุณเขียนเองก่อน แล้วค่อยไว้ใจให้ช่วยกับทั้งต้นฉบับ
เขียนเป็นภาษาเช็กใช่หรือไม่ ระบบตรวจจับอัตโนมัติและทำให้เป็นภาษามนุษย์ได้ทันที
นักวิจัยชาวเช็กมักร่างงานเป็นภาษาแรกก่อนจะเปลี่ยนมาเป็นภาษาอังกฤษ และเครื่องมือ humanizer ถูกออกแบบมาเพื่อสถานการณ์นี้โดยเฉพาะ วางข้อความภาษาเช็กลงไป แล้ว ProofreaderPro จะตรวจจับภาษาได้เอง จากนั้นประมวลผลผ่านโมเดลที่เข้าใจภาษาเช็ก โดยคงเครื่องหมาย háček และเครื่องหมายกำกับเสียงอื่น ๆ ของคุณไว้ คงคำศัพท์เฉพาะของคุณไว้ และคงการอ้างอิงของคุณไว้ในตำแหน่งเดิมอย่างแม่นยำ ผ่าน humanizace AI textu ร่างเช็กของคุณจะถูกทำให้เป็นภาษามนุษย์ได้อย่างง่ายดายพอ ๆ กับภาษาอังกฤษ โดยไม่ต้องแปลมาก่อน การตรวจจับเดียวกันรองรับมากกว่าหกสิบภาษา แต่ละภาษาจะถูกเขียนใหม่ด้วย “เสียง” ของภาษาเดิม
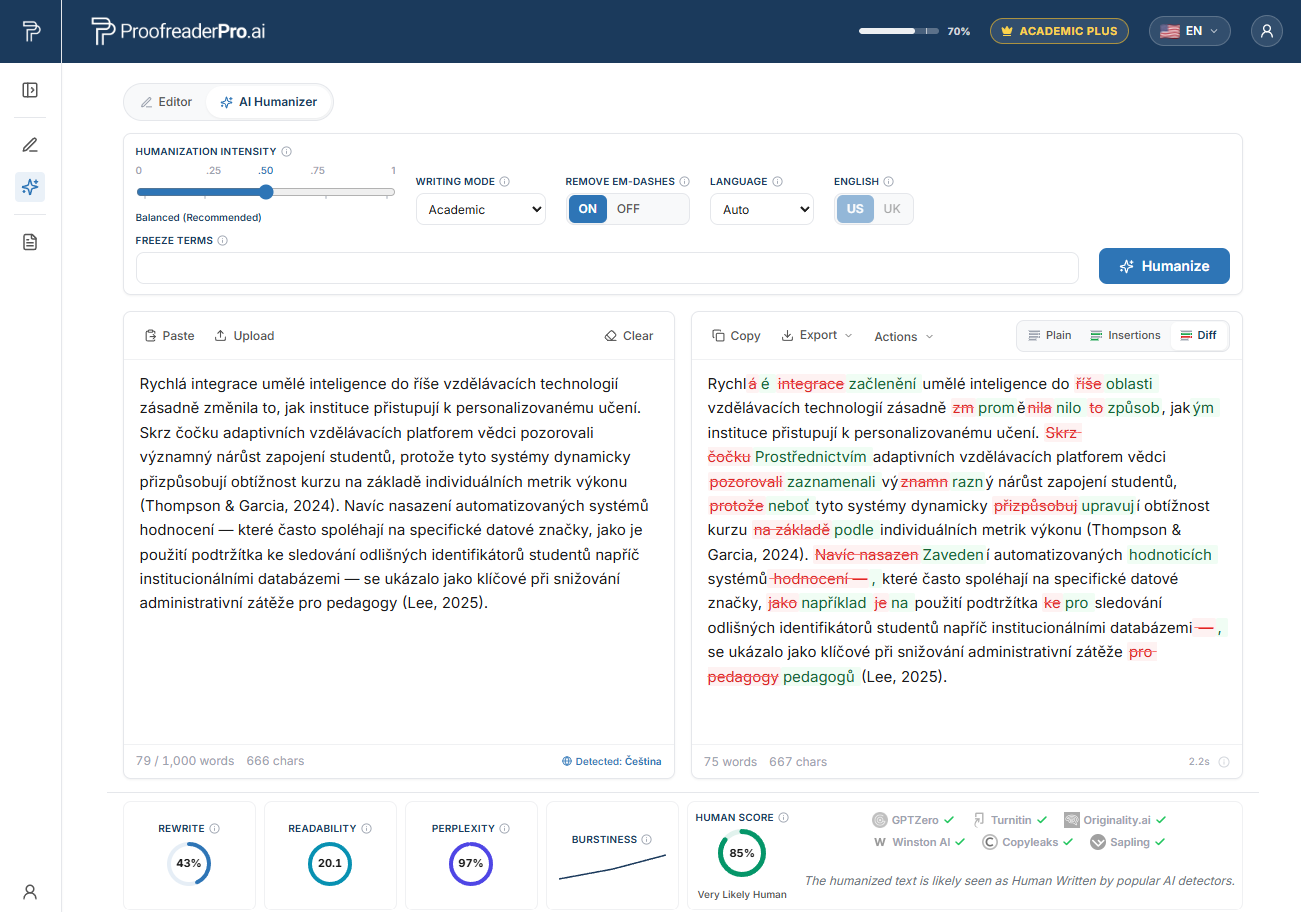
ProofreaderPro AI Humanizer ที่เขียนปรับข้อความวิชาการภาษาเช็กให้เหมือนมนุษย์ ความแตกต่างก่อนและหลัง (diff) จะคงความหมายและการอ้างอิงของคุณไว้ และการตรวจจับของตัวตรวจจับยืนยันว่าการอ่านนั้นเป็นธรรมชาติและเป็นมนุษย์
Why Czech researchers get flagged by AI detectors
ในปี 2023 ทีมงานจาก Stanford นำโดย Weixin Liang เผยแพร่การศึกษาลงในวารสาร Patterns ของ Cell Press โดยใช้ชื่อที่สรุปประเด็นได้ทั้งหมด: "GPT detectors are biased against non-native English writers." นักวิจัยนำเรียงความ TOEFL ที่เขียนโดยมนุษย์ล้วน ๆ แล้วนำไปผ่านตัวตรวจจับ AI ที่เป็นที่นิยมและใช้งานกันอย่างแพร่หลาย 7 ระบบ
ผลลัพธ์นี้ควรทำให้ผู้ที่เขียนภาษาอังกฤษเป็นภาษาที่สองรู้สึกกังวล ในภาพรวม ประมาณ 61% ของเรียงความที่ผู้เขียนไม่ใช่เจ้าของภาษา ถูกตั้งค่าสถานะว่าเป็น AI-generated ขณะที่อยู่ที่ราว 5% สำหรับเรียงความที่เขียนโดยผู้พูดเจ้าของภาษา เกือบหนึ่งในห้า หรือราว 19.8% ของเรียงความที่ไม่ใช่เจ้าของภาษา ถูกทุกตัวตรวจจับยืนยันร่วมกันว่าเป็น AI โดยไม่มีตัวใดคัดค้าน ไม่มีข้อความใดในกลุ่มนี้ที่ถูกเขียนโดยเครื่องจักร
กลไกนี้เรียกว่า perplexity ตัวตรวจจับจำนวนมากให้คะแนนว่าทางเลือกคำใด “คาดไม่ถึง” แค่ไหนเมื่อเทียบกับภาษาที่โมเดลคาดการณ์ได้ นักเขียนที่มั่นใจในภาษา (เจ้าของภาษา) มักกล้าลอง ใช้สำนวน และสลับรูปแบบการเขียนในลักษณะที่โมเดลคาดเดาได้ยาก จึงอ่านออกมาเหมือนมนุษย์ ส่วน “นักวิจัยชาวเช็ก” ที่เขียนอย่างระมัดระวังกลับทำตรงกันข้าม เลือกคำที่ปลอดภัย เลือกโครงสร้างมาตรฐาน และใช้รูปประโยคที่ถูกฝึกฝนในทุกบทเรียนภาษาอังกฤษ ความระมัดระวังนั้นทำให้ perplexity ต่ำ และ perplexity ต่ำเองที่ตัวตรวจจับตีความว่าเป็นข้อความที่มาจากเครื่อง เราอธิบายกลไกทั้งหมดใน why AI detectors flag non-native writers
The Czech first-language patterns behind false flags
เช็กและอังกฤษมีโครงสร้างไวยากรณ์ที่แตกต่างกัน และจุดที่ทั้งสองภาษาไม่สอดคล้องกันจะทิ้งร่องรอยไว้ในภาษาอังกฤษของคุณ สิ่งเหล่านี้ไม่ใช่ “ความผิดพลาดของการคิด” แต่เป็นร่องรอยมาตรฐานที่คาดเดาได้ของความคิดแบบภาษาเช็กที่กำลังเขียนภาษาอังกฤษอย่างรอบคอบ และความสม่ำเสมอนั่นเองที่ทำให้ตัวตรวจจับให้คะแนนเป็น perplexity ต่ำ
Articles that appear and vanish. ภาษาเช็กไม่มี "the" หรือ "a" ดังนั้น article ในภาษาอังกฤษจึงถูกตัด อาจถูกเติม หรืออาจถูกสลับ ทำให้คุณเขียนว่า "result was significant" หรือ "we performed the analysis of the data" พอบรรณาธิการปรับแก้ให้เรียบร้อย ประโยคโดยรอบมักจะยิ่งกลายเป็นสำนวน “ตำรามาตรฐาน” มากขึ้น ซึ่งกลับเพิ่มความเสี่ยงของสัญญาณเตือน แทนที่จะลดลง
Aspect standing in for tense. ไวยากรณ์ภาษาเช็กเน้นที่แง่มุม (perfective และ imperfective) มากกว่าระบบ tense ของอังกฤษ ความแตกต่างระหว่าง past แบบ perfect versus simple past ออกมาจึงไม่สม่ำเสมอ และเมื่อตรวจแก้แล้ว เวอร์ชันที่ถูกต้องมักจะ “กระตุก” ให้เข้ากับตัวเลือก tense ที่โมเดลคาดหวังในแบบที่เป็นธรรมเนียมมากที่สุด
Word order that carries emphasis. ภาษาเช็กอาศัย “รูปลงท้ายกรณี (case endings)” เพื่อสื่อความหมาย และอาศัยลำดับคำเพื่อสื่อจุดเน้น ทำให้โครงสร้างข้อมูลในภาษาอังกฤษอาจถ่ายโอนมาอย่างไม่ลงตัว เมื่อถูกปรับให้เข้ากับรูปแบบมาตรฐาน subject-verb-object ของอังกฤษ ประโยคจะสูญเสียความไม่สามารถคาดเดาได้อย่างพอดีเป๊ะ ซึ่งคือสิ่งที่ตัวตรวจจับอ่านว่าเป็นความเป็นมนุษย์
Countable nouns that go plural. "Informations", "researches", "an advice", "evidences" สิ่งเหล่านี้เป็นเหตุผลเชิงตรรกะในภาษาเช็ก และพบได้ทั่วไปในฉบับร่างที่เป็นเช็ก-อังกฤษ และพอถูกแก้ไขสำนวนให้ตรง ก็จะพอดีไปอยู่ในชุดภาษาที่ตัวตรวจจับถูกฝึกให้เรียนรู้
Prepositions and missing auxiliaries. บุพบท (prepositions) มักโอนไปตรง ๆ จากภาษาเช็ก และกริยาช่วย "do" หรือ "does" ก็จะหายไปในคำถามและประโยคปฏิเสธ เมื่อถูกแก้ไข โครงสร้างเหล่านี้จะกลายเป็นภาษาที่เรียบ สะอาด และเป็นแบบแผนทั่วไป ซึ่งเป็น “โปรไฟล์” ที่อ่านออกมาเป็น perplexity ต่ำพอดี
Czechia's AI-detection and Turnitin context
วิทยานิพนธ์และบทความวารสารในเช็กเกียมักถูกคัดกรองทั้งความคล้ายคลึง (similarity) และข้อความที่สร้างโดย AI ระบบระดับชาติหลายแห่งในเช็กเกียใช้โครงสร้างพื้นฐานร่วมกัน คือ Theses.cz และ Odevzdej.cz ซึ่งประสานงานโดย Masarykova univerzita และ Turnitin ถูกใช้ร่วมกันอย่างแพร่หลาย
สถาบันในเช็กเกียได้ออกแนวทางเกี่ยวกับ generative AI ของตนเอง และทิศทางของเรื่องนี้ชัดเจน: ผู้สนับสนุนทุนและวารสารต่างคาดหวังมากขึ้นเรื่อย ๆ ว่าคุณจะต้องเปิดเผยว่าคุณใช้ AI อย่างไร สภาพแวดล้อมเช่นนี้สมเหตุสมผล ปัญหาไม่ได้อยู่ที่การเปิดเผย ซึ่งทำได้ทั้งง่ายและซื่อสัตย์ ปัญหาคือ “คะแนนจากตัวตรวจจับ” ถูกปฏิบัติราวกับเป็นคำตัดสิน ทั้งที่ในความเป็นจริง มันคือการเดาเชิงสถิติที่มักจะพลาดที่สุดกับงานภาษาอังกฤษที่ไม่ใช่เจ้าของภาษาอย่างระมัดระวัง ซึ่งนักวิจัยชาวเช็กถูกฝึกให้ผลิตออกมา
สิ่งที่ควรจำไว้คือ แม้แต่ผู้จำหน่ายตัวตรวจจับก็ยังมีการ “วางหมากป้องกัน” Turnitin จะซ่อนคะแนนของตนเองในช่วงค่าต่ำ และเตือนว่าตัวเลขไม่ควรถูกใช้เพียงอย่างเดียวเพื่อการตัดสินเรื่องความซื่อสัตย์ หลายมหาวิทยาลัยรวมถึง Vanderbilt ไปไกลกว่านั้นอีกขั้น โดยปิดตัวตรวจจับ AI ทั้งหมด โดยอ้างถึงผลบวกลวงและอคติที่มีต่อผู้เขียนที่ไม่ใช่เจ้าของภาษา สัญญาณเตือนคือ “ข้อกล่าวอ้างที่ต้องโต้แย้ง” ไม่ใช่คำสารภาพ
ปกป้องงานเขียนภาษาอังกฤษแบบเช็กของท่านจากการตรวจพบ AI แบบผิดพลาด
วางย่อหน้าบทความงานวิจัยของท่านเอง แล้วดูว่าเครื่องมือทำให้เป็นมนุษย์ช่วยคงความหมายและการอ้างอิงของท่าน พร้อมลดโอกาสที่ตัวตรวจจับจะตีความผิดกับภาษาอังกฤษที่รอบคอบซึ่งไม่ใช่ภาษาแม่
ลองใช้ Humanizer ฟรีTop Czech universities and where AI checks appear
หากคุณเรียน สอน หรือส่งผลงานในเช็กเกีย งานของคุณจะผ่านหนึ่งในสถาบันเหล่านี้ และทุกแห่งมีการคัดกรองวิทยานิพนธ์และต้นฉบับเพื่อความคล้ายคลึง รวมถึงให้ความสำคัญกับตัวบ่งชี้ที่เกี่ยวกับ AI มากขึ้นเรื่อย ๆ
- Univerzita Karlova (Charles University), ปราก (Prague)
- České vysoké učení technické v Praze (ČVUT, Czech Technical University), ปราก (Prague)
- Masarykova univerzita (Masaryk University), เบอร์โน (Brno)
- Univerzita Palackého v Olomouci (Palacký University), โอลอูมุค (Olomouc)
- Vysoké učení technické v Brně (VUT, Brno University of Technology), เบอร์โน (Brno)
- Vysoká škola chemicko-technologická v Praze (VŠCHT, University of Chemistry and Technology), ปราก (Prague)
- Vysoká škola báňská, Technická univerzita Ostrava (VŠB-TUO), ออสตราวา (Ostrava)
- Mendelova univerzita v Brně (Mendel University), เบอร์โน (Brno)
- Jihočeská univerzita v Českých Budějovicích (University of South Bohemia), เชสเกบูเดยอวิซ (České Budějovice)
- Univerzita Pardubice, พาร์ดูบิซ (Pardubice)
ความเสี่ยงต่างกันตามประเภทเอกสาร การปฏิเสธต้นฉบับบทความวารสารอาจทำให้คุณเสียเวลาไปหลายเดือน หากวิทยานิพนธ์ถูกตั้งค่าสถานะที่ Univerzita Karlova หรือ Masarykova univerzita อาจนำไปสู่การไต่สวนที่ทำให้ “ความซื่อสัตย์” ของคุณถูกนำขึ้นพิจารณา แทนที่จะเป็นไวยากรณ์ของคุณ นี่คือบทสนทนาที่ไม่ควรเกิดขึ้นจากผลบวกลวง
AI Humanizer สำหรับนักวิจัยชาวเช็กทำงานอย่างไร
เวิร์กโฟลว์ที่ซื่อสัตย์ทำได้ง่าย และการเปิดเผยอยู่ตรงกลาง ไม่ใช่อยู่ชายขอบ
เริ่มจากจุดที่คุณแข็งแรงที่สุด ร่างเป็นภาษาเช็กหากนั่นคือวิธีที่คุณคิดได้ดีที่สุด แล้วค่อยแปล หรือร่างเป็นภาษาอังกฤษโดยใช้ความช่วยเหลือจาก AI ก่อน ปรับให้วิทยาศาสตร์ถูกต้องก่อน จากนั้นแก้ไวยากรณ์เพื่อให้ความหมายชัดเจนและแม่นยำ หลังจากนั้นค่อยนำข้อความไปผ่าน AI humanizer สำหรับนักวิจัยชาวเช็ก ซึ่งจะปรับจังหวะและทางเลือกคำ เพื่อให้ “ภาษาอังกฤษมาตรฐานที่คุณตั้งใจเขียน” มีโอกาสถูกอ่านผิดโดยตัวตรวจจับน้อยลง ขณะเดียวกัน ความหมาย คำศัพท์เฉพาะ และการอ้างอิงของคุณจะยังคงอยู่เหมือนที่คุณเขียนไว้ทุกประการ
คุณคาดหวังอะไรได้บ้าง? จากการทดสอบของเราเอง เครื่องมือ humanizer ลดความถี่ที่ภาษาอังกฤษที่ไม่ใช่เจ้าของภาษาและเขียนอย่างระมัดระวังถูกอ่านผิดโดยตัวตรวจจับหลัก ๆ อย่างมีนัยสำคัญ รวมถึง Turnitin, Originality.ai และ GPTZero โดยไม่ไปแตะต้องข้อโต้แย้งของคุณ เรานิยามผลลัพธ์นี้ว่าเป็นสิ่งที่เราเห็นจากการทดสอบ ไม่ใช่คำสัญญา ตัวตรวจจับจะฝึกใหม่ทุกไม่กี่เดือน และไม่มีเครื่องมือที่ซื่อสัตย์ใดสามารถสัญญาว่าจะตรวจไม่พบได้ 100% คนที่รับประกันแบบนั้นกำลังขายอะไรบางอย่างให้กับคุณ
ข้อความที่ไม่ใช่ภาษาอังกฤษก็สำคัญเช่นกัน เพราะ humanizer รองรับมากกว่า 60 ภาษา และส่งข้อความที่ไม่ใช่ภาษาอังกฤษผ่านโมเดลที่รับรู้ภาษา ทำให้คุณทำงานกับร่างเช็กหรือโน้ตแบบหลายภาษาร่วมกันได้ โดยไม่ทำให้โครงสร้างประโยคของคุณถูกทำให้แบนลง ช่องนี้แทรกอยู่ใน multilingual AI humanizer hub ของเรา และจับคู่ได้อย่างเป็นธรรมชาติกับการแก้ไขแบบลงมือทำจาก global academic editing hub ของเรา เมื่อใดที่ต้นฉบับต้องการ “สายตาของมนุษย์” ด้วย
จากนั้นก็มาถึงขั้นตอนที่ทำให้ทั้งระบบยังซื่อสัตย์อยู่: เปิดเผยการใช้ AI ของคุณในรูปแบบที่สถาบันและวารสารเป้าหมายของคุณกำหนด การทำให้ร่างของคุณเป็นภาษามนุษย์ช่วยปกป้องงานเขียนที่ชัดเจนจากสัญญาณเตือนที่ไม่เป็นธรรม การเปิดเผยวิธีการทำให้คุณอยู่ในกติกา คุณทำทั้งสองอย่าง และคุณไม่มีอะไรต้องปิดบัง
Local funding bodies, journals, and AI-disclosure expectations
เงินทุนวิจัยของเช็กดำเนินไปเป็นส่วนใหญ่ผ่านองค์กรหลักสามกลุ่ม และแต่ละกลุ่มต่างคาดหวังความโปร่งใสเกี่ยวกับการใช้ AI มากขึ้นเรื่อย ๆ GAČR (Grantová agentura České republiky, the Czech Science Foundation) สนับสนุนงานวิจัยพื้นฐาน TAČR (Technologická agentura České republiky, the Technology Agency) สนับสนุนงานวิจัยประยุกต์ AV ČR (Akademie věd České republiky, the Czech Academy of Sciences) ดำเนินสถาบันระดับชาติซึ่งเป็นแหล่งกำเนิดผลงานจำนวนมากของประเทศ
ในมุมของการตีพิมพ์ จุดที่มีแรงกดดันไปในทิศทางเดียวกัน การประเมินระดับชาติและงบประมาณของสถาบันให้รางวัลกับผลงานในวารสารที่ติดดัชนี Web of Science และ Scopus และผลการวิจัยจะถูกส่งเข้าระบบทะเบียนข้อมูล R&D ระดับชาติ RIV สิ่งนี้จะให้คุณค่าแก่การตีพิมพ์เป็นภาษาอังกฤษ ซึ่งจะพาคุณวนกลับไปสู่ปัญหา “สัญญาณเตือนแบบผิดพลาด” ที่บทความนี้เริ่มต้นกับมัน
ลองทบทวนสิ่งที่ตัวเลขบอกเราอยู่แล้วเกี่ยวกับกำแพงนี้ ผู้พูดภาษาอังกฤษที่ไม่ใช่เจ้าของภาษาเผชิญอัตราการถูกปฏิเสธสูงกว่าผู้พูดเจ้าของภาษาเกือบ 2.5 เท่า ใช้เวลาร่างบทความประมาณ 51% มากกว่า และใช้เวลาอ่านมากกว่าประมาณ 91% และได้รับคำขอให้แก้ไขที่ผูกกับคุณภาพด้านภาษาเกือบ 12.5 เท่า น้อยกว่า 7% ของวารสารทั้งหมดที่รับบทความที่ไม่ใช่ภาษาอังกฤษตั้งแต่แรก ระบบบังคับให้นักวิจัยชาวเช็กแข่งขันในภาษาอังกฤษ แล้วลงโทษภาษาอังกฤษที่ “เขียนอย่างระมัดระวัง” ซึ่งการแข่งขันนั้นเป็นผู้ผลิตขึ้น Humanizing your own draft โดยคงการอ้างอิงไว้และเปิดเผยวิธีการ คือการตอบสนองที่เป็นธรรมต่อสถานการณ์ที่ไม่เป็นธรรม ไม่ใช่ทางลัดเพื่อหลีกเลี่ยง ใช้ the humanizer เป็นหนึ่งในเครื่องมือในเวิร์กโฟลว์ที่ซื่อสัตย์นี้
Frequently asked questions
Q: Does using an AI humanizer for Czech researchers count as cheating?
ไม่ ไม่ใช่ เมื่อคุณใช้มันอย่างซื่อสัตย์ คุณกำลังปรับจังหวะของร่างที่ช่วยด้วย AI ของตนเอง คงความหมายและการอ้างอิงไว้ แล้วจึงเปิดเผยการใช้ AI ตามที่สถาบันและวารสารของคุณกำหนด นี่คือการแก้ไขด้านภาษาและความโปร่งใส ไม่ใช่การหลอกลวง มันจะเป็นปัญหาเฉพาะเมื่อคุณพยายามทำให้คนอื่นเข้าใจผิดว่าเป็นงานที่คุณไม่ได้ทำ หรือพยายามปกปิดการใช้ AI ที่คุณถูกขอให้เปิดเผย
Q: Will the humanizer change my technical terms or my citations?
ไม่ เครื่องมือนี้ออกแบบมาเพื่อคงความหมายเชิงวิชาการ คงศัพท์เฉพาะ และคงตัวชี้อ้างอิง ขณะที่จะปรับจังหวะของประโยคและทางเลือกคำเท่านั้น สายเคมีของคุณยังคงเป็นเคมี และการอ้างอิงของคุณยังอยู่ในตำแหน่งเดิม คุณควรพิสูจน์อักษร (proofread) เวอร์ชันสุดท้ายต่อไป เพราะคุณยังคงเป็นผู้เขียนที่รับผิดชอบต่อทุกคำ
Q: Can you guarantee my paper will pass Turnitin or GPTZero?
ไม่ได้ และคุณก็ควรไม่เชื่อใครก็ตามที่พูดเช่นนั้น ตัวตรวจจับได้รับการฝึกใหม่อย่างต่อเนื่อง ดังนั้นจึงไม่มีเครื่องมือที่ซื่อสัตย์ใดรับประกันการตรวจไม่พบได้ 100% สิ่งที่เราพูดได้คือ จากการทดสอบของเรา humanizing ภาษาอังกฤษที่ไม่ใช่เจ้าของภาษาและเขียนอย่างระมัดระวัง ช่วยลดความถี่ที่ตัวตรวจจับหลักอ่านผิดอย่างมีนัยสำคัญ ขณะเดียวกันก็ยังคงความหมายของคุณไว้ครบถ้วน
Q: Why does my correct Czech-English get flagged in the first place?
เพราะงานเขียนภาษาอังกฤษแบบภาษาที่สองที่ระมัดระวังมักมี perplexity ต่ำ คุณเลือกคำที่ปลอดภัยและโครงสร้างมาตรฐาน และตัวตรวจจับมองความคาดเดาได้นั้นเหมือน “ข้อความที่สร้างโดยเครื่อง” การศึกษาของ Stanford พบว่าเรียงความที่ผู้เขียนไม่ใช่เจ้าของภาษาเขียนเอง (human-written) ถูกตั้งค่าสถานะว่าเป็น AI มากกว่าเจ้าของภาษา ซึ่งบ่งชี้ว่าอคติอยู่ที่ตัวตรวจจับ ไม่ใช่ที่งานเขียนของคุณ
Q: Do I still have to tell my university or journal that I used AI?
ใช่ เมื่อใดก็ตามที่พวกเขาถาม และแนวโน้มคือพวกเขาถามมากขึ้นเรื่อย ๆ การทำให้ร่างของคุณเป็นภาษามนุษย์เกี่ยวกับความเป็นธรรม ไม่ใช่การปิดบัง ดังนั้นจึงเป็นเรื่อง “การเปิดเผย” ไม่ใช่เป็นช่องโหว่ คุณควรระบุอย่างชัดเจนว่าคุณใช้ AI ในขั้นตอนร่างและการแก้ไขอย่างไร และคุณจะอยู่ในด้านที่ถูกต้องทั้งตามกติกาด้านความซื่อสัตย์และตามความสบายใจของตัวคุณเอง
ลดการตรวจพบ AI แบบผิดพลาดสำหรับภาษาอังกฤษเชิงวิชาการแบบเช็กที่รอบคอบ โดยยังคงความหมาย คำศัพท์ และการอ้างอิงไว้ จากนั้นเปิดเผยการใช้งาน AI ของท่านอย่างมั่นใจ

Moe เป็นวิศวกร NLP ที่มี PhD ในการประมวลผลภาษาธรรมชาติ งานวิจัยของเขาครอบคลุมภาษาศาสตร์เชิงคำนวณ การวิเคราะห์ข้อความ และการเรียนรู้ของเครื่อง และป้อนโดยตรงไปยังโมเดลการแก้ไขและการทำให้มีมนุษยธรรมที่อยู่เบื้องหลัง ProofreaderPro เขาเขียนเกี่ยวกับส่วนหนึ่งของกระบวนการที่คนส่วนใหญ่ไม่เคยเห็นมาก่อน เช่น วิธีที่โมเดลภาษาอ่านประโยค ให้คะแนน และตัดสินใจว่าจะเปลี่ยนแปลงอะไร


