
OpenAI, Google และ Anthropic ล้วนสร้างเทคโนโลยีเดียวกัน: ตราประทับแบบสถิติสำหรับข้อความที่สร้างโดย AI OpenAI เก็บเวอร์ชันของตนไว้เป็นเวลาหลายปี แล้วเริ่มทยอยปล่อยออกมาในชื่อ textGrain ในเดือนตุลาคม 2026 Google ส่ง SynthID มาพร้อมกับ Gemini และเผยแพร่วิธีการ Anthropic ทำให้ตราประทับของ Claude เป็นสิ่งที่บังคับสำหรับผู้ใช้ทุกคนในเดือนสิงหาคม 2026 หากคุณเขียนโดยใช้ความช่วยเหลือจาก AI ไม่ว่ารูปแบบใด การตัดสินใจทั้งสามนี้ล้วนกำหนดว่าเอกสารของคุณจะถูกประเมินอย่างไร
การประทับรอยย้ายจากหัวข้อวิจัยไปสู่กระแสหลักในข่าวเมื่อวันที่ 11 สิงหาคม 2026 เมื่อ Anthropic ประกาศว่าทุกรุ่น Claude ใหม่จะประทับรอยบนเอาต์พุตข้อความของตน เราอธิบายประกาศนั้นอย่างละเอียดใน ตัวอธิบายตราประทับของ Claude คู่มือนี้ครอบคลุมภาพรวมทั้งหมด ว่าตราประทับข้อความคืออะไร แต่ละแล็บหลักทั้งสามได้นำไปใช้หรือระงับไว้ และระบบแต่ละแบบบอกอะไรได้บ้างเกี่ยวกับงานเขียนชิ้นหนึ่ง
ตราประทับข้อความของ AI คืออะไร
ตราประทับข้อความของ AI คือรูปแบบเชิงสถิติที่ซ่อนอยู่ใน การเลือกคำ ของข้อความที่สร้างขึ้น โดยฝังไว้ในช่วงเวลาที่สร้าง เพื่อให้ตัวตรวจจับที่มีคีย์ที่ถูกต้องสามารถตรวจสอบภายหลังได้ว่าข้อความนั้นมาจากระบบ AI เฉพาะเจาะจง มันไม่ใช่ป้ายที่มองเห็นได้ ไม่ใช่อักขระที่ซ่อนอยู่ และไม่ใช่เมทาดาทาที่แนบมากับไฟล์ รอยนั้นอยู่ในคำของตัวข้อความเอง
ความแตกต่างนี้สำคัญ เพราะคำว่า "watermark" ถูกนำมาใช้แบบหลวม ๆ สำหรับสิ่งที่แตกต่างกันสามอย่าง:
| มันคืออะไร | อยู่ตรงไหน | คงอยู่หลังคัดลอกวาง? | |
|---|---|---|---|
| ตราประทับเชิงสถิติ | อคติที่ทำให้โมเดลเลือกคำ | ตัวข้อความเอง | ใช่ |
| เมทาดาทาไฟล์ (C2PA) | ป้ายแหล่งที่มาที่ลงนาม | ภาชนะของไฟล์ | ไม่ ตัวคัดลอกข้อความล้วนจะตัดมันออก |
| อักขระแบบไม่มีความกว้าง | แทรกยูนิโค้ดที่มองไม่เห็นลงในข้อความ | ระหว่างอักขระที่มองเห็นได้ | ไม่ แทบจะถูกลบออกได้อย่างง่ายดาย |
การทำเครื่องหมายด้วยลายน้ำเชิงสถิติคือเพียงวิธีเดียวจากทั้งหมดสามวิธีที่ยังคงอยู่หลังจากคัดลอก วาง พิมพ์ซ้ำ หรือแปลงรูปแบบไปเป็นเอกสารใหม่ นั่นเป็นเหตุผลที่ทั้งสามห้องแล็บหลักจึงมาบรรจบกันที่วิธีนี้สำหรับข้อความ และเป็นเหตุผลที่ "ตัวลบลายน้ำ" ที่ตัดอักขระที่มองไม่เห็นออกไม่ได้ผลต่อมัน หน้า ตัวลบลายน้ำ Claude แบบฟรี ของเรารวบรวมกรณีที่วิธีนี้ล้มเหลว พร้อมแหล่งอ้างอิงไว้
การทำลายน้ำเชิงสถิติทำงานอย่างไรจริงๆ?
ทุกครั้งที่เขียนประโยค โมเดลภาษาจะเลือกคำที่ใกล้เคียงกันหลายคำ และลายน้ำจะค่อยๆ โหลดการสุ่มตัวเลือกเหล่านั้นไว้ สูตรตั้งต้นได้รับการเผยแพร่โดย Kirchenbauer และคณะจาก University of Maryland ในเดือนมกราคม 2023 ใน A Watermark for Large Language Models (ICML 2023) มันทำงานแบบนี้:
- ก่อนที่จะเลือกคำ คีย์ลับที่ได้จากคำก่อนหน้าจะใช้แยกคำศัพท์ออกเป็นชุดที่ต้องการและชุดที่เป็นกลาง
- โมเดลจะปรับการตัดสินใจให้ไปทางชุดที่ต้องการ "Suggest" แทน "indicate" "Across" แทน "among" การเลือกแต่ละครั้งดูเป็นธรรมชาติอย่างสมบูรณ์
- ตัวตรวจจับที่มีคีย์จะนับว่าข้อความไปลงในชุดที่ต้องการบ่อยแค่ไหน ข้อความที่มนุษย์เขียนจะเข้าถึงอัตราที่คาดไว้ได้ด้วยการเดาเท่านั้น ข้อความที่ใส่ลายน้ำจะสูงกว่ามากเกินไป และการทดสอบทางสถิติจะชี้ความคลาดเคลื่อนนั้น
ไม่มีคำใดคำเดียวเป็นหลักฐานของสิ่งใดๆ สัญญาณจะปรากฏเมื่อมองรวมกันหลายสิบหรือหลายร้อยครั้งของการเลือก นี่จึงทำให้ข้อความที่ยาวทดสอบได้ง่ายกว่าข้อความสั้น และทำไมการตรวจจับจึงเป็นเชิงความน่าจะเป็นเสมอ ไม่ใช่ตรายืนยันแบบใช่หรือไม่
ระบบผลิตในระดับการใช้งานจริงของ Google DeepMind เผยแพร่ใน Nature ในเดือนตุลาคม 2024 ใน การทำลายน้ำแบบปรับขนาดได้เพื่อระบุผลลัพธ์ของโมเดลภาษาขนาดใหญ่ ซึ่งได้รับการพัฒนาต่อด้วยเทคนิคที่เรียกว่า tournament sampling โดยช่วยรักษาคุณภาพของข้อความได้ดีพอที่จะทำงานแบบเงียบๆ ภายในผลิตภัณฑ์สำหรับผู้บริโภคในระดับการใช้งานจริงอย่างกว้างขวาง กระดาษฉบับนี้สำคัญเกินกว่าของ Google เพราะเป็นฐานที่เผยแพร่ซึ่ง Anthropic อ้างถึงสำหรับการนำไปใช้ของ Claude
จุดอ่อนหลักถูกเผยแพร่ก่อนที่จะมีการใช้งานจริงเป็นส่วนใหญ่ ในเดือนมีนาคม 2023 Krishna และทีมงานแสดงใน การถอดความหลบเลี่ยงตัวตรวจจับข้อความที่สร้างโดย AI (NeurIPS 2023) ว่าการเขียนถ้อยคำใหม่ของเนื้อหาทำให้การตรวจจับพังลงในหลายวิธี รวมถึงการทำลายน้ำด้วย สัญญาณอยู่ในลำดับโทเค็นแบบตรงตามที่เป็นอยู่เท่านั้น และไม่มีที่อื่น ดังนั้นสิ่งใดก็ตามที่เขียนทับลำดับนี้ ไม่ว่าจะเป็นการรีไรต์โดยมนุษย์หรือนักแก้ไขข้อความ ก็จะเขียนหลักฐานออกไปให้หมด ผู้ให้บริการทุกรายที่นำลายน้ำออกจำหน่ายในปัจจุบันระบุข้อจำกัดนี้ไว้ในเอกสารของตนเอง

OpenAI: บริษัทที่เป็นผู้คิดค้นและเผยแพร่เป็นรายสุดท้าย
OpenAI มีลายน้ำข้อความที่ใช้งานได้จริงมาหลายปี และเลือกที่จะไม่ปล่อยให้สาธารณะใช้จนกระทั่งเดือนตุลาคม 2026 Scott Aaronson ซึ่งขณะนั้นทำงานด้านความปลอดภัยที่ OpenAI ได้อธิบายแนวคิดนี้ต่อสาธารณะครั้งแรกใน การบรรยายเดือนพฤศจิกายน 2022 วิธีนี้ทำให้การเลือกของโมเดลเอนเอียงระหว่างคำที่ใกล้เคียงกันด้วยฟังก์ชันเข้ารหัสลับ ทำให้ตัวข้อความเองบอกได้ว่ามาจากที่ใด การบรรยายครั้งนั้นเก่ากว่าแทบทุกรายการระบบที่ใช้งานจริงทั้งหมด
ในเดือนพฤษภาคม 2024 OpenAI ได้อธิบายสถานะของโปรเจกต์ในการอัปเดตเรื่อง provenance โดย ทำความเข้าใจแหล่งที่มาของสิ่งที่เราเห็นและได้ยินบนโลกออนไลน์ บริษัทระบุว่าวิธีการฝังลายน้ำในข้อความมีความแม่นยำและได้ผลกับการแก้ไขเพียงเล็กน้อย แต่บริษัทตัดสินใจชะลอการปล่อยออกไปในขณะที่ประเมินข้อแลกเปลี่ยน สองในความเสี่ยงที่ OpenAI ยกมานั้นส่งผลโดยตรงต่อผู้เขียนเชิงวิชาการ:
- หลีกเลี่ยงได้ง่าย. การถอดความหรือการแปลข้อความจะลบรอยออกไปได้ ตามที่งานวิจัยปี 2023 คาดการณ์ไว้ รอยดิจิทัลที่จับได้เป็นหลักกับคนที่ไม่รู้ว่าระบบนี้มีอยู่จึงเป็นเครื่องมือบังคับใช้ที่อ่อน
- ผลกระทบไม่สมส่วนต่อผู้ใช้ที่ไม่ใช่เจ้าของภาษาอังกฤษ. OpenAI ระบุว่าการฝังรอยดิจิทัลอาจทำให้การใช้งาน AI อย่างถูกต้องตามวัตถุประสงค์ในฐานะเครื่องมือช่วยการเขียนสำหรับผู้ที่เขียนในภาษาอังกฤษเป็นภาษาที่สองเกิดตราหน้า ชิ้นงานของเราเกี่ยวกับ เหตุใด AI detectors จึงตรวจพบผู้เขียนที่ไม่ใช่เจ้าของภาษา อธิบายปัญหาเดียวกันจากมุมมองของตัวตรวจจับ
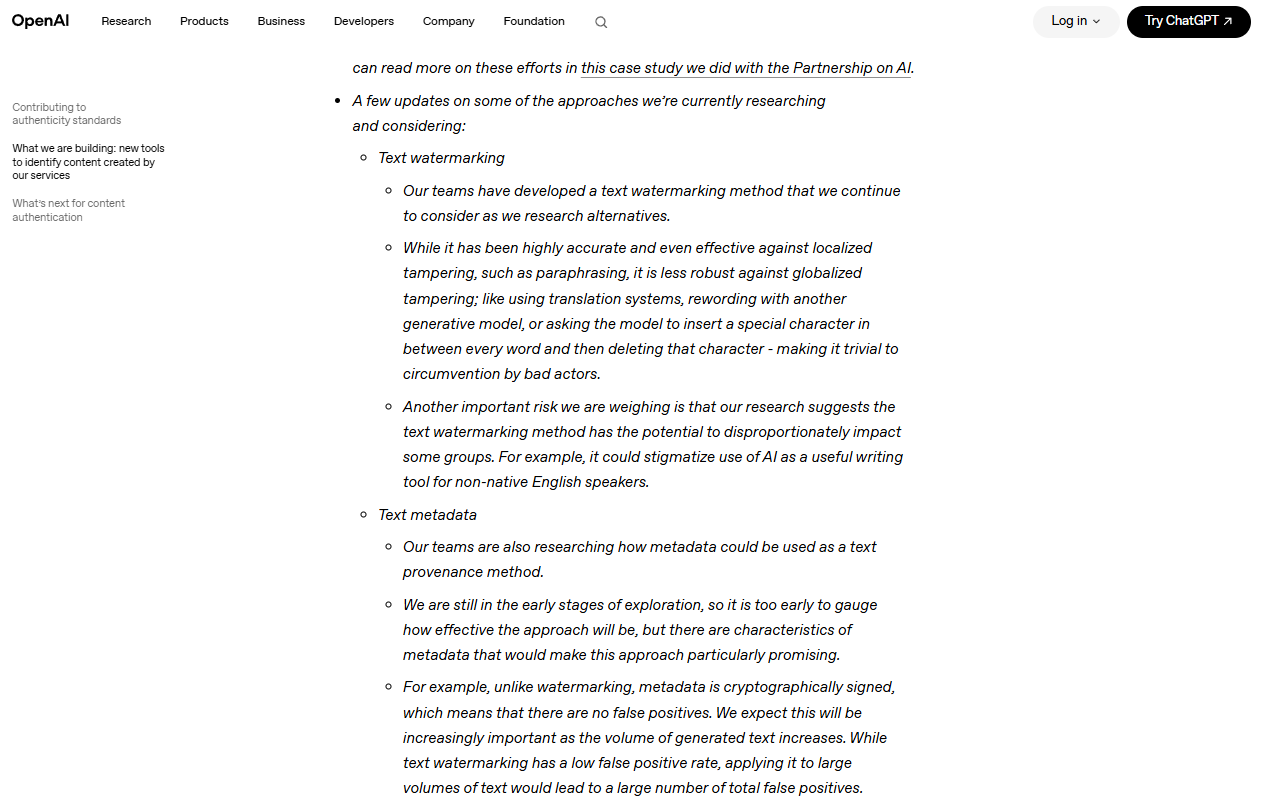
อัปเดต provenance ปี 2024 ของ OpenAI: วิธีการใช้ได้ และบริษัทระบุเหตุผลที่ชะลอไว้ในตอนนั้น.
สำหรับภาพและเสียง OpenAI ใช้วิธีที่แตกต่างออกไป: C2PA provenance metadata ในผลลัพธ์ของ DALL-E และ Sora ซึ่งเป็นป้ายกำกับในระดับไฟล์ ไม่ใช่รอยในตัวเนื้อหา เทคโนโลยีที่บริษัทเสนอนั้นเป็นรายสุดท้ายในสามรายที่นำไปใช้งาน สำหรับข้อความนั้นผลลัพธ์จาก ChatGPT ไม่มีรอยดิจิทัลจนถึงเดือนตุลาคม 2026
ตอนนี้ OpenAI ฝังรอยดิจิทัลในข้อความหรือยัง?
ใช่ OpenAI เริ่มฝังรอยดิจิทัลในข้อความบางส่วนเมื่อวันที่ 5 ตุลาคม 2026 เพื่อรองรับ EU AI Act โดย ประกาศ แนะนำรอยดิจิทัลในข้อความที่เรียกว่า textGrain ซึ่งเพิ่มสัญญาณเชิงสถิติที่มองไม่เห็นให้กับการเลือกคำของโมเดล การเปิดให้ใช้งานมี 3 ส่วน และรอยดิจิทัลไม่ได้เปิดเป็นค่าเริ่มต้นทั่วโลก:
- ลูกค้าของ API ทุกที่สามารถเปิดใช้งานผลลัพธ์ที่มีการฝังรอยดิจิทัลสำหรับโมเดลที่เลือกไว้ ระบบจะปิดไว้โดยค่าเริ่มต้น
- ในช่วงสัปดาห์ถัดไป ผลลัพธ์ข้อความของ ChatGPT และ Codex ที่มีคุณสมบัติเหมาะสมในสหภาพยุโรปจะได้รับการฝังรอยดิจิทัลในทุกแพ็กเกจ
- นักวิจัยที่ได้รับอนุมัติและองค์กรผู้เชี่ยวชาญสามารถยื่นขอการเข้าถึงเครื่องมือตรวจจับรอยดิจิทัลในข้อความได้
OpenAI ระบุว่า textGrain ทำได้เท่ากับหรือดีกว่าวิธีอื่นที่บริษัททดสอบ รวมถึง SynthID สำหรับข้อความของ Google บริษัทเผยแพร่ด้วยว่าการตรวจจับจะอ่อนลงตรงไหน เมื่ออัตราการตรวจพบผิดพลาดที่ 1% ตัวตรวจจับสามารถระบุรอยดิจิทัลได้ราว 80% ของช่วงข้อความ 200 คำ และราว 95% ของช่วงข้อความ 400 คำในเนื้อหาด้านจิตวิทยา การตรวจจับต่ำกว่ามากในงานด้านคณิตศาสตร์ ซึ่งมีอิสระในการเลือกคำค่อนข้างน้อย
การแก้ไขทำให้สัญญาณอ่อนลงอย่างรวดเร็ว ในช่วงข้อความ 400 คำ การแทนที่คำ 10% ด้วยคำพ้องทำให้การตรวจจับลดจากประมาณ 92% เหลือ 66% และเมื่อแทนที่ 25% จะลดลงเหลือ 17%
OpenAI ยังตรวจสอบว่ารอยดิจิทัลเปลี่ยนคุณภาพของคำตอบหรือไม่บน Astra ซึ่งเป็นโมเดลล่าสุดของบริษัท และระบุว่าไม่พบความแตกต่างอย่างมีนัยสำคัญ นี่คือ 4 ในบรรดาเกณฑ์วัดผล (benchmarks) ที่บริษัทเผยแพร่:
| Benchmark | Without watermark (Astra) | With watermark (Astra) |
|---|---|---|
| Artificial Analysis Intelligence Index | 49.57 คะแนน | 49.76 คะแนน |
| GPQA Diamond | 94.44% | 93.94% |
| HealthBench Professional | 64.27% | 64.60% |
| BrowseComp | 87.92% | 87.35% |
สำหรับนักศึกษา วันที่มีความสำคัญ ข้อความของ ChatGPT ที่เขียนมาก่อนการเปิดใช้งาน หรืออยู่นอกสหภาพยุโรปโดยไม่ได้เปิดการตั้งค่าในส่วน API จะไม่มีรอยดิจิทัลของ OpenAI คู่มือของเราเกี่ยวกับ ทำความเข้าใจ Turnitin Clarity อธิบายว่าสถาบันการศึกษากำลังกำหนดนโยบายการใช้ AI ของตนเองอย่างไรในระหว่างนี้
มีเครื่องมือตรวจสอบรอยดิจิทัลของ OpenAI แบบสาธารณะหรือไม่?
ยังไม่มีเครื่องมือตรวจสอบลายน้ำของ OpenAI แบบสาธารณะสำหรับข้อความในตอนนี้ เครื่องมือ ตรวจสอบการยืนยัน ฟรีของ OpenAI จะตรวจไฟล์ภาพและเสียงสำหรับ C2PA Content Credentials และสำหรับลายน้ำ SynthID ซึ่ง OpenAI ฝังไว้ในภาพและไฟล์เสียงที่รองรับ OpenAI ระบุว่าเครื่องมือนี้ไม่รองรับข้อความ
สำหรับข้อความ OpenAI ให้สิทธิ์การเข้าถึงเครื่องมือตรวจจับแบบพิจารณาเป็นรายกรณีแก่ผู้วิจัยที่ได้รับอนุมัติและองค์กรผู้เชี่ยวชาญ ผ่าน แบบฟอร์ม Content Provenance API ระบุว่า จะยังไม่ทำเครื่องมือตรวจจับข้อความให้สาธารณะในช่วงเปิดตัว เนื่องจากความเสี่ยงของการพลาดลายน้ำและผลบวกลวง เครื่องมือตรวจจับรายงานได้ว่าเจอลายน้ำของ OpenAI หรือไม่ และไม่สามารถระบุตัวผู้ใช้หรือแสดงพรอมต์ของพวกเขาได้
| สิ่งที่คุณต้องการตรวจสอบ | เครื่องมือ | ใครใช้งานได้บ้าง |
|---|---|---|
| ไฟล์ภาพหรือเสียงของ OpenAI | เครื่องมือยืนยันของ OpenAI | ทุกคน ใช้งานฟรี |
| ผลลัพธ์ข้อความของ OpenAI (textGrain) | เครื่องมือตรวจจับลายน้ำข้อความของ OpenAI | ผู้วิจัยที่ได้รับอนุมัติและองค์กรผู้เชี่ยวชาญ ตามการยื่นคำขอ |
| ผลลัพธ์ข้อความของ Claude | Claude Watermark Detector | องค์กรที่มีสิทธิ ตามการยื่นคำขอ (ดู คู่มือ Claude watermark) |
OpenAI ยังชัดเจนในสิ่งที่ผลลัพธ์บอกไม่ได้ ลายน้ำที่ตรวจพบไม่ได้บอกว่ามีคนมีส่วนร่วมมากน้อยเพียงใด และไม่ได้ระบุว่าใครเป็นผู้เขียนหรือใช้งานข้อความ การไม่พบลายน้ำก็ไม่ได้พิสูจน์ว่าผู้เขียนเป็นมนุษย์ เพราะข้อความอาจสั้นเกินไป ถูกแก้ไข ถูกแปล หรือมาจากโมเดลที่ไม่รองรับ
Google: เจ้าแรกที่ออกก่อน จากนั้นจึงเปิดเผยสูตร
Google DeepMind ออกมาก่อน เผยแพร่ให้ครบถ้วน แล้วจึงเปิดวิธีการออกมา ระบบของพวกเขา SynthID เริ่มจากการเป็นลายน้ำในภาพตั้งแต่ปี 2023 และขยายไปสู่ข้อความในปี 2024 พอถึงเวลาที่บทความของ Nature ออกในเดือนตุลาคม 2024 SynthID-Text ก็ใช้งานอยู่ใน Gemini ระดับการผลิตแล้ว ทำให้เป็นลายน้ำข้อความเชิงสถิติชุดแรกที่ถูกนำไปใช้งานจริงในระดับผู้ใช้งานทั่วไป
SynthID ครอบคลุมข้อความ ภาพ เสียง และวิดีโอ และใช้งานอยู่ในเอาต์พุตข้อความของ Gemini ตั้งแต่เดือนตุลาคม 2024
จากนั้น Google เผยแพร่การนำไปใช้งานเป็น open source บน Hugging Face ทำให้ผู้พัฒนารายใดก็นำรูปแบบการฝังลายน้ำแบบเดียวกันไปใช้กับโมเดลของตนเองได้ ในเดือนพฤษภาคม 2025 มีการประกาศ SynthID Detector ซึ่งเป็นพอร์ทัลสำหรับการยืนยัน ที่สามารถตรวจสอบเครื่องหมาย SynthID ในข้อความ ภาพ เสียง และวิดีโอได้
ข้อจำกัดของขอบเขตที่สำคัญมีอยู่หนึ่งข้อ: SynthID จะทำเครื่องหมายได้เฉพาะเนื้อหาจากโมเดลของ Google เท่านั้น และตรวจพบได้เฉพาะส่วนนี้เท่านั้น ไม่ได้บอกอะไรเกี่ยวกับผลลัพธ์ของ ChatGPT หรือ Claude และการสแกน SynthID ที่สะอาดก็ไม่ได้หมายความว่าข้อความนั้นเขียนโดยมนุษย์ มันหมายความว่าโมเดลของ Google ไม่ได้เป็นผู้เขียน ซึ่งเป็นข้อกล่าวอ้างที่แคบกว่ามาก
Anthropic: ย้ายทีหลัง แต่เข้มงวดที่สุด
Anthropic เปิดใช้งานเวอร์ชันล่าสุด โดยมีการครอบคลุมที่บังคับใช้ในวงกว้างที่สุด โมเดล Claude ทุกตัวที่เปิดตัวในหรือหลังวันที่ 2 สิงหาคม 2026 จะฝังลายน้ำเชิงสถิติลงในเอาต์พุตข้อความ ทั่วโลก บนทุกแผน โดยไม่มีตัวเลือกยกเว้น บริษัทอธิบายกลไกในบทความอธิบาย วิธีการทำงานของลายน้ำข้อความของ Claude และอธิบายนโยบายในบทความศูนย์ช่วยเหลือ Claude ทำเครื่องหมายเนื้อหาที่สร้างด้วย AI อย่างไร ซึ่งครอบคลุม Claude API, claude.ai, Claude Code, Claude Cowork และ Claude Tag ทั้งหมด โมเดลที่เปิดตัวก่อนช่วงตัดเกณฑ์จะอยู่ในระยะเปลี่ยนผ่าน และ Anthropic ระบุว่าจะเพิ่มการรองรับการทำเครื่องหมายให้กับโมเดลเหล่านั้นด้วยเช่นกัน นอกจากเครื่องหมายเชิงสถิติแล้ว ไฟล์ที่สร้างโดย Claude ยังมีเมทาดาต้า C2PA ซึ่งเป็นระบบที่สองที่แยกต่างหาก และการคัดลอกข้อความล้วนจะตัดออกไป
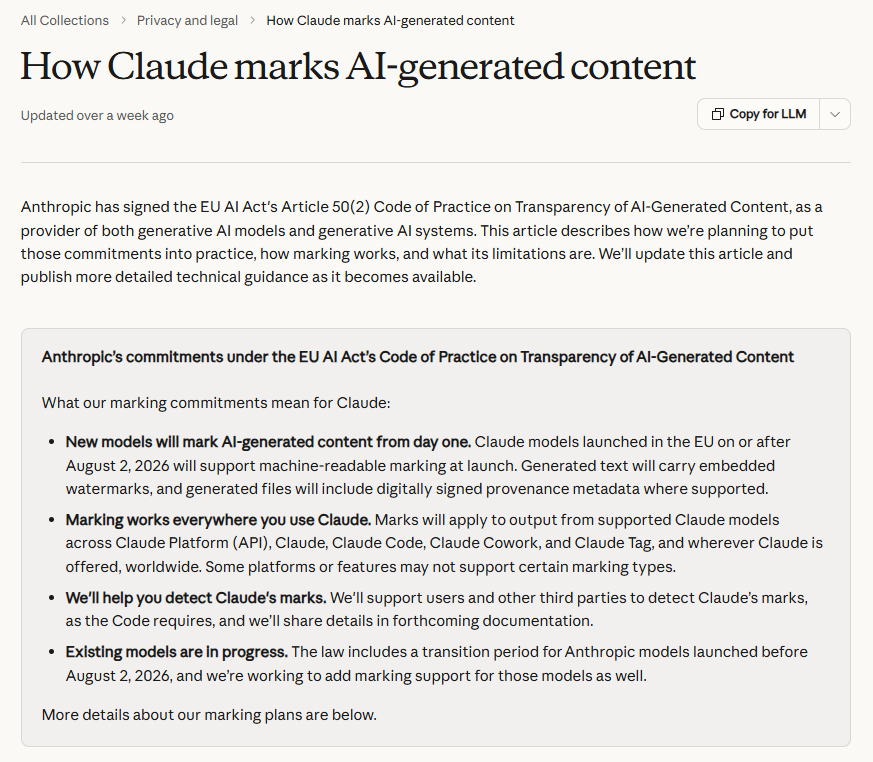
ถ้อยคำในนโยบายของ Anthropic เอง: ทุกโมเดลใหม่ ทุกแพลตฟอร์ม ทั่วโลก โดยโมเดลเก่าจะทยอยเพิ่มเข้ามา
เอกสารของ Anthropic ระบุขีดจำกัดไว้อย่างชัดเจน การตรวจจับเป็นแบบความน่าจะเป็น เครื่องหมายไม่สามารถแยกเอกสารที่ Claude เป็นผู้เขียน ออกจากเอกสารที่มนุษย์เขียนและให้ Claude แก้ไขอย่างเบาๆ ได้ การเขียนใหม่ทั้งหมดจะทำให้เครื่องหมายหายไป เราไล่ทำความเข้าใจเรื่องนี้ทั้งหมด รวมถึงว่า “การตรวจจับเชิงบวก” จริงๆ แล้วพิสูจน์อะไรได้บ้าง และควรทำอย่างไรหากงานเขียนของคุณถูกทำเครื่องหมาย ใน คู่มือเฉพาะสำหรับรอยน้ำของ Claude.
เวลาที่กำหนดเป็นไปตามกฎระเบียบ Anthropic ได้ลงนามใน Article 50(2) Code of Practice on Transparency of AI-Generated Content ภายใต้ EU AI Act ซึ่งกำหนดให้ผู้ให้บริการระบบ AI เชิงกำเนิดต้องทำให้เอาต์พุต "ทำเครื่องหมายในรูปแบบที่อ่านได้ด้วยเครื่องและตรวจจับได้ว่าเป็นที่สร้างขึ้นโดยเทียม" ภาระหน้าที่ด้านความโปร่งใสเหล่านี้เริ่มมีผลบังคับใช้เมื่อวันที่ 2 สิงหาคม 2026 ซึ่งเป็นวันตัดขาดที่แน่นอนตามนโยบายโมเดลของ Anthropic ก่อนประกาศสาธารณะ 9 วัน Anthropic เลือกปฏิบัติตามทั่วโลกแทนการรักษาพฤติกรรมที่แตกต่างสำหรับทราฟฟิกในสหภาพยุโรป Google ทำให้สอดคล้องตามแบบตั้งแต่แรกแล้ว คำถามเรื่องความสอดคล้องในปี 2027 คือข้อความที่ไม่ได้ทำเครื่องหมายจาก OpenAI
ทั้ง 3 แนวทาง เทียบกันแบบเคียงข้างกัน
| OpenAI | Google DeepMind | Anthropic | |
|---|---|---|---|
| มีการใช้งานรอยน้ำข้อความหรือไม่? | ใช่ (textGrain, เผยแพร่ในสหภาพยุโรปตั้งแต่วันที่ 5 ตุลาคม 2026) | ใช่ (Gemini ตั้งแต่เดือนตุลาคม 2024) | ใช่ (โมเดลของ Claude ตั้งแต่วันที่ 2 สิงหาคม 2026) |
| เทคนิค | textGrain สัญญาณเชิงสถิติจากการเลือกคำ | การสุ่มตัวอย่างแบบ tournament ของ SynthID | การทำเครื่องหมายจากการสุ่มเชิงสถิติ ในรูปแบบคล้าย SynthID |
| ขอบเขตการใช้งาน | ข้อความของ ChatGPT และ Codex ที่เข้าเงื่อนไขในสหภาพยุโรป; เลือกใช้ผ่าน API ได้ทั่วโลก | โมเดลของ Google เท่านั้น | โมเดล Claude ใหม่ทั้งหมด; โมเดลเก่าอยู่ระหว่างเปลี่ยนผ่าน |
| การปิดใช้งาน | ปิดโดยค่าเริ่มต้นใน API | ไม่ | ไม่ |
| ตัวตรวจจับสาธารณะ | ไม่ | พอร์ทัลตัวตรวจจับ SynthID (2025) | วางแผนไว้ แต่ยังไม่เปิดให้ใช้งาน |
| เผยแพร่โครงร่างแล้วหรือยัง? | เฉพาะบทเรียนแนวคิด | บทความ Nature + โอเพนซอร์ส | คำอธิบาย อ้างอิงจากงานที่เผยแพร่แล้ว |
| เมทาดาทาไฟล์ (C2PA) | ใช่ ภาพและเสียง | ใช่ ครอบคลุมหลายสื่อ | ใช่ ในไฟล์ที่ถูกสร้างขึ้น |
| ข้อจำกัดที่ระบุไว้ | การหลีกเลี่ยง การตีตราในบริบท ESL | ขอบเขตจำกัดเฉพาะโมเดลของตนเอง | เชิงความน่าจะเป็น การแก้ไขทำให้ความเป็นผู้เขียนเลือนลาง |
รูปแบบที่พบข้ามคอลัมน์: OpenAI มองการใส่ลายน้ำข้อความเป็นปัญหาด้านนโยบายที่ยังแก้ไม่ได้ Google มองเป็นโครงสร้างพื้นฐานที่ต้องมาตรฐาน และ Anthropic มองเป็นภาระด้านการปฏิบัติตามข้อกำหนดที่ต้องนำไปใช้ให้ครบถ้วน
ความหมายต่อผู้วิจัยและนักเขียนเชิงวิชาการ
ผลลัพธ์เชิงปฏิบัติขึ้นอยู่กับว่าเครื่องมือใดไปแตะต้องข้อความของคุณ หากคุณร่างด้วย ChatGPT วันนี้ข้อความของคุณจะไม่มีลายน้ำ หากคุณร่างด้วย Gemini ข้อความจะมีเครื่องหมาย SynthID ที่ตรวจอ่านได้โดยเครื่องมือตรวจจับของ Google เท่านั้น หากคุณร่างหรือแก้ไขด้วยโมเดล Claude รุ่นปัจจุบัน ข้อความจะมีเครื่องหมายของ Anthropic และไม่มีการตั้งค่าที่ปิดสิ่งนี้
สามสิ่งที่นักเขียนเชิงวิชาการควรรู้:
ลายน้ำระบุเครื่องมือ ไม่ใช่ผู้เขียน. ผู้ให้บริการทุกรายระบุสิ่งนี้ไว้ในเอกสารของตนเอง และควรย้ำอีกครั้งเพราะนโยบายของสถาบันอาจไม่เสมอไปที่จะทำให้ความแตกต่างนี้ชัดเจน ข้อความอาจถูกใส่ลายน้ำเพราะ AI เป็นผู้ร่าง ข้อความอาจถูกใส่เพราะ AI ทำการแก้ไขเชิงคัดลอก-ปรับปรุงสองประโยคของมัน หรือเพราะมีการอ้างอิงยกย่องข้อความย่อหน้าที่มีลายน้ำ หากสถาบันของคุณเรียกใช้การตรวจลายน้ำ สิ่งที่การตรวจยืนยันได้คือโมเดลใดโมเดลหนึ่งได้แตะต้องข้อความนั้นในช่วงเวลาใดเวลาหนึ่ง เท่านั้น ไม่มีอะไรมากกว่านั้น คู่มือของเราบน การอุทธรณ์ข้อกล่าวหาเท็จจากการตรวจจับ AI อธิบายวิธีการทำข้อเรียกร้องนี้เมื่อมันสำคัญ
ลายน้ำและเครื่องมือตรวจจับ AI คือเทคโนโลยีคนละแบบ และมีรูปแบบความล้มเหลวที่แตกต่างกัน. ตัวตรวจจับอย่าง Turnitin หรือ GPTZero คาดเดาจากรูปแบบเชิงสถิติของสำนวนด้วยปัญหาด้านความแม่นยำที่เรา ได้บันทึกไว้. ส่วนการตรวจจับลายน้ำเป็นการทดสอบแบบอิงคีย์ ที่มีอัตราผิดพลาดเชิงบวกต่ำมากสำหรับข้อความมนุษย์ที่ไม่มีลายน้ำ ความไม่สมมาตรจะกลับด้านเมื่อเป็นกรณีผลลบเท็จ: การตรวจลายน้ำพลาดข้อความที่สร้างโดย AI จากโมเดลที่ไม่ได้ใส่ลายน้ำ ซึ่งในปัจจุบันรวมถึงโมเดลทั้งหมดของ ChatGPT
การเปิดเผยยังเป็นจุดยืนที่แข็งแกร่งที่สุดของคุณ. การใส่ลายน้ำทำให้การใช้ AI แบบไม่เปิดเผยมีความเสี่ยงมากขึ้น ในขณะที่การใช้ AI แบบเปิดเผยปลอดภัยกว่า เพราะขั้นตอนที่เปิดเผยแล้วไม่มีอะไรให้ต้องกังวลจากเครื่องหมายเชิงบวก วารสารและมหาวิทยาลัยส่วนใหญ่ตอนนี้มีนโยบายที่ชัดเจนเกี่ยวกับการใช้ AI; นโยบายการใช้ AI ของเราจะอธิบายว่าพวกเราวาดเส้นแบ่งเหล่านั้นอย่างไรตามเครื่องมือของเราเอง และเป็นแม่แบบที่สมเหตุสมผลสำหรับสิ่งที่การใช้อย่างโปร่งใสมีหน้าตาเป็นอย่างไร
อะไรที่ทำให้ลายน้ำข้อความหายไป และอะไรที่ไม่ทำให้หาย
การเขียนใหม่ทำให้หายไป แต่การจัดรูปแบบใหม่ไม่ทำให้หาย การคัดลอก การตัดวาง การเปลี่ยนฟอนต์ การแปลงระหว่างรูปแบบไฟล์ และการลบอักขระที่มองไม่เห็นล้วนทิ้งลายน้ำเชิงสถิติไว้ครบถ้วน เพราะลายน้ำอยู่ในตัวเลือกคำ สิ่งที่ทำให้หายไปคือสิ่งใดก็ตามที่ทำให้เกิดการสร้างใหม่ของถ้อยคำ: การแก้ไขอย่างลึกแบบมนุษย์ การแปล หรือการถอดความที่เป็นการสรุปใหม่จริงๆ ซึ่งงานความทนทานของ NeurIPS 2023 NeurIPS 2023 งานความทนทาน ได้แสดงไว้ก่อนที่ระบบเหล่านี้จะถูกส่งออกใช้งาน
ทั้งสองทิศทางมีความหมายตรงนี้ การที่ “เครื่องหมายหายไป” ไม่ได้ทำให้ข้อความนั้นเป็นของคุณ และการที่ “เครื่องหมายนั้นยังอยู่” ก็ไม่ได้ทำให้ข้อความนั้นไม่ใช่ของคุณ ร่างงานที่เขียนใหม่ด้วย AI ยังคงเป็นเอกสารที่ใช้ความช่วยเหลือจาก AI ซึ่งกฎการเปิดเผยของสถาบันคุณยังคงมีผลบังคับใช้กับเอกสารนั้น AI text humanizer ของเราเขียนร่างที่ใช้ AI ใหม่ให้เป็นภาษาวิชาการที่เป็นธรรมชาติ และเนื่องจากกระบวนการนี้สร้างลำดับโทเค็นขึ้นใหม่ เครื่องหมายเชิงสถิติจึงไม่คงอยู่ สำหรับข้อความของ Claude โดยเฉพาะ เครื่องมือลบลายน้ำ Claude จะถ่ายทอดทุกประโยคใหม่ด้วยถ้อยคำใหม่โดยยังคงข้อเท็จจริง ตัวเลข และคำอ้างอิงไว้เหมือนเดิม สิ่งที่เครื่องมือใด ๆ ไม่สามารถเปลี่ยนได้คือสิ่งที่คุณต้องรับผิดชอบต่อผู้อ่าน นั่นคือความโปร่งใสเกี่ยวกับเอกสารถูกทำขึ้นอย่างไร
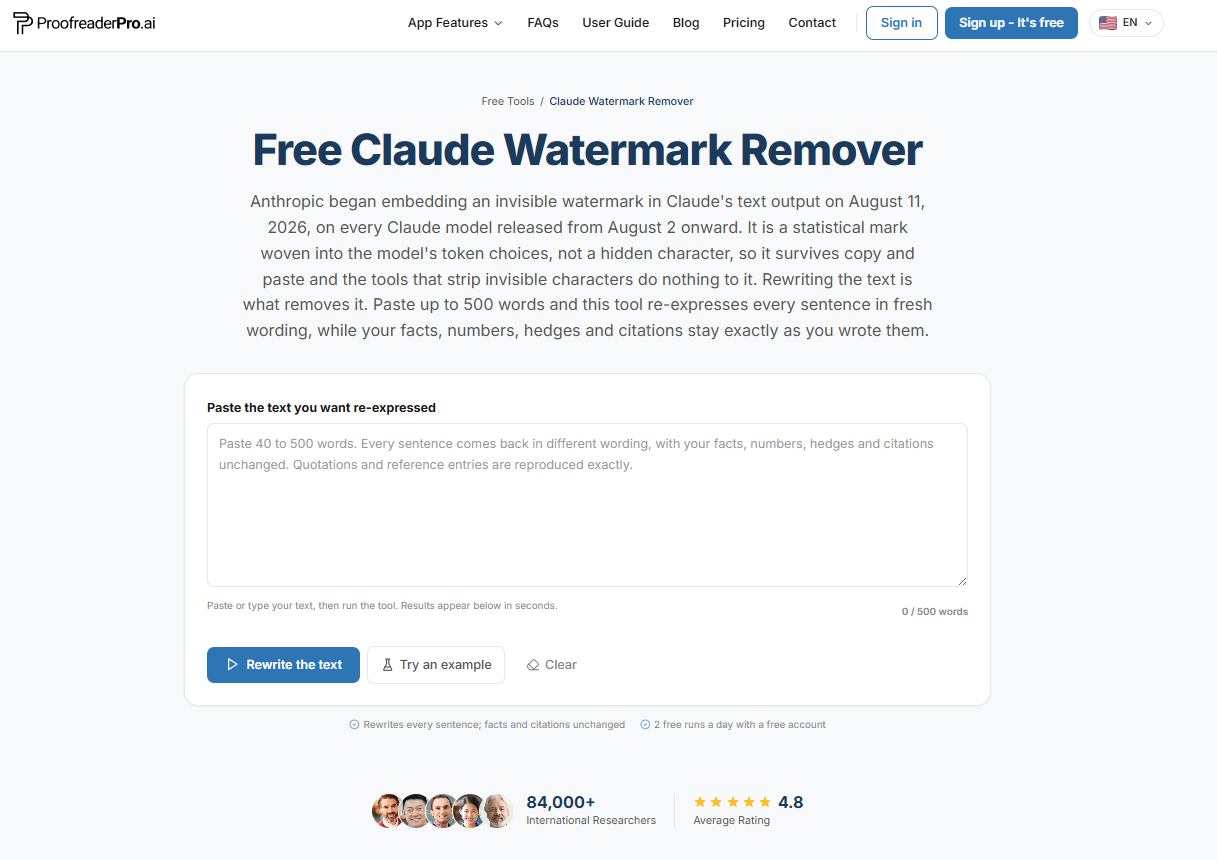
การเขียนใหม่เป็นปฏิบัติการเพียงอย่างเดียวที่ลบเครื่องหมายเชิงสถิติได้ และนี่คือสิ่งที่เครื่องมือนี้ทำ ไล่เรียงทีละประโยค
ไปต่อที่ตรงไหน
ติดตามดูสามเรื่องจนถึงปี 2027 ก่อนอื่น ดูว่า OpenAI นำ textGrain ไปไกลกว่ายูโรปหรือไม่ มันเริ่มต้นตรงนั้นเพราะการบังคับใช้กฎในสหภาพยุโรปของมาตรา 50 กำหนดให้มีเครื่องหมายที่อ่านได้ด้วยเครื่องบนข้อความที่สร้างด้วย AI ต่อมาดูว่าเครื่องมือตรวจจับมาบรรจบกันหรือไม่ หากทุกห้องแล็บสำคัญใส่ลายน้ำตามแบบแผนที่เผยแพร่ มหาวิทยาลัยก็สามารถตรวจคีย์ได้แทนการเดาจากสไตล์การเขียน ซึ่งจะช่วยยกระดับจาก การตรวจจับที่มีโอกาสเกิดผลบวกลวงสูง ในปัจจุบัน และสุดท้าย ดูว่าเครื่องหมายเหล่านั้นกลายมาเข้ากันได้หรือไม่ วันนี้มีแล็บสามแห่งที่ใช้เครื่องหมายสามแบบที่แตกต่างกัน และการตรวจสอบแบบเดียวไม่ครอบคลุมทั้งหมด C2PA เติมเต็มช่องว่างนี้สำหรับไฟล์ แต่ยังไม่มีอะไรเติมเต็มสำหรับข้อความดิบ
ChatGPT ใส่ลายน้ำให้ข้อความของตนหรือไม่?
ใช่ บางส่วน ตั้งแต่วันที่ 5 ตุลาคม 2026 OpenAI เริ่มเพิ่มลายน้ำ textGrain ให้กับข้อความของ ChatGPT และ Codex ที่เข้าเกณฑ์ในสหภาพยุโรป และลูกค้า API ทั่วโลกสามารถเปิดใช้งานได้ ลายน้ำคือสัญญาณเชิงสถิติในทางเลือกคำ ไม่มีอักขระที่ซ่อนอยู่ OpenAI ใช้เมตาดาต้าเชิงความเป็นมาของ C2PA กับสื่อของ DALL-E และ Sora ด้วย ซึ่งเป็นระบบแยกต่างหากในระดับไฟล์
Google Gemini ใส่ลายน้ำให้ข้อความของตนหรือไม่?
ใช่ เอาต์พุตของ Gemini มีการใส่ลายน้ำ SynthID-Text ของ Google DeepMind ตั้งแต่เดือนตุลาคม 2024 ลายน้ำเป็นเครื่องหมายเชิงสถิติในทางเลือกคำ มองไม่เห็นสำหรับผู้อ่าน และตรวจสอบได้ผ่านตัวตรวจจับ SynthID ของ Google ใช้ได้กับโมเดลของ Google เองเท่านั้น ดังนั้นผล SynthID เชิงลบจึงไม่ได้บอกอะไรเกี่ยวกับข้อความจากระบบ AI อื่น ๆ
Claude ใส่ลายน้ำให้ข้อความของตนหรือไม่?
ใช่ โมเดล Claude ทุกตัวที่เปิดตัวในหรือหลังวันที่ 2 สิงหาคม 2026 จะฝังลายน้ำเชิงสถิติในเอาต์พุตข้อความของตน บนทุกแพลตฟอร์มและทุกแผน โดยไม่มีทางเลือกยกเลิก และไฟล์ที่สร้างโดย Claude จะมีเมตาดาต้า C2PA เพิ่มเติมด้วย โมเดลที่เปิดตัวก่อนวันที่ดังกล่าวยังไม่ได้ใส่เครื่องหมายเอาต์พุต ในช่วงเปลี่ยนผ่าน Anthropic ระบุว่าจะเพิ่มความสามารถในการใส่เครื่องหมายให้กับโมเดลเหล่านั้น รายละเอียดฉบับเต็มอยู่ในบทอธิบายลายน้ำของ Claude ของเรา
มหาวิทยาลัยสามารถตรวจจับลายน้ำจาก AI ได้หรือไม่?
ทำได้เฉพาะเมื่อผู้ให้บริการร่วมมือ เพราะการตรวจจับต้องใช้คีย์ของผู้ให้บริการ Google มีพอร์ทัลตัวตรวจจับสาธารณะสำหรับคอนเทนต์ SynthID Anthropic ระบุว่ามีแผนรองรับการตรวจจับสำหรับผู้ใช้และบุคคลที่สาม แต่ยังไม่ได้เผยแพร่ตัวตรวจจับสาธารณะ ขณะนี้ชุดตรวจจับการคัดลอกที่เป็นที่นิยมทั่วไปไม่สามารถยืนยันลายน้ำเชิงสถิติจากแล็บใด ๆ ได้ ดังนั้น “การตรวจจับ AI” ของสถาบันในวันนี้จึงยังหมายถึงการเดาจากสไตล์ ไม่ใช่การยืนยันลายน้ำ
การใส่ลายน้ำของ AI จำเป็นตามกฎหมายหรือไม่?
ในสหภาพยุโรป โดยมีผลในทางปฏิบัติแล้ว มาตรา 50(2) ของพระราชบัญญัติ AI ของสหภาพยุโรปกำหนดให้ผู้ให้บริการ AI เชิงกำเนิดต้องทำให้ผลลัพธ์ถูกทำเครื่องหมายให้อยู่ในรูปแบบที่อ่านได้โดยเครื่อง และตรวจพบได้ว่าเป็นการสร้างขึ้นอย่างผิดธรรมชาติ โดยมีข้อกำหนดด้านความโปร่งใสซึ่งมีผลตั้งแต่วันที่ 2 สิงหาคม 2026 Anthropic ลงนามใน Code of Practice ที่เกี่ยวข้อง และเลือกปฏิบัติตามอย่างครอบคลุมทั่วโลก ประเด็นที่ต้องจับตาในปี 2027 คือหน่วยงานกำกับจะประเมินแถบลายน้ำของข้อความที่ยังไม่เผยแพร่ของ OpenAI อย่างไร
AI watermarks อยู่รอดเมื่อมีการแปลหรือไม่?
ไม่ แถบลายน้ำเชิงสถิติงานอยู่ในลำดับคำที่โมเดลเลือกอย่างแท้จริง และการแปลจะเปลี่ยนทุกคำ เช่นเดียวกันกับการถอดความแบบเน้นสถิติและการแก้ไขด้วยมืออย่างหนัก ข้อจำกัดนี้ถูกบันทึกไว้ในวรรณกรรมที่ผ่านการตรวจสอบโดยผู้ทรงคุณวุฒิ และได้รับการยอมรับจากทุกรายที่จำหน่ายซอฟต์แวร์ที่มีการใช้งานลายน้ำ
มีตัวตรวจสอบลายน้ำข้อความของ OpenAI แบบสาธารณะหรือไม่?
ไม่มี เครื่องมือยืนยันแบบสาธารณะของ OpenAI ตรวจสอบได้เฉพาะไฟล์ภาพและเสียง เพื่อดูเมทาดาทา C2PA และลายน้ำ SynthID OpenAI ระบุว่าไม่รองรับข้อความ ตัวตรวจจับลายน้ำข้อความของ OpenAI เปิดให้เฉพาะนักวิจัยที่ได้รับอนุมัติและองค์กรผู้เชี่ยวชาญเท่านั้น โดยพิจารณาเป็นรายกรณี
textGrain คืออะไร?
textGrain คือ ลายน้ำข้อความของ OpenAI ประกาศเมื่อวันที่ 5 ตุลาคม 2026 มันเพิ่มสัญญาณเชิงสถิติที่มองไม่เห็นให้กับการเลือกคำของโมเดล ทำให้เครื่องหมายนั้นเป็นส่วนหนึ่งของคำ โดยไม่มีตัวอักษรที่ซ่อนอยู่หรือเมทาดาทาไฟล์ OpenAI ระบุว่าวิธีนี้เทียบได้หรือดีกว่าวิธีอื่นที่ตนทดสอบ รวมถึง SynthID สำหรับข้อความ และกล่าวว่าการแก้ไขทำให้ความสามารถของมันอ่อนลง
นักวิจัยสามารถยื่นขอเข้าถึงตัวตรวจจับลายน้ำข้อความของ OpenAI ได้หรือไม่?
ได้ นักวิจัยที่ได้รับอนุมัติและองค์กรผู้เชี่ยวชาญสามารถยื่นผ่านแบบฟอร์มของ OpenAI ใน Content Provenance API OpenAI ให้สิทธิ์เข้าถึงเป็นรายกรณีภายใต้ EU Code of Practice และระบุว่าจะทบทวนการให้สิทธิ์เข้าถึงในวงกว้างมากขึ้นเมื่อเทคโนโลยีและหลักฐานพัฒนาขึ้น
แหล่งข้อมูล
- Anthropic, วิธีการทำงานของลายน้ำข้อความของ Claude, สิงหาคม 2026
- Anthropic Help Center, วิธีที่ Claude ระบุเนื้อหาที่สร้างโดย AI, 2026
- OpenAI, ทำความเข้าใจแหล่งที่มาของสิ่งที่เรามองเห็นและได้ยินทางออนไลน์, May 2024
- Google DeepMind, SynthID
- Dathathri et al., Scalable watermarking เพื่อระบุผลลัพธ์ของ large language model, Nature, ตุลาคม 2024
- Google, ประกาศตัวตรวจจับ SynthID Detector, May 2025
- Hugging Face, Introducing SynthID Text, ตุลาคม 2024
- Kirchenbauer et al., เครื่องหมายกำกับน้ำสำหรับโมเดลภาษาขนาดใหญ่, ICML 2023
- Krishna et al., การถอดความช่วยหลบเลี่ยงเครื่องตรวจจับข้อความที่สร้างด้วย AI, NeurIPS 2023
- Scott Aaronson, การบรรยายเรื่องความปลอดภัยของ AI ของฉันสำหรับ UT Effective Altruism, พฤศจิกายน 2022
- สหภาพยุโรป, AI Act, Article 50
- C2PA, พันธมิตรเพื่อการพิสูจน์ที่มาของเนื้อหาและความแท้จริง
Dana เป็นผู้สร้างเนื้อหาที่ ProofreaderPro ซึ่งเธอดูแลบล็อกและการเขียนรายวัน เธอเขียนบทความเกี่ยวกับวิธีการทำงานของแพลตฟอร์มการแก้ไขออนไลน์ และเธอจัดการกับข้อความของลูกค้าทุกวัน พร้อมแสดงคะแนนความพึงพอใจห้าดาว