
AI Humanizer สำหรับนักวิจัยชาวฮังการีที่เขียนภาษาอังกฤษ
AI humanizer สำหรับนักวิจัยชาวฮังการี ช่วยลดการแจ้งเตือนตรวจจับ AI แบบผิดพลาดสำหรับภาษาอังกฤษที่ได้รับอิทธิพลจากฮังการี โดยคงความหมายและการอ้างอิงไว้ และเปิดเผยการใช้งานอย่างตรงไปตรงมา

วิทยาศาสตร์ของฮังการีก้าวล้ำเกินขนาดประเทศ นักวิจัยและนักวิทยาศาสตร์ของประเทศที่มีประชากรน้อยกว่า 10 ล้านคนได้สร้างผลงานโดดเด่นในสายคณิตศาสตร์ ฟิสิกส์ เคมี และวิทยาศาสตร์ชีวภาพ และประเพณีนั้นยังสะท้อนอยู่ในผลงานของมหาวิทยาลัยในปัจจุบันเช่นเดียวกัน ทว่ากระบวนการเขียนกลับเป็นภาษาอังกฤษ แทบทุกคนที่ทำงานในบูดาเปสต์หรือเซเกดมักร่างและคิดเป็นภาษาฮังการีก่อน จากนั้นจึงถ่ายทอดข้อโต้แย้งไปยังภาษาที่สองซึ่งมีไวยากรณ์แทบไม่เกี่ยวข้องกันเลย ช่องว่างในการแปลนี้เองที่ทำให้ AI humanizer สำหรับนักวิจัยชาวฮังการีมีบทบาท เพราะปัจจุบันภาษาอังกฤษที่ปรับให้ถูกต้องตามแบบแผน ซึ่งมาจากการถ่ายทอดอย่างรอบคอบจากภาษาฮังการี กลับถูกอ่านผิดว่าเป็น “ข้อความจากเครื่องจักร”
นี่คือส่วนที่ไม่สบายใจ ยิ่งภาษาอังกฤษของคุณสะอาดและเป็นมาตรฐานมากเท่าใด โอกาสที่ระบบตรวจจับ AI จะติดธงก็ยิ่งสูงขึ้น โมเดลที่ให้คะแนนข้อความด้วยความ “แปลก” ของแต่ละคำ จะมองว่าการใช้ถ้อยคำที่มีวินัย เป็นระบบ และคาดเดาได้ของคุณเป็นสัญญาณของผู้เขียนที่เป็นเครื่องจักร รางวัลของการเขียนอย่างชัดเจนในภาษาที่สองที่ยาก ก็คือการถูกกล่าวหาอย่างผิดพลาด
เราพัฒนา humanizer ขึ้นมาเพื่อปัญหาเฉพาะนั้น เพื่อปกป้องงานจริงของนักวิจัยตัวจริง ไม่ใช่เพื่อปิดบังทางลัดของใคร คู่มือนี้อธิบายว่าเครื่องมือนี้ผสานเข้ากับกระบวนการเผยแพร่อย่างซื่อสัตย์สำหรับนักวิชาการในฮังการีได้อย่างไร
AI-szöveg humanizálása สำหรับนักวิจัยชาวฮังการี
AI-szöveg humanizálása หมายถึงการทำให้ข้อความที่ได้รับความช่วยเหลือจากปัญญาประดิษฐ์มีจังหวะที่เป็น “ความเป็นมนุษย์” มากขึ้น โดยยังคงความหมาย คำเฉพาะทาง และการอ้างอิงไว้ไม่เปลี่ยนแปลง เครื่องมือตามที่เราพัฒนาสำหรับนักวิชาการชาวฮังการีที่ร่างงานด้วยภาษาของตนเอง แล้วจึงเผยแพร่ออกมาเป็นภาษาอังกฤษ
ประเด็นไม่ได้อยู่ที่การปิดบังสิ่งใดๆ ประเด็นคือ ประโยคภาษาอังกฤษที่เขียนอย่างรอบคอบและเป็นมาตรฐานโดยนักวิชาการชาวฮังการี ไม่ควรถูกมองว่า “น่าสงสัย” เพียงเพราะมันรอบคอบและเป็นมาตรฐาน นี่คือธงลวงที่ text humanizer ออกแบบมาเพื่อลด
ร่างเป็นภาษาฮังการีก่อน? เครื่องมือตรวจพบและปรับเขียนได้โดยตรง
คุณสามารถทำให้ร่างภาษาฮังการีเป็น “human” ได้โดยไม่ต้องแปลเป็นภาษาอังกฤษก่อน นำข้อความของคุณมาวาง แล้ว ProofreaderPro จะตรวจจับภาษาโดยอัตโนมัติ จากนั้นส่งผ่านโมเดลที่เข้าใจภาษาฮังการี ซึ่งให้ความสำคัญกับสระเสียงยาว รูปคำแบบเติมคำต่อท้าย (agglutinated forms) และการอ้างอิงในงานเขียนของคุณ ในขั้นตอนนี้ AI-szöveg humanizálása จะปรับจังหวะของงานร้อยแก้วภาษาฮังการีของคุณ ขณะเดียวกันก็รักษาทุกคำและทุกการอ้างอิงไว้ครบถ้วน การตรวจจับอัตโนมัติรองรับมากกว่าหกสิบภาษา ดังนั้น “ภาษาฮังการี” จึงถูกมองว่าเป็นฮังการี ไม่ใช่ถูกปรับรูปเป็นภาษาอังกฤษ
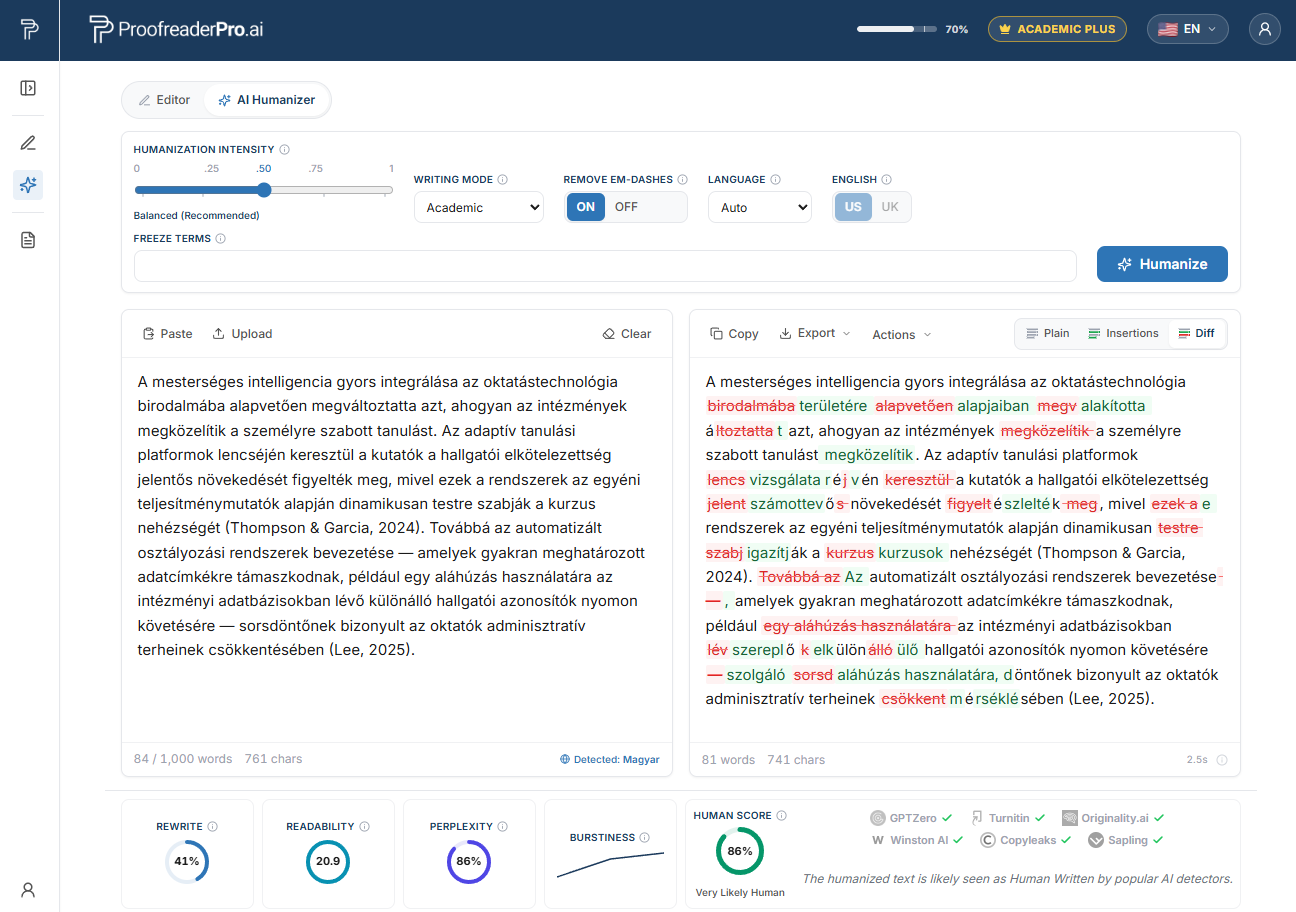
ProofreaderPro AI Humanizer ที่ปรับข้อความวิชาการภาษาฮังการีให้เป็นธรรมชาติ ความต่างก่อนและหลัง (before and after diff) จะคงความหมายและการอ้างอิงของคุณไว้ และการตรวจสอบจากตัวตรวจจับยืนยันว่าการอ่านนั้นเป็นธรรมชาติและเป็นงานของมนุษย์.
เหตุใดนักวิจัยชาวฮังการีจึงถูกระบบตรวจจับ AI ติดธงบ่อย
ในปี 2023 กลุ่มวิจัยจากมหาวิทยาลัยสแตนฟอร์ดนำโดย Weixin Liang ได้ทดสอบตัวตรวจจับ GPT ที่ใช้กันอย่างแพร่หลายจำนวน 7 รายการบนเรียงความที่เขียนโดยมนุษย์ เรียงความเหล่านี้มาจากการสอบ TOEFL ดังนั้นแต่ละชิ้นจึงมีผู้เขียนที่เป็นมนุษย์ซึ่งเป็นผู้เขียนภาษาอังกฤษที่ไม่ใช่เจ้าของภาษาโดยบังเอิญ โดยเฉลี่ยแล้วประมาณ 61% ของเรียงความเหล่านั้นถูกติดธงว่าเป็น AI-generated สำหรับเรียงความที่เขียนโดยเจ้าของภาษาอังกฤษ ตัวเลขอยู่ราว 5% เกือบหนึ่งในห้าของเรียงความที่ไม่ใช่เจ้าของภาษา หรือประมาณ 19.8% ถูกตรวจจับอย่างเป็นเอกฉันท์โดยเครื่องมือตรวจจับทุกตัว
อ่านประโยคนั้นอีกครั้ง งานเขียนของมนุษย์กลับถูกติดธงบ่อยกว่ามาก มากกว่าสิบเท่า เพียงเพราะภาษาอังกฤษเป็น “ภาษาที่สอง” ของผู้เขียน
กลไกนี้เรียกว่า perplexity ตัวตรวจจับจำนวนมากประเมินได้ว่า “การเลือกคำ” ของคุณคาดเดาได้เพียงใดสำหรับโมเดลภาษา เมื่อคุณเขียนด้วยภาษาที่สอง คุณมักจะเลือกโครงสร้างที่ปลอดภัย เป็นคำที่ใช้กันทั่วไป และถูกต้อง เพราะนั่นคือสิ่งที่ผู้เขียนที่รอบคอบทำ “ปลอดภัย” และ “ใช้กันทั่วไป” หมายถึง perplexity ต่ำ และ perplexity ต่ำคือร่องรอยที่เครื่องมือเหล่านี้ได้รับการฝึกให้ตรวจอ่านว่าเป็นข้อความจากเครื่องจักร เราอธิบายกลไกเต็มรูปแบบใน why AI detectors flag non-native writers แต่เวอร์ชันสั้นคือโหดร้าย: นิสัยที่ทำให้งานเขียนของคุณชัดเจน คือสิ่งเดียวกันกับที่ทำให้ถูกติดธง
รูปแบบภาษาฮังการีที่เป็นพื้นฐานของ “ธงลวง”
ภาษาฮังการีเป็นภาษาในตระกูลอูราลิก (Uralic) ซึ่งไม่เกี่ยวข้องกับตระกูลภาษาอินโด-ยูโรเปียนที่อยู่รอบตัว และตรรกะของภาษานี้แตกต่างจากภาษาอังกฤษอย่างแท้จริง ความแตกต่างนี้ทิ้ง “รอย” ไว้ในงานเขียนแบบฮังการี-อังกฤษ รอยเหล่านี้ไม่ใช่ความผิดพลาดด้านสติปัญญา เป็นเพียงเงาของไวยากรณ์ที่ต่างกันมาก และเมื่อถูกปรับให้เรียบเป็นภาษาอังกฤษที่สะอาดแล้ว มันจะถูกเครื่องมือตรวจจับมองว่าเรียบและคาดเดาได้
สรรพนามหนึ่งตัวสำหรับ he และ she ภาษาฮังการีมีสรรพนามบุรุษที่สามเพียงหนึ่งคำ และไม่มีเพศทางไวยากรณ์ ดังนั้น “he” และ “she” จึงถูกสลับในภาษาอังกฤษ ผู้เขียนที่แก้ไขเรื่องนี้มักจะใช้ตัวเลือกที่ “ปลอดภัยที่สุด” มากเกินไป หรือสร้างประโยคใหม่รอบคำว่า “the author” และ “the participant” ซึ่งทำให้เกิดร้อยแก้วที่ค่อนข้างสม่ำเสมอและมีความแปรปรวนน้อย
การใช้บทนำหน้าคำ (articles) กระจายคนละแบบ ภาษาฮังการีก็มีบทนำหน้าคำ (a, az, egy) แต่จัดวางภายใต้ตรรกะที่ต่างจากภาษาอังกฤษ บทนำหน้าคำนิยามและบทนำหน้าคำไม่เฉพาะเจาะจงมักถูกตัดหรือเติม และการแก้ไขที่รอบคอบมักจะเป็นบทนำหน้าคำที่เป็นมาตรฐานที่สุดตามตำราในแต่ละครั้ง “มาตรฐาน” คือสิ่งที่ให้คะแนนความเป็นลักษณะของงานจากเครื่องจักรได้พอดี
การเติมคำต่อท้ายและการทำให้นามมากขึ้น (heavy nominalisation) ภาษาฮังการีสร้างความหมายด้วยการซ้อน “คำลงท้าย” เข้ากับคำราก เมื่อถ่ายทอดเป็นภาษาอังกฤษ ความเคยชินนี้จะกลายเป็นวลีคำนามที่แน่น และสายโซ่ของคำที่ทำให้อยู่ในรูปนาม (nominalised chains) ที่ยาว (เช่น “the implementation of the optimisation of...”) ซึ่งทั้งถูกต้องตามไวยากรณ์และให้จังหวะที่ค่อนข้างน่าเบื่อ เครื่องมือตรวจจับชอบความน่าเบื่อนี้
ลำดับคำที่เด่นเรื่องหัวข้อ (topic-prominent word order) ภาษาฮังการีทำให้ “หัวข้อ” และ “สิ่งที่ต้องการเน้น” ของประโยคเด่นขึ้น ดังนั้นน้ำหนักจึงตกอยู่คนละตำแหน่งกับที่ผู้อ่านภาษาอังกฤษคาดหวัง เมื่อผู้เขียนปรับให้เป็นภาษาอังกฤษแบบประธาน-กริยา-กรรม (subject-verb-object) ที่เป็นกลาง ผลลัพธ์จะถูกต้อง เป็นระเบียบ และคาดเดาได้
ไม่มีตัวบอกกาลอนาคต (future tense marker) และระบบแง่มุม (aspect) ที่ต่างกัน ภาษาฮังการีทำเครื่องหมายอนาคตแตกต่างกัน และจัดการ aspect ด้วยวิธีของตนเอง ดังนั้นการเลือกกาลเวลาในภาษาอังกฤษจึงออกมาไม่สม่ำเสมอ แล้วมักถูกแก้กลับไปสู่กาลที่เป็นกลางและพบได้ทั่วไปที่สุด กาลที่ปลอดภัยที่สุดคือกาลที่ให้ perplexity ต่ำที่สุดอีกครั้ง
ใช้คำบุพบทหลังคำนาม (postpositions) แทนบุพบทหน้าคำนาม (prepositions) ภาษาฮังการีวางตัวบอกความสัมพันธ์ไว้หลังคำนาม ซึ่งทำให้เกิดความคลาดเคลื่อนของการใช้ preposition ในภาษาอังกฤษ การแก้ความคลาดเคลื่อนเหล่านี้หมายถึงการ “หยิบ” preposition ที่เป็นมาตรฐานทุกครั้ง และ “มาตรฐาน” คือสิ่งที่เครื่องมือตรวจจับอ่านว่าเกิดจากการสร้างขึ้น
ปกป้องร่างวิชาการภาษาอังกฤษที่รอบคอบของคุณที่ใช้ฮังการี-อังกฤษจากการถูกสัญญาณผิดพลาด
ทำให้ร่างที่ช่วยด้วย AI ของคุณเป็นมนุษย์ โดยยังคงการอ้างอิง, คำศัพท์, และผลการค้นพบทุกข้อไว้ จากนั้นเปิดเผยเครื่องมือของคุณด้วยความมั่นใจ
ลองใช้ Humanizer ฟรีบริบทการตรวจจับ AI ในฮังการีและ Turnitin
วิทยานิพนธ์และบทความส่งตีพิมพ์จากสถาบันการศึกษาฮังการีมักถูกคัดกรองความคล้ายคลึงของข้อความเป็นประจำ โดยมักใช้ Turnitin หรือระบบที่เทียบเคียงได้ และตัวชี้วัดที่เกี่ยวกับ AI ก็ถูกนำไปรวมเข้ากับกระบวนการคัดกรองนั้นมากขึ้นเรื่อยๆ ปัจจุบันนี้จึงเป็นส่วนปกติของการสอบป้องกันวิทยานิพนธ์ระดับปริญญาเอกและการทบทวนต้นฉบับ ไม่ใช่ขั้นตอนพิเศษ
ควรคำนึงถึงขีดจำกัดของเครื่องมือเหล่านี้ไว้ด้วย มหาวิทยาลัยใหญ่หลายแห่งในต่างประเทศรวมถึง Vanderbilt ได้ปิดการทำงานของตัวตรวจจับการเขียนด้วย AI ของ Turnitin เนื่องจากผลบวกลวงและอคติที่มีต่อผู้เขียนที่ไม่ใช่เจ้าของภาษา และตัว Turnitin เองก็ระงับคะแนนระดับต่ำสุดพร้อมเตือนว่า “จำนวนคะแนน” ไม่ควรเป็นตัวตัดสินคดีด้านความซื่อสัตย์โดยตัวมันเอง คะแนนของตัวตรวจจับคือข้อกล่าวอ้างที่คุณมีสิทธิ์โต้แย้ง ไม่ใช่คำตัดสิน
สถาบันการศึกษาฮังการีได้ออกแนวทางของตนเองเกี่ยวกับ generative AI และผู้สนับสนุนทุนรวมถึงวารสารต่างคาดหวังให้ผู้เขียนเปิดเผยว่าเครื่องมือเหล่านี้ถูกใช้อย่างไร มากขึ้นเรื่อยๆ คำตอบที่ตรงไปตรงมาไม่ใช่การซ่อนสิ่งใดๆ เป้าหมายคือเขียนและแก้ไขอย่างรับผิดชอบ แล้วจึงประกาศเครื่องมือที่คุณใช้ไป
มหาวิทยาลัยชั้นนำของฮังการีและจุดที่มักพบการตรวจ AI
การคัดกรองความคล้ายคลึงและตัวชี้วัด AI ปรากฏอยู่ทั่วทั้งระบบการศึกษาระดับอุดมศึกษาของฮังการี ตั้งแต่โรงเรียนบัณฑิตศึกษา ไปจนถึงสำนักงานกองบรรณาธิการของวารสาร สถาบันต่อไปนี้เป็นหนึ่งในผู้ที่เน้นงานวิจัยเข้มข้นที่สุดในประเทศ และวิทยานิพนธ์กับต้นฉบับของพวกเขามักผ่านการตรวจคัดกรองเหล่านี้:
- Eötvös Loránd Tudományegyetem (Eötvös Loránd University, ELTE), บูดาเปสต์
- Semmelweis Egyetem (Semmelweis University), บูดาเปสต์ ซึ่งเป็นคณะแพทยศาสตร์หลัก
- Szegedi Tudományegyetem (University of Szeged), เซเกด
- Debreceni Egyetem (University of Debrecen), เดเบรเซน
- Budapesti Műszaki és Gazdaságtudományi Egyetem (Budapest University of Technology and Economics, BME), บูดาเปสต์
- Budapesti Corvinus Egyetem (Corvinus University of Budapest), บูดาเปสต์
- Pécsi Tudományegyetem (University of Pécs), เปช
- Pázmány Péter Katolikus Egyetem (Pázmány Péter Catholic University), บูดาเปสต์
- Óbudai Egyetem (Óbuda University), บูดาเปสต์
ไม่ว่าผลงานของคุณจะเป็นวิทยานิพนธ์ที่ป้องกันที่ ELTE หรือเป็นต้นฉบับทางคลินิกจาก Semmelweis พลวัตเดียวกันก็เกิดขึ้น: ภาษาอังกฤษที่เป็นมาตรฐานและรอบคอบจากภาษาฮังการีเป็นงานประเภทที่มีโอกาสสูงที่สุดที่จะ “ติดธง” จากการประเมินแบบ perplexity
กระบวนการทำงานของ AI humanizer สำหรับนักวิจัยชาวฮังการี
เวิร์กโฟลว์ที่เราขอแนะนำทั้งง่ายและที่สำคัญกว่านั้นคือซื่อสัตย์ มี 3 ขั้นตอน
ขั้นแรก ร่าง เขียนบทความของคุณในแบบที่ทำให้ความคิดของคุณลงสู่หน้ากระดาษได้เร็วที่สุด สำหรับนักวิจัยชาวฮังการีจำนวนมาก นั่นหมายถึงการร่างเป็นภาษาฮังการีแล้วแปล หรือเขียนโดยตรงเป็นภาษาอังกฤษพร้อมความช่วยเหลือจาก AI แบบใดแบบหนึ่งก็ได้
ขั้นที่สอง พิสูจน์และปรับเนื้อหา แก้ไวยากรณ์ คำเฉพาะทาง และข้อโต้แย้ง เพื่อให้วิทยาศาสตร์ถูกต้อง หากตัวภาษาเองจำเป็นต้องได้รับการตรวจอย่างรอบคอบ global academic editing hub ของเราครอบคลุมส่วนนี้
ขั้นที่สาม ทำให้ร่างของคุณ “เป็นมนุษย์” ตรงนี้แหละที่ text humanizer เข้ามา มันจะปรับความยาวของประโยคและจังหวะ แยกจังหวะที่ค่อนข้างน่าเบื่อที่ภาษาฮังการี-อังกฤษแบบเติมคำต่อท้ายมักก่อให้เกิด และกำจัดเครื่องหมายขีดยาว (em dashes) ที่หลงเหลือ รวมถึงโครงสร้างที่ซ้ำๆ ซึ่งทั้งเครื่องมือ AI และนิสัยการใช้ภาษาของผู้เรียนภาษาที่สองมักทิ้งไว้ สำคัญที่สุดคือมันยังคงความหมาย คำศัพท์เชิงเทคนิค และการอ้างอิงทุกรายการของคุณไว้ ไม่ว่าจะเป็นข้อความต้นทางที่ไม่ใช่ภาษาอังกฤษจะถูกส่งผ่านโมเดลที่เข้าใจภาษา และเครื่องมือนี้รองรับมากกว่าหกสิบภาษา
อะไรคือสิ่งที่ทำได้? จากการทดสอบของเราเอง การทำให้ร่างที่ไม่ใช่เจ้าของภาษาและเขียนอย่างรอบคอบให้ “เป็นมนุษย์” ช่วยลดโอกาสที่ตัวตรวจจับรายใหญ่จะอ่านผิดว่าเป็นงานเขียนด้วยเครื่องจักรได้อย่างมีนัยสำคัญ ขณะเดียวกันก็ยังคงความหมายเชิงวิชาการไว้ เราอธิบายสิ่งนี้ว่าเป็น “สิ่งที่เราเห็นในการทดสอบ” ไม่ใช่สัญญา ไม่มีเครื่องมือใดที่ซื่อสัตย์สามารถรับประกันผลลัพธ์ที่นี่ได้ เพราะตัวตรวจจับจะถูกฝึกใหม่ทุก ๆ ไม่กี่เดือน และบริการที่อ้างว่า “ตรวจไม่พบ 100%” กำลังขายบางสิ่งที่มันไม่สามารถส่งมอบได้
จากนั้น ขั้นสุดท้าย: เปิดเผย เพิ่มข้อความแสดงการใช้งาน AI ตามรูปแบบที่มหาวิทยาลัยและวารสารเป้าหมายของคุณกำหนด การทำให้ข้อความที่คุณเขียนด้วย AI ด้วยตัวเองให้เป็นมนุษย์ แล้วประกาศออกมาว่าใช้ AI นั้นไม่ใช่กลอุบาย มันคือการทำให้แน่ใจว่างานที่รอบคอบของคุณถูกประเมินด้วย “คุณค่า” แทนที่จะถูกติดธงจากความผิดที่เขียนชัดในภาษาที่สอง สำหรับภาพรวมด้านภาษาในหลายประเทศ โปรดดู multilingual AI humanizer hub
หน่วยทุนท้องถิ่น วารสาร และความคาดหวังด้านการเปิดเผยการใช้ AI
งานวิจัยที่แข่งขันกันในฮังการีได้รับทุนส่วนใหญ่จาก NKFIH (Nemzeti Kutatási, Fejlesztési és Innovációs Hivatal, the National Research, Development and Innovation Office) โดยมี MTA (Magyar Tudományos Akadémia, the Hungarian Academy of Sciences) เป็นสถาบันวิชาการระดับชาติ และ HUN-REN (the Hungarian Research Network) ดูแลสถาบันวิจัยสาธารณะ ทั้งหมดนี้ให้คุณค่ากับผลงานที่เผยแพร่และถูกจัดทำดัชนี ซึ่งสร้างแรงกดดันอย่างต่อเนื่องให้นักวิจัยต้องเผยแพร่เป็นภาษาอังกฤษ
ผลผลิตดังกล่าวถูกวัดในวารสารที่จัดทำดัชนีใน Web of Science และ Scopus และถูกบันทึกใน MTMT (Magyar Tudományos Művek Tára, the Hungarian Scientific Bibliography) ซึ่งเป็นฐานข้อมูลสิ่งพิมพ์ระดับชาติ วัฒนธรรมการประเมินที่สนับสนุนการตีพิมพ์ระดับนานาชาติเป็นภาษาอังกฤษ คือแรงกดดันที่ผลักให้นักวิชาการชาวฮังการีมุ่งไปสู่สำนวนที่สะอาดและเป็นมาตรฐาน ซึ่งตัวตรวจจับกลับอ่านผิด
คาดว่า “การเปิดเผยการใช้ AI” จะพบได้บ่อยขึ้นทั้งในรายงานการให้ทุนและในกระบวนการส่งต้นฉบับ ให้มองว่าเป็นเรื่องปกติ ระบุอย่างตรงไปตรงมาว่าคุณใช้เครื่องมือใดและใช้อย่างไร ทำให้ข้อมูลและการอ้างอิงของคุณซื่อสัตย์ และคุณจะยังคงอยู่ในกรอบกติกาได้อย่างสบายใจพร้อมต่อสู้กับธงลวงที่ไม่เป็นธรรม
คำถามที่พบบ่อย
Q: Does the AI humanizer for Hungarian researchers change my citations or technical terms?
ไม่ เครื่องมือนี้ออกแบบมาเพื่อคงความหมาย คำศัพท์เฉพาะในสาขาของคุณ และการอ้างอิงทุกรายการไว้ตามที่คุณเขียน ไม่ได้เปลี่ยนวิทยาศาสตร์หรือแหล่งอ้างอิงของคุณ แต่จะปรับจังหวะและถ้อยคำเท่านั้น
Q: Can any tool guarantee my paper will pass every AI detector?
ไม่ และคุณควรตั้งข้อสงสัยกับทุกคนที่อ้างแบบนั้น ตัวตรวจจับถูกฝึกใหม่เป็นประจำ ดังนั้นไม่มีบริการที่ซื่อสัตย์ใดสามารถสัญญาว่าจะ “ตรวจไม่พบ 100%” ได้ สิ่งที่เราพูดได้คือจากการทดสอบของเรา การทำให้ร่างที่ไม่ใช่เจ้าของภาษาและเขียนอย่างรอบคอบให้เป็นมนุษย์ช่วยลดโอกาสที่มันถูกอ่านผิดว่าเป็นงานเขียนด้วยเครื่องจักรได้อย่างมีนัยสำคัญ
Q: Is humanizing my own draft a form of cheating?
ไม่ใช่ ตราบใดที่คุณทำงานกับข้อความที่ได้รับความช่วยเหลือจาก AI ด้วยตนเอง ทำให้ข้อค้นพบของคุณยังซื่อสัตย์ และเปิดเผยการใช้เครื่องมือตามที่สถาบันและวารสารของคุณกำหนด เป้าหมายคือความเป็นธรรมต่อผลงานจริง ไม่ใช่การปลอมแปลง
Q: Why does my clear English get flagged when weaker writing does not?
เพราะตัวตรวจจับจำนวนมากให้คะแนนความคาดเดาได้ ผู้เขียนที่ไม่ใช่เจ้าของภาษาแต่เขียนอย่างรอบคอบจะเลือกโครงสร้างที่ปลอดภัย เป็นมาตรฐาน และถูกต้อง ซึ่งทำให้เกิดข้อความที่มี perplexity ต่ำ และ perplexity ต่ำคือรูปแบบที่เครื่องมือเหล่านี้เชื่อมโยงกับงานเขียนด้วยเครื่องจักร ความชัดของคุณจึงทำงานเป็นตัวต่อต้าน
Q: I write in Hungarian first. Does the tool handle that?
ใช่ ข้อความที่ไม่ใช่ภาษาอังกฤษจะถูกส่งผ่านโมเดลที่เข้าใจภาษา ซึ่งคงโครงสร้างประโยคและความหมายไว้ได้มากกว่าหกสิบภาษา ดังนั้นคุณสามารถร่างเป็นภาษาฮังการี แปล แล้วทำให้เวอร์ชันภาษาอังกฤษเป็นมนุษย์ได้โดยไม่ทำให้ข้อโต้แย้งของคุณสูญหาย
เปลี่ยนร่างภาษาอังกฤษที่ช่วยด้วย AI ของคุณแบบฮังการี-อังกฤษให้เป็นสำนวนวิชาการที่เป็นธรรมชาติ โดยยังคงการอ้างอิงและผลการค้นพบทุกข้อไว้ จากนั้นเปิดเผยการใช้งาน AI ของคุณด้วยความมั่นใจ

Moe เป็นวิศวกร NLP ที่มี PhD ในการประมวลผลภาษาธรรมชาติ งานวิจัยของเขาครอบคลุมภาษาศาสตร์เชิงคำนวณ การวิเคราะห์ข้อความ และการเรียนรู้ของเครื่อง และป้อนโดยตรงไปยังโมเดลการแก้ไขและการทำให้มีมนุษยธรรมที่อยู่เบื้องหลัง ProofreaderPro เขาเขียนเกี่ยวกับส่วนหนึ่งของกระบวนการที่คนส่วนใหญ่ไม่เคยเห็นมาก่อน เช่น วิธีที่โมเดลภาษาอ่านประโยค ให้คะแนน และตัดสินใจว่าจะเปลี่ยนแปลงอะไร


