
AI-хьюманайзер для индийских исследователей, пишущих на английском
AI-хьюманайзер для индийских исследователей. Снижает ложные срабатывания ИИ-детекторов на английском с влиянием хинди: сохраняет смысл и цитирования, а также честно сообщает об использовании.

Индия публикует более 278 000 научных статей с индексом Scopus в год, что делает её третьей по величине исследовательской страной в мире — после Китая и Соединённых Штатов. Набор в PhD-программы вырос на 81% в период с 2015 по 2022 год, а проект регламентов UGC на 2025 год перевёл публикации из разряда «рекомендуемых» в юридически обязательные для набора, а также для продвижения преподавателей по службе. Больше индийских исследователей пишет для международных журналов, чем когда-либо раньше.
Многие из них уже создают черновики с помощью ИИ и пропускают результат через проверку на ИИ перед отправкой. Именно здесь появляется место AI-хьюманайзера для индийских исследователей: на такой проверке возникает конкретная проблема — аккуратный, корректный, не носительский английский воспринимается как машинно-сгенерированный текст.
Носители английского как второго языка уже сталкиваются с показателями отказов примерно в 2,5 раза выше, чем носители. А когда ИИ-детектор добавляет ложное срабатывание поверх этого, даже хорошо написанный раздел «Методы» может выглядеть сомнительным без какой-либо иной причины, кроме того, как автор, пишущий на втором языке, формулирует мысли. Это руководство объясняет, почему с такой проблемой сталкиваются индийские исследователи, и как действовать при этом максимально прямо.
एआई ह्यूमनाइज़र भारतीय शोधकर्ताओं को अंग्रेज़ी में प्रकाशित करने में मदद करता है
Наш एआई ह्यूमनाइज़र (AI humanizer) помогает индийским исследователям публиковаться на английском, не допуская, чтобы аккуратное письмо принимали за ИИ-вывод. Он работает с вашим собственным черновиком с поддержкой ИИ: сохраняет смысл, терминологию и цитирования «как есть», а также меняет ритм и подбор слов — те параметры, которые детекторы чаще всего отмечают.
Он поддерживает более 60 языков. Если сначала продумать аргументацию на хинди, тамильском, бенгальском, телугу или маратхи, то языково-ориентированный text humanizer сохраняет структуру предложений и смысл по мере перехода к академическому английскому.
Пишете на хинди? Он тоже автоматически определяется и «очеловечивается»
Многие индийские исследователи сначала думают и составляют черновики на хинди, а затем переходят к английскому — и хьюманайзер создан именно для этого. Вставьте отрывок на хинди, и ProofreaderPro автоматически распознаёт деванагари, после чего обрабатывает текст языково-ориентированной моделью, сохраняя ваш текст, терминологию и ссылки ровно так, как вы их написали. एआई ह्यूमनाइज़र работает с вашим хинди-черновиком так же естественно, как с английским, поэтому сначала ничего переводить не нужно. Автоопределение распространяется более чем на шестьдесят языков, и каждый из них «очеловечивается» в собственной манере.
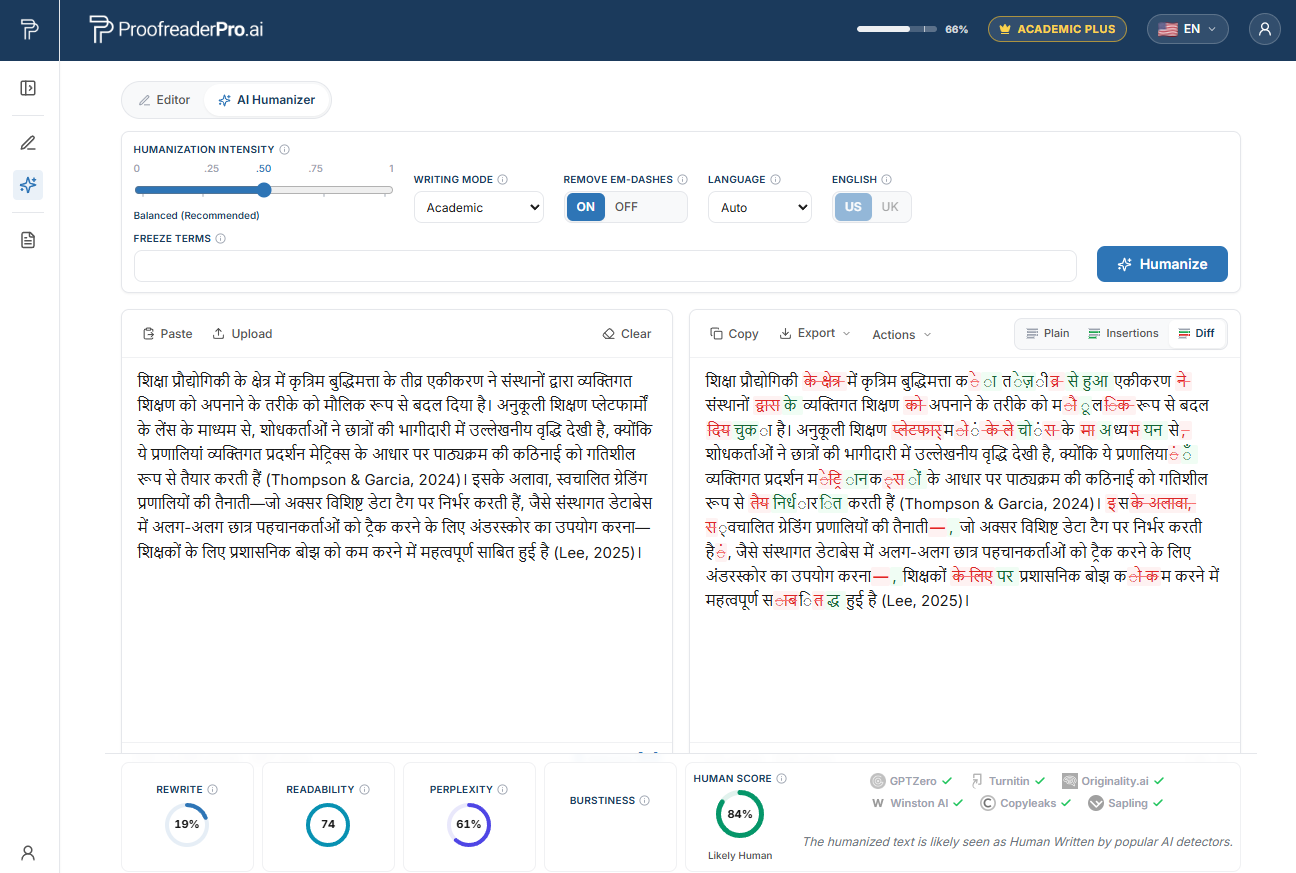
ProofreaderPro AI Humanizer переписывает академический текст на хинди. Разница «до/после» сохраняет смысл и цитирования, а проверки детектора подтверждают естественное, человеческое прочтение.
Почему индийских исследователей отмечают ИИ-детекторы
В 2023 году команда из Stanford во главе с Liang и коллегами опубликовала в журнале Cell Press Patterns исследование под названием «GPT detectors are biased against non-native English writers». Они прогнали эссе, написанные людьми, по TOEFL через семь широко используемых детекторов. В среднем около 61% не носительских эссе было отмечено как ИИ — по сравнению примерно с 5% у эссе, написанных носителями английского. Почти каждое пятое не носительское эссе (около 19,8%) было отмечено единогласно каждым из детекторов. Все эссе были написаны людьми.
Механизм здесь — перплексность (perplexity). Многие детекторы оценивают, насколько «неожиданно» для языковой модели выбранное слово в каждом конкретном случае. Аккуратные авторы, пишущие на втором языке, используют распространённые слова и стандартные, предсказуемые формулировки — это даёт низкую перплексность, и текст считывается как машинный. Привычки, благодаря которым не носительский академический текст выглядит ясным и корректным, — это ровно те привычки, которым эти инструменты обучали «искать». Мы подробно разбираем это в материале why AI detectors flag non-native writers.
Паттерны хинди и региональных языков, стоящие за ложными срабатываниями
Академический английский в Индии несёт системное влияние хинди, тамильского, бенгальского, телугу, маратхи и других первых языков. Это не «неряшливые» ошибки. Это предсказуемые стандартизированные способы, которыми внимательные авторы компенсируют дистанцию между их родным языком и английским; а именно предсказуемость обеспечивает тому же детектору на основе перплексности высокий балл ИИ.
Артикли. Во многих индийских языках нет системы артиклей, поэтому различие «the» vs «a» vs отсутствие артикля — того, что в хинди не существует. Авторы, которые приучили себя не забывать артикли (то есть «выпилили» привычку их опускать), нередко переисправляют это в чрезмерно регулярные «учебниковые» формулировки вроде «The experiment was conducted using a modified protocol». Корректно, стандартно и с низкой перплексностью.
Предлоги. Паттерны вроде «discuss about», «comprises of» и «interested on» напрямую переносятся из хинди. После редактирования до стандартной формы английского фраза каждый раз «приземляется» на самый распространённый, наиболее предсказуемый предлог — ровно то, чего детектор ожидает от модели.
Порядок слов и согласование. Хинди следует порядку «подлежащее — дополнение — сказуемое». Индийские исследователи, строящие длинные предложения на английском, часто перестраивают их в самое безопасное, привычное «подлежащее — сказуемое» конструктивное ядро, чтобы оставаться корректными. Безопасно и привычно — значит, это также воспринимается как низкая перплексность.
Согласование времён. Маркеры времён в английском более жёсткие, чем в большинстве индийских языков, поэтому внимательные авторы фиксируют раздел «Методы» в едином прошедшем времени. Единообразно, регулярно и предсказуемо — снова.
Длина предложений. Индийская академическая проза чаще тяготеет к более длинным предложениям со сложной структурой. Когда их «подрезают» под ожидания журнала, они нередко схлопываются в короткие, ровные, похожие по форме предложения — и детектор считывает это как машинный ритм.
Контекст ИИ-детектирования и Turnitin в Индии
Диссертации и журнальные заявки в Индии нередко проходят проверку через Turnitin или iThenticate — и на сходство, и на признаки ИИ. Большинство университетов проводит обязательную проверку на плагиат до того, как диссертацию принимают, и многие теперь также смотрят индикатор ИИ-авторства в том же отчёте. Рекомендации UGC по академической добросовестности сделали проверку сходства рутинной частью оценки исследований.
Важно быть точными в том, что именно эти инструменты делают. Сам Turnitin подавляет баллы за ИИ в диапазоне 1–19%: вместо числа отображается астериск, и при этом предупреждается, что этот балл нельзя использовать в одиночку для принятия решения о добросовестности. Ряд учреждений за рубежом, включая Vanderbilt, пошли дальше: в 2023 году они отключили ИИ-детектор Turnitin, ссылаясь на ложные срабатывания и систематическую предвзятость против авторов, не являющихся носителями английского. Michigan State, UT Austin, Northwestern, Pittsburgh, SMU и Waterloo приняли похожие меры. Балл детектора — это утверждение, которое можно оспаривать, а не окончательный вердикт.
При этом всё чаще спонсоры и журналы просят авторов раскрывать, как они использовали ИИ. Для индийского исследователя разумная позиция — не скрывать использование ИИ. Нужно написать и отредактировать тщательно, защитить аккуратное письмо от ложного флага, а затем чётко раскрыть, что именно вы сделали.
Защитите ваш аккуратный английский от ложной отметки о применении ИИ
Сделайте более естественным ваш черновик с ИИ-помощью, сохраните смысл и цитирования, затем сообщите об этом. Создано для индийских исследователей, подготавливающих статьи для журналов Scopus и Web of Science.
Попробуйте бесплатный HumanizerТоповые индийские университеты и где встречаются ИИ-проверки
Объём научной продукции Индии сосредоточен в сети элитных учреждений, и каждое из них до продвижения работы вперёд проводит проверки диссертаций и рукописей — на сходство и на ИИ.
- IISc Bengaluru (भारतीय विज्ञान संस्थान): ведущая исследовательская организация Индии (NIRF 2025 — №1), сильнейшая в физических науках, инженерии и биологических науках.
- IIT Madras, IIT Delhi, IIT Bombay, IIT Kharagpur, and IIT Kanpur (भारतीय प्रौद्योगिकी संस्थान): исходные пять IIT; стабильно входят в топ-10 по исследованиям в инженерии, информатике и материаловедении.
- IIT Roorkee, IIT Guwahati, and IIT Hyderabad: более новые IIT с быстро растущими исследовательскими профилями в инженерных и прикладных науках.
- AIIMS New Delhi (अखिल भारतीय आयुर्विज्ञान संस्थान): ведущая медицинская исследовательская организация Индии; публикует биомедицинские и клинические работы в высокорейтинговых журналах.
- Jawaharlal Nehru University (जवाहरलाल नेहरू विश्वविद्यालय): NIRF 2025 — №2 в категории университетов; сильнейшие позиции в социальных науках и гуманитарных дисциплинах.
- University of Delhi (दिल्ली विश्वविद्यालय): один из крупнейших научных университетов Индии с широким охватом в естественных и гуманитарных науках.
- Banaras Hindu University (काशी हिन्दू विश्वविद्यालय): значительный объём работ в естественных науках, инженерии и аюрведической медицине.
- Jadavpur University: сильные инженерные и естественнонаучные исследования; стабильно входит в топ-10 индийских университетов.
- Homi Bhabha National Institute: ядерная наука, физика и инженерия; аффилирован с BARC и другими организациями DAE.
Каждое из этих учреждений требует от исследователей публиковаться в англоязычных международных журналах для карьерного продвижения, и каждое использует ИИ- и проверку сходства, на которые ложный флаг тоже может «попасть».
Как работает AI-хьюманайзер для индийских исследователей
AI-хьюманайзер для индийских исследователей построен вокруг одной рабочей последовательности, а не вокруг обходного пути. Вот порядок действий, который мы рекомендуем.
Сначала — черновик. Если так удобнее, пишите на том языке, в котором думаете: хинди или тамильском, бенгальском — затем переводите на английский или же составляйте черновик на английском с поддержкой ИИ. Во-вторых, вычитайте грамматику, чтобы артикли, предлоги и времена были корректными. В-третьих, прогоните результат через text humanizer, чтобы аккуратно стандартизированная проза получила естественное разнообразие по ритму и подбору слов и с меньшей вероятностью была неверно прочитана как машинный вывод. Ваш смысл, техническая терминология и цитирования остаются ровно там, куда вы их поставили.
Наш хьюманайзер преобразует ИИ-текст в более естественную «человеческую» форму: это снижает ИИ-сигнал и повышает шансы против сложных детекторов (при этом точность грамматики остаётся высокой на академическом тексте). Это основано на тестировании, а не на гарантиях. Детекторы перенастраиваются каждые несколько месяцев, поэтому мы описываем, что именно делает инструмент, никогда не обещаем, что любой текст навсегда останется нераспознаваемым, и не рассматриваем это как способ обойти проверку.
Затем — раскрытие. Добавьте формулировку об использовании ИИ в формате, который требует ваше учреждение и целевой журнал. Аккуратное письмо, защищённое от ложного флага, а затем — ясное раскрытие — помогают оставаться в рамках правил добросовестности. Это тот же принцип, что лежит в основе нашего academic editing guide for researchers in India, и он встроен в наш более широкий multilingual AI humanizer hub.
Локальные организации, финансирующие исследования, журналы и ожидания по раскрытию использования ИИ
От исследователей, финансируемых DST-SERB, CSIR, ICMR или DBT, ожидают публикации в международных журналах как часть отчётных результатов гранта, а языковое редактирование признано допустимой статьёй расходов в большинстве из этих организаций. Это важно, потому что означает: использование инструмента для вычитки и «очеловечивания» черновика, подготовленного с помощью ИИ, — легитимная статья исследовательских затрат, а не обходной манёвр.
Индийские исследователи публикуются и в международных, и в отечественных журналах. Ряд заметных индийских изданий ожидают английский, готовый к публикации, и всё чаще спрашивают об использовании ИИ при отправке:
- Current Science: старейший междисциплинарный журнал Индии, основан C.V. Raman в 1932 году.
- Indian Journal of Medical Research (IJMR): открытый доступ, издаётся ICMR, только на английском — и входит в число наиболее цитируемых журналов Индии.
- Pramana (Journal of Physics): Indian Academy of Sciences; совместная публикация со Springer.
- Economic & Political Weekly (EPW): ведущий журнал по общественным наукам; индексируется в Scopus.
- Journal of Biosciences и Journal of Earth System Science: оба издания — от Indian Academy of Sciences.
- Sadhana: инженерные науки от Indian Academy of Sciences; в рейтингах Q1 и Q2.
- The National Medical Journal of India: рецензируемые клинические и медицинские исследования.
Все журналы Indian Academy of Sciences требуют английские рукописи. Куда бы вы ни отправляли работу, самое безопасное правило — раскрывать своё использование ИИ в формате, требуемом журналом, и при необходимости иметь короткую приватную запись о том, что именно вы сделали, на случай апелляции из‑за ложного флага.
Часто задаваемые вопросы
В: Является ли использование AI-хьюманайзера для индийских исследователей формой обмана?
Нет. Правильное применение — «очеловечить» собственный черновик с поддержкой ИИ, сохранить смысл и цитирования и затем раскрыть использование ИИ в том формате, который требует ваше учреждение и журнал. Вы защищаете аккуратное, человеческое исследование от ложного флага, а не маскируете выдуманные материалы или чужое письмо.
В: Гарантирует ли хьюманайзер, что моя статья пройдёт ИИ-детектор Turnitin?
Нет. Ни один инструмент не может обещать подобного, и любой инструмент, который это обещает, вводит вас в заблуждение. После тестирования на основных детекторах наш хьюманайзер переписывает ИИ-текст в более естественную «человеческую» форму: это снижает ИИ-сигнал и повышает шансы против сложных детекторов. При этом детекторы продолжают перенастраиваться, поэтому результат не бывает постоянным. Мы сообщаем, что показало тестирование, и никогда не заявляем, что текст навсегда останется нераспознаваемым.
В: Работает ли это для хинди, тамильского, бенгальского и других индийских языков?
Да. Хьюманайзер поддерживает более 60 языков. Вы можете составлять черновик на том языке, в котором думаете, затем перейти к академическому английскому — и языково-ориентированная модель сохранит структуру предложений и смысл. Она обрабатывает типичные для хинди, тамильского, бенгальского, телугу, маратхи и других первых языков интерференционные паттерны в английском.
В: Могу ли я оплатить это из моего гранта DST-SERB или CSIR?
Языковое редактирование признано допустимой статьёй расходов в большинстве организаций, финансирующих исследования в Индии, включая DST-SERB, CSIR, ICMR и DBT. Подписки на редактирующие и «хьюманайзинговые» программные решения обычно укладываются в допустимые исследовательские расходы. Проверьте условия вашего конкретного гранта, чтобы убедиться.
В: Что происходит с моими цитированиями и техническими терминами?
Они остаются ровно там, где вы их разместили. Хьюманайзер меняет ритм и подбор слов и убирает навязчивую «каденцию», но сохраняет ваш смысл, вашу техническую терминологию и каждое цитирование. Перед отправкой вы оцениваете результат самостоятельно.
Сохраняйте смысл, терминологию и цитирования. Изменяйте ритм, который детекторы отмечают. Создано для индийских исследователей, пишущих на английском как на втором или третьем языке.

Мо — инженер NLP с PhD в области обработки естественного языка. Его исследования охватывают компьютерную лингвистику, анализ текста и машинное обучение, и они напрямую используются в моделях редактирования и гуманизации, лежащих в основе ProofreaderPro. Он пишет о той части процесса, которую большинство людей никогда не видит: о том, как языковая модель читает предложение, оценивает его и решает, что изменить.


