
ИИ «humanizer» для греческих исследователей, пишущих на английском
ИИ humanizer для греческих исследователей. Снижает ложные срабатывания при детекции ИИ для английского, на который влияет греческий: сохраняет смысл и цитирования и честно сообщает о применении.

Физик из Национального технического университета Афин готовит раздел «Методы» на английском: она проверяет каждую статью и каждое видовременное значение дважды, а затем отправляет рукопись в журнал, индексируемый в Scopus. Через несколько недель соавтор пересылает ей редакторскую заметку: автоматический детектор ИИ пометил часть рукописи как написанную машиной. Она написала каждое предложение сама.
Ситуация сейчас достаточно типична, и поэтому она влияет на то, насколько тщательно исследователи решают вообще подавать материалы. ИИ humanizer для греческих исследователей создан, чтобы решить эту проблему — и причина его необходимости говорит больше о самих детекторах, чем о качестве письма.
Греческие исследования сильны в инженерии, информатике, физике, медицине и классических дисциплинах, и значительная их часть выходит в мир на английском, тогда как ход мысли и первые наброски формируются на греческом. Поскольку за продвижение и оценку единиц измерения отвечают публикации в Web of Science и Scopus, давление публиковаться на ясном английском не ослабевает. Проблема в том, что ясный, нормативный английский как второй язык — именно тот тип письма, который эти инструменты чаще всего неверно читают.
Humanising AI text for Greek researchers (εξανθρωπισμός κειμένου AI)
Наш humanizer помогает греческим академическим авторам публиковаться на английском без того, чтобы внимательная к нормам и «влияниям родного языка» проза ошибочно принималась за машинную. Он работает с вашим собственным черновиком с ИИ-помощью, сохраняет ваш смысл и цитирования, а также меняет ритм фраз и выбор слов — то, на чём детекторы обычно фиксируются. Вы можете протестировать его на text humanizer с любым абзацем, который был отмечен несправедливо.
Это руководство — один узел в более широком multilingual AI humanizer hub, который решает ту же проблему более чем для шестидесяти языков, потому что паттерн ложных срабатываний повторяется везде, где люди пишут академический английский как второй язык.
Пишете по-гречески? Человеко-ориентатор распознает и обрабатывает и этот язык
Не каждый черновик начинается на английском, и humanizer не требует этого. Вставьте греческий текст — и ProofreaderPro автоматически распознаёт греческий алфавит, после чего направляет его в языково-ориентированную модель, сохраняющую вашу терминологию, акценты и цитирования ровно в том виде, в каком они заданы. Как εξανθρωπισμός κειμένου AI он переписывает вашу греческую прозу напрямую, чтобы вы могли сделать её более «человечной» ещё до перевода. Тот же механизм детекции охватывает более шестидесяти языков: каждый текст переписывается как «сам себя».
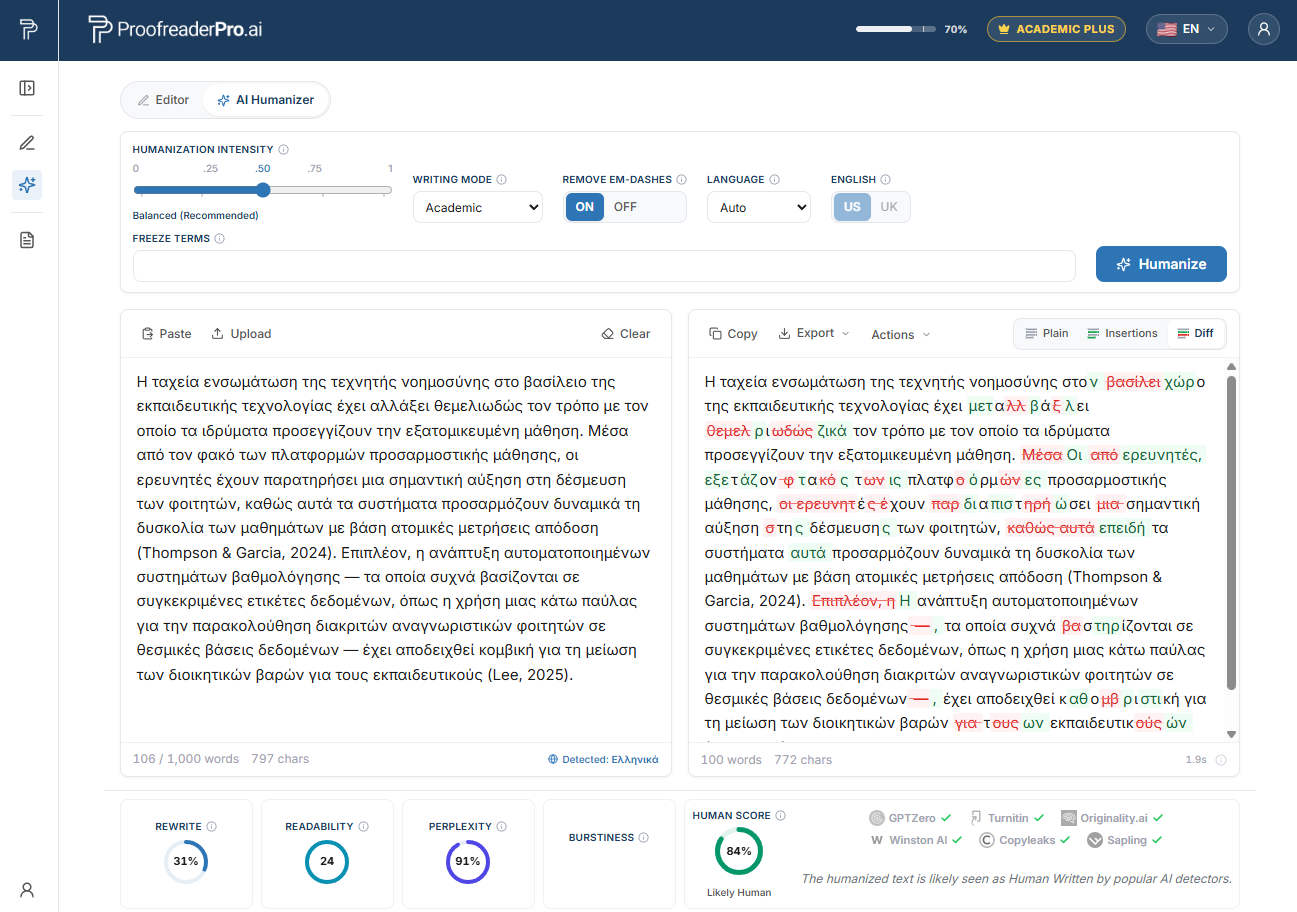
ProofreaderPro AI Humanizer переписывает греческий академический текст. Сравнение до и после сохраняет ваш смысл и цитирования, а проверки детектора подтверждают естественное, человеческое чтение.
Почему греческих исследователей чаще помечают детекторы ИИ
Начнём с исследования, которое дало цифры этой проблеме. В 2023 году команда Стэнфорда во главе с Weixin Liang опубликовала в журнале Cell Press Patterns материал «GPT detectors are biased against non-native English writers». Авторы взяли эссе, написанные людьми для TOEFL, и прогнали их через семь широко используемых детекторов.
Результат оказался перекошенным. В среднем около 61% эссе, написанных авторами, для которых английский не является родным языком, были помечены как ИИ — против примерно 5% для эссе носителей английского. Почти одно из пяти не-навородных эссе — около 19,8% — было помечено единогласно каждым детектором из набора. И каждое из этих эссе имело человеческого автора.
Механизм называется perplexity (перплексией). Многие детекторы оценивают, насколько «неожиданно» следующее слово для языковой модели, и текст, построенный из частотных слов в предсказуемом порядке, получает низкий балл. Низкая перплексия читается как машинный текст. Внимательный греческий исследователь, выбирающий стандартную лексику и безопасные шаблоны предложений, фактически создаёт именно ту прозу, которой детектор был обучен не доверять. Мы глубже разбираем этот сбой в why AI detectors flag non-native writers.
Греческие паттерны первого языка за ложными срабатываниями
Ни одна из привычек ниже не является ошибкой. Это корректные, стандартные конструкции — и именно поэтому они снижают перплексию и «рисуют» отметку.
Артикли — самый наглядный случай. В греческом используется определённый артикль с абстрактными существительными, собственными именами и обобщающими оборотами, поэтому на английском, написанном носителем греческого, естественно появляется «the»: «the science shows», «the Professor Papadopoulos argued», «the nature of the problem». Каждая фраза грамматически корректна, а их устойчивое накопление отличается очень регулярным характером.
Время и вид задают второй сигнал. В греческом аспект маркируется иначе, чем в английском, поэтому выбор между present perfect и simple past, или между простыми и длительными формами, может выглядеть ровно и предсказуемо по всему абзацу. Детектор воспринимает эту ровность как паттерн, а не как результат выбора человеком.
Важна также длина предложений. Академический стиль греческого часто предпочитает длинные периоды, связанный плотными связками, поэтому «moreover», «furthermore» и «in addition» накапливаются в «швах» аргумента. Эти связки — также среди слов с наивысшей вероятностью, которые модель ожидает увидеть следующими, что дополнительно снижает перплексию.
Ещё два эффекта переноса завершают картину. Порядок слов переходит из языка с более свободным порядком, порождая топикализированные предложения, которые корректны, но однообразны по форме. А варианты транслитерации, когда имена и технические термины выходят за пределы греческого алфавита, добавляют ещё один слой регулярности. Вместе эти черты заставляют честный греко-английский выглядеть — с точки зрения детектора — подозрительно «гладким».
Контекст ИИ-детекции: Греция и Turnitin
Тезисы и журнальные подачи из греческих учреждений регулярно проходят проверку. Сходство через Turnitin или iThenticate является стандартной практикой для диссертаций и рукописей, и эти же платформы теперь показывают индикаторы ИИ-письма наряду с показателем сходства.
Университеты по всей Греции выпустили собственные рекомендации по generative AI, и направление развития указывает не на запрет, а на раскрытие информации. Финансирующие организации и журналы всё чаще просят авторов указывать, где и как использовались инструменты ИИ. Ничто из этого не делает помощь ИИ запрещённой. Это означает, что от авторов ожидают честного раскрытия — а это совершенно иная вещь, чем скрывать использование.
Важно помнить: балл детектора — не приговор. Сама по себе Turnitin подавляет низкие оценки ИИ и предупреждает, что её число не должно быть единственной основой для решения об академической добросовестности. Некоторые университеты в других странах пошли дальше и отключили свои детекторы ИИ ровно из‑за той предвзятости, которая документирована выше. Пометка — это утверждение, которое вы вправе оспорить, а не установление вины.
Не позволяйте предвзятому детектору говорить за ваше исследование
Вставьте абзац, отмеченный детектором, и посмотрите, как приведение текста к естественному виду сохраняет ваш смысл, терминологию и цитирования, при этом меняя ритм, который детекторы часто неверно считывают.
Попробуйте бесплатный HumanizerЛучшие греческие университеты и где появляются проверки ИИ
Ниже перечислены учреждения, которые проверяют диссертации и рукописи на сходство и всё чаще учитывают индикаторы ИИ. Если вы подаёте в любое из них, ожидайте, что ваша диссертация или заявка будет проходить через одну из этих систем.
- Εθνικό και Καποδιστριακό Πανεπιστήμιο Αθηνών (National and Kapodistrian University of Athens, NKUA), в Афинах
- Αριστοτέλειο Πανεπιστήμιο Θεσσαλονίκης (Aristotle University of Thessaloniki, AUTH), в Салониках
- Εθνικό Μετσόβιο Πολυτεχνείο (National Technical University of Athens, NTUA), в Афинах
- Πανεπιστήμιο Πατρών (University of Patras), в Патрах
- Πανεπιστήμιο Κρήτης (University of Crete), в Ираклионе и Ретимно
- Πανεπιστήμιο Ιωαννίνων (University of Ioannina), в Янине
- Πανεπιστήμιο Θεσσαλίας (University of Thessaly), в Волосе
- Οικονομικό Πανεπιστήμιο Αθηνών (Athens University of Economics and Business, AUEB), в Афинах
- Δημοκρίτειο Πανεπιστήμιο Θράκης (Democritus University of Thrace), в Комотини
Этот список не исчерпывает высшее образование Греции, но он охватывает те места, где чаще всего реально происходит основное английскоязычное исследовательское письмо и где, в основном, осуществляется скрининг.
Как работает AI humanizer для греческих исследователей
Процесс честный и понятный, и он помогает вам оставаться в рамках правил.
Сначала черновик. Пишите на греческом, если именно там ваша мысль выражается яснее всего, а затем переводите — или сразу создайте черновик на английском с любой доступной вам помощью. Доведите аргументацию и доказательства до корректности, прежде чем беспокоиться о том, как текст звучит.
Следующий шаг — вычитка грамматики. Исправьте избыточное употребление артиклей, выровняйте времена и проверьте терминологию, чтобы смысл был ровно таким, как вы задумали. Наш text humanizer не заменяет этот этап, потому что чистый исходный текст даёт лучший результат.
Затем «humanize» — сделайте более «человечным» — ваш собственный текст с ИИ-помощью. Инструмент меняет ритм предложений и выбор слов, разбивает однообразную интонацию, которая читается как низкая перплексия, и убирает узнаваемые следы вроде повторяющихся связок и случайных длинных тире — при этом сохраняет ваш смысл, терминологию и каждое цитирование. Текст на неанглийском языке проходит через языково-ориентированную модель, поэтому греческий фрагмент сохраняет свою структуру, а не превращается в «плоский» вариант.
Что мы можем честно утверждать о результатах? В наших собственных тестах humanizing существенно снижает вероятность того, что внимательный стандартный не-родной английский будет неверно принят за ИИ главными детекторами, такими как Turnitin, Originality.ai и GPTZero, сохраняя академический смысл. Мы не будем подставлять цифру. Детекторы перенастраиваются раз в несколько месяцев, и ни один честный инструмент не может обещать 100% неуловимость. Любой, кто гарантирует обратное, фактически продаёт вам обещание.
И наконец — раскрывайте использование. Укажите своё применение ИИ в формате, который требует руководитель, учреждение и целевой журнал. Humanizing защищает внимательное письмо от смещённой пометки; раскрытие сохраняет корректную запись о том, какую помощь вы использовали. Эти две вещи идут вместе. А для редакторской помощи, выходящей за рамки humanizing, наш global academic editing hub собирает языковые ресурсы поддержки в одном месте.
Локальные структуры финансирования, журналы и ожидания по раскрытию ИИ
Конкурентное финансирование исследований в Греции во многом проходит через HFRI — Hellenic Foundation for Research and Innovation (ΕΛΙΔΕΚ), которое поддерживает проекты под руководством исследователей, тогда как GSRI, General Secretariat for Research and Innovation, задаёт национальную политику в области исследований. Многие греческие группы также держат гранты Европейского исследовательского совета (ERC). У каждого из этих контуров — своя культура отчётности, и раскрытие использования ИИ постепенно становится её частью.
Со стороны публикаций греческие исследователи ориентируются на журналы, индексируемые в Web of Science и Scopus, а National Documentation Centre (EKT) ведёт национальные репозитории и статистику исследований. Большинство международных журналов теперь включает оговорку о раскрытии ИИ в руководствах для авторов. Безопасная привычка — прочитать эту оговорку до подачи материалов и написать короткое заявление, описывающее ваши инструменты, вместо того чтобы оставлять процесс на то, что можно будет лишь предположить.
Держите рассуждение в фокусе. Humanizing собственного черновика — это не способ обойти что-либо из перечисленного. Он защищает ясный греко-английский от документированной предвзятости детектора, а раскрытие оставляет запись корректной. Настоящая работа — обработанная справедливо.
Часто задаваемые вопросы
Вопрос: Поможет ли ИИ humanizer, если мой текст пометили, хотя я писал его сам?
Да, именно этот случай и заложен в его основу. Внимательный английский как не-родной язык получает низкий балл по перплексии и ошибочно воспринимается как машинный текст; humanizing меняет ритм и выбор слов, которые запускают пометку, сохраняя ваш смысл. Он не может отменить тот факт, что детекторы несовершенны, но убирает те конкретные черты, которые они переоценивают.
Вопрос: Меняет ли humanising AI text мои цитирования или технические термины?
Нет. Humanizer сохраняет цитирования, ссылки и терминологию предметной области, потому что любое изменение повредило бы рукопись. Он работает с ритмом и формулировками, а не с вашими доказательствами или специализированным словарём.
Вопрос: Считается ли использование AI humanizer для греческих исследователей нечестным (cheating)?
Нет, если использовать его честно. Вы humanize собственный черновик с ИИ‑помощью, сохраняете ваш смысл и цитирования, а затем раскрываете использование ИИ так, как требуют ваше учреждение и журнал. Цель — справедливость для реального письма, а не маскировка вымышленных работ.
Вопрос: Может ли какой-либо инструмент гарантировать, что мой текст пройдёт каждый детектор ИИ?
Нет — и вам стоит недоверять тем, кто это обещает. Детекторы регулярно меняют модели, поэтому ни один инструмент не может гарантировать 100% неуловимость. То, что может сделать хороший humanizer, — уменьшить частоту, с которой честная не-родная проза получает ошибочную пометку; именно это мы наблюдаем в тестировании.
Вопрос: Я писал на греческом, а затем перевёл. Это делает пометку более вероятной?
Это может быть так, потому что переведённая академическая проза обычно бывает очень стандартной и регулярной — а именно это выглядит как низкая перплексия. Humanizing переведённого черновика и последующее раскрытие вашего процесса — разумный способ не наказывать ясное письмо за его ясность.
Разработано для академических авторов не из англоязычных стран: снижайте число ложных отметок об ИИ для аккуратного греко-английского, сохраняя цитирования, терминологию и аргументацию.

Мо — инженер NLP с PhD в области обработки естественного языка. Его исследования охватывают компьютерную лингвистику, анализ текста и машинное обучение, и они напрямую используются в моделях редактирования и гуманизации, лежащих в основе ProofreaderPro. Он пишет о той части процесса, которую большинство людей никогда не видит: о том, как языковая модель читает предложение, оценивает его и решает, что изменить.


