
AI Humanizer untuk Penyelidik Hungary yang Menulis dalam Bahasa Inggeris
AI humanizer untuk penyelidik Hungary. Kurangkan salah tanggapan pengesanan AI pada bahasa Inggeris yang dipengaruhi oleh struktur Hungary, kekalkan makna dan petikan, serta nyatakan penggunaan secara jujur.

Sains Hungary menonjol melebihi ukurannya. Sebuah negara dengan jumlah penduduk kurang daripada sepuluh juta telah melahirkan barisan ahli matematik, ahli fizik, ahli kimia dan saintis hayat yang luar biasa, dan tradisi itu masih terserlah dalam hasil kerja universiti-universitinya hari ini. Namun, kerja itu ditulis dalam bahasa Inggeris. Hampir setiap penyelidik di Budapest atau Szeged terlebih dahulu menyusun draf dan berfikir dalam bahasa Hungary, kemudian membawa hujah itu ke dalam bahasa kedua yang hampir tiada persamaan dari segi tatabahasa. Jurang terjemahan inilah yang menjadi sebab AI humanizer untuk penyelidik Hungary wajar ada, kerana bahasa Hungary–Inggeris yang ditulis dengan teliti kini tersalah dibaca sebagai teks mesin.
Bahagian yang tidak selesa ialah ini. Semakin bersih dan semakin standard bahasa Inggeris anda, semakin besar kemungkinan pengesan AI akan menandainya. Model yang menilai teks berdasarkan betapa "mengejutkan" setiap perkataan dianggap memperlakukan frasa anda yang berdisiplin dan mudah dijangka sebagai petunjuk penulisan oleh pengarang mesin. Ganjaran kerana menulis dengan jelas dalam bahasa kedua yang sukar ialah tuduhan palsu.
Kami membina humanizer ini khusus untuk masalah tersebut: untuk melindungi kerja sebenar oleh penyelidik sebenar, bukan untuk menyembunyikan jalan pintas sesiapa. Panduan ini menerangkan bagaimana ia sesuai dalam aliran kerja penerbitan yang jujur bagi sarjana di Hungary.
AI-szöveg humanizálása untuk penyelidik Hungary
AI-szöveg humanizálása bermaksud menjadikan teks yang dibantu kecerdasan buatan anda lebih berirama seperti manusia, sambil memastikan maksud, istilah bidang dan rujukan kekal tidak berubah. Our tool is built for Hungarian academics who draft in their own language and then publish in English.
Intinya bukan untuk menyamar. Intinya ialah ayat bahasa Inggeris standard dan teliti yang ditulis oleh seorang sarjana Hungary tidak seharusnya dianggap meragukan hanya kerana ia teliti dan standard. Itulah "false flag" yang direka untuk dikurangkan oleh text humanizer.
Draf dalam bahasa Hungary? Humanizer mengesan dan mengubahnya secara terus
Anda boleh menghumanisasikan draf bahasa Hungary tanpa menterjemahkannya ke bahasa Inggeris terlebih dahulu. Tampal teks anda, kemudian ProofreaderPro mengesan bahasa secara automatik dan meneruskannya melalui model yang memahami bahasa Hungary, menghormati vokal panjang, bentuk beragglutinasi, serta petikan dalam penulisan anda. AI-szöveg humanizálása ini mengubah ritma penulisan prosa Hungary sambil mengekalkan setiap istilah dan rujukan. Pengesanan automatik merentas lebih daripada enam puluh bahasa, jadi bahasa Hungary diperlakukan sebagai bahasa Hungary, bukannya diubah suai menjadi bahasa Inggeris semata-mata.
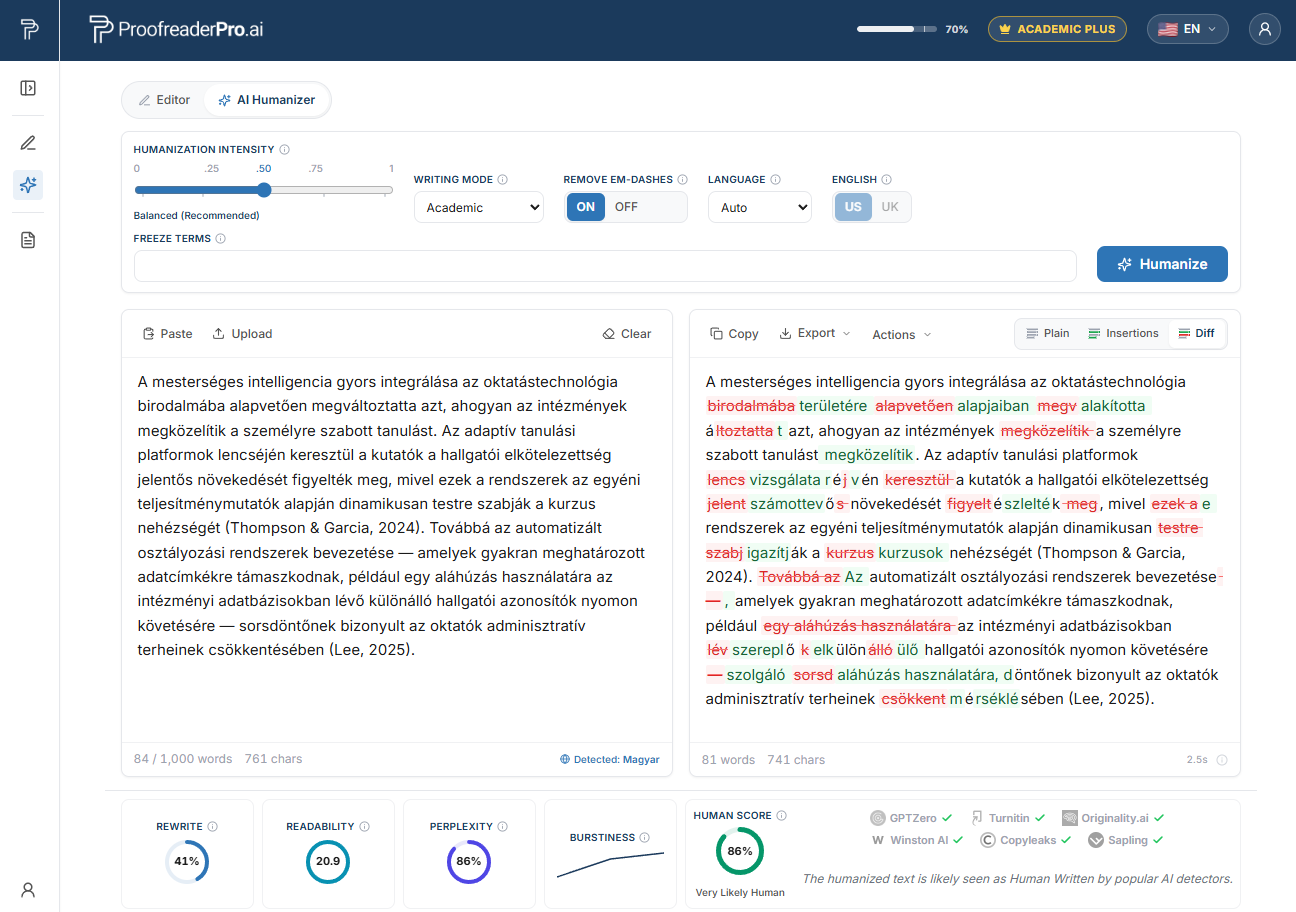
The ProofreaderPro AI Humanizer rewriting Hungarian academic text. Perbezaan sebelum dan selepas (before and after diff) mengekalkan maksud serta petikan anda, dan pemeriksaan pengesan mengesahkan bacaan yang lebih natural dan bersifat manusia.
Mengapa penyelidik Hungary mudah ditandai oleh pengesan AI
Pada 2023, sebuah kumpulan penyelidikan dari Stanford yang diketuai oleh Weixin Liang menguji tujuh pengesan GPT yang digunakan secara meluas pada esei yang ditulis oleh manusia. Esei tersebut datang daripada peperiksaan TOEFL, jadi setiap satu mempunyai pengarang manusia yang kebetulan ialah penulis bahasa Inggeris bukan penutur asli. Secara purata, kira-kira 61% daripada esei tersebut ditandai sebagai dijana AI. Bagi esei yang ditulis oleh penutur asli bahasa Inggeris, bilangannya sekitar 5%. Hampir satu daripada lima esei bukan penutur asli, lebih kurang 19.8%, ditandai secara sebulat suara oleh setiap pengesan.
Baca sekali lagi. Penulisan manusia ditandai lebih kerap lebih daripada sepuluh kali ganda semata-mata kerana bahasa Inggeris ialah bahasa kedua penulis.
Mekanisme ini dipanggil perplexity. Banyak pengesan menganggarkan sejauh mana pilihan perkataan anda dapat diramal oleh model bahasa. Apabila anda menulis dalam bahasa kedua, anda akan cenderung memilih binaan yang selamat, biasa dan betul, kerana itulah yang dilakukan oleh penulis yang teliti. Yang selamat dan yang biasa bermakna perplexity yang rendah, dan perplexity yang rendah ialah cap yang tepat yang alat-alat ini dilatih untuk dibaca sebagai teks mesin. Kami mengupas mekanisme penuh dalam why AI detectors flag non-native writers, tetapi versi ringkasnya keras: tabiat yang menjadikan prosa anda jelas ialah tabiat yang menyebabkan ia ditandai.
Pola bahasa pertama Hungary di sebalik false flag
Bahasa Hungary ialah bahasa Uralik, tidak berkaitan dengan bahasa-bahasa Indo-Eropah di sekelilingnya, dan logiknya memang berbeza daripada bahasa Inggeris. Perbezaan itu meninggalkan "cap" dalam penulisan bahasa Hungary–Inggeris. Tiada satu pun daripada cap ini ialah kesilapan kecerdasan. Ini ialah bayangan tatabahasa yang sangat berbeza, dan apabila dihaluskan menjadi bahasa Inggeris yang bersih, ia terbaca rata dan mudah dijangka oleh sebuah pengesan.
Satu kata ganti untuk he dan she. Bahasa Hungary mempunyai satu kata ganti orang ketiga dan tiada jantina tatabahasa, jadi "he" dan "she" akan bertukar dalam bahasa Inggeris. Penulis yang membetulkan perkara ini cenderung menggunakan pilihan paling selamat secara berlebihan atau membina semula ayat sekitar "the author" dan "the participant," lalu menghasilkan prosa yang sangat sekata dan variasinya rendah.
Artikel yang diedarkan dengan cara berbeza. Bahasa Hungary memang menggunakan artikel (a, az, egy), tetapi meletakkannya berdasarkan logik yang berlainan daripada bahasa Inggeris. Artikel definitif dan indefinitif boleh digugurkan atau ditambah, dan pembetulan yang teliti biasanya ialah artikel paling standard seperti dalam buku teks, setiap kali. "Standard" ialah perkara yang tepat untuk menjaringkan teks seakan-akan mesin.
Ag=glutination dan nominalisasi yang berat. Bahasa Hungary membina maksud dengan menyusun kata akhiran pada satu kata dasar. Apabila dipindahkan ke bahasa Inggeris, tabiat itu bertukar menjadi frasa nama yang padat dan rangkaian nominalisasi panjang ("the implementation of the optimisation of...") yang sempurna dari sudut tatabahasa namun monoton dari segi irama. Penganalisis gemar akan monoton.
Susunan perkataan yang menonjolkan topik. Bahasa Hungary mengutamakan topik serta fokus sesuatu ayat, jadi penekanan itu jatuh di tempat yang berbeza daripada jangkaan pembaca bahasa Inggeris. Apabila seorang penulis menormalkan ini menjadi susunan bahasa Inggeris yang mudah (subjek–kata kerja–objek), hasilnya betul, tersusun, dan mudah dijangka.
Tiada penanda kala masa hadapan dan sistem aspek yang berbeza. Bahasa Hungary menandai masa hadapan dengan cara yang berlainan dan mengendalikan aspek mengikut caranya sendiri, jadi pilihan kala dalam bahasa Inggeris boleh menjadi tidak konsisten, kemudian dibetulkan ke arah kala yang paling neutral dan paling biasa. Kala yang paling selamat sekali lagi ialah kala dengan perplexity yang paling rendah.
Postposisi, bukan preposisi. Bahasa Hungary meletakkan penanda hubungan selepas kata nama, lalu menghasilkan "preposition slips" dalam bahasa Inggeris. Membetulkan kesilapan itu bermaksud memilih preposisi standard setiap kali, dan standard ialah sesuatu yang dibaca oleh pengesan sebagai terjana.
Lindungi bahasa Hungary-Inggeris anda yang teliti daripada tanda palsu
Manusiakan draf anda yang dibantu AI sambil mengekalkan setiap petikan, istilah, dan dapatan, kemudian nyatakan alat anda dengan yakin.
Cuba Humanizer secara percumaKonteks pengesanan AI Hungary dan Turnitin
Tesis dan penghantaran jurnal daripada institusi Hungary lazimnya disaring untuk persamaan kandungan, paling kerap menggunakan Turnitin atau sistem yang setara, dan petunjuk AI kini semakin digabungkan dalam saringan yang sama. Ini kini menjadi bahagian normal dalam pertahanan doktorat dan semakan manuskrip, bukan langkah luar biasa.
Ada baiknya kita melihat had alat-alat ini. Beberapa universiti besar di luar negara, termasuk Vanderbilt, telah mematikan pengesan penulisan AI Turnitin kerana false positives dan kecenderungan terhadap penulis bukan penutur asli, dan Turnitin sendiri menyekat skor paling rendahnya serta memberi amaran bahawa jumlah itu tidak seharusnya menentukan kes integriti secara sendirian. Skor pengesan ialah satu dakwaan yang anda dibenarkan untuk pertikaikan, bukan keputusan muktamad.
Institusi di Hungary telah mengeluarkan panduan mereka sendiri tentang AI generatif, dan pemberi dana serta jurnal semakin mengharapkan penulis untuk mendedahkan bagaimana alat-alat ini digunakan. Jawapan yang jujur bukan untuk menyembunyikan apa-apa. Jawapannya ialah menulis dan menyunting secara bertanggungjawab, kemudian mengisytiharkan alat yang anda bergantung padanya.
Universiti Hungary utama dan di mana semakan AI muncul
Penyaringan persamaan serta petunjuk AI dapat dilihat di seluruh sistem pendidikan tinggi Hungary, daripada sekolah doktorat hingga pejabat editorial jurnal. Institusi berikut antara yang paling intensif dari segi penyelidikan di negara ini, dan tesis serta manuskrip mereka melalui semakan tersebut:
- Eötvös Loránd Tudományegyetem (Eötvös Loránd University, ELTE), Budapest
- Semmelweis Egyetem (Semmelweis University), Budapest, sebuah sekolah perubatan utama
- Szegedi Tudományegyetem (University of Szeged), Szeged
- Debreceni Egyetem (University of Debrecen), Debrecen
- Budapesti Műszaki és Gazdaságtudományi Egyetem (Budapest University of Technology and Economics, BME), Budapest
- Budapesti Corvinus Egyetem (Corvinus University of Budapest), Budapest
- Pécsi Tudományegyetem (University of Pécs), Pécs
- Pázmány Péter Katolikus Egyetem (Pázmány Péter Catholic University), Budapest
- Óbudai Egyetem (Óbuda University), Budapest
Sama ada kerja anda ialah disertasi yang dipertahankan di ELTE atau manuskrip klinikal daripada Semmelweis, dinamik yang sama tetap berlaku: bahasa Hungary–Inggeris yang standard dan teliti ialah penulisan yang paling berkemungkinan mencetuskan "flag" berasaskan perplexity.
Cara AI humanizer untuk penyelidik Hungary berfungsi
Aliran kerja yang kami cadangkan adalah ringkas dan, yang lebih penting, jujur. Ia mempunyai tiga peringkat.
Pertama, draf. Tulis kertas anda dengan cara yang paling cepat memindahkan pemikiran anda ke halaman. Bagi ramai penyelidik Hungary, ini bermakna mendraf dalam bahasa Hungary dan menterjemah, atau menulis terus dalam bahasa Inggeris dengan bantuan AI. Kedua-duanya boleh.
Kedua, prufkan isi. Betulkan tatabahasa, istilah, dan hujah supaya sains adalah tepat. Jika bahasa itu sendiri memerlukan semakan yang teliti, global academic editing hub kami meliputi sisi kerja tersebut.
Ketiga, humanisasikan draf anda sendiri. Di sinilah text humanizer masuk. Ia mengubah panjang ayat dan ritma, memecahkan rentak monoton yang cenderung dihasilkan oleh bahasa Hungary–Inggeris yang beragglutinasi, serta menghapuskan em dash yang terasing dan struktur berulang yang ditinggalkan oleh kedua-dua alat AI dan kebiasaan penulisan bahasa kedua. Yang penting, ia mengekalkan maksud anda, kosa kata teknikal anda, dan setiap petikan. Teks sumber bukan Inggeris dialihkan melalui model yang memahami bahasa, dan alat ini menyokong lebih daripada enam puluh bahasa.
Apa yang itu capai? Dalam ujian kami sendiri, humanisasi draf bukan penutur asli yang teliti mengurangkan secara ketara seberapa kerap pengesan utama tersalah membacanya sebagai penulisan yang dijana mesin, namun maksud akademik kekal utuh. Kami menggambarkannya sebagai apa yang kami lihat dalam ujian, bukan sebagai janji. Tiada alat yang jujur dapat menjamin hasil di sini, kerana pengesan akan dilatih semula setiap beberapa bulan, dan mana-mana perkhidmatan yang mendakwa 100% tidak dapat dikesan sedang menjual sesuatu yang ia sendiri tidak dapat buktikan.
Langkah terakhir: nyatakan. Tambahkan kenyataan penggunaan AI dalam format yang universiti dan jurnal sasaran anda perlukan. Humanisasi penulisan yang dibantu AI anda sendiri dan kemudian mengisytiharkannya bukan satu helah. Ini bermaksud memastikan kerja teliti anda dinilai berdasarkan meritnya, bukannya ditandai kerana "jenayah" menjadi jelas dalam bahasa kedua. Untuk gambaran bahasa yang lebih luas merentasi negara, lihat multilingual AI humanizer hub.
Badan pembiayaan tempatan, jurnal, dan jangkaan pendedahan AI
Penyelidikan yang kompetitif di Hungary sebahagian besarnya dibiayai melalui NKFIH (Nemzeti Kutatási, Fejlesztési és Innovációs Hivatal, the National Research, Development and Innovation Office), dengan MTA (Magyar Tudományos Akadémia, the Hungarian Academy of Sciences) sebagai akademi kebangsaan dan HUN-REN (the Hungarian Research Network) mengendalikan institut penyelidikan awam. Kesemuanya memberi ganjaran kepada hasil yang diterbitkan dan diindeks, yang mengekalkan tekanan berterusan terhadap penyelidik untuk menerbitkan dalam bahasa Inggeris.
Hasil itu diukur melalui jurnal yang diindeks dalam Web of Science dan Scopus serta didaftarkan dalam MTMT (Magyar Tudományos Művek Tára, the Hungarian Scientific Bibliography), pangkalan data penerbitan kebangsaan. Budaya penilaian yang mengutamakan penerbitan antarabangsa dalam bahasa Inggeris ialah tekanan yang sama yang mendorong sarjana Hungary beralih kepada prosa yang bersih dan standard, tepat jenis prosa yang sering disalahbaca oleh pengesan.
Jangkaan pendedahan penggunaan AI akan menjadi lebih lazim dalam laporan geran dan penghantaran jurnal. Anggaplah ia sebagai rutin. Nyatakan dengan jelas alat yang anda gunakan dan bagaimana ia digunakan, kekalkan data dan petikan anda secara jujur, dan anda akan kekal dalam ruang lingkup peraturan dengan selesa sambil mempertahankan penulisan anda daripada penandaan yang tidak adil.
Soalan lazim
S: Adakah AI humanizer untuk penyelidik Hungary mengubah petikan saya atau istilah teknikal?
Tidak. Humanizer dibina untuk mengekalkan maksud anda, istilah bidang yang khusus kepada disiplin anda, dan setiap rujukan dengan tepat seperti yang anda tulis. Ia mengubah ritma dan frasa, bukan sains anda atau sumber anda.
S: Bolehkah mana-mana alat menjamin kertas saya melepasi setiap pengesan AI?
Tidak, dan anda perlu tidak mempercayai sesiapa yang mendakwa sebaliknya. Pengesan dilatih semula secara kerap, jadi tiada perkhidmatan yang jujur boleh menjanjikan ia 100% tidak dapat dikesan. Yang boleh kami katakan ialah, dalam ujian kami, humanisasi prosa bukan penutur asli yang teliti mengurangkan dengan ketara kekerapan ia disalahbaca sebagai penulisan yang dijana mesin.
S: Adakah menghumanisasi draf saya sendiri satu bentuk menipu?
Bukan, selagi anda bekerja pada penulisan yang dibantu AI anda sendiri, memastikan dapatan anda kekal jujur, dan mendedahkan penggunaan alat anda seperti yang dikehendaki universiti dan jurnal. Matlamatnya ialah keadilan untuk kerja yang benar, bukan penyamaran.
S: Mengapa bahasa Inggeris saya yang jelas ditandai, sedangkan penulisan yang lebih lemah tidak?
Kerana banyak pengesan menjaringkan kebolehramalan. Penulis bahasa kedua yang teliti cenderung memilih binaan yang selamat, standard dan betul, yang menghasilkan teks dengan perplexity rendah; dan perplexity yang rendah ialah corak tepat yang dikaitkan oleh alat-alat ini dengan penulisan mesin. Kejelasan anda justeru bekerja menentang anda.
S: Saya menulis dalam bahasa Hungary dahulu. Adakah alat itu boleh mengendalikan itu?
Ya. Teks bukan Inggeris dialihkan melalui model yang memahami bahasa dan mengekalkan struktur ayat serta maksud merentas lebih daripada enam puluh bahasa, jadi anda boleh mendraf dalam bahasa Hungary, menterjemah, kemudian menghumanisasikan versi bahasa Inggeris tanpa kehilangan hujah anda.
Ubah draf Hungary-Inggeris anda yang teliti, dibantu AI, menjadi gaya prosa akademik yang lebih natural, sambil mengekalkan setiap petikan dan dapatan, kemudian nyatakan penggunaan AI anda dengan yakin.

Moe ialah seorang jurutera NLP dengan PhD dalam pemprosesan bahasa semula jadi. Penyelidikan beliau meliputi linguistik pengiraan, analisis teks dan pembelajaran mesin, dan ia disalurkan terus ke dalam model penyuntingan dan kemanusiaan di belakang ProofreaderPro. Dia menulis tentang bahagian proses yang tidak pernah dilihat oleh kebanyakan orang: bagaimana model bahasa membaca ayat, menjaringkannya dan memutuskan perkara yang perlu diubah.


