
영어로 글을 쓰는 이탈리아 연구자를 위한 AI 휴머나이저
이탈리아 연구자를 위한 AI 휴머나이저입니다. 이탈리아식 영향이 반영된 영어에서 발생하는 AI 감지 오탐(false AI-detection) 경고를 줄이되, 의미와 인용을 그대로 유지하고 정직하게 AI 사용을 공개하세요.

이탈리아는 세계 최고의 연구 생산국(상위 8~10개 국가) 중 하나로 꼽히지만, 그 성과가 이탈리아어로는 거의 독자에게 전달되지 않습니다. 이곳의 학자들은 한 언어로 초안을 작성하고 사고를 전개한 뒤, 다른 언어로 출판합니다. 이탈리아의 연구 경력은 색인된 영어 학술지의 영어 논문을 통과하는 경로로 이어지기 때문입니다. VQR 연구의 질 평가와 ASN(교수 자격) 역시 Scopus와 Web of Science에서의 서지(바이브리오메트릭) 기준에 기대고 있으므로, 적절한 저널에 실린 영어 논문은 선택 사항이 아닙니다.
이러한 압박은 이제 더 새로운 문제와 충돌하고 있습니다. 이탈리아 연구자를 위한 AI 휴머나이저가 존재하는 이유는, 세심하고 정확한 제2외국어 영어가야말로 AI 감지기가 기계가 쓴 글로 오인하기 쉬운 문체이기 때문입니다. 동료가 직접 작업하고 모든 문장을 작성했는데도 여전히 감지(플래그)가 붙었다면, 이는 단지 우연이 아닙니다.
이 글은 ‘위장’이 아니라 ‘공정성’에 관한 안내입니다. AI 보조 초안을 사람다운 글로 다듬되 의미와 인용을 그대로 유지하고, 그다음 소속 기관과 학술지가 요구하는 방식에 따라 AI 사용을 정직하게 공개하세요.
영어로 출판하는 이탈리아 연구자를 위한 IA 텍스트 휴머나이저
저희의 IA 텍스트 휴머나이저는 이탈리아 연구자들이 영어로 출판할 때, 올바른 글쓰기가 기계가 생성한 텍스트로 오인되지 않도록 돕습니다. 의미, 전문 용어, 그리고 인용을 보존하면서 문장 리듬과 어휘 선택을 다양화합니다.
쉽게 말하면, 과학(연구)은 사용자가 직접 쓰고, 도구는 표준적인 비원어민 글이 ‘합성된 글’처럼 읽히게 만드는 통계적 지문을 매끈하게 다듬어 줍니다. 사용자의 주장, 데이터, 참고문헌은 어떤 것도 바뀌지 않습니다. 달라지는 것은 일부 감지기가 ‘기계의 서명’처럼 취급하는, 고르게 예측 가능한 문장 리듬뿐입니다.
이탈리아어 초안을 쓰고 있나요? 휴머나이저가 이를 직접 감지하고 재작성합니다
먼저 이탈리아어 초안을 영어로 번역하지 않고도 인간다운 글로 만들 수 있습니다. 텍스트를 그대로 붙여넣으면 ProofreaderPro가 언어를 자동으로 감지한 뒤, 이탈리아어에 민감하게 설계된 모델로 라우팅하여 악센트, 전문 용어, 인용을 그대로 유지합니다. IA 텍스트 휴머나이저는 이탈리아어 문장의 리듬을 다양하게 만들면서도 모든 발견과 참고문헌을 보존합니다. 자동 감지는 60개 이상의 언어에 걸쳐 작동하므로, 이탈리아어는 영어로 재구성되는 것이 아니라 ‘이탈리아어로서’ 처리됩니다.
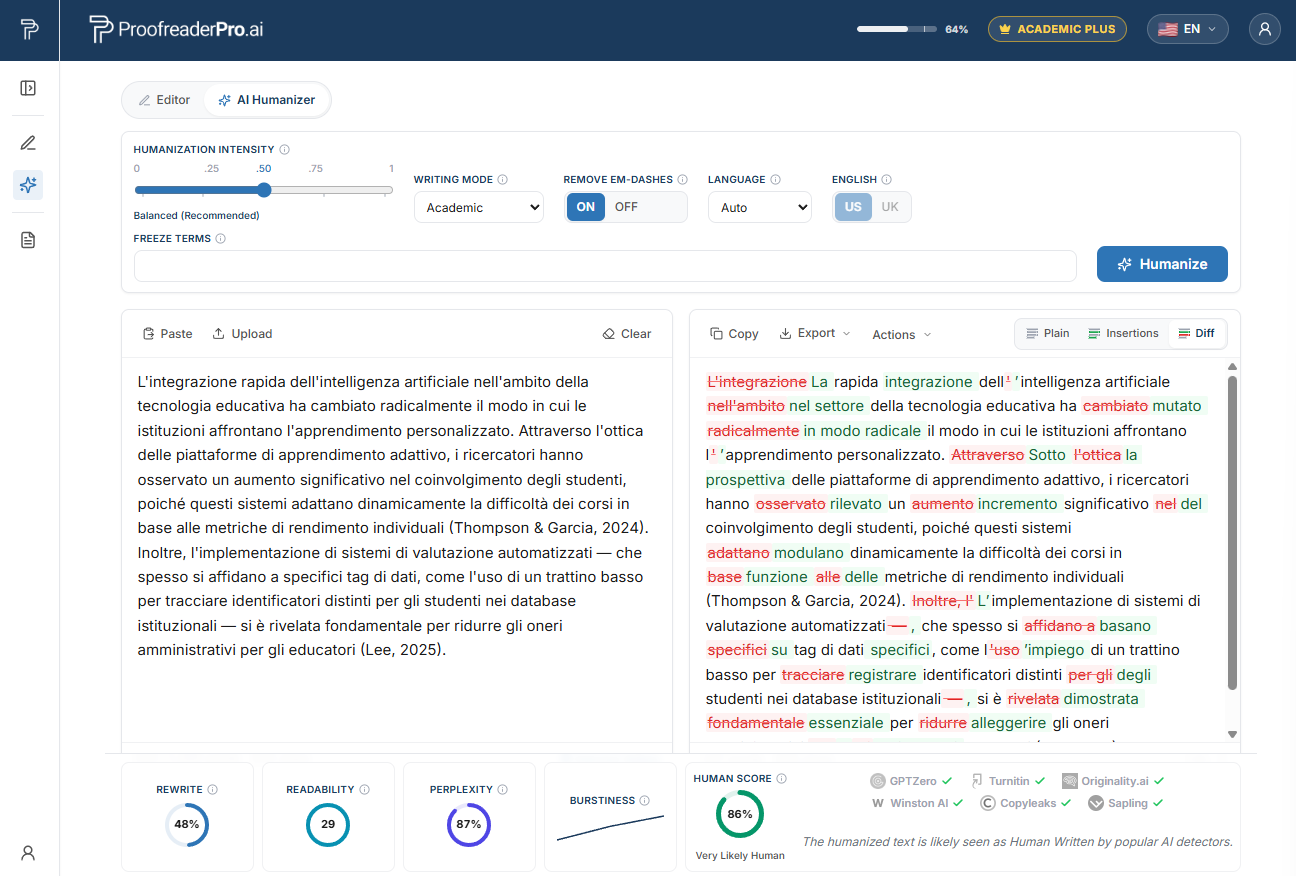
ProofreaderPro AI 휴머나이저가 이탈리아 학술 텍스트를 재작성하는 모습입니다. before/after diff는 의미와 인용을 그대로 유지하며, 감지기 체크는 자연스럽고 사람이 읽는 방식임을 확인해 줍니다.
왜 이탈리아 연구자는 AI 감지기에서 플래그가 뜰까요?
2023년, Liang과 동료들이 이끄는 스탠퍼드 팀은 Cell Press 저널 Patterns에 비교적 직설적인 제목의 연구를 발표했습니다: GPT detectors are biased against non-native English writers (GPT 감지기는 비원어민 영어 작가에게 불리하다). 연구진은 사람이 직접 쓴 TOEFL 에세이를 널리 쓰이는 7개 감지기에 통과시켰습니다.
결과는 2언어 환경에서 출판하는 모든 사람에게 우려를 불러일으킬 만합니다. 평균적으로 비원어민이 쓴 에세이의 약 61%가 AI로 플래그되었고, 원어민은 약 5%였습니다. 거의 5분의 1에 해당하는 약 19.8%는 모든 감지기에 대해 만장일치로 플래그되었습니다. 그리고 그 에세이들 모두는 실제로 사람이 작성한 글이었습니다.
그 메커니즘을 ‘퍼플렉서티(perplexity)’라고 부릅니다. 감지기는 언어 모델 관점에서 각 단어 선택이 얼마나 ‘놀라운지(생소한지)’를 측정합니다. 제2언어를 신중하게 다듬어 쓰는 작가들은 흔한 단어와 표준적이고 예측 가능한 문구를 선택하는 경향이 있습니다. 그러면 퍼플렉서티가 낮아지고, 그 결과 기계가 쓴 텍스트처럼 읽힙니다. 영어를 선명하게 만드는 습관과, 이 도구들이 벌주도록 훈련된 습관은 동일합니다. 자세한 내용은 why AI detectors flag non-native writing에서 더 나눠 설명하겠습니다.
‘오탐’ 뒤에 있는 이탈리아어(모국어) 패턴
아래에 제시된 어떤 패턴도 ‘오류’가 아닙니다. 이탈리아의 학자가 교과서에 맞춰 세심하게 선택하는 표현들이고, 바로 그처럼 규칙적이라는 점이 감지기가 낮은 퍼플렉서티로 읽도록 만드는 요인입니다.
긴 종속(가설) 문장. 이탈리아 학술 문체는 몇 개의 중첩된 종속 절을 포함하는 긴 문장을 선호합니다. 이를 영어로 옮기면 문법은 유지되지만 문장 밀도가 높아지고, 고르게 다듬어진 ‘과도하게 격식 있는’ 리듬은 모델 입장에서는 예측 가능한 패턴으로 보일 수 있습니다.
추상명사와 함께 쓰는 관사. 영어에서는 보통 관사를 생략하는 ‘자연, 과학, 사회’ 같은 표현을 작성할 때, 이탈리아어에서의 관사 사용이 그대로 옮겨가는 경우가 많습니다. 이런 일관된 전달은 감지기가 낮은 점수로 보상하는 신호와 정확히 일치합니다.
전치사 전이. depend from(= dipendere da) 또는 on the basis of(= based on) 같은 선택은 체계적이고 규칙에 의해 통제되는 경향입니다. 체계적인 선택은 정의상 낮은 퍼플렉서티로 이어집니다.
명사화와 라틴계 어휘. the realization of the analysis 같은 무거운 명사구와, 라틴계 어휘를 꾸준히 선호하는 태도는 표준적인 격식 체계입니다. 격식적이고 표준적인 문체야말로 이런 도구들이 플래그하는 방식입니다.
칼크(번역투) 커넥터. 문장 첫머리에서 Moreover, Furthermore, In fact 같은 연결어를 자주 쓰는 습관은 이탈리아 담화 표지에서 그대로 옮겨 온 것입니다. 이로 인해 규칙적이고 반복적인 문장 리듬이 만들어져, 기계가 매끄럽게 이어 붙인 글처럼 읽힙니다.
가짜 동족어(오해하기 쉬운 표현). Attualmente는 actually rather than currently, 또는 eventualmente는 eventually rather than possibly처럼, 신중한 작가가 가장 표준적으로 보이는 단어로 교정해 가는 과정에서 생기는 선택입니다. 가장 표준적인 단어는 또한 가장 덜 놀라운(덜 생소한) 단어이기도 합니다.
이탈리아의 AI 감지 및 Turnitin 맥락
이탈리아의 학위논문과 원고는 텍스트 유사도 검사를 받는 경우가 흔하며, 대개 Turnitin 또는 iThenticate로 수행됩니다. 또한 이들 도구는 익숙한 유사도 점수와 함께 AI 지표를 점점 더 많이 함께 노출하고 있습니다. 유사도 리포트는 박사과정 학교와 편집 워크플로에서 정상적인 절차이며, 그 자체만으로는 사용자의 성실성(정직성)에 대해 아무 말도 하지 못합니다.
관점을 정리해 두면 좋은 점은 두 가지입니다. 첫째, AI 지표는 ‘판결’이 아니라 ‘주장’입니다. Turnitin 자체도 1~19% 범위의 점수를 억제하며, 그 숫자만으로 단독 판단을 내려 무결성(integrity) 사안을 결정하지 말아야 한다고 경고합니다. Vanderbilt, Michigan State, UT Austin을 포함한 여러 대학은 오탐과 비원어민 작성자에 대한 편향을 이유로 AI 감지기를 아예 비활성화했습니다.
둘째, 이탈리아를 포함해 다른 지역에서도 이동 방향은 ‘공개’로 향하고 있습니다. 지원기관과 저널은 점점 더 사용자가 AI를 어디에서, 어떻게 사용했는지 명시하길 요구합니다. 이러한 기대는 사용자를 보호하는 장치입니다. ‘완벽한 감지 점수’가 아니라 ‘완전한 공개’가 사용자를 규정 안에 있게 만드는 요인입니다.
잘못된 플래그로부터 자신의 글을 보호하십시오
몇 분 만에 AI로 보조한 초안을 자연스럽게 바꾸고, 모든 인용을 유지한 다음 공개하십시오. 세심한 비원어 학술 영어를 위해 제작되었습니다.
Humanizer를 무료로 사용해 보세요이탈리아의 주요 대학과 AI 체크가 나타나는 위치
위에서 설명한 선별은 이탈리아의 핵심 기관 전반에서 이뤄집니다. 박사과정 학교와 편집 사무실은 이 대학들에서 논문과 원고를 유사도 점검에 돌리고, 점차 AI 지표의 비중도 함께 고려합니다:
- 로마의 Sapienza Università di Roma
- 볼로냐의 Università di Bologna (Alma Mater Studiorum)
- 밀라노의 Politecnico di Milano 및 Università degli Studi di Milano (Statale)
- 파도바의 Università degli Studi di Padova
- 나폴리의 Università degli Studi di Napoli Federico II
- 토리노의 Politecnico di Torino 및 Università degli Studi di Torino
- 피사의 Università di Pisa, Scuola Normale Superiore, 그리고 Scuola Superiore Sant'Anna
- 피렌체의 Università degli Studi di Firenze
- 트렌토의 Università degli Studi di Trento
- 밀라노의 Università Cattolica del Sacro Cuore
어느 곳이든, 플래그는 사용자의 정직성을 판정하는 결론이 아니라 방법에 대해 대화를 시작하는 신호입니다. 이런 점검이 일상적이라는 사실을 아는 것은 공황의 이유가 아니라, 준비해야 할 이유가 됩니다.
이탈리아 연구자를 위한 AI 휴머나이저는 어떻게 작동하나요?
다음은 워크플로이며, 순서가 중요합니다.
먼저, 주장(논지)의 초안을 작성하세요. 사고가 가장 날카롭게 정리되는 지점이라면 이탈리아어로 먼저 작성한 뒤 번역하거나, 또는 영어로 직접 초안을 작성하셔도 됩니다. 어떤 경우든 아이디어와 데이터는 모두 사용자의 것입니다.
둘째, 문법을 바로잡습니다. 잘못된 동족어, 전치사, 관사 누락/실수를 교정해 언어가 무엇보다도 먼저 깨끗하게 정돈되도록 하세요. 저희의 교정 도구는 바로 이런 목적을 위해 구축되어 있으며, AI proofreading for Italian academics에서 관련 ‘형제’ 워크플로를 확인할 수 있습니다.
셋째, 자신의 문장을 인간다운 방식으로 만드세요. AI 보조 초안을 AI text humanizer를 통해 실행합니다. 이 과정은 리듬과 단어 선택을 다양화하고, 감지기를 넘어뜨리기 쉬운 반복적이고 낮은 퍼플렉서티의 문장 리듬을 제거하면서도 의미, 기술 용어, 인용을 보존합니다.
휴머나이저는 주요 감지기에 대해 테스트되었고, AI 텍스트를 더 자연스러운 ‘사람의 글’ 형태로 재구성합니다. 그 결과는 Turnitin, Originality.ai, GPTZero에서 사람이 쓴 글처럼 읽히도록 하면서도, 학술 텍스트에서 문법 정확도를 높게 유지합니다. 이 결과는 약속이 아니라 테스트에서 나온 값입니다. 감지기는 몇 달마다 재학습하므로, 어떤 것도 우회해 주겠다는 식으로 약속하지 않습니다.
넷째, 공개하세요. AI 사용 내역을 소속 기관과 목표 저널이 요구하는 형식에 맞춰 명시합니다. 이 마지막 단계가 ‘진짜 작업을 공정하게 보호’하는 것과 ‘위장’의 차이를 갈라놓습니다.
이 글은 저희 multilingual AI humanizer hub에서 제공하는 단계 중 하나로, 다른 모국어를 가진 연구자들이 작성할 때도 동일한 워크플로를 다룹니다. 필요한 것이 감지기 공정성보다 ‘완전한 언어 편집’에 더 가깝다면, global academic editing hub에서 시작해 보세요.
현지 연구지원 기관, 저널, 그리고 AI 공개 기대치
이탈리아의 연구지원 및 평가 체계는 몇몇 주요 기관을 통해 이뤄지며, 각 기관은 사용자의 연구가 어디에 출판되는지에 따라 위험도를 다르게 높입니다.
MUR(Ministero dell'Università e della Ricerca)는 대학과 국가 단위 그랜트를 지원합니다. PRIN(Progetti di Ricerca di Rilevante Interesse Nazionale)은 핵심 경쟁형 국가 프로그램입니다. CNR(Consiglio Nazionale delle Ricerche)은 이 나라에서 가장 큰 공공 연구기관입니다. ANVUR는 VQR 평가와 ASN 자격을 모두 운영하며, 인문·사회과학 분야에서 실제 영향력이 있는 ‘A등급 저널’ 목록도 관리합니다.
배치(게재) 측면에서는, 이는 Scopus 및 Web of Science 색인과, 비-바이브리오메트릭 분야에서의 ANVUR A등급 지위를 의미합니다. 이런 저널로 향하는 원고는 Turnitin 또는 iThenticate로 선별되며, 점점 더 많은 저널과 지원기관이 AI 사용에 대한 명시적 진술서를 요구하고 있습니다. 해당 진술서는 미리 준비하세요. 그리고 만약 감지기가 깨끗한 작업에 플래그를 붙인다면, 그 보고서를 ‘판결’이 아니라 ‘다투어 볼 수 있는 증거’로 취급하십시오. 제출 전에 AI text humanizer를 한 번 더 적용하면 비원어민 글이 더 공정하게 읽히고, 사용자의 공개는 전체 절차를 투명하게 유지해 줍니다.
자주 묻는 질문
Q: 이탈리아 연구자를 위한 AI 휴머나이저를 사용하는 것은 부정행위의 한 형태인가요?
아니요. 자신의 작업에 사용할 때는 그렇지 않습니다. 사용자가 연구를 작성했고, 도구는 단지 신중한 비원어민 문장이 기계 텍스트로 오인될 가능성을 낮추도록 문장 리듬과 단어 선택을 다양화할 뿐입니다. 이를 투명하게 만드는 규칙은 ‘공개’입니다. 사용자는 여전히 자신의 소속 기관과 저널에 AI를 어떻게 사용했는지 알려야 합니다.
Q: 휴머나이저가 제 인용이나 기술 용어를 바꾸나요?
아니요. 참고문헌, 데이터, 그리고 해당 학문의 용어를 보존합니다. 이 도구는 감지기가 반응하는 낮은 퍼플렉서티의 문장 리듬을 목표로 하며, 사용자의 주장 내용 자체를 바꾸지 않습니다.
Q: 제 논문이 Turnitin 또는 GPTZero를 통과할 수 있음을 보장하나요?
아니요. 그런 약속을 하는 어떤 도구도 조심하세요. 저희 테스트에서 휴머나이저는 AI 텍스트를 더 자연스러운 사람의 글 형태로 재작성하여 AI 신호를 낮추고, 까다로운 감지기에 대한 가능성을 높이지만, 감지기는 계속 재학습하므로 보증이 아니라 테스트된 결과를 보고드립니다.
Q: 제 문법적으로 정확한 영어가 왜 애초에 플래그되나요?
감지기는 사용자의 단어 선택이 얼마나 ‘예측 가능한지’를 점수로 매깁니다. 관사 사용부터 라틴계 어휘 선택까지 이어지는 표준적이고 교과서적인 이탈리아어-영어 구성은 매우 예측 가능하며, 이는 낮은 퍼플렉서티로 읽히고, 일부 도구는 이를 AI의 신호로 취급합니다. 이는 사용자의 작업에 대한 판단이 아니라, 신중하게 쓰는 제2언어 글쓰기에 대한 문서화된 편향입니다.
Q: 위원회나 저널이 제 글을 플래그하면 무엇을 해야 하나요?
침착하게 대응하고 플래그를 ‘판결’이 아니라 ‘답변해야 할 주장’으로 취급하세요. 초안과 메모를 유지하고, 비원어민 작가에 대한 문서화된 편향을 지목하며, AI 사용 내역 공개를 공유하십시오. 감지기 점수는 다툴 수 있는 증거이지, 결코 확정적 증명은 아닙니다.
세심한 비원어 영어를 더 공정하게 읽히게 하십시오. 의미와 인용을 보존하고, 잘못된 AI 경고를 줄인 뒤, 자신 있게 공개하십시오.

Moe는 자연어 처리 분야에 PhD를 갖춘 NLP 엔지니어입니다. 그의 연구는 컴퓨터 언어학, 텍스트 분석 및 기계 학습을 다루며 ProofreaderPro의 편집 및 인간화 모델에 직접 적용됩니다. 그는 대부분의 사람들이 전혀 보지 못하는 프로세스의 일부, 즉 언어 모델이 문장을 읽고 점수를 매기고 무엇을 변경할지 결정하는 방법에 대해 글을 씁니다.


