2026년 AI 텍스트 워터마킹: OpenAI, Google, 그리고 Anthropic의 차이
OpenAI는 텍스트 워터마크를 만들었지만 출시하지 않았습니다. Google은 SynthID를 배포하고 오픈 소스로 공개했습니다. Anthropic은 Claude에 대한 필수 사용을 도입했습니다. 각 시스템이 무엇을 하는지, 무엇을 입증하는지, 그리고 글쓰기에 어떤 의미가 있는지 알아봅니다.

OpenAI, Google, 그리고 Anthropic은 모두 같은 기술, 즉 AI 생성 텍스트를 위한 통계적 워터마크를 구축했습니다. OpenAI는 자사의 버전을 한 번도 공개하지 않았습니다. Google은 SynthID를 Gemini에 탑재해 제공하고 방법을 공개했습니다. Anthropic은 2026년 8월에 Claude의 워터마크를 모든 사용자에게 의무화했습니다. 어떤 형태로든 AI의 도움을 받아 글을 쓴다면, 이제 이 세 가지 결정이 모두 여러분의 문서가 어떻게 평가되는지에 영향을 미칩니다.
워터마킹은 2026년 8월 11일 Anthropic이 모든 새 Claude 모델이 텍스트 출력을 표시한다고 발표하면서 연구 주제에서 대중 뉴스로 옮겨갔습니다. 우리는 그 발표를 Claude 워터마크 해설에서 자세히 다뤘습니다. 이 가이드는 전체 그림을 설명합니다. 텍스트 워터마크가 무엇인지, 세 개의 주요 연구소가 각각 이를 어떻게 구현하거나 보류했는지, 그리고 각 시스템이 글의 어떤 부분을 증명하는지입니다.
AI 텍스트 워터마크란 무엇인가?
AI 텍스트 워터마크는 생성된 텍스트의 단어 선택에 숨겨진 통계적 패턴으로, 생성 시점에 심어져 나중에 올바른 키를 가진 탐지기가 그 텍스트가 특정 AI 시스템에서 나왔음을 검증할 수 있게 합니다. 이는 눈에 보이는 라벨도 아니고, 숨겨진 문자도 아니며, 파일에 붙는 메타데이터도 아닙니다. 이 표시는 단어 자체에 존재합니다.
이 구분은 중요합니다. "워터마크"라는 용어가 세 가지 서로 다른 것을 느슨하게 가리키기 때문입니다:
| 무엇인지 | 어디에 존재하는지 | 복사 붙여넣기 후에도 유지되는가? | |
|---|---|---|---|
| 통계적 워터마크 | 모델이 선택하는 단어에 대한 편향 | 텍스트 자체 | 예 |
| 파일 메타데이터 (C2PA) | 서명된 출처 라벨 | 파일 컨테이너 | 아니오, 일반 텍스트로 복사하면 제거됨 |
| 제로폭 문자 | 텍스트에 삽입된 보이지 않는 Unicode | 보이는 문자들 사이 | 아니오, 쉽게 제거됨 |
통계적 워터마킹은 복사, 붙여넣기, 새 문서로의 재입력, 형식 변환을 거쳐도 살아남는 세 가지 중 유일한 방식입니다. 이것이 바로 세 개의 주요 연구소가 텍스트에 대해 이 방식으로 수렴한 이유이며, 보이지 않는 문자를 제거하는 "워터마크 제거기"가 이에 대해 아무런 효과가 없는 이유입니다. 우리의 무료 Claude 워터마크 제거기 페이지는 출처와 함께 이 실패 양상을 문서화합니다.
통계적 워터마킹은 실제로 어떻게 작동하나요?
문장을 쓰는 매 단계에서 언어 모델은 서로 거의 동등한 여러 단어 중에서 하나를 고르고, 워터마킹은 그 주사위를 조용히 조작합니다. 이 기본적인 방식은 2023년 1월 메릴랜드 대학교의 Kirchenbauer와 동료들이 대규모 언어 모델을 위한 워터마크 (ICML 2023)에서 발표했습니다. 작동 방식은 다음과 같습니다:
- 각 단어가 선택되기 전에, 앞선 단어들로부터 파생된 비밀 키가 어휘를 선호 집합과 중립 집합으로 나눕니다.
- 모델은 선택을 선호 집합 쪽으로 약간 밀어줍니다. "indicate" 대신 "suggest". "among" 대신 "across". 각 개별 선택은 전혀 자연스럽게 보입니다.
- 키를 가진 탐지기는 텍스트가 선호 집합에 얼마나 자주 들어가는지 셉니다. 사람이 쓴 글은 우연히 기대되는 비율에 도달합니다. 워터마크가 적용된 텍스트는 그 비율에 지나치게 자주 도달하며, 통계적 검정이 그 차이를 포착합니다.
어떤 한 단어도 무언가의 증거가 되지는 않습니다. 신호는 수십 개 또는 수백 개의 선택에 걸쳐서야 드러나며, 그래서 긴 문단이 짧은 문단보다 검정하기 쉽고, 탐지는 언제나 예 아니오가 아니라 확률적일 수밖에 없습니다.
Google DeepMind의 생산 시스템은 2024년 10월 Nature에 대규모 언어 모델 출력을 식별하기 위한 확장 가능한 워터마킹으로 발표되었고, 토너먼트 샘플링이라는 기법으로 이를 다듬었습니다. 이 기법은 소비자용 제품 안에서 대규모로 조용히 작동할 만큼 텍스트 품질을 충분히 잘 보존합니다. 이 논문은 Google에만 중요한 것이 아닙니다. Anthropic이 Claude의 구현 근거로 지목하는, 공개된 기반이기 때문입니다.
가장 큰 약점은 대부분의 도입보다 먼저 공개되었습니다. 2023년 3월 Krishna와 동료들은 패러프레이징은 AI 생성 텍스트 탐지기를 회피한다 (NeurIPS 2023)에서 한 구절의 표현을 다시 생성하면 워터마킹을 포함한 여러 방법에서 탐지가 무너진다는 점을 보였습니다. 신호는 정확한 토큰 시퀀스 안에만 존재하며 다른 곳에는 없기 때문에, 그 시퀀스를 다시 쓰는 것은 인간 편집자를 포함해 증거 자체를 다시 쓰는 것과 같습니다. 오늘날 워터마크를 제공하는 모든 업체는 자체 문서에서 이 한계를 밝히고 있습니다.

OpenAI: 그것을 발명했지만 끝내 출시하지 않은 회사
OpenAI는 수년간 작동하는 텍스트 워터마크를 보유해 왔지만, 지금까지 이를 공개하지 않기로 선택해 왔다. 이 아이디어는 처음에 당시 OpenAI의 안전 분야에서 일하던 Scott Aaronson이 2022년 11월 강연에서 공개적으로 설명했다. 핵심은 비밀 암호학적 함수로 거의 동등한 단어들 사이에서 모델의 선택을 편향시켜, 텍스트 자체가 어디에서 왔는지 증명하게 하자는 것이었다. 그 강연은 배포된 모든 시스템보다 앞서 있으며, 이 분야의 창립 문서라고 할 수 있다.
2024년 5월, OpenAI는 출처 추적(provenance) 업데이트인 온라인에서 우리가 보고 듣는 것의 출처 이해하기에서 프로젝트의 현황을 설명했다. 회사는 자사의 텍스트 워터마킹 방식이 정확하고 작은 수정에는 효과적이지만, 장단점을 검토하는 동안 공개를 보류하고 있다고 말했다. OpenAI가 언급한 두 가지 위험은 학술 글쓰는 사람들에게 직접적인 의미가 있다.
- 쉽게 우회됨. 텍스트를 바꾸어 쓰거나 번역하면 마크가 사라지는데, 이는 2023년 연구가 예측한 그대로다. 존재조차 모르는 사람들만 주로 걸러내는 워터마크는 강한 집행 도구가 아니다.
- 비원어민 영어 사용자에게 불균형한 영향. OpenAI는 워터마킹이 제2언어로 글을 쓰는 사람들에게 AI를 글쓰기 보조로 합법적으로 사용하는 행위를 낙인찍을 수 있다고 밝혔다. 왜 AI 탐지기가 비원어민 작가를 걸러내는가에서 그 문제를 탐지기 측면에서 다룬다.
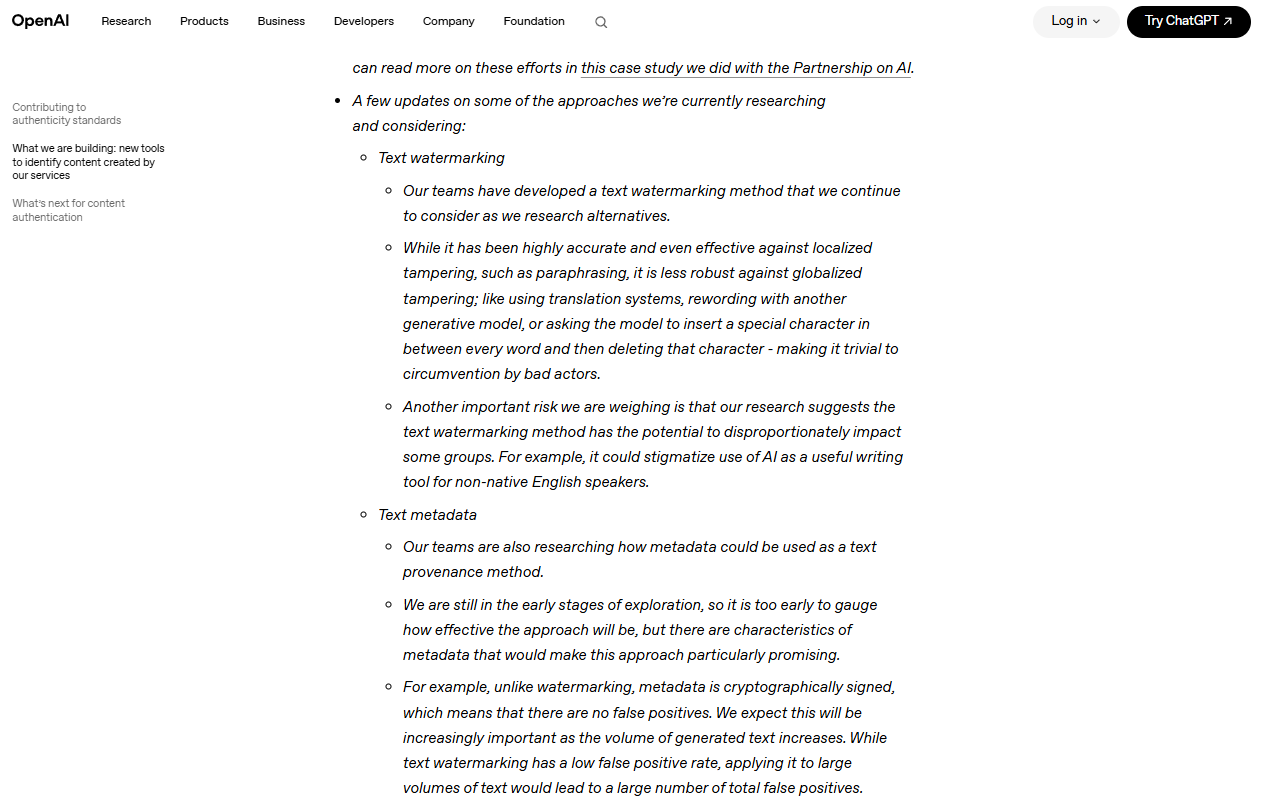
OpenAI의 자체 출처 추적 업데이트: 방식은 작동하며, 회사는 아직 출시하지 않은 이유를 나열하고 있다.
이미지와 오디오에 대해서는 OpenAI가 다른 경로를 택했다. DALL-E와 Sora 출력에 C2PA 출처 메타데이터를 넣는 방식으로, 콘텐츠 내부의 마크가 아니라 파일 수준의 라벨이다. 텍스트의 경우, 2026년 8월 말 기준으로 ChatGPT 출력에는 워터마크가 없다. 그 기술을 제안한 회사가 여전히 세 회사 중 유일하게 이를 배포한 적이 없는 셈이다.
Google: 먼저 출시하고, 그다음 레시피를 공개하다
Google DeepMind는 가장 먼저 출시했고, 완전히 공개했으며, 그다음 방법을 개방했다. SynthID라는 이 시스템은 2023년 이미지 워터마크로 시작해 2024년 텍스트로 확장되었다. 2024년 10월 Nature 논문이 나올 무렵, SynthID-Text는 이미 Gemini 내부에서 프로덕션으로 운영되고 있었고, 이는 소비자 규모에서 배포된 최초의 통계적 텍스트 워터마크가 되었다.
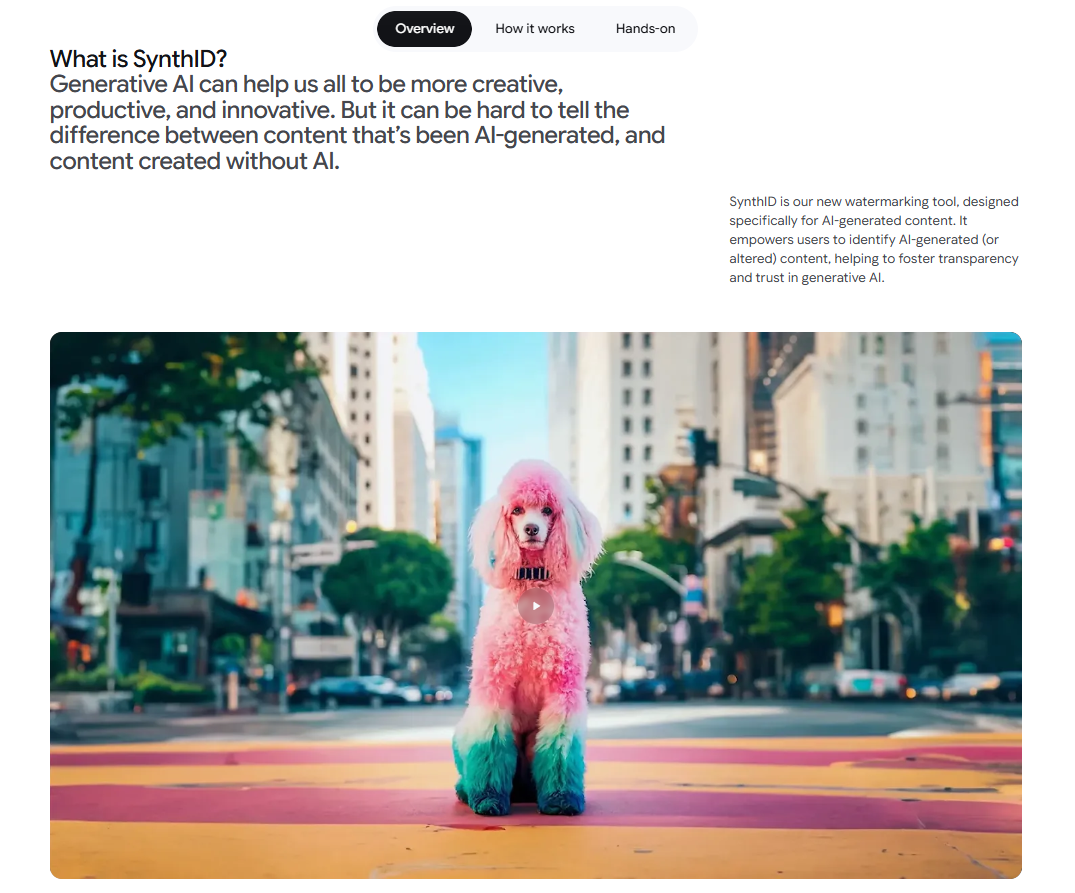
SynthID는 텍스트, 이미지, 오디오, 비디오를 포괄하며, 2024년 10월부터 Gemini 텍스트 출력에서 가동 중이다.
이후 Google은 구현을 Hugging Face의 오픈 소스로 공개하여, 어떤 개발자든 같은 워터마킹 방식을 자신의 모델에 적용할 수 있게 했다. 2025년 5월에는 SynthID Detector를 발표했는데, 이는 텍스트, 이미지, 오디오, 비디오 전반에서 SynthID 마크를 확인할 수 있는 검증 포털이다.
한 가지 범위상의 제한이 중요하다. SynthID는 Google 자체 모델의 콘텐츠만 마킹하고 탐지한다. ChatGPT나 Claude 출력에 대해서는 아무것도 말해 주지 않으며, SynthID 검사에서 깨끗하게 나온다고 해서 텍스트가 인간이 썼다는 뜻도 아니다. 그것은 Google의 모델이 쓰지 않았다는 뜻일 뿐이며, 훨씬 더 좁은 주장이다.
Anthropic: 가장 늦게 움직였지만, 가장 엄격한 정책
Anthropic는 가장 늦게 배포했지만, 의무 적용 범위는 가장 넓었습니다. 2026년 8월 2일 이후 출시된 모든 Claude 모델은 전 세계에서, 모든 요금제에 걸쳐, 옵트아웃 없이 텍스트 출력에 통계적 워터마크를 내장합니다. 회사는 이 메커니즘을 설명문 How Claude's text watermark works에서, 정책 범위를 도움말 센터 기사 How Claude marks AI-generated content에서 설명합니다. Claude API, claude.ai, Claude Code, Claude Cowork, Claude Tag가 모두 적용 대상입니다. 기준일 이전에 출시된 모델은 전환 기간에 있으며, Anthropic는 이들에도 마킹 지원을 추가하고 있다고 밝힙니다. 통계적 표식과 함께 Claude가 생성한 파일에는 C2PA 메타데이터도 포함되는데, 이는 일반 텍스트로 복사하면 사라지는 별도의 두 번째 시스템입니다.
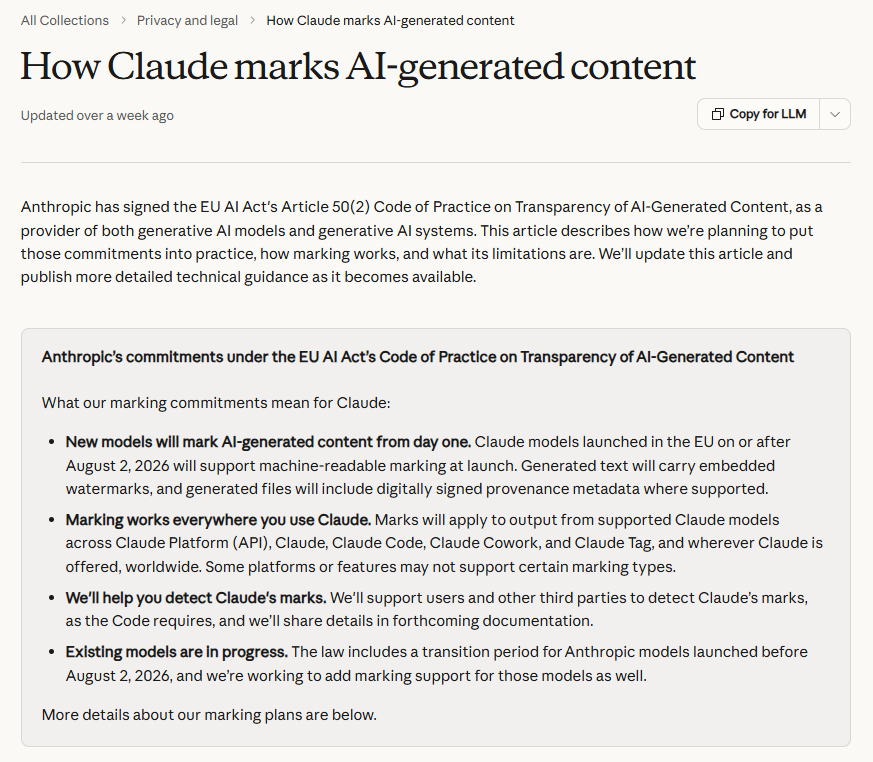
Anthropic 자체 표현으로 본 정책: 모든 새 모델, 모든 플랫폼, 전 세계 적용, 그리고 기존 모델도 추가 중.
Anthropic의 문서는 한계를 직접 명시합니다. 탐지는 확률적입니다. 이 표식만으로는 Claude가 작성한 문서와 사람이 작성한 뒤 Claude가 가볍게 편집한 문서를 구분할 수 없습니다. 완전히 다시 쓰면 표식은 제거됩니다. 탐지가 실제로 무엇을 입증하는지, 그리고 자신의 글이 표시되었을 때 어떻게 해야 하는지를 포함해 이 모든 내용을 전용 Claude 워터마크 가이드에서 자세히 다뤘습니다.
시점은 규제를 따릅니다. Anthropic는 EU AI Act에 따른 AI Generated Content 투명성에 관한 Article 50(2) Code of Practice에 서명했으며, 이 규정은 생성형 AI 시스템 제공자가 출력이 "기계 판독 가능한 형식으로 표시되고 인공적으로 생성된 것으로 탐지 가능"하도록 보장할 것을 요구합니다. 이러한 투명성 의무는 2026년 8월 2일부터 적용되었습니다. 이는 Anthropic의 모델 정책에서 정한 정확한 기준일이며, 공개 발표보다 9일 앞선 날짜입니다. Anthropic는 EU 트래픽에 대해 별도 동작을 유지하는 대신 전 세계적으로 준수하기로 했습니다. Google은 설계상 이미 준수하고 있었습니다. OpenAI의 비표시 텍스트 출력은 2027년의 미해결 준수 쟁점입니다.
세 가지 접근 방식, 나란히 보기
| OpenAI | Google DeepMind | Anthropic | |
|---|---|---|---|
| Text watermark 배포됨? | 아니오 | 예 (Gemini, 2024년 10월부터) | 예 (2026년 8월 2일 이후 Claude 모델) |
| 기법 | 암호학적 샘플링 편향 (구축됨, 미공개) | SynthID-Text 토너먼트 샘플링 | 통계적 샘플링 표식, SynthID 스타일 |
| 적용 범위 | 텍스트에는 없음 | Google 모델에만 적용 | 모든 새 Claude 모델, 기존 모델은 전환 중 |
| 옵트아웃 | 해당 없음 | 아니오 | 아니오 |
| 공개 탐지기 | 아니오 | SynthID Detector 포털 (2025) | 계획됨, 아직 출시 전 |
| 방식 공개 여부 | 개념 강연만 | Nature 논문 + 오픈 소스 | 설명문, 공개된 연구 기반 |
| 파일 메타데이터 (C2PA) | 예, 이미지와 오디오 | 예, 모든 미디어 전반 | 예, 생성된 파일에 적용 |
| 명시된 한계 | 우회 가능성, ESL 낙인 | 자체 모델로 범위 제한 | 확률적이며, 편집이 저자성을 흐림 |
열 전반의 패턴은 이렇습니다. OpenAI는 텍스트 watermarking을 아직 해결되지 않은 정책 문제로 보고, Google은 이를 표준화할 인프라로 다루며, Anthropic는 이를 전면 구현해야 할 규제 준수 의무로 취급합니다.
연구자와 학술 저자에게 이것이 의미하는 바
실제적인 영향은 어떤 도구가 여러분의 텍스트에 닿았는지에 따라 달라집니다. ChatGPT로 초안을 작성했다면, 현재 그 텍스트에는 워터마크가 없습니다. Gemini로 초안을 작성했다면, Google의 탐지기만 읽을 수 있는 SynthID 표시가 들어갑니다. 현재의 Claude 모델로 초안을 작성하거나 편집했다면, Anthropic의 표시가 들어가며 이를 끄는 설정은 없습니다.
학술 저자가 알아야 할 세 가지:
워터마크는 작성자가 아니라 도구를 식별합니다. 모든 벤더는 각자 문서에서 이를 밝히고 있으며, 기관 정책이 항상 이 구분을 명확히 하지는 않기 때문에 다시 강조할 필요가 있습니다. 텍스트는 AI가 초안을 작성했기 때문에, AI가 문장 두 개를 교정했기 때문에, 또는 표시된 단락을 인용했기 때문에 표시될 수 있습니다. 소속 기관이 워터마크 검사를 시행한다면, 그 검사가 입증하는 것은 특정 모델이 어느 시점에 그 텍스트에 관여했다는 사실뿐입니다. 그 이상은 아닙니다. 허위 AI 탐지 표시 이의 제기에 관한 가이드는 이런 점이 중요할 때 어떻게 주장할 수 있는지 설명합니다.
워터마크와 AI 탐지기는 서로 다른 실패 양상을 가진 서로 다른 기술입니다. Turnitin이나 GPTZero 같은 탐지기는 통계적 문체를 바탕으로 추정하며, 우리가 문서화한 정확도 문제가 있습니다. 워터마크 탐지는 키 기반 검사로, 워터마크가 없는 인간 텍스트에 대해서는 거짓 양성률이 매우 낮습니다. 반대로 거짓 음성에서는 비대칭이 뒤집힙니다. 워터마크 검사는 워터마크를 쓰지 않는 모델의 AI 텍스트를 놓치는데, 여기에는 오늘날의 모든 ChatGPT가 포함됩니다.
공개가 여전히 가장 강한 입장입니다. 워터마킹은 비공개 AI 사용의 위험을 높이고 공개된 AI 사용은 더 안전하게 만듭니다. 공개된 워크플로에는 양성 표시가 나오더라도 두려워할 것이 없기 때문입니다. 대부분의 학술지와 대학은 이제 명시적인 AI 사용 정책을 갖고 있습니다. 우리의 AI 사용 정책은 자체 도구 전반에서 이러한 경계를 어떻게 설정하는지 설명하며, 투명한 사용이 어떤 모습인지 보여주는 합리적인 템플릿입니다.
텍스트 워터마크를 제거하는 것과 제거하지 못하는 것
재작성은 제거하지만, 서식 변경은 제거하지 않습니다. 복사, 붙여넣기, 글꼴 변경, 파일 형식 변환, 보이지 않는 문자 삭제는 모두 통계적 워터마크를 그대로 유지합니다. 표시가 단어 선택에 들어 있기 때문입니다. 이를 제거하는 것은 문구를 다시 생성하는 어떤 것이든 해당됩니다. 심층적인 인간 편집, 번역, 또는 진정한 패러프레이즈가 그렇습니다. 이러한 시스템이 출시되기 전에 이미 NeurIPS 2023 견고성 연구가 이를 보여주었습니다.
여기서는 양방향이 모두 중요합니다. 표시가 사라진다고 해서 그 텍스트가 여러분의 것이 되는 것은 아니고, 표시가 남아 있다고 해서 그 텍스트가 여러분의 것이 아니게 되는 것도 아닙니다. 다시 쓴 AI 초안은 여전히 기관의 공개 규정이 적용되는 AI 보조 문서입니다. 우리의 AI text humanizer는 AI 보조 초안을 자연스러운 학술 문체로 다시 쓰며, 이 과정에서 토큰 시퀀스가 다시 생성되기 때문에 통계적 표시는 남지 않습니다. Claude 텍스트에 한정하면, 무료 Claude 워터마크 제거기는 사실, 숫자, 인용은 그대로 유지하면서 모든 문장을 새로운 표현으로 다시 씁니다. 어떤 도구도 바꿀 수 없는 것은 독자에게 져야 할 책임입니다. 즉, 문서가 어떻게 만들어졌는지에 대한 투명성입니다.
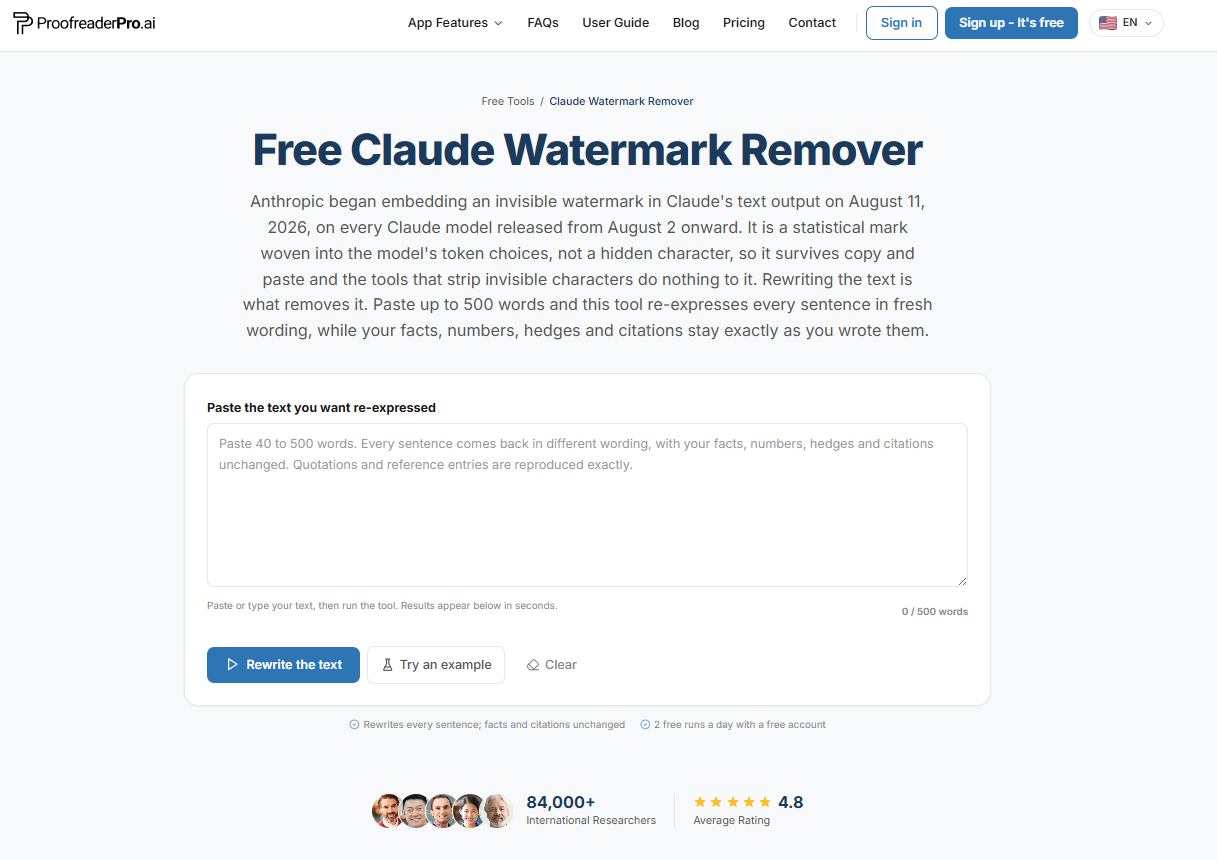
재작성은 통계적 표시를 제거하는 유일한 작업이며, 이 도구가 문장마다 수행하는 것도 바로 그것입니다.
다음에 이어질 흐름
2027년까지 세 가지를 지켜보자. 첫째, OpenAI가 출시에 나서는지: Article 50에 대한 EU 집행은 "만들었지만 미출시" 상태를 텍스트에 대해 점점 더 비용이 큰 선택으로 만든다. 둘째, 탐지기가 수렴하는지: 주요 연구실들이 모두 공개된 방식으로 워터마크를 넣는 세상이라면, 대학들은 문체를 보고 추측하는 대신 키를 확인하게 되고, 이는 오늘날의 오탐지에 취약한 탐지보다 훨씬 나은 진전일 것이다. 셋째, 상호운용성이 도래하는지: 지금은 세 개의 연구실이 세 가지 호환되지 않는 표식을 뜻하고, 보편적인 검증 수단은 없다. C2PA는 파일에 대해 그 공백을 메우지만, 아직 원문 텍스트를 위한 것은 없다.
ChatGPT는 텍스트에 워터마크를 넣나요?
아니요. 2026년 8월 기준으로 OpenAI는 텍스트 워터마킹 방법을 개발했지만 아직 배포하지는 않았으며, 회사는 2024년 5월 provenance 업데이트에서 이 입장을 설명했습니다. ChatGPT의 텍스트 출력에는 통계적 워터마크도, 숨겨진 문자도 없습니다. OpenAI는 DALL-E와 Sora 미디어 파일에는 C2PA provenance 메타데이터를 적용하지만, 이는 별도의 파일 수준 시스템입니다.
Google Gemini는 텍스트에 워터마크를 넣나요?
예. Gemini 출력에는 2024년 10월부터 Google DeepMind의 SynthID-Text 워터마크가 적용되어 왔습니다. 이는 단어 선택 안에 들어 있는 통계적 표식으로, 독자에게는 보이지 않지만 Google의 SynthID Detector로 확인할 수 있습니다. 이는 Google 자체 모델에만 적용되므로, SynthID 결과가 음성이라고 해서 다른 AI 시스템의 텍스트가 아니라는 뜻은 아닙니다.
Claude는 텍스트에 워터마크를 넣나요?
예. 2026년 8월 2일 이후에 출시된 모든 Claude 모델은 모든 플랫폼과 요금제에서, 옵트아웃 없이, 텍스트 출력에 통계적 워터마크를 포함하며, Claude가 생성한 파일에는 추가로 C2PA 메타데이터가 포함됩니다. 그 이전에 출시된 모델은 아직 출력을 표시하지 않으며, Anthropic은 전환 기간 동안 이들에 대한 표식 지원을 추가하고 있다고 밝혔습니다. 전체 내용은 우리의 Claude watermark 해설에서 확인할 수 있습니다.
대학은 AI 워터마크를 탐지할 수 있나요?
탐지에는 벤더의 키가 필요하므로, 벤더의 협력이 있어야만 가능합니다. Google은 SynthID 콘텐츠를 위한 공개 탐지 포털을 제공합니다. Anthropic은 사용자와 제3자를 위한 탐지 지원을 계획하고 있다고 밝혔지만 아직 공개 탐지기를 출시하지는 않았습니다. 현재 어떤 주류 표절 검사 도구도 어떤 연구실의 통계적 워터마크도 검증할 수 없으므로, 오늘날 기관의 "AI 탐지"는 여전히 문체를 바탕으로 한 추측일 뿐, 워터마크 검증이 아닙니다.
AI 워터마킹은 법으로 의무인가요?
EU에서는 사실상 그렇습니다. EU AI Act의 Article 50(2)는 생성형 AI 제공자가 출력물이 기계 판독 가능한 형식으로 표시되고 인공적으로 생성된 것으로 탐지 가능하도록 보장할 것을 요구하며, 투명성 의무는 2026년 8월 2일부터 적용됩니다. Anthropic은 관련 Code of Practice에 서명하고 전 세계적 준수를 선택했습니다. 규제 당국이 OpenAI의 미출시 텍스트 워터마크를 어떻게 다룰지는 2027년에 주목해야 할 질문입니다.
AI 워터마크는 번역을 거치면 유지되나요?
아니요. 통계적 워터마크는 모델이 선택한 정확한 단어 순서에 존재하며, 번역은 모든 단어를 바꿉니다. 깊은 수준의 패러프레이징과 강한 인간 편집도 마찬가지입니다. 이러한 한계는 동료 심사를 거친 문헌에 문서화되어 있으며, 워터마크를 배포하는 모든 벤더도 이를 인정합니다.
Sources
- Anthropic, Claude의 텍스트 워터마크 작동 방식, 2026년 8월
- Anthropic Help Center, Claude가 AI 생성 콘텐츠를 표시하는 방식, 2026
- OpenAI, 온라인에서 보고 듣는 것의 출처를 이해하기, 2024년 5월
- Google DeepMind, SynthID
- Dathathri et al., 대규모 언어 모델 출력 식별을 위한 확장 가능한 워터마킹, Nature, 2024년 10월
- Google, SynthID Detector 발표, 2025년 5월
- Hugging Face, SynthID Text 소개, 2024년 10월
- Kirchenbauer et al., 대규모 언어 모델을 위한 워터마크, ICML 2023
- Krishna et al., 패러프레이징은 AI 생성 텍스트 탐지기를 회피한다, NeurIPS 2023
- Scott Aaronson, UT Effective Altruism을 위한 나의 AI 안전 강연, 2022년 11월
- European Union, AI Act, Article 50
- C2PA, 콘텐츠 출처 및 진정성 연합
Dana는 ProofreaderPro의 콘텐츠 제작자로서 매일 블로그를 운영하고 글쓰기 작업을 진행합니다. 그녀는 온라인 편집 플랫폼의 작동 방식에 대한 기사를 작성하고 매일 고객 메시지를 처리하며 이에 대한 만족도 점수는 별 5개입니다.


