
গবেষকদের জন্য AI Detection Score কমানোর ব্যবহারিক নির্দেশিকা
ধাপে ধাপে নির্দেশনা, যার মাধ্যমে GPTZero, ZeroGPT, এবং Copyleaks-এ AI detection score 15% এর নিচে নামানো যায়।

যদি আপনি আপনার গবেষণাপত্রে সহায়তার জন্য ChatGPT, Claude, Gemini বা Deepseek-এর মতো AI মডেল ব্যবহার করে থাকেন, তবে Turnitin বা GPTZero-এর মতো জনপ্রিয় AI ডিটেক্টরে আপনার AI স্কোর সম্ভবত বেশি দেখাবে। এই পোস্টটি আপনাকে দেখাবে কীভাবে আপনার AI ডিটেকশন স্কোর আবার এমন একটি স্তরে নামিয়ে আনবেন, যা জমা দেওয়ার জন্য উপযুক্ত।
আপনার AI শতাংশকে নিরাপদ সীমায় নামিয়ে আনবে এমন সঠিক workflowটি এখানে দেওয়া হলো।
পাঁচটি ধাপ সংক্ষেপে
- আপনার খসড়াটি দুটি ডিটেক্টরের মধ্য দিয়ে চালান এবং কোন কোন অংশ চিহ্নিত হয়েছে তা নোট করুন।
- চিহ্নিত অংশগুলো নিজের কণ্ঠে হাতে-কলমে পুনর্লিখন করুন, শব্দ বদলানোর চেয়ে গঠন পরিবর্তন করুন।
- যে অংশগুলো অনড় থাকে, সেগুলোকে একটি একাডেমিক humanizer দিয়ে প্রক্রিয়া করুন, যা উদ্ধৃতি এবং পরিভাষা অক্ষুণ্ণ রাখে।
- শুরুতে যেসব ডিটেক্টর ব্যবহার করেছিলেন, সেগুলোর মাধ্যমেই পুরো নথিটি আবার পরীক্ষা করুন।
- একটি বাস্তবসম্মত লক্ষ্যে থামুন, 15% এর নিচে পৌঁছানো সম্ভব, এবং 0% প্রয়োজনীয় নয়।
নিচের অংশগুলো প্রতিটি ধাপ বিস্তারিতভাবে ব্যাখ্যা করে, যার মধ্যে মানব-লিখিত লেখা চিহ্নিত হলে কী করতে হবে তাও অন্তর্ভুক্ত আছে।
আপনার AI detection score আসলে কী মাপে
আপনি সংখ্যা ঠিক করতে শুরু করার আগে, এর অর্থ কী তা আপনাকে বুঝতে হবে। Turnitin, GPTZero, Originality.ai, এবং Copyleaks-এর মতো AI detector-গুলো আপনার লেখায় এমন পরিসংখ্যানগত pattern খোঁজে, যা AI-generated লেখায় সাধারণভাবে দেখা যায়।
এই pattern-গুলোর মধ্যে আছে low perplexity, অর্থাৎ পূর্বানুমানযোগ্য শব্দচয়ন, low burstiness, অর্থাৎ বাক্যের দৈর্ঘ্য ও গঠনে একরূপতা, এবং paragraph rhythm-এ উচ্চ consistency। মানব লেখা সাধারণত এলোমেলো হয়, ভিন্ন ভিন্ন বাক্যদৈর্ঘ্য, অপ্রত্যাশিত শব্দচয়ন, মাঝেমধ্যে মূল প্রসঙ্গ থেকে সরে যাওয়া। AI লেখা সাধারণত মসৃণ, সমান, এবং পূর্বানুমানযোগ্য হয়।
আপনার AI detection score এইটা মাপছে না যে আপনি AI ব্যবহার করেছেন কি না। এটা মাপছে, আপনার লেখায় এমন pattern আছে কি না, যা AI output-এর সঙ্গে সম্পর্কিত। এটি একটি গুরুত্বপূর্ণ পার্থক্য, কারণ অনেক human-written লেখা এই একই pattern-গুলো তৈরি করে, বিশেষ করে formal academic writing, যা স্বভাবতই casual prose-এর তুলনায় বেশি structured এবং predictable।
কিছু detector যে তৃতীয় signal-কে গুরুত্ব দেয়, তা হলো vocabulary distribution। Model-গুলো তাদের training data-তে পরিসংখ্যানগতভাবে common এমন শব্দকে বেশি প্রাধান্য দেয়, আর human writer-দের শব্দভান্ডার idiosyncratic হয়, তারা কিছু শব্দ অতিরিক্ত ব্যবহার করে, কিছু অস্বাভাবিক শব্দ পছন্দ করে, আবার discipline-specific jargon কখনও অপ্রত্যাশিত জায়গায় ব্যবহার করে।
বিশ্ববিদ্যালয়-স্তরের ডিটেক্টরগুলো, একে একে
আপনি কোন ডিটেক্টরের মুখোমুখি, তা জানা আপনার স্কোর পড়ার ধরন বদলে দেয়। এগুলোই সেই টুল, যেগুলো প্রতিষ্ঠান ও ক্লায়েন্টরা 2026 সালে বাস্তবে চালায়, প্রতিটি কী পরিমাপ করে, আর কোন ফলাফলকে নিরাপদ ধরা যায়। টুল যাই হোক, যেকোনো স্কোরকে প্রমাণ নয়, বরং পর্যালোচনার জন্য একটি সংকেত হিসেবে ধরুন: বহুল উদ্ধৃত এক Stanford গবেষণায়, প্রধানধারার ডিটেক্টরগুলো অ-স্থানীয় ইংরেজি বক্তাদের 61% প্রবন্ধকে AI-লিখিত বলে চিহ্নিত করেছিল।
| ডিটেক্টর | কারা চালায় | যা জানা দরকার |
|---|---|---|
| Turnitin | বিশ্ববিদ্যালয়, প্রতিষ্ঠানব্যাপী | 20%-এর নিচে *% দেখায়; বাস্তব লক্ষ্য 20%-এর নিচে |
| GPTZero | শিক্ষক ও শিক্ষার্থী | ফ্ল্যাগ হওয়া বাক্য হাইলাইট করে; হাইলাইট করা অংশ ছাড়া 15%-এর নিচে লক্ষ্য রাখুন |
| Originality.ai | প্রকাশক, এজেন্সি, ক্লায়েন্ট | শুধুই পেইড, আক্রমণাত্মক, ঘন ঘন আপডেট হয় |
| Copyleaks | LMS ইন্টিগ্রেশনের মাধ্যমে বিশ্ববিদ্যালয় | বহুভাষিক, প্রকাশিত ফলস পজিটিভ হার 1%-এর নিচে |
| Winston AI | শিক্ষক ও কনটেন্ট টিম | OCR ইনপুট হ্যান্ডলিং; 99.98% দাবিকে মার্কেটিং হিসেবে পড়ুন |
| ZeroGPT | ফ্রি প্রথম যাচাই হিসেবে শিক্ষার্থীরা | স্কোর ব্যাপকভাবে ওঠানামা করে; একা কখনও চূড়ান্ত নয় |
| Pangram | একাডেমিক-ইন্টিগ্রিটি অফিস | একটি স্বাধীন গবেষণায় ফলস পজিটিভ 0.5% বা তার নিচে |
| Scribbr AI Detector | জমা দেওয়ার আগে শিক্ষার্থীরা | 70-এর উঁচু থেকে 80-এর মাঝামাঝি নির্ভুলতা; একটি প্রাথমিক ছাঁকনি, প্রমাণ নয় |
| Sapling | ব্যবসা ও সাপোর্ট টিম | একটি পিয়ার-রিভিউড গবেষণায় 90% মানব নমুনা ফ্ল্যাগ হয়েছে |
Turnitin
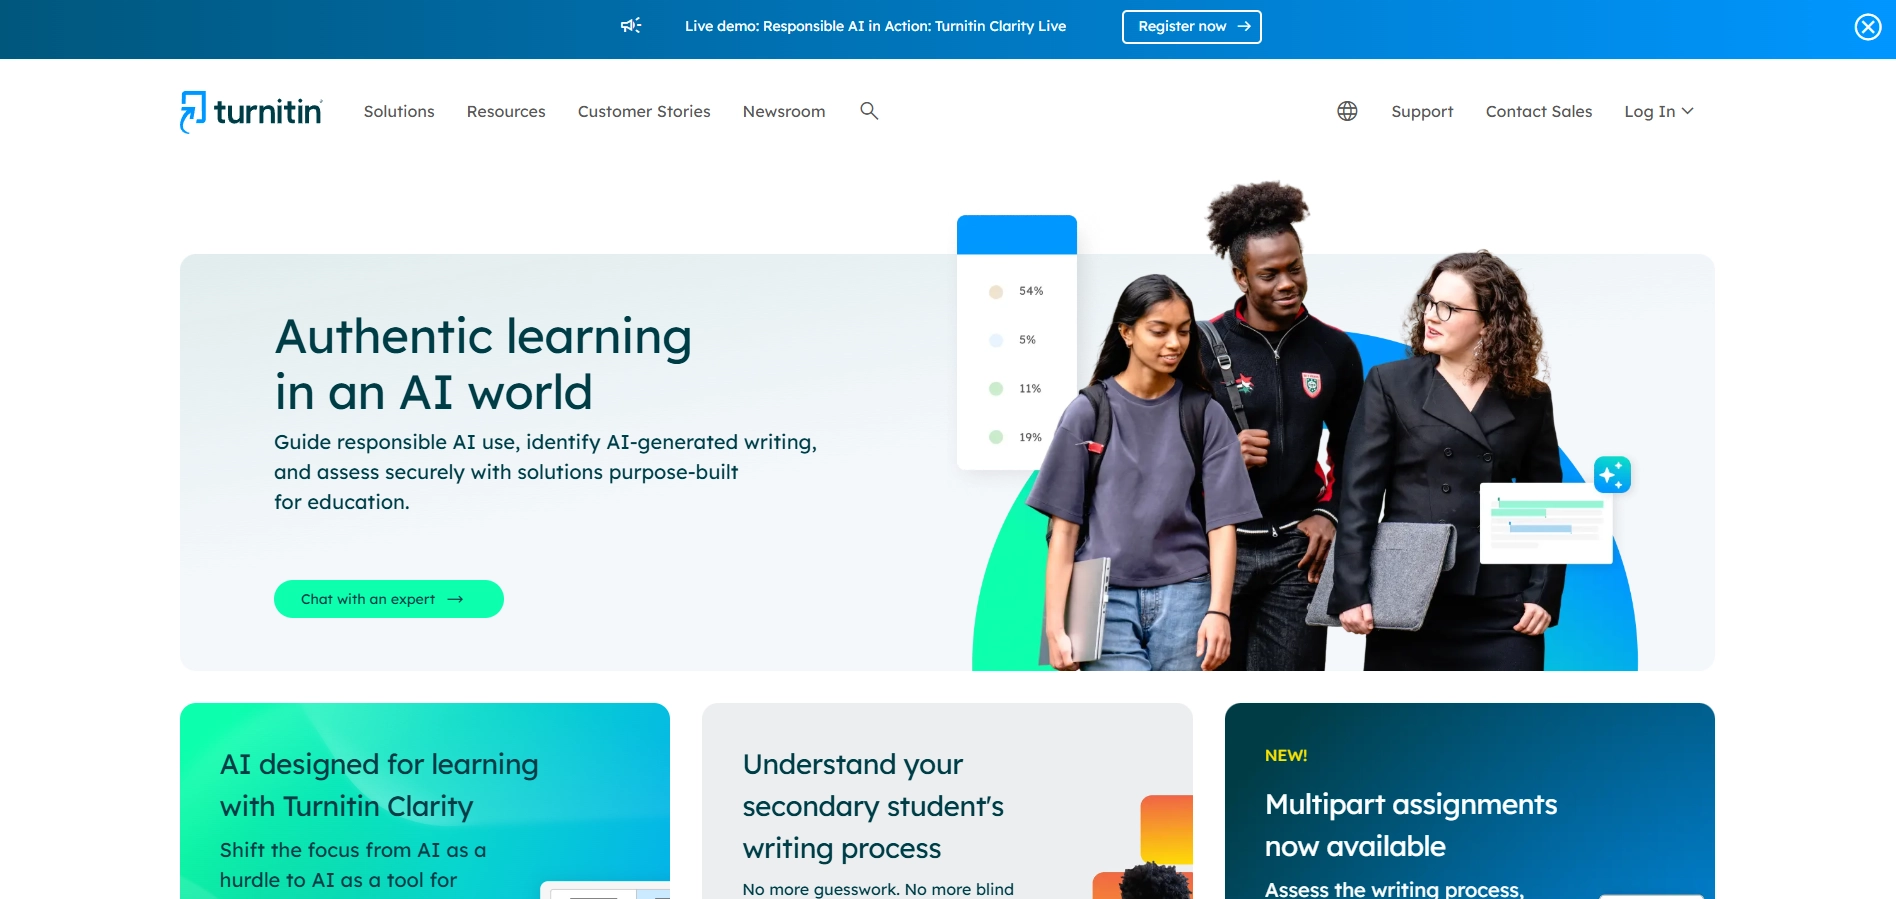
বিশ্ববিদ্যালয়গুলোর ডিফল্ট। Turnitin-এর AI লেখন সনাক্তকরণ একই প্ল্যাটফর্মের মধ্যে অন্তর্ভুক্ত, যা similarity report চালায়, এবং এটি প্রতিষ্ঠান-ব্যাপী লাইসেন্সকৃত, তাই শিক্ষার্থীরা জমা দেওয়ার আগে নিজেরা কিনে পরীক্ষা করতে পারে না। এটি আপনার ডকুমেন্টকে অংশে ভাগ করে এবং similarity score থেকে আলাদাভাবে কতটা গদ্য AI-উৎপাদিত বলে পড়া যায় তা স্কোর করে। দুটি প্রদর্শন-নিয়ম গুরুত্বপূর্ণ: 20% এবং তার বেশি স্কোরে শতাংশটি বাক্য-স্তরের হাইলাইটসহ দেখায়, আর 1% থেকে 19% ফলাফল *% হিসেবে কোনো সংখ্যা ছাড়া দেখা যায়, কারণ Turnitin-এর নিজস্ব পরীক্ষায় 20% এর নিচে বেশি false positive পাওয়া গেছে। বাস্তব লক্ষ্য হলো 20% এর নিচে থাকা, সেই সীমার নিচে যেখানে রিপোর্টটি একটি কঠিন সংখ্যা দেখায়। false-positive নিয়ে উদ্বেগের কারণে বেশ কয়েকটি বড় বিশ্ববিদ্যালয় এই ফিচারটি বন্ধ করে দিয়েছে, আর Turnitin-এর নতুন Clarity পণ্য প্রমাণকে আপনার drafting process-এর দিকে সরিয়ে দেয়। আমাদের Turnitin Clarity explainer এবং Turnitin score guide এ দুটিকে বিস্তারিতভাবে কভার করা হয়েছে।
GPTZero
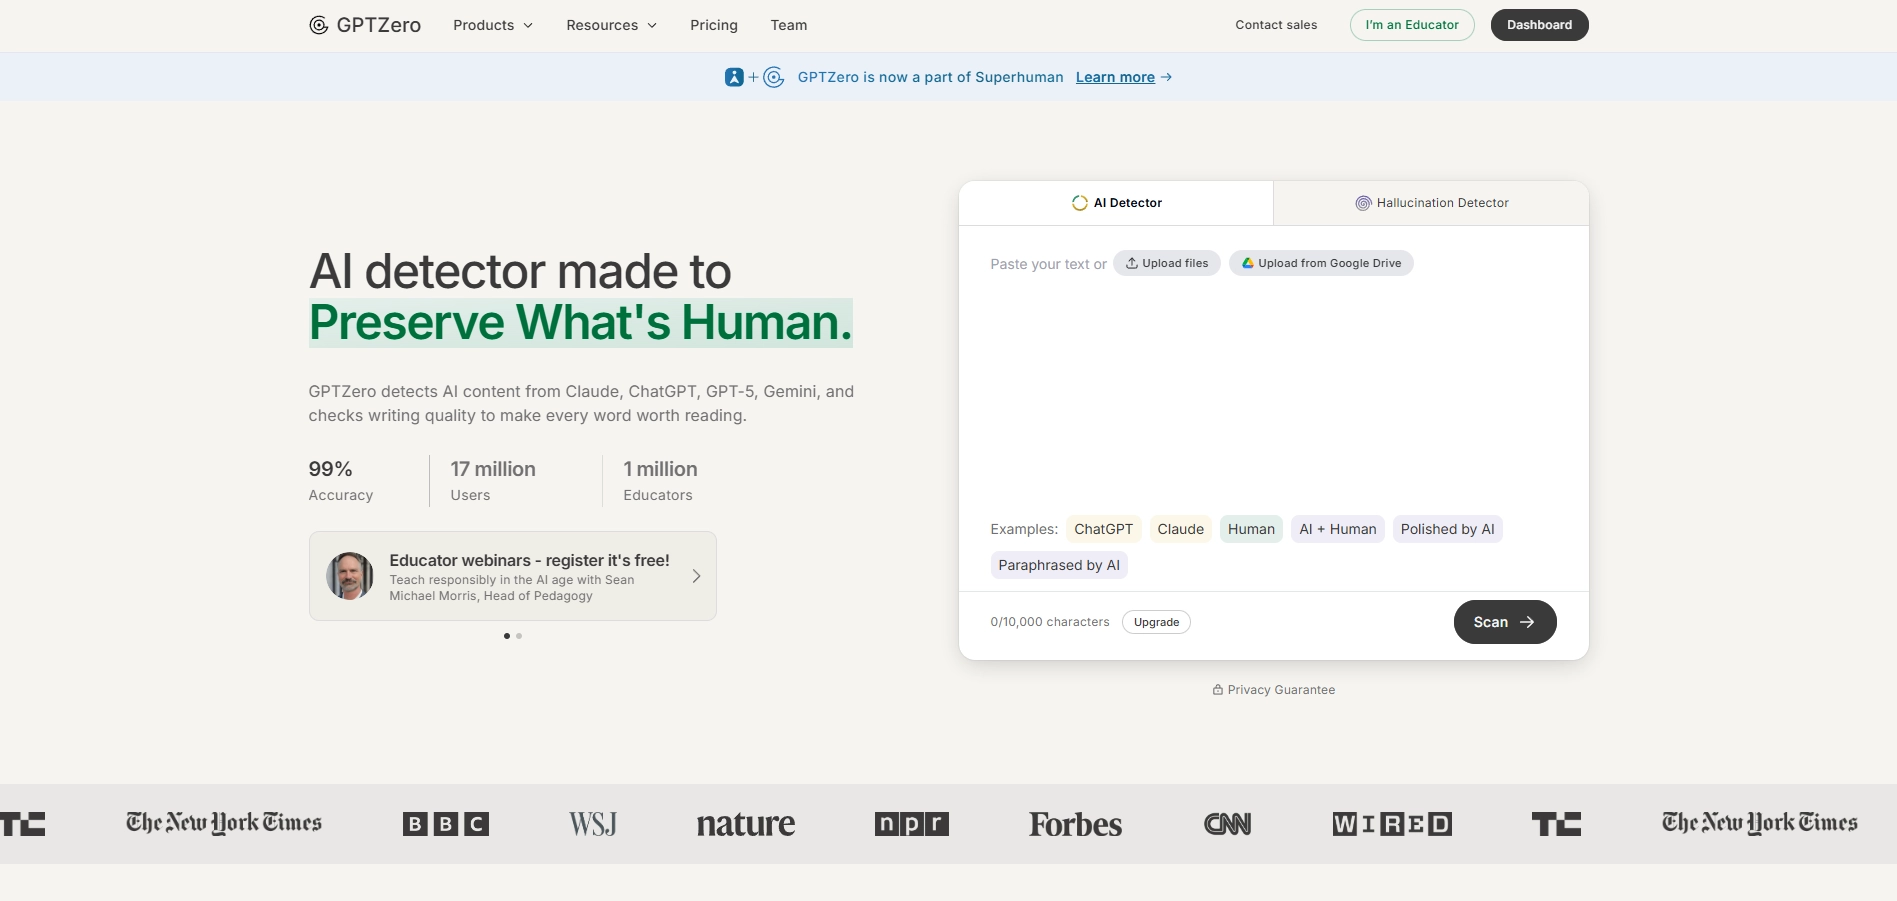
শিক্ষার জন্য তৈরি, সবচেয়ে পরিচিত standalone detector। GPTZero সরাসরি perplexity এবং burstiness পরিমাপ করে এবং যেসব একক বাক্যকে এটি machine-written মনে করে সেগুলো হাইলাইট করে, যা এই গাইডের targeted-rewrite workflow-এর জন্য এটিকে সবচেয়ে উপযোগী টুল করে তোলে। শিক্ষকরা এর classroom dashboard ব্যবহার করেন, শিক্ষার্থীরা pre-check হিসেবে free tier ব্যবহার করে। benchmark test-এ এটি unedited model output-এর উপর ভালো স্কোর করে, কিন্তু লেখা সত্যিই revision করার পর দুর্বল হয়ে যায়। কোনো highlighted consecutive sentence-run না রেখে 15% এর নিচে লক্ষ্য করুন। আমাদের GPTZero score guide এর বিশেষ বৈশিষ্ট্যগুলো কভার করে।
Originality.ai
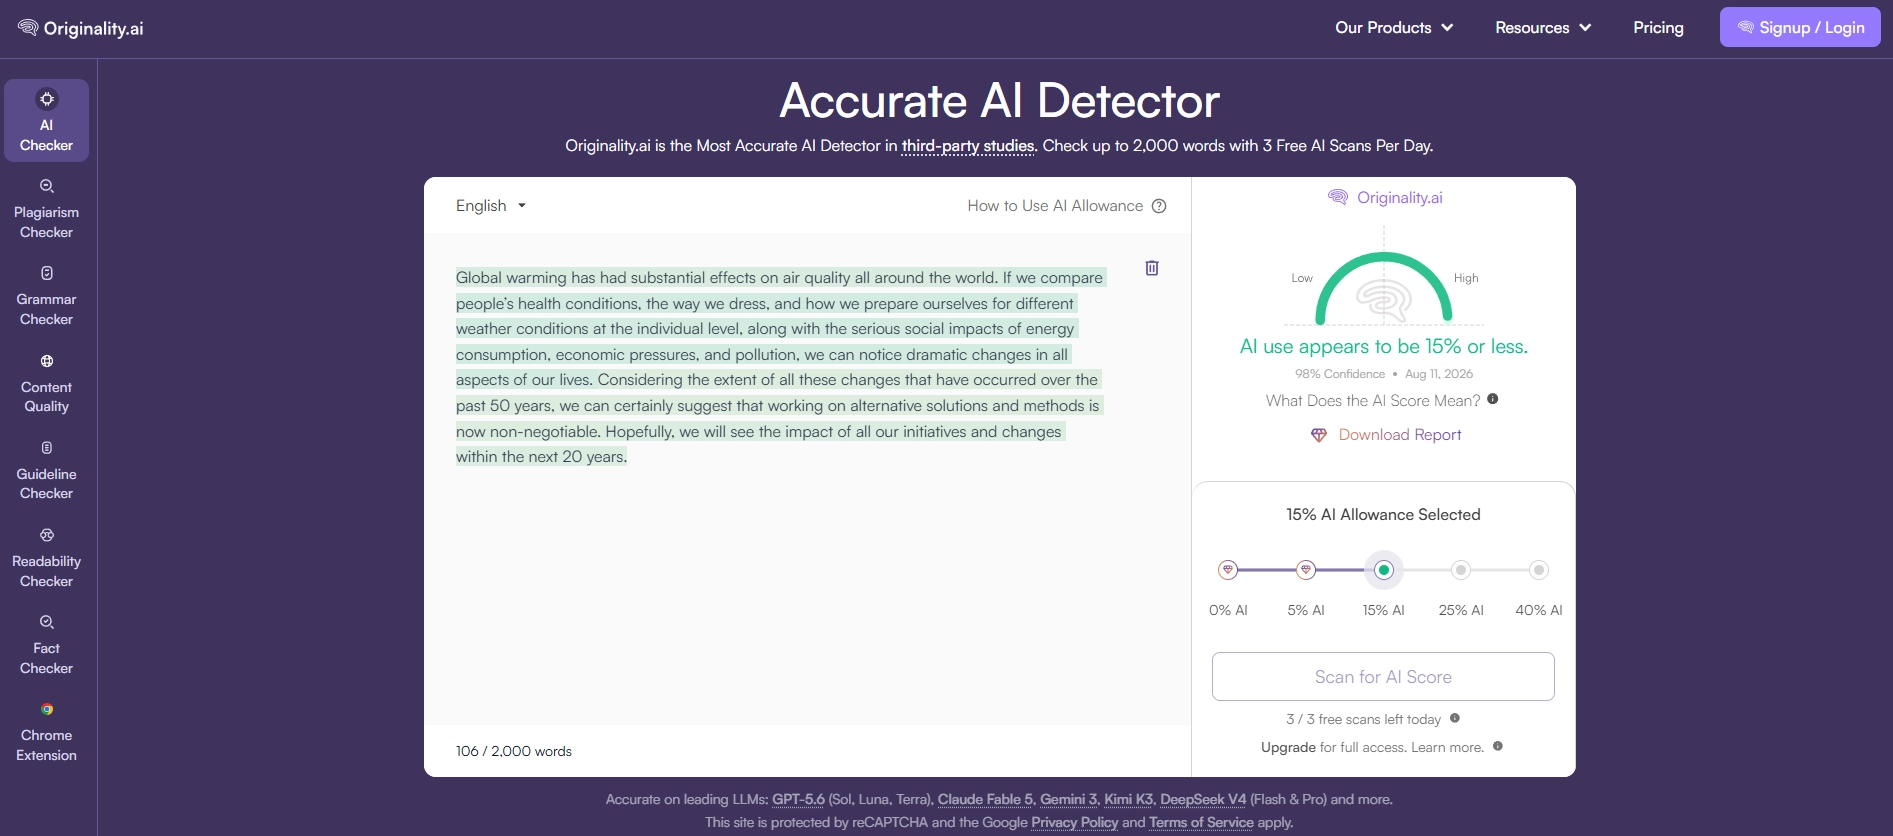
শ্রেণিকক্ষের চেয়ে freelance এবং publishing জগতের ডিটেক্টর। Agency, editor, এবং site ownerরা পুরো article ও website এতে চালান, আর red score working writer-দের payment আটকে দিতে পারে। এটি paid-only, নিয়মিত নিজের model আপডেট করে, এবং আক্রমণাত্মক পদ্ধতির দিকে ঝোঁকে, clean prose-এ বেশি false flag ধরলেও অন্য প্রতিযোগীদের তুলনায় বেশি AI text ধরে। কোনো client যদি এটি দিয়ে screening করে, আপনার নিজের report রেখে দিন এবং পরিষ্কার human verdict-এর লক্ষ্য রাখুন। বিরোধ ও revision tactic আমরা Originality.ai score guide-এ কভার করেছি।
Copyleaks
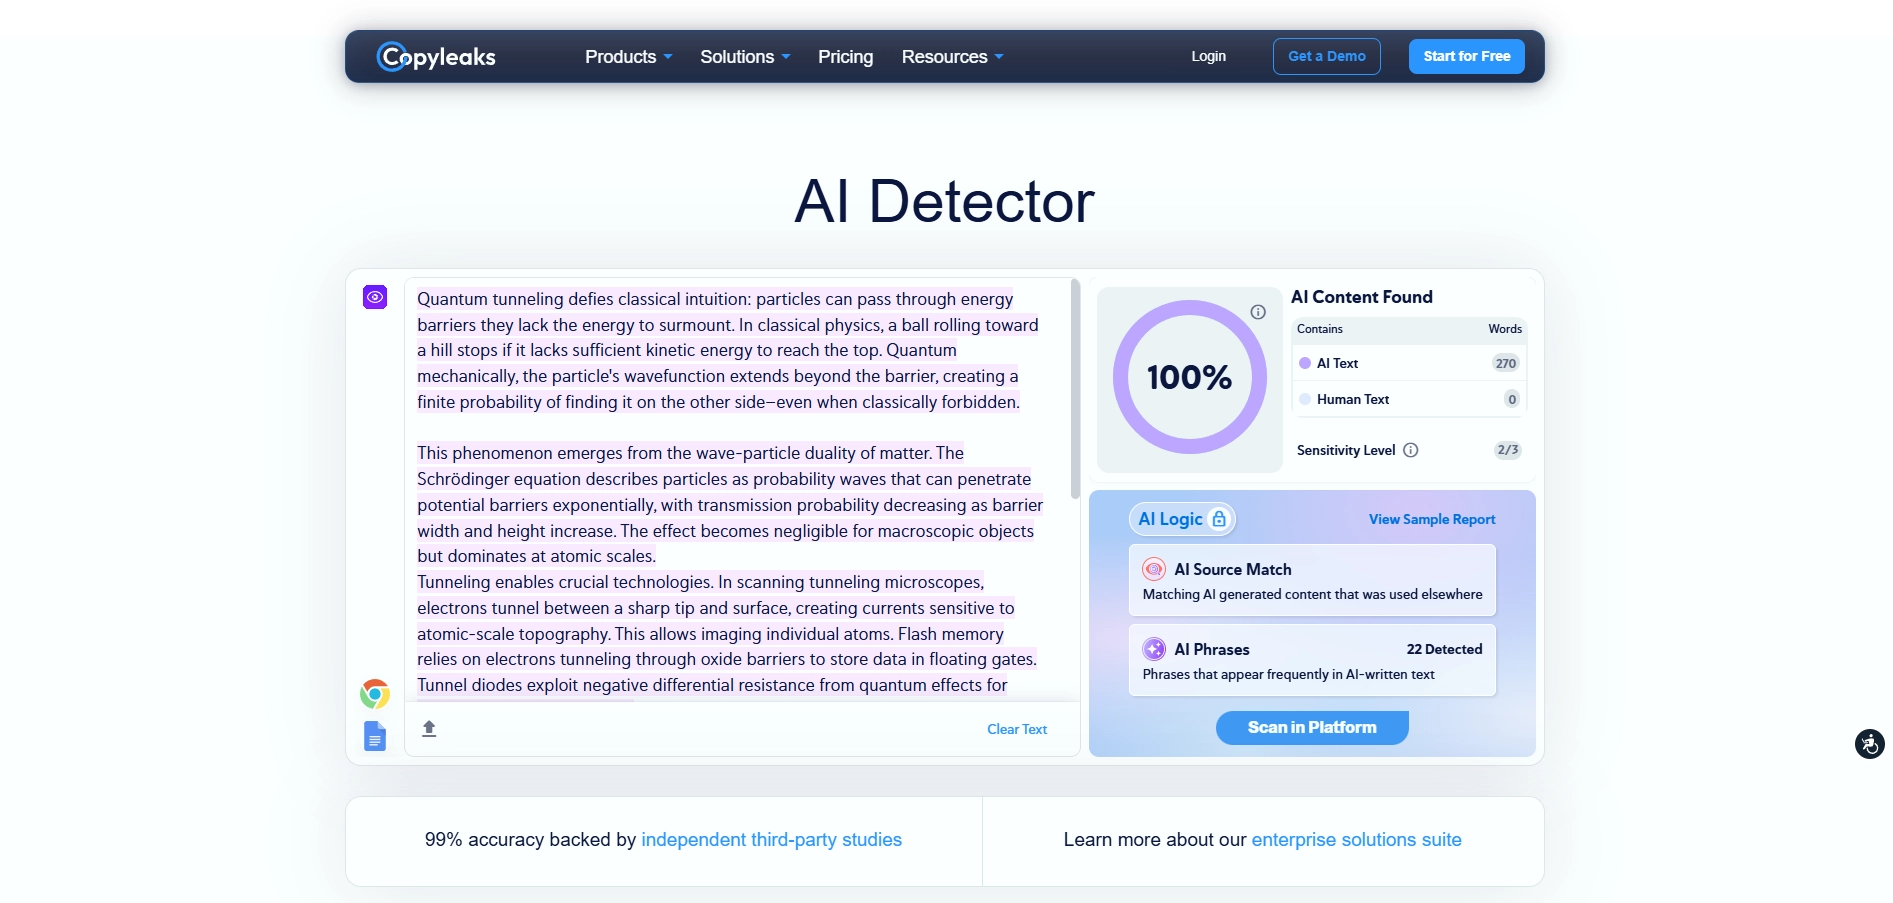
enterprise-দের পছন্দের টুল। Copyleaks Canvas, Moodle, এবং Blackboard-এর মতো learning management system-এ যুক্ত হয়, একাধিক ভাষা জুড়ে শনাক্ত করে, এবং sensitivity mode-এর পাশাপাশি সেই compliance certification-ও দেয় যা procurement team-কে স্বচ্ছন্দ করে। এর প্রকাশিত false-positive rate 1% এর নিচে, যা প্রধানধারার টুলগুলোর মধ্যে সর্বনিম্নের অন্যতম। যেসব বিশ্ববিদ্যালয় Turnitin চালায় না, তারা প্রায়ই Copyleaks চালায়। আমাদের Copyleaks explainer দেখায় একটি flag কতটা বিশ্বাসযোগ্য।
Winston AI
99.98% accuracy হিসেবে বাজারজাত করা হয়, কিন্তু এই সংখ্যাকে আপনাকে পরিমাপ নয়, marketing হিসেবে পড়া উচিত, কারণ স্বাধীন পরীক্ষায় আরও সংযত চিত্র দেখা যায়। Winston-এর আসল পার্থক্য হলো input handling, এটি OCR চালায়, তাই শিক্ষকরা হাতে লেখা বা মুদ্রিত কাজ এবং নথির ছবি স্ক্যান করতে পারেন। এটি educator এবং content team-দের কাছে বিক্রি হয়। এর শতাংশকে অন্য যেকোনো single-tool result-এর মতোই ধরুন এবং দ্বিতীয় detector দিয়ে যাচাই করুন। দেখুন আমাদের Winston AI accuracy analysis।
ZeroGPT
free, no-login টুল, যা বেশিরভাগ শিক্ষার্থী প্রথমে চেষ্টা করে। একই লেখায় এর স্কোর ব্যাপকভাবে ওঠানামা করে, তাই এটি কেবল একটি মোটামুটি প্রথম দৃষ্টির জন্য উপযোগী, এর বেশি নয়। আপনি নিজে যে লেখা লিখেছেন, তাতে ZeroGPT-এ উচ্চ সংখ্যা আসা সাধারণ, এবং তা Turnitin বা Copyleaks কী বলবে, তা পূর্বাভাস দেয় না। যদি ZeroGPT আপনাকে flag করে, একটি শব্দও বদলানোর আগে আরও দুইটি ভালোভাবে ক্যালিব্রেট করা টুলে আবার পরীক্ষা করুন। আমাদের ZeroGPT accuracy review ব্যাখ্যা করে কেন এর সংখ্যা এদিক-ওদিক করে।
Pangram
নতুন প্রজন্মের মধ্যে সবচেয়ে শক্তিশালী। University of Chicago-এর এক স্বাধীন গবেষণায়, Pangram-ই একমাত্র detector ছিল যা false positive 0.5% বা তার নিচে রেখেও AI text নির্ভরযোগ্যভাবে ধরতে পেরেছে, আর humanizer দিয়ে text চালানোর পরেও এর accuracy টিকে থাকে। এটি academic-integrity office এবং editorial team-এ জায়গা করে নিচ্ছে, যারা অন্যত্র false positive-এ ক্ষতিগ্রস্ত হয়েছিল। আপনার কাজ যদি Pangram-এর মুখোমুখি হয়, একমাত্র নির্ভরযোগ্য পদ্ধতি হলো এই গাইড যা শেখায়, আপনার নিজের কণ্ঠে প্রকৃত কাঠামোগত revision।
Scribbr AI Detector
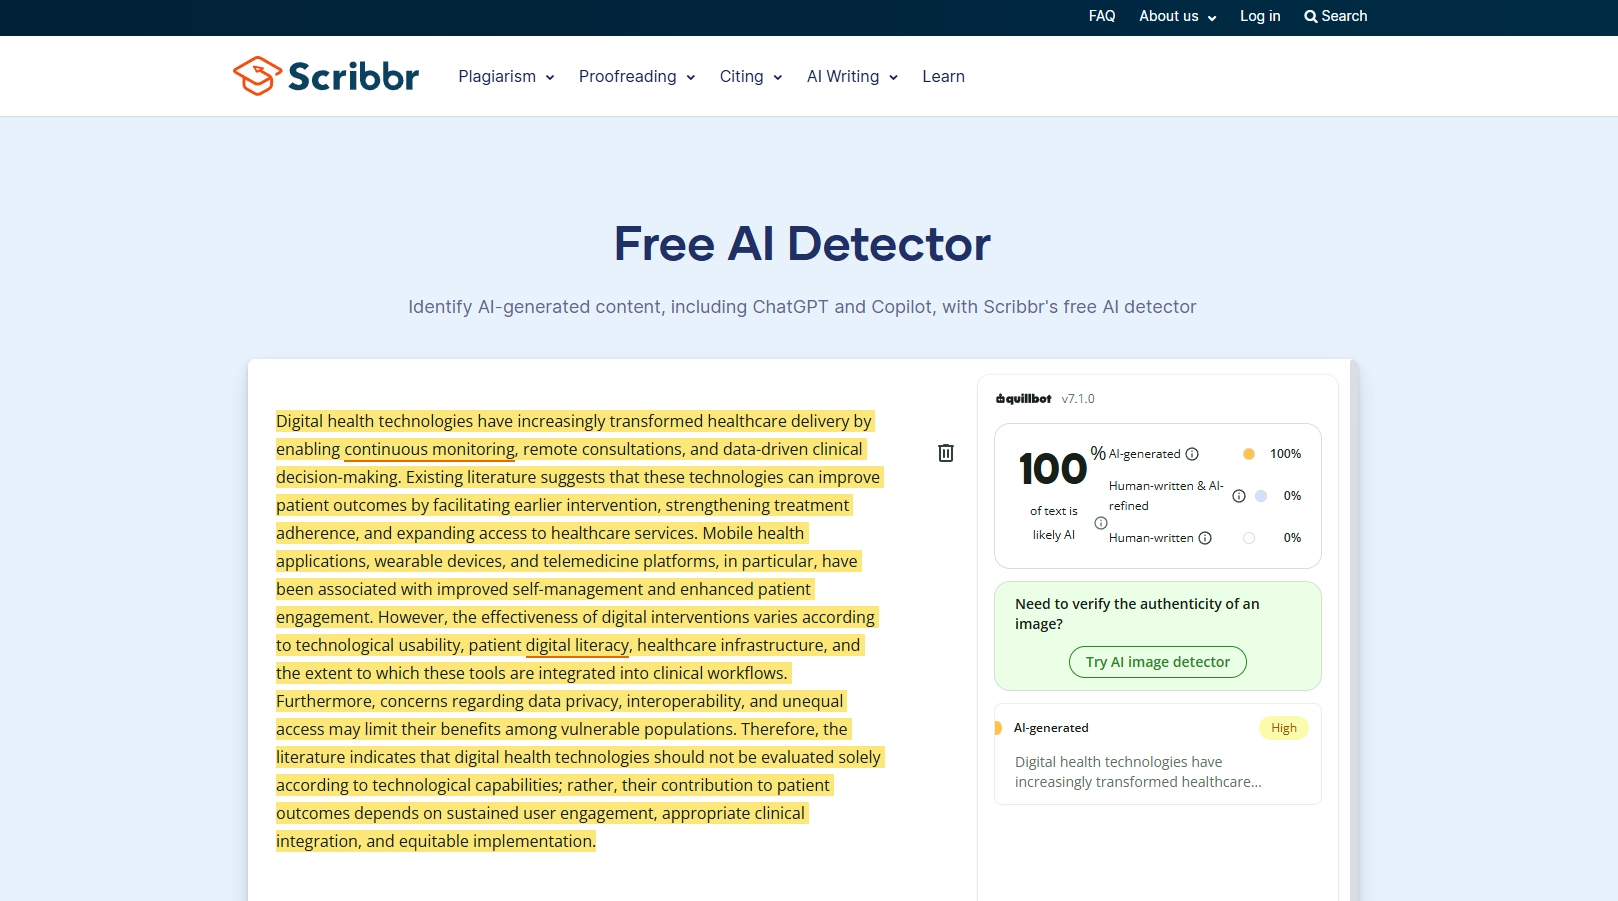
একটি free student-facing checker, paid tier-সহ, একই নামের editing company থেকে। accuracy test-এ এটি high-70s থেকে mid-80s শতাংশ পরিসরে পড়ে, যা এটিকে submission-এর আগে সুবিধাজনক screen বানায়, কিন্তু integrity decision-এর জন্য দুর্বল ভিত্তি। একে প্রথম মতামত হিসেবে ব্যবহার করুন, তারপর আরও শক্তিশালী টুল দিয়ে নিশ্চিত করুন।
Sapling
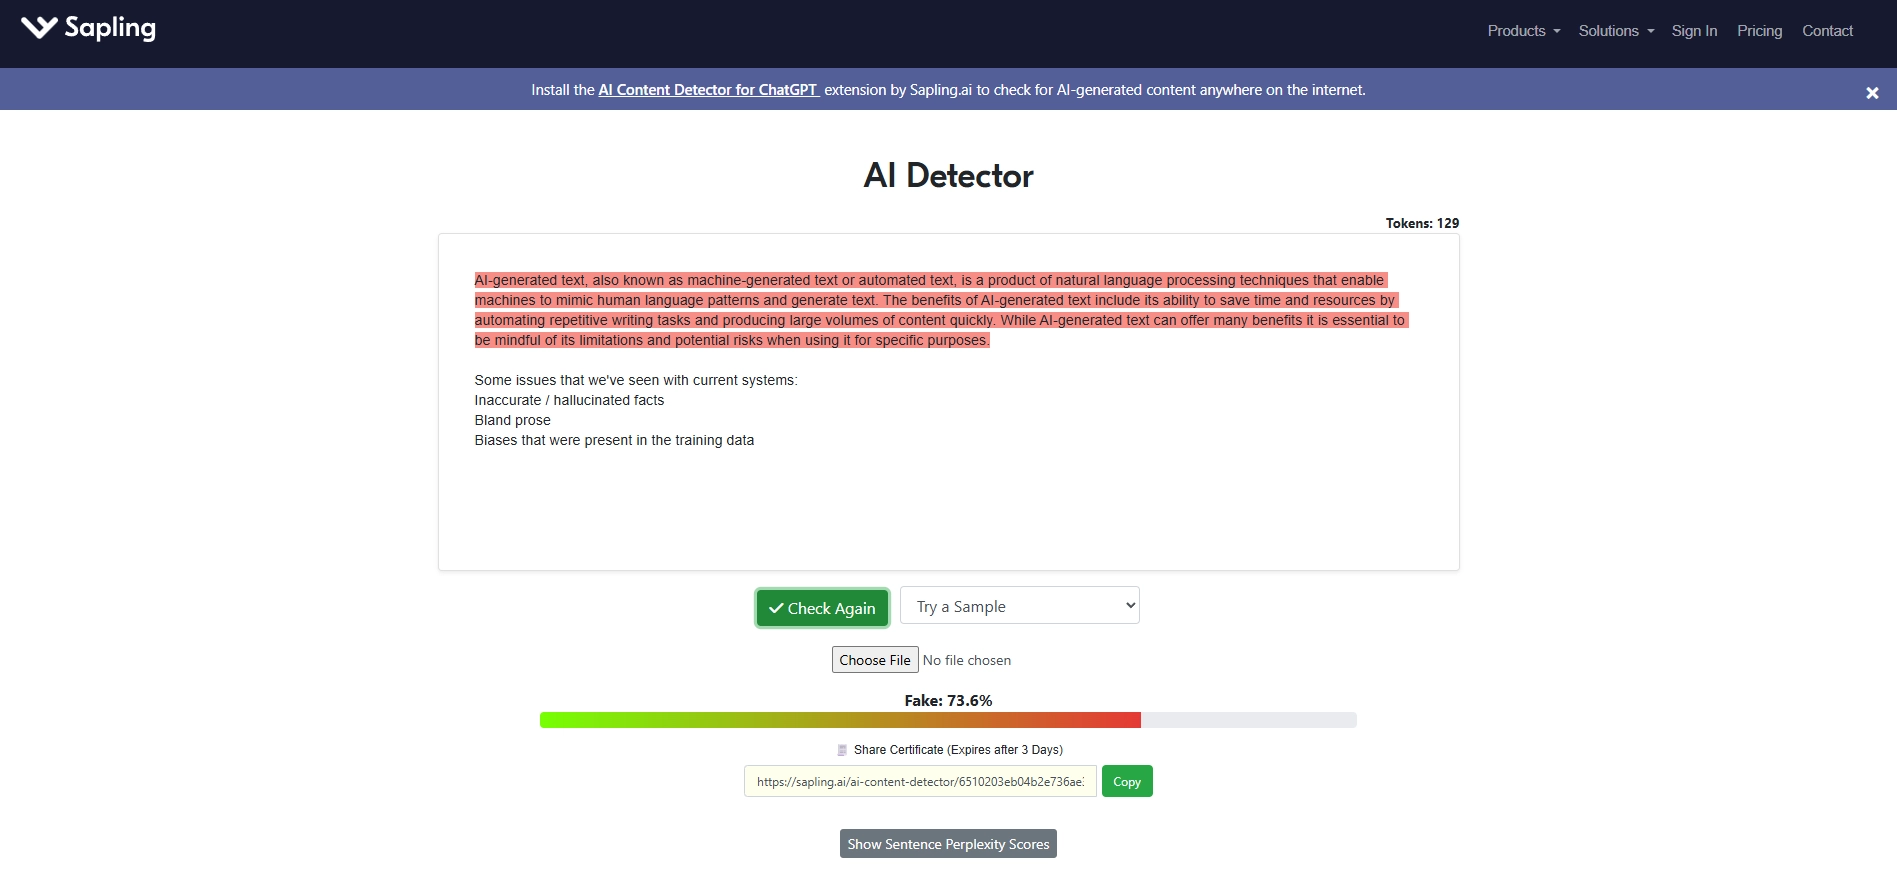
শিক্ষাক্ষেত্রের বদলে business এবং customer-service text-এর জন্য তৈরি, আর একটি উপযোগী সতর্কতামূলক উদাহরণ: এটি up to 97% accuracy দাবি করে, তবু এক peer-reviewed study-তে দেখা গেছে এটি genuinely human-written নমুনার 90% AI হিসেবে flag করেছে। যদি এমন কোনো টুলের স্কোর আপনার বিরুদ্ধে ব্যবহৃত হয়, জানার মতো study সেটিই। আর এ কারণেই এই গাইড একই নিয়ম বারবার বলছে: কোনো single detector-এর সংখ্যা evidence নয়।
ধাপ ১: কোন অংশগুলো চিহ্নিত হয়েছে তা শনাক্ত করুন
আপনার পুরো পেপারটি নতুন করে লিখবেন না। এটা সময়ের অপচয়, আর এতে পরিস্থিতি আরও খারাপও হতে পারে।
তার বদলে, আপনার লেখাটি এমন একটি ডিটেক্টরের মধ্যে চালান, যা বাক্যভিত্তিক বা অনুচ্ছেদভিত্তিক বিশ্লেষণ দেখায়। GPTZero-এর sentence-level highlighting এখানে বিশেষভাবে উপকারী। এটি আপনাকে স্পষ্টভাবে দেখাবে কোন কোন অংশকে সম্ভবত AI-generated হিসেবে চিহ্নিত করা হচ্ছে।
আমাদের অভিজ্ঞতায়, AI detection scores খুব কমই পুরো পেপার জুড়ে সমান থাকে। সাধারণত আপনি দেখবেন যে 2-3টি অংশই স্কোরের বড় অংশ চালিত করছে, প্রায়ই ভূমিকা, literature review, অথবা অত্যন্ত গঠিত methodology descriptions। এগুলোই হলো সেই অংশ, যেগুলোর ওপর আপনার মনোযোগ দেওয়া উচিত।
আপনার লেখা একটি ডিটেক্টরের মধ্যে কপি করুন। চিহ্নিত অংশগুলো নোট করুন। সেটাই আপনার hit list।
ধাপ 2: চিহ্নিত অংশগুলো হাতে ধরে পুনর্লিখন করুন
AI শনাক্তকরণ স্কোর কমাতে আপনি এককভাবে এটিই সবচেয়ে কার্যকর পদক্ষেপ নিতে পারেন, এবং এর কোনো শর্টকাট নেই।
প্রতিটি চিহ্নিত অংশ আলাদা করে নিয়ে একেবারে নতুন করে লিখুন। বিদ্যমান লেখাটি সম্পাদনা করবেন না। একটি ফাঁকা ডকুমেন্ট খুলে একই ভাবনা আপনার নিজের কণ্ঠে লিখুন। এতে আপনি সেই পরিসংখ্যানগত ধরনগুলো ভেঙে ফেলতে বাধ্য হবেন, যেগুলো ডিটেক্টরগুলো ধরছে।
যে তিনটি নির্দিষ্ট কৌশল কাজ করে:
আপনার বাক্যের দৈর্ঘ্য ইচ্ছাকৃতভাবে বৈচিত্র্যপূর্ণ করুন। AI লেখা সাধারণত 15-25 শব্দের বাক্যের দিকে ঝোঁকে, এবং তা আশ্চর্যজনকভাবে ধারাবাহিক থাকে। কিছু ছোট বাক্য যোগ করুন। তারপর একটি দীর্ঘ বাক্য লিখুন, যা ধারণাটিকে আরও পূর্ণভাবে বিকশিত করবে এবং এক বা দুইটি অধীনস্থ উপবাক্যও অন্তর্ভুক্ত করবে। এই বৈচিত্র্যই একা একটি অনুচ্ছেদের AI স্কোর উল্লেখযোগ্যভাবে কমিয়ে দিতে পারে।
ব্যক্তিগত একাডেমিক কণ্ঠ যোগ করুন। যেখানে উপযুক্ত, সেখানে hedging language যোগ করুন ("this may suggest"), qualification ("with the qualification that"), অথবা আপনার ক্ষেত্র-নির্দিষ্ট শাস্ত্রীয় ভাষা ব্যবহার করুন। AI সাধারণত সাধারণ একাডেমিক ইংরেজিতে লেখে। আপনার শাস্ত্রের নিজস্ব রীতিনীতি আছে, সেগুলো ব্যবহার করুন।
শুধু paraphrase নয়, কাঠামোও বদলান। যদি AI-নির্মিত সংস্করণে তিনটি পয়েন্ট সংখ্যাযুক্ত ফরম্যাটে তালিকাভুক্ত থাকে, সেগুলোকে প্রবাহমান গদ্যে একত্র করুন। যদি সেখানে topic-sentence-then-evidence কাঠামো ব্যবহার করা হয়ে থাকে, তবে প্রমাণ দিয়ে শুরু করে দাবি পর্যন্ত অগ্রসর হওয়ার চেষ্টা করুন। কেবল শব্দ-স্তরের পরিবর্তনের তুলনায় কাঠামোগত পরিবর্তন বেশি কার্যকর।
ধাপ 3: জেদি অংশগুলির জন্য একটি AI humanizer ব্যবহার করুন
কিছু অংশ হাতে পুনর্লিখনকে প্রতিরোধ করে, বিশেষ করে নির্দিষ্ট প্রক্রিয়াগত ভাষাযুক্ত methods sections, অথবা পরিসংখ্যানগত প্রতিবেদনকে ভিত্তি করে গড়ে ওঠা results sections। এই অংশগুলো স্বভাবতই কাঠামোবদ্ধ এবং পূর্বানুমেয়, তাই AI লিখুক বা না লিখুক, detectors এগুলিকে flag করে।
এই অংশগুলোর জন্য, একটি AI text humanizer সাহায্য করতে পারে। একটি ভালো humanizer প্রযুক্তিগত নির্ভুলতা বজায় রেখে বাক্যগঠন ও শব্দচয়নে স্বাভাবিক বৈচিত্র্য আনে।
মূল শব্দটি হলো "ভালো।" অধিকাংশ humanizer আপনার technical vocabulary বাদ দেবে এবং আপনার citations বিকৃত করবে। academic text-এর জন্য তৈরি, এমন একটি tool ব্যবহার করুন, যা বোঝে যে "p < 0.05" একটি statistical expression, typo নয়, যেটি ঠিক করতে হবে। আমাদের humanizing AI text for academic writing নির্দেশিকায় quality ক্ষুণ্ণ না করে কীভাবে এই tools নির্বাচন ও ব্যবহার করতে হয়, তা ব্যাখ্যা করা হয়েছে।
কয়েক মিনিটে আপনার AI স্কোর কমান
আমাদের টেক্সট হিউম্যানাইজার একাডেমিক লেখার জন্য তৈরি। এটি উদ্ধৃতি, প্রযুক্তিগত পরিভাষা, এবং প্রাজ্ঞ সুর অক্ষুণ্ণ রেখে AI শনাক্তকরণ স্কোর কমায়।
টেক্সট হিউম্যানাইজারটি বিনামূল্যে ব্যবহার করুনধাপ 4: একাধিক ডিটেক্টরের মাধ্যমে পুনরায় যাচাই করুন
পুনর্লিখন ও মানবিককরণের পর, আপনার সংশোধিত পাঠ অন্তত তিনটি ভিন্ন ডিটেক্টরের মধ্যে চালান। আমরা GPTZero, ZeroGPT, এবং Copyleaks-এর সুপারিশ করি, কারণ এগুলো ভিন্ন ভিন্ন মডেল ব্যবহার করে এবং আলাদা আলাদা প্যাটার্ন ধরে।
কেন তিনটি? কারণ কোনো একক ডিটেক্টরই চূড়ান্ত কর্তৃত্বপূর্ণ নয়। GPTZero-তে যে অনুচ্ছেদ 5% স্কোর করতে পারে, সেটি ZeroGPT-তে 30% স্কোর করতে পারে। আপনার অধ্যাপক এগুলোর যেকোনো একটি, অথবা সম্পূর্ণ ভিন্ন কোনো ডিটেক্টরও ব্যবহার করতে পারেন। একাধিক ডিটেক্টর যাচাই করে আপনি বেশি ক্ষেত্র কভার করছেন।
আপনার পাঠ যদি তিনটিতেই 15%-এর নিচে স্কোর করে, তাহলে আপনি নিরাপদ অবস্থায় আছেন। যদি কোনো একটি ডিটেক্টর এখনও কোনো নির্দিষ্ট অংশকে চিহ্নিত করে, তাহলে সেই নির্দিষ্ট অনুচ্ছেদে ফিরে যান এবং ধাপ 2-এর ম্যানুয়াল পুনর্লিখন কৌশল প্রয়োগ করুন।
কী কাজ করে না
কিছু জনপ্রিয় কৌশল নির্ভরযোগ্যভাবে ব্যর্থ হয়, আর কয়েকটি স্কোর আরও খারাপ করে।
- সমার্থক শব্দ-প্রতিস্থাপনভিত্তিক প্যারাফ্রেজারগুলি শব্দ বদলায়, কিন্তু AI-সদৃশ বাক্যগঠন বজায় রাখে, আর আসলে ডিটেক্টররা সেটাই মাপে। শব্দ বদলের পর প্রায়ই স্কোর বেড়ে যায়।
- অক্ষর-ভিত্তিক কৌশল, যেমন অদৃশ্য Unicode, দেখতে একই রকম অক্ষর, বা বাড়তি ফাঁকা স্থান, আধুনিক ডিটেক্টর বিশ্লেষণের আগে স্বাভাবিকীকরণের মাধ্যমে বাদ দিয়ে দেয়, আর কিছু ডিটেক্টর এই হেরফেরটিকেই চিহ্নিত করে।
- অন্য একটি ভাষার মাধ্যমে অনুবাদের রাউন্ড-ট্রিপ অর্থ ও উদ্ধৃতি নষ্ট করে, কিন্তু যান্ত্রিক-সদৃশ ছন্দ অক্ষত রাখে।
- ইচ্ছাকৃত বানান ভুল পাণ্ডুলিপির মান কমায়, কিন্তু ডিটেক্টর যে পরিসংখ্যানগত ধরন পড়ে, তা বদলায় না।
কাঠামোগত পুনর্লিখনই একমাত্র পদ্ধতি, যা ডিটেক্টর যে বিষয়গুলি মাপে, সেগুলি বদলায়, বাক্যের ছন্দ, শব্দের পূর্বানুমেয়তা, এবং অনুচ্ছেদের আকৃতি। ম্যানুয়াল পুনর্লিখন এবং academic humanization উভয়ই এটি করে, পার্থক্য হলো গতি।
কোথায় মনোযোগ দেবেন, অংশ ধরে ধরে
একটি পেপারের বিভিন্ন অংশ ভিন্নভাবে ফ্ল্যাগ হয়, তাই আপনার পুনর্লিখনের সময় সেখানেই ব্যয় করুন, যেখানে তা সবচেয়ে গুরুত্বপূর্ণ।
সারসংক্ষেপ। সাধারণত এটিই সবচেয়ে বেশি ফ্ল্যাগ হওয়া অংশ, কারণ স্বভাবতই এটি ঘন এবং সূত্রনির্ভর। বাক্যগঠনে বৈচিত্র্য আনুন, এবং টানা তিনটি বাক্য "This study," "This paper," বা "This research," দিয়ে শুরু করা এড়িয়ে চলুন, কারণ এই ধাঁচটি AI পছন্দ করে।
ভূমিকা। এখানে ব্যক্তিগত অবস্থান-সংক্রান্ত বক্তব্য কার্যকর। "We became interested in this question when..." বা "The gap became apparent during our review of..." প্রথম-পুরুষ আখ্যানের উপাদানগুলি একটি মডেলের পক্ষে স্বাভাবিকভাবে তৈরি করা কঠিন, এবং এগুলি মানব লেখকত্বের মতো পড়ে।
পদ্ধতি। অন্তর্নিহিতভাবে সূত্রনির্ভর, তাই এটি স্বাভাবিকভাবেই perplexity-তে কম স্কোর করে। AI detection এখানে সবচেয়ে কম নির্ভরযোগ্য, এবং এখানেই মূল্যায়নকারীরা কঠোর রীতি প্রত্যাশা করেন। মানবিকীকরণের চেয়ে নির্ভুলতার ওপর মনোযোগ দিন।
ফলাফল। সুনির্দিষ্ট সংখ্যাসহ নির্দিষ্ট ফলাফল উপস্থাপন করুন। "Participants in the treatment group showed a mean improvement of 3.7 points (SD = 1.2, p = 0.003)" মানবিক শোনায়। সাধারণ সারসংক্ষেপ AI-এর মতো শোনায়।
আলোচনা। এখানে আপনার ব্যাখ্যামূলক কণ্ঠস্বর সবচেয়ে গুরুত্বপূর্ণ। পরস্পরবিরোধী ফলাফলের সঙ্গে যুক্ত হোন, সীমাবদ্ধতাগুলি সাধারণভাবে নয়, নির্দিষ্টভাবে স্বীকার করুন, এবং ফলাফলকে আপনার বৃহত্তর গবেষণা কর্মসূচির সঙ্গে সংযুক্ত করুন। এই উপাদানগুলির জন্য প্রকৃত দক্ষতা প্রয়োজন, এবং এগুলি প্রামাণিকভাবে মানবিক বলে মনে হয়।
কেন কিছু মানব-লিখিত লেখা ফ্ল্যাগ হয় (false positives)
এখানে এমন একটি বিষয় আছে যা বেশিরভাগ মানুষকে অবাক করে: সম্পূর্ণ মানব-লিখিত লেখা নিয়মিতভাবেই AI detector-এ ধরা পড়ে।
আমরা এটি নিজেদেরই পরীক্ষা করেছি। আমরা মানব গবেষকদের লেখা পাঁচটি অংশ নিয়েছিলাম, যেখানে AI-এর কোনো involvement ছিল না, এবং সেগুলো GPTZero, ZeroGPT, এবং Copyleaks-এর মাধ্যমে চালিয়েছিলাম। সব অংশের গড় AI score ছিল 18%। একটি methods section-এ 34% AI score দেখায়, যদিও সেটি দশ বছরের অভিজ্ঞতাসম্পন্ন একটি postdoc হাতে লিখেছিলেন।
False positives ঘটে কারণ academic writing-এর সঙ্গে AI output-এর কাঠামোগত কিছু বৈশিষ্ট্য মিলে যায়। উভয় ক্ষেত্রেই formal register, consistent paragraph structure, এবং কোনো discipline-এর ভেতরে predictable vocabulary-এর দিকে ঝোঁক থাকে। Detector-গুলো "এটি AI-এর মতো শোনাচ্ছে কারণ AI এটি লিখেছে" এবং "এটি AI-এর মতো শোনাচ্ছে কারণ এটি formal academic prose" এর মধ্যে পার্থক্য করতে পারে না।
এই কারণেই মাঝারি AI score দেখে আতঙ্কিত হওয়া counterproductive। কিছুটা detection স্বাভাবিক, এমনকি সম্পূর্ণ original work-এর ক্ষেত্রেও। এই tools আসলে কতটা reliable, তা আরও গভীরভাবে জানতে, দেখুন আমাদের 2026 সালে AI detection-এর accuracy-এর বিশ্লেষণ।
Grammarly, QuillBot, এবং অন্যান্য সম্পাদনা টুল কি আপনার AI স্কোর বাড়ায়?
হ্যাঁ, বাড়াতে পারে, এবং এটি অনেককে অবাক করে, কারণ খসড়াটি শুরুতেই সম্পূর্ণ মানব-লিখিত। এই টুলগুলো যা বদলে দেয়, ঠিক সেটাই ডিটেক্টররা মাপে।
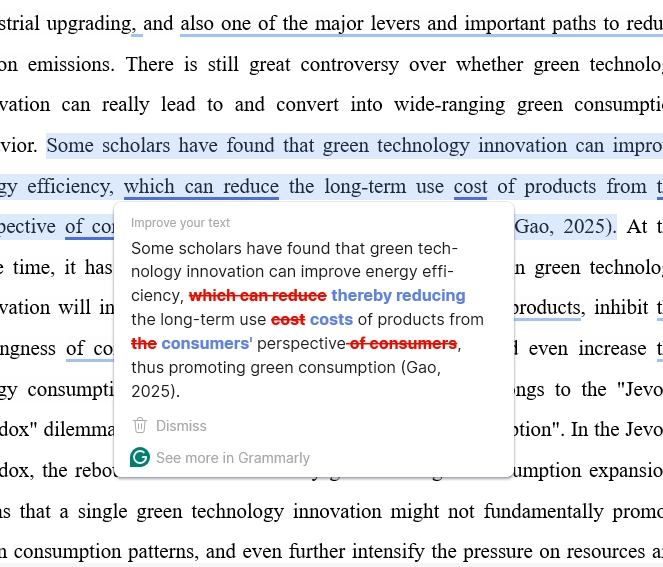
নিচের স্ক্রিনশটটি দেখায় Grammarly কীভাবে একটি মানব-লিখিত অর্থনীতি পাণ্ডুলিপির ওপর কাজ করছে। এর পরামর্শে "which can reduce" বদলে "thereby reducing" করা হয়েছে এবং "the consumers' perspective" পুনর্বিন্যাস করে "the perspective of consumers" করা হয়েছে। প্রতিটি পরিবর্তনই ব্যাকরণগতভাবে সঠিক, এবং প্রতিটি পরিবর্তনই বাক্যটিকে ভাষা মডেলের ডিফল্ট মসৃণ, আনুষ্ঠানিক রেজিস্টারের দিকে নিয়ে যায়।
একই রিভিউ ধাপে "which highlights" এর বদলে "underscoring" প্রস্তাব করা হয়েছিল, যা একাডেমিক গদ্যে AI-সদৃশ সবচেয়ে চেনা শব্দগুলোর একটি:
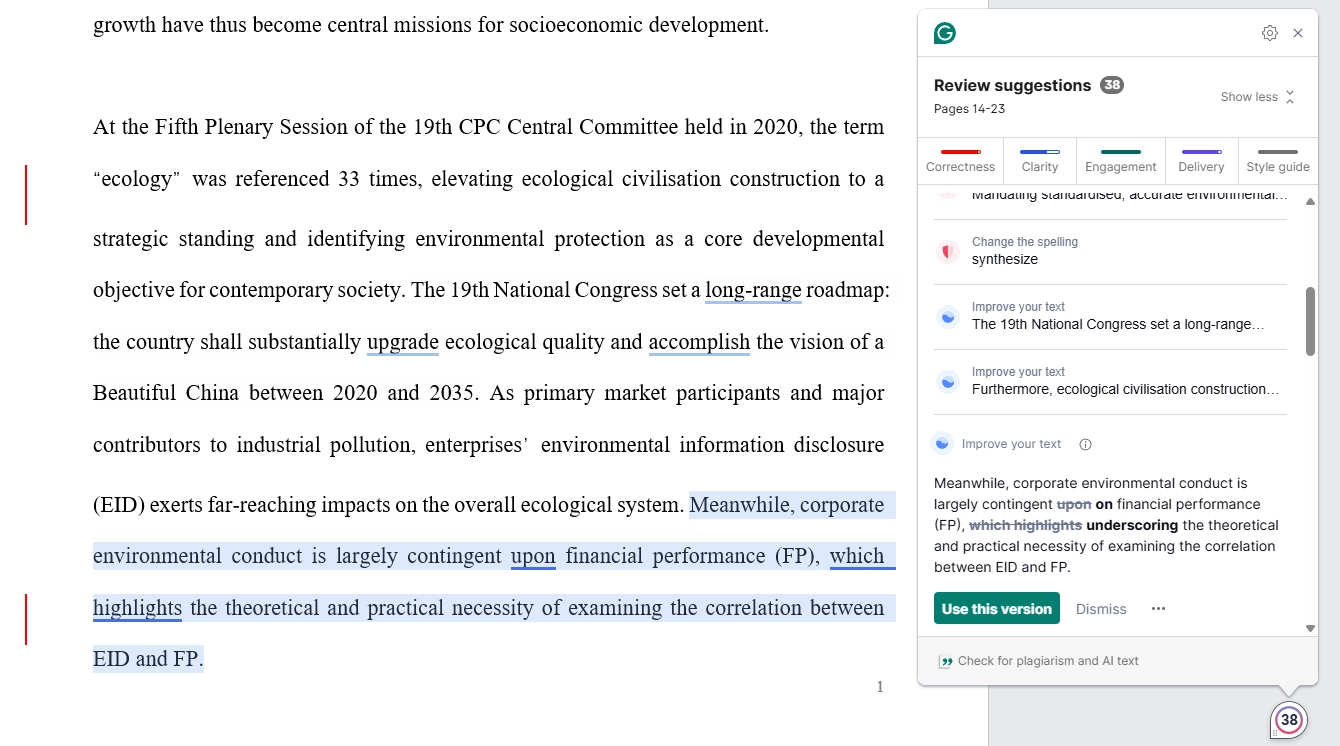
একটি গ্রহণ করা পরামর্শে কিছুই বদলায় না। কিন্তু কয়েক ডজন পরিবর্তনে নথির পরিসংখ্যানগত বৈশিষ্ট্য বদলে যায়: বাক্যের ছন্দ আরও একরকম হয়ে যায়, সংযোগকারী শব্দগুলো আরও আনুষ্ঠানিক হয়, এবং "thereby", "moreover", এবং "underscoring" এর মতো শব্দ জমতে থাকে। ডিটেক্টররা এই প্রোফাইলই স্কোর করে, এবং কিছু ডিটেক্টর এখন এটিকে সরাসরি নামেও চিহ্নিত করে। এই গাইডে আগে দেখানো Scribbr-এর ডিটেক্টর এমন ধরনের লেখার জন্য আলাদা "Human-written & AI-refined" বিভাগ দেখায়। QuillBot-এর প্যারাফ্রেজ মোড একই দিকে আরও এগিয়ে যায়, কারণ পুরো বাক্যকে হাউস স্টাইলে পুনর্লিখন করাই তাদের মূল পণ্য।
সমাধানটি সম্পাদনা এড়িয়ে চলা নয়। বরং এমন একটি সম্পাদক ব্যবহার করা, যা আপনার গদ্যকে নতুনভাবে সাজানো ছাড়াই ভুল সংশোধন করে। ProofreaderPro-এর Light proofreading মোড এই কারণেই detector safe: এটি ব্যাকরণ, বানান, এবং যতিচিহ্নকে পৃথক ট্র্যাকড পরিবর্তন হিসেবে ঠিক করে এবং আপনার বাক্যগঠন ও শব্দচয়ন অপরিবর্তিত রাখে, ফলে ডিটেক্টরদের fingerprint করা প্যাটার্নগুলো আপনারই থাকে। এটি AI proofreader থেকে চালান, প্রতিটি পরিবর্তন পর্যালোচনা করুন, এবং আপনার স্কোর আপনার লেখাকে প্রতিফলিত করবে, আপনার সম্পাদনা টুলকে নয়।
বাস্তবসম্মত লক্ষ্য: 0% নয়, 15%-এর নিচে
0% পাওয়ার চেষ্টা বন্ধ করুন। এটি অর্জনযোগ্য নয়, আর এটি তাড়া করতে থাকলে আপনার লেখার মান আরও খারাপ হবে।
0% AI স্কোর পেতে হলে এমন পাঠ্য লিখতে হবে যা এতটাই অনিয়মিত ও অপ্রত্যাশিত যে তা দুর্বলভাবে লেখা বলে মনে হবে। ডিটেক্টরগুলো যে পরিসংখ্যানগত ধরণ খোঁজে, সেগুলো স্পষ্ট, সুসংগঠিত একাডেমিক গদ্যের ধরণের সঙ্গে উল্লেখযোগ্যভাবে মিলে যায়। সব ডিটেক্টর সিগন্যাল মুছে ফেলতে গেলে স্পষ্টতা ও গঠন, দুটোই মুছে ফেলতে হয়।
একাডেমিক কাজের জন্য বাস্তবসম্মত লক্ষ্য হলো একাধিক ডিটেক্টরে 15%-এর নিচে থাকা। সেই স্তরে আপনার পাঠ্য মানব-লিখিত একাডেমিক কনটেন্টের স্বাভাবিক পরিসরের মধ্যে পড়ে। AI ডিটেকশন ব্যবহারকারী অধিকাংশ প্রতিষ্ঠান তাদের সীমা 20% বা তার বেশি রাখে, কারণ কিছুটা প্যাটার্ন-ম্যাচিং অনিবার্য, এটি তারা স্বীকার করে।
আমরা যে কর্মপ্রবাহটি সুপারিশ করি, তা হলো:
- আপনার খসড়া লিখুন বা তৈরি করুন - আপনি যেভাবেই তা উৎপাদন করুন না কেন
- এটিকে GPTZero-এর মাধ্যমে চালান যাতে চিহ্নিত অংশগুলো শনাক্ত করা যায়
- সবচেয়ে কম স্কোর পাওয়া অংশগুলো হাতে ধরে পুনর্লিখন করুন উপরের কৌশলগুলো ব্যবহার করে
- জেদি অংশগুলোর জন্য text humanizer ব্যবহার করুন যেগুলো হাতে পুনর্লিখন মেনে নেয় না
- তিনটি ডিটেক্টর জুড়ে আবার পরীক্ষা করুন - GPTZero, ZeroGPT, Copyleaks
- তিনটিতেই 15%-এর নিচে লক্ষ্য করুন, তারপর থামুন
15%-এর নিচে নামলে লাভ ক্রমশ কমে যায়। আরও কম সংখ্যা তাড়াতে যে সময় ব্যয় করবেন, তা আপনার প্রবন্ধের প্রকৃত বিষয়বস্তু এবং যুক্তি উন্নত করতে ব্যয় করা বেশি ভালো।
পরের বার: আগে লিখুন, পরে AI ব্যবহার করুন
প্রথমেই উচ্চ স্কোর এড়ানোর সবচেয়ে নির্ভরযোগ্য উপায় হলো প্রচলিত AI ওয়ার্কফ্লোকে উল্টে দেওয়া, আগে নিজের খসড়া লিখুন এবং AI-কে কেবল সেটি পরিমার্জনের জন্য ব্যবহার করুন। একটি খসড়া, অসম্পূর্ণ মানব-লিখিত ড্রাফটে আপনার বাক্যগত ছন্দ, শব্দচয়ন, এবং গঠনগত অভ্যাস থাকে, আর AI-ভিত্তিক পরিমার্জন সেই গভীরতর ছাপগুলো মুছে না দিয়ে পৃষ্ঠতলকে মসৃণ করে।
- AI সহায়তা ছাড়া, আপনার নোট ও গবেষণা থেকে একটি খসড়া লিখুন
- কাঠামো ও যুক্তি নিজের উদ্যোগে সংশোধন করুন
- নির্দিষ্ট কাজের জন্য AI ব্যবহার করুন: ব্যাকরণ পরীক্ষা, বাক্যের স্বচ্ছতা, শব্দচয়নের পরামর্শ
- AI-এর পরামর্শ পর্যালোচনা করে আপনার কণ্ঠস্বরের সঙ্গে মিলিয়ে তা পরিবর্তন করুন
- চূড়ান্তভাবে পড়ে দেখুন, লেখাটি আপনার মতো শোনাচ্ছে কি না নিশ্চিত করতে
দীর্ঘমেয়াদে, একই অভ্যাস সবচেয়ে শক্তিশালী প্রতিরক্ষা গড়ে তোলে, একটি স্বতন্ত্র কণ্ঠস্বর। আপনার ক্ষেত্রের লেখা বিস্তৃতভাবে পড়ুন, নিয়মিত লিখুন, এবং চিন্তাভাবনা শেষ হওয়ার পর পরিমার্জনের জন্য একটি AI proofreading tool ব্যবহার করুন। সত্যিকারের মানব-লিখিত লেখায় এমন প্যাটার্ন থাকে যা কোনো মডেল অনুকরণ করতে পারে না, আর লেখা আপনার নিজের হলে একটি detector-এর ধরারও কিছু থাকে না.
নীতিগত বিষয়টি, সরলভাবে বলা হলে
দুই পরিস্থিতির মধ্যে একটি তাৎপর্যপূর্ণ পার্থক্য আছে। AI ব্যবহার করে এমন একটি প্রবন্ধ লেখা, যেটিকে আপনি নিজের কাজ বলে দাবি করেন, তারপর সেই AI-এর সম্পৃক্ততা গোপন করা, একাডেমিক অসততা, এবং যতই মানবিককরণ করা হোক না কেন, তা এই সত্য বদলায় না। ব্যাকরণ, স্বচ্ছতা, ও গঠন উন্নত করার জন্য AI-কে লেখার উপকরণ হিসেবে ব্যবহার করা, তারপর আউটপুট যেন ভুলভাবে চিহ্নিত না হয় তা নিশ্চিত করা, দায়িত্বশীল টুল ব্যবহার। আসল পরীক্ষাটি বৌদ্ধিক অবদান: ধারণা, বিশ্লেষণ, এবং যুক্তিগুলো আপনারই হতে হবে। এখন অনেক বিশ্ববিদ্যালয় তাদের AI নীতিমালায় এই পার্থক্যটি স্পষ্টভাবে লিখে রাখছে, তাই আপনারটি পরীক্ষা করুন এবং যেখানে প্রয়োজন সেখানে টুল ব্যবহারের বিষয়টি প্রকাশ করুন।
প্রায়শই জিজ্ঞাসিত প্রশ্নাবলি
আমি কীভাবে আমার AI শতাংশ 20% এর নিচে নামাব?
সবচেয়ে কার্যকর পদ্ধতি হলো চিহ্নিত অংশগুলো হাতে-কলমে পুনর্লিখন করা। আপনার লেখাটি GPTZero-এর মতো sentence-level detector দিয়ে চালান, কোন নির্দিষ্ট অনুচ্ছেদগুলো আপনার স্কোর বাড়াচ্ছে তা চিহ্নিত করুন, এবং সেই অংশগুলো একেবারে শূন্য থেকে পুনর্লিখন করুন, শুধু সম্পাদনা করবেন না। বাক্যের দৈর্ঘ্যে বৈচিত্র্য আনুন, ক্ষেত্র-নির্দিষ্ট ভাষা যোগ করুন, এবং অনুচ্ছেদের গঠন পুনর্বিন্যাস করুন। জেদি অংশগুলোর জন্য academic AI humanizer ব্যবহার করুন। অধিকাংশ শিক্ষার্থী লক্ষ্যভিত্তিক পুনর্লিখনের এক দফার মধ্যেই 20% এর নিচে নামতে পারেন।
ZeroGPT কি সব AI-লিখিত লেখা শনাক্ত করে?
না। ZeroGPT, অন্য সব AI detector-এর মতো, উল্লেখযোগ্য সীমাবদ্ধতা আছে। স্বাধীন পরীক্ষায় দেখা গেছে, ZeroGPT-এর নির্ভুলতা লেখার ধরন এবং যে AI model এটি তৈরি করেছে তার ওপর নির্ভর করে 60-85% এর মধ্যে ওঠানামা করে। এটি সম্পাদনা না করা GPT-3.5 output-এ ভালো কাজ করে, আর নতুন model থেকে আসা লেখা বা হাতে সংশোধিত লেখায় খারাপ কাজ করে। এটি false positive-ও তৈরি করে, অর্থাৎ মানব-লিখিত লেখাকে AI-generated বলে চিহ্নিত করে, এবং লেখার শৈলীর ওপর নির্ভর করে এ হার 5-15% এর মধ্যে থাকে। কোনো AI detector-কে নির্ভুল বা ভুলত্রুটিহীন বলে ধরা উচিত নয়।
আমি নিজে লিখলেও কেন আমার AI score এত বেশি?
একাডেমিক লেখায় false positive সাধারণ, কারণ আনুষ্ঠানিক scholarly prose-এর পরিসংখ্যানগত বৈশিষ্ট্য AI-generated text-এর সঙ্গে মিলে যায়, যেমন বাক্যের দৈর্ঘ্য স্থিতিশীল থাকা, আনুষ্ঠানিক শব্দভান্ডার, পূর্বানুমেয় অনুচ্ছেদ কাঠামো, এবং topic-sentence organization। methods section এবং literature review বিশেষভাবে false positive-এর ঝুঁকিতে থাকে, কারণ এগুলো কঠোর disciplinary convention অনুসরণ করে। আপনি যদি লেখাটি নিজে লিখে থাকেন, তবে আপনার writing process নথিবদ্ধ করুন এবং detector-কে ফাঁকি দিতে নিখুঁত prose পুনর্লিখনের চেষ্টা করার বদলে আপনার instructor-এর সঙ্গে কথা বলুন।
অধিকাংশ বিশ্ববিদ্যালয় কোন AI detection score গ্রহণ করে?
কোনো সার্বজনীন মানদণ্ড নেই। নীতি প্রতিষ্ঠানে প্রতিষ্ঠানে, এমনকি একই বিশ্ববিদ্যালয়ের ভিন্ন department-এর মধ্যেও, ব্যাপকভাবে ভিন্ন। আমরা যে সবচেয়ে সাধারণ threshold দেখেছি তা 15% থেকে 25% পর্যন্ত, যদিও কিছু প্রতিষ্ঠান 10% এর বেশি যেকোনো কিছু review-এর জন্য চিহ্নিত করে। অনেক বিশ্ববিদ্যালয় একেবারেই কঠোর cutoff নির্ধারণ করে না, তারা AI detection-কে screening tool হিসেবে ব্যবহার করে যা স্বয়ংক্রিয় শাস্তির বদলে human review শুরু করে। আপনার নির্দিষ্ট প্রতিষ্ঠানের নীতি পরীক্ষা করুন, এবং সন্দেহ হলে, একাধিক detector জুড়ে 15% এর নিচে লক্ষ্য করুন।
Turnitin-এর AI score-এর ক্ষেত্রে কি একই পদ্ধতি কাজ করে?
হ্যাঁ। Turnitin-এর AI indicator, GPTZero এবং Copyleaks-এর মতো একই শ্রেণির statistical pattern পড়ে, তাই structural revision এটিকেও একইভাবে প্রভাবিত করে। Turnitin-নির্দিষ্ট বিস্তারিত জানতে আমাদের Turnitin humanizer guide এবং Turnitin score guide দেখুন।
একাডেমিক লেখায় AI detection এড়ানো কি নৈতিক?
আপনি AI কীভাবে ব্যবহার করেছেন তার ওপর নির্ভর করে। যদি আপনি AI-কে writing aid, grammar checking, sentence clarity, বা নিজের ধারণাগুলো গুছিয়ে নেওয়ার জন্য ব্যবহার করে থাকেন, তবে আপনার লেখা যেন ভুলভাবে চিহ্নিত না হয় তা নিশ্চিত করা যুক্তিসংগত। যদি আপনি এমন বিষয়বস্তু তৈরিতে AI ব্যবহার করেন যা আপনি নিজের intellectual work হিসেবে দাবি করছেন, তবে detection এড়ানো অসৎ। নৈতিক প্রশ্নটি ধারণা নিয়ে, লেখার শৈলী নিয়ে নয়। সবসময় আপনার প্রতিষ্ঠানের AI use policy পরীক্ষা করুন এবং তা অনুসরণ করুন।
AI detection এড়ানোর সবচেয়ে কার্যকর উপায় কী?
নিজের প্রথম খসড়া নিজে লেখা এবং AI-কে কেবল refinement-এর জন্য ব্যবহার করা। যে লেখা human writing হিসেবে শুরু হয়, AI editing-এর পরও তাতে human pattern বজায় থাকে। এর সঙ্গে ইচ্ছাকৃতভাবে বাক্যের দৈর্ঘ্যে বৈচিত্র্য আনা, ব্যক্তিগত কণ্ঠস্বর যোগ করা, এবং চূড়ান্ত detection check মিলিয়ে নিলে এমন লেখা তৈরি হয় যা ধারাবাহিকভাবে AI detector পাস করে।
AI detector কি non-English text-এ কাজ করে?
Non-English text-এর জন্য AI detector, English-language detector-এর তুলনায় কম নির্ভরযোগ্য। অধিকাংশ বাণিজ্যিক detector মূলত English data-তে প্রশিক্ষিত। আপনি যদি অন্য কোনো ভাষায় লিখছেন, তাহলে false positive rate বেশি হতে পারে, এবং detection এড়ানোর কৌশলগুলোকে সেই ভাষার convention অনুযায়ী মানিয়ে নিতে হতে পারে।
Turnitin কি AI-assisted writing শনাক্ত করতে পারে?
Turnitin-এর AI detection AI generation-এর সঙ্গে সঙ্গতিপূর্ণ pattern শনাক্ত করে, এবং এটি AI-generated ও AI-assisted text-এর মধ্যে পার্থক্য করতে পারে না। যে লেখা মূলত একজন মানুষ লিখেছে এবং AI দিয়ে পরিমার্জিত হয়েছে, সেটিও চিহ্নিত হতে পারে। প্রথম খসড়া নিজে লেখা এবং বাক্যগঠনে উল্লেখযোগ্য বৈচিত্র্য আনা false flagging কমায়।
একাডেমিক সুর, উদ্ধৃতি, এবং কারিগরি শব্দভাণ্ডার অক্ষুণ্ণ রেখে AI detection score কমান।

Moe একজন NLP ইঞ্জিনিয়ার একজন PhD সহ প্রাকৃতিক ভাষা প্রক্রিয়াকরণে। তার গবেষণা কম্পিউটেশনাল ভাষাতত্ত্ব, পাঠ্য বিশ্লেষণ এবং মেশিন লার্নিংকে কভার করে এবং এটি সরাসরি ProofreaderPro-এর পিছনে সম্পাদনা এবং মানবীকরণ মডেলগুলিতে যোগ করে। তিনি প্রক্রিয়াটির অংশ সম্পর্কে লিখেছেন যা বেশিরভাগ লোকেরা কখনই দেখে না: কীভাবে একটি ভাষা মডেল একটি বাক্য পড়ে, স্কোর করে এবং কী পরিবর্তন করতে হবে তা সিদ্ধান্ত নেয়।


