
OpenAI, Google এবং Anthropic সবাই একই প্রযুক্তি তৈরি করেছে: AI-Generated টেক্সটের জন্য একটি পরিসংখ্যানভিত্তিক ওয়াটারমার্ক। OpenAI তাদের সংস্করণ বহু বছর ধরে গোপন রেখেছিল এবং অক্টোবর 2026 সালে textGrain নামে এটি ধীরে ধীরে চালু করতে শুরু করে। Google Gemini-এর ভেতরে SynthID পাঠিয়ে দেয় এবং পদ্ধতিটি প্রকাশ করে। Anthropic আগস্ট 2026-এ Claude-এর ওয়াটারমার্ককে প্রত্যেক ব্যবহারকারীর জন্য বাধ্যতামূলক করে। আপনি যেভাবেই AI সহায়তা দিয়ে লিখুন না কেন, এখন এই তিনটি সিদ্ধান্ত আপনার নথিগুলো কীভাবে বিচার হবে তা নির্ধারণ করে।
ওয়াটারমার্কিং গবেষণার বিষয় থেকে 11 আগস্ট 2026 তারিখে মূলধারার সংবাদে পরিণত হয়, যখন Anthropic ঘোষণা করে যে প্রতিটি নতুন Claude মডেল তার টেক্সট আউটপুটে ওয়াটারমার্ক বসায়। আমরা আমাদের Anthropic-এর Claude জলছাপ, ব্যাখ্যা (2026) অংশে ওই ঘোষণাটি বিস্তারিতভাবে কভার করেছি। এই গাইডে পুরো চিত্রটি আছে: একটি টেক্সট ওয়াটারমার্ক কী, এই তিনটি বড় ল্যাব কীভাবে তা বাস্তবায়ন করেছে বা আটকে রেখেছে, এবং প্রতিটি সিস্টেম লেখার একটি অংশ সম্পর্কে কী প্রমাণ করে।
AI টেক্সট ওয়াটারমার্ক কী?
একটি AI টেক্সট ওয়াটারমার্ক হলো জেনারেটেড টেক্সটের word choices এর মধ্যে লুকানো একটি পরিসংখ্যানভিত্তিক প্যাটার্ন। জেনারেশনের মুহূর্তে এটি বসানো হয়, যাতে সঠিক কী ধারণকারী একটি ডিটেক্টর পরে যাচাই করতে পারে যে টেক্সটি নির্দিষ্ট কোনো AI সিস্টেম থেকে এসেছে। এটি কোনো দৃশ্যমান লেবেল নয়, কোনো লুকানো অক্ষর নয়, এবং ফাইলে সংযুক্ত কোনো মেটাডেটাও নয়। এই চিহ্নটি শব্দগুলোর মধ্যেই থাকে।
এই পার্থক্যটি গুরুত্বপূর্ণ, কারণ "watermark" শব্দটি তিনটি আলাদা জিনিস বোঝাতে ঢিলেঢালাভাবে ব্যবহৃত হয়:
| এটি কী | কোথায় থাকে | কপি-পেস্ট টিকে থাকে? | |
|---|---|---|---|
| পরিসংখ্যানভিত্তিক ওয়াটারমার্ক | এক ধরনের পক্ষপাত, যেখানে মডেল কোন শব্দ বেছে নেয় | নিজের টেক্সট | হ্যাঁ |
| ফাইল মেটাডেটা (C2PA) | স্বাক্ষরিত একটি প্রোভেন্যান্স লেবেল | ফাইল কন্টেইনার | না, সরল-প্লেইন টেক্সট কপি করলে তা চলে যায় |
| শূন্য-প্রস্থ অক্ষর | টেক্সটের মধ্যে অদৃশ্যভাবে ইউনিকোড ঢুকিয়ে দেওয়া | দৃশ্যমান অক্ষরগুলোর মাঝখানে | না, সহজেই সরিয়ে ফেলা যায় |
তিনটির মধ্যে শুধুমাত্র পরিসংখ্যানভিত্তিক ওয়াটারমার্কিং কপি, পেস্ট, নতুন নথিতে পুনরটাইপ, এবং ফরম্যাট রূপান্তরের পরও টিকে থাকে। তাই টেক্সটের ক্ষেত্রে তিনটি প্রধান গবেষণাগারই এটিকে একত্রে বেছে নিয়েছে, এবং তাইই "ওয়াটারমার্ক সরানো" টুলগুলো যা অদৃশ্য অক্ষর মুছে ফেলে, সেটার বিরুদ্ধে কার্যত কিছুই করতে পারে না। আমাদের claude ওয়াটারমার্ক অপসারণকারী পেজটি উৎসসহ এই ব্যর্থতার ধরনটি নথিভুক্ত করেছে।
পরিসংখ্যানভিত্তিক ওয়াটারমার্কিং আসলে কীভাবে কাজ করে?
একটি বাক্য লেখার প্রতিটি ধাপে, একটি ভাষা মডেল কয়েকটি প্রায় সমার্থক শব্দের মধ্যে থেকে বেছে নেয়, এবং সেই শব্দগুলোর ওপর একটি ওয়াটারমার্ক নীরবে সেই পছন্দের ডাইসগুলো লোড করে। ভিত্তিমূলক রেসিপিটি জানুয়ারি ২০২৩ সালে মেরিল্যান্ড বিশ্ববিদ্যালয়ের Kirchenbauer ও সহকর্মীরা প্রকাশ করেন, বড় ভাষা মডেলের আউটপুট শনাক্তকরণের জন্য একটি ওয়াটারমার্ক (ICML 2023)। এটি এভাবে কাজ করে:
- প্রতিটি শব্দ বাছাইয়ের আগে, আগের শব্দগুলো থেকে উদ্ভূত একটি গোপন কী শব্দভান্ডারকে একটি পছন্দের সেট এবং একটি নিরপেক্ষ সেটে ভাগ করে।
- মডেলটি তার পছন্দকে পছন্দের সেটের দিকে সামান্য ঠেলে দেয়। "Suggest" বদলে "indicate"। "Across" বদলে "among"। প্রতিটি আলাদা পছন্দ একেবারেই স্বাভাবিক দেখায়।
- কী-টি ধরে রাখা একটি ডিটেক্টর গণনা করে টেক্সটটি কতবার পছন্দের সেটে পড়ে। মানুষ-লেখা টেক্সট সম্ভাবনার কারণে প্রত্যাশিত হারের কাছাকাছি থাকে। ওয়াটারমার্কযুক্ত টেক্সট অনেক বেশি ঘন ঘন সেখানে পড়ে, এবং একটি পরিসংখ্যানগত পরীক্ষা পার্থক্যটি চিহ্নিত করে।
একটি একক শব্দই কোনো কিছুর প্রমাণ নয়। সিগন্যালটি কেবল ডজন বা শতাধিক পছন্দের ওপর জুড়েই স্পষ্ট হয়, এজন্যই ছোট অংশের চেয়ে লম্বা অংশ পরীক্ষা করা সহজ, এবং এজন্যই ডিটেকশন সবসময়ই সম্ভাবনাভিত্তিক, হ্যাঁ বা না ধরনের সিল নয়।
Google DeepMind-এর উৎপাদন-ব্যবস্থা, যেটি অক্টোবর ২০২৪-এ Nature পত্রিকায় বড় ভাষা মডেলের আউটপুট শনাক্তকরণের জন্য স্কেলেবল ওয়াটারমার্কিং হিসেবে প্রকাশিত, tournament sampling নামে একটি কৌশল দিয়ে এটি আরও পরিমার্জিত করে। এতে টেক্সটের মান এতটাই ভালো থাকে যে সেটি বড় পরিসরে কোনো ভোক্তা পণ্যের ভেতরে নীরবে চালানো যায়। এই প্রবন্ধটি Google-এর বাইরেও গুরুত্বপূর্ণ: এটি সেই প্রকাশিত ভিত্তি, যেটির কথা Anthropic উল্লেখ করে Claude-এর বাস্তবায়নে।
প্রধান দুর্বলতাটি অধিকাংশ ডিপ্লয়মেন্টের আগেই প্রকাশিত হয়েছিল। মার্চ ২০২৩-এ Krishna ও সহকর্মীরা Paraphrasing evades AI-generated text detectors (NeurIPS 2023)-এ দেখিয়েছেন যে কোনো প্যাসেজের বাক্যগঠন পুনর্লিখন করলে ডিটেকশন সব পদ্ধতিতেই ভেঙে পড়ে, ওয়াটারমার্কিংসহ। সিগন্যালটি থাকে একদম নির্দিষ্ট টোকেনের ক্রমেই, আর কোথাও নয়। ফলে যে কোনো কিছু যা এই ক্রম পুনর্লিখন করে, একজন মানব সম্পাদকসহ, প্রমাণটাকেই মুছে দেয়। আজ যে কোনো বিক্রেতা ওয়াটারমার্ক শিপ করে, তার নিজস্ব ডকুমেন্টেশনেই এই সীমাবদ্ধতার কথা উল্লেখ থাকে।

OpenAI: যে কোম্পানিটি এটি উদ্ভাবন করেছে এবং শেষবার শিপ করেছে
OpenAI-এর কয়েক বছর ধরে একটি কার্যকর টেক্সট ওয়াটারমার্ক ছিল এবং অক্টোবর ২০২৬ পর্যন্ত সেটি প্রকাশ করার সিদ্ধান্ত নেয়নি। তখন OpenAI-তে সেফটিতে কাজ করা Scott Aaronson প্রথম এই ধারণাটি জনসমক্ষে একটি November 2022 lecture-এ ব্যাখ্যা করেন। এই পদ্ধতিটি একটি গোপন ক্রিপ্টোগ্রাফিক ফাংশন দিয়ে প্রায় সমতুল্য শব্দগুলোর মধ্যে মডেলের পছন্দকে পক্ষপাতদুষ্ট করে, ফলে টেক্সটেই নিজে থেকেই বোঝা যায় এটি কোথা থেকে এসেছে। ওই লেকচারটি প্রতিটি ডেপ্লয়ড সিস্টেমের চেয়েও পুরোনো।
২০২৪ সালের মে মাসে, OpenAI তার প্রোভেন্যান্স আপডেটে প্রকল্পটির অবস্থা সম্পর্কে আমরা অনলাইনে যা দেখি এবং শুনি তার উৎস কীভাবে বোঝা যায় শীর্ষক আপডেট দেয়। কোম্পানিটি বলেছে, তাদের টেক্সট ওয়াটারমার্কিং পদ্ধতি ছোটখাটো এডিটে নির্ভুল এবং কার্যকর, তবে এটি ছাড়ার আগে তারা সুবিধা-অসুবিধা যাচাই করছিল। OpenAI যে দুইটি ঝুঁকির কথা উল্লেখ করেছে, সেগুলো একাডেমিক লেখকদের জন্য সরাসরি গুরুত্বপূর্ণ:
- সহজে এড়িয়ে যাওয়া। টেক্সটকে প্যারাফ্রেজ বা অনুবাদ করলে মার্কটি উঠে যায়, ঠিক যেমন ২০২৩ সালের গবেষণা পূর্বাভাস দিয়েছিল। যে ওয়াটারমার্কটি মূলত তাদেরই ধরতে পারে যারা এটি যে আছে তা জানে না, সেটি দুর্বল প্রয়োগ-ক্ষমতার একটি টুল।
- অ-মাতৃভাষী ইংরেজিভাষীদের ওপর অসম প্রভাব। OpenAI জানিয়েছে, ওয়াটারমার্কিং এমন মানুষদের বৈধভাবে AI ব্যবহারকে লেখার সহায়তা হিসেবে দেখলে তাদের প্রতি নেতিবাচক সামাজিক কলঙ্ক সৃষ্টি করতে পারে, বিশেষ করে যারা দ্বিতীয় ভাষা হিসেবে ইংরেজিতে লেখেন। কেন AI detector অ-মাতৃভাষী লেখকদের ওপর নিশানা লাগায় শীর্ষক আমাদের লেখাটিতে একই সমস্যা ডিটেক্টর দিক থেকে ব্যাখ্যা করা হয়েছে।
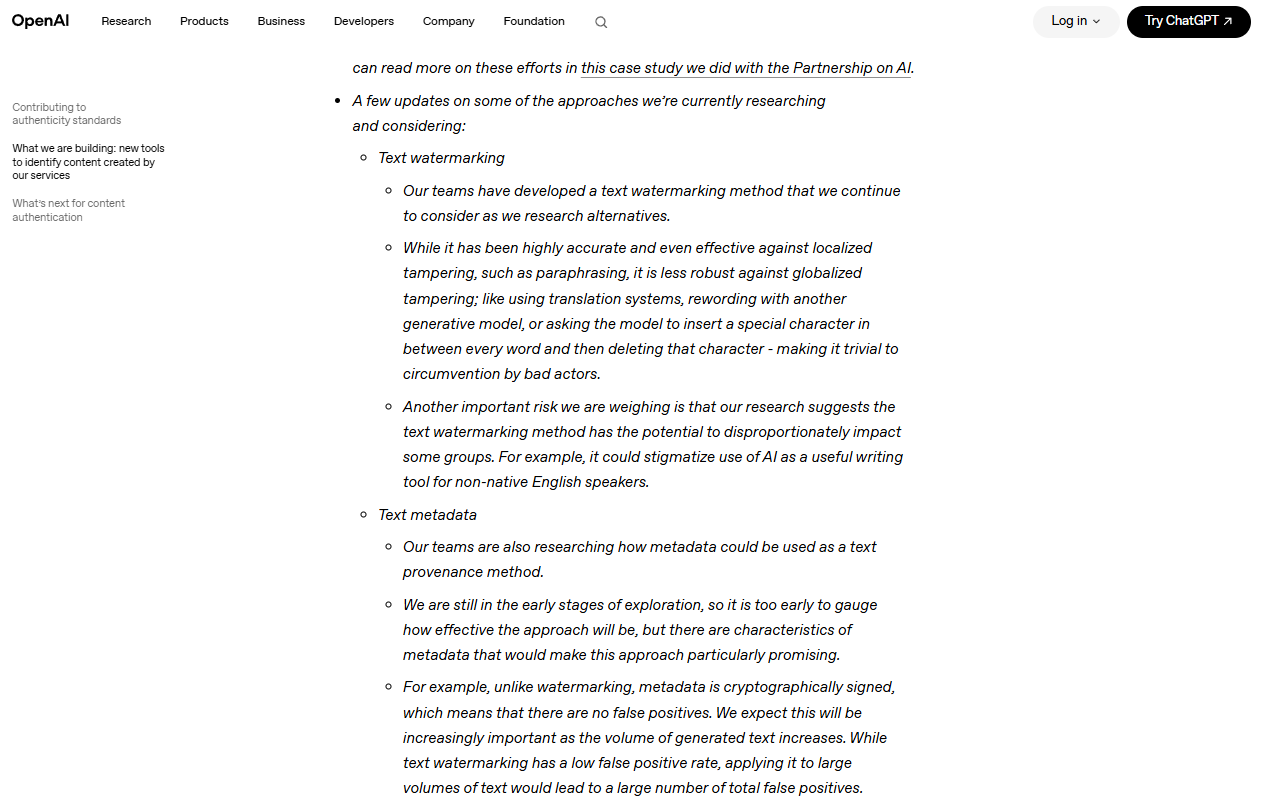
OpenAI-এর ২০২৪ প্রোভেন্যান্স আপডেট: পদ্ধতিটি কাজ করে, এবং কোম্পানিটি তখন এটিকে পিছিয়ে রাখার কারণগুলোও তালিকাভুক্ত করেছে।
ছবি এবং অডিওর ক্ষেত্রে OpenAI ভিন্ন পথে গেছে: DALL-E এবং Sora আউটপুটে C2PA প্রোভেন্যান্স মেটাডেটা ব্যবহার, যা কনটেন্টের ভেতরের একটি মার্ক নয়, বরং ফাইল-লেভেলের একটি লেবেল। টেক্সটের ক্ষেত্রে, ChatGPT আউটপুটে অক্টোবর ২০২৬ পর্যন্ত কোনো ওয়াটারমার্ক ছিল না। যে কোম্পানিটি প্রযুক্তিটি প্রস্তাব করেছিল, তাদের মধ্যে তিনজনের মধ্যে সর্বশেষ তার বাস্তবায়ন করেছে।
OpenAI কি এখন টেক্সট ওয়াটারমার্ক দেয়?
হ্যাঁ, OpenAI ৫ অক্টোবর ২০২৬ থেকে কিছু টেক্সটে ওয়াটারমার্কিং শুরু করেছে, EU AI Act-এর প্রতিক্রিয়ায়। তাদের ঘোষণা টেক্সটগ্রেইন নামে একটি টেক্সট ওয়াটারমার্ক তুলে ধরে, যা মডেলের শব্দচয়েসে একটি অদৃশ্য পরিসংখ্যানভিত্তিক সংকেত যোগ করে। রোলআউটটির তিনটি অংশ আছে, এবং ওয়াটারমার্কটি কোনো সর্বজনীন ডিফল্ট নয়:
- যেকোনো জায়গার API গ্রাহকেরা নির্দিষ্ট কিছু মডেলের জন্য ওয়াটারমার্কযুক্ত আউটপুট অন করতে পারে। ডিফল্ট হিসেবে এটি বন্ধ থাকে।
- পরবর্তী কয়েক সপ্তাহে, ইউরোপীয় ইউনিয়নে যোগ্য ChatGPT এবং Codex টেক্সট আউটপুটে ওয়াটারমার্কটি আসে, সব পরিকল্পনায়।
- অনুমোদিত গবেষক এবং বিশেষজ্ঞ সংস্থাগুলো টেক্সট ওয়াটারমার্ক ডিটেক্টরে অ্যাক্সেসের জন্য আবেদন করতে পারে।
OpenAI বলছে, টেক্সটগ্রেইন তারা যে অন্য পদ্ধতিগুলো পরীক্ষা করেছে তার সমান বা ভালো পারফর্ম করেছে, যার মধ্যে টেক্সটের জন্য Google's SynthIDও আছে। তারা আরও প্রকাশ করেছে কোথায় ডিটেকশন দুর্বল হয়ে পড়ে। ১% false-positive রেটে, ডিটেক্টরটি ২০০ টোকেনের প্যাসেজে প্রায় ৮০% এবং ৪০০ টোকেনের প্যাসেজে প্রায় ৯৫% সাইকোলজি কনটেন্টে ওয়াটারমার্ক শনাক্ত করতে পেরেছে। শব্দচয়েসের স্বাধীনতা কম থাকার কারণে গণিতের ক্ষেত্রে ডিটেকশন অনেক কম ছিল।
এডিটিং দ্রুত সংকেতকে দুর্বল করে। ৪০০ টোকেনের প্যাসেজে, ১০% শব্দকে সমার্থক শব্দ দিয়ে বদলালে ডিটেকশন প্রায় ৯২% থেকে ৬৬% এ নেমে আসে, আর ২৫% বদলালে সেটা ১৭% হয়।
OpenAI আরও দেখেছে, Astra, তাদের সর্বশেষ মডেলে ওয়াটারমার্ক উত্তরগুলোর মান বদলায় কি না, এবং তারা বলছে কোনো অর্থপূর্ণ পার্থক্য তারা দেখেনি। নিচে তারা প্রকাশ করা চারটি বেঞ্চমার্কের মধ্যে কয়েকটি:
| বেঞ্চমার্ক | ওয়াটারমার্ক ছাড়া (Astra) | ওয়াটারমার্কসহ (Astra) |
|---|---|---|
| Artificial Analysis Intelligence Index | 49.57 পয়েন্ট | 49.76 পয়েন্ট |
| GPQA Diamond | 94.44% | 93.94% |
| HealthBench Professional | 64.27% | 64.60% |
| BrowseComp | 87.92% | 87.35% |
শিক্ষার্থীদের জন্য তারিখটা গুরুত্বপূর্ণ। রোলআউটের আগে লেখা বা API সেটিং ছাড়া ইউরোপীয় ইউনিয়নের বাইরে লেখা ChatGPT টেক্সটে OpenAI ওয়াটারমার্ক থাকে না। এদিকে স্কুলগুলো কীভাবে নিজেদের AI-ব্যবহারের নীতি ঠিক করছে তা জানতে আমাদের Turnitin Clarity ব্যাখ্যা গাইড দেখুন।
সেখানে কি কোনো পাবলিক OpenAI ওয়াটারমার্ক চেকার আছে?
এখনো টেক্সটের জন্য কোনো পাবলিক OpenAI ওয়াটারমার্ক যাচাইকারী টুল নেই। OpenAI-এর বিনামূল্যের ভেরিফিকেশন টুল C2PA Content Credentials এবং SynthID ওয়াটারমার্কের জন্য ছবি ও অডিও ফাইল যাচাই করে। OpenAI সমর্থিত ছবি ও অডিওতে এই SynthID ওয়াটারমার্ক এম্বেড করে। OpenAI বলেছে, টুলটি টেক্সট সমর্থন করে না।
টেক্সটের ক্ষেত্রে, OpenAI অনুমোদিত গবেষক এবং বিশেষজ্ঞ সংস্থার জন্য কেস বাই কেস ভিত্তিতে ডিটেক্টর অ্যাক্সেস দেয়, তাদের কনটেন্ট প্রোভেন্যান্স API ফর্ম এর মাধ্যমে। তারা বলে, মিসড ওয়াটারমার্ক এবং ফলস পজিটিভের ঝুঁকির কারণে লঞ্চের সময় টেক্সট ডিটেক্টরটি জনসমক্ষে দেবে না। ডিটেক্টর জানায় এটি OpenAI ওয়াটারমার্ক খুঁজে পায় কি না, এবং এটি ব্যবহারকারীকে শনাক্ত করে না বা তাদের প্রম্পট দেখায় না।
| আপনি কী যাচাই করতে চান | টুল | কে ব্যবহার করতে পারে |
|---|---|---|
| OpenAI-এর একটি ছবি বা অডিও ফাইল | OpenAI-এর যাচাই টুল | যে কেউ, বিনামূল্যে |
| OpenAI টেক্সট আউটপুট (textGrain) | OpenAI-এর টেক্সট ওয়াটারমার্ক ডিটেক্টর | আবেদন করে অনুমোদিত গবেষক ও বিশেষজ্ঞ সংস্থাগুলো |
| Claude টেক্সট আউটপুট | Claude Watermark Detector | যোগ্য সংস্থা, আবেদন সাপেক্ষে (দেখুন আমাদের Anthropic-এর Claude জলছাপ, ব্যাখ্যা (2026)) |
ফলাফল কী বলতে পারে না সে বিষয়েও OpenAI স্পষ্ট। একটি শনাক্ত করা ওয়াটারমার্ক কোনোভাবেই বলে না একজন ব্যক্তি কতটা অবদান রেখেছেন, এবং এটি কে টেক্সটটি লিখেছেন বা ব্যবহার করেছেন তা শনাক্ত করে না। একটি ওয়াটারমার্ক না থাকা মানে মানব লেখকত্বও প্রমাণ করে না, কারণ টেক্সট খুব ছোট হতে পারে, এডিট বা অনুবাদ হতে পারে, অথবা অসমর্থিত মডেল থেকে আসতে পারে।
Google: আগে প্রকাশ, তারপর রেসিপি উন্মুক্ত করে দেওয়া
Google DeepMind আগে প্রকাশ করে, সম্পূর্ণভাবে প্রকাশনা দেয়, তারপর পদ্ধতিটিও উন্মুক্ত করে। তাদের সিস্টেম SynthID, ২০২৩ সালে একটি ছবি ওয়াটারমার্ক হিসেবে শুরু হয় এবং ২০২৪ সালে টেক্সটে সম্প্রসারিত হয়। অক্টোবর ২০২৪-এ Nature পেপার আসার আগেই SynthID-Text প্রোডাকশনে Gemini-এর ভেতরে চলছিল, ফলে এটি কনজিউমার স্কেলে মোতায়েন হওয়া প্রথম পরিসংখ্যানভিত্তিক টেক্সট ওয়াটারমার্ক।
SynthID টেক্সট, ছবি, অডিও এবং ভিডিও কভার করে, এবং অক্টোবর ২০২৪ থেকে Gemini টেক্সট আউটপুটে লাইভ আছে।
এরপর Google বাস্তবায়নটিকে Hugging Face-এ ওপেন সোর্স হিসেবে প্রকাশ করে, যাতে যে কোনো ডেভেলপার নিজস্ব মডেলেও একই ওয়াটারমার্কিং স্কিম প্রয়োগ করতে পারে। মে ২০২৫-এ তারা SynthID Detector ঘোষণা করে, একটি ভেরিফিকেশন পোর্টাল যেখানে টেক্সট, ছবি, অডিও এবং ভিডিও জুড়ে SynthID মার্কের জন্য কনটেন্ট পরীক্ষা করা যায়।
একটি গুরুত্বপূর্ণ সীমাবদ্ধতা হলো: SynthID শুধুমাত্র Google-এর নিজস্ব মডেল থেকে আসা কনটেন্টে মার্ক করে এবং শুধুমাত্র সেগুলোই ডিটেক্ট করে। এটি ChatGPT বা Claude-এর আউটপুট সম্পর্কে কোনো কথা বলে না, এবং একটি পরিষ্কার SynthID স্ক্যান মানেই টেক্সটটি মানুষ লিখেছে এমন নয়। এর মানে হলো Google-এর মডেলগুলো সেটি লেখেনি, যা তুলনামূলকভাবে অনেক বেশি সীমিত দাবি।
Anthropic: শেষ পর্যন্ত যাওয়া, সবচেয়ে কঠোর নীতি
Anthropic সর্বশেষ মোতায়েন করেছে এবং সবচেয়ে বিস্তৃত বাধ্যতামূলক কভারেজ দিয়েছে। ২ অগাস্ট ২০২৬ অথবা তার পর চালু হওয়া প্রতিটি Claude মডেল তার টেক্সট আউটপুটে বিশ্বব্যাপী একটি পরিসংখ্যানভিত্তিক ওয়াটারমার্ক এম্বেড করে, সব পরিকল্পনায়, কোনো অপ্ট-আউট ছাড়াই। কোম্পানি তাদের ব্যাখ্যায় প্রক্রিয়াটি বর্ণনা করেছে, Claude-এর টেক্সট ওয়াটারমার্ক কীভাবে কাজ করে, এবং সাহায্য-কেন্দ্রের আর্টিকেলে নীতির পরিধি দিয়েছে, Claude কীভাবে AI-উৎপন্ন কনটেন্টকে চিহ্নিত করে। Claude API, claude.ai, Claude Code, Claude Cowork, এবং Claude Tag সবই কভার করা। কাট-অফের আগে চালু হওয়া মডেলগুলো ট্রানজিশন পিরিয়ডে আছে, এবং Anthropic বলেছে, সেগুলোর ক্ষেত্রেও তারা মার্কিং সাপোর্ট যোগ করছে। পরিসংখ্যানভিত্তিক মার্কের পাশাপাশি, Claude-generated ফাইলগুলোতেও C2PA মেটাডেটা থাকে, যা দ্বিতীয় এবং আলাদা একটি সিস্টেম। সাধারণ টেক্সট কপি করলে এটি কেটে যায়।
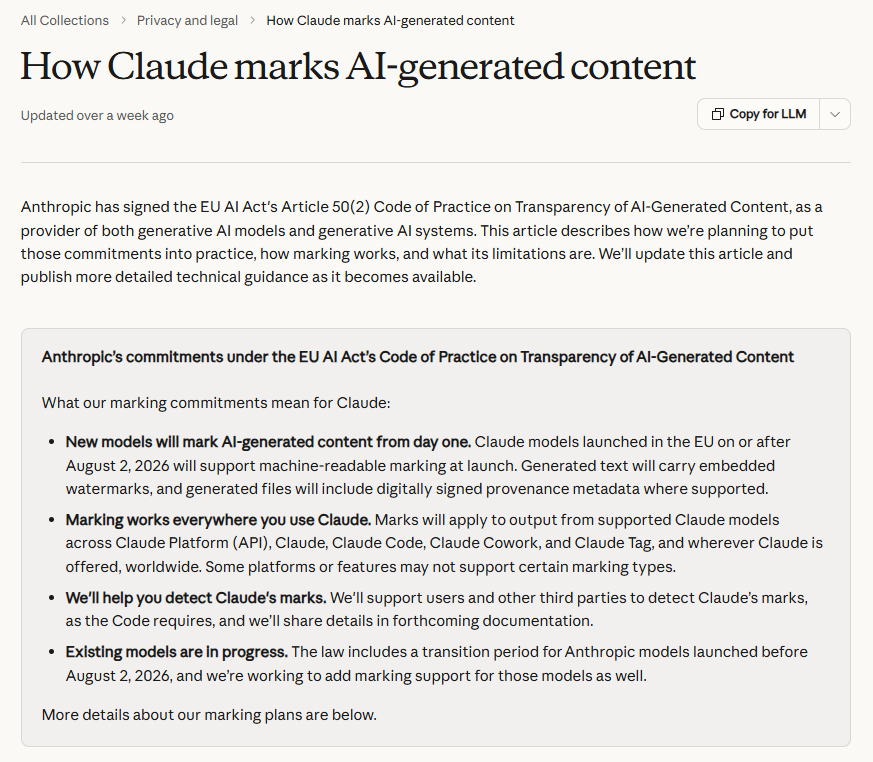
Anthropic নিজের ভাষায় যে নীতিটি লিখেছে: প্রতিটি নতুন মডেল, প্রতিটি প্ল্যাটফর্ম, সারা বিশ্ব জুড়ে, আর পুরনো মডেলগুলো ধাপে ধাপে যোগ করা হচ্ছে।
Anthropic-এর ডকুমেন্টেশন সীমাবদ্ধতাগুলি সরাসরি বলে। ডিটেকশন সম্ভাব্যতাভিত্তিক। এই মার্ক কোনো নথি Claude লিখেছে নাকি একজন মানুষ লিখে Claude তা সামান্য সম্পাদনা করেছে, তা আলাদা করে বলতে পারে না। পুরোপুরি নতুন করে লেখা হলে মার্কটি থাকে না। আমরা এগুলোর সবকিছুই ঘেঁটে দেখেছি, ইতিবাচক ডিটেকশন আসলে কী প্রমাণ করে এবং আপনার নিজের লেখা মার্কড হলে কী করবেন, এই নির্দিষ্ট Claude ওয়াটারমার্ক গাইড এর মধ্যে।
সময় নির্ধারণটি বিধিবিধানের সঙ্গে সামঞ্জস্যপূর্ণ। Anthropic EU AI Act এর অধীনে Article 50(2) Code of Practice on Transparency of AI-Generated Content স্বাক্ষর করেছে, যেখানে জেনারেটিভ AI সিস্টেমের সরবরাহকারীদের নিশ্চিত করতে বলা হয়েছে যে আউটপুটগুলোকে "মেশিন-পাঠযোগ্য ফরম্যাটে মার্ক করতে হবে এবং কৃত্রিমভাবে তৈরি হিসেবে শনাক্তযোগ্য হতে হবে।" এই স্বচ্ছতার বাধ্যবাধকতাগুলি ২ অগাস্ট, ২০২৬ থেকে কার্যকর হয়: Anthropic-এর মডেল নীতিতে ঠিক ওই নির্দিষ্ট কাট-অফ তারিখ, যা জনসমক্ষে ঘোষণার নয় দিন আগে। Anthropic EU ট্র্যাফিকের জন্য আলাদা আচরণ বজায় না রেখে বিশ্বব্যাপীভাবে মেনে চলার সিদ্ধান্ত নিয়েছে। Google নিজ থেকেই ডিজাইনে কমপ্লায়েন্ট ছিল। ২০২৭ সালে OpenAI-এর আনমার্কড টেক্সট আউটপুটটি কীভাবে কমপ্লায়েন্ট হবে, সেটাই উন্মুক্ত প্রশ্ন।
তিনটি পদ্ধতি, পাশাপাশি
| OpenAI | Google DeepMind | Anthropic | |
|---|---|---|---|
| টেক্সট ওয়াটারমার্ক ডেপ্লয় করা হয়েছে? | হ্যাঁ (textGrain, ৫ অক্টোবর, ২০২৬ থেকে EU রোলআউট) | হ্যাঁ (Gemini, অক্টোবর ২০২৪ থেকে) | হ্যাঁ (Claude মডেল, ২ অগাস্ট, ২০২৬ থেকে) |
| কৌশল | textGrain, শব্দচয়নে পরিসংখ্যানভিত্তিক সংকেত | SynthID-Text টুর্নামেন্ট স্যাম্পলিং | পরিসংখ্যানভিত্তিক স্যাম্পলিং মার্ক, SynthID-ধাঁচের |
| কভারেজ | EU-তে যোগ্য ChatGPT এবং Codex টেক্সট; API-তে সারা বিশ্বে অপ্ট-ইন | শুধু Google মডেলগুলো | সব নতুন Claude মডেল; পুরনো মডেলগুলি ট্রানজিশনে |
| অপ্ট-আউট | ডিফল্টভাবে API-তে বন্ধ | না | না |
| পাবলিক ডিটেক্টর | না | SynthID Detector পোর্টাল (২০২৫) | পরিকল্পিত, এখনও প্রকাশিত নয় |
| স্কিম প্রকাশিত? | কেবল ধারণাগত লেকচার | Nature পেপার + ওপেন সোর্স | ব্যাখ্যাকার, প্রকাশিত গবেষণার ওপর ভিত্তি করে |
| ফাইল মেটাডেটা (C2PA) | হ্যাঁ, ছবি এবং অডিও | হ্যাঁ, একাধিক মিডিয়ায় | হ্যাঁ, জেনারেটেড ফাইলে |
| উল্লেখিত সীমাবদ্ধতা | বাইপাস করা, ESL সংশ্লিষ্ট কলঙ্ক | নিজস্ব মডেলের মধ্যে সীমিত | প্রবাবিলিস্টিক, সম্পাদনায় লেখকত্ব অস্পষ্ট হয় |
কলামগুলোর মধ্যে যে প্যাটার্নটি দেখা যায়: OpenAI টেক্সট ওয়াটারমার্কিংকে একটি অনিষ্পন্ন নীতিগত সমস্যা হিসেবে দেখে, Google এটিকে মানসম্মত করার অবকাঠামো হিসেবে দেখে, এবং Anthropic এটিকে সম্পূর্ণভাবে বাস্তবায়নের জন্য একটি সম্মতি বাধ্যবাধকতা হিসেবে দেখে।
গবেষক ও একাডেমিক লেখকদের জন্য এর মানে কী
বাস্তব ফলাফল নির্ভর করে কোন টুলগুলো আপনার টেক্সটে হাত লাগায় তার ওপর। আপনি যদি ChatGPT দিয়ে খসড়া লেখেন, আজ আপনার টেক্সটে কোনো ওয়াটারমার্ক থাকে না। আপনি যদি Gemini দিয়ে খসড়া লেখেন, এতে একটি SynthID চিহ্ন থাকে যা কেবল Google-এর ডিটেক্টরই পড়তে পারে। আপনি যদি বর্তমান Claude মডেল দিয়ে খসড়া বা সম্পাদনা করেন, এতে Anthropic-এর চিহ্ন থাকে, এবং এটিকে বন্ধ করার কোনো সেটিং নেই।
তিনটি বিষয় যা একাডেমিক লেখকদের জানা উচিত:
ওয়াটারমার্ক কোনো লেখককে নয়, একটি টুলকে শনাক্ত করে। প্রতিটি বিক্রেতা তাদের নিজস্ব ডকুমেন্টেশনে এটি বলে, এবং পার্থক্যটা মনে করিয়ে দেওয়া মূল্যবান, কারণ প্রতিষ্ঠানের নীতিমালা সব সময় এই পার্থক্যটা ধরতে পারে না। টেক্সটে চিহ্ন বসতে পারে কারণ সেটি কোনো AI লিখেছে, কারণ সেটির দুটো বাক্যে AI কপি-এডিট করেছে, অথবা কারণ কোনো চিহ্নিত অনুচ্ছেদ উদ্ধৃত করা হয়েছে। আপনার প্রতিষ্ঠান যদি ওয়াটারমার্ক যাচাই চালায়, তাহলে যাচাইটি প্রমাণ করে যে নির্দিষ্ট কোনো মডেল কোনো এক সময়ে টেক্সটে হাত দিয়েছে, এর বেশি কিছু নয়। আমাদের গাইড একটি ভুল AI ডিটেকশন ফ্ল্যাগ আপিল করা দেখায়, যখন প্রয়োজন হয় তখন কীভাবে এই যুক্তি উপস্থাপন করবেন।
ওয়াটারমার্ক এবং AI ডিটেক্টর ভিন্ন প্রযুক্তি, ভিন্ন ব্যর্থতার ধরন নিয়ে কাজ করে। Turnitin বা GPTZero-এর মতো ডিটেক্টরগুলো পরিসংখ্যানগত স্টাইল থেকে অনুমান করে, যার যথার্থতা-সংক্রান্ত সমস্যা আমরা নথিভুক্ত করেছি। ওয়াটারমার্ক শনাক্তকরণ হলো কী-ভিত্তিক পরীক্ষা, যাতে অনাহিহ্নিত মানব টেক্সটে মিথ্যা পজিটিভের হার খুব কম। কিন্তু ফালস নেগেটিভের ক্ষেত্রে অসমতা উল্টো হয়ে যায়: কোনো ওয়াটারমার্ক না দেওয়া মডেল থেকে আসা যেকোনো AI টেক্সট মিস করে, আর আজ এমন মডেলগুলোর মধ্যে ChatGPT অন্তর্ভুক্ত।
প্রকাশ করা আপনার সবচেয়ে শক্তিশালী অবস্থান। ওয়াটারমার্কিং নীরবে AI ব্যবহার করার ঝুঁকি বাড়ায়, আর প্রকাশ করে AI ব্যবহার করা নিরাপদ থাকে, কারণ প্রকাশিত ওয়ার্কফ্লোতে একটি পজিটিভ চিহ্ন থেকে ভয়ের কিছু থাকে না। বেশিরভাগ জার্নাল এবং বিশ্ববিদ্যালয়ের এখন AI ব্যবহারের জন্য স্পষ্ট নীতিমালা আছে; আমাদের AI ব্যবহার নীতি দেখায়, আমাদের নিজস্ব টুলগুলোর ক্ষেত্রে কীভাবে আমরা সেই সীমারেখা টানি, এবং এটি স্বচ্ছ ব্যবহারের জন্য একটি যুক্তিসঙ্গত টেমপ্লেট।
কোনটি টেক্সট ওয়াটারমার্ক সরায়, আর কোনটি সরায় না
লেখা নতুন করে লেখা এটি সরায়; রিফরম্যাটিং এটি সরায় না। কপি করা, পেস্ট করা, ফন্ট বদলানো, ফাইল ফরম্যাটের মধ্যে রূপান্তর করা, এবং অদৃশ্য অক্ষর সরানো সবই পরিসংখ্যানগত ওয়াটারমার্ককে সম্পূর্ণ অক্ষত রাখে, কারণ চিহ্নটি শব্দচয়নের মধ্যে থাকে। এটি সরায় এমন সবকিছুই হলো এমন কোনো পরিবর্তন যা নতুন করে বাক্যগঠন তৈরি করে: গভীর মানব সম্পাদনা, অনুবাদ, বা সত্যিকারের প্যারাফ্রেজ। যেমনটি NeurIPS 2023-এর robustness কাজ এই সিস্টেমগুলোর শিপমেন্টের আগে দেখিয়েছিল।
এখানে উভয় দিকই গুরুত্বপূর্ণ। চিহ্নটি অদৃশ্য হয়ে যাওয়া মানেই লেখাটি আপনার, আর চিহ্নটি টিকে থাকা মানেই লেখাটি আপনার নয়। একটি পুনর্লিখিত AI খসড়াও আপনার প্রতিষ্ঠানের প্রকাশ-সংক্রান্ত নীতিমালার আওতায় পড়ে এমন একটি AI-সহায়তাপ্রাপ্ত নথি। আমাদের AI text humanizer AI-সহায়তাপ্রাপ্ত খসড়াগুলোকে স্বাভাবিক একাডেমিক ভঙ্গিতে পুনর্লিখন করে, এবং যেহেতু এই প্রক্রিয়ায় টোকেন ক্রম পুনরায় তৈরি হয়, পরিসংখ্যানগত চিহ্নগুলো সেটিতে টিকে থাকে না। বিশেষভাবে Claude টেক্সটের ক্ষেত্রে, claude ওয়াটারমার্ক অপসারণকারী প্রতিটি বাক্যকে নতুনভাবে ভাষান্তর করে আবার প্রকাশ করে, তবে তথ্য, সংখ্যা এবং উদ্ধৃতিগুলো অপরিবর্তিত রাখে। কোনো টুল যা বদলাতে পারে না তা হলো আপনি আপনার পাঠকের কাছে কী দেন: নথিটি কীভাবে তৈরি হয়েছে সে বিষয়ে স্বচ্ছতা।
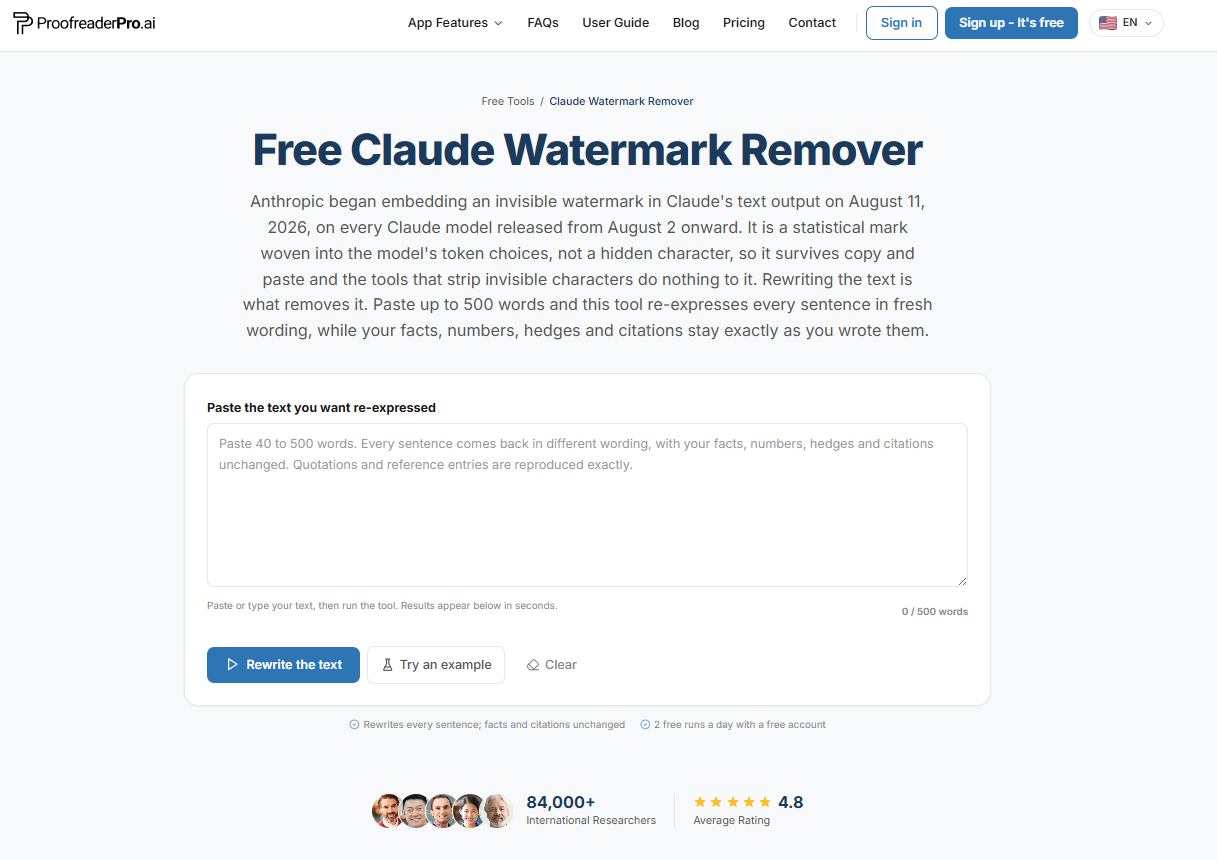
পুনর্লিখনই একমাত্র এমন কাজ যা একটি পরিসংখ্যানগত চিহ্ন সরিয়ে দেয়, এবং এটিই এই টুলটি বাক্য ধরে ধরে করে।
এর পর এটি কোথায় যায়
২০২৭ পর্যন্ত তিনটি বিষয় নজরে রাখুন। প্রথমত, OpenAI কি EU-এর বাইরে textGrain নিয়ে যায় কি না: এটি শুরু হয়েছিল সেখানে, কারণ EU-এর Article 50 প্রয়োগে AI টেক্সটে এমন চিহ্ন দরকার যা মেশিন-পাঠযোগ্য। দ্বিতীয়ত, ডিটেক্টরগুলো কি একত্রে (কনভার্জ) আসছে কি না। যদি প্রতিটি বড় গবেষণাগার প্রকাশিত একটি স্কিম অনুযায়ী ওয়াটারমার্ক করে, তাহলে বিশ্ববিদ্যালয়গুলো লেখার ধরণ দেখে আন্দাজ না করে কীগুলো যাচাই করতে পারবে, যা আজকের 2026 সালে AI ডিটেক্টর কতটা নির্ভুল? পরীক্ষিত নির্ভুলতা ও false positive এর তুলনায় উন্নতি ঘটাবে। তৃতীয়ত, চিহ্নগুলো কি সামঞ্জস্যপূর্ণ হয়ে উঠছে কি না। আজ তিনটি গবেষণাগার তিন ধরনের আলাদা চিহ্ন ব্যবহার করে, এবং এমন কোনো একক যাচাই নেই যা সবগুলোকে কভার করে। ফাইলের ক্ষেত্রে C2PA এই ফাঁক পূরণ করে; কিন্তু কাঁচা টেক্সটের ক্ষেত্রে এখনো কোনো কিছুর সমাধান নেই।
ChatGPT কি তার টেক্সটে ওয়াটারমার্ক দেয়?
হ্যাঁ, আংশিকভাবে, ৫ অক্টোবর ২০২৬ থেকে। OpenAI ইউরোপীয় ইউনিয়নে যোগ্য ChatGPT এবং Codex টেক্সটে তার textGrain ওয়াটারমার্ক যুক্ত করা শুরু করে, এবং যেকোনো স্থানের API গ্রাহকরা এটি চালু করতে পারেন। এই ওয়াটারমার্ক শব্দচয়নে একটি পরিসংখ্যানগত সংকেত, এতে কোনো লুকানো অক্ষর নেই। OpenAI DALL-E এবং Sora মিডিয়া ফাইলে আলাদা ফাইল-লেভেল সিস্টেম হিসেবে C2PA provenance মেটাডেটাও প্রয়োগ করে।
Google Gemini কি তার টেক্সটে ওয়াটারমার্ক দেয়?
হ্যাঁ। Gemini-এর আউটপুটে ২০২৪ সালের অক্টোবর থেকে Google DeepMind-এর SynthID-Text ওয়াটারমার্ক আছে। এটি শব্দচয়নে একটি পরিসংখ্যানগত চিহ্ন, পাঠকদের কাছে অদৃশ্য, এবং Google-এর SynthID Detector দিয়ে যাচাইযোগ্য। এটি কেবল Google-এর নিজস্ব মডেলগুলোর জন্য প্রযোজ্য, তাই কোনো SynthID ফলাফল নেগেটিভ হলে তা অন্যান্য AI সিস্টেমের টেক্সট সম্পর্কে কিছু বলে না।
Claude কি তার টেক্সটে ওয়াটারমার্ক দেয়?
হ্যাঁ। ২ আগস্ট ২০২৬ তারিখে বা তার পরে চালু হওয়া প্রতিটি Claude মডেল তার টেক্সট আউটপুটে একটি পরিসংখ্যানগত ওয়াটারমার্ক এম্বেড করে, সব প্ল্যাটফর্ম ও সব প্ল্যানে, এবং কোনো opt-out নেই। এছাড়া Claude-generated ফাইলগুলোতে অতিরিক্তভাবে C2PA মেটাডেটাও থাকে। ওই তারিখের আগে চালু হওয়া মডেলগুলো এখনো তাদের আউটপুটে চিহ্ন দেয় না; Anthropic বলছে ট্রানজিশন পিরিয়ডের মধ্যে এগুলোর জন্য marking সাপোর্ট যোগ করছে। সম্পূর্ণ বিস্তারিত আমাদের Claude watermark explainer-এ আছে।
বিশ্ববিদ্যালয় কি AI ওয়াটারমার্ক শনাক্ত করতে পারে?
শুধুমাত্র বিক্রেতার সহযোগিতার মাধ্যমেই, কারণ শনাক্তকরণে বিক্রেতার কী দরকার। SynthID কনটেন্টের জন্য Google একটি পাবলিক ডিটেক্টর পোর্টাল দেয়। Anthropic বলছে ব্যবহারকারী এবং তৃতীয় পক্ষের জন্য ডিটেকশন সাপোর্ট পরিকল্পিত, তবে এখনো কোনো পাবলিক ডিটেক্টর প্রকাশ করেনি। বর্তমানে কোনো মূলধারার প্ল্যাজিয়ারিজম স্যুট কোনো গবেষণাগারের পরিসংখ্যানগত ওয়াটারমার্ক যাচাই করতে পারে না, তাই প্রতিষ্ঠানের আজকের "AI detection" এখনও মূলত লেখার ধরণভিত্তিক অনুমানই, ওয়াটারমার্ক যাচাই নয়।
আইন অনুযায়ী কি AI ওয়াটারমার্কিং বাধ্যতামূলক?
ইইউ-তে কার্যকরভাবেই আছে। ইইউ AI আইনের ধারা ৫০(২) অনুযায়ী জেনারেটিভ AI সেবা প্রদানকারীদের নিশ্চিত করতে হবে যে আউটপুটগুলো এমন একটি মেশিন-পাঠযোগ্য ফরম্যাটে চিহ্নিত হয় এবং কৃত্রিমভাবে তৈরি হিসাবে শনাক্তযোগ্য থাকে। স্বচ্ছতা সংক্রান্ত বাধ্যবাধকতাগুলো কার্যকর হবে ২ আগস্ট, ২০২৬ থেকে। Anthropic সংশ্লিষ্ট Code of Practice স্বাক্ষর করেছে এবং বিশ্বব্যাপী মানদণ্ড মেনে চলার সিদ্ধান্ত নিয়েছে। ২০২৭ সালে OpenAI-এর অপ্রকাশিত টেক্সট ওয়াটারমার্ককে নিয়ন্ত্রকরা কীভাবে দেখবে, সেটাই লক্ষণীয় প্রশ্ন।
AI ওয়াটারমার্ক কি অনুবাদ টিকে থাকে?
না। একটি পরিসংখ্যানভিত্তিক ওয়াটারমার্ক থাকে মডেল যে নির্দিষ্ট শব্দের ক্রম বেছে নিয়েছে সেই সিকোয়েন্সের মধ্যে, আর অনুবাদ প্রতিটি শব্দ বদলে দেয়। গভীর প্যারাফ্রেজিং এবং কঠোর মানবসম্পাদনার ক্ষেত্রেও একই কথা সত্য। এই সীমাবদ্ধতাটি peer-reviewed গবেষণালেখায় নথিভুক্ত করা হয়েছে এবং ওয়াটারমার্ক যুক্ত করে যে প্রতিটি বিক্রেতা পণ্য বাজারে আনে তারা সেটি স্বীকার করে।
টেক্সটের জন্য কি কোনো পাবলিক OpenAI ওয়াটারমার্ক যাচাইকারী আছে?
না। OpenAI-এর পাবলিক ভেরিফিকেশন টুল শুধু চিত্র ও অডিও ফাইল পরীক্ষা করে, C2PA মেটাডেটা এবং SynthID ওয়াটারমার্কের ক্ষেত্রে। OpenAI বলেছে যে এটি টেক্সট সমর্থন করে না। টেক্সট ওয়াটারমার্ক শনাক্তকরণ টুলটি কেবল অনুমোদিত গবেষক এবং বিশেষজ্ঞ সংস্থাগুলোর জন্য, ক্ষেত্রবিশেষে।
textGrain কী?
textGrain হলো OpenAI-এর টেক্সট ওয়াটারমার্ক, যা ৫ অক্টোবর, ২০২৬ তারিখে ঘোষণা করা হয়। এটি মডেলের শব্দ নির্বাচনে একটি অদৃশ্য পরিসংখ্যানভিত্তিক সংকেত যোগ করে, ফলে এই চিহ্নটি শব্দের অংশ হয়ে যায়, কোনো গোপন অক্ষর বা ফাইল মেটাডেটা ছাড়াই। OpenAI বলেছে যে তারা যে অন্যান্য পদ্ধতিগুলো পরীক্ষা করেছে, সেগুলোর তুলনায় এটি মিলেছে বা ভালো করেছে, যার মধ্যে টেক্সটের জন্য SynthID-ও আছে। এছাড়া তাদের দাবি, সম্পাদনা এটিকে দুর্বল করে দেয়।
গবেষকরা কি OpenAI-এর টেক্সট ওয়াটারমার্ক শনাক্তকারী ব্যবহারের জন্য আবেদন করতে পারেন?
হ্যাঁ। অনুমোদিত গবেষক এবং বিশেষজ্ঞ সংস্থাগুলো OpenAI-এর Content Provenance API ফর্মের মাধ্যমে আবেদন করতে পারে। Code of Practice-এর ইইউ সংস্করণের অধীনে OpenAI ক্ষেত্রবিশেষে অ্যাক্সেস প্রদান করে। তারা বলেছে, প্রযুক্তি ও প্রমাণ সামনে এগোলে আরও ব্যাপক অ্যাক্সেস পুনর্বিবেচনা করবে।
উৎসসমূহ
- Anthropic, Claude-এর টেক্সট ওয়াটারমার্ক কীভাবে কাজ করে, আগস্ট ২০২৬
- Anthropic Help Center, Claude কীভাবে AI-উৎপাদিত কনটেন্ট চিহ্নিত করে, ২০২৬
- OpenAI, অনলাইনে আমরা যা দেখি এবং শুনি তার উৎস বোঝা, মে ২০২৪
- Google DeepMind, SynthID
- Dathathri প্রমুখ, বড় ভাষা মডেল আউটপুট শনাক্তকরণের জন্য Scalable ওয়াটারমার্কিং, Nature, অক্টোবর ২০২৪
- Google, SynthID Detector ঘোষণা, মে ২০২৫
- Hugging Face, Introducing SynthID Text, অক্টোবর ২০২৪
- Kirchenbauer প্রমুখ, বড় ভাষা মডেলের জন্য একটি Watermark, ICML ২০২৩
- Krishna প্রমুখ, Paraphrasing কীভাবে AI-Generated টেক্সটের শনাক্তকরণ এড়ায়, NeurIPS ২০২৩
- Scott Aaronson, UT Effective Altruism-এর জন্য আমার AI Safety Lecture, নভেম্বর ২০২২
- ইউরোপীয় ইউনিয়ন, AI Act, ধারা ৫০
- C2PA, কনসোর্টিয়াম ফর কনটেন্ট প্রোভেন্যান্স অ্যান্ড অথেন্টিসিটি
ডানা ProofreaderPro-এর একজন বিষয়বস্তু নির্মাতা, যেখানে তিনি দৈনিক ব্লগ এবং লেখার কাজ চালান। অনলাইন এডিটিং প্ল্যাটফর্ম কীভাবে কাজ করে সে বিষয়ে তিনি নিবন্ধগুলি লেখেন এবং তিনি প্রতিদিন গ্রাহকের বার্তাগুলি পরিচালনা করেন, এটি দেখানোর জন্য একটি ফাইভ-স্টার সন্তুষ্টি স্কোর সহ।