
ইংরেজিতে লেখারত ইউক্রেনীয় গবেষকদের জন্য AI হিউম্যানাইজার
ইউক্রেনীয় গবেষকদের জন্য AI হিউম্যানাইজার। ইউক্রেনীয় ও রুশি-প্রভাবিত ইংরেজিতে ভুল AI-ডিটেকশন সতর্কতা কমান, অর্থ ও উদ্ধৃতি অক্ষুণ্ণ রাখুন, এবং সৎভাবে ব্যবহার প্রকাশ করুন।

ইউক্রেন এমন পরিস্থিতিতেও নিয়মিতভাবে গুরুত্বপূর্ণ বিজ্ঞান উৎপাদন করে যাচ্ছে, যেখানে বেশির ভাগ গবেষণা ব্যবস্থাই স্থবির হয়ে পড়ত। পদার্থবিজ্ঞানী, গণিতবিদ, উপাদান বিজ্ঞানী এবং প্রকৌশলীরা জমা দিতে থাকেন, আর জাতীয় নীতি সবাইকে এমন জার্নালে প্রকাশে ঠেলে দেয় যেগুলো Web of Science এবং Scopus-এ সূচিবদ্ধ। বাস্তবে এর অর্থ একটাই: আপনি ইংরেজিতে লেখেন, আপনি যে ভাষাটিকে ভাবেন সেটি ইংরেজি হোক বা না হোক।
ইউক্রেনীয় গবেষকদের জন্য একটি AI হিউম্যানাইজার ঠিক এই ফাঁদে সহায়তা করার উদ্দেশ্যেই তৈরি। একজন যত্নশীল গবেষক পরিষ্কার, মানসম্মত ইংরেজি লেখেন, খসড়াটি একটি AI চেকারের মধ্য দিয়ে চালান, এবং দেখেন তা ফেরত আসে, মেশিন-লিখিত হিসেবে চিহ্নিত। কিছুই জাল করা হয়নি। গদ্যটি কেবল অতিরিক্ত নির্ভুল ছিল। টুলটি আপনার অর্থ, পরিভাষা এবং উদ্ধৃতি অক্ষুণ্ণ রাখে; একই সঙ্গে এমনভাবে অ-নেটিভ লেখাকে উপস্থাপন করে যেন তা সত্যি একজন মানুষ যেমন লিখতেন, তেমনই পড়ে। জীবন বিজ্ঞানী ও চিকিৎসকদের ক্ষেত্রেও একই দেয়াল।
অধিকাংশ ইউক্রেনীয় গবেষক দ্বিভাষিক, ইউক্রেনীয় ও রুশির মধ্যে যাতায়াত করেন, আর দুটি ভাষাই ইংরেজি গদ্যে একই ধরনের ছাপ ফেলে। এই ছাপগুলো কোনো ভুল নয়। এগুলো এমন লেখকের চিহ্ন, যিনি স্লাভিক ব্যাকরণ মাধ্যমে ইংরেজি শিখেছেন, এবং বিদ্রূপের বিষয় হলো, আপনি যত বেশি সেই ইংরেজিটাকে পরিস্কার করেন, ডিটেক্টর তত বেশি সেটিকে ভুলভাবে ব্যাখ্যা করার সম্ভাবনা বাড়ে।
Гуманізація AI-тексту для українських дослідників
আমাদের AI-текст гуманізація ইউক্রেনীয় বিজ্ঞানীদের আত্মবিশ্বাসের সাথে ইংরেজিতে প্রকাশ করতে সহায়তা করে, বিষয়বস্তু ও রেফারেন্স অক্ষুণ্ণ রেখে। Whether your first language is Ukrainian or Russian, the goal is the same: prose that keeps your argument exactly as you meant it, but no longer trips a detector trained mostly on native English.
আমরা আমাদের হিউম্যানাইজারটি এমন গবেষকদের জন্য তৈরি করেছি যারা বাস্তবে কাজ করেন এবং চান এটি ন্যায্যভাবে পড়া হোক। আপনি বিজ্ঞানটি খসড়া করেন। টুলটি বাক্যের ছন্দ ও শব্দচয়ন বদলায়, যন্ত্রের সঙ্গে যে ক্যাডেন্স বেশি দেখা যায় সেটি মসৃণ করে, এবং আপনাকে এমন লেখা দেয় যা ঠিক আপনি যা বলেছেন তা-ই বলে, কেবল এমন এক কণ্ঠে, যা পড়তে গিয়ে মানুষ-লেখা বলেই মনে হয়।
ইউক্রেনীয় ভাষায় লিখছেন? এটি স্বয়ংক্রিয়ভাবে শনাক্ত হয়ে নেটিভভাবে হিউম্যানাইজ করা হয়
অনেক ইউক্রেনীয় গবেষক ইংরেজিতে লেখার আগে ইউক্রেনীয় ভাষায় খসড়া করেন, এবং হিউম্যানাইজার সেটি সরাসরি সামলে নেয়। ইউক্রেনীয় লেখা পেস্ট করুন, ProofreaderPro সিরিলিক স্ক্রিপ্ট চিনে নেয় এবং সেটিকে রুশি থেকে আলাদা করে; এরপর এটি এমন একটি language-aware মডেলের মাধ্যমে প্রক্রিয়াজাত করে যা আপনার পরিভাষা ও উদ্ধৃতি ঠিক যেমন লেখা আছে তেমনই ধরে রাখে। Through гуманізація AI-тексту আপনার ইউক্রেনীয় খসড়াটি প্রথমে কোনো অনুবাদ ছাড়াই, ইংরেজির মতোই সহজে humanized হয়। একই ডিটেকশন চল্লিশেরও বেশি ভাষায় বিস্তৃত, প্রতিটি ভাষাই তার নিজস্ব কণ্ঠে পুনর্লিখিত হয়।
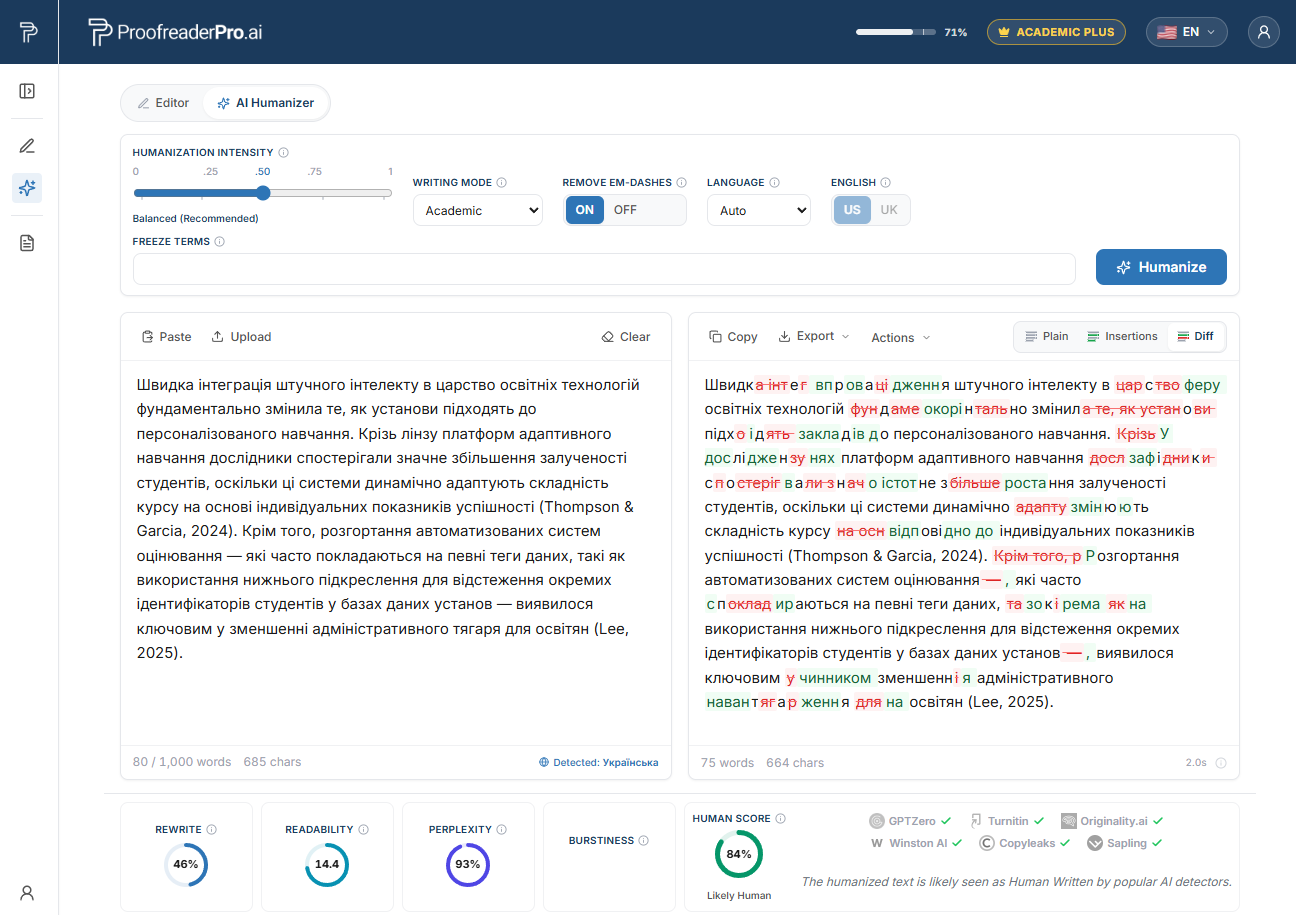
ইউক্রেনীয় একাডেমিক লেখা পুনর্লিখনে ProofreaderPro AI Humanizer। before and after diff আপনার অর্থ ও উদ্ধৃতি ধরে রাখে, এবং detector checks নিশ্চিত করে যে এটি স্বাভাবিকভাবে মানুষ-লেখা পাঠ।
কেন ইউক্রেনীয় গবেষকদের AI ডিটেক্টর সতর্ক করে
সবচেয়ে পরিষ্কার প্রমাণ আসে ২০২৩ সালের স্ট্যানফোর্ডের এক গবেষণা থেকে, যার নেতৃত্বে ছিলেন Weixin Liang এবং সহকর্মীরা; এটি Cell Press জার্নাল Patterns-এ প্রকাশিত। দলটি সাতটি বহুল ব্যবহৃত AI ডিটেক্টরে মানব-লিখিত TOEFL প্রবন্ধ চালায়। গড়ে, নন-নেটিভ প্রবন্ধগুলোর প্রায় ৬১% AI-generated হিসেবে চিহ্নিত হয়; নেটিভ ইংরেজি লেখকদের ক্ষেত্রে তা প্রায় ৫%। প্রায় প্রতি পাঁচটির মধ্যে একটিতে, অর্থাৎ নন-নেটিভ প্রবন্ধগুলোর প্রায় ১৯.৮%, সবগুলো ডিটেক্টরই একমতভাবে সতর্ক করে। প্রতিটি প্রবন্ধই একজন মানুষের লেখা।
এটা কেন ঘটে? অনেক ডিটেক্টর এমন একটি মানকে স্কোর করে, যাকে perplexity বলা হয়, এটি প্রতিটি পরবর্তী শব্দ ভাষা মডেলের কাছে কতটা “সারপ্রাইজিং”, তা মাপে। আপনি যখন দ্বিতীয় ভাষায় সতর্কভাবে লেখেন, তখন আপনি সাধারণ শব্দ এবং নিরাপদ, পূর্বানুমানযোগ্য বাক্যবিন্যাসের দিকে ঝুঁকেন। এতে perplexity কমে, আর কম perplexity-ই ডিটেক্টররা ঠিক মেশিন-লিখিত হিসেবে পড়ে। ইউক্রেনীয়-ইংরেজিকে পরিষ্কার ও সঠিক করে তোলে যে অভ্যাসগুলো, সেই অভ্যাসগুলোকেই এই সিস্টেমগুলো সন্দেহ করতে শিখেছে।
অতএব ফ্ল্যাগটি আপনার সততার বিরুদ্ধে কোনো রায় নয়। এটি টুলটি যেভাবে কাজ করে, তার একটি পরিসংখ্যানগত ফল, এবং আমরা why AI detectors flag non-native writing অংশে মেকানিজমটি আরও গভীরভাবে ব্যাখ্যা করি। এটি জানলে লাল স্কোরকে কীভাবে ধরবেন সেটিও বদলায়: এটিকে “প্রমাণ করার মতো দাবি” হিসেবে দেখুন, “স্বীকারোক্তি” হিসেবে নয়।
মিথ্যা ফ্ল্যাগের পেছনে ইউক্রেনীয় ও রুশি প্রথম-ভাষার প্যাটার্ন
স্লাভিক ব্যাকরণ ইংরেজির থেকে কয়েকটি গঠনগতভাবে আলাদা, এবং প্রতিটি পার্থক্য আপনার ইংরেজিকে সেই সমতল, পূর্বানুমানযোগ্য ভঙ্গির দিকে ঠেলে দেয়, যেটিকে ডিটেক্টররা শাস্তি দেয়। এর কোনোটাই ভুল নয়। এগুলো যত্নসহকারে গঠিত নির্মাণ, এবং তাদের অত্যন্ত মানসম্মত হওয়াই সমস্যার জায়গা।
No articles. ইউক্রেনীয় বা রুশি, কোনোটাতেই "the" বা "a" নেই, ফলে ইংরেজি আর্টিকেল বাদ পড়ে, যোগ হয়, বা ভুলভাবে বসানো/নতুন করে নির্ধারিত হয় ("result was significant", "we studied the influence of the temperature")। সম্পাদক যখন এগুলো ঠিক করেন, তখন সংশোধিত বাক্যগুলো আরও মসৃণ ও সাধারণ (generic) হয়ে ওঠে, যা কম perplexity হিসেবে পড়ে।
Aspect instead of tense. স্লাভিক ব্যাকরণ সময়সূচক tense সিস্টেমের বদলে perfective ও imperfective aspect-এর চারপাশে তৈরি; ফলে perfect ও simple past-এর মধ্যে বেছে নেওয়া প্রায়ই অসঙ্গত দেখা দেয়। এটি ঠিক করলে সাধারণত ছোট, পাঠ্যবই-ধাঁচের (textbook-plain) বাক্য তৈরি হয়।
Flexible word order. ইউক্রেনীয় ও রুশিতে case ending-গুলো অর্থ বহন করে, ফলে শব্দ বিন্যাস স্বাধীনভাবে নড়াচড়া করতে পারে। ইংরেজিতে স্থানান্তরিত হলে information structure একটু অস্বাভাবিকভাবে বসে, এবং সবচেয়ে নিরাপদ সংশোধন হলো সবচেয়ে প্রচলিত বিন্যাস, যেটি আবার সবচেয়ে মেশিন-সদৃশও।
Countable and uncountable nouns. "informations", "researches", "an equipment", এবং "evidences"-এর মতো ফর্মগুলো উৎস ভাষাগুলোর প্রভাব থেকে স্বাভাবিকভাবেই আসে। সংশোধিত হলে এগুলো স্ট্যান্ডার্ড mass-noun বাক্যবিন্যাসে গিয়ে পড়ে, যেটি প্রশিক্ষণের লক্ষ লক্ষ উদাহরণে দেখা যায়।
Preposition transfer and the missing auxiliary. ভাষাগুলোর মধ্যে preposition-এর মানচিত্র ভিন্নভাবে কাজ করে, এবং ইংরেজি সহায়ক ক্রিয়া "do/does"-এর সরাসরি সমতুল্য নেই, ফলে সম্পাদনার সময় উভয়ই আবার সবচেয়ে মানানসই, সবচেয়ে সহজ ফর্মে মানকায়িত হয়।
Transliteration. সিরিলিক থেকে আসা নাম ও কারিগরি পরিভাষা প্রচলিত ইংরেজি বানানে নিয়মিতভাবে রূপ নেয়, এটি আরও এক ধাপ, যা একরূপতার দিকে নিয়ে যায়। এগুলো সব মিলিয়ে আপনি পান পরিষ্কার, সঠিক, কম-ভ্যারিয়েন্স গদ্য: ঠিক সেই প্রোফাইল, যা ডিটেক্টররা কৃত্রিম হিসেবে স্কোর করে।
ইউক্রেনের AI-ডিটেকশন ও Turnitin প্রেক্ষাপট
ইউক্রেনীয় উচ্চশিক্ষায় similarity screening নিয়মিত চর্চা, এবং এখন তার ওপর AI screening যুক্ত হচ্ছে। অনেক বিশ্ববিদ্যালয় Unicheck চালায়, যা আসলে ইউক্রেনেই তৈরি হয়েছিল এবং এখন Turnitin-এর অংশ, যখন অন্যরা StrikePlagiarism ব্যবহার করে। আপনি যদি থিসিস বা পান্ডুলিপি জমা দেন, ধরে নিন এটি মানুষের ঘনিষ্ঠভাবে পড়ার আগে এদের অন্তত একটির মধ্য দিয়ে যাবে।
শিক্ষা ও বিজ্ঞান মন্ত্রণালয় (MES) এবং বিভিন্ন প্রতিষ্ঠান একাডেমিক-ইনটেগ্রিটি ও AI সংক্রান্ত নির্দেশনা দিয়েছে; সামগ্রিক দিকনির্দেশ হলো নিষেধ নয়, বরং প্রকাশ (disclosure)। অর্থদাতা ও জার্নালগুলো ক্রমেই জানতে চায়, পেপার প্রস্তুতে আপনি কখন এবং কীভাবে AI ব্যবহার করেছেন।
সৎভাবে এগোলে এই পরিস্থিতি সামাল দেওয়া যায়। হিউম্যানাইজ করার উদ্দেশ্য কখনো AI ব্যবহার লুকানো বা Unicheck-কে ফাঁকি দেওয়া নয়। লক্ষ্য হলো টুলিংয়ের একটি fairness gap যেন প্রকৃত কাজকে শাস্তি না দেয়; তারপর বিশ্ববিদ্যালয় ও লক্ষ্য জার্নাল যেভাবে চায় ঠিক সেভাবেই আপনার AI ব্যবহার প্রকাশ করা।
আপনার ইউক্রেনীয় গবেষণা ন্যায্য ইংরেজিতে প্রকাশ করুন
আপনার নিজস্ব AI-সহায়তাপ্রাপ্ত খসড়াটিকে মানবসুলভ করুন, আপনার অর্থ এবং উদ্ধৃতি বজায় রাখুন, তারপর আত্মবিশ্বাসের সাথে আপনার AI ব্যবহার প্রকাশ করুন।
Humanizer ফ্রি করে দেখুনশীর্ষস্থানীয় ইউক্রেনীয় বিশ্ববিদ্যালয়সমূহ এবং কোথায় AI চেক দেখা যায়
নিচের প্রতিষ্ঠানগুলো থিসিস ও পান্ডুলিপি similarity-এর জন্য স্ক্রিন করে এবং ক্রমেই AI সূচককেও বেশি গুরুত্ব দেয়। আপনি যদি এদের কোনো একটিতে কাজ করেন বা পড়াশোনা করেন, তবে similarity ও AI চেক, একটি defended থিসিস বা জমা দেওয়া পেপারের স্বাভাবিক পথে অংশ।
- Київський національний університет імені Тараса Шевченка (Taras Shevchenko National University of Kyiv), Kyiv
- Національний технічний університет України «Київський політехнічний інститут імені Ігоря Сікорського» (Igor Sikorsky Kyiv Polytechnic Institute, KPI), Kyiv
- Харківський національний університет імені В. Н. Каразіна (V. N. Karazin Kharkiv National University), Kharkiv
- Львівський національний університет імені Івана Франка (Ivan Franko National University of Lviv), Lviv
- Національний університет «Львівська політехніка» (Lviv Polytechnic National University), Lviv
- Сумський державний університет (Sumy State University), Sumy
- Національний університет «Києво-Могилянська академія» (National University of Kyiv-Mohyla Academy), Kyiv
- Дніпровський національний університет імені Олеся Гончара (Oles Honchar Dnipro National University), Dnipro
এই বিশ্ববিদ্যালয়গুলো জুড়ে ওয়ার্কফ্লোটা প্রায় একই রকম: আপনার খসড়া একটি automated চেকের সাথে প্রথম দেখা করে, তারপর তা কমিটির কাছে পৌঁছায়। এই চেকটি আসলে কী মাপে, তা বোঝাই আপনাকে আতঙ্ক না ছড়িয়ে ফ্ল্যাগের জবাব শান্তভাবে দিতে সক্ষম করে।
ইউক্রেনীয় গবেষকদের জন্য AI হিউম্যানাইজার কীভাবে কাজ করে
সৎ ওয়ার্কফ্লোতে চারটি ধাপ আছে, এবং disclosure সেটারই অংশ, শেষ মুহূর্তের চিন্তা নয়।
প্রথমে, আপনার বিজ্ঞানটি খসড়া করুন। অনেক ইউক্রেনীয় গবেষক আগে ইউক্রেনীয় বা রুশিতে যুক্তিটি ভেবে নেন, তারপর অনুবাদ করেন, এটি সম্পূর্ণ ঠিক। পড়তে কেমন হবে সেটি নিয়ে দুশ্চিন্তা করার আগে যুক্তিটা ঠিক করুন।
দ্বিতীয়ত, ব্যাকরণ প্রুফরিড করুন যাতে ইংরেজি সঠিক হয় এবং আপনার পরিভাষা সামঞ্জস্যপূর্ণ থাকে। পরিষ্কার ব্যাকরণ আর প্রাকৃতিক কণ্ঠ, দুটি আলাদা বিষয়, আর আপনি দুটোই চান।
তৃতীয়ত, আপনার নিজের AI-assisted prose-টি text humanizer দিয়ে চালান। এটি বাক্যের ছন্দ ও শব্দচয়নে ভিন্নতা আনে, যন্ত্রের তৈরি এবং ভারীভাবে-সম্পাদিত দ্বিতীয়-ভাষার লেখায় যে পুনরাবৃত্তিমূলক cadence সাধারণত থাকে তা সরায়, এবং অযথা em dash-গুলো বাদ দেয়—তার সবই আপনার অর্থ, আপনার টেকনিক্যাল ভোকাবুলারি, এবং প্রতিটি উদ্ধৃতি সংরক্ষণ করে। যেহেতু আমাদের হিউম্যানাইজার ৬০টিরও বেশি ভাষা সমর্থন করে, তাই নন-ইংরেজি টেক্সট একটি language-aware মডেলের মাধ্যমে রাউট হয়, যা বাক্যগঠন ও অর্থ অক্ষুণ্ণ রাখে, সেগুলোকে গেঁজানোভাবে বিকৃত না করে।
ফল থেকে আপনি কী আশা করতে পারেন? আমাদের নিজস্ব পরীক্ষায় দেখা গেছে, humanizing উল্লেখযোগ্যভাবে কমায়, কত ঘনঘন যত্নসহকারে লেখা, মানসম্মত নন-নেটিভ ইংরেজি বড় ডিটেক্টরগুলো ভুলভাবে পড়ে; এর মধ্যে আছে Turnitin, Originality.ai, এবং GPTZero, আর আপনার একাডেমিক অর্থ ঠিকই থাকে। আমরা একে বলি যা পরীক্ষায় আমরা দেখেছি; এটি কোনো প্রতিশ্রুতি নয়। ডিটেক্টরগুলো কয়েক মাস পরপর নতুন করে শিখে, এবং কোনো সৎ টুল ১০০% undetectable হওয়ার দাবি করতে পারে না। যারা ভিন্নভাবে গ্যারান্টি দেয়, তারা আপনাকে এমন নিশ্চয়তা বিক্রি করছে যা বাস্তবে নেই।
চতুর্থত, disclosure দিন। আপনার প্রতিষ্ঠান ও জার্নাল যেভাবে চায় ঠিক সেই ফরম্যাটে একটি AI-use বিবৃতি যোগ করুন, যাতে আপনার কাজটি স্পষ্টভাবে integrity rules-এর মধ্যেই থাকে। এখানেই আসল উদ্দেশ্য: আপনি সত্যিকারের গবেষণাকে কোনো পক্ষপাতদুষ্ট টুলের শাস্তি থেকে রক্ষা করছেন, কোনো কিছু গোপন করছেন না। ইউক্রেন আমাদের multilingual AI humanizer hub-এর একটি ধাপ, এবং আপনার পেপারের যদি পূর্ণাঙ্গ ভাষা সম্পাদনাও প্রয়োজন হয়, আমাদের global academic editing hub প্রক্রিয়ার ওই দিকটা কীভাবে হয় তা দেখিয়ে দেয়।
স্থানীয় অর্থায়ন সংস্থা, জার্নাল, এবং AI-disclosure প্রত্যাশা
ইউক্রেনীয় গবেষণা কয়েকটি কেন্দ্রীয় সংস্থার মাধ্যমে অর্থায়ন ও সংগঠিত হয়। National Research Foundation of Ukraine (NRFU, Національний фонд досліджень України) প্রতিযোগিতামূলক গ্রান্ট পরিচালনা করে। National Academy of Sciences of Ukraine (NAS, НАН України) দেশের জাতীয় ইনস্টিটিউটগুলো তদারকি করে। Ministry of Education and Science (MES) গবেষণা ও প্রকাশনা নীতিমালা নির্ধারণ করে, এর মধ্যে indexed আউটপুটের দিকে চাপও অন্তর্ভুক্ত।
এই চাপটি বাস্তব। জাতীয় নীতি Web of Science এবং Scopus-এ সূচিবদ্ধ জার্নালে প্রকাশকে পুরস্কৃত করে, যা প্রতি বছরই ইংরেজিতে লেখার চাপকে উচ্চ রাখে। আপনি যখন ওই জার্নালগুলো লক্ষ্য করেন, তখন similarity screening-কে নিয়ম হিসেবেই ধরুন এবং জমা দেওয়ার সময় ক্রমবর্ধমান সংখ্যক জার্নাল AI-use disclosure চাইবে, এটাও ধরুন।
সেই প্রত্যাশাকে সরাসরি পূরণ করুন। কী ব্যবহার করেছেন তা বলুন, রেকর্ড পরিষ্কার রাখুন, এবং humanized খসড়াটিকে একটি প্রাকৃতিক কণ্ঠে আপনার নিজস্ব যুক্তি বহন করতে দিন। আপনি কখনো যদি মনে করেন কোনো ফ্ল্যাগ ভুল, তাহলে এটিকে “উত্তর দেওয়ার মতো দাবি” হিসেবে নিন, প্রমাণ দিয়ে জবাব দিতে পারবেন। এরপর প্রত্যাখ্যানের পরে নয়, পরের জমার আগে আবারও text humanizer-এর সাহায্য নিন।
Frequently asked questions
Q: Is using an AI humanizer for Ukrainian researchers considered cheating?
না, যদি আপনি সৎভাবে ব্যবহার করেন। আপনি পক্ষপাতদুষ্ট ডিটেক্টরের হাত থেকে যত্নসহকারে লেখা অ-নেটিভ লেখাকে রক্ষা করতে আপনার নিজের AI-assisted খসড়াকে humanize করছেন, ফলাফল বানিয়ে নেওয়া বা লেখকত্ব গোপন করা নয়। আপনি আপনার অর্থ ও উদ্ধৃতি ঠিক রাখেন, তারপর আপনার বিশ্ববিদ্যালয় ও জার্নাল যেভাবে চায় সেই ফরম্যাটে আপনার AI ব্যবহার disclose করেন।
Q: Will the humanizer change my technical terms or citations?
না। টুলটি আপনার একাডেমিক অর্থ, টেকনিক্যাল পরিভাষা, এবং প্রতিটি রেফারেন্স, ঠিক যেমন আপনি লিখেছেন তেমনই, সংরক্ষণ করার জন্য তৈরি। এটি আপনার কনটেন্টের চারপাশে ছন্দ ও শব্দচয়নে ভিন্নতা আনে; ফলে আপনার পদ্ধতি (methods), পরিভাষা (terms), এবং citation সংখ্যাগুলো অক্ষুণ্ণ থাকে।
Q: Does the гуманізація AI-тексту process work for Russian-speaking Ukrainian researchers too?
হ্যাঁ। ইউক্রেনীয় ও রুশি অনেক ব্যাকরণগত বৈশিষ্ট্যে ভাগ করে নেয়, যা ইংরেজি গদ্যে একই ধরনের ছাপ ফেলে, যেমন আর্টিকেল অনুপস্থিত থাকা এবং aspect-ভিত্তিক ক্রিয়া। humanizer নন-ইংরেজি ও নন-নেটিভ টেক্সটকে language-aware মডেলের মাধ্যমে রাউট করে; তাই দুই ভাষার মধ্যে কোনটি আপনার বেশি শক্তিশালী, তার তোয়াক্কা না করেই এটি সাহায্য করে।
Q: Can any tool guarantee my paper will pass an AI detector?
না, এবং যে কেউ এমন দাবি করে তাকে আপনার অবিশ্বাস করা উচিত। ডিটেক্টরগুলো ক্রমাগত নতুন করে প্রশিক্ষিত হয়, আর কোনো সৎ টুল ১০০% undetectable হওয়ার প্রতিশ্রুতি দিতে পারে না। আমরা যা বলতে পারি তা হলো, আমাদের পরীক্ষায় দেখা গেছে humanizing উল্লেখযোগ্যভাবে কমায় কত ঘনঘন যত্নসহকারে লেখা নন-নেটিভ ইংরেজি ভুলভাবে পড়া হয়; এটি একটি গ্যারান্টির চেয়ে অনেক বেশি ভিন্ন এবং আরও সৎ দাবি।
Q: What should I do if my thesis gets flagged by Unicheck or Turnitin at my university?
স্কোরটিকে রায় নয়, বরং “চ্যালেঞ্জ করার মতো দাবি” হিসেবে ধরুন। আপনার খসড়া ও নোটগুলোকে আপনার প্রক্রিয়ার প্রমাণ হিসেবে সংরক্ষণ করুন; আপনার নিজের লেখাকে humanize করুন যাতে তা স্বাভাবিকভাবে পড়ে; এবং আপনার প্রতিষ্ঠানের নীতিমালা অনুযায়ী আপনার AI ব্যবহার disclose করুন। একটি ডিটেক্টর ফ্ল্যাগ কথোপকথনের শুরু, শেষ নয়।
একটি ভাষা-সচেতন হিউম্যানাইজার, যা আপনার অর্থ, পরিভাষা এবং উদ্ধৃতি বজায় রেখে সতর্কভাবে লেখা অ-স্থানীয় ভাষার গদ্যকে মানবসুলভ হিসেবে পড়তে সহায়তা করে

Moe একজন NLP ইঞ্জিনিয়ার একজন PhD সহ প্রাকৃতিক ভাষা প্রক্রিয়াকরণে। তার গবেষণা কম্পিউটেশনাল ভাষাতত্ত্ব, পাঠ্য বিশ্লেষণ এবং মেশিন লার্নিংকে কভার করে এবং এটি সরাসরি ProofreaderPro-এর পিছনে সম্পাদনা এবং মানবীকরণ মডেলগুলিতে যোগ করে। তিনি প্রক্রিয়াটির অংশ সম্পর্কে লিখেছেন যা বেশিরভাগ লোকেরা কখনই দেখে না: কীভাবে একটি ভাষা মডেল একটি বাক্য পড়ে, স্কোর করে এবং কী পরিবর্তন করতে হবে তা সিদ্ধান্ত নেয়।


