
চেক গবেষকদের জন্য ইংরেজিতে লেখার AI Humanizer
চেক গবেষকদের জন্য AI humanizer। চেক-প্রভাবিত ইংরেজিতে ভুলভাবে AI-ডিটেকশন ফ্ল্যাগ কমান, অর্থ ও উদ্ধৃতি বজায় রেখে, সততার সঙ্গে তা প্রকাশ করুন।

চেকিয়া সক্ষমতার তুলনায় বেশি কাজ করে। পদার্থবিজ্ঞান, রসায়ন, উপকরণ বিজ্ঞান এবং জীবনবিজ্ঞানে একটি শক্ত গবেষণা ভিত্তি থাকা সত্ত্বেও দেশটির আন্তর্জাতিক উপস্থিতি বাস্তব, এর বেশির ভাগই চেক একাডেমি অব সায়েন্সেসের (Czech Academy of Sciences) সঙ্গে দৃঢ়ভাবে সংযুক্ত। এই কাজগুলোর প্রায় সবই ইংরেজিতে বিশ্বে পৌঁছে, যদিও সেগুলোর বেশির ভাগই চেক ভাষায় ভেবে দেখা হয় এবং প্রথম খসড়া চেকেই লেখা হয়।
আপনি যে ভাষায় চিন্তা করেন এবং যে ভাষায় প্রকাশ করেন, এই ভাষাগত ব্যবধানই ঠিক সেখানেই সমস্যার সূচনা করে। চেক গবেষকদের জন্য একটি AI humanizer আছে একটি সরল কারণে: একজন চেক বিজ্ঞানীর যত্নশীল, সঠিক ইংরেজি এখন স্বয়ংক্রিয় ডিটেক্টর দ্বারা যন্ত্র-লেখা হিসেবে ভুল পড়া হচ্ছে। ফলে একটি পরিষ্কার পেপারে একটিমাত্র ভুল ফ্ল্যাগ, যা আপনি বছরের পর বছর গড়েছেন, জমা দেওয়া, গ্রেড, বা সুনাম পর্যন্ত খরচ করে দিতে পারে।
এখন কঠিন অংশটি বলি। যে অভ্যাসগুলো চেক-ইংরেজিকে প্রকাশের জন্য যথেষ্ট পরিষ্কার করে, মানক বাক্যগঠন, প্রচলিত শব্দভাণ্ডার, পূর্বানুমেয় বাক্যরীতি, ঠিক সেই অভ্যাসগুলোকেই একটি AI ডিটেক্টর সন্দেহজনক হিসেবে শিখে নেওয়া হয়েছে।
Humanizace AI textu pro české výzkumníky publikující v angličtině
আমাদের AI textu-এর humanizace চেকের গবেষকদের ইংরেজিতে প্রকাশ করতে সহায়তা করে, যাতে তাদের যত্ন করে লেখা কাজ অন্যায়ভাবে ডিটেক্টরগুলোর কাছে মেশিনের লেখা বলে চিহ্নিত না হয়। লক্ষ্য হলো অর্থ, বৈজ্ঞানিক পরিভাষা এবং উদ্ধৃতিগুলো অক্ষুণ্ণ রাখা।
সোজা কথায়: আমাদের টুলটি এমন ইংরেজিতেই কাজ করে যা আপনি ইতিমধ্যে লিখেছেন বা AI সহায়তায় খসড়া করেছেন; আপনার যুক্তি এবং আপনার রেফারেন্স অক্ষুণ্ণ রাখে, এবং ছন্দকে এমনভাবে পুনর্গঠন করে যাতে একটি ডিটেক্টর সেটিকে ভুলভাবে বিচার করার সম্ভাবনা কম থাকে। এটি এমন বাস্তব গবেষণার জন্য, যা আপনি করেননি, সেসব কাজকে আড়াল করার জন্য নয়। পুরো ম্যানুস্ক্রিপ্টে বিশ্বাস করার আগে আপনি নিজের এক অনুচ্ছেদসহ our humanizer-এ এটি চেষ্টা করে দেখতে পারেন।
চেক ভাষায় লেখা? এটি স্বয়ংক্রিয়ভাবে সনাক্ত হয় এবং সরাসরি মানবিকরণ করা হয়
চেক গবেষকেরা প্রায়ই ইংরেজিতে যাওয়ার আগে তাদের প্রথম ভাষায় খসড়া তৈরি করেন, এবং সেই কারণেই humanizer সেটির জন্যই তৈরি। চেক টেক্সট পেস্ট করুন, ProofreaderPro নিজেই ভাষাটি শনাক্ত করবে, তারপর সেটিকে একটি চেক-সচেতন মডেলের মধ্য দিয়ে প্রক্রিয়াকরণ করবে, যেখানে háček এবং অন্যান্য ডায়াক্রিটিক্স, আপনার পরিভাষা, এবং আপনার উদ্ধৃতিগুলো ঠিক একই জায়গায় থাকে। Through humanizace AI textu আপনার চেক খসড়াটি ঠিক ততটাই সহজে humanize হয় যতটা আপনার ইংরেজি; আগে কিছুই অনুবাদ করা লাগে না। একই শনাক্তকরণ ৬০টিরও বেশি ভাষা জুড়ে কাজ করে, এবং প্রতিটি ভাষায় সেটি সেই ভাষার নিজস্ব ভঙ্গিতে পুনর্লিখিত হয়।
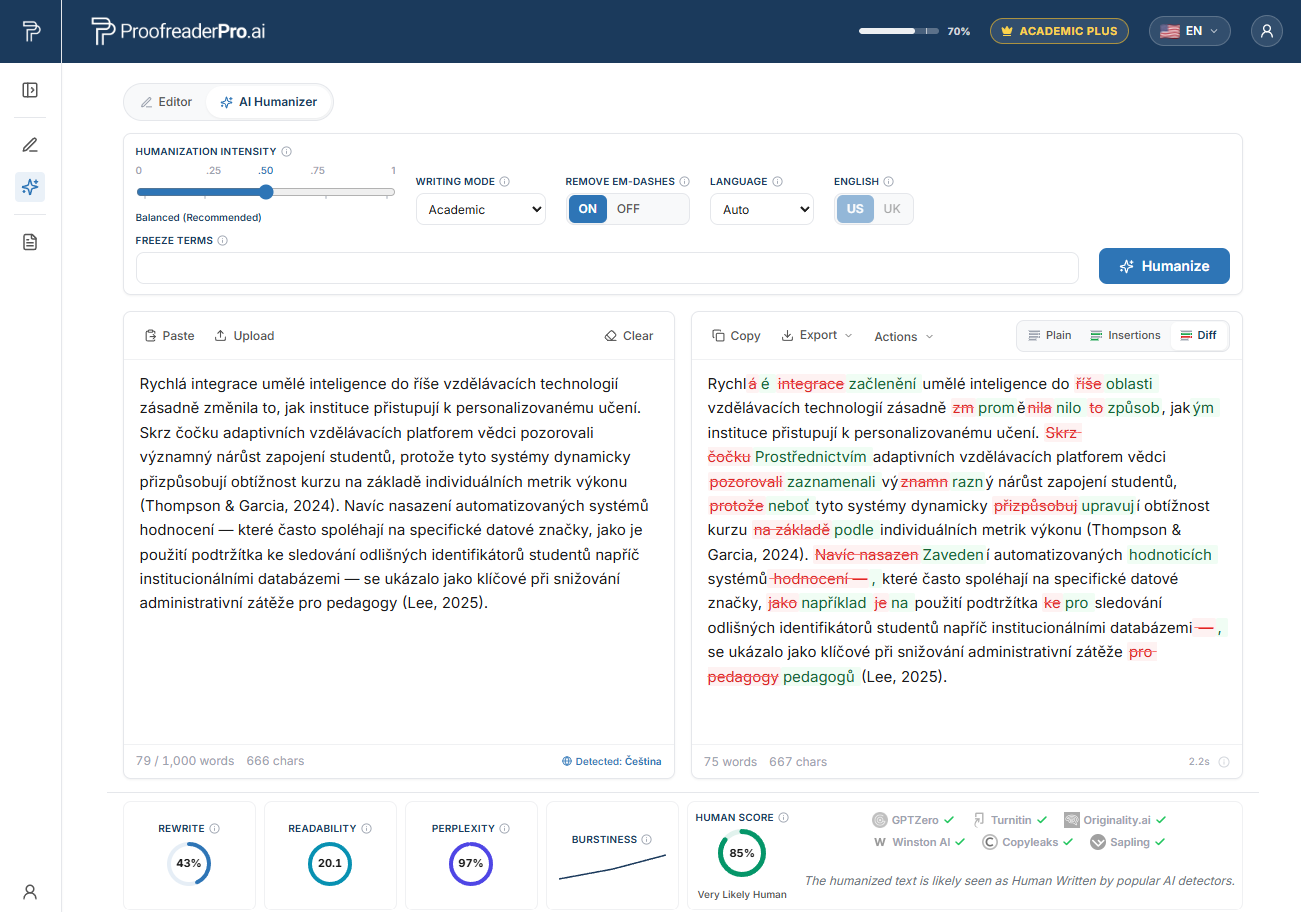
The ProofreaderPro AI Humanizer চেক একাডেমিক টেক্সট পুনর্লিখন করছে। আগে-পরের diff আপনার অর্থ ও উদ্ধৃতি ধরে রাখে, এবং ডিটেক্টর চেকগুলো নিশ্চিত করে যে এটি স্বাভাবিকভাবে মানুষ-লেখা পড়ে।
Why Czech researchers get flagged by AI detectors
২০২৩ সালে, Stanford-এর নেতৃত্বে Weixin Liang-এর একটি দল Cell Press-এর জার্নাল Patterns-এ একটি গবেষণা প্রকাশ করে, যার শিরোনামই সব বলে: "GPT detectors are biased against non-native English writers." গবেষকেরা TOEFL প্রবন্ধ নিয়েছিলেন যেগুলো পুরোপুরি মানুষ লিখেছিল এবং সেটিকে সাতটি বহুল ব্যবহৃত AI ডিটেক্টরের মধ্য দিয়ে চালান।
ফলাফলটি যেকোনো ইংরেজি দ্বিতীয় ভাষা হিসেবে লেখেন, তাঁদের উদ্বিগ্ন করা উচিত। গড়ে, স্থানীয় নন-ইংলিশ প্রবন্ধগুলোর প্রায় ৬১% AI-জেনারেটেড হিসেবে ফ্ল্যাগ হয়েছিল, যেখানে স্থানীয় ইংরেজি বক্তাদের প্রবন্ধে সেটি ছিল প্রায় ৫%। এমনকি নন-নেটিভ প্রবন্ধগুলোর প্রায় প্রতি পাঁচটির মধ্যে একটিতে, প্রায় ১৯.৮%, সবগুলো ডিটেক্টরই একমত হয়ে একইভাবে ফ্ল্যাগ করেছে। এই লেখাগুলোর কোনোটিই কোনো মেশিন লেখেনি।
যে প্রক্রিয়াটিকে বলা হয় তা হলো perplexity। অনেক ডিটেক্টর প্রতিটি শব্দ নির্বাচনে ভাষা মডেলের কাছে কতটা “অপ্রত্যাশিত” তা স্কোর করে। একজন আত্মবিশ্বাসী স্থানীয় লেখক ঝুঁকি নেয়, বাগধারা ব্যবহার করে, এবং এমনভাবে বাক্যগঠন বদলায় যা একটি মডেলের কাছে পূর্বানুমেয় নয়, ফলে সেটি মানুষ-লেখা মনে হয়। একজন যত্নশীল চেক গবেষক উল্টোটা করে: নিরাপদ শব্দ বেছে নেয়, মানক গঠন বেছে নেয়, এবং প্রতিটি ইংরেজি কোর্সে শেখানো বাক্যের কাঠামো ঠিক রেখে বাক্য বানায়। এই সতর্কতা কম perplexity তৈরি করে, এবং কম perplexity-ই ডিটেক্টরকে “মেশিন টেক্সট” হিসেবে পড়তে সাহায্য করে। আমরা পুরো প্রক্রিয়াটি why AI detectors flag non-native writers অংশে ব্যাখ্যা করি।
The Czech first-language patterns behind false flags
চেক এবং ইংরেজি ভিন্ন ব্যাকরণভিত্তিক কাঠামোতে গড়া, এবং যেখানে তারা গরমিল করে, সেই জায়গাগুলোই আপনার ইংরেজিতে দাগ ফেলে। এগুলো চিন্তার ত্রুটি নয়। এগুলো চেক মনের সাবধানে লেখা সতর্ক ইংরেজির পূর্বানুমেয়, মানক চিহ্ন, এবং ঠিক সেই নিয়মিততাই ডিটেক্টরে কম perplexity হিসেবে স্কোর হয়।
Articles that appear and vanish. চেকে কোনো "the" বা "a" নেই। ইংরেজি আর্টিকেলগুলো বাদ পড়ে, যোগ হয়, বা বদলে যায়, তাই আপনি লিখতে পারেন "result was significant" বা "we performed the analysis of the data"। এগুলো একজন এডিটর ঠিক করে দিলে অনেক সময় আশেপাশের বাক্যগুলো আরও বেশি টেক্সটবুক-স্ট্যান্ডার্ড হয়ে যায়, যা আসলে ফ্ল্যাগের ঝুঁকি কমানোর বদলে বাড়ায়।
Aspect standing in for tense. চেক ব্যাকরণে ইংরেজি tense সিস্টেমের চেয়ে নিখুঁত (perfective) ও অসম্পূর্ণ (imperfective) aspect গুরুত্বপূর্ণ। perfect বনাম simple past বেরিয়ে আসে অসামঞ্জস্যপূর্ণভাবে, এবং সংশোধিত সংস্করণটি সাধারণত এমন tense পছন্দের দিকে স্ন্যাপ করে, যা একটি মডেল সবচেয়ে প্রচলিত বলে আশা করে।
Word order that carries emphasis. চেক অর্থের জন্য কেস-এন্ডিং এবং জোরের জন্য শব্দক্রমে ঝোঁকে, তাই ইংরেজির information structure অস্বস্তিকরভাবে ট্রান্সফার হতে পারে। স্ট্যান্ডার্ড subject-verb-object ইংরেজিতে স্মুথ করা হলে বাক্যটি ঠিক সেই unpredictability হারায়, যেটিকে ডিটেক্টর মানুষ-লেখা হিসেবে পড়ে।
Countable nouns that go plural. "Informations", "researches", "an advice", "evidences"। এগুলো চেকে যৌক্তিক এবং চেক-ইংলিশ খসড়ায় সাধারণ। একবার এগুলো ঠিক করা হয়ে গেলে, বাক্যগঠনটি ডিটেক্টর যে রেজিস্টারে প্রশিক্ষিত হয়েছে সেই রেজিস্টারের সঙ্গে সরাসরি মিলে যায়।
Prepositions and missing auxiliaries. প্রিপোজিশনগুলো সরাসরি চেক থেকে ট্রান্সফার হয়, এবং auxiliary "do" বা "does" প্রশ্ন ও নেগেটিভে হারিয়ে যায়। সংশোধন করলে এগুলো পরিষ্কার ও জেনেরিক হয়ে যায়, এটাই ঠিক সেই প্রোফাইল, যেটি কম perplexity হিসেবে পড়ে।
Czechia's AI-detection and Turnitin context
চেকিয়ার থিসিস ও জার্নাল জমা দেওয়া, সেগুলো নিয়মিতভাবে similarity এবং AI-generated টেক্সট, দুটো দিক থেকেই স্ক্রিন করা হয়। অনেক চেক বিশ্ববিদ্যালয় এ জন্য একটি জাতীয় অবকাঠামো শেয়ার করে: Theses.cz এবং Odevzdej.cz সিস্টেম, যা Masarykova univerzita দ্বারা সমন্বিত, এবং তাদের পাশে Turnitinও ব্যাপকভাবে ব্যবহার করা হয়।
চেক প্রতিষ্ঠানগুলো জেনারেটিভ AI সম্পর্কে নিজেদের নির্দেশিকাও দিয়েছে, এবং অগ্রসরতার দিকটি স্পষ্ট: অর্থদাতা ও জার্নাল ক্রমেই আশা করে যে আপনি কীভাবে AI ব্যবহার করেছেন তা প্রকাশ করবেন। এই পরিবেশটি যুক্তিসংগত। সমস্যা প্রকাশ নয়, যা করা সহজ এবং সততাভিত্তিক। আসল সমস্যা হলো ডিটেক্টরের স্কোরকে একটি রায় হিসেবে ধরা, যখন বাস্তবে সেটি একটি পরিসংখ্যানগত অনুমান, যা বেশি করে ভুল করে ঠিক সেই যত্নশীল নন-নেটিভ প্রোজের ক্ষেত্রে, যেটি চেক গবেষকেরাই উৎপাদন করতে প্রশিক্ষিত।
মনে রাখাও সহায়ক যে ডিটেক্টর ভেন্ডররাও ঝুঁকি কমাতে কিছুটা “হেজ” করে। Turnitin কম রেঞ্জে নিজের স্কোর দমন করে এবং সতর্ক করে যে কোনো সংখ্যাকে একা কোনো integrity সিদ্ধান্তে ব্যবহার করা উচিত নয়। Vanderbilt-সহ বেশ কিছু বিশ্ববিদ্যালয় আরও এক ধাপ এগিয়ে নিজেদের AI ডিটেক্টর সম্পূর্ণভাবে বন্ধ করে দেয়, false positive এবং নন-নেটিভ লেখকদের বিরুদ্ধে bias উল্লেখ করে। একটি ফ্ল্যাগ হলো প্রতিদ্বন্দ্বিতা করার দাবি, কোনো স্বীকারোক্তি নয়।
মিথ্যা AI সতর্কবার্তা থেকে আপনার চেক-ইংরেজি লেখাকে সুরক্ষিত রাখুন
আপনার নিজের গবেষণা-ভিত্তিক গদ্যের একটি অনুচ্ছেদ পেস্ট করুন, দেখুন কীভাবে humanizer আপনার অর্থ ও উদ্ধৃতি সংরক্ষণ করে এবং সতর্ক অ-মাতৃভাষার ইংরেজি কোনো ডিটেক্টর ভুলভাবে পড়ার সম্ভাবনা কমায়।
Humanizer ফ্রি করে দেখুনTop Czech universities and where AI checks appear
আপনি যদি চেকিয়ায় পড়েন, শেখান, বা জমা দেন, আপনার কাজ উপরের যেকোনো একটি প্রতিষ্ঠানের মধ্য দিয়ে যাবে, এবং এদের সবকটিই থিসিস ও ম্যানুস্ক্রিপ্টে similarity স্ক্রিন করে, পাশাপাশি ক্রমেই AI সূচকগুলোর ওজন বাড়িয়ে দেয়।
- Univerzita Karlova (Charles University), Prague
- České vysoké učení technické v Praze (ČVUT, Czech Technical University), Prague
- Masarykova univerzita (Masaryk University), Brno
- Univerzita Palackého v Olomouci (Palacký University), Olomouc
- Vysoké učení technické v Brně (VUT, Brno University of Technology), Brno
- Vysoká škola chemicko-technologická v Praze (VŠCHT, University of Chemistry and Technology), Prague
- Vysoká škola báňská, Technická univerzita Ostrava (VŠB-TUO), Ostrava
- Mendelova univerzita v Brně (Mendel University), Brno
- Jihočeská univerzita v Českých Budějovicích (University of South Bohemia), České Budějovice
- Univerzita Pardubice, Pardubice
ডকুমেন্টভেদে ঝুঁকির মাত্রা ভিন্ন। একটি প্রত্যাখ্যাত জার্নাল ম্যানুস্ক্রিপ্ট আপনাকে কয়েক মাস খরচ করায়। Univerzita Karlova বা Masarykova univerzita-তে ফ্ল্যাগ হওয়া একটি থিসিস এমন একটি শুনানির ট্রিগার করতে পারে, যেখানে আপনার integrity, আপনার ব্যাকরণ নয়, পরীক্ষার মুখে পড়ে। এটি একটি ভুল ইতিবাচক ফলাফলের কারণে হওয়া উচিত এমন আলোচনা নয়।
চেক গবেষকদের জন্য AI মানবিকরণকারী কীভাবে কাজ করে
সৎ workflowটা সহজ, এবং এতে disclosure কেন্দ্রে থাকে, কোনো প্রান্তে নয়।
যেখানটায় আপনি সবচেয়ে শক্তিশালী, সেখান থেকে শুরু করুন। চেকে খসড়া করুন, যেভাবে আপনি ভাবতে সবচেয়ে স্বাচ্ছন্দ্য বোধ করেন, তারপর অনুবাদ করুন, অথবা AI সহায়তায় সরাসরি ইংরেজিতে খসড়া বানান। আগে বিজ্ঞানটা ঠিক করুন। এরপর grammar ঠিক করুন যাতে অর্থ নির্ভুল হয়। সবশেষে, চেক গবেষকদের জন্য AI humanizer-এর মধ্য দিয়ে টেক্সটটি চালান, এটি ছন্দ ও শব্দচয়েসকে এমনভাবে বদলায় যাতে আপনার যত্নশীল, স্ট্যান্ডার্ড ইংরেজি ডিটেক্টরে ভুলভাবে পড়ার সম্ভাবনা কমে, আর আপনার অর্থ, পরিভাষা ও উদ্ধৃতি, আপনি যেভাবে লিখেছেন ঠিক সেভাবেই, অক্ষুণ্ণ থাকে।
আপনি কী আশা করতে পারেন? আমাদের নিজস্ব পরীক্ষায় দেখা গেছে, AI humanizer যত্নশীল নন-নেটিভ ইংরেজি কীভাবে বড় ডিটেক্টরগুলো (Turnitin, Originality.ai, এবং GPTZero সহ) ভুলভাবে পড়ে, তার ফ্রিকোয়েন্সি উল্লেখযোগ্যভাবে কমিয়ে দেয়, আপনার যুক্তিকে ছুঁয়ে না। আমরা এটিকে এমনভাবে বলছি যেমন পরীক্ষা পর্যবেক্ষণে আমরা দেখেছি, কোনো প্রতিশ্রুতি হিসেবে নয়। ডিটেক্টরগুলো প্রতি কয়েক মাস পরপর আবার প্রশিক্ষিত হয়, এবং কোনো সৎ টুল ১০০% undetectable হওয়ার প্রতিশ্রুতি দিতে পারে না। যে কেউ এটা গ্যারান্টি দেয়, সে আপনাকে কিছু একটা বিক্রি করছে।
এখানে নন-ইংলিশ টেক্সটও গুরুত্বপূর্ণ। কারণ humanizer ৬০টিরও বেশি ভাষা সমর্থন করে এবং নন-ইংলিশকে একটি ভাষা-সচেতন মডেলের মধ্য দিয়ে রুট করে, আপনি চেক খসড়া বা মিশ্র-ভাষার নোটে কাজ করতে পারেন, টুলটি আপনার বাক্যগঠনকে “সমতল” করে দেয় না। এই অংশটি আমাদের multilingual AI humanizer hub-এর ভেতরে আছে, এবং যখন কোনো ম্যানুস্ক্রিপ্টে মানুষের হাতে-কলমে নজরও দরকার, তখন এটি আমাদের global academic editing hub থেকে করা এডিটিংয়ের সঙ্গে স্বাভাবিকভাবে মিলে যায়।
তারপর আসে সেই পদক্ষেপ, যা পুরো প্রক্রিয়াটিকে সৎ রাখে: আপনার প্রতিষ্ঠান ও লক্ষ্য জার্নাল যে ফরম্যাটে চায়, সেই ফরম্যাটে আপনার AI ব্যবহারটি disclose করুন। নিজের খসড়াকে humanize করলে ন্যায্য নয় এমন ফ্ল্যাগ থেকে স্পষ্ট লেখা সুরক্ষিত থাকে। আপনার পদ্ধতি disclose করলে আপনি নিয়মের ভেতরেই থাকেন। আপনি দুটোই করেন, এবং লুকানোর কিছু থাকে না।
Local funding bodies, journals, and AI-disclosure expectations
চেক গবেষণার অর্থায়ন মূলত তিনটি সংস্থার মাধ্যমে হয়, এবং প্রতিটিই ক্রমেই AI ব্যবহারের ক্ষেত্রে স্বচ্ছতা প্রত্যাশা করে। GAČR (Grantová agentura České republiky, the Czech Science Foundation) মৌলিক গবেষণা অর্থায়ন করে। TAČR (Technologická agentura České republiky, the Technology Agency) প্রয়োগভিত্তিক গবেষণা অর্থায়ন করে। AV ČR (Akademie věd České republiky, the Czech Academy of Sciences) জাতীয় ইনস্টিটিউটগুলো পরিচালনা করে, যেখানে দেশের আউটপুটের বড় অংশের উৎপত্তি হয়।
প্রকাশনার দিকে চাপগুলো এক দিকেই। জাতীয় মূল্যায়ন এবং প্রতিষ্ঠানগত বাজেট Web of Science ও Scopus-indexed জার্নালে প্রকাশিত আউটপুটকে পুরস্কৃত করে, এবং ফলাফলগুলো R&D তথ্যের জাতীয় রেজিস্টার, RIV-এ রিপোর্ট করা হয়। এটি ইংরেজি-ভাষার প্রকাশনাকে পুরস্কৃত করে, যা আপনাকে সরাসরি এই নিবন্ধে শুরু হওয়া false-flag সমস্যায় ফিরিয়ে আনে।
সংখ্যাগুলো আমাদের ওই বাধা সম্পর্কে যা আগেই বলে, সেটি মনে রাখুন। নন-নেটিভ ইংরেজি বক্তাদের ক্ষেত্রে প্রত্যাখ্যানের হার স্থানীয় বক্তাদের তুলনায় প্রায় ২.৫ গুণ বেশি, গবেষণাপত্র লেখায় তারা মোটামুটি ৫১% বেশি সময় ব্যয় করে এবং পড়তে প্রায় ৯১% বেশি সময় ব্যয় করে, এবং ভাষার মান-সংক্রান্ত সংশোধনী অনুরোধ পায় প্রায় ১২.৫ গুণ বেশি। মোটের ওপর ৭% এর কম জার্নালই নন-ইংলিশ জমা গ্রহণ করে। সিস্টেম চেক গবেষকদের ইংরেজিতে প্রতিযোগিতা করতে বলে, তারপর সেই প্রতিযোগিতা থেকে তৈরি হওয়া যত্নশীল ইংরেজিকে শাস্তি দেয়। নিজের খসড়াকে humanize করা, আপনার উদ্ধৃতিগুলো ধরে রাখা, এবং আপনার পদ্ধতি disclose করা, এটা আসলে একটি অন্যায় সেটআপের ন্যায্য প্রতিক্রিয়া; এর কোনো “পথ এড়িয়ে যাওয়া” নয়। the humanizer-কে এই সৎ workflow-এর একটি টুল হিসেবে ব্যবহার করুন।
Frequently asked questions
Q: Does using an AI humanizer for Czech researchers count as cheating?
না, কেবল যখন আপনি এটি সততার সঙ্গে ব্যবহার করেন। আপনি আপনার নিজের AI-সহায়তাপ্রাপ্ত খসড়ার ছন্দকে এমনভাবে গড়ে তুলছেন, যাতে আপনার অর্থ ও উদ্ধৃতি বজায় থাকে, তারপর আপনার প্রতিষ্ঠান ও জার্নাল যেমন চায়, সেইভাবে আপনার AI ব্যবহারটি disclose করেন। এটি ভাষা সম্পাদনা প্লাস স্বচ্ছতা, প্রতারণা নয়। সমস্যা তৈরি হয় কেবল তখনই, যখন আপনি এমন কাজকে নিজের বলে চালাতে চান যা আপনি করেননি বা এমন একটি ব্যবহার লুকাতে চান যেটি ঘোষণা করতে বলা হয়েছিল।
Q: Will the humanizer change my technical terms or my citations?
না। টুলটি একাডেমিক অর্থ, বিশেষায়িত পরিভাষা এবং রেফারেন্স মার্কারগুলো সংরক্ষণ করার জন্যই তৈরি, যদিও এটি বাক্যের ছন্দ ও শব্দচয়েসে বৈচিত্র্য আনে। আপনার রসায়ন রসায়নই থাকে, এবং আপনার উদ্ধৃতিগুলো একই জায়গায় থাকে। তবুও আপনাকে চূড়ান্ত সংস্করণটি প্রুফরিড করা উচিত, কারণ আপনি প্রতিটি শব্দের জন্য দায়ী লেখকই থাকেন।
Q: Can you guarantee my paper will pass Turnitin or GPTZero?
না, এবং আপনার উচিত যাকে কেউ এ বিষয়ে নিশ্চয়তা দেয় তাকে অবিশ্বাস করা। ডিটেক্টরগুলো ক্রমাগত রি-ট্রেন হয়, তাই কোনো সৎ টুল ১০০% undetectable হওয়ার প্রতিশ্রুতি দিতে পারে না। আমরা যা বলতে পারি তা হলো, আমাদের পরীক্ষায় দেখা গেছে, যত্নশীল নন-নেটিভ ইংরেজিকে humanize করলে বড় ডিটেক্টরগুলো সেটিকে ভুলভাবে পড়ার ঘটনা উল্লেখযোগ্যভাবে কমে, এবং আপনার অর্থ অক্ষুণ্ণ থাকে।
Q: Why does my correct Czech-English get flagged in the first place?
কারণ দ্বিতীয় ভাষায় লেখা যত্নশীল টেক্সটগুলো প্রায়ই কম perplexity দেখায়। আপনি নিরাপদ শব্দ ও মানক গঠন বেছে নেন, আর ডিটেক্টরগুলো এই পূর্বানুমেয়তাকেই মেশিন-উৎপাদিত হিসেবে পড়ে। Stanford-এর গবেষণায় দেখা গেছে, স্থানীয় নয় এমন, মানুষ-লেখা, প্রবন্ধগুলো AI হিসেবে অনেক বেশি হারে ফ্ল্যাগ হয়, যেখানে স্থানীয়গুলোর হার তুলনামূলক কম। এটি দেখায় bias ডিটেক্টরে, আপনার লেখায় নয়।
Q: Do I still have to tell my university or journal that I used AI?
হ্যাঁ, যখনই তারা জিজ্ঞেস করে, এবং ক্রমেই তারা জিজ্ঞেস করে। আপনার খসড়াকে humanize করা হলো ন্যায্যতা নিশ্চিত করার বিষয়, লুকানোর নয়, তাই disclosure-ই এখানে মূল বিষয়, কোনো ফাঁকি নয়। আপনার খসড়া ও সম্পাদনায় কীভাবে AI ব্যবহার করেছেন তা স্পষ্টভাবে বলুন, তাহলে আপনি integrity নিয়ম এবং নিজের বিবেক, দুটোর সঠিক দিকেই থাকবেন।
অর্থ, পরিভাষা, এবং উদ্ধৃতি বজায় রেখে সতর্ক চেক-ইংরেজিতে ভুল AI সতর্কবার্তা কমিয়ে দিন, তারপর আত্মবিশ্বাসের সাথে আপনার AI ব্যবহারের কথা প্রকাশ করুন।

Moe একজন NLP ইঞ্জিনিয়ার একজন PhD সহ প্রাকৃতিক ভাষা প্রক্রিয়াকরণে। তার গবেষণা কম্পিউটেশনাল ভাষাতত্ত্ব, পাঠ্য বিশ্লেষণ এবং মেশিন লার্নিংকে কভার করে এবং এটি সরাসরি ProofreaderPro-এর পিছনে সম্পাদনা এবং মানবীকরণ মডেলগুলিতে যোগ করে। তিনি প্রক্রিয়াটির অংশ সম্পর্কে লিখেছেন যা বেশিরভাগ লোকেরা কখনই দেখে না: কীভাবে একটি ভাষা মডেল একটি বাক্য পড়ে, স্কোর করে এবং কী পরিবর্তন করতে হবে তা সিদ্ধান্ত নেয়।


