
ইংরেজিতে লিখতে থাকা রোমানিয়ান গবেষকদের জন্য AI হিউম্যানাইজার
রোমানিয়ান গবেষকদের জন্য AI হিউম্যানাইজার। রোমানিয়া-প্রভাবিত ইংরেজিতে ভুলভাবে AI শনাক্তকরণের (false AI-detection) সংকেত কমান, অর্থ ও উদ্ধৃতি (citations) অক্ষুণ্ণ রেখে, এবং সত্যনিষ্ঠভাবে ব্যবহারটি প্রকাশ করুন।

রোমানিয়া গুরুত্ব দিয়ে বিজ্ঞান প্রকাশ করে। প্রতি বছর তাদের গণিতবিদ, কম্পিউটার বিজ্ঞানী, পদার্থবিজ্ঞানী এবং রসায়নবিদরা Web of Science ও Scopus জার্নালে কাজ জমা দেন, আর CNATDCU-র জাতীয় প্রমোশন মানদণ্ড সেই চাপকে স্থির রাখে: সূচিবদ্ধ (indexed) প্রকাশনা না থাকলে অগ্রগতি সম্ভব নয়। এ গবেষণার প্রায় সবটাই রোমানিয়ান ভাষায় খসড়া করা হয় এবং তারপর ইংরেজিতে উপস্থাপন করা হয়।
রোমানিয়ান গবেষকদের জন্য নির্মিত একটি AI হিউম্যানাইজার ঠিক যে সমস্যাটি সমাধান করতে চায়, তা হলো, আপনি যদি দ্বিতীয় ভাষা হিসেবে সতর্ক, মানসম্পন্ন একাডেমিক ইংরেজি লেখেন, তবে একটি AI ডিটেক্টর সেটিকে মেশিন-তৈরি লেখা বলে ভুল পড়তে পারে। আপনার ব্যাকরণ থাকে পরিপাটি। আপনার বাক্যগঠন পূর্বানুমেয়। আর ঠিক পূর্বানুমেয়তাকেই এই টুলগুলো শনাক্ত করার জন্য প্রশিক্ষিত করা হয়েছে।
এটি কোনো বিচ্ছিন্ন ব্যতিক্রম নয়। এটি একটি কাঠামোগত পক্ষপাত (structural bias), এবং এটি সবচেয়ে বেশি আঘাত করে তাদেরই, যারা পরিষ্কার ও সঠিক ইংরেজি লেখার জন্য দীর্ঘতম সময় কাজ করেছেন।
রোমানিয়ান গবেষকদের জন্য AI টেক্সট হিউম্যানাইজেশন কীভাবে সাহায্য করে
AI টেক্সট হিউম্যানাইজেশন রোমানিয়ান গবেষকদের ইংরেজি ভাষায়, এমনভাবে, প্রকাশ করতে সহায়তা করে যাতে তাদের যত্নসহকারে ও সঠিক লেখাকে মেশিন-উৎপাদিত লেখা বলে বিভ্রান্ত না করা হয়। Meaning, পরিভাষা, এবং citations ঠিক সেই জায়গাতেই থাকে, যেভাবে আপনি বসিয়েছেন।
ভাবনাটি সহজ এবং সৎ। আপনি কঠোর (rigorous) ইংরেজি লিখতেই থাকেন। একটি হিউম্যানাইজার বাক্যরীতি (rhythm) ও শব্দচয়নের (word choice) বৈচিত্র্য আনে, ফলে আপনার গদ্য আর এমন ডিটেক্টরকে বাধা দেয় না, যেটি পূর্বানুমেয়তাকে শাস্তি দেওয়ার জন্য টিউন করা। আপনার যুক্তি (argument), আপনার তথ্য (data), বা আপনার রেফারেন্স, কোনো কিছুই বদলায় না।
কেবল আপনার ইংরেজি নয়: রোমানিয়ান সরাসরি হিউম্যানাইজ করতে পারবেন
হিউম্যানাইজ করার আগে খসড়াটি ইংরেজিতে অনুবাদ করার বাধ্যবাধকতা নেই। রোমানিয়ান ভাষায় লেখা টেক্সট কপি-পেস্ট করুন, আর ProofreaderPro ভাষাটি স্বয়ংক্রিয়ভাবে শনাক্ত করে; এরপর এটি এমন একটি রোমানিয়ান-সচেতন মডেলের মাধ্যমে পাঠায়, যা মূল লেখার diacritics, ব্যাকরণ, এবং একাডেমিক রেজিস্টারকে সম্মান করে। আপনার অর্থ, টেকনিক্যাল টার্ম, এবং citations অক্ষুণ্ণ থাকে, তাই AI টেক্সট হিউম্যানাইজেশন আপনার প্রথম ভাষার লেখাতেও ঠিক ততটাই কাজ করে, যতটা করে আপনার ইংরেজিতে। এ হিউম্যানাইজার এভাবে ষাটেরও বেশি ভাষা হ্যান্ডেল করে; প্রতিটি ভাষা আলাদাভাবে শনাক্ত হয় এবং সেটিকে সাধারণ, জেনেরিক ইংরেজিতে চেপ্টে না ফেলে ‘নিজের মতোই’ পুনর্লিখন করে।
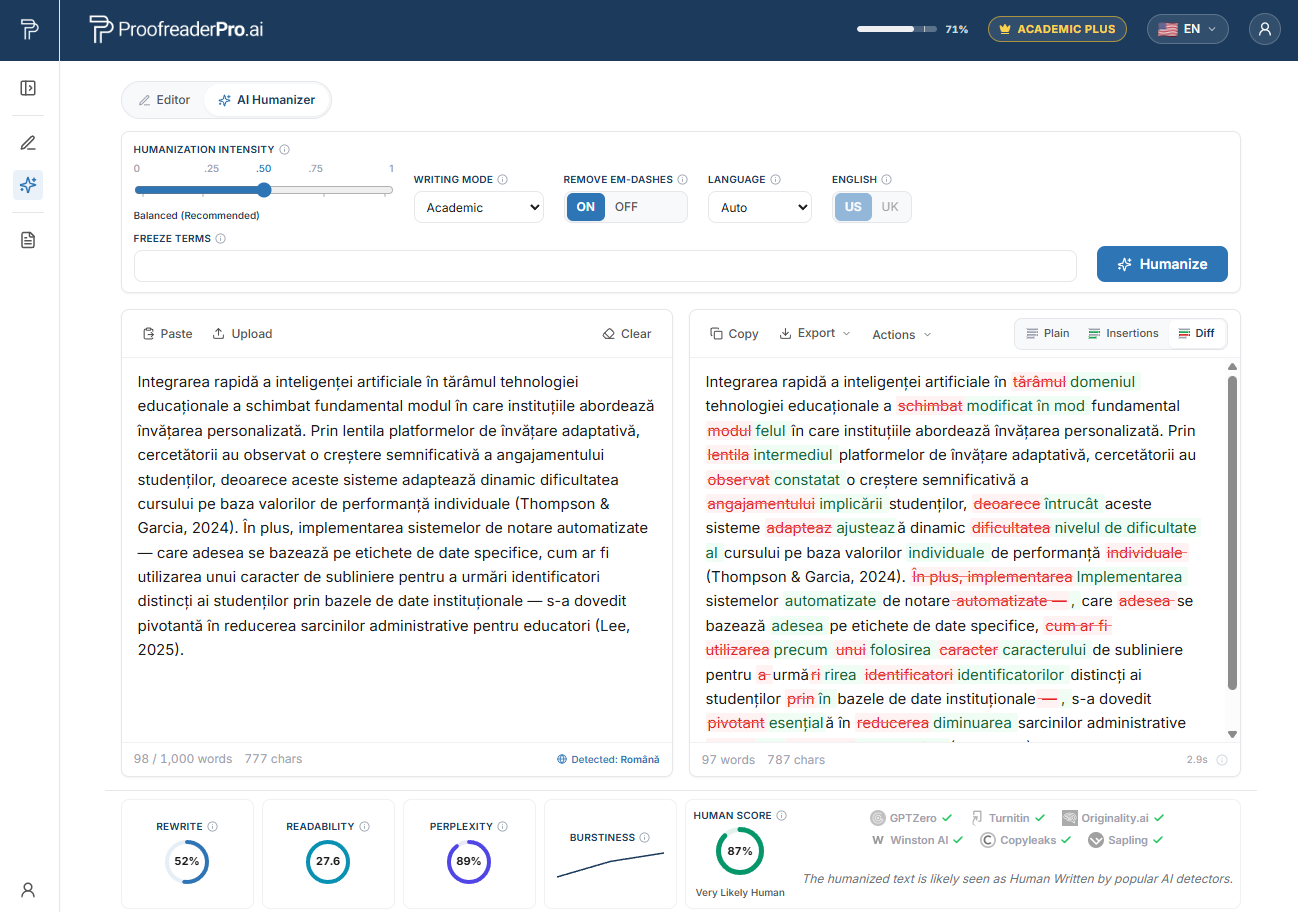
ProofreaderPro AI Humanizer রোমানিয়ান একাডেমিক টেক্সটকে পুনর্লিখন করছে। before and after diff আপনার অর্থ ও citations ধরে রাখে, আর detector checks নিশ্চিত করে যে পাঠটি স্বাভাবিক, মানুষের মতো।
কেন রোমানিয়ান গবেষকদের AI ডিটেক্টরে ফ্ল্যাগ পড়ে
২০২৩ সালে স্ট্যানফোর্ডের গবেষকরা, Weixin Liang-এর নেতৃত্বে, Cell Press জার্নাল Patterns-এ একটি গবেষণা প্রকাশ করেন, একদম সরাসরি শিরোনামে: "GPT detectors are biased against non-native English writers." তারা TOEFL-এ মানবদ্বারা লেখা প্রবন্ধ নিয়ে সেগুলোকে সাতটি বহুল ব্যবহৃত AI ডিটেক্টরের মাধ্যমে চালান।
ফলাফলগুলো দ্বিতীয় ভাষায় প্রকাশ করতে ইচ্ছুক যে কারও জন্যই উদ্বেগজনক। গড়ে, নেটিভ ইংরেজি বক্তাদের প্রবন্ধের তুলনায় (প্রায় ৫%), নন-নেটিভ প্রবন্ধগুলোর প্রায় ৬১% AI-written হিসেবে ফ্ল্যাগ হয়। তাছাড়া পাঁচটির মধ্যে প্রায় একটিতে, প্রায় ১৯.৮%, প্রতিটি একক ডিটেক্টর দ্বিমতহীনভাবে (unanimously) ফ্ল্যাগ করেছে। এই প্রতিটি প্রবন্ধই একজন মানুষের লেখা।
ক্রিয়াকৌশলটি (mechanism) ‘perplexity’ নামে একটি মাপ দিয়ে ব্যাখ্যা করা হয়, এটি দেখে যে কোনো ভাষা মডেলের কাছে শব্দচয়ন কতটা ‘বিস্ময়কর/অপ্রত্যাশিত’। দ্বিতীয় ভাষার লেখকেরা সাধারণ শব্দ এবং মানক, নিরাপদ গঠন বেছে নিতে ঝোঁকেন, ফলে তাদের perplexity কম থাকে। কম perplexity মেশিন টেক্সটের মতো শোনায়। যে অভ্যাসগুলো রোমানিয়ান-ইংরেজিকে স্পষ্ট ও সঠিক করে তোলে, ঠিক সেই অভ্যাসগুলোকেই এই টুলগুলো সন্দেহের চোখে দেখতেই শিখেছে। আমরা কেন AI ডিটেক্টর নন-নেটিভ লেখকদের ফ্ল্যাগ করে প্রক্রিয়াটি বিস্তারিতভাবে বিশ্লেষণ করেছি।
false flag-এর পেছনে রোমানিয়ান প্রথম-ভাষার প্যাটার্ন
রোমানিয়ান হলো লাতিন বর্ণমালাভিত্তিক একটি Romance ভাষা, যা ইংরেজির কাছাকাছি, ফলে পরিচিতও লাগে; আবার যথেষ্ট আলাদা, ফলে এর ‘ফিঙ্গারপ্রিন্ট’ও রয়ে যায়। নিচের কোনো প্যাটার্নই ভুল নয়। এগুলো সঠিক, যত্নসহকারে নির্বাচিত, এবং মানসম্পন্ন পছন্দ, আর ঠিক এই মানসম্পন্নতাকেই ডিটেক্টর কম perplexity হিসেবে পড়ে।
False friends আপনার লেখাকে পরিচিত একটি ‘আকৃতি’ দেয়। রোমানিয়ানে actual মানে বর্তমান (current), eventual মানে সম্ভাব্য (possible), a realiza মানে অর্জন করা বা বাস্তবায়ন করা, sensibil মানে সংবেদনশীল (sensitive), আর a pretinde মানে দাবি করা। একজন সতর্ক লেখক যিনি এসব ফাঁদ এড়াতে শিখেছেন, তিনি প্রায়ই প্রতিবার একই রকম নিরাপদ, পাঠ্যবই-ধাঁচের ইংরেজি শব্দে পৌঁছান, যা ভিন্নতাকে (variety) কমিয়ে দেয়, এবং ডিটেক্টররা সেটাই লক্ষ্য করে।
নিশ্চিত নির্দিষ্ট নির্দেশক (definite article) ভিন্নভাবে আচরণ করে। রোমানিয়ান ভাষায় article-টি noun-এর শেষে যুক্ত হয়, সামনে আলাদা শব্দ হিসেবে বসে না। তাই ইংরেজির "the" বাদ পড়া বা ভুল বসার সম্ভাবনা থাকে। যারা অতিরিক্ত সংশোধন (overcorrect) করেন, তারা খুব নিয়মিতভাবে article ব্যবহার করেন, এটিও আরেকটি অভিন্ন (uniform) সংকেত (signal)।
বাক্যগুলো লম্বা হয় এবং subordinate-heavy থাকে। রোমানিয়ান একাডেমিক গদ্যে স্তরযুক্ত উপবাক্য (layered clauses) এবং subjunctive-এর প্রতি ঝোঁক বেশি, ফলে অনেক সময় রিভিউয়াররা অনুবাদিত সংস্করণটিকে ঘন (dense) বলে পড়েন। ঘন, নিবিড়ভাবে গঠিত বাক্যও ডিটেক্টরের কাছে পরিসংখ্যানগতভাবে ‘মসৃণ’ (statistically smooth) মনে হতে পারে।
Preposition সরাসরি স্থানান্তরিত হয়। "depend of" বা "different of"-এর মতো গঠন রোমানিয়ান প্যাটার্ন অনুসরণ করে; এবং relative clause শুরু করতে "which"-এর উপর ভারী নির্ভরতা একটি পূর্বানুমেয় ছন্দ (predictable cadence) যোগ করে।
Nominalisation জমে ওঠে। ক্রিয়াকে ভারী noun phrase-এ রূপান্তর করা আনুষ্ঠানিক রোমানিয়ানেই স্বাভাবিক, এবং আনুষ্ঠানিক ইংরেজিতেও স্বাভাবিক, কিন্তু পাশাপাশি স্তূপ করলে এমন এক ধরনের সমান (even), বিমূর্ত (abstract) ছন্দ তৈরি হয়, যা মেশিন-জাতীয় মতো স্কোর করে।
এইগুলো একত্র করলে এমন গদ্য পাওয়া যায় যা নির্ভুল (accurate), পেশাদার (professional), এবং AI ডিটেক্টরের কাছে সন্দেহজনকভাবে মসৃণ।
রোমানিয়ার AI-ডিটেকশন ও Turnitin প্রেক্ষাপট
রোমানিয়ার উচ্চশিক্ষায় similarity screening একটি রুটিন প্রক্রিয়া। ডক্টরাল থিসিস এবং জার্নাল সাবমিশন সাধারণত Turnitin বা তুলনীয় সিস্টেম দিয়ে যাচাই করা হয়, এবং এসব প্ল্যাটফর্মের অনেকগুলো এখন traditional similarity score-এর পাশাপাশি একটি AI-writing সূচকও যোগ করে।
বিশ্ববিদ্যালয়গুলো নিজেদের generative-AI সংক্রান্ত নির্দেশনা জারি করেছে, এবং পরিবর্তনের দিকটা স্পষ্ট: ফান্ডার এবং জার্নালগুলো ক্রমেই লেখকদের AI টুল ব্যবহারের বিষয়টি প্রকাশ করতে বলছে। এটি একটি যুক্তিসঙ্গত অনুরোধ, এবং এটি AI-কে পুরোপুরি নিষিদ্ধ করার থেকে একেবারেই আলাদা।
সৎ অবস্থানটাই (honest position) ধরে রাখার মতো। আপনার নিজের কাজ খসড়া করতে বা পরিশীলন করতে AI ব্যবহার করুন, প্রতিটি দাবি ও citation সত্য রাখুন, তারপর আপনার প্রতিষ্ঠান ও লক্ষ্য জার্নাল যে ফরম্যাট চায় সেইভাবে ব্যবহারটি প্রকাশ করুন। ডিটেক্টর স্কোর একটি চ্যালেঞ্জযোগ্য দাবি (claim to contest), চূড়ান্ত রায় (verdict) নয়, আর কোনো দায়িত্বশীল রিভিউয়ারই একটি মাত্র সংখ্যা দিয়ে misconduct প্রমাণ করা উচিত নয়।
ভুল AI ফ্ল্যাগের হাত থেকে আপনার রোমানীয়-ইংরেজি গবেষণাকে সুরক্ষিত করুন
আপনার নিজস্ব যত্নসহকারে লেখা একাডেমিক খসড়াটিকে মানবসুলভ করুন, প্রতিটি উদ্ধৃতি এবং টেকনিক্যাল টার্ম বজায় রাখুন, তারপর আত্মবিশ্বাসের সাথে আপনার AI ব্যবহার প্রকাশ করুন।
Humanizer ফ্রি করে দেখুনশীর্ষ রোমানিয়ান বিশ্ববিদ্যালয় এবং কোথায় AI চেক দেখা যায়
যেসব প্রতিষ্ঠানে রোমানিয়ান গবেষণা লেখা হয়, ডিফেন্ড করা হয়, এবং স্ক্রিন করা হয়, এগুলোই। প্রতিটিই থিসিস ও ম্যানুস্ক্রিপ্টকে similarity সিস্টেমে চালায়, এবং ক্রমেই একই রিভিউয়ের অংশ হিসেবে AI সূচকগুলোকেও বেশি ওজন দিচ্ছে।
- Universitatea din București (University of Bucharest), Bucharest
- Universitatea Babeș-Bolyai (Babeș-Bolyai University), Cluj-Napoca
- Universitatea Politehnica din București (Politehnica University of Bucharest), Bucharest
- Universitatea Alexandru Ioan Cuza din Iași, Iași
- Universitatea de Vest din Timișoara (West University of Timișoara), Timișoara
- Universitatea de Medicină și Farmacie Carol Davila, Bucharest
- Universitatea Tehnică din Cluj-Napoca (Technical University of Cluj-Napoca), Cluj-Napoca
- Universitatea Transilvania din Brașov (Transilvania University of Brașov), Brașov
- Academia de Studii Economice din București (Bucharest University of Economic Studies, ASE), Bucharest
- Universitatea din Craiova (University of Craiova), Craiova
এই সিস্টেমগুলোর যেকোনো একটিতে ফ্ল্যাগ পড়া, তা একটি আলোচনার (conversation) শুরু, শেষ নয়। আপনি যে গদ্য চান তা হলো এমন লেখা, যা প্রথমেই কখনো আলোচনার আমন্ত্রণ জানায় না; কারণ এটি স্পষ্টভাবেই সেই যত্নসহকারে মানুষের লেখা মতো পড়বে, যেটি এটি ইতিমধ্যেই হয়ে উঠেছে।
রোমানিয়ান গবেষকদের জন্য AI হিউম্যানাইজার কীভাবে কাজ করে
ওয়ার্কফ্লোটি সৎ, এবং এটি আপনার বিদ্যমান লেখার পদ্ধতির সঙ্গে মেলে। রোমানিয়ান গবেষকদের জন্য AI হিউম্যানাইজার বাস্তবে কীভাবে কাজ করে, তা নিচে দেওয়া হলো।
প্রথমে আপনার পেপারের খসড়া তৈরি করুন। যদি আগে রোমানিয়ান ভাষায় চিন্তা করা সুবিধাজনক হয়, তাহলে তা করুন; তারপর এটি অনুবাদ করে ইংরেজিতে লিখে নিন, অথবা একটি AI সহকারী ব্যবহার করে প্রথম খসড়া এগিয়ে নিতে সাহায্য নিন। ব্যাকরণ ও পরিভাষা ঠিক করুন যাতে বিজ্ঞানটি নির্ভুল হয়। এরপর আপনার নিজের ইংরেজিকে text humanizer-এ চালান, এটি বাক্যের দৈর্ঘ্য (sentence length) এবং শব্দচয়নের (word choice) বৈচিত্র্য আনে, ডিটেক্টররা যেটিকে শাস্তি দেয় সেই একঘেয়ে ছন্দকে মসৃণ করে, এবং নীরবে সেসব এলোমেলো (stray) em dash ও পুনরাবৃত্তিমূলক বাক্যবিন্যাস (repetitive phrasing) ছেঁটে দেয় যেগুলো মেশিন-জাতীয় খসড়াকে ‘ধরে’ ফেলে।
Meaning, টেকনিক্যাল ভোকাবুলারি, এবং citations সংরক্ষিত থাকে। নন-ইংরেজি টেক্সট একটি language-aware মডেলে রুট হয়, যা sentence structureকে সম্মান করে; ফলে রোমানিয়ান-ইনফ্লেক্টেড কোনো অংশ বিকৃত হয়ে বের হয় না। আমাদের নিজস্ব পরীক্ষায় দেখা যায়, এতে যত্নসহকারে লেখা মানসম্পন্ন নন-নেটিভ ইংরেজি বড় ডিটেক্টরগুলোর (Turnitin, Originality.ai, এবং GPTZero সহ) দ্বারা ভুলভাবে পড়ার হার উল্লেখযোগ্যভাবে কমে, একই সঙ্গে একাডেমিক কনটেন্ট অক্ষুণ্ণ থাকে।
আমরা এটিকে ‘আমরা যা দেখেছি’ হিসেবে বর্ণনা করি, প্রতিশ্রুতি (promise) হিসেবে নয়। ডিটেক্টরগুলো প্রতি কয়েক মাসে পুনঃপ্রশিক্ষিত হয়, আর কোনো সৎ টুলই ১০০% অচিহ্নিত (undetectable) হওয়ার দাবি করতে পারে না। আমরা যা বলতে পারি তা হলো, যতটা স্পষ্টভাবে মানুষের লেখা গদ্য, এবং যেটিতে সামান্য বেশি বৈচিত্র্য আছে, সেটিকে মেশিন বলে ভুল ধরার ঝুঁকি অনেক বেশি কঠিন। এটি আমাদের multilingual AI humanizer hub-এর অংশ, এবং পুরো সম্পাদনা (editing) পরিপ্রেক্ষিতে এটি আমাদের global academic editing hub–এর সাথে পাশাপাশি অবস্থান করে।
শেষ ধাপটি ঐচ্ছিক নয়। আপনার খসড়া যখন স্বাভাবিকভাবে পড়া যায়, তখন আপনার AI ব্যবহারটি আপনার প্রতিষ্ঠান ও জার্নাল যেভাবে চায় সেভাবে প্রকাশ করুন। নিজের কাজকে হিউম্যানাইজ করা সেটিকে পক্ষপাতদুষ্ট ফ্ল্যাগ থেকে রক্ষা করে। প্রকাশনা আপনাকে পুরোপুরি নিয়মের ভেতরে রাখে।
স্থানীয় ফান্ডিং সংস্থা, জার্নাল, এবং AI-প্রকাশের প্রত্যাশা
রোমানিয়ান প্রতিযোগিতামূলক গ্রান্টগুলো মূলত UEFISCDI, Executive Agency for Higher Education, Research, Development and Innovation Funding, এর মাধ্যমে পরিচালিত হয়। গবেষণা মূল্যায়ন নীতি নির্ধারণ করে CNCS, the National Council for Scientific Research, এবং Academia Română, রোমানিয়ান একাডেমি, দেশব্যাপী জাতীয় ইনস্টিটিউটের একটি নেটওয়ার্ক পরিচালনা করে। সবকিছুর ওপরে আছে CNATDCU, যার ন্যূনতম প্রমোশন মানদণ্ড সূচিবদ্ধ জার্নালে আউটপুটকে পুরস্কৃত করে।
এই সূচিবদ্ধতা-সংক্রান্ত চাপ সবাইকে একই টার্গেটে ঠেলে দেয়: Web of Science ও Scopus জার্নালগুলো। সেখানে ভাষা নিয়ে রিভিউয়াররা অত্যন্ত কড়া, এবং একটি AI ফ্ল্যাগ বিজ্ঞানের পাঠ শুরু হওয়ার আগেই একটি সাবমিশন থামিয়ে দিতে পারে।
গ্রান্ট রিপোর্ট এবং জার্নাল সাবমিশন সিস্টেম জুড়ে AI-প্রকাশ সংক্রান্ত অনুরোধ ছড়াতে থাকবে, এটাই আশা করা যায়। নিরাপদ অভ্যাস হলো প্রকাশনাকে স্বাভাবিক প্র্যাকটিস হিসেবে ধরা, একে কোনো স্বীকারোক্তি (admission) হিসেবে না দেখা। আপনি কোন টুল ব্যবহার করে লিখেছেন তা স্পষ্টভাবে বলুন, আপনার তথ্য ও citations সত্য রাখুন, এবং একটি পরিষ্কার, মানুষের মতো শোনায় এমন ম্যানুস্ক্রিপ্টকে কাজের পক্ষে কথা বলতে দিন। যখন আপনি আপনার খসড়া humanizer-এ চালান, তখন আপনি নির্ভুল লেখাকে রক্ষা করছেন, কোনো কিছু আড়াল করছেন না।
প্রায় জিজ্ঞাসিত প্রশ্ন
প্রশ্ন: রোমানিয়ান গবেষকদের জন্য AI হিউম্যানাইজার কি আমার citations বা টেকনিক্যাল টার্ম বদলায়?
না। হিউম্যানাইজার আপনার অর্থ (meaning), আপনার পরিভাষা (terminology), এবং প্রতিটি citation ঠিক যেমন লেখা আছে তেমনই সংরক্ষণ করে। আশেপাশের প্রবন্ধ জুড়ে rhythm ও word choice পরিবর্তন করে, ফলে আপনার রেফারেন্স ও বিশেষায়িত শব্দভাণ্ডার অক্ষুণ্ণ থাকে, আর লেখাটি আরও স্বাভাবিকভাবে পড়া যায়।
প্রশ্ন: কোনো হিউম্যানাইজার কি গ্যারান্টি দিতে পারে যে আমার পেপার AI ডিটেক্টর পার হবে?
না। কোনো সৎ টুলই এ ধরনের প্রতিশ্রুতি দিতে পারে না, এবং আপনারও যেগুলো তা দাবি করে তাদের ওপর ভরসা করা উচিত নয়। ডিটেক্টরগুলো প্রতি কয়েক মাসে পুনঃপ্রশিক্ষিত হয়, তাই কোনো ফলাফল গ্যারান্টি দেওয়া যায় না এবং কিছুই ১০০% অচিহ্নিত বলে বলা যায় না। আমরা যা বলতে পারি তা হলো, আমাদের পরীক্ষায় বিভিন্ন ধরনের যত্নসহকারে লেখা নন-নেটিভ গদ্য বড় ডিটেক্টরগুলোর দ্বারা ভুলভাবে পড়ার হার উল্লেখযোগ্যভাবে কমায়।
প্রশ্ন: আমার নিজের খসড়ায় umanizarea textului AI ব্যবহার করা কি চুরি/প্রতারণা (cheating) হিসেবে ধরা হয়?
না, যখন আপনি তা সৎভাবে করেন। আপনি আপনার নিজের AI-সহায়তায় তৈরি কাজকে পরিশীলিত করছেন, প্রতিটি দাবি ও citation সত্য রাখছেন, তারপর আপনার বিশ্ববিদ্যালয় ও জার্নাল যেভাবে চায় সেভাবে আপনার AI ব্যবহারটি প্রকাশ করছেন। এটি আসল কাজের প্রতি ন্যায্যতা (fairness), কোনো কিছু আড়াল করার পথ নয়।
প্রশ্ন: শুরুতেই আমার সঠিক ইংরেজি কেন AI হিসেবে ফ্ল্যাগ হয়?
কারণ ডিটেক্টরগুলো predictability স্কোর করে, আর দ্বিতীয় ভাষায় লেখা যত্নসহকারে গদ্য খুবই পূর্বানুমেয়। স্ট্যানফোর্ডের গবেষণায় দেখা গেছে, মানুষের লেখা নন-নেটিভ প্রবন্ধগুলো নেটিভগুলোর চেয়ে অনেক বেশি হারে AI হিসেবে ফ্ল্যাগ হয়েছে। পরিষ্কার, মানসম্পন্ন রোমানিয়ান-ইংরেজি কম perplexity হিসেবে পড়ে, যেটিকে এই টুলগুলো মেশিন সংকেত (machine signal) হিসেবে ধরে।
প্রশ্ন: রোমানিয়ান বিশ্ববিদ্যালয়গুলো কি সত্যিই AI-এর জন্য স্ক্রিন করে?
হ্যাঁ, সাধারণ অর্থে। Turnitin বা তুলনীয় সিস্টেম দিয়ে similarity চেক করা একটি রুটিন কাজ, আর এর অনেকগুলো প্ল্যাটফর্ম এখন AI-writing সূচকও দেখায়। একটি ফ্ল্যাগ হলো পর্যালোচনার দাবি (claim to review), চূড়ান্ত রায় নয় (verdict)। তাই নিশ্চিত হওয়া জরুরি যে আপনার গদ্য প্রথমেই প্রশ্নের আমন্ত্রণ না জানায়।
আপনার অর্থ, পরিভাষা, এবং উদ্ধৃতি বজায় রাখুন। যেসব অংশ ডিটেক্টরকে বিভ্রান্ত করে, সেগুলোর ছন্দ সামান্য বদলান, তারপর আত্মবিশ্বাসের সাথে আপনার AI ব্যবহার প্রকাশ করুন।

Moe একজন NLP ইঞ্জিনিয়ার একজন PhD সহ প্রাকৃতিক ভাষা প্রক্রিয়াকরণে। তার গবেষণা কম্পিউটেশনাল ভাষাতত্ত্ব, পাঠ্য বিশ্লেষণ এবং মেশিন লার্নিংকে কভার করে এবং এটি সরাসরি ProofreaderPro-এর পিছনে সম্পাদনা এবং মানবীকরণ মডেলগুলিতে যোগ করে। তিনি প্রক্রিয়াটির অংশ সম্পর্কে লিখেছেন যা বেশিরভাগ লোকেরা কখনই দেখে না: কীভাবে একটি ভাষা মডেল একটি বাক্য পড়ে, স্কোর করে এবং কী পরিবর্তন করতে হবে তা সিদ্ধান্ত নেয়।


