
ইংরেজিতে লিখতে আগ্রহী হাঙ্গেরীয় গবেষকদের জন্য AI Humanizer
হাঙ্গেরীয় গবেষকদের জন্য AI humanizer। হাঙ্গেরীয় প্রভাবিত ইংরেজিতে যেন ভুলভাবে AI-ডিটেকশন সতর্কতা না আসে, অর্থ ও উদ্ধৃতি অক্ষুণ্ণ রেখে তা কমাতে সহায়তা করে, এবং সৎভাবে ব্যবহারের বিষয়টি জানায়।

হাঙ্গেরীয় বিজ্ঞান, মানুষের সংখ্যার তুলনায় অনেক বেশি প্রভাব ফেলে। দশ মিলিয়নেরও কম জনসংখ্যার একটি দেশ এমন একদল উল্লেখযোগ্য গণিতবিদ, পদার্থবিদ, রসায়নবিদ এবং জীবনবিজ্ঞানীদের জন্ম দিয়েছে, এবং সেই ঐতিহ্য আজও তাদের বিশ্ববিদ্যালয়গুলোর আউটপুটে স্পষ্ট। কিন্তু কাজগুলো ইংরেজিতেই লেখা হয়। প্রায় প্রতিটি গবেষক বুদাপেস্ট বা সেজেডে আগে আগে হাঙ্গেরীয় ভাষায়ই খসড়া তৈরি করেন ও ভাবনা গুছিয়ে নেন, তারপর দ্বিতীয় একটি ভাষায় যুক্তিটা এমনভাবে বহন করেন যার ব্যাকরণ প্রায় কিছুতেই তাদের ভাষার মতো নয়। ঠিক এই অনুবাদ-ফাঁকটাই সেই জায়গা, যেখানে হাঙ্গেরীয় গবেষকদের জন্য একটি AI humanizer নিজের মূল্য তৈরি করে, কারণ এখন যত্নসহকারে লেখা হাঙ্গেরীয়-ইংরেজিকে ভুল করে যন্ত্রের লেখা বলে পড়া হচ্ছে।
অস্বস্তিকর অংশটা হলো, আপনার ইংরেজি যত পরিষ্কার ও যত বেশি মানানসই হবে, AI ডিটেক্টরের সেটি চিহ্নিত করার সম্ভাবনা তত বাড়বে। এমন একটি মডেল যে প্রতিটি শব্দ “কতটা বিস্ময়কর”, তার ভিত্তিতে টেক্সট স্কোর করে, আপনার শৃঙ্খলাপূর্ণ, পূর্বানুমেয় ভঙ্গিকে মেশিন-লেখকতার ইঙ্গিত হিসেবে ধরে। কঠিন দ্বিতীয় ভাষায় স্পষ্টভাবে লেখার যে পুরস্কার পাওয়ার কথা, সেটাই পরিণত হয় এক ধরনের মিথ্যা অভিযোগে।
আমরা এই নির্দিষ্ট সমস্যার জন্য আমাদের humanizer তৈরি করেছি: আসল গবেষকদের আসল কাজকে রক্ষা করার জন্য, কারও শর্টকাট ঢাকতে নয়। এই গাইডটি দেখায়, হাঙ্গেরির গবেষকদের জন্য এটি কীভাবে একটি সৎ প্রকাশনা-প্রক্রিয়ার মধ্যে যুক্ত হয়।
AI-szöveg humanizálása magyar kutatóknak
AI-szöveg humanizálása মানে হলো, আপনার নিজের, কৃত্রিম বুদ্ধিমত্তা-সহায়তাপ্রাপ্ত লেখা আরও মানবিক ছন্দে বদলে দেওয়া, অথচ অর্থ, বিশেষায়িত পরিভাষা এবং উদ্ধৃতিগুলো অপরিবর্তিত রাখা। Our tool is built for Hungarian academics who draft in their own language and then publish in English.
মূল বিষয়টি কোনো কিছু আড়াল করা নয়। মূল বিষয়টি হলো, হাঙ্গেরীয় একজন গবেষকের লেখা একটি যত্নসহকারে, মানানসই ইংরেজির বাক্যকে কেবল তাই “সন্দেহজনক” মনে করা উচিত নয় যে সেটি যত্নসহকারে ও মানানসই। ঠিক যে “false flag” কমাতে text humanizer ডিজাইন করা হয়েছে, সেটাই এখানকার উদ্দেশ্য।
হাঙ্গেরীয় ভাষায় লিখছেন? হিউম্যানাইজার তা স্বয়ংক্রিয়ভাবে শনাক্ত করে এবং সরাসরি পুনর্লিখন করে
ইংরেজিতে আগে অনুবাদ না করেও আপনি একটি হাঙ্গেরীয় খসড়াকে humanize করতে পারেন। আপনার লেখা কপি-পেস্ট করুন; তারপর ProofreaderPro ভাষাটি স্বয়ংক্রিয়ভাবে শনাক্ত করে, এবং সেটিকে হাঙ্গেরি-সচেতন এমন একটি মডেলের মধ্য দিয়ে চালায় যা আপনার লেখার দীর্ঘ স্বরধ্বনি, agglutinated ফর্ম এবং উদ্ধৃতিগুলোর প্রতি শ্রদ্ধাশীল। AI-szöveg humanizálása হিসেবে এটি আপনার হাঙ্গেরীয় গদ্যের ছন্দের পরিবর্তন আনে, কিন্তু প্রতিটি টার্ম ও রেফারেন্স অক্ষুণ্ণ রাখে। স্বয়ংক্রিয় শনাক্তকরণ ষাটেরও বেশি ভাষা জুড়ে কাজ করে, ফলে হাঙ্গেরীয়কে ইংরেজিতে “reshape” না করে বরং হাঙ্গেরীয় হিসেবেই ধরা হয়।
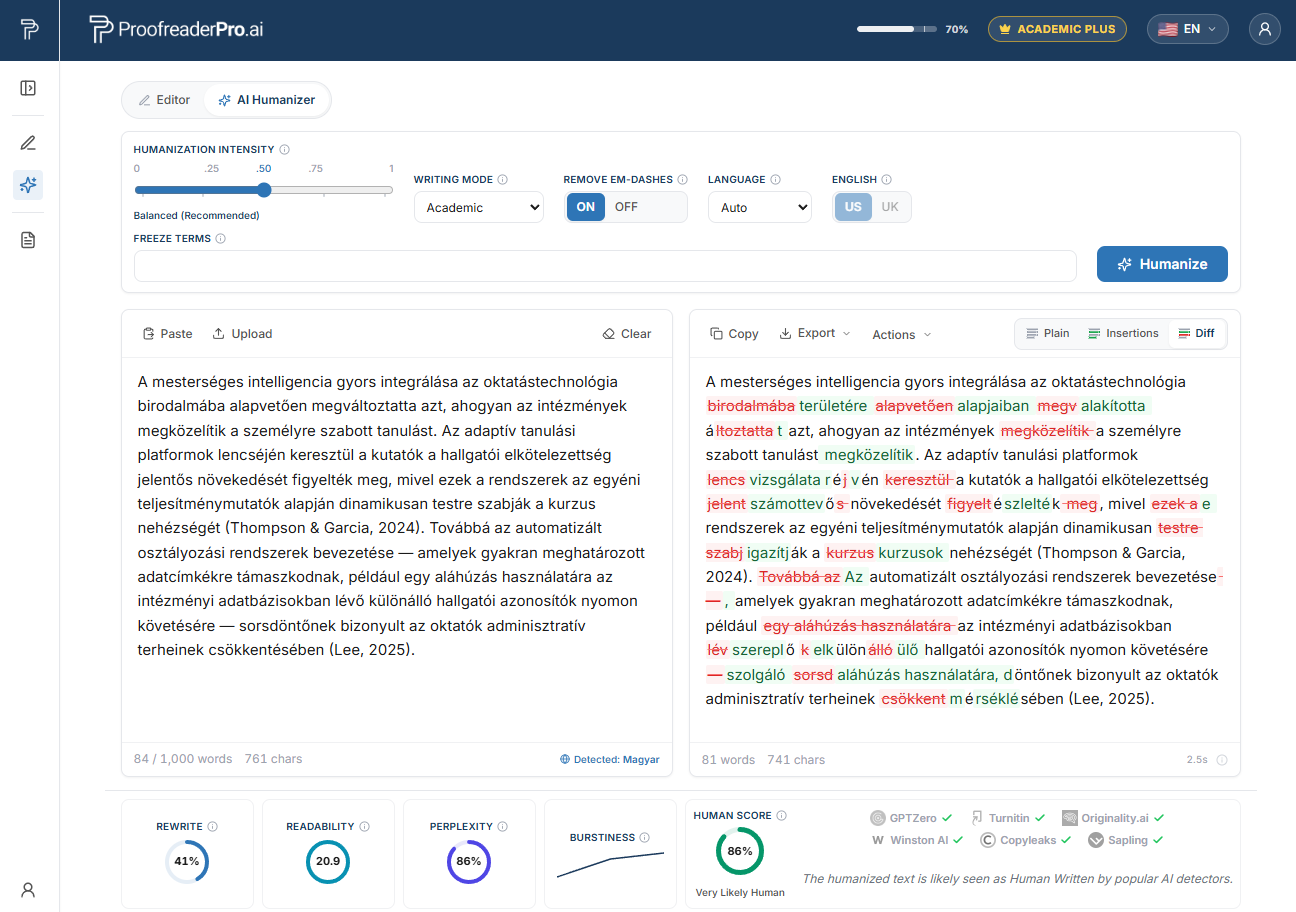
হাঙ্গেরীয় একাডেমিক লেখাকে পুনর্লিখন করছে ProofreaderPro AI Humanizer। আগে-পরের diff আপনার অর্থ ও উদ্ধৃতিগুলো ঠিক রাখে, এবং ডিটেক্টর চেকগুলো দেখায় যে পাঠটা স্বাভাবিকভাবে মানুষ-পড়া।
কেন হাঙ্গেরীয় গবেষকেরা AI ডিটেক্টরে বেশি চিহ্নিত হন
২০২৩ সালে Weixin Liang-এর নেতৃত্বে একটি স্ট্যানফোর্ড গবেষণা দল সাতটি বহুল ব্যবহৃত GPT ডিটেক্টর পরীক্ষা করে দেখেছে, মানুষের লেখা প্রবন্ধে। প্রবন্ধগুলো TOEFL পরীক্ষার থেকে নেওয়া, তাই সেগুলোর প্রত্যেকটারই একজন মানুষ-লেখক ছিল, যিনি ছিলেন নেটিভ ইংরেজিভাষী নন। গড়ে, ওই প্রবন্ধগুলোর প্রায় ৬১% AI-generated হিসেবে চিহ্নিত হয়। নেটিভ ইংরেজি বক্তাদের লেখা প্রবন্ধে এই হার ছিল প্রায় ৫%। নন-নেটিভ প্রবন্ধগুলোর মধ্যে প্রায় প্রতি পাঁচটির মধ্যে একটির মতো, প্রায় ১৯.৮%, প্রতিটি ডিটেক্টরই সর্বসম্মতভাবে চিহ্নিত করেছে।
এই অংশটা আবার পড়ুন। ইংরেজি ছিল লেখকের দ্বিতীয় ভাষা, এ কারণে কেবল “non-native” হওয়ার জন্যই মানবিক লেখা দশ গুণেরও বেশি হারে চিহ্নিত হয়।
এই প্রক্রিয়াটিকে বলা হয় perplexity। অনেক ডিটেক্টর অনুমান করে, আপনার শব্দচয়নগুলো কতটা ভাষা মডেলের কাছে “পূর্বানুমেয়”। দ্বিতীয় ভাষায় লিখলে আপনি সেই নিরাপদ, সাধারণ এবং ঠিকঠাক গঠনগুলোতে ঝুঁকেন, কারণ যত্নবান লেখকেরাই সেটাই করেন। নিরাপদ ও সাধারণ মানে কম perplexity, এবং কম perplexity ঠিক সেই “fingerprint” যা এই টুলগুলো মেশিন-টেক্সট হিসেবে পড়তে প্রশিক্ষিত। আমরা why AI detectors flag non-native writers প্রবন্ধে পুরো প্রক্রিয়াটি খুঁটিয়ে ব্যাখ্যা করেছি, কিন্তু সংক্ষেপে কথা বললে, খুবই কঠিন সত্যটা হলো: আপনার গদ্যকে পরিষ্কার করে যে অভ্যাসগুলো, সেগুলোই সেটিকে মেশিন-টেক্সট হিসেবে চিহ্নিত হওয়ার দিকে ঠেলে দেয়।
false flag-এর পেছনে হাঙ্গেরীয় প্রথম-ভাষার ধরনগুলো
হাঙ্গেরীয় একটি Uralic ভাষা, যা আশেপাশের Indo-European ভাষাগুলোর সঙ্গে সম্পর্কিত নয়; আর এর যুক্তি সত্যিকার অর্থেই ইংরেজি থেকে আলাদা। এই পার্থক্য হাঙ্গেরীয়-ইংরেজি লেখায় কিছু “চিহ্ন/ফিঙ্গারপ্রিন্ট” রেখে যায়। এর কোনোটিই বুদ্ধিমত্তার ভুল নয়। এগুলোই একেবারে ভিন্ন ব্যাকরণের ছায়া; এবং সেটিকে পরিষ্কার ইংরেজিতে “স্মুথ” করে ফেললে ডিটেক্টরের কাছে তা সমতল ও পূর্বানুমেয় মনে হয়।
he ও she, এর জন্য একটি মাত্র সর্বনাম। হাঙ্গেরীয় ভাষায় তৃতীয় পুরুষে একটি মাত্র pronoun আছে এবং ব্যাকরণগত gender নেই; তাই ইংরেজিতে "he" ও "she" বদলে যায়। যারা এগুলো ঠিক করেন, তারা প্রায়ই সবচেয়ে নিরাপদ বিকল্পটি অতিরিক্ত ব্যবহার করেন, অথবা "the author" এবং "the participant"-কে কেন্দ্র করে বাক্য সাজান, যার ফলে গদ্য হয় খুবই সমান, ভ্যারিয়েশনে কম।
Articles ভিন্নভাবে বিতরণ। হাঙ্গেরীয় ভাষায় article ব্যবহার হয় (a, az, egy), কিন্তু সেগুলোর যুক্তি ইংরেজির থেকে আলাদা। definite এবং indefinite article বাদ পড়ে বা যোগ হয়, এবং যত্নসহকারে ঠিক করা সাধারণত প্রতিবারই সবচেয়ে মানানসই, পাঠ্যবই-ধাঁচের article বেছে নেয়। “Standard”, ঠিক সেটাই মেশিন-জাতীয় স্কোর পায়।
Agglutination এবং ভারী nominalisation। হাঙ্গেরীয় অর্থ নির্মাণ করে কোনো এক stems-এর সঙ্গে ধারাবাহিকভাবে suffix বসিয়ে। সেটি ইংরেজিতে স্থানান্তরিত হলে সেই অভ্যাস ঘন ঘন noun phrase এবং দীর্ঘ nominalised chain তৈরি করে ("the implementation of the optimisation of..."), যেগুলো ব্যাকরণগতভাবে নিখুঁত, কিন্তু ছন্দগতভাবে একঘেয়ে। ডিটেক্টররা একঘেয়েমি পছন্দ করে, অর্থাৎ একঘেয়েমিই তারা খোঁজে।
Topic-prominent word order। হাঙ্গেরীয় বাক্যের topic এবং focus-কে সামনে আনে, ফলে জোর/এমফ্যাসিস এমন এক জায়গায় পড়ে যা ইংরেজি পাঠকের প্রত্যাশার চেয়ে আলাদা। একজন লেখক যখন এটিকে সাধারণ subject-verb-object ইংরেজিতে স্বাভাবিক করে লেখেন, ফল হয় সঠিক, গুছানো এবং পূর্বানুমেয়।
Future tense marker নেই এবং aspect সিস্টেম আলাদা। হাঙ্গেরীয় ভবিষ্যৎকে আলাদা পদ্ধতিতে চিহ্নিত করে এবং aspect-ও নিজের মতো করে পরিচালনা করে; ফলে ইংরেজির tense নির্বাচনগুলো অসামঞ্জস্যপূর্ণভাবে বেরিয়ে আসে, এরপর সবচেয়ে নিরপেক্ষ ও সাধারণ tense-এ টিউন করে ঠিক করা হয়। নিরাপদ tense আবারও সেই, সবচেয়ে কম perplexity-ধারার।
preposition-এর বদলে postposition। হাঙ্গেরীয় তার relational marker-গুলো noun-এর পরে বসায়; ফলে ইংরেজিতে preposition slip হয়। এই slip ঠিক করতে প্রতিবারই মানানসই preposition ধরে ফেলতে হয়, এবং standard, ঠিক সেটাকেই ডিটেক্টর উৎপন্ন হিসেবে ধরে।
ভুল ফ্ল্যাগ থেকে আপনার যত্নসহকারে লেখা হাঙ্গেরীয়-ইংরেজিকে সুরক্ষিত করুন
প্রতিটি উদ্ধৃতি, টার্ম, এবং ফলাফল অক্ষুণ্ণ রেখে আপনার নিজস্ব AI-সহায়তাপ্রাপ্ত খসড়াটিকে আরও মানবসুলভ করুন, তারপর আত্মবিশ্বাসের সাথে আপনার টুলগুলো প্রকাশ করুন।
Humanizer ফ্রি করে দেখুনহাঙ্গেরির AI-ডিটেকশন ও Turnitin প্রসঙ্গ
হাঙ্গেরীয় প্রতিষ্ঠানের থিসিস ও জার্নাল সাবমিশনগুলো নিয়মিতভাবে টেক্সট সাদৃশ্যের জন্য স্ক্রিন করা হয়, বেশিরভাগ সময় Turnitin বা সমজাতীয় কোনো সিস্টেম দিয়ে, এবং AI-ইন্ডিকেটরগুলো ক্রমেই একই স্ক্রিনিং প্রক্রিয়ার মধ্যে যুক্ত হচ্ছে। এটি এখন ডক্টরাল ডিফেন্স এবং ম্যানুস্ক্রিপ্ট রিভিউ-এর একটি স্বাভাবিক অংশ, অসাধারণ কোনো ধাপ নয়।
এই টুলগুলোর সীমাবদ্ধতাও মনে রাখা জরুরি। বিদেশের কয়েকটি বড় বিশ্ববিদ্যালয়, যেমন Vanderbilt, false positives এবং নন-নেটিভ লেখকদের বিরুদ্ধে bias-এর কারণে Turnitin-এর AI-writing detector বন্ধ করে দিয়েছে; এবং Turnitin নিজেও তার সর্বনিম্ন স্কোরগুলো দমন করে ও সতর্ক করে যে, তার এই সংখ্যাটি একাই কোনো integrity কেসের সিদ্ধান্ত নির্ধারণ করা উচিত নয়। একটি ডিটেক্টর স্কোর হলো এমন এক দাবি, যার বিরুদ্ধে আপনি আপত্তি তুলতে পারেন, এটা কোনো চূড়ান্ত রায় নয়।
হাঙ্গেরীয় প্রতিষ্ঠানগুলো generative AI নিয়ে নিজেদের গাইডলাইন প্রকাশ করেছে, এবং ফান্ডার ও জার্নালগুলো ক্রমেই লেখকদের কাছ থেকে আশা করছে, এই টুলগুলো কীভাবে ব্যবহার হয়েছে তা তারা জানাবে। সৎ উত্তর হলো, কিছুই আড়াল না করা। দায়িত্বশীলভাবে লিখুন ও সম্পাদনা করুন, তারপর আপনি যে টুলগুলোর ওপর নির্ভর করেছিলেন সেগুলো ঘোষণা করুন।
শীর্ষ হাঙ্গেরীয় বিশ্ববিদ্যালয় এবং কোথায় AI চেক দেখা যায়
সাদৃশ্য ও AI-ইন্ডিকেটরের জন্য স্ক্রিনিং হাঙ্গেরির উচ্চশিক্ষা ব্যবস্থার জুড়ে দেখা যায়, ডক্টরাল স্কুল থেকে শুরু করে জার্নালের সম্পাদকীয় অফিস পর্যন্ত। দেশের গবেষণাভিত্তিকভাবে গুরুত্বপূর্ণ কিছু প্রতিষ্ঠানের থিসিস ও ম্যানুস্ক্রিপ্ট এই চেকগুলোর মধ্য দিয়ে যায়:
- Eötvös Loránd Tudományegyetem (Eötvös Loránd University, ELTE), বুদাপেস্ট
- Semmelweis Egyetem (Semmelweis University), বুদাপেস্ট, একটি প্রধান মেডিক্যাল স্কুল
- Szegedi Tudományegyetem (University of Szeged), সেজেড
- Debreceni Egyetem (University of Debrecen), ডেব্রেসেন
- Budapesti Műszaki és Gazdaságtudományi Egyetem (Budapest University of Technology and Economics, BME), বুদাপেস্ট
- Budapesti Corvinus Egyetem (Corvinus University of Budapest), বুদাপেস্ট
- Pécsi Tudományegyetem (University of Pécs), পেচ
- Pázmány Péter Katolikus Egyetem (Pázmány Péter Catholic University), বুদাপেস্ট
- Óbudai Egyetem (Óbuda University), বুদাপেস্ট
আপনার কাজ যদি ELTE-তে ডিফেন্ড করা কোনো ডিসার্টেশন হয় কিংবা Semmelweis-এর কোনো ক্লিনিক্যাল ম্যানুস্ক্রিপ্ট, সব ক্ষেত্রেই একই গতিশীলতা কাজ করে: স্ট্যান্ডার্ড, যত্নসহকারে লেখা হাঙ্গেরীয়-ইংরেজি সেই লেখাটাই, যার “perplexity”-ভিত্তিক ফ্ল্যাগে পড়ার সম্ভাবনা সবচেয়ে বেশি।
হাঙ্গেরীয় গবেষকদের জন্য AI humanizer কীভাবে কাজ করে
আমরা যে ওয়ার্কফ্লো সুপারিশ করি তা সহজ এবং, আরও গুরুত্বপূর্ণভাবে, সৎ। এতে তিনটি ধাপ রয়েছে।
প্রথম ধাপ, draft। আপনার পেপার এমনভাবে খসড়া করুন যাতে আপনার চিন্তাগুলো সবচেয়ে দ্রুত পাতায় উঠে আসে। অনেক হাঙ্গেরীয় গবেষকের জন্য এর মানে হলো হাঙ্গেরীয় ভাষায় ড্রাফট করে অনুবাদ করা, অথবা AI সহায়তায় সরাসরি ইংরেজিতে লেখা। যেটাই হোক, দুটিই গ্রহণযোগ্য।
দ্বিতীয় ধাপ, মূল লেখাটি proofread করা। ব্যাকরণ, পরিভাষা এবং যুক্তি ঠিক করুন যাতে বিজ্ঞানটি সঠিক থাকে। যদি ভাষা নিজেই যত্নসহকারে একটি পাস প্রয়োজন করে, আমাদের global academic editing hub সেই অংশটাই কভার করে।
তৃতীয় ধাপ, নিজের খসড়াটিকে humanize করুন। এখানেই text humanizer কাজে আসে। এটি বাক্যের দৈর্ঘ্য ও ছন্দ বদলে দেয়, aggultinative হাঙ্গেরীয়-ইংরেজি যে একঘেয়ে cadence তৈরি করতে চায় তা ভেঙে দেয়, এবং অতিরিক্ত em dash ও পুনরাবৃত্তিমূলক কাঠামো সরিয়ে দেয়—যেগুলো দুই ধরনের AI টুলই এবং দ্বিতীয় ভাষার অভ্যাসও রেখে যায়। সবচেয়ে গুরুত্বপূর্ণ বিষয় হলো, এটি আপনার অর্থ, আপনার টেকনিক্যাল শব্দভাণ্ডার, এবং প্রতিটি উদ্ধৃতিই ধরে রাখে। নন-ইংলিশ উৎস টেক্সট ভাষা-সচেতন একটি মডেলের মধ্য দিয়ে যায়, এবং টুলটি ষাটেরও বেশি ভাষা সমর্থন করে।
এতে কী অর্জিত হয়? আমাদের নিজস্ব পরীক্ষায় দেখা গেছে, যত্নসহকারে লেখা নন-নেটিভ খসড়াকে humanize করলে বড় ডিটেক্টরগুলো সেটিকে কতবার ভুলভাবে “machine-written” হিসেবে পড়ছে, সেই হার উল্লেখযোগ্যভাবে কমে যায়; তবে একাডেমিক অর্থ অক্ষুণ্ণ থাকে। আমরা এটাকে “আমাদের দেখা ফল” হিসেবে বর্ণনা করেছি, প্রতিশ্রুতি হিসেবে নয়। কোনো সৎ টুলই এখানে ১০০% ফল নিশ্চয়তা দিতে পারে না, কারণ ডিটেক্টরগুলো প্রতি কয়েক মাস পর পর নতুন করে প্রশিক্ষিত হয়; আর যে কোনো সার্ভিস “১০০% undetectable” বলে দাবি করলে তা এমন কিছু বিক্রি করছে যা তারা সরবরাহ করতে পারে না।
এরপর শেষ ধাপ: disclose। আপনার বিশ্ববিদ্যালয় এবং টার্গেট জার্নাল যে ফরম্যাট চায় সেই ফরম্যাটে একটি AI-use statement যোগ করুন। আপনার নিজের AI-সহায়তাপ্রাপ্ত লেখা humanize করা এবং সেটি ঘোষণা করা কোনো কৌশল নয়। এটি নিশ্চিত করা, যাতে আপনার যত্নসহকারে করা কাজকে তার গুণগত মানের ভিত্তিতে বিচার করা হয়, বরং দ্বিতীয় ভাষায় স্পষ্ট হওয়ার অপরাধে ফ্ল্যাগ করার জন্য নয়। দেশজুড়ে বৃহত্তর ভাষাগত প্রেক্ষাপট দেখতে দেখুন আমাদের multilingual AI humanizer hub.
স্থানীয় অর্থায়নকারী সংস্থা, জার্নাল, এবং AI-disclosure প্রত্যাশা
হাঙ্গেরিতে প্রতিযোগিতামূলক গবেষণা মূলত NKFIH (Nemzeti Kutatási, Fejlesztési és Innovációs Hivatal, the National Research, Development and Innovation Office)-এর মাধ্যমে অর্থায়ন করা হয়; জাতীয় একাডেমি হিসেবে MTA (Magyar Tudományos Akadémia, the Hungarian Academy of Sciences) রয়েছে; এবং জনসাধারণের গবেষণা প্রতিষ্ঠানগুলো পরিচালনা করে HUN-REN (the Hungarian Research Network)। এদের সকলেই প্রকাশিত, ইনডেক্সড আউটপুটকে পুরস্কৃত করে, যা গবেষকদের ওপর ইংরেজিতে প্রকাশ করার চাপ স্থিরভাবে বজায় রাখে।
এই আউটপুট পরিমাপ করা হয় Web of Science এবং Scopus-ইনডেক্সড জার্নালগুলোর মাধ্যমে, এবং তা MTMT (Magyar Tudományos Művek Tára, the Hungarian Scientific Bibliography)-তে নিবন্ধিত হয়, যা জাতীয় প্রকাশনা ডেটাবেস। মূল্যায়ন-সংস্কৃতি আন্তর্জাতিক, ইংরেজি ভাষায় প্রকাশনাকে উৎসাহ দেয়; আর ঠিক এই চাপটিই হাঙ্গেরীয় গবেষকদের সেই পরিষ্কার, মানানসই গদির দিকে ঠেলে দেয়, যেটিকে ডিটেক্টররা ভুল পড়ে ফেলে।
AI-use disclosure অনুদান প্রতিবেদনে এবং জার্নাল সাবমিশন, দুটিতেই ক্রমে বেশি সাধারণ হয়ে উঠবে বলে আশা করুন। এটিকে রুটিন হিসেবে ধরুন। আপনি কোন টুলগুলো ব্যবহার করেছেন এবং কীভাবে, এটি সরাসরি বলুন, আপনার ডেটা ও উদ্ধৃতিগুলো সৎ রাখুন, এবং আপনি যেন অন্যায় ফ্ল্যাগের বিরুদ্ধে আপনার লেখাকে রক্ষা করেও স্বাচ্ছন্দ্যে নিয়মের ভেতরেই থাকেন।
প্রায়শই জিজ্ঞাসিত প্রশ্নাবলি
Q: Does the AI humanizer for Hungarian researchers change my citations or technical terms?
না। humanizer এমনভাবে তৈরি করা হয়েছে যাতে আপনার অর্থ, বিষয়ভিত্তিক বিশেষায়িত পরিভাষা, এবং আপনি যেভাবে লিখেছেন ঠিক সেভাবেই প্রতিটি রেফারেন্স অক্ষুণ্ণ থাকে। এটি ছন্দ ও বাক্যগঠন বদলায়, কিন্তু আপনার বিজ্ঞান বা উৎসসমূহকে বদলায় না।
Q: Can any tool guarantee my paper will pass every AI detector?
না, এবং এরকম দাবি করা কারও ওপর আপনার সন্দেহ থাকা উচিত। ডিটেক্টরগুলো নিয়মিতভাবে পুনরায় প্রশিক্ষিত হয়, তাই কোনো সৎ সার্ভিসই ১০০% undetectable হওয়ার প্রতিশ্রুতি দিতে পারে না। আমরা যা বলতে পারি তা হলো, আমাদের পরীক্ষায় দেখা গেছে, যত্নসহকারে লেখা নন-নেটিভ গদ্যকে humanize করলে সেটিকে ভুলভাবে “machine-written” হিসেবে পড়ার হার উল্লেখযোগ্যভাবে কমে।
Q: Is humanizing my own draft a form of cheating?
এটি cheating নয়, যদি আপনি নিজের AI-সহায়তাপ্রাপ্ত লেখার কাজ নিজেই করেন, আপনার ফলাফলগুলো সৎ রাখেন, এবং আপনার প্রতিষ্ঠান ও জার্নাল যে অনুযায়ী tool use disclose করতে বলে সেটা অনুসরণ করেন। লক্ষ্য হলো আসল কাজের ক্ষেত্রে ন্যায্যতা, আড়াল নয়।
Q: Why does my clear English get flagged when weaker writing does not?
কারণ অনেক ডিটেক্টর predictability স্কোর করে। যত্নশীল দ্বিতীয় ভাষায় লেখকেরা নিরাপদ, মানানসই ও সঠিক গঠন বেছে নেন, ফলে কম perplexity টেক্সট তৈরি হয়, এবং কম perplexity হলো ঠিক সেই প্যাটার্ন যেটিকে এই টুলগুলো মেশিন লেখার সঙ্গে যুক্ত করে। আপনার স্পষ্টতা আপনার বিরুদ্ধে কাজ করে।
Q: I write in Hungarian first. Does the tool handle that?
হ্যাঁ। নন-ইংলিশ টেক্সট ভাষা-সচেতন একটি মডেলের মধ্য দিয়ে যায়, যা ষাটেরও বেশি ভাষা জুড়ে বাক্যগঠন ও অর্থ সংরক্ষণ করে, তাই আপনি হাঙ্গেরীয় ভাষায় ড্রাফট করতে পারেন, তারপর অনুবাদ করতে পারেন, এবং এরপর ইংরেজি সংস্করণটি humanize করতে পারেন; এতে আপনার যুক্তি হারাবে না।
প্রতিটি উদ্ধৃতি এবং ফলাফল অক্ষুণ্ণ রেখে আপনার যত্নসহকারে, AI-সহায়তাপ্রাপ্ত হাঙ্গেরীয়-ইংরেজি খসড়াটিকে প্রাকৃতিক একাডেমিক গদ্যে রূপ দিন, তারপর আত্মবিশ্বাসের সাথে আপনার AI ব্যবহার প্রকাশ করুন।

Moe একজন NLP ইঞ্জিনিয়ার একজন PhD সহ প্রাকৃতিক ভাষা প্রক্রিয়াকরণে। তার গবেষণা কম্পিউটেশনাল ভাষাতত্ত্ব, পাঠ্য বিশ্লেষণ এবং মেশিন লার্নিংকে কভার করে এবং এটি সরাসরি ProofreaderPro-এর পিছনে সম্পাদনা এবং মানবীকরণ মডেলগুলিতে যোগ করে। তিনি প্রক্রিয়াটির অংশ সম্পর্কে লিখেছেন যা বেশিরভাগ লোকেরা কখনই দেখে না: কীভাবে একটি ভাষা মডেল একটি বাক্য পড়ে, স্কোর করে এবং কী পরিবর্তন করতে হবে তা সিদ্ধান্ত নেয়।


