
ইংরেজিতে লিখছেন, ডাচ গবেষকদের জন্য AI হিউম্যানাইজার
ডাচ গবেষকদের জন্য AI হিউম্যানাইজার। ডাচ-প্রভাবিত ইংরেজিতে ভুলভাবে AI-ডিটেকশনের (AI detection) ফ্ল্যাগ পড়ার হার কমান, অর্থ ও উদ্ধৃতি (citations) অক্ষুণ্ণ রাখুন, এবং সৎভাবে প্রকাশ করুন।

নেদারল্যান্ডস পৃথিবীর প্রায় যেকোনো দেশের তুলনায় মাথাপিছু আরও বেশি উচ্চ-প্রভাবসম্পন্ন গবেষণা প্রকাশ করে, এবং তার প্রায় সবটাই ইংরেজিতে লেখা দেখা যায়। EF English Proficiency Index-এ ডাচ একাডেমিকরা প্রতি বছর শীর্ষের দিকে বা একেবারে শীর্ষে অবস্থান করে, তাই আমস্টারডাম বা ডেলফ্ট থেকে আসা একটি ম্যানুস্ক্রিপ্ট সাধারণত পরিষ্কার, নির্ভুল এবং ব্যাকরণগতভাবে পাঠ্যবই-মানেরভাবে পৌঁছায়। এরপর একই পরিপাটি গদ্য পড়ে একটি AI ডিটেক্টর সেটিকে উচ্চ "AI-generated" সম্ভাবনা দিয়ে ফেরত দিতে পারে, এবং যিনি প্রতিটি শব্দ হাতে লিখেছেন সেই সতর্ক গবেষক হঠাৎ করে নিজেকে ব্যাখ্যা করতে বলা হয়। ডাচ গবেষকদের জন্য AI হিউম্যানাইজার ঠিক এই সমস্যাটির সমাধান করতে তৈরি।
এখন অস্বস্তিকর বিদ্রূপটি দেখা যাক। আপনার ইংরেজি যত ভালো, আপনার বাক্যভঙ্গি সাধারণত ততটাই বেশি মানসম্মত ও পূর্বানুমেয়, আর পূর্বানুমেয় গদ্যই বর্তমানে ব্যবহৃত ডিটেক্টরগুলোর কাছে মেশিন-লেখা হিসেবে ধরা পড়ার একেবারে নিখুঁত উপাদান। শক্তিশালী ডাচ-ইংরেজি কোনোভাবেই একটি পত্রকে false flag থেকে রক্ষা করে না। কিছু ক্ষেত্রে তা এমন ফ্ল্যাগ ডেকে আনে।
এই গাইডে ব্যাখ্যা করা হয়েছে কেন বিষয়টি ঘটে, ডাচের মাতৃভাষাভিত্তিক কোন অভ্যাসগুলো false flag ট্রিগার করে, নেদারল্যান্ডসের বিশ্ববিদ্যালয়গুলোতে similarity ও AI screening বাস্তবে কীভাবে কাজ করে, এবং কীভাবে আপনি নিজের লেখাকে সৎভাবে সুরক্ষিত করবেন: আপনি যে AI-সহায়তায় খসড়া ইতিমধ্যেই লিখেছেন সেটিকে humanize করুন, আপনার অর্থ ও citations অক্ষুণ্ণ রাখুন, তারপর আপনার প্রতিষ্ঠান ও জার্নাল যেভাবে চাইছে সেভাবেই আপনার AI ব্যবহারটি প্রকাশ করুন।
ইংরেজিতে প্রকাশ করতে চাওয়া নেদারল্যান্ডসের গবেষকদের জন্য AI-tekst humaniseren
আমাদের humanizer ডাচ গবেষকদের তাদের ইংরেজি ম্যানুস্ক্রিপ্ট এমনভাবে প্রকাশ করতে সাহায্য করে যেন যত্নশীল, সঠিক প্রোজা ভুল করে machinetekst (মেশিন টেক্সট) হিসেবে চিহ্নিত না হয়। AI-tekst humaniseren-এর লক্ষ্য খুবই সহজ: অর্থ, পরিভাষা এবং উৎস-উল্লেখ (sourcevermeldingen) ঠিক একই থাকে, কিন্তু ছন্দ (ritme) ও শব্দচয়ন (woordkeuze) আরও স্বাভাবিক হয়।
সোজা ইংরেজিতে বললে: humanizer আপনি যে খসড়াটি আগে থেকেই লিখেছেন (বা AI সহায়তায় খসড়া করেছেন) সেটির ওপর কাজ করে। এটি বাক্যের rhythm বদলায়, পুনরাবৃত্ত cadence ভেঙে দেয়, এবং ডিটেক্টরকে যে “টেলস” (চিহ্ন) ট্রিপ করে সেগুলো সরিয়ে দেয়, আপনার যুক্তি (argument), আপনার ডেটা (data), বা আপনার রেফারেন্স (references) স্পর্শ না করেই। ইংরেজি ছাড়া অন্য ভাষার টেক্সটের ক্ষেত্রে এটি ভাষা-সচেতন একটি মডেলের মধ্য দিয়ে রাউট করে, যা ষাটেরও বেশি ভাষাজুড়ে গঠন (structure) ও অর্থ (meaning) সংরক্ষণ করে।
ডাচ ভাষায় লিখছেন? এটি স্বয়ংক্রিয়ভাবে শনাক্ত হয় এবং সরাসরি humanize করা হয়
আপনার ডাচ খসড়াটি humanize করার আগে ইংরেজিতে অনুবাদ করতে হবে না। ডাচ টেক্সট পেস্ট করুন, ProofreaderPro নিজের থেকেই ভাষাটি শনাক্ত করবে, তারপর এটি ডাচ-সচেতন একটি মডেলের মধ্য দিয়ে রাউট করবে, যা আপনার পরিভাষা, যৌগিক শব্দ (compound words), এবং উদ্ধৃতিগুলো (citations) ঠিক যেমন লেখা আছে তেমনভাবেই রাখে। অর্থাৎ, আপনার প্রথম ভাষা ডাচের ক্ষেত্রেই AI-tekst humaniseren প্রয়োগ হচ্ছে: আপনার ডাচ খসড়াটি ইংরেজির মতোই সহজে humanize হয়। একই শনাক্তকরণ (detection) ষাটেরও বেশি ভাষা জুড়ে কাজ করে, তাই ডাচকে ইংরেজিতে “চ্যাপ্টা” করে ফেলার বদলে ডাচ হিসেবেই আবার লেখা হয়।
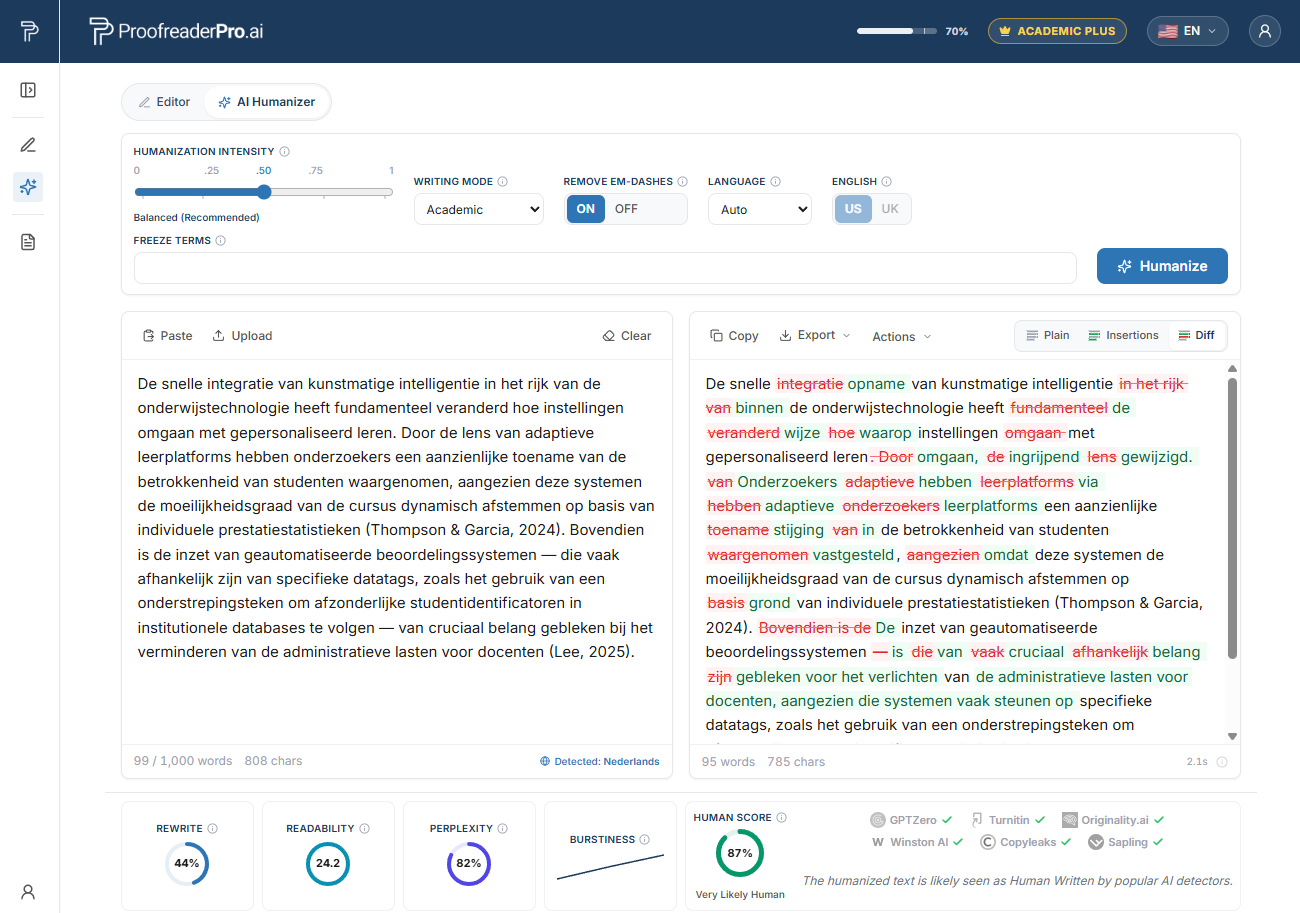
ডাচ একাডেমিক টেক্সটকে পুনর্লিখন করে ProofreaderPro AI Humanizer। আগে ও পরে diff আপনার অর্থ ও citations বজায় রাখে, আর detector চেক নিশ্চিত করে যে পড়াটা স্বাভাবিক এবং মানুষের মতো।
কেন ডাচ গবেষকরা AI ডিটেক্টর দ্বারা ফ্ল্যাগ পান
২০২৩ সালে স্ট্যানফোর্ডের নেতৃত্বাধীন একটি টিম, Weixin Liang-এর নেতৃত্বে, Cell Press জার্নাল Patterns-এ একটি সরাসরি শিরোনামের গবেষণা প্রকাশ করে: "GPT detectors are biased against non-native English writers." তারা মানব-লেখা TOEFL প্রবন্ধ সাতটি বহুল ব্যবহৃত AI ডিটেক্টরের মধ্য দিয়ে চালায়। গড়ে, নন-নেটিভ প্রবন্ধগুলোর প্রায় ৬১% AI-generated হিসেবে ফ্ল্যাগ হয়েছিল। নেটিভ ইংরেজি বক্তাদের প্রবন্ধে এই হার প্রায় ৫%। মোটামুটিভাবে প্রতি পাঁচটি নন-নেটিভ প্রবন্ধের মধ্যে একটিতে, প্রায় ১৯.৮%, সব ডিটেক্টরই একযোগে (unanimously) ফ্ল্যাগ করেছিল। এদের প্রতিটিতেই একজন মানুষই লিখেছে।
মেকানিজমটা বোঝা মূল্যবান, কারণ এটি ব্যাখ্যা করে কেন fluency কোনো ঢাল নয়। বেশিরভাগ ডিটেক্টর perplexity নামে একটি জিনিস স্কোর করে, যা ভাষা মডেলের কাছে প্রতিটি শব্দচয়নের “কতটা আশ্চর্যজনক” তা মাপে। যে লেখা সাধারণ শব্দগুলোকে মানসম্মত ও প্রত্যাশিত কম্বিনেশনে ব্যবহার করে, সেটির perplexity কম; আর কম perplexity ডিটেক্টরের চোখে মেশিন-লেখা হিসেবেই পড়ে। যত্নশীল একাডেমিক লেখকেরা, বিশেষ করে যারা দ্বিতীয় ভাষায় কাজ করেন, ঠিক এই কারণেই স্পষ্ট, প্রচলিত (conventional) বাক্যভঙ্গির দিকে ঝোঁকেন, কারণ সেটাই নিরাপদ ও সঠিক। আপনার গদ্যকে পাঠযোগ্য করে তোলে এমন অভ্যাসগুলোই ডিটেক্টররা শাস্তি দিতে (punish) প্রশিক্ষিত।
ডাচ গবেষকেরা এখানে এক ধরনের অস্বস্তিকর অবস্থানে থাকেন। নেদারল্যান্ডসে ইংরেজি দক্ষতা অসাধারণ, ফলে ডাচ একাডেমিক ইংরেজি প্রায়ই গড় নেটিভ খসড়ার চেয়ে বেশি পরিষ্কার ও বেশি মানসম্মত থাকে। এই পালিশ (polish) আরও perplexity কমিয়ে দেয়। আমরা এই গতিশীলতা নিয়ে why AI detectors flag non-native writers শিরোনামে একটি পূর্ণ ব্যাখ্যা লিখেছিলাম, এবং এটি ডাচ কাজের ক্ষেত্রে অস্বাভাবিক জোরে প্রযোজ্য।
false flag-এর পেছনে ডাচ মাতৃভাষার প্যাটার্নগুলো
নিচের কোনো প্যাটার্নই ভুল নয়। এগুলো সঠিক, যত্নশীল এবং মানসম্মত গঠন, আর এই মানসম্মততাই (standardness) ঠিক সেই জিনিস, যেটাকে একটি ডিটেক্টর কম-perplexity, মেশিনের মতো টেক্সট হিসেবে পড়ে। কয়েকটি উদাহরণ দেখায় কীভাবে ডাচ অভ্যাসগুলো ইংরেজি গদ্য গঠন করে।
ডাচ ও ইংরেজি অনেক vocabulary শেয়ার করে, ফলে নির্ভরযোগ্য false friend তৈরি হয়। "Actueel" মানে current, "actual" নয়; "eventueel" মানে possibly, "eventually" নয়; "controleren" মানে to check, "to control" নয়। যেসব ডাচ গবেষক এই ফাঁদগুলো এড়াতে শেখেন, তারা প্রায়ই এমন এক ধরনের ইচ্ছাকৃত, সতর্ক নির্ভুলতায় লিখেন যা variation-কে “সমতল” করে দেয়। ফলাফল হয় ধারাবাহিক ও সঠিক লেখা, আর consistency নিজেই একটি perplexity সংকেত।
আরেকটি নিরব সংকেত হলো word order। ডাচ ভাষায় একটি clause-এর মধ্যে finite verb দ্বিতীয় অবস্থানে থাকে; ফলে adverb-fronted একটি বাক্য ইংরেজিতে এমনভাবে দেখা দিতে পারে: "Therefore is the result significant" বা "In this study investigate we the effect." অনেক ডাচ লেখক জমা দেওয়ার আগেই এটি ঠিক করে নেন, কিন্তু সেই সংশোধন এমন ধরনের পরিচ্ছন্ন, canonical sentence structure তৈরি করে, যেটার সঙ্গে ডিটেক্টররা generated text-কে যুক্ত করে।
তারপর আসে আর্টিকেলগুলো (articles)। ডাচে generic ও abstract nouns-এর আগে definite article বসানো যায়, ফলে খসড়ায় থাকে যেমন "the research shows," "the society," বা "the nature of the problem", যেখানে ইংরেজিতে সাধারণত article বাদ পড়বে। এগুলো আনুষ্ঠানিক (formal) ও নির্ভুল মনে হয়। এগুলো আবার খুব নিয়মিতও (very regular) পড়ে।
আরো দুটি অভ্যাস সবকিছু সম্পূর্ণ করে। ডাচ ভারী noun phrase এবং nominalization পছন্দ করে, যেমন "the realisation of the implementation of," ধরনের কম্বিনেশনগুলোকে স্তরে স্তরে সাজিয়ে দেয়, এবং পাশাপাশি discourse marker ব্যবহার করে যেমন "namely" (namelijk) এবং "respectively" (respectievelijk)। এগুলো প্রায়ই এমন এক ধরনের সরাসরি, রূঢ় (blunt) রেজিস্টারে আসে, যেটা অনেক সময় রিভিউয়াররা সংক্ষিপ্ত বা তীক্ষ্ণ (terse) বলে পড়ে ফেলেন। এগুলোর প্রতিটিই ব্যাকরণগতভাবে একেবারেই ঠিক। একসাথে এগুলো এমন এক মসৃণ, কম-আশ্চর্যের (low-surprise) টেক্সচার বানায়, যেটার বিরুদ্ধে একটি ডিটেক্টর আপনার লেখা স্কোর করে।
নিজের লেখাকে সুরক্ষিত করুন, সৎভাবে
আপনার অর্থ, পরিভাষা এবং উদ্ধৃতি অক্ষুণ্ণ রেখে AI-সহায়ক খসড়াটিকে মানবিক করুন, তারপর আপনার জার্নাল যেমনভাবে চায় ঠিক সেভাবে আপনার AI ব্যবহারের বিষয়টি প্রকাশ করুন।
Humanizer ফ্রি করে দেখুননেদারল্যান্ডসের AI-detection এবং Turnitin প্রসঙ্গ
ডাচ থিসিস ও জার্নাল সাবমিশনগুলো নিয়মিতভাবে similarity-এর জন্য স্ক্রিন করা হয়, সবচেয়ে বেশি ক্ষেত্রে Turnitin বা iThenticate দিয়ে, এবং প্রতিষ্ঠানগুলো ধীরে ধীরে AI সূচক (AI indicators) যোগ করছে পুরনো plagiarism চেকগুলোর পাশাপাশি। এখন এটি ব্যতিক্রম নয়; সাবমিশন পাইপলাইনের একেবারে স্বাভাবিক অংশ।
নেদারল্যান্ডসের ইউনিভার্সিটিগুলো (UNL) এবং পৃথক পৃথক প্রতিষ্ঠানগুলো generative-AI সম্পর্কিত নির্দেশিকা প্রকাশ করেছে, এবং সামগ্রিক দিকটি পরিষ্কার: অনেক কাজে AI টুল অনুমোদিত, কিন্তু সেটার ব্যবহার লুকিয়ে না রেখে প্রকাশ করা উচিত। ফান্ডার ও জার্নালগুলোও একই পথে এগোচ্ছে, লেখকদের কাছে জানতে চাওয়া হচ্ছে কোথায় এবং কীভাবে তাদের কাজে AI সহায়তা করেছে।
ডিটেক্টরের স্কোর আসলে কতটা ওজন (weight) বহন করে সেটি মনে রাখা গুরুত্বপূর্ণ। Turnitin ১ থেকে ১৯% রেঞ্জে AI স্কোরকে suppress করে এবং সতর্ক করে যে কেবল তার সংখ্যাটিকে একা integrity সিদ্ধান্ত নেওয়ার ভিত্তি হিসেবে ব্যবহার করা উচিত নয়। কয়েকটি বড় প্রতিষ্ঠান আরও এক ধাপ পিছিয়েছে: Vanderbilt ২০২৩ সালে Turnitin-এর AI ডিটেক্টর নিষ্ক্রিয় করে দেয়, false positives ও নন-নেটিভ লেখকদের বিরুদ্ধে bias উল্লেখ করে, এবং Michigan State, Northwestern, ও University of Pittsburghও অনুরূপ পদক্ষেপ নিয়েছে। একটি ডিটেকশন ফ্ল্যাগ হলো এমন একটি দাবি, যেটি আপনি চ্যালেঞ্জ করতে পারেন, কোনো চূড়ান্ত রায় নয়, যা আপনাকে “দিয়ে দেওয়া” হয়েছে।
শীর্ষ ডাচ বিশ্ববিদ্যালয় এবং কোথায় AI চেক দেখা যায়
ডাচ সিস্টেমজুড়েই স্ক্রিনিং হয়। নিচের প্রতিষ্ঠানগুলো সবই থিসিস ও ম্যানুস্ক্রিপ্টে similarity-এর জন্য পরীক্ষা করে, সাধারণত Turnitin বা iThenticate দিয়ে, এবং ক্রমশ AI সূচকও (AI indicators) বিবেচনায় আনে:
- Universiteit van Amsterdam (UvA), Amsterdam
- Universiteit Utrecht, Utrecht
- Universiteit Leiden, Leiden
- Technische Universiteit Delft (TU Delft), Delft
- Erasmus Universiteit Rotterdam (EUR), Rotterdam
- Rijksuniversiteit Groningen (RUG), Groningen
- Wageningen University & Research (WUR), Wageningen
- Radboud Universiteit, Nijmegen
- Vrije Universiteit Amsterdam (VU), Amsterdam
- Technische Universiteit Eindhoven (TU/e), Eindhoven
- Universiteit Twente (UT), Enschede
- Universiteit Maastricht (UM), Maastricht
- Tilburg University, Tilburg
আপনি যদি Leiden-এ একটি ডিসার্টেশন ডিফেন্ড করেন কিংবা WUR-এর ল্যাব থেকে সাবমিট করেন, আপনার ডকুমেন্ট এই ধরনের চেকের মধ্য দিয়ে যাবে। আগে থেকেই এটি জানা আপনার ফাইনাল খসড়া কীভাবে প্রস্তুত করবেন, সেদিকে প্রভাব ফেলতে পারে।
ডাচ গবেষকদের জন্য AI humanizer কীভাবে কাজ করে
সৎ ও স্বচ্ছ workflow-এ তিনটি ধাপ আছে, এবং disclosure অংশটি, শেষ কথা হিসেবে পরে যোগ করা নয়।
প্রথম ধাপ: ড্রাফট। ইংরেজিতে লিখুন, বা ডাচ ভাষায় লিখে ট্রান্সলেট করুন, ভাবনা দ্রুত করতে চাইলে AI সহায়তা ব্যবহার করতে পারেন। AI-সহায়তায় প্রথম খসড়া তৈরি করায় কোনো ভুল নেই, যতক্ষণ না যুক্তি (argument), বিশ্লেষণ (analysis), এবং প্রমাণ (evidence) সত্যিই আপনারই হয়।
দ্বিতীয় ধাপ: proofread ও humanize করুন। ব্যাকরণ পরিষ্কার করুন, তারপর খসড়াটি AI humanizer–এর মধ্য দিয়ে চালান। এটি বাক্যের দৈর্ঘ্য বদলায়, মেশিন টেক্সটের সংকেত দেয় এমন পুনরাবৃত্ত cadence ভেঙে দেয়, এবং stray formatting-এর কিচ্ছির মতো টিকস (tics) সরিয়ে দেয়, কিন্তু আপনার অর্থ, আপনার প্রযুক্তিগত পরিভাষা, এবং আপনি যেখানে রেখেছেন ঠিক সেখানেই প্রতিটি citation রেখে দেয়। আমাদের নিজস্ব পরীক্ষায় দেখা গেছে, যত্নশীল, মানসম্মত নন-নেটিভ ইংরেজি প্রধান ডিটেক্টর যেমন Turnitin, Originality.ai, এবং GPTZero-এর কাছে ভুলভাবে কতবার পড়ে সেটি উল্লেখযোগ্যভাবে কমে, এবং একই সঙ্গে একাডেমিক অর্থ ও ব্যাকরণ বজায় থাকে। আমরা এটিকে প্রতিশ্রুতি হিসেবে নয়, পরীক্ষায় যা দেখেছি ঠিক সেটাই, এভাবে উপস্থাপন করি। ডিটেক্টরগুলো কয়েক মাস পরপর নিজেদের মডেল আপডেট করে, আর কোনো সৎ টুল ১০০% undetectable হওয়ার দাবি করতে পারে না। যে কেউ এটি নিশ্চিত করে গ্যারান্টি দিচ্ছে, তার মানে সে আপনাকে কিছু বিক্রি করছে।
তৃতীয় ধাপ: disclose করুন। আপনার সুপারভাইজার, আপনার প্রতিষ্ঠান, এবং যে টার্গেট জার্নালে আপনি সাবমিট করবেন, তারা যেভাবে চাইছে সেই ফরম্যাটে আপনার AI ব্যবহারটি লিখুন। এটাই মূল কথা। উদ্দেশ্য হলো AI লুকানো নয় বা কোনো similarity checker-কে ফাঁকি দেওয়া নয়; বরং নিশ্চিত করা, যাতে যত্নশীল, সঠিক লেখা ভুলভাবে মেশিন টেক্সট হিসেবে পড়া না হয়, এবং আপনি যেন integrity নিয়মের মধ্যে থেকেই তা করেন।
এই বিষয়বস্তুটি আমাদের multilingual AI humanizer hub-এর ভেতরে রয়েছে, যেখানে বহু ভাষাভিত্তিক পটভূমির গবেষকদের জন্য একই workflow কভার করা হয়। আপনার বড় প্রয়োজন যদি detection fairness-এর বদলে line-level ভাষা এডিটিং হয়, তাহলে আমাদের global academic editing hub শুরু করার জন্য আরও ভালো জায়গা।
স্থানীয় ফান্ডিং সংস্থা, জার্নাল, এবং AI-disclosure প্রত্যাশা
ডাচ প্রতিযোগিতামূলক ফান্ডিং মূলত NWO (Nederlandse Organisatie voor Wetenschappelijk Onderzoek, the Dutch Research Council)–এর মাধ্যমে চলে, যার অধীনে Talent প্রোগ্রামের গ্র্যান্ট Veni, Vidi, এবং Vici রয়েছে। স্বাস্থ্য ও চিকিৎসা-সংক্রান্ত কাজ ZonMw-এর মাধ্যমে ফান্ড করা হয় এবং KNAW (Koninklijke Nederlandse Akademie van Wetenschappen, the Royal Netherlands Academy of Arts and Sciences) জাতীয় গবেষণা সম্প্রদায়ের কেন্দ্রে অবস্থান করে। ডাচ দলগুলো European Research Council (ERC) গ্র্যান্টেরও বড় অংশ জিতে থাকে, এবং Plan S-এর অধীনে ওপেন-অ্যাকসেস প্রকাশনা NWO-ফান্ডেড আউটপুটের জন্য বাধ্যতামূলক।
প্রকাশনার দিক থেকে, ডাচ গবেষকেরা Web of Science ও Scopus–ইনডেক্সড জার্নালকে টার্গেট করেন, আউটপুটগুলো প্রতিষ্ঠানভিত্তিক রিপোজিটরিতে জমা দেন, এবং SURF ও বিশ্ববিদ্যালয়গুলোর সমন্বয়ে থাকা জাতীয় অবকাঠামো ব্যবহার করেন। ফান্ডার ও জার্নাল, দুই ক্ষেত্রেই AI নিয়ে প্রত্যাশা একই নীতির দিকে একীভূত হচ্ছে: আপনার ব্যবহার প্রকাশ করুন, লুকাবেন না। AI কোথায় এবং কীভাবে আপনার drafting-এ সহায়তা করেছে, এ বিষয়ে সংক্ষিপ্ত, সৎ একটি রেকর্ড রাখা গ্র্যান্ট রিপোর্ট বা সাবমিশন ফর্মে এটি চাওয়া হলে disclosure সহজ করে। আপনি যদি কখনও ফ্ল্যাগ পান, তবুও যখন আপনি নিজের পেপার নিজেই লিখেছেন, সেক্ষেত্রে appealing a false AI detection flag–এ আমাদের গাইড জানায় কীভাবে প্রতিক্রিয়া জানাতে হবে।
প্রায়শই জিজ্ঞাসিত প্রশ্নাবলি
প্রশ্ন: আমার পেপারে AI humanizer ব্যবহার করা কি cheating হিসেবে গণ্য হয়?
না, যখন আপনি এটি আমাদের বর্ণিতভাবে ব্যবহার করেন। আপনি আপনার নিজের AI-সহায়তাপ্রাপ্ত খসড়াকে humanize করছেন, আপনার যুক্তি (argument), ডেটা (data), এবং citations অক্ষুণ্ণ রাখছেন, তারপর আপনার AI ব্যবহারের বিষয়টি আপনার প্রতিষ্ঠান ও জার্নালে disclose করছেন। এটিই এমন কিছুর উল্টো যা কোনো কিছু লুকানো। এটি যে সমস্যার সমাধান করে সেটি টেকনিক্যাল: যত্নশীল লেখা যেন মেশিন টেক্সট হিসেবে ভুল পড়ে না যায়; নৈতিকতার (integrity) সমস্যা নয়।
প্রশ্ন: আমার ইংরেজি সত্যিই দারুণ। তাহলে কেন কোনো ডিটেক্টর আমার কাজকে ফ্ল্যাগ করবে?
কারণ ডিটেক্টররা লেখাটি ভালো কি না তা মাপে না; তারা মাপে কতটা পূর্বানুমেয়। শক্তিশালী, মানসম্মত, দ্বিতীয় ভাষার ইংরেজি সাধারণত খুবই সামঞ্জস্যপূর্ণ (consistent), এবং এই সামঞ্জস্যতা এমন কম-perplexity তৈরি করে যা ডিটেক্টররা AI টেক্সটের সঙ্গে যুক্ত করে। স্ট্যানফোর্ডের গবেষণায় দেখা গেছে মানব-লেখা নন-নেটিভ প্রবন্ধগুলো নেটিভদের তুলনায় অনেক বেশি হারে ফ্ল্যাগ হয়, আর ঠিক এই প্যাটার্নটাই বহু সাবলীল ডাচ গবেষকের মুখোমুখি হয়।
প্রশ্ন: humanizer কি নিশ্চিত করতে পারে যে আমি Turnitin বা GPTZero পাস করব?
না, এবং যেসব টুল বলে যে এটি পারবে, সেগুলোর ব্যাপারে সতর্ক থাকা উচিত। ডিটেক্টরগুলো কয়েক মাস পরপর তাদের মডেল বদলে, তাই কোনো সৎ পণ্য নির্দিষ্ট ফলাফলের নিশ্চয়তা দিতে পারে না বা ১০০% undetectable হওয়ার দাবি করতে পারে না। আমরা যা বলতে পারি তা হলো: আমাদের পরীক্ষায় humanizer যত্নশীল নন-নেটিভ প্রোজা কতবার ভুলভাবে ফ্ল্যাগ হয়, সেটি উল্লেখযোগ্যভাবে কমিয়েছে, এবং আপনার অর্থ ও citations অপরিবর্তিত রেখেছে।
প্রশ্ন: humanizing কি আমার citations, পরিভাষা, বা ডেটা বদলে দেবে?
না। humanizer তৈরি করা হয়েছে প্রযুক্তিগত পরিভাষা (technical terms), রেফারেন্স মার্কার (reference markers), এবং আপনার যুক্তির (argument) মূল বিষয়বস্তু (substance) সংরক্ষণ করতে। এটি rhythm ও শব্দচয়ন এমনভাবে বদলায় যাতে লেখা আরও স্বাভাবিক শোনায়, কিন্তু আপনি যে facts, সংখ্যা, বা sources উদ্ধৃত করেন সেগুলো বদলায় না। সাবমিট করার আগে ফলাফলটি আবার পড়া উচিত, যেকোনো এডিটের মতোই।
প্রশ্ন: আমি আগে ডাচে লিখি এবং পরে ট্রান্সলেট করি। এটা কি তবুও কাজ করবে?
হ্যাঁ। আপনি ডাচে ড্রাফট করতে পারেন, তারপর ইংরেজি সংস্করণে ট্রান্সলেট করে humanize করতে পারেন। টুলটি নন-ইংরেজি ও অনুবাদিত টেক্সটকে ভাষা-সচেতন একটি মডেলের মধ্য দিয়ে রাউট করে, যা বাক্যের গঠন ও অর্থ স্থিতিশীল রাখে, তাই workflow ডাচ গবেষকদের বাস্তব লেখার ধরনটির সঙ্গে সামঞ্জস্যপূর্ণ।
অ-নেটিভ ইংরেজিতে যত্ন করে লেখা হলেও যেন ভুল করে AI-এর মতো ধরা না পড়ে, সেই ঝুঁকি কমান। আপনার অর্থ, পরিভাষা এবং উদ্ধৃতি অক্ষুণ্ণ রাখুন। বিনামূল্যে চেষ্টা করুন, গবেষকদের জন্য নির্মিত।

Moe একজন NLP ইঞ্জিনিয়ার একজন PhD সহ প্রাকৃতিক ভাষা প্রক্রিয়াকরণে। তার গবেষণা কম্পিউটেশনাল ভাষাতত্ত্ব, পাঠ্য বিশ্লেষণ এবং মেশিন লার্নিংকে কভার করে এবং এটি সরাসরি ProofreaderPro-এর পিছনে সম্পাদনা এবং মানবীকরণ মডেলগুলিতে যোগ করে। তিনি প্রক্রিয়াটির অংশ সম্পর্কে লিখেছেন যা বেশিরভাগ লোকেরা কখনই দেখে না: কীভাবে একটি ভাষা মডেল একটি বাক্য পড়ে, স্কোর করে এবং কী পরিবর্তন করতে হবে তা সিদ্ধান্ত নেয়।


