
পর্তুগাল তার আকারের তুলনায় অনেক বেশি উৎপাদনশীল। গত দুই দশকে সামুদ্রিক বিজ্ঞান, উপকরণ, স্বাস্থ্য, ও প্রকৌশলে এর আউটপুট দ্রুত বেড়েছে, এবং ওই কাজের বেশির ভাগই ইংরেজিতে বিশ্বের কাছে পৌঁছায়, সেই সব গবেষকের লেখা, যারা ইউরোপীয় পর্তুগিজে ভাবেন ও খসড়া করেন। প্রণোদনাগুলোও পরিষ্কার। ক্যারিয়ার এবং গবেষণা-ইউনিটের তহবিল নির্ভর করে Web of Science ও Scopus-ইনডেক্সড জার্নালে পেপার বসানোর ওপর, ফলে হাই-ইমপ্যাক্ট ইংরেজি ভেন্যুতে লেখার জন্য স্থায়ী চাপ তৈরি হয়।
পর্তুগিজ গবেষকদের জন্য নির্মিত একটি AI হিউম্যানাইজার ঠিক করতে চায় এমন সমস্যাটাই এখানে। যখন একজন যত্নশীল দ্বিতীয় ভাষার লেখক পরিষ্কার, মানসম্মত ইংরেজি তৈরি করেন, তখন অনেক সময় AI ডিটেক্টর সেই স্পষ্টতাকেই মেশিন টেক্সট হিসেবে ধরে ফেলে এবং ম্যানুস্ক্রিপ্টে ফ্ল্যাগ বসায়। লেখা মানুষই লিখেছে। সফটওয়্যার তা মানতে চায় না, আর একটি একক ভুল ফ্ল্যাগ সাবমিশন থামিয়ে দিতে পারে বা সুপারভাইজার/এডিটরের সঙ্গে বিব্রতকর নৈতিকতা-সংক্রান্ত আলোচনা শুরু করতে পারে।
আপনি যা আসলে লিখেছেন আর ডিটেক্টর যা রিপোর্ট করে, এই ফারাকটা আপনার ব্যর্থতা নয়, এবং কোনো কিছু লুকিয়েও আপনি তা বন্ধ করতে পারেন। পথটা সোজা: আপনার নিজের খসড়াটি পরিমার্জন করুন, প্রতিটি উদ্ধৃতি ও প্রতিটি টেকনিক্যাল টার্ম অক্ষুণ্ণ রাখুন, তারপর আপনার বিশ্ববিদ্যালয় ও লক্ষ্য জার্নাল যেভাবে চাইছে সেভাবেই সৎভাবে আপনার AI ব্যবহার প্রকাশ করুন। এই গাইড ব্যাখ্যা করে কেন পর্তুগাল-ইংরেজি ভুলভাবে পড়া হয়, এবং এর বিষয়ে কী করতে হবে।
Um humanizador de texto de IA para investigadores portugueses
যদি আপনি পর্তুগিজে লেখেন এবং ইংরেজিতে প্রকাশ করেন, তাহলে একটি AI টেক্সট humanizer পর্তুগিজ গবেষকদের পৃষ্ঠায় স্বাভাবিক শোনাতে সাহায্য করে, তাও তাদের কাজের নির্ভুলতা, অর্থ বা উদ্ধৃতি না হারিয়ে।
সাদামাটা ভাষায় বললে: আমাদের text humanizer আপনার নিজের ইংরেজি খসড়ায় ছন্দ (rhythm) ও শব্দচয়ন (word choice) পরিবর্তন করে, যাতে যত্নশীল Portuguese-English কম্পিউটারভিত্তিক ডিটেক্টরের ভুল বোঝার সম্ভাবনা কমে। এটি আপনার ফলাফল (findings) নতুন করে লেখে না, কল্পিত উৎস (invent sources) তৈরি করে না, কিংবা আপনার যুক্তি (argument) বদলায় না। এটি আপনার আগে থেকেই লেখা বা AI সহায়তায় খসড়া করা গদ্যে কাজ করে, এবং আপনি যেখানে রেফারেন্স বসিয়েছেন সেটিই ধরে রাখে।
উদ্দেশ্য ন্যায্যতা (fairness), ছদ্মবেশ (disguise) নয়। আপনার বিজ্ঞান সত্য। লক্ষ্য হলো একটি প্যাটার্ন-ম্যাচিং টুল যেন আপনার স্পষ্ট ইংরেজিকে ভুল করে মেশিন বলে ধরে না নেয়, সেটা বন্ধ করা।
ইউরোপীয় পর্তুগিজে খসড়া তৈরি করছেন? মানবিকরণকারী সেটি সনাক্ত করে এবং পুনর্লিখন করে
আপনি আগে এটিকে ইংরেজিতে অনুবাদ না করেও একটি পর্তুগিজ খসড়া হিউম্যানাইজ করতে পারেন। আপনার লেখা পেস্ট করুন, ProofreaderPro স্বয়ংক্রিয়ভাবে ভাষা শনাক্ত করে, এরপর পর্তুগিজ-সচেতন (Portuguese-aware) একটি মডেলের মাধ্যমে রাউট করে, যা অ্যাকসেন্ট, টার্মিনোলজি এবং উদ্ধৃতি (citations) ঠিক জায়গায় রেখে দেয়। একটি humanizador de texto de IA হিসেবে এটি আপনার ইউরোপীয় পর্তুগিজ গদ্যের ছন্দ বদলায়, কিন্তু প্রতিটি finding ও রেফারেন্স সংরক্ষণ করে। স্বয়ংক্রিয় শনাক্তকরণ ষাটেরও বেশি ভাষায় বিস্তৃত, ফলে পর্তুগিজকে ইংরেজিতে “রিশেপ” না করে পর্তুগিজ হিসেবেই ধরা হয়।
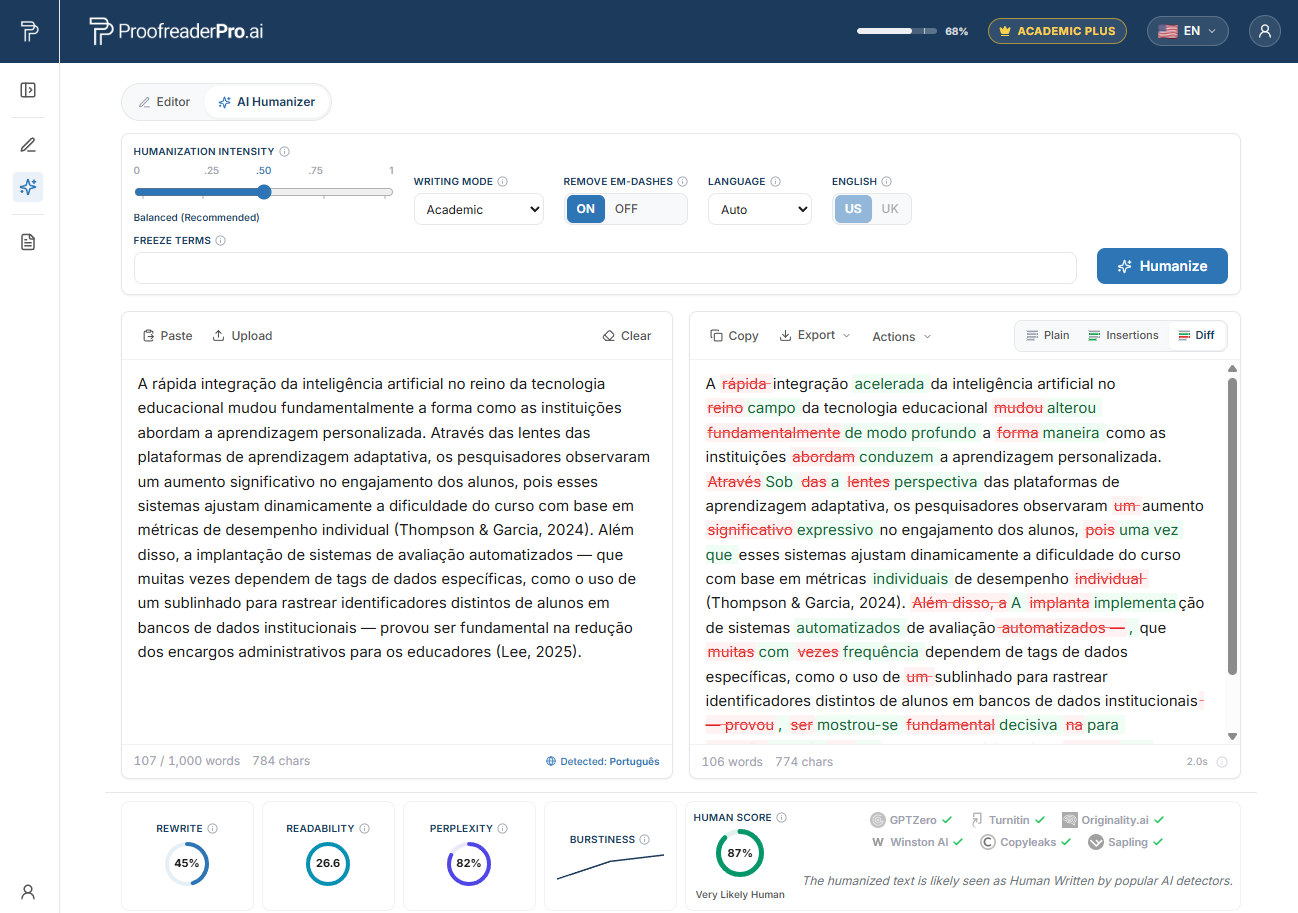
পর্তুগিজ একাডেমিক টেক্সটকে হিউম্যানাইজ করছে ProofreaderPro AI Humanizer। before and after diff আপনার অর্থ ও citations ধরে রাখে, এবং detector checks নিশ্চিত করে যে পাঠটি স্বাভাবিকভাবে মানুষ-লিখা।
কেন পর্তুগিজ গবেষকেরা AI detector-এ ধরা পড়ে
সবচেয়ে স্পষ্ট প্রমাণ আসে ২০২৩ সালের স্ট্যানফোর্ড স্টাডি থেকে, Liang এবং সহকর্মীদের কাজ, যা Cell Press জার্নাল Patterns-এ প্রকাশিত হয়, সোজাসাপ্টা শিরোনামে: "GPT detectors are biased against non-native English writers." দলটি সাতটি বহুল ব্যবহৃত ডিটেক্টরে মানব-লিখিত TOEFL প্রবন্ধ চালিয়েছে। গড়ে প্রায় ৬১% নন-নেটিভ প্রবন্ধ AI হিসেবে ফ্ল্যাগ হয়, নেটিভ ইংরেজি লেখকদের ক্ষেত্রে সেটা ছিল আনুমানিক ৫%। পাঁচ জনে একজনেরও কম নয়, প্রায় ১৯.৮% নন-নেটিভ প্রবন্ধ, সব ডিটেক্টরেই সর্বসম্মতভাবে AI ফ্ল্যাগ পেয়েছে। ওই প্রতিটি প্রবন্ধই একজন মানুষের লেখা।
এটা কেন ঘটে? অনেক ডিটেক্টর “perplexity” নামে একটি স্কোরিংয়ের ওপর নির্ভর করে, পরের প্রতিটি শব্দ ভাষামডেলের কাছে কতটা বিস্ময়কর (surprising) তা মাপার একটি সূচক। দ্বিতীয় ভাষায় লিখতে থাকা লেখকেরা সাধারণ, নিরাপদ (safe) শব্দভাণ্ডার এবং মানসম্মত, পূর্বানুমেয় (predictable) বাক্যগঠন বেছে নেন। এতে perplexity কমে যায়, এবং কম perplexity-ই ঠিক ওই সিস্টেমগুলো শিখেছে মেশিন-উৎপাদিত টেক্সট হিসেবে পড়তে। যে অভ্যাসগুলো Portuguese-English-কে পরিষ্কার ও সঠিক করে তোলে, সেই অভ্যাসগুলোই ডিটেক্টরের কাছে সন্দেহজনক লাগে। আমরা why AI detectors flag non-native writers প্রবন্ধে প্রক্রিয়াটি বিস্তারিতভাবে খুলে বলি।
ঝুঁকিটা বিমূর্ত নয়। নন-নেটিভ ইংরেজি বক্তারা ইতোমধ্যেই নেটিভদের তুলনায় প্রায় ২.৫ গুণ বেশি রিজেকশনের মুখোমুখি হন, পেপার লেখায় প্রায় ৫১% বেশি সময় ব্যয় করেন এবং ইংরেজিতে পড়তে আনুমানিক ৯১% বেশি সময় ব্যয় করেন, আর ভাষাগত মানের সঙ্গে যুক্ত হয়ে প্রায় ১২.৫ গুণ বেশি রিভিশন রিকোয়েস্ট পান। ৭% এরও কম জার্নাল নন-ইংরেজি সাবমিশন গ্রহণ করে। একটি ভুল AI ফ্ল্যাগ এসে এই সব কিছুর ওপরেই বসে।
মিথ্যা ফ্ল্যাগের পেছনে থাকা পর্তুগিজ প্রথমভাষাগত ধরন
নিচের কোনো নির্মাণই সাধারণ অর্থে “ভুল” নয়। এগুলো ইউরোপীয় পর্তুগিজ দ্বারা গঠিত যত্নশীল, মানসম্মত পছন্দ, এবং ঠিক এই মানসম্মততাই ডিটেক্টরকে perplexity কম বলে পড়ে।
False friends. পর্তুগিজ ও ইংরেজি বিশাল আকারের ল্যাটিন শব্দভাণ্ডার শেয়ার করে, যা নীরবে শব্দচয়নকে প্রভাবিত করে। একজন পর্তুগিজ লেখক বর্তমান অর্থে "actual", সম্ভাবনা বোঝাতে "eventual", যেখানে "intend" (pretender) বোঝাতে চাওয়া হয়েছিল সেখানে "pretend", অথবা attend (assistir a) বোঝাতে "assist", কিংবা carry out (realizar) বোঝাতে "realize" ব্যবহার করতে পারেন। এমনকি শব্দটি সঠিকভাবে বসলেও, এই নিরাপদ সঙ্গী-শব্দগুলোর (safe cognates) টান গদ্যকে সমতল করে পূর্বানুমেয়, কম-বিস্ময়কর (low-surprise) বাক্যগঠনে ঠেলে দেয়।
Article overuse with generic nouns. পর্তুগিজ অ্যাবস্ট্রাক্ট ও জেনেরিক নাউনের আগে একটি নির্দিষ্ট আর্টিকেল বসায়। তাই "a ciência" এবং "a sociedade" ইংরেজিতে অনেক জায়গায় যায় “the science” ও “the society” হিসেবে, যেখানে ইংরেজি সাধারণত আর্টিকেল বাদ দেয়। এটি ব্যাকরণগতভাবে সঠিক এবং ধারাবাহিক। এ ধরনের ধারাবাহিকতাই মেশিন-স্মুথ বলে পড়া হয়।
Long, subordinate-heavy sentences. রোমান্স একাডেমিক স্টাইল দীর্ঘ পর্যায়ক্রমিক (periodic) বাক্যকে পছন্দ করে, stacked relative clauses দিয়ে একাধিক ধারণা মূল ক্রিয়াপদ আসার আগেই গুছিয়ে ধরে। ইংরেজি রিভিউয়াররা প্রায়ই এটিকে ঘন (dense) বলে থাকেন, আর ডিটেক্টর সেটাকে নেটিভ খসড়াকারীর অনিয়মিত ছন্দের বদলে স্থির, সমান ক্যাডেন্স হিসেবে দেখে।
Preposition transfer. পর্তুগিজের প্রিপোজিশনগুলো অভ্যাসের মাধ্যমে ইংরেজিতে মানচিত্রিত হয়: depender de থেকে "depend of", consistir em থেকে "consist in", এবং different from-এর বদলে "different of"। এগুলো ছোট, পদ্ধতিগত (systematic) প্রতিস্থাপন, এবং pদ্ধতিগত, ঠিক সেটাই একটি perplexity মডেলকে কম স্কোর দিতে সাহায্য করে।
Nominalisation and "which" overuse. নাউনের আধিক্যযুক্ত বাক্যগঠন বেছে নেওয়ার প্রবণতা, পাশাপাশি সাধারণ কানেক্টর হিসেবে "which" এবং "it"-এর বদলে “the same” (o mesmo) কে প্রোনাউন হিসেবে ব্যবহার করা, পরিমিত, ফরমাল বাক্য তৈরি করে, যেগুলো পার্স করা সহজ; আর ডিটেক্টরের দৃষ্টিতে সেগুলো জেনারেটেড টেক্সট হিসেবে ভুল হওয়ার মতো সহজও।
পরিষ্কার পর্তুগিজ-ইংরেজি যেন ভুলভাবে বোঝা না হয়, তা বন্ধ করুন
নিজের AI-সহায়তাপ্রাপ্ত খসড়াকে মানবিক করুন, প্রতিটি উদ্ধৃতি ও প্রযুক্তিগত পরিভাষা অক্ষুণ্ণ রাখুন, তারপর আপনার AI ব্যবহারের কথা প্রকাশ করুন। সতর্কভাবে লেখা যেন মেশিনের লেখা বলে ভুল ধরা না পড়ে।
Humanizer ফ্রি করে দেখুনPortugal-এর AI-detection এবং Turnitin প্রসঙ্গ
পর্তুগাল থেকে আসা থিসিস ও জার্নাল সাবমিশন নিয়মিত স্ক্রিনিংয়ের মধ্য দিয়ে যায়। Turnitin বা iThenticate দিয়ে সিমিলারিটি চেক করা বিশ্ববিদ্যালয় ও জার্নালে স্ট্যান্ডার্ড প্র্যাকটিস, এবং AI সূচকগুলো ক্রমেই পুরোনো plagiarism রিপোর্টের পাশাপাশি ওজন (weighed) পায়। আপনি যদি পর্তুগিজ কোনো প্রতিষ্ঠানে থিসিস জমা দেন বা কোনো ইনডেক্সড জার্নালে ম্যানুস্ক্রিপ্ট পাঠান, তাহলে ধরে নিন, আপনার টেক্সটে কোনো না কোনো রকম স্বয়ংক্রিয় স্ক্রিনিং অবশ্যই স্পর্শ করবে।
নৈতিকতা-সংক্রান্ত পরিবেশ (integrity climate) এখন শাস্তিমূলক দিকের চেয়ে দায়ী/দায়িত্বশীল (responsible) দিকেই গড়ে উঠছে। FCT এবং কিছু কিছু ইউনিভার্সিটি দায়িত্বশীল AI ব্যবহারের নির্দেশনা দিয়েছে, আর তহবিলদাতা ও জার্নালগুলো ক্রমেই লেখকদের কাছে জানতে চাইছে কীভাবে AI টুলগুলো জড়িত ছিল। কার্যকর অবস্থান হলো প্রকাশ (disclosure), নীরবতা নয়। আপনি যা ব্যবহার করেছেন তা ব্যাখ্যা করতে পারলে এবং মূল substance যে আপনারই, তা দেখাতে পারলে, ডিটেক্টর ফ্ল্যাগ হয়ে ওঠে এমন একটি দাবি (claim) যেটার উত্তর আপনি দিতে পারেন; এমন কোনো চূড়ান্ত রায় নয় (verdict) যেটা কেবল মেনে নিতে হবে।
ডিটেক্টর ভেন্ডররাই কীভাবে তাদের টুল নিয়ে কথা বলে, সেটা মনে রাখা কাজে দেয়। Turnitin ১ থেকে ১৯% রেঞ্জে AI স্কোর দমন করে, অর্থাৎ হার্ড নম্বরের বদলে একটি অ্যাস্টেরিস্ক দেখায়, এবং সতর্ক করে যে তাদের স্কোর একা ব্যবহার করে কোনো integrity কেস সিদ্ধান্ত নেওয়া উচিত নয়। কয়েকটি বিশ্ববিদ্যালয় আরও এগিয়ে তাদের AI ডিটেক্টর বন্ধ করে দিয়েছে। এতে ডিটেকশন অপ্রাসঙ্গিক হয়ে যায় না, কিন্তু এর মানে হলো একটি ফ্ল্যাগ কথোপকথনের শুরু, কথোপকথনের শেষ নয়।
শীর্ষ পর্তুগিজ বিশ্ববিদ্যালয়গুলো এবং কোথায় AI checks দেখা যায়
নিচের প্রতিষ্ঠানগুলো সাধারণত Turnitin বা iThenticate দিয়ে থিসিস ও ম্যানুস্ক্রিপ্টে সিমিলারিটি স্ক্রিন করে, এবং একই রিভিউ প্রক্রিয়ার অংশ হিসেবে ক্রমেই AI সূচকগুলোকেও একসঙ্গে ওজন দেয়:
- Universidade de Lisboa (ULisboa), Lisbon
- Universidade do Porto (UPorto), Porto
- Universidade de Coimbra (UC), Coimbra
- Universidade NOVA de Lisboa (NOVA), Lisbon
- Universidade de Aveiro (UA), Aveiro
- Universidade do Minho (UMinho), Braga এবং Guimarães
- Instituto Superior Técnico (IST), Lisbon, part of ULisboa
- Universidade de Évora, Évora
- ISCTE, Instituto Universitário de Lisboa (ISCTE-IUL), Lisbon
- Universidade da Beira Interior (UBI), Covilhã
- Universidade do Algarve, Faro
আপনি যেখানেই লেখেন না কেন, স্ক্রিনিং লজিক একই। একটি টুল আপনার গদ্যকে স্কোর দেয়, এবং পরিষ্কার Portuguese-English এমনভাবে স্কোর পেতে পারে যা যত্নশীল মানুষের কাজকে ভুলভাবে উপস্থাপন করে। আগে থেকেই এটা জানা, লড়াইয়ের অর্ধেক অংশ।
পর্তুগিজ গবেষকদের জন্য AI হিউম্যানাইজার কীভাবে কাজ করে
সততার ওয়ার্কফ্লোতে চারটি ধাপ আছে, এবং সেখানে disclosure অংশই বটে, পরের চিন্তা নয়।
প্রথমে, ড্রাফট করুন। ইংরেজিতে লিখুন, অথবা ইউরোপীয় পর্তুগিজে খসড়া করুন এবং অনুবাদ করুন, যেটা আপনার যুক্তিটা সবচেয়ে পরিষ্কারভাবে নামিয়ে আনতে সাহায্য করে। প্রথম পাস তৈরি করতে AI সহকারী ব্যবহার করা গ্রহণযোগ্য; কিন্তু গুরুত্বপূর্ণ হলো, যুক্তি, ডেটা, এবং উপসংহার আপনারই হতে হবে।
দ্বিতীয়ত, ব্যাকরণ ও টার্মিনোলজিটি প্রুফরিড করুন যাতে বিজ্ঞানটি নির্ভুল হয়। false friends ও preposition সঠিকভাবে ধরাটা কোনো ডিটেক্টর থাকুক বা না থাকুক, একজন পাঠকের কাছে গুরুত্বপূর্ণ।
তৃতীয়ত, আপনার নিজের ড্রাফটকে humanize করুন। আপনার ইংরেজিটা আমাদের text humanizer-এ পেস্ট করুন। এটি বাক্যের ছন্দ ও শব্দচয়ন পরিবর্তন করে, low perplexity হিসেবে পড়ার মতো একঘেয়ে ক্যাডেন্স ভেঙে দেয়, এবং পুনরাবৃত্তিমূলক ফ্রেজিং বা stray em dashes-এর মতো টিকস কমায়—যদিও আপনার অর্থ (meaning), আপনার টেকনিক্যাল টার্ম, ও আপনার citations সংরক্ষিত থাকে। নন-ইংরেজি টেক্সট ভাষা-সচেতন (language-aware) একটি মডেলে রাউট হয়, যাতে বাক্যগঠন ও অর্থ অক্ষুণ্ণ থাকে; এবং humanizer ষাটেরও বেশি ভাষাকে সাপোর্ট করে, ফলে পর্তুগিজ ড্রাফটকেও ইংরেজির মতো একই যত্নে হ্যান্ডেল করা হয়।
এই ধাপ থেকে আপনি কী আশা করতে পারেন? আমাদের নিজস্ব পরীক্ষায় দেখা গেছে, যত্নশীল, মানসম্মত নন-নেটিভ ড্রাফটকে humanize করলে বড় ডিটেক্টরগুলো (Turnitin, Originality.ai, GPTZero এবং অনুরূপ) সেটিকে মেশিন-লিখা হিসেবে ভুল পড়ার হার উল্লেখযোগ্যভাবে কমে, অথচ অর্থ ও ব্যাকরণ ঠিক থাকে। আমরা এটিকে “পরীক্ষায় যা আমরা দেখেছি” হিসেবে বলি, গ্যারান্টি হিসেবে নয়। ডিটেক্টরগুলো কয়েক মাস পরপর retrain হয়, তাই কোনো সৎ টুলই প্রতিশ্রুতি দিতে পারে না যে কোনো নির্দিষ্ট টেক্সট ১০০% undetectable পড়বে; আর আপনি এমন কোনো পণ্যের ব্যাপারে সতর্ক থাকবেন যা এর উল্টো দাবি করে।
চতুর্থত, disclose করুন। আপনার AI ব্যবহারটি আপনার প্রতিষ্ঠান ও লক্ষ্য জার্নাল যেভাবে চাইছে সেভাবে লিখুন। ভাষাভিত্তিক এই ওয়ার্কফ্লো সম্পর্কে আরও বিস্তৃত দৃষ্টিভঙ্গির জন্য দেখুন আমাদের multilingual AI humanizer hub। আর আপনি যদি মানবিক এডিটিংয়ের (human editing) আরেকটি পাসও চান, তাহলে global academic editing hub ব্যাখ্যা করে প্রুফরিডিং ও humanizing কীভাবে একসঙ্গে ফিট করে।
স্থানীয় তহবিল প্রদানকারী সংস্থা, জার্নাল এবং AI-প্রকাশনা প্রত্যাশা
মূল জাতীয় ফান্ডার হলো FCT (Fundação para a Ciência e a Tecnologia): যা গবেষণা ও ফেলোশিপকে সমর্থন করে এবং Ciência ID গবেষক শনাক্তকারী সেবা চালায়। পর্তুগিজ গ্রুপগুলো European Research Council (ERC) গ্রান্টও জিতে থাকে, এবং Plan S অনুযায়ী FCT-অর্থায়িত কাজের ক্ষেত্রে ওপেন অ্যাকসেস প্রযোজ্য, ফলে পর্তুগিজ আউটপুটের একটি বড় অংশ উন্মুক্তভাবে প্রকাশিত হয় এবং ব্যাপকভাবে পড়াও হয়।
প্রকাশনার দিক থেকে লক্ষ্য প্রায় সবসময় একটি Web of Science বা Scopus-ইনডেক্সড জার্নাল; আর সেখানে একটি কপি জাতীয় ওপেন-অ্যাকসেস রিপোজিটরি RCAAP-এ জমা রাখা হয়। এসব ভেন্যুগুলোর মধ্যে AI-disclosure প্রত্যাশাও টাইট হচ্ছে। এডিটররা ক্রমেই লেখকদের কাছে জানতে চান, ড্রাফটিং বা এডিটিংয়ে AI টুলগুলো কীভাবে ব্যবহৃত হয়েছে, আর তহবিলদাতারাও একই দিকে এগোচ্ছে।
এই প্রবণতাকে হুমকি নয়, সুযোগ হিসেবে দেখুন। একটি সংক্ষিপ্ত, সৎ disclosure লাইন আপনাকে সুরক্ষা দেয়: এটি বৈধ ভাষা সহায়তা (language help) ও অসদাচরণকে আলাদা করে, এবং এর মানে হলো একটি ডিটেক্টর ফ্ল্যাগের জবাব আপনি সহজভাবে দিতে পারবেন, আপনি ঠিক কী করেছেন তার সরাসরি বিবরণ দিয়ে। নিজের লেখাকে humanize করা এবং তা disclose করা, দুটি অংশ মিলে একই ন্যায্য প্রক্রিয়া।
প্রায়শই জিজ্ঞাসিত প্রশ্ন
প্রশ্ন: পর্তুগিজ গবেষকদের জন্য AI humanizer ব্যবহার করা কি প্রতারণা হিসেবে গণ্য হয়?
না, যতক্ষণ আপনি নিজের কাজ নিজেই পরিমার্জন করছেন এবং সেটি আপনি disclose করছেন। আপনি ফলাফল বানিয়ে ফেলছেন না, কিংবা অন্য কারও লেখা নিজের বলে চালিয়ে দিচ্ছেন না। আপনি যত্নশীল Portuguese-English-কে স্বাভাবিকভাবে পড়ার মতো করছেন যাতে সেটি ভুলভাবে বিচারিত না হয়, তারপর আপনার প্রতিষ্ঠান ও জার্নালকে জানান কীভাবে AI ব্যবহার করা হয়েছে। এটি ন্যায্যতার একটি ধাপ (fairness step), কোনো কিছু লুকানোর কৌশল নয়।
প্রশ্ন: humanizer কি আমার citations এবং technical terminology অক্ষুণ্ণ রাখবে?
হ্যাঁ। humanizer আপনার ছন্দ (rhythm) ও শব্দচয়েস (word choice) বদলায়, কিন্তু আপনার অর্থ, আপনার রেফারেন্স, এবং ক্ষেত্রভিত্তিক টার্মগুলো সংরক্ষণ করে। আপনার reference list ও in-text citations আপনি যেখানে রেখেছেন, সেখানেই থাকে, আর বিশেষায়িত শব্দভাণ্ডারকে ঢিলে (looser) সমার্থকে বদলে দেওয়ার বদলে অক্ষুণ্ণই রাখা হয়।
প্রশ্ন: কোনো tool কি নিশ্চয়তা দিতে পারে যে আমার text AI detector পেরিয়ে যাবে?
না, এবং আপনার উচিত এমন যেকোনো টুলের প্রতি সন্দেহ করা যেটি তা দাবি করে। ডিটেক্টরগুলো নিয়মিত retrain হয়, ফলে কোনো সৎ টুল নির্দিষ্ট pass rate বা আপনার লেখাটি ১০০% undetectable হবে, এমন প্রতিশ্রুতি দিতে পারে না। একটি ভালো humanizer কী করতে পারে, এবং আমাদের পরীক্ষায় যা আমরা দেখেছি, তা হলো: যত্নশীল নন-নেটিভ গদ্যকে ভুলভাবে ফ্ল্যাগ করার ঘটনা উল্লেখযোগ্যভাবে কমানো যায়, অথচ আপনার কাজ নির্ভুলই থাকে।
প্রশ্ন: আমার ইংরেজি একদম নিজের লেখা হওয়া সত্ত্বেও কেন তা flag হয়?
কারণ অনেক ডিটেক্টর perplexity স্কোর করে, যেটি বিস্ময়কর (surprising) শব্দচয়নকে পুরস্কৃত করে এবং নিরাপদ, মানসম্মতগুলোকে শাস্তি দেয়। দ্বিতীয় ভাষার লেখকেরা সাধারণত সাধারণ শব্দভাণ্ডার ও পূর্বানুমেয় বাক্যগঠন ব্যবহার করেন, যা কম perplexity তৈরি করে। স্ট্যানফোর্ড স্টাডিতে দেখা গেছে, মানুষ-লিখিত নন-নেটিভ প্রবন্ধগুলো নেটিভদের তুলনায় অনেক বেশি হারে ফ্ল্যাগ হয়; তাই একটি ফ্ল্যাগ অনেক সময় মেশিন-লেখকত্ব নয়, বরং আপনার লেখনীর স্টাইলকেই প্রতিফলিত করে।
প্রশ্ন: humanizer কি English-এর পাশাপাশি European Portuguese-এও কাজ করে?
হ্যাঁ। আপনি ইউরোপীয় পর্তুগিজে ড্রাফট করতে পারেন, এবং language-aware মডেলটি আপনার বাক্যগঠন ও অর্থ সংরক্ষণ করে; এরপর ইংরেজিতে গেলে একই যত্ন প্রযোজ্য। টুলটি ষাটেরও বেশি ভাষা সাপোর্ট করে, ফলে পর্তুগিজ-প্রথম ওয়ার্কফ্লো পুরো প্রক্রিয়া জুড়েই সমর্থিত।
সতর্ক পর্তুগিজ-ইংরেজিকে এমন গদ্যে রূপান্তর করুন, যা স্বাভাবিকভাবে পড়া যায়, আপনার অর্থ, উদ্ধৃতি, এবং পরিভাষা সংরক্ষণ করে। এরপর আত্মবিশ্বাসের সাথে আপনার AI ব্যবহারের কথা প্রকাশ করুন।
Moe একজন NLP ইঞ্জিনিয়ার একজন PhD সহ প্রাকৃতিক ভাষা প্রক্রিয়াকরণে। তার গবেষণা কম্পিউটেশনাল ভাষাতত্ত্ব, পাঠ্য বিশ্লেষণ এবং মেশিন লার্নিংকে কভার করে এবং এটি সরাসরি ProofreaderPro-এর পিছনে সম্পাদনা এবং মানবীকরণ মডেলগুলিতে যোগ করে। তিনি প্রক্রিয়াটির অংশ সম্পর্কে লিখেছেন যা বেশিরভাগ লোকেরা কখনই দেখে না: কীভাবে একটি ভাষা মডেল একটি বাক্য পড়ে, স্কোর করে এবং কী পরিবর্তন করতে হবে তা সিদ্ধান্ত নেয়।