AI Humanizer для казахстанських дослідників, які пишуть англійською
AI humanizer для казахстанських дослідників. Зменшує хибні спрацювання детекторів ШІ на англійській мові з казахським або російським впливом: зберігає зміст і цитування, чесно розкриває використання ШІ.

Казахстан щороку створює приблизно 7 600 статей, індексованих у Scopus, і посідає близько 64-го місця у світі за обсягами наукових публікацій — показник швидко зростає, адже кар’єра нині прямо залежить від цього. Кандидат на здобуття ступеня PhD не може захистити дисертацію без щонайменше однієї публікації у Scopus із позитивним індексом впливу. Доцент (dotsent) має мати дві, а професор — три. Майже кожна з цих статей повинна бути написана англійською. AI humanizer для казахстанських дослідників існує з однієї вузької, реальної причини: ретельно написана англійська носієм казахської або російської мови дедалі частіше автоматизованими детекторами сприймається як машинний текст, і таке хибне прочитання може коштувати вам подання.
Казахстан має 427 балів за EF English Proficiency Index, посідаючи 103-тє місце у групі «Very Low Proficiency». Більшість дослідників здобували освіту переважно казахською або російською, а англійську вивчали пізніше — часто через самоосвіту. Читання англомовних статей — це один навик. Підготовка рукопису, який готовий до публікації та відповідає вимогам міжнародних рецензентів, — значно складніше завдання, і підтримка досліджень у країні не встигла за мандатом «publish-or-perish».
Ось пастка. Коли казахстанський науковець пише бездоганну, нормативну, «підручникову» англійську, сама передбачуваність такого тексту стає тим, що AI-детектор зчитує як «generated» (згенеровано). Прийоми, які роблять письмо другою мовою ясним, — це саме ті звички, які детектори були натреновані відстежувати. Це не лише проблема Казахстану, але тут тримовна реальність робить її виразнішою.
AI humanization для казахстанських дослідників, які пишуть англійською
ProofreaderPro.ai приходить на допомогу: наш humanizer допомагає казахстанським дослідникам публікувати уважно написану, природну англійську в міжнародних журналах — без хибних спрацювань як ШІ. Він працює з вашим власним чернетковим текстом, згенерованим/підсиленим AI, зберігає ваші зміст і цитування та читається природно для людського рецензента.
Наукові дослідження в Казахстані спираються на дві мови, а не на одну. Казахська (Қазақ тілі) є державною мовою, а російська (русский язык) лишається робочою мовою науки в більшості лабораторій та на старших факультетах. Багато дослідників формують логіку викладу російською або казахською, перекладають, а потім полірують англійською. Наш humanizer вбудовується в кінець цього процесу — після того, як ваш зміст уже визначено — щоб захистити законну роботу від хибнопозитивного результату.
Пишете українською чи російською спершу? Humanizer розпізнає кожну з них
Казахстанські дослідники часто працюють казахською або російською до того, як оформлюють матеріали англійською, і humanizer підтримує обидва варіанти безпосередньо. Вставте казахський текст — ProofreaderPro автоматично розпізнає кириличний шрифт, а потім пропустить його через мовно-зорієнтовану модель, що зберігає ваші терміни й цитування точно такими, як вони є. За допомогою AI мәтінін адамдандыру ваш казахський чернетковий текст «олюднюється» так само легко, як і англійський — без попереднього перекладу. А оскільки детекція охоплює понад шістдесят мов, російська чернетка розпізнається й олюднюється так само швидко.
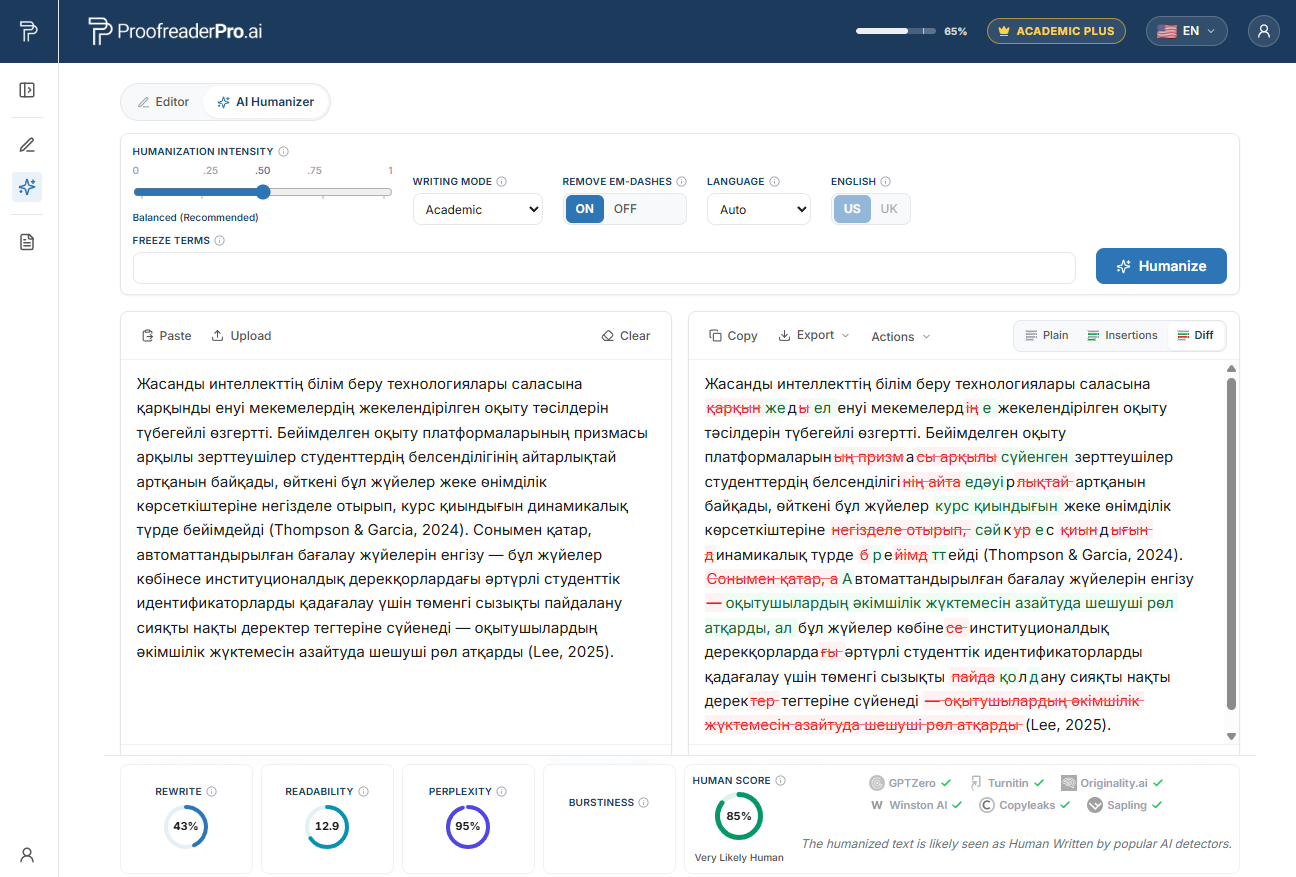
ProofreaderPro AI Humanizer переписує казахський академічний текст. Різниця «до і після» зберігає зміст та цитування, а перевірки детектора підтверджують природне, людське читання.
Чому казахстанських дослідників частіше позначають AI-детектори
У 2023 році команда зі Стенфорда на чолі з Weixin Liang опублікувала дослідження в журналі Cell Press Patterns під назвою «GPT detectors are biased against non-native English writers». Дослідники пропустили через сім широко використовуваних детекторів есе з написаних людьми TOEFL. У середньому приблизно 61% есе не носіями мови було позначено як ШІ — проти близько 5% для есе носіїв англійської. Майже кожне п’яте есе не носіями (близько 19,8%) було позначено одноголосно кожним детектором. І кожне есе було написано людиною.
Механізм — у перплексії. Багато детекторів оцінюють, наскільки «несподіваним» є кожне наступне слово для мовної моделі. Обережний автор, який пише другою мовою, обирає поширені слова та стандартні, передбачувані формулювання — і це дає низьку перплексію, яка читається як машинний текст. Казахський дослідник, який «прокачав» формальну англійську, щоб уникати помилок, зрештою пише саме той гладкий текст із низькими коливаннями, який детектор сприймає як червоний прапорець. Повний механізм ми пояснюємо в why AI detectors flag non-native writers.
Патерни першої мови в казахській та російській, які стоять за хибними спрацюваннями
Лінгвістична ситуація тут нетипова: більшість дослідників несуть інтерференцію одразу з двох типологічно різних мов. Казахська — тюркська, аглютинативна, із порядком слів Subject-Object-Verb. Російська — слов’янська з багатою системою відмінків. У жодної з цих мов немає артиклів. Теза нижче не в тому, що ці патерни — помилки, яких треба соромитися. Суть у тому, що виправлені, ретельні версії цих конструкцій є стандартною, низькоперплексійною англійською — і саме її детектор зчитує як згенеровану.
Дисципліна артиклів. У казахській та російській немає «a», «an» або «the», тож автори вивчають артиклеву систему як абстрактне правило й застосовують її дуже послідовно. «We conducted an experiment to measure the temperature of the solution» — це підручниково правильно, і саме така «підручникова» регулярність дає низьку перплексію.
Порядок слів SOV, а потім надмірне виправлення. Казахська ставить дієслово в кінець («Men kitapty oqydym,» буквально «I book-the read»). Письменники, які знають, що в англійській порядок SVO, заради безпеки перебудовують речення у чистий канонічний порядок. Однорідна, добре оформлена «архітектура» речень читається детектором як передбачувана.
Відновлення зв’язки (copula) з російської. Російська прибирає «to be» у теперішньому часі («Eta metod effektiven,» «this method [is] effective»). Казахські автори вчаться вставляти зв’язку всюди: «This method is effective for detecting outliers.» Це правильно й рівномірно розкладено.
Прийменники як фіксовані пари. Російська використовує відмінки там, де англійська — прийменники, тож автори запам’ятовують «depends on», «consists of», «results in» і «participates in» як сталi звороти та застосовують їх одноманітно. Послідовні колокації знову ж таки дають текст із низькою варіативністю.
Нерозділені словосполучення іменників. Казахська «збирає» зміст суфіксами. Ретельні автори розкладають це в вивірену англійську ("an analysis of the efficiency of the temperature control system"). Результат граматично коректний, формальний і гладкий.
Регулярність часових форм. Оскільки жодна з цих мов не відображає англійські часи та видові форми «прямо», автори стандартизують: простий минулий для методів, present perfect — для актуальності, що триває. Стандартизація зменшує несподіваність, а зменшена несподіваність — це те, що детектор карає.
Жодна з цих конструкцій не є неправильною. Це маркери дисциплінованого автора, який пише другою мовою, і чесний процес рецензування не має перетворювати цю дисципліну на доказ шахрайства.
Контекст AI-детекції та Turnitin у Казахстані
Дисертації й журнальні подання з Казахстану часто перевіряють на подібність за допомогою Turnitin або iThenticate, а індикатори AI тепер «подорожують» разом із цими показниками подібності. Казахстанські університети активно вдаються до міжнародних публікацій, тому інструменти скринінгу, які були завезені разом із цим імпульсом, дедалі частіше стають частиною робочого процесу під час захисту та на етапі подання.
Варто чітко пояснити, що означають ці оцінки. Сам Turnitin пригнічує AI-оцінки в діапазоні 1–19% (відображаючи зірочку замість числа) і попереджає, що цей показник не слід використовувати самостійно для ухвалення рішення про доброчесність. У 2023 році Vanderbilt вимкнув AI-детектор Turnitin, посилаючись на хибні спрацювання та упередженість проти авторів, які не є носіями. Подібних кроків також дотрималися Michigan State, UT Austin, Northwestern, Pittsburgh, SMU та Waterloo. Прапорець детектора — це твердження, яке можна оскаржити, а не вирок.
Водночас фандери та журнали дедалі частіше просять авторів розкривати, як саме вони використовували інструменти AI. Ці два факти не суперечать одне одному. Прямий шлях — писати реальну роботу, захистити її від хибних спрацювань і відкрито розкривати використання інструментів.
Захистіть акуратну англійську від хибного позначення AI
Зробіть «людяним» власну чернетку, підготовлену за допомогою AI, збережіть зміст, посилання та технічні терміни, а також розкрийте ваше використання інструмента так, як цього вимагає ваш журнал. Створено для мовців, які пишуть для Scopus, зокрема для казахської та російської.
Спробуйте Humanizer безкоштовноПровідні університети Казахстану та де з’являються AI-перевірки
Обсяг наукової продукції концентрується в невеликій кількості флагманських установ, більшість з яких — в Астані, Алмати, а також кілька регіональних центрів. Кожен із цих скринінгів перевіряє дисертації та рукописи на подібність і AI-індикатори як частину захисту та подання.
- Nazarbayev University (NU), Астана — флагманський університет із викладанням англійською та міжнародними партнерствами
- Al-Farabi Kazakh National University (KazNU), Алмати — найстаріший і найбільший національний університет та один із лідерів за кількістю Scopus-публікацій
- Satbayev University (Kazakh National Research and Technical University), Алмати — провідний технічний університет
- L.N. Gumilyov Eurasian National University (ENU), Астана — сильний у природничих науках та інженерії
- Kazakh-British Technical University (KBTU), Алмати — частково з викладанням англійською, напрями нафтогазового сектору та IT
- KIMEP University, Алмати — викладання англійською в бізнесі, економіці та праві
- Karaganda University (Ye.A. Buketov Karaganda University), Караганда — хімія, фізика та освіта
- South Kazakhstan University (M. Auezov South Kazakhstan University), Шимкент — хімічна інженерія та сільськогосподарські науки
- Turan University, Алмати — приватний університет із зростаючим обсягом досліджень
- International Information Technology University (IITU), Алмати — комп’ютерні науки та цифрові технології
Дослідники з Nazarbayev University зазвичай мають найсильнішу англійську, але навіть там ретельно підготовлений рукопис може «зачепити» AI-позначку. У закладах із викладанням казахською або російською, де англійська є пізнішою здобутою мовою, ризик хибнопозитивного спрацювання вищий саме тому, що письмові формулювання надзвичайно коректні й послідовні.
Як працює AI humanizer для казахстанських дослідників
Процес зрозумілий і простий. Спершу підготуйте чернетку статті — російською або казахською, якщо саме звідти «тече» ваша логіка. Потім перекладіть англійською. Виправте граматику так, щоб зміст збігався рівно з тим, який ви маєте на увазі. Далі пропустіть власний англомовний текст із AI-підсиленням через humanizer, щоб ретельно сформований матеріал із низькою варіативністю рідше сприймався детектором як машинний. Ваші цитування (APA, MLA, Chicago, IEEE, Vancouver), ваші числа та технічна термінологія зберігаються. Змінюється ритм і вибір слів: humanizer варіює каденцію, розриває повторювані патерни та прибирає «маяки», як-от випадкові довгі тире.
Протестований на основних детекторах, наш text humanizer переписує AI-текст у більш природну «людську» форму — це знижує AI-сигнал і підвищує шанси проти складних детекторів, зберігаючи високу точність граматики для академічного тексту. Це результати тестування, а не гарантії. Детектори перенавчаються кожні кілька місяців, тож ми ніколи не обіцяємо конкретне число і ніколи не стверджуємо, що ваш текст буде «100% undetectable». Ціль — справедливість для реальної роботи, а не трюк.
Після цього — розкрийте використання. Додайте statement про застосування AI у форматі, який вимагають ваш інститут і цільовий журнал. Олюднення власної чернетки та розкриття інструментів — не суперечності: разом вони тримають вас у межах правил доброчесності, захищаючи реальне письмо другою мовою від хибного прапорця. Якщо вам потрібні загальні механіки для різних мов, перегляньте multilingual AI humanizer hub. Якщо ваш рукопис потребує виправлення граматики та структури перед олюдненням — це має бути academic editing for Kazakh researchers.
Організації, що фінансують на місцях, журнали та очікування щодо розкриття AI
Ministry of Science and Higher Education встановлює й періодично посилює вимоги Scopus до публікацій, які «відсіюють» кожен щабель академічної драбини, а National Academy of Sciences of the Republic of Kazakhstan задає основу значній частині мультидисциплінарного наукового доробку країни. Багато університетів пропонують грошові бонуси за публікації у Scopus, тож ставки на кожне подання дуже високі — а мовне відхилення на рівні редакції (desk rejection) через мовні фактори стає особливо дорогим.
Дані вітчизняних журналів рухаються у бік англійської та міжнародної індексації. Серед відомих видань — Eurasian Journal of Mathematical and Computer Applications, Central Asian Journal of Medical Hypotheses and Ethics, Chemical Bulletin of Kazakh National University (Al-Farabi KazNU), Eurasian Physical Technical Journal, International Journal of Biology and Chemistry (Al-Farabi KazNU), а також Reports of the National Academy of Sciences of the Republic of Kazakhstan. Незалежно від того, чи ви орієнтуєтеся на ці журнали, чи на міжнародний журнал категорії Q1, якість англійської є спільним «фільтром», і дедалі більше з них тепер очікують явну примітку про будь-яку допомогу від AI.
Наша порада незмінна: олюдніть власну чернетку за допомогою text humanizer, збережіть цитування без змін і напишіть чітку заяву про розкриття. Саме таку версію цього процесу можна пройти перед рецензентом, керівником і — зрештою — перед вашим власним сумлінням.
Часті запитання
Q: Чи вважається використання AI humanizer для казахстанських дослідників шахрайством?
Ні, не в разі відповідального використання. Ви олюднюєте власну чернетку, підсилену AI, зберігаєте зміст і цитування та розкриваєте використання AI у форматі, який вимагають ваш інститут і журнал. Це мовна підтримка, що захищає реальну роботу, а не спосіб приховати вигаданий контент чи видати за свій чужі тексти.
Q: Чи гарантує humanizer, що моя стаття пройде Turnitin або GPTZero?
Ні. Перевірений на основних детекторах, він переписує AI-текст у більш природну людську форму — це знижує AI-сигнал і підвищує шанси проти складних детекторів, зберігаючи високу точність граматики для академічного тексту. Це результати тестування, а не обіцянки. Детектори перенавчаються часто, тож жоден інструмент не може чесно гарантувати показник або стверджувати, що ваш текст буде 100% undetectable.
Q: Чи працює він на англійській із казахським та російським впливом?
Так. Humanizer підтримує понад 60 мов і пропускає англомовні тексти з впливом інших мов через мовно-зорієнтовану модель, яка зберігає структуру речень і зміст. Для двомовних носіїв казахської та російської мов він варіює гладкий ритм із низькою перплексією, який детектори часто зчитують неправильно, зберігаючи при цьому ваш науковий тон і технічні терміни.
Q: Чому ретельних авторів із казахською першою мовою позначають частіше, ніж тих, хто пише недбало?
Бо детектори оцінюють передбачуваність, а не якість. Дослідження зі Стенфорда виявило, що приблизно 61% есе, написаних людьми та не носіями, було позначено як AI — проти близько 5% для носіїв. Дисциплінована, стандартна англійська з правильними артиклями, яку створює сильний казахстанський дослідник, — це саме низькоперплексійний текст, який детектор сприймає як машинно згенерований.
Q: Що мені робити, якщо мій рукопис позначили після того, як я його олюднив і розкрив використання?
Ставтеся до позначки як до твердження, яке можна оскаржити, а не як до вироку. Сам Turnitin зазначає, що його оцінку не слід використовувати самостійно для рішень про доброчесність, і кілька університетів вимкнули AI-детекцію через хибні спрацювання. Зберігайте чернетки та нотатки, передайте заяву про розкриття та поясніть ваш процес рецензенту або комісії.
Лінгвістично орієнтований humanizer для мовців казахською та російською мовами: змінюйте ритм, який детектори неправильно зчитують, зберігайте зміст і посилання, а потім з упевненістю розкрийте ваше використання AI.
Мо є інженером NLP із PhD у обробці природної мови. Його дослідження охоплюють комп’ютерну лінгвістику, аналіз тексту та машинне навчання, і це безпосередньо вплинуло на моделі редагування та гуманізації, що стоять за ProofreaderPro. Він пише про ту частину процесу, яку більшість людей ніколи не бачить: як мовна модель читає речення, оцінює його та вирішує, що змінити.


