AI-humanizer для італійських дослідників, які пишуть англійською
AI-humanizer для італійських дослідників. Зменшуйте хибні спрацювання детекторів ШІ на англійській мові з італійським впливом, зберігайте зміст і цитування та чесно розкривайте використання.

Італія входить до восьми-десяти провідних країн світу за обсягом наукових публікацій, але майже жодна з цієї роботи не доходить до читачів італійською. Туттешні академіки мислять і працюють в одній мові, а публікуються в іншій — адже кар’єра в італійських дослідженнях значною мірою вибудовується навколо індексованих англомовних журналів. Оцінювання якості за VQR і національна кваліфікація ASN для професорства спираються на бібліометричні пороги у Scopus та Web of Science, тож публікація англійською в «правильному» журналі не є опцією.
Тепер цей тиск стикається з новішою проблемою. AI-humanizer для італійських дослідників існує тому, що ретельна й коректна англійська як друга мова — саме той тип прози, який детектори ШІ найчастіше сприймають як машинне письмо. Колега зробив(ла) роботу, написав(ла) кожне слово, але все одно отримав(ла) позначку.
Цей гайд — про справедливість, а не про маскування. Завдання — «олюднити» ваш власний чернетковий текст із допомогою ШІ, зберегти зміст і цитування, а потім розкрити використання ШІ так, як того вимагають ваш заклад і журнал.
Уманізатор IA для італійських дослідників, які публікуються англійською
Наш AI-текстовий уманізатор допомагає італійським дослідникам публікуватися англійською так, щоб коректно написаний текст не сприймався як згенерований машиною. Він зберігає значення, технічну термінологію та цитування, а також змінює ритм і лексичні вибори.
Простими словами: ви пишете науку, а інструмент згладжує статистичний «відбиток», через який типова неговорна для носіїв англійська читається як синтетична. Ваш аргумент, ваші дані чи ваші посилання не змінюються. Змінюється лише рівна, передбачувана каденція, яку деякі детектори трактують як «машинний» маркер.
Ви чернеткуєте італійською? Уманізатор виявляє її та переписує безпосередньо
Ви можете «олюднити» італійську чернетку без попереднього перекладу на англійську. Вставте текст — ProofreaderPro автоматично визначить мову, а потім пропустить його через модель, орієнтовану на італійську, зберігаючи акценти, термінологію та цитування на місці. Як umanizzatore di testo IA він варіює ритм вашої італійської наукової прози, зберігаючи кожен результат і кожне посилання. Автоматичне визначення охоплює понад шістдесят мов, тож італійська сприймається як італійська, а не «перебудовується» в англійську.
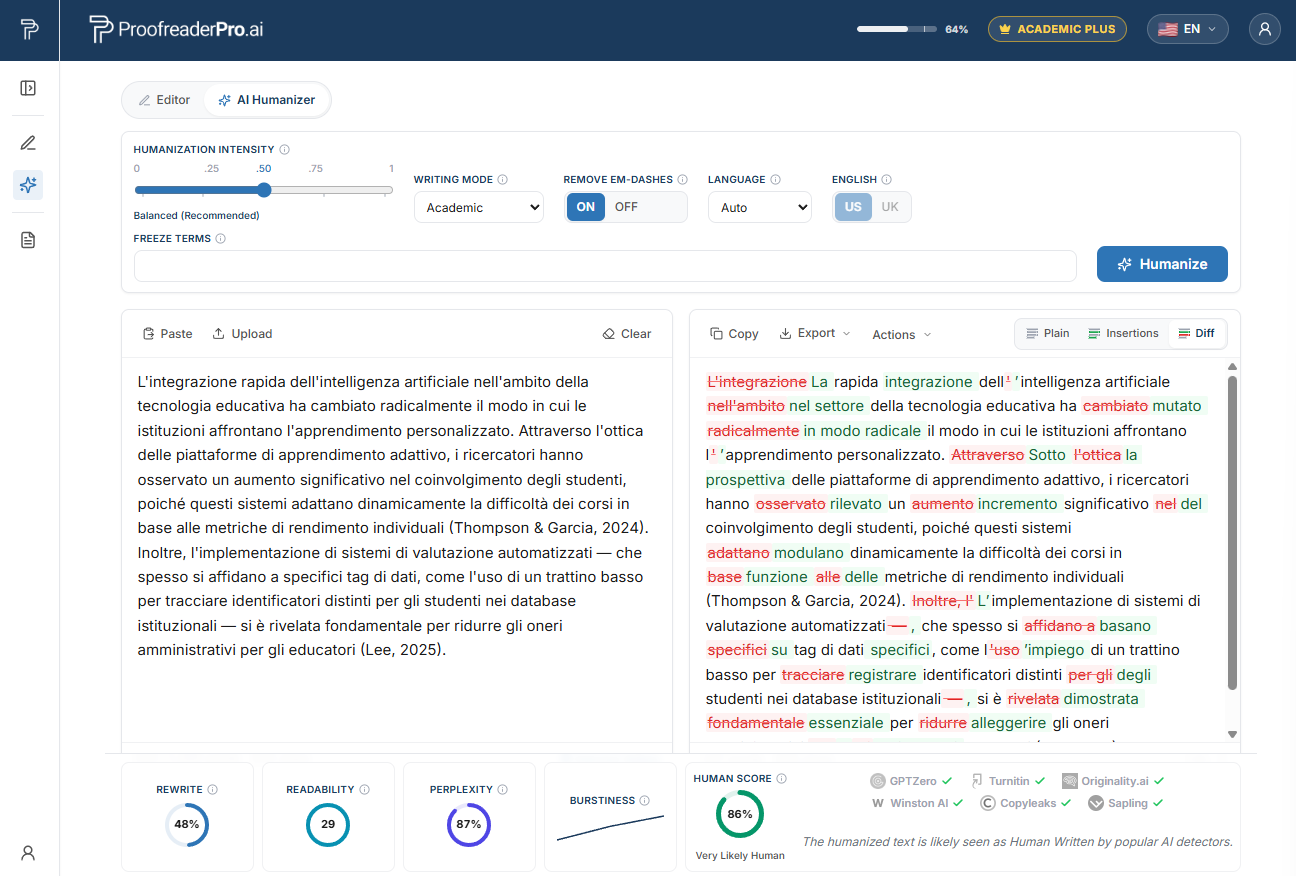
ProofreaderPro AI Humanizer переписує італійський академічний текст. Різниця «до/після» зберігає ваші сенси та цитування, а перевірки детекторів підтверджують природне, людське читання.
Чому італійських дослідників позначають детектори ШІ
У 2023 році команда Стенфорда на чолі з Liang та колегами опублікувала у журналі Cell Press Patterns дослідження з доволі прямолінійною назвою: GPT detectors are biased against non-native English writers. Вони прогнали через сім широко використовуваних детекторів есейні завдання TOEFL, написані людьми.
Результат має насторожити кожного, хто публікується другою мовою. У середньому приблизно 61% неговорних есеїв було позначено як ШІ, тоді як для носіїв — близько 5%. Майже кожен п’ятий, тобто 19,8%, був позначений одностайно всіма детекторами. І кожне з цих есеїв було написано людиною.
Механізм називається perplexity. Детектори вимірюють, наскільки «несподіваними» для мовної моделі є кожні ваші словесні вибори. Обережні автори з другою мовою частіше використовують поширені слова й стандартні, передбачувані формулювання — це дає низьку perplexity, яка читається як машинний текст. Звички, завдяки яким ваша англійська виглядає зрозумілою, — ті самі звички, яких ці інструменти навчені «карано» уникати. Ми розбираємо це докладніше в why AI detectors flag non-native writing.
Італійські патерни першої мови, що стоять за хибними позначками
Жоден із наведених нижче патернів не є помилкою. Це обережні, «підручникові» конструкції, до яких звертається італійський науковець, і саме їхня така регулярність детектор зчитує як низьку perplexity.
Довгі гіпотактичні речення. Італійський академічний стиль тяжіє до довгих періодів із кількома вкладеними підрядними частинами. У перекладі англійською вони залишаються граматичними, але стають щільнішими, а рівний, надто «кваліфікований» ритм виглядає передбачуваним для моделі.
Артиклі з абстрактними іменниками. «Природа», «наука» чи «суспільство» — там, де англійська зазвичай опускає артикль — часто є прямим і послідовним переносом з італійської. Саме така послідовність є тим сигналом, який детектори «винагороджують» низьким балом.
Перенесення прийменників. depend from for dipendere da або on the basis of in place of based on — це системні вибори за правилами. Системні вибори, за визначенням, мають низьку perplexity.
Номіналізація та латинізована лексика. Питомо «важкі» іменникові конструкції на кшталт the realization of the analysis і стійка перевага до латинізованого словника є стандартним формальним регістром. Формальною і стандартною — тобто саме такою, як ці інструменти вміють «фіксувати», — це й виглядає.
Кальковані зв’язки. Часті конектори на початку речення — Moreover, Furthermore та In fact — віддзеркалюють італійські маркери дискурсу й додають регулярної, повторюваної каденції, яка читається як «машинно-вивірена».
Хибні друзі. Attualmente, спрямоване на actually замість currently, або eventualmente, спрямоване на eventually замість possibly, — це корекції, які робить уважний автор, рухаючись до найстандартнішого на вигляд слова. Найстандартніше слово водночас є й найменш несподіваним.
Контекст виявлення ШІ та Turnitin в Італії
Італійські дипломні роботи й рукописи регулярно перевіряють на текстову подібність — найчастіше за допомогою Turnitin або iThenticate. Ці інструменти дедалі частіше показують індикатори ШІ разом із звичним показником подібності. Звіт про подібність — звична практика в докторантських школах та редакційних процесах, і сам по собі він не каже нічого про вашу доброчесність.
Є дві речі, які варто тримати в перспективі. По-перше, індикатор ШІ — це твердження, а не вирок. Сам Turnitin пригнічує бали в діапазоні 1–19% і попереджає, що його значення не повинно самостійно визначати справу про доброчесність. Декілька університетів, зокрема Vanderbilt, Michigan State та UT Austin, повністю вимкнули детектор ШІ, посилаючись на хибні спрацювання та упередженість щодо авторів, які пишуть не рідною мовою.
По-друге, напрям у Італії, як і в інших країнах, — у бік розкриття інформації. Стипендійні організації та журнали все частіше просять вас вказати, де і як ви використовували ШІ. Це очікування — ваш захист: повне розкриття, а не «ідеальний» бал детектора, — те, що тримає вас у межах правил.
Захистіть власне письмо від хибного спрацювання
Зробіть текст, підготовлений за допомогою ШІ, більш людяним за лічені хвилини, зберігши кожну цитату, а потім розкрийте використання. Створено для уважної не носіїв англійської академічної англійської.
Спробуйте Humanizer безкоштовноПровідні італійські університети та місця, де з’являються перевірки ШІ
Описане вище скринінгування відбувається в провідних італійських установах. Докторантські школи та редакційні офіси в цих університетах проганяють дипломні роботи й рукописи через перевірки подібності, а дедалі частіше зважують і індикатори ШІ:
- Sapienza Università di Roma, у Римі
- Università di Bologna (Alma Mater Studiorum), у Болоньї
- Politecnico di Milano та Università degli Studi di Milano (Statale), у Мілані
- Università degli Studi di Padova, у Падуї
- Università degli Studi di Napoli Federico II, у Неаполі
- Politecnico di Torino та Università degli Studi di Torino, у Турині
- Università di Pisa, Scuola Normale Superiore та Scuola Superiore Sant'Anna, у Пізі
- Università degli Studi di Firenze, у Флоренції
- Università degli Studi di Trento, у Тренто
- Università Cattolica del Sacro Cuore, у Мілані
У кожному з них «прапорець» — це початок розмови про ваші методи, а не висновок про вашу чесність. Усвідомлення того, що ці перевірки є рутинними, — підстава підготуватися, а не панікувати.
Як працює AI-humanizer для італійських дослідників
Ось робочий процес — і порядок має значення.
Спершу сформулюйте аргумент. Пишіть італійською, якщо саме там вам найгостріше мислиться, а тоді перекладіть або створіть чернетку напряму англійською. У будь-якому разі ідеї та дані — ваші.
По-друге, виправте граматику. Вичистіть хибні друзі, прийменники та промахи з артиклями, щоб мова була коректною ще до того, як будь-що інше торкнеться тексту. Наші інструменти вичитування створені саме для цього, і ви можете побачити «сестринський» процес у AI proofreading for Italian academics.
По-третє, «олюдніть» власну прозу. Пропустіть чернетку, підготовлену за допомогою ШІ, через AI text humanizer. Він варіює ритм і вибір слів та прибирає повторювану каденцію з низькою perplexity, яка збиває детектори, зберігаючи при цьому ваші сенси, технічну термінологію та цитування.
Інструмент уманізації тестують на основних детекторах, і він перетворює текст, згенерований ШІ, на більш природну форму, що виглядає «по-людськи» для Turnitin, Originality.ai та GPTZero, при цьому зберігаючи високу точність граматики в академічному тексті. Результати отримані тестуванням, а не обіцянками. Ми не обіцяємо «обійти» будь-що, адже детектори перенавчаються кожні кілька місяців.
Четверте — розкрийте інформацію. Вкажіть використання ШІ в тому форматі, який вимагають ваш заклад і цільовий журнал. Саме цей фінальний крок відокремлює чесний захист реальної роботи від маскування.
Цей допис — одна точка входу до нашого multilingual AI humanizer hub, де описано той самий робочий процес для дослідників, які пишуть з інших перших мов. Якщо ваша більша потреба — повне мовне редагування, а не «справедливість» детекторів, почніть із нашого global academic editing hub.
Локальні органи фінансування, журнали та очікування щодо розкриття використання ШІ
Італійське фінансування та оцінювання досліджень відбувається через кілька інституцій, і кожна підвищує ставки щодо того, де саме публікується ваша робота.
MUR (Ministero dell'Università e della Ricerca) фінансує університети та національні гранти. PRIN (Progetti di Ricerca di Rilevante Interesse Nazionale) — головна конкурентна загальнонаціональна програма. CNR (Consiglio Nazionale delle Ricerche) — найбільша в країні державна дослідницька установа. ANVUR проводить і оцінювання VQR, і кваліфікацію ASN та підтримує списки класу A, які мають реальну вагу в гуманітарних і соціальних науках.
Для розміщення публікацій це означає індексування в Scopus і Web of Science та статус ANVUR класу A в непібліометричних дисциплінах. Рукописи, спрямовані в ці журнали, перевіряють за допомогою Turnitin або iThenticate, а кількість журналів і грантодавців, які просять явну заяву про використання ШІ, зростає. Підготуйте таку заяву завчасно, і якщо детектор колись позначить чисту роботу, ставтеся до звіту як до матеріалу для оскарження, а не як до рішення. Фінальна «проливка» через AI text humanizer перед поданням дає неговорній прозі справедливіше читання, а ваше розкриття зберігає весь процес прозорим.
Часті запитання
П: Чи є використання AI-humanizer для італійських дослідників формою шахрайства?
Ні, не тоді, коли ви використовуєте його на власній роботі. Ви виконали дослідження; інструмент лише варіює ритм і вибір слів ретельної неговорної прози, тож її менше шансів прочитати як машинний текст. Правило, яке робить використання прозорим, — це розкриття інформації: ви все одно повідомляєте свій заклад і журнал, як саме ви застосували ШІ.
П: Чи змінить уманізатор мої цитування або технічні терміни?
Ні. Він зберігає ваші посилання, ваші дані та термінологію вашої дисципліни. Він націлений на каденцію з низькою perplexity, на яку реагують детектори, а не на суть вашого аргументу.
П: Чи можете ви гарантувати, що моя стаття пройде Turnitin або GPTZero?
Ні, і будьте обережні з будь-яким інструментом, який обіцяє таке. У наших тестах humanizer перетворює текст ШІ на більш природну форму, що знижує «сигнал ШІ» та підвищує шанси проти складних детекторів, але детектори перенавчаються постійно, тож ми звітуємо про результати тестування, а не про гарантії.
П: Чому мою коректну англійську взагалі позначають?
Тому що детектори оцінюють, наскільки передбачуваними є ваші словесні вибори. Стандартні, «підручникові» італійсько-англійські конструкції — від використання артиклів до латинізованої лексики — надзвичайно передбачувані. Це читається як низька perplexity, яку деякі інструменти трактують як ознаку ШІ. Це задокументована упередженість проти уважного письма другою мовою, а не оцінка вашої роботи.
П: Що мені робити, якщо комітет або журнал позначив мій текст?
Зберігайте спокій і сприймайте позначку як твердження, на яке треба відповісти, а не як вирок. Тримайте при собі чернетки та нотатки, вкажіть на задокументовану упередженість проти авторів, які пишуть не рідною мовою, і поділіться заявою про використання ШІ. Оцінка детектора — це матеріал для оскарження, ніколи не доказ.
Забезпечте Вашій уважній не носіїв англійської англійській більш справедливе прочитання. Збережіть зміст і цитування, зменште кількість хибних спрацювань ШІ, а потім розкрийте використання з упевненістю.
Мо є інженером NLP із PhD у обробці природної мови. Його дослідження охоплюють комп’ютерну лінгвістику, аналіз тексту та машинне навчання, і це безпосередньо вплинуло на моделі редагування та гуманізації, що стоять за ProofreaderPro. Він пише про ту частину процесу, яку більшість людей ніколи не бачить: як мовна модель читає речення, оцінює його та вирішує, що змінити.


