
AI Humanizer สำหรับนักวิจัยชาวสวีเดนที่เขียนภาษาอังกฤษ
AI humanizer สำหรับนักวิจัยชาวสวีเดน ลดการถูกตรวจจับว่าเป็น AI แบบผิดพลาดสำหรับภาษาอังกฤษที่ได้รับอิทธิพลจากสวีเดน รักษาความหมายและการอ้างอิงไว้ และเปิดเผยการใช้งานอย่างตรงไปตรงมา

สวีเดนขับเคลื่อนด้วยภาษาอังกฤษ วิทยานิพนธ์ระดับปริญญาเอกที่ Karolinska Institutet เขียนและนำเสนอ/ปกป้องในภาษานี้ บทความจาก Lund และ Uppsala ก็ถูกเรียบเรียงในภาษานี้ และประเทศอยู่ในกลุ่มผู้นำของ EF English Proficiency Index ติดต่อกันปีแล้วปีเล่า ดังนั้นเมื่อ นักศึกษาปริญญาเอกชาวสวีเดนเรียนรู้ว่าเครื่องตรวจจับ AI ได้ทำเครื่องหมายบทหนึ่งที่เธอเขียนเอง ปฏิกิริยาที่มักเกิดขึ้นจึงเป็นความไม่เชื่ออย่างตรงไปตรงมา
ปฏิกิริยานั้นยุติธรรม AI humanizer สำหรับนักวิจัยชาวสวีเดนมีอยู่ เพราะสำนวนสวีเดน-อังกฤษที่รอบคอบ เป็นมาตรฐาน และลื่นไหลแบบ “ถูกวิธี” คือประเภทของงานเขียนที่เครื่องตรวจจับเหล่านี้มักอ่านผิด เครื่องเขียนภาษาอังกฤษที่ยอดเยี่ยมไม่ได้ช่วยคุณเสมอไป บางครั้งนั่นแหละคือปัญหา
กลไกนี้ทำให้ไม่สบายใจเมื่อคุณเห็นมันแล้ว เครื่องตรวจจับจะให้คะแนนกับการเลือกคำที่น่าประหลาดใจ และลงโทษตัวเลือกที่คาดเดาได้ นักเขียนที่ได้รับการฝึกให้เขียนให้ชัดเจน ใช้คำทั่วไป และจัดโครงสร้างประโยคให้สะอาด Produce ข้อความที่มีความแปลกประหลาดต่อแบบจำลองต่ำ (low-perplexity) และความแปลกประหลาดต่ำนี้เองที่เครื่องตรวจจับให้คะแนนว่าเป็นงานเขียนของเครื่อง
Så kan svenska forskare humanisera AI-text för publicering på engelska
Humanizer ของเราช่วยนักวิจัยชาวสวีเดนให้ทำให้ข้อความที่ช่วยด้วย AI มีความเป็นมนุษย์มากขึ้นในร่างของตนเอง เพื่อให้ภาษาอังกฤษสวีเดนที่ถูกต้องและเขียนอย่างดีไม่ถูกทำเครื่องหมายอย่างผิดพลาดว่าเป็นการ “ซ่อนต้นฉบับด้วย AI” (maskingenererad) ขณะเดียวกันก็ยังคงความหมาย ศัพท์เฉพาะ และการอ้างอิงแหล่งที่มาไว้ครบถ้วน
In plain English: เครื่องมือนี้นำร่างที่คุณช่วยด้วย AI อยู่แล้วของคุณ และปรับเปลี่ยนจังหวะ (rhythm) รวมถึงการเลือกคำ เพื่อให้ภาษาอังกฤษสวีเดนที่สะอาด (clean Swedish-English) มีโอกาสถูกอ่านผิดโดยเครื่องตรวจจับหลัก ๆ น้อยลง มันคงการอ้างอิงของคุณ ศัพท์เทคนิคของคุณ และข้อโต้แย้งของคุณไว้ครบถ้วน มันไม่ได้เขียนบทความของคุณให้ และไม่ได้ถูกออกแบบมาเพื่อซ่อนสิ่งใดๆ
เขียนเป็นภาษาสวีเดนอยู่แล้วใช่ไหม? ระบบตรวจจับได้อัตโนมัติและทำให้เป็นมนุษย์อย่างเป็นธรรมชาติ
นักวิจัยชาวสวีเดนจำนวนมากร่างงานเป็นภาษาแรกก่อนจะย้ายไปเป็นภาษาอังกฤษ และ humanizer จะรองรับขั้นตอนนั้น เพียงนำข้อความภาษาสวีเดนมาวาง แล้ว ProofreaderPro จะตรวจจับภาษาได้เอง จากนั้นประมวลผลด้วยโมเดลที่ “เข้าใจภาษา” ซึ่งคงไว้ได้อย่างถูกต้องทั้งอักขระ å, ä, และ ö ศัพท์เฉพาะของคุณ และการอ้างอิงของคุณในตำแหน่งเดิม To humanisera AI-text คุณสามารถเริ่มจากร่างภาษาสวีเดนของคุณ ซึ่งจะถูกเขียนใหม่ได้อย่างลื่นไหลพอ ๆ กับการเขียนเป็นภาษาอังกฤษ การตรวจจับแบบเดียวกันครอบคลุมมากกว่า 60 ภาษา และทำให้แต่ละภาษามีความเป็นเสียงของตนเอง
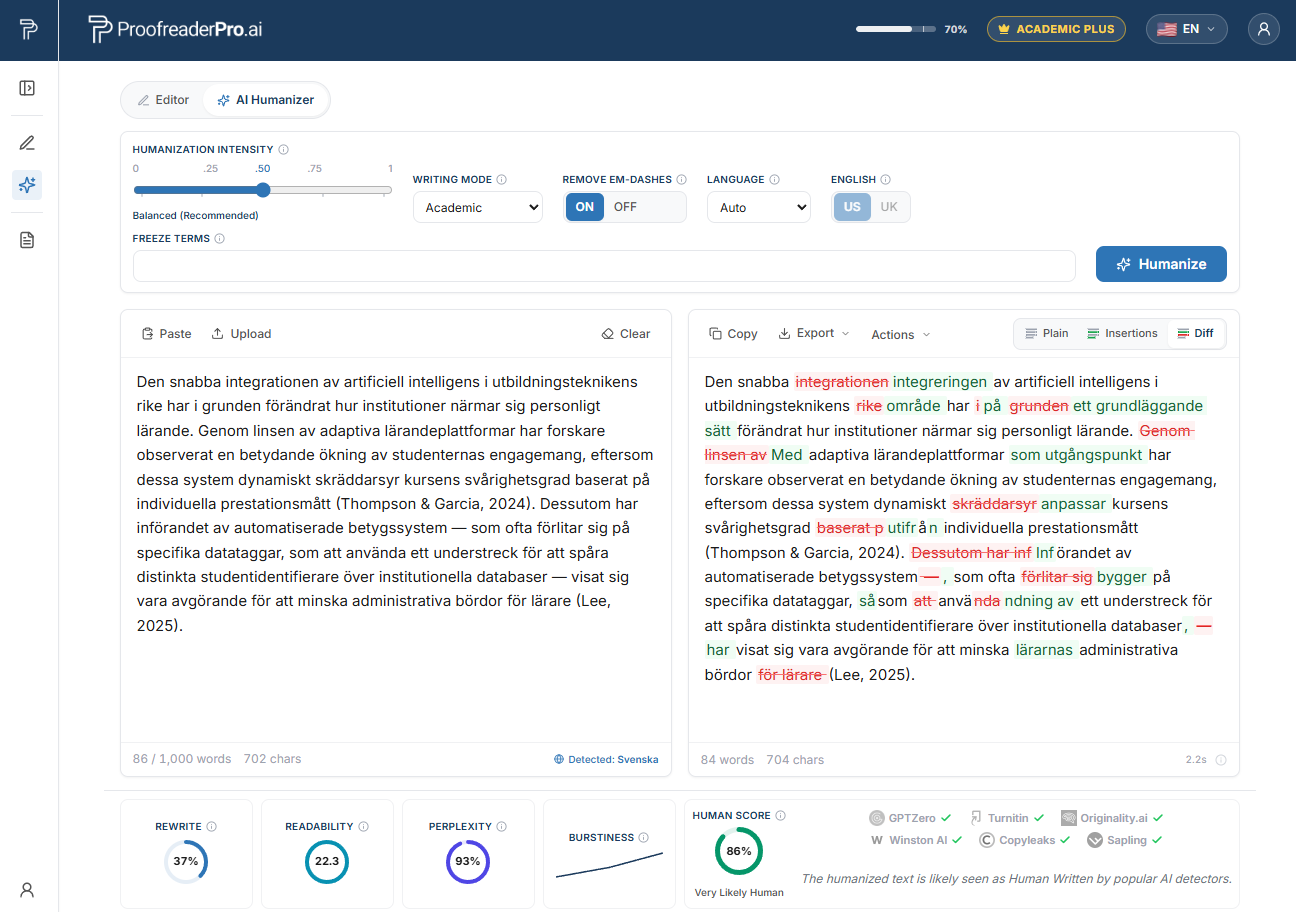
ProofreaderPro AI Humanizer ที่เขียนใหม่เพื่อทำให้ข้อความวิชาการภาษาสวีเดนมีความเป็นมนุษย์ยิ่งขึ้น ความแตกต่างก่อน-หลัง (before and after diff) ยังคงความหมายและการอ้างอิงไว้ และการตรวจของเครื่องตรวจจับยืนยันว่าการอ่านนั้นเป็นธรรมชาติและเป็นมนุษย์
เหตุใดนักวิจัยชาวสวีเดนจึงถูกทำเครื่องหมายโดยเครื่องตรวจจับ AI
เริ่มจากงานวิจัยที่ใส่ตัวเลขให้เห็นปัญหา ในปี 2023 ทีมงานของ Stanford นำโดย Liang และคณะ ได้ตีพิมพ์ "GPT detectors are biased against non-native English writers" ในวารสาร Patterns ของ Cell Press พวกเขานำเรียงความ TOEFL ที่เขียนโดยมนุษย์ไปทดสอบผ่านเครื่องตรวจจับที่เป็นที่นิยมใช้งานกันอย่างแพร่หลายถึงเจ็ดแบบ
ผลลัพธ์ชัดเจนมาก โดยเฉลี่ยแล้วเรียงความของผู้เขียนที่ไม่ใช่เจ้าของภาษา (non-native) ประมาณ 61% ถูกทำเครื่องหมายว่าเป็น AI เทียบกับราว 5% สำหรับผู้เขียนเจ้าของภาษาอังกฤษ (native English writers) เกือบหนึ่งในห้า (ประมาณ 19.8%) ของเรียงความที่ไม่ใช่เจ้าของภาษา ถูกทำเครื่องหมายแบบเป็นเอกฉันท์โดยเครื่องตรวจจับทุกตัวในชุดทดสอบ และเรียงความทุกชิ้นถูกเขียนโดยมนุษย์
สาเหตุคืออะไร? เครื่องตรวจจับหลายแบบให้คะแนนกับ perplexity ซึ่งเป็นตัวชี้วัดว่าคำถัดไปแต่ละคำ “คาดไม่ถึงเพียงใด” ต่อโมเดลภาษา ผู้เขียนภาษาที่สองอย่างรอบคอบจะเลือกใช้คำทั่วไปและโครงสร้างมาตรฐาน ซึ่งเป็นงานเขียนที่ดีอยู่แล้ว แต่ก็ทำให้เกิดข้อความที่คาดเดาได้และมี perplexity ต่ำ นิสัยที่ทำให้สวีเดน-อังกฤษชัดเจน คือสิ่งเดียวกับที่ระบบเหล่านี้ถูกฝึกให้ตรวจจับ เราอธิบายกลไกอย่างละเอียดมากขึ้นใน why AI detectors flag non-native English
ประเด็นนี้ไม่ใช่เรื่องนามธรรม นักวิจัยที่ไม่ใช่เจ้าของภาษายังต้องเผชิญอัตราการถูกปฏิเสธสูงกว่าผู้พูดเจ้าของภาษาอยู่แล้วประมาณ 2.5 เท่า ใช้เวลาร่างงานราว 51% มากขึ้น และต้องรับคำร้องขอให้แก้ไขด้านคุณภาพภาษาเป็นจำนวนมากกว่ามาก การถูกทำเครื่องหมายว่าเป็น AI แบบผิดพลาดจึงไปทับอยู่บน “กำแพง” ที่สูงอยู่แล้ว
รูปแบบภาษาสวีเดน-ภาษาอังกฤษในภาษาแรก ที่อยู่เบื้องหลังการถูกทำเครื่องหมายผิด
ภาษาอังกฤษเชิงวิชาการของสวีเดนมี “รูปทรง” ที่จำได้ และไม่มีสิ่งใดที่ผิดทั้งหมด ล้วนเป็นโครงสร้างที่ถูกต้อง รอบคอบ และเป็นมาตรฐาน ความเป็นมาตรฐานนี่แหละคือกับดัก เพราะความเป็นมาตรฐานทำให้เครื่องตรวจจับมองว่ามี perplexity ต่ำ
เพื่อนเทียมคือสัญญาณคลาสสิก "Aktuell" หมายถึง “current” หรือ “relevant” ไม่ใช่ "actual"; "eventuellt" หมายถึง “possibly” ไม่ใช่ "eventually"; "kontrollera" หมายถึง “to check” ไม่ใช่ "to control" ผู้เขียนชาวสวีเดนที่เขียนว่า "we controlled the temperature" เพื่อหมายถึง "we checked it" กำลังใช้คำศัพท์ที่แม่นยำและตั้งใจ ซึ่งเป็นชนิดที่โมเดลทำนายได้ง่าย
ลำดับคำก็ส่งต่อด้วย สวีเดนเป็นภาษาแบบกริยาที่สอง (verb-second) ดังนั้นกริยาที่เป็นตัวแสดง (finite verb) จึงต้องการตำแหน่งที่สอง พฤติกรรมนี้ทำให้เกิดประโยคที่ค่อนข้างมีการวัดผลและดูเป็นทางการเล็กน้อย และเมื่อแก้ไขแล้ว ("Therefore the model is robust") ความ “สม่ำเสมอ” ที่เหลืออยู่ก็ถูกเครื่องตรวจจับอ่านว่าเป็นจังหวะที่เหมือนเครื่อง
ยังมีเรื่องคำนำหน้านาม (articles) ด้วย ภาษาสวีเดนแสดงความชัดเจน/ความไม่ชัดเจนด้วยคำลงท้าย (suffix) มากกว่าคำแยก ดังนั้นคำนำหน้านามในภาษาอังกฤษจึงถูกละหรือล้ำขึ้นเป็นสองครั้ง เช่น "the research show", "result was significant" เมื่อผู้ตรวจพิสูจน์แก้ไขสิ่งเหล่านี้ออกมา งานที่ได้จะสม่ำเสมอและเรียบร้อย และความสม่ำเสมอนี่เองคือสิ่งที่ให้คะแนนเป็น perplexity ต่ำ
ยังมีสัญญาณเล็ก ๆ น้อย ๆ ที่พบซ้ำอยู่บ่อยครั้ง: "since" ที่ถูกใช้แทน "for" สำหรับช่วงเวลา การใช้คำนามประกอบ (compound nouns) อย่างหนัก และคำว่า "respective" รวมถึงโทนการเขียนที่ค่อนข้างไม่เน้น (understated) ซึ่งผู้ประเมินบางคนอาจตีความว่าเรียบแบน แต่ละทางเลือกเหล่านี้มีเหตุผลรองรับได้ในตัวเอง เมื่อรวมกันแล้วมันทำให้เกิดงานเขียนที่ลื่นไหล สม่ำเสมอ และคาดการณ์ล่วงหน้าได้ง่ายสำหรับโมเดล
ปกป้องสวีดิช-อังกฤษของท่านก่อนส่งผลงาน
ทำให้ฉบับร่างที่ช่วยด้วย AI ของท่านเป็นธรรมชาติมากขึ้น คงการอ้างอิงและความหมายของท่านไว้ จากนั้นเปิดเผยการใช้ AI ของท่าน ลองกับย่อหน้าเดียวในวิทยานิพนธ์ของท่าน แล้วจะเห็นความแตกต่าง
ลองใช้ Humanizer ฟรีบริบทการตรวจจับ AI ของสวีเดนและ Turnitin
วิทยานิพนธ์และต้นฉบับในสวีเดนถูกคัดกรองเป็นกิจวัตร การตรวจสอบความคล้ายคลึงเป็นแนวปฏิบัติมาตรฐานในทั้งภาคส่วน และมหาวิทยาลัยสวีเดนหลายแห่งเคยพึ่งพาระบบ Urkund และ Ouriginal ที่พัฒนาภายในประเทศ ซึ่งปัจจุบันได้รวมอยู่ใน Turnitin แล้ว ตัวชี้วัด AI จะถูกวางไว้เคียงข้างคะแนนความคล้ายคลึงมากขึ้นเรื่อย ๆ ในรายงานชุดเดียวกัน
คำแนะนำกำลังตามทัน เครื่องมือของสมาคมสถาบันอุดมศึกษาสวีเดน (SUHF) และมหาวิทยาลัยแต่ละแห่งได้ออกแนวทางด้าน generative-AI และผู้ให้ทุนกับวารสารยิ่งขอให้ระบุอย่างชัดเจนว่ามีการใช้งาน AI อย่างไรบ่อยขึ้น ทิศทางคือการ “เปิดเผย” ไม่ใช่การ “ห้าม”
สิ่งหนึ่งที่ควรจำไว้: คะแนนจากเครื่องตรวจจับคือ “ข้อกล่าวอ้าง” ไม่ใช่ “คำตัดสิน” ตัวของ Turnitin เองจะกดทับคะแนนช่วงต่ำแทนการแสดงเป็นตัวเลข และยังเตือนว่าคะแนนของมันไม่ควรนำไปใช้เพียงลำพังในการตัดสินคดีด้านความซื่อสัตย์ (integrity) มหาวิทยาลัยหลายแห่งในต่างประเทศ รวมถึง Vanderbilt ได้ปิดการใช้งานเครื่องตรวจจับ AI ทั้งหมดด้วยเหตุผลเรื่อง false positives และอคติต่อผู้เขียนที่ไม่ใช่เจ้าของภาษา การถูกทำเครื่องหมายคือสิ่งที่ต้องโต้แย้ง ไม่ใช่การสารภาพ
มหาวิทยาลัยชั้นนำของสวีเดนและจุดที่พบการตรวจ AI
เครื่องมือคัดกรองแบบเดียวกันจะปรากฏในสถาบันชั้นนำทั่วสวีเดน ตั้งแต่คณะแพทย์ไปจนถึงมหาวิทยาลัยเทคนิค:
- Karolinska Institutet (KI), Stockholm (medicine)
- Uppsala universitet, Uppsala
- Lunds universitet, Lund
- Kungliga Tekniska högskolan (KTH), Stockholm
- Stockholms universitet (SU), Stockholm
- Göteborgs universitet (GU), Gothenburg
- Chalmers tekniska högskola, Gothenburg
- Linköpings universitet (LiU), Linköping
- Umeå universitet, Umeå
- Sveriges lantbruksuniversitet (SLU), Uppsala
- Örebro universitet, Örebro
- Linnéuniversitetet, Växjö and Kalmar
ทุกสถาบันเหล่านี้ทำการคัดกรองวิทยานิพนธ์และต้นฉบับเพื่อความคล้ายคลึง และปัจจุบันยังให้ค่าน้ำหนักกับตัวชี้วัด AI ในเวิร์กโฟลว์เดียวกันมากขึ้น จุดสำคัญไม่ใช่ว่าสถาบันใด “ไม่เป็นมิตร” กับคุณ แต่คือการถูกทำเครื่องหมายแบบผิดพลาดอาจเกิดขึ้นกับงานที่รอบคอบในสถาบันใดก็ได้ ดังนั้นทางเลือกที่เหมาะสมคือปกป้องงานเขียนของคุณก่อนจะส่ง
วิธีการทำงานของ AI humanizer สำหรับนักวิจัยชาวสวีเดน
เวิร์กโฟลว์ทั้งซื่อสัตย์และเรียบง่าย และเริ่มต้นจากร่างของคุณเอง
เขียนก่อน นักวิจัยชาวสวีเดนจำนวนมากร่างงานเป็นภาษาสวีเดน ซึ่งทำให้คิดได้เร็วที่สุด แล้วจึงแปล ในขณะที่บางคนร่างลงเป็นภาษาอังกฤษโดยตรง ไม่ว่าคุณจะเลือกทางใด คำและข้อโต้แย้งนั้นเป็นของคุณเอง
ตรวจไวยากรณ์ ทำความสะอาดเพื่อนเทียม (false friends) คำนำหน้านามที่ถูกละ และการส่งต่อโครงสร้างที่ต้องมี “กริยาอันดับสอง” Our AI proofreader แก้ไขกลไก (mechanics) โดยไม่ทำให้ความหมายของคุณแบนราบ และเมื่อไวยากรณ์มั่นคงแล้ว คุณจึงไปยังขั้น humanizer
จากนั้นทำให้ข้อความที่คุณช่วยด้วย AI ของตนเองมีความเป็นมนุษย์ ขั้นนี้คือจุดที่ AI humanizer for Swedish researchers ปรับจังหวะและการเลือกคำ แยกความสม่ำเสมอที่มากเกินไป ออกแบบแพตเทิร์นที่ซ้ำ ๆ และตัดเครื่องหมาย dash ยาว (em dashes) ที่ทำให้เครื่องตรวจจับสะดุด ในการทดสอบของเราเอง สิ่งนี้ช่วยลดอย่างมีนัยสำคัญว่าข้อความภาษาอังกฤษสวีเดนที่รอบคอบและเป็นมาตรฐานจะถูกอ่านผิดบ่อยเพียงใดโดยเครื่องตรวจจับหลัก ๆ (Turnitin, Originality.ai, GPTZero และกลุ่มที่คล้ายกัน) ขณะเดียวกันก็ยังรักษาความหมาย ศัพท์เฉพาะ และการอ้างอิงของคุณไว้ เราอธิบายสิ่งนี้ว่าเป็นสิ่งที่เราเห็นจากการทดสอบ ไม่ใช่คำสัญญา เครื่องตรวจจับจะฝึกใหม่ทุก ๆ ไม่กี่เดือน และไม่มีเครื่องมือที่ซื่อสัตย์ใดอ้างได้ว่าสามารถ “ตรวจไม่พบ 100%”
รองรับร่างที่ไม่ใช่ภาษาอังกฤษด้วยเช่นกัน humanizer รองรับมากกว่า 60 ภาษา และส่งข้อความที่ไม่ใช่ภาษาอังกฤษผ่านโมเดลที่ “เข้าใจภาษา” โดยคงโครงสร้างประโยคและความหมายไว้ ซึ่งสำคัญหากคุณทำให้ร่างภาษาสวีเดนมีความเป็นมนุษย์ก่อนจะแปล โพสต์นี้คือหนึ่งในโหนดของ multilingual AI humanizer hub ของเรา และอยู่คู่กับ global academic editing hub สำหรับงานที่ครอบคลุมทั้งต้นฉบับ
จากนั้นเปิดเผย การทำให้ข้อความของคุณเองมีความเป็นมนุษย์ไม่ใช่การซ่อนมัน ระบุว่าคุณใช้งาน AI อย่างไรตามรูปแบบที่ภาควิชาและวารสารเป้าหมายของคุณกำหนด แล้วคุณจะอยู่ภายในกรอบกติกาความซื่อสัตย์ (integrity rules) อย่างเต็มที่ ขณะเดียวกันก็ปกป้องงานของคุณจากการถูกทำเครื่องหมายแบบผิดพลาด
หน่วยงานให้ทุนท้องถิ่น วารสาร และความคาดหวังด้านการเปิดเผยการใช้ AI
ผู้ให้ทุนของสวีเดนคาดหวังความโปร่งใสเกี่ยวกับการใช้ AI มากขึ้นเรื่อย ๆ Vetenskapsrådet (the Swedish Research Council, VR) เป็นผู้ให้ทุนสาธารณะหลัก และ Knut and Alice Wallenberg Foundation (KAW) เป็นผู้ให้ทุนเอกชนรายใหญ่ Forte (health, working life, welfare), Formas (environment and agriculture) และ Vinnova (innovation) สนับสนุนโดเมนของตนเอง กลุ่มจากสวีเดนได้รับทุน ERC อย่างสม่ำเสมอ และการเข้าถึงแบบ open access ถูกกำหนดในทุกด้าน
ในด้านการตีพิมพ์ นักวิจัยชาวสวีเดนมุ่งเป้าวารสารที่ถูกจัดทำดัชนีใน Web of Science และ Scopus และลงทะเบียนผลงานใน SwePub วารสารเหล่านั้นมักขอการระบุหมายเหตุอย่างชัดเจนเกี่ยวกับความช่วยเหลือจาก AI มากขึ้นเรื่อย ๆ ตอนนี้ การเปิดเผยสั้น ๆ แบบซื่อสัตย์ควรอยู่ในส่วน methods หรือ acknowledgements ตามปกติ และการทำให้ถูกต้องนั้นง่ายกว่าที่คนส่วนใหญ่มักคิด ดูคู่มือของเราสำหรับการเขียน AI disclosure statement และหากงานยังถูกทำเครื่องหมายแม้ผ่านกระบวนการที่สะอาดและเปิดเผยแล้ว appeal playbook จะอธิบายวิธีตอบกลับ
สิ่งที่เชื่อมโยงกันตรงนี้คือ “ความเป็นธรรม” คุณทำการวิจัย คุณเขียนบทความ และคะแนน perplexity ไม่ควรได้รับอนุญาตให้มาบดบังความจริงนั้น
คำถามที่พบบ่อย
Q: AI humanizer จะช่วยได้ไหม ถ้าภาษาอังกฤษของฉันดีอยู่แล้วมาก?
มักจะช่วยได้ และนี่คือส่วนที่สวนความคาดคิด เครื่องตรวจจับจะทำเครื่องหมายข้อความที่มี perplexity ต่ำ และภาษาอังกฤษสวีเดนที่ขัดเกลา เป็นมาตรฐาน มักมี perplexity ต่ำอยู่แล้วตามธรรมชาติ humanizer จะปรับจังหวะและสำนวนของคุณ ทำให้การเขียนที่สะอาดอ่านยากต่อการถูกอ่านผิด โดยไม่เปลี่ยนสิ่งที่คุณพูดจริง ๆ
Q: การ humanise ข้อความที่ช่วยด้วย AI ในวิทยานิพนธ์ของตัวเองผิดกฎหรือไม่?
การ humanize ร่างของตนเองแล้วจึงเปิดเผยการใช้ AI โดยมากไม่ได้ผิดกฎในสถานศึกษาเกือบทั้งหมด สิ่งที่กฎให้ความสำคัญคือการไม่ส่งผ่านงานที่แต่งขึ้นหรือไม่ได้เปิดเผยว่าเป็นของตนเอง เมื่อคุณคงความหมายและการอ้างอิงไว้ และระบุอย่างชัดเจนว่าคุณใช้ AI อย่างไร คุณก็ยังอยู่ภายในกรอบความซื่อสัตย์
Q: มีเครื่องมือใดที่รับประกันได้ว่าบทความของฉันจะผ่าน Turnitin หรือ GPTZero?
ไม่มี และระวังคนที่บอกเป็นอย่างอื่น เครื่องตรวจจับจะเปลี่ยนโมเดลทุก ๆ ไม่กี่เดือน ดังนั้นไม่มีเครื่องมือที่ซื่อสัตย์ใดรับประกันผลลัพธ์หรืออ้างว่า “ตรวจไม่พบ 100%” สิ่งที่เราพูดได้คือ ในการทดสอบของเรา humanizer ช่วยลดการถูกทำเครื่องหมายแบบผิดพลาดบนงานเขียนที่ไม่ใช่เจ้าของภาษาอย่างรอบคอบได้อย่างมีนัยสำคัญ ซึ่งต่างจากการรับประกัน
Q: humanizer เปลี่ยนการอ้างอิงหรือคำศัพท์เชิงเทคนิคของฉันไหม?
ไม่ มันถูกออกแบบมาเพื่อรักษาการอ้างอิง ศัพท์เฉพาะทางเทคนิค และเนื้อหาสาระของข้อโต้แย้งของคุณ ขณะที่ยังปรับจังหวะและการเลือกคำ รายการอ้างอิงของคุณ สมการของคุณ และคำศัพท์ในสาขาของคุณจะยังคงอยู่ตามที่คุณเขียนไว้
Q: ฉันร่างเป็นภาษาสวีเดนก่อนตั้งแต่แรก แบบนี้สำคัญไหม?
ไม่ใช่ปัญหา humanizer รองรับมากกว่า 60 ภาษา และประมวลผลข้อความที่ไม่ใช่ภาษาอังกฤษด้วยโมเดลที่เข้าใจภาษา ซึ่งปกป้องโครงสร้างประโยคและความหมาย ดังนั้นคุณทำงานเป็นภาษาสวีเดนและแปล หรือทำให้ข้อความมีความเป็นมนุษย์หลังจากแปลเป็นภาษาอังกฤษได้
ลดการเตือนว่าเป็น AI แบบไม่ถูกต้องในงานเขียนภาษาอังกฤษที่ไม่ใช่ภาษาแม่อย่างรอบคอบ โดยคงความหมาย คำศัพท์ และการอ้างอิงของท่านไว้ ออกแบบมาเพื่อผู้วิจัยที่ตีพิมพ์เป็นภาษาอังกฤษ

Moe เป็นวิศวกร NLP ที่มี PhD ในการประมวลผลภาษาธรรมชาติ งานวิจัยของเขาครอบคลุมภาษาศาสตร์เชิงคำนวณ การวิเคราะห์ข้อความ และการเรียนรู้ของเครื่อง และป้อนโดยตรงไปยังโมเดลการแก้ไขและการทำให้มีมนุษยธรรมที่อยู่เบื้องหลัง ProofreaderPro เขาเขียนเกี่ยวกับส่วนหนึ่งของกระบวนการที่คนส่วนใหญ่ไม่เคยเห็นมาก่อน เช่น วิธีที่โมเดลภาษาอ่านประโยค ให้คะแนน และตัดสินใจว่าจะเปลี่ยนแปลงอะไร


