
AI Humanizer สำหรับนักวิจัยชาวดัตช์ที่เขียนภาษาอังกฤษ
AI humanizer สำหรับนักวิจัยชาวดัตช์ ลดการถูกตรวจจับว่าเป็น AI แบบผิดพลาดสำหรับภาษาอังกฤษที่ได้รับอิทธิพลจากดัตช์ โดยคงความหมายและการอ้างอิงไว้ และเปิดเผยการใช้งานอย่างตรงไปตรงมา

เนเธอร์แลนด์เผยแพร่ผลงานวิจัยที่มีผลกระทบสูงต่อประชากรต่อหัวมากกว่าประเทศเกือบทุกแห่งบนโลก และแทบทั้งหมดปรากฏในรูปแบบภาษาอังกฤษ นักวิชาการชาวดัตช์ครองอันดับอยู่ระดับบนสุดหรือใกล้เคียงที่สุดของ EF English Proficiency Index ทุกปี ดังนั้นต้นฉบับจากอัมสเตอร์ดัมหรือเดลฟต์มักจะมาถึงได้อย่างสะอาด ชัดเจน และถูกต้องตามหลักไวยากรณ์ราวกับ “ตำราเรียน” แต่แล้วเครื่องตรวจจับ AI อ่านร้อยแก้วที่ดูดีและแม่นยำชุดเดิมนั้น และกลับให้ความน่าจะเป็นสูงว่า “สร้างโดย AI” ทันใดนั้น นักวิจัยที่เขียนทุกคำด้วยตนเองก็ถูกถามให้ชี้แจงตนเอง ปัญหาเฉพาะนี้คือสิ่งที่ AI humanizer สำหรับนักวิจัยชาวดัตช์ถูกออกแบบมาเพื่อแก้ไข
นี่คือความประชดที่ไม่สบายใจ ยิ่งภาษาอังกฤษของคุณดีเท่าไร รูปแบบถ้อยคำมักยิ่งเป็นมาตรฐานและคาดเดาได้มากเท่านั้น และรูปแบบที่คาดเดาได้คือสิ่งที่เครื่องตรวจจับในปัจจุบันให้คะแนนว่าเป็นงานเขียนเชิงเครื่อง Strong Dutch English ไม่ได้ช่วยปกป้องบทความจากการถูกฟ้องผิด (false flag) ไม่กี่ทางก็อาจยิ่งชวนให้ถูกตรวจเจอด้วยซ้ำ
คู่มือนี้จะอธิบายว่าเหตุใดจึงเกิดขึ้น นิสัยพื้นฐานของผู้เขียนภาษาแรกชาวดัตช์แบบใดที่เป็นตัวกระตุ้น ตลอดจนระบบการประเมินความคล้ายคลึงและการคัดกรอง AI ของมหาวิทยาลัยในเนเธอร์แลนด์ และคุณจะปกป้องงานเขียนของตนเองอย่างซื่อสัตย์ได้อย่างไร: humanize ฉบับร่างที่ใช้ AI ช่วยซึ่งคุณได้เขียนไว้แล้ว คงความหมายและการอ้างอิงไว้ จากนั้นเปิดเผยการใช้งาน AI ตามที่สถาบันและวารสารของคุณกำหนด
AI-tekst humaniseren สำหรับนักวิจัยชาวดัตช์ที่ตีพิมพ์เป็นภาษาอังกฤษ
humanizer ของเราช่วยให้นักวิจัยชาวดัตช์เผยแพร่ต้นฉบับภาษาอังกฤษได้ โดยไม่ให้ร้อยแก้วที่รอบคอบและถูกต้องถูกมองว่าเป็น “ข้อความจากเครื่อง” อย่างไม่เป็นธรรม วัตถุประสงค์ของการทำ AI-tekst humaniseren นั้นเรียบง่าย: ความหมาย คำศัพท์ และการอ้างอิงแหล่งที่มาได้รับการคงไว้ ขณะที่จังหวะและการเลือกคำถูกทำให้เป็นธรรมชาติมากขึ้น
พูดแบบง่าย ๆ ในภาษาอังกฤษ: humanizer ทำงานกับฉบับร่างที่คุณเขียนไว้แล้ว หรือที่ร่างขึ้นโดยใช้ความช่วยเหลือจาก AI ช่วย มันปรับจังหวะของประโยค ทำให้จังหวะซ้ำ ๆ แตกกระจาย และขจัด “สัญญาณ” ที่ทำให้เครื่องตรวจจับสะดุด โดยไม่แตะต้องข้อโต้แย้ง ข้อมูล หรือเอกสารอ้างอิงของคุณ สำหรับข้อความที่ไม่ใช่ภาษาอังกฤษ ระบบจะส่งผ่านโมเดลที่รับรู้ภาษา ซึ่งคงโครงสร้างและความหมายไว้ข้ามมากกว่าหกสิบภาษา
เขียนเป็นภาษาดัตช์? ระบบตรวจจับอัตโนมัติและทำให้เป็นแบบ “มนุษย์” โดยตรง
คุณไม่จำเป็นต้องแปลฉบับร่างเป็นภาษาอังกฤษก่อนจะทำให้เป็นแบบ humanized คุณสามารถวางข้อความภาษาดัตช์ได้เลย แล้ว ProofreaderPro จะตรวจจับภาษาเอง จากนั้นส่งต่อผ่านโมเดลที่เข้าใจภาษาดัตช์ ซึ่งคงคำศัพท์ คำประสม และการอ้างอิงไว้ “ตามที่เขียน” อย่างถูกต้อง นี่คือ AI-tekst humaniseren ที่ประยุกต์กับภาษาแรกของคุณ: ฉบับร่างภาษาดัตช์ของคุณถูก humanize ได้พอ ๆ กับฉบับภาษาอังกฤษ ระบบตรวจจับเดียวกันนี้ครอบคลุมมากกว่าหกสิบภาษา จึงทำให้ภาษาดัตช์ถูกเขียนใหม่เป็น “ภาษาดัตช์” แทนที่จะถูกทำให้แบนเป็นภาษาอังกฤษ
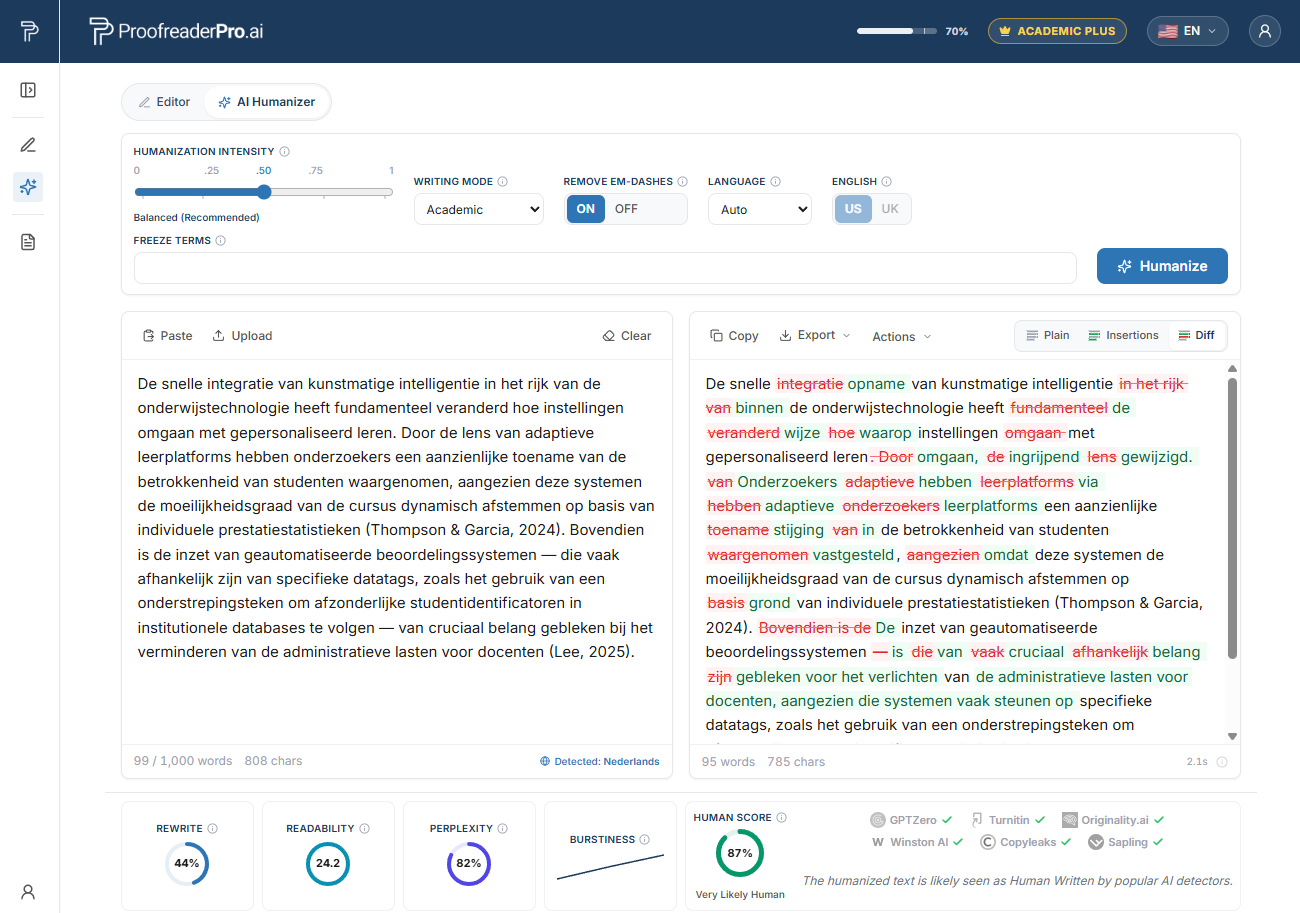
ProofreaderPro AI Humanizer ปรับข้อความเชิงวิชาการภาษาอังกฤษของชาวดัตช์ให้เป็นแบบมนุษย์ โดยความแตกต่างก่อนและหลัง (before and after diff) จะคงความหมายและการอ้างอิงไว้ และการตรวจของตัวตรวจจับยืนยันว่าการอ่านเป็นธรรมชาติแบบมนุษย์
เหตุใดนักวิจัยชาวดัตช์จึงถูกแจ้งเตือนโดยเครื่องตรวจจับ AI
ในปี 2023 ทีมงานจากมหาวิทยาลัย Stanford นำโดย Weixin Liang ได้ตีพิมพ์งานวิจัยในวารสาร Patterns ของ Cell Press ภายใต้หัวข้อที่ตรงไปตรงมา: "GPT detectors are biased against non-native English writers." พวกเขานำเรียงความ TOEFL ที่เขียนโดยมนุษย์ไปตรวจผ่านเครื่องตรวจจับ AI ที่ใช้อย่างแพร่หลาย 7 รายการ โดยเฉลี่ยแล้ว เรียงความที่เขียนโดยผู้ที่ไม่ใช่เจ้าของภาษาอังกฤษประมาณ 61% ถูกติดธงว่าเป็น AI-generated สำหรับเรียงความที่เขียนโดยเจ้าของภาษา ตัวเลขอยู่ราว 5% ในขณะที่เกือบหนึ่งในห้าของเรียงความจากผู้ที่ไม่ใช่เจ้าของภาษา ซึ่งคิดเป็นประมาณ 19.8% ถูกติดธงแบบ “เห็นพ้องกันอย่างเอกฉันท์” โดยเครื่องตรวจจับทุกตัว ไม่มีใครในนั้นที่ไม่ใช่มนุษย์เขียน
ควรทำความเข้าใจกระบวนการนี้ เพราะมันอธิบายว่าทำไม “ความลื่นไหล” จึงไม่ใช่เกราะป้องกัน เครื่องตรวจจับจำนวนมากให้คะแนนสิ่งที่เรียกว่า perplexity ซึ่งเป็นการวัดว่าการเลือกคำแต่ละคำในแบบจำลองภาษานั้น “น่าประหลาดใจ” หรือ “คาดไม่ถึง” เพียงใด การเขียนที่ใช้คำทั่วไปในชุดค่าผสมที่เป็นมาตรฐานและเป็นที่คาดหมายจะให้ perplexity ต่ำ และ perplexity ที่ต่ำถูกอ่านว่าเป็นข้อความจากเครื่อง ผู้เขียนบทความวิชาการที่รอบคอบ โดยเฉพาะผู้ที่ทำงานในภาษาที่สอง มักเลือกถ้อยคำที่ชัดเจนและเป็นแบบแผนอย่างแม่นยำ เพราะปลอดภัยและถูกต้อง นิสัยที่ทำให้งานเขียนอ่านง่ายคือสิ่งเดียวกันกับที่เครื่องตรวจจับถูกฝึกมาให้ “ลงโทษ”
นักวิจัยชาวดัตช์อยู่ในจุดที่คับขันตรงนี้ ทักษะภาษาอังกฤษในเนเธอร์แลนด์โดดเด่นมาก ซึ่งหมายความว่าภาษาอังกฤษเชิงวิชาการของชาวดัตชมักสะอาดและเป็นมาตรฐานมากกว่าโดยเฉลี่ยเมื่อเทียบกับต้นฉบับภาษาอังกฤษของเจ้าของภาษา ความปราณีตนั้นยิ่งทำให้ perplexity ต่ำลงไปอีก เราเขียนคำอธิบายที่ครอบคลุมกว่าใน why AI detectors flag non-native writers และคำอธิบายนี้ใช้ได้อย่างแรงเป็นพิเศษกับงานของชาวดัตช์
รูปแบบจากภาษาแรกของชาวดัตช์ที่อยู่เบื้องหลัง false flags
รูปแบบด้านล่างนี้ไม่ใช่ความผิดพลาด สิ่งเหล่านี้เป็นโครงสร้างที่ถูกต้อง รอบคอบ และเป็นมาตรฐาน และ “ความเป็นมาตรฐาน” นี่เองคือสิ่งที่เครื่องตรวจจับมองว่าเป็นข้อความที่มี perplexity ต่ำและเหมือนงานจากเครื่อง ตัวอย่างบางส่วนจะชี้ให้เห็นว่า “นิสัย” ของภาษาดัตช์หล่อหลอมร้อยแก้วภาษาอังกฤษอย่างไร
ภาษาดัตช์และภาษาอังกฤษมีคำศัพท์ร่วมกันจำนวนมาก ทำให้เกิด “false friends” ที่เชื่อถือได้ "Actueel" หมายถึง “ปัจจุบัน/ในขณะนี้” ไม่ใช่ "actual"; "eventueel" หมายถึง “เป็นไปได้/อาจจะ” ไม่ใช่ "eventually"; "controleren" หมายถึง “ตรวจสอบ” ไม่ใช่ "to control" นักวิจัยชาวดัตช์ที่เรียนรู้ที่จะหลีกเลี่ยงกับดักเหล่านี้มักเขียนด้วยความแม่นยำอย่างตั้งใจและรอบคอบ จนทำให้ความหลากหลายลดลง ผลลัพธ์คือความสม่ำเสมอและถูกต้อง และความสม่ำเสมอนี้เป็นสัญญาณหนึ่งของ perplexity
ลำดับคำก็เป็นอีก “ร่องรอย” ที่เงียบ ๆ ภาษาดัตช์วางกริยาแบบผันอันดับที่สองในอนุประโยค ดังนั้นประโยคที่ขึ้นต้นด้วย adverb อาจออกมาในภาษาอังกฤษในรูป "Therefore is the result significant" หรือ "In this study investigate we the effect." ผู้เขียนชาวดัตช์จำนวนมากแก้ไขสิ่งนี้ก่อนส่ง แต่การแก้ไขนั้นกลับสร้างโครงสร้างประโยคที่เป็นระเบียบและเป็นมาตรฐาน (canonical) ซึ่งเครื่องตรวจจับมักเชื่อมโยงกับข้อความที่ถูกสร้างขึ้น
แล้วก็ยังมีการใช้ article ภาษาดัตช์อนุญาตให้ใช้ definite article ก่อนคำนามทั่วไปและนามเชิงนามธรรม ดังนั้นฉบับร่างจึงมักมีโครงสร้างเช่น "the research shows," "the society," หรือ "the nature of the problem," ในขณะที่ภาษาอังกฤษมักจะละคำ article ออก สิ่งเหล่านี้ให้ความรู้สึกเป็นทางการและแม่นยำ และก็ยังอ่านออกมาได้เป็น “ความสม่ำเสมออย่างมาก” อีกด้วย
อีกสองนิสัยช่วยประกอบภาพรวม ภาษาดัตช์นิยมใช้วลีคำนามหนัก ๆ และการทำให้เป็นคำนาม (nominalization) โดยซ้อนโครงสร้าง เช่น "the realisation of the implementation of," และยังพึ่งตัวบ่งชี้เชิงวาทกรรม (discourse markers) เช่น "namely" (namelijk) และ "respectively" (respectievelijk) ซึ่งมักใช้ถ้อยคำที่ตรงไปตรงมาและกระชับแบบที่กรรมการบางครั้งอ่านว่า “สั้นคม” ทุกข้อข้างต้นล้วนถูกต้องตามไวยากรณ์ เมื่อรวมกันแล้วมันสร้างพื้นผิวของภาษาเรียบลื่นและคาดไม่ค่อยได้ (low-surprise) ซึ่งเป็นสิ่งที่เครื่องตรวจจับให้คะแนนสวนทางกับคุณ
ปกป้องงานเขียนของท่านอย่างซื่อสัตย์
ทำให้ฉบับร่างที่ช่วยด้วย AI เป็นธรรมชาติมากขึ้น โดยคงความหมาย คำศัพท์ และการอ้างอิงของท่านไว้ จากนั้นเปิดเผยการใช้ AI ตามที่วารสารของท่านกำหนด
ลองใช้ Humanizer ฟรีบริบทด้านการตรวจจับ AI และ Turnitin ในเนเธอร์แลนด์
วิทยานิพนธ์และบทความวารสารของชาวดัตช์มักถูกตรวจสอบความคล้ายคลึงอย่างสม่ำเสมอ โดยส่วนใหญ่ด้วย Turnitin หรือ iThenticate และสถาบันต่าง ๆ ก็ให้น้ำหนักกับตัวชี้วัดของ AI มากขึ้นควบคู่ไปกับการตรวจการคัดลอกผลงานแบบเดิม นี่จึงกลายเป็นส่วนปกติของกระบวนการส่ง ไม่ใช่ข้อยกเว้น
มหาวิทยาลัยในเนเธอร์แลนด์ (UNL) และสถาบันรายบุคคลได้ออกแนวทางเกี่ยวกับ generative-AI และทิศทางโดยรวมชัดเจน: อนุญาตให้ใช้เครื่องมือ AI สำหรับหลายงาน แต่การใช้งานควรเปิดเผย ไม่ใช่ปิดบัง ผู้ให้ทุนและวารสารกำลังขยับไปทิศทางเดียวกัน โดยขอให้ผู้เขียนระบุว่า AI ช่วยงานของตนอย่างไรและในส่วนใด
ควรนึกถึงด้วยว่า “คะแนน” ที่เครื่องตรวจจับให้มีน้ำหนักมากเพียงใด Turnitin จะลดทอนคะแนน AI ในช่วง 1 ถึง 19% และเตือนว่าตัวเลขนั้นไม่ควรถูกใช้เพียงลำพังเพื่อการตัดสินด้านความซื่อสัตย์ นอกจากนี้สถาบันใหญ่หลายแห่งยังถอยหลังไปอีกขั้น: Vanderbilt ปิดใช้งานตัวตรวจจับ AI ของ Turnitin ในปี 2023 โดยอ้างถึง false positives และอคติที่มีต่อผู้เขียนที่ไม่ใช่เจ้าของภาษา และ Michigan State, Northwestern, และ University of Pittsburgh ก็ได้ดำเนินการในลักษณะเทียบเคียงกัน การติดธงจากการตรวจจับจึงเป็น “ข้อกล่าวอ้าง” ที่คุณโต้แย้งได้ ไม่ใช่คำตัดสินที่ถูกประกาศมาแล้ว
มหาวิทยาลัยชั้นนำของชาวดัตช์และตำแหน่งที่มักปรากฏการตรวจ AI
ระบบการคัดกรองเกิดขึ้นทั่วทั้งระบบของเนเธอร์แลนด์ สถาบันต่อไปนี้ล้วนตรวจวิทยานิพนธ์และต้นฉบับเพื่อความคล้ายคลึง มักใช้ Turnitin หรือ iThenticate และในปัจจุบันยังเพิ่มการพิจารณาตัวชี้วัดของ AI อีกด้วย:
- Universiteit van Amsterdam (UvA), อัมสเตอร์ดัม
- Universiteit Utrecht, อูเทรคท์
- Universiteit Leiden, ไลเดน
- Technische Universiteit Delft (TU Delft), เดลฟต์
- Erasmus Universiteit Rotterdam (EUR), รอตเทอร์ดัม
- Rijksuniversiteit Groningen (RUG), กรอนิงเกน
- Wageningen University & Research (WUR), วาเกนิงเงน
- Radboud Universiteit, ไนเมเคิน
- Vrije Universiteit Amsterdam (VU), อัมสเตอร์ดัม
- Technische Universiteit Eindhoven (TU/e), ไอน์โฮเฟิน
- Universiteit Twente (UT), เอนเชเด
- Universiteit Maastricht (UM), มาสทริชท์
- Tilburg University, ทิลเบิร์ก
หากคุณกำลังปกป้องวิทยานิพนธ์ที่ไลเดนหรือส่งจากห้องปฏิบัติการของ WUR เอกสารของคุณก็จะผ่านการตรวจลักษณะนี้ การรู้ล่วงหน้าจะเปลี่ยนวิธีที่คุณเตรียมฉบับร่างสุดท้าย
AI humanizer สำหรับนักวิจัยชาวดัตช์ทำงานอย่างไร
เวิร์กโฟลว์ที่ซื่อสัตย์มีสามขั้นตอน และการเปิดเผยเป็นส่วนหนึ่งของกระบวนการนั้น ไม่ใช่เรื่องภายหลัง
ขั้นแรก: ร่าง (draft) เขียนเป็นภาษาอังกฤษ หรือเขียนเป็นภาษาดัตช์แล้วแปล โดยใช้ความช่วยเหลือจาก AI หากช่วยให้คุณคิดเร็วขึ้น ไม่มีอะไรผิดกับการมี “ฉบับร่างแรก” ที่ใช้ AI ช่วย ตราบใดที่ข้อโต้แย้ง การวิเคราะห์ และหลักฐานเป็นของคุณอย่างแท้จริง
ขั้นที่สอง: อ่านพิสูจน์และ humanize ให้เรียบ รันตรวจไวยากรณ์ให้สะอาด แล้วนำฉบับร่างผ่าน AI humanizer ระบบจะปรับความยาวของประโยค ทำลายจังหวะซ้ำที่เป็นสัญญาณของข้อความจากเครื่อง และตัด “นิสัยการจัดรูปแบบ” ที่หลุดรอดออกไป โดยยังคงความหมาย คำศัพท์เชิงเทคนิค และการอ้างอิงทุกรายการไว้ตรงตำแหน่งที่คุณวางไว้ ในการทดสอบของเรา ระบบช่วยลดโอกาสที่ภาษาอังกฤษเชิงวิชาการแบบไม่ใช่เจ้าของภาษาที่ยึดตามมาตรฐานอย่างรอบคอบจะถูกอ่านผิดโดยเครื่องตรวจจับรายใหญ่ เช่น Turnitin, Originality.ai และ GPTZero ได้อย่างมีนัยสำคัญ โดยยังคงความหมายเชิงวิชาการและไวยากรณ์ไว้ เรากำหนดสิ่งนี้ในฐานะ “สิ่งที่เราเห็นในการทดสอบ” ไม่ใช่คำสัญญา เครื่องตรวจจับมีการฝึกโมเดลใหม่ทุกไม่กี่เดือน และไม่มีเครื่องมือใดที่ซื่อสัตย์สามารถอ้างได้ว่า “ตรวจไม่พบ 100%” ผู้ใดรับประกันแบบนั้นคือกำลังขายบางอย่างให้คุณ
ขั้นที่สาม: เปิดเผย (disclose) ระบุการใช้ AI ตามรูปแบบที่อาจารย์ที่ปรึกษา สถาบัน และวารสารเป้าหมายของคุณต้องการ นี่คือทั้งประเด็น ไม่ใช่เพื่อซ่อนการใช้ AI หรือหลอกตัวตรวจความคล้ายคลึง แต่เพื่อไม่ให้การเขียนที่รอบคอบและถูกต้องถูกอ่านผิด และเพื่อให้คุณอยู่ภายใต้กฎด้านความซื่อสัตย์อย่างชัดเจนในกระบวนการนั้น
ส่วนนี้อยู่ใน multilingual AI humanizer hub ของเราที่ครอบคลุมเวิร์กโฟลว์เดียวกันสำหรับนักวิจัยที่เขียนจากหลากหลายภูมิหลังด้านภาษา หากความต้องการหลักของคุณคือการแก้ไขภาษาในระดับบรรทัด (line-level editing) มากกว่าความเป็นธรรมด้านการตรวจจับ เราแนะนำให้เริ่มจาก global academic editing hub
หน่วยให้ทุนท้องถิ่น วารสาร และความคาดหวังต่อการเปิดเผยการใช้ AI
ทุนวิจัยเชิงแข่งขันของเนเธอร์แลนด์ดำเนินการเป็นหลักผ่าน NWO (Nederlandse Organisatie voor Wetenschappelijk Onderzoek, สภาวิจัยแห่งชาติของเนเธอร์แลนด์) รวมถึงทุนในโครงการ Talent อย่าง Veni, Vidi และ Vici งานด้านสุขภาพและการแพทย์ได้รับทุนผ่าน ZonMw และ KNAW (Koninklijke Nederlandse Akademie van Wetenschappen, ราชสมาคมแห่งเนเธอร์แลนด์สำหรับวิทยาศาสตร์และศิลป์) อยู่ตรงกลางของชุมชนวิจัยระดับชาติ นอกจากนี้กลุ่มชาวดัตช์ยังได้รับสัดส่วนทุนจำนวนมากจาก European Research Council (ERC) และการเผยแพร่แบบ open-access ภายใต้ Plan S กำหนดให้ต้องใช้กับผลงานที่ได้รับทุนจาก NWO
ด้านการตีพิมพ์ นักวิจัยชาวดัตช์มุ่งเป้าวารสารที่อยู่ในฐานข้อมูล Web of Science และ Scopus ส่งผลลัพธ์ลงในคลังข้อมูลของสถาบัน และใช้โครงสร้างพื้นฐานระดับประเทศที่ประสานงานผ่าน SURF และมหาวิทยาลัย โดยภาพรวมแล้ว ในทุกหน่วยให้ทุนและวารสาร ความคาดหวังเรื่อง AI กำลังมาบรรจบกันบนหลักการเดียวกัน: เปิดเผยการใช้งานของคุณ ไม่ใช่ปกปิด การเก็บบันทึกสั้น ๆ อย่างซื่อสัตย์ว่าขั้นตอนไหน AI ช่วยในการร่าง ช่วยให้การเปิดเผยทำได้ง่ายเมื่อมีการขอข้อมูลในรายงานการให้ทุนหรือแบบฟอร์มการส่ง หากคุณถูกติดธงทั้งที่คุณเขียนบทความเอง คู่มือของเราที่ การอุทธรณ์ false AI detection flag อธิบายวิธีตอบโต้ไว้
คำถามที่พบบ่อย
Q: การใช้ AI humanizer กับบทความของฉันถือเป็นการโกงไหม?
ไม่ หากคุณใช้ตามที่เราระบุ การทำให้เป็นแบบ humanize คือการปรับฉบับร่างที่ AI ช่วยของตัวคุณเอง โดยคงข้อโต้แย้ง ข้อมูล และการอ้างอิงไว้ จากนั้นเปิดเผยการใช้ AI ต่อสถาบันและวารสารของคุณ นี่คือสิ่งที่ตรงกันข้ามกับการซ่อนบางอย่าง ปัญหาที่มันแก้คือปัญหาเชิงเทคนิค การเขียนที่รอบคอบถูกอ่านผิดว่าเป็นข้อความจากเครื่อง ไม่ใช่ปัญหาเชิงจริยธรรมหรือความซื่อสัตย์
Q: ภาษาอังกฤษของฉันยอดเยี่ยมจริง ๆ ทำไมเครื่องตรวจจับถึงยังติดธงงานของฉัน?
เพราะเครื่องตรวจจับไม่ได้วัดว่างานเขียน “ดี” หรือไม่ แต่วัดว่า “คาดเดาได้มากเพียงใด” ภาษาอังกฤษที่เข้มแข็ง เป็นมาตรฐาน และไม่ใช่ภาษาแม่ มักมีความสม่ำเสมอสูง และความสม่ำเสมอนี้เองสร้าง perplexity ต่ำซึ่งเครื่องตรวจจับเชื่อมโยงกับข้อความที่เป็น AI text งานวิจัยของ Stanford พบว่าเรียงความที่เขียนโดยผู้ที่ไม่ใช่เจ้าของภาษา ถูกติดธงมากกว่าเรียงความที่เขียนโดยเจ้าของภาษา ซึ่งเป็นรูปแบบที่นักวิจัยชาวดัตช์ที่ใช้ภาษาได้คล่องจำนวนมากกำลังเผชิญ
Q: humanizer สามารถรับประกันได้ไหมว่าฉันจะผ่าน Turnitin หรือ GPTZero?
ไม่ได้ และคุณควรระวังเครื่องมือใดก็ตามที่บอกว่าสามารถรับประกันได้ เครื่องตรวจจับจะเปลี่ยนโมเดลทุกไม่กี่เดือน ดังนั้นไม่มีผลิตภัณฑ์ที่ซื่อสัตย์ตัวใดสัญญาผลลัพธ์เฉพาะเจาะจงหรืออ้างได้ว่า “ตรวจไม่พบ 100%” สิ่งที่เราพอพูดได้คือ ในการทดสอบของเรา humanizer ช่วยลดความถี่ที่ข้อความภาษาอังกฤษของผู้ที่ไม่ใช่เจ้าของภาษาถูกติดธงผิดได้อย่างมีนัยสำคัญ ขณะเดียวกันยังคงความหมายและการอ้างอิงของคุณไว้โดยไม่เปลี่ยนแปลง
Q: การทำให้เป็นแบบ humanized จะเปลี่ยนการอ้างอิง คำศัพท์ หรือข้อมูลของฉันไหม?
ไม่ ระบบถูกสร้างมาเพื่อคงคำเชิงเทคนิค ตัวบ่งชี้การอ้างอิง และแก่นสารของข้อโต้แย้งคุณ ระบบปรับจังหวะและการเลือกคำเพื่อให้ฟังเป็นธรรมชาติมากขึ้น ไม่ใช่เพื่อเปลี่ยนข้อเท็จจริง ตัวเลข หรือแหล่งที่มาที่คุณอ้างถึง คุณควรอ่านผลลัพธ์ก่อนส่ง เช่นเดียวกับการแก้ไขใด ๆ
Q: ฉันเขียนเป็นภาษาดัตช์ก่อนแล้วค่อยแปล ยังใช้ได้ไหม?
ได้ คุณสามารถร่างเป็นภาษาดัตช์ แปล แล้วค่อยทำให้ฉบับภาษาอังกฤษเป็นแบบ humanize เครื่องมือนี้ส่งข้อความที่ไม่ใช่ภาษาอังกฤษและข้อความที่ผ่านการแปลผ่านโมเดลที่รับรู้ภาษา ซึ่งช่วยคงโครงสร้างประโยคและความหมายให้คงเสถียร ดังนั้นเวิร์กโฟลว์จึงเข้ากับวิธีที่นักวิจัยชาวดัตช์จำนวนมากใช้งานจริง
ลดการเตือนว่าเป็น AI แบบไม่ถูกต้องในงานเขียนภาษาอังกฤษที่ไม่ใช่ภาษาแม่อย่างรอบคอบ โดยคงความหมาย คำศัพท์ และการอ้างอิงของท่านไว้ ทดลองใช้งานได้ฟรี สร้างมาเพื่อผู้วิจัย

Moe เป็นวิศวกร NLP ที่มี PhD ในการประมวลผลภาษาธรรมชาติ งานวิจัยของเขาครอบคลุมภาษาศาสตร์เชิงคำนวณ การวิเคราะห์ข้อความ และการเรียนรู้ของเครื่อง และป้อนโดยตรงไปยังโมเดลการแก้ไขและการทำให้มีมนุษยธรรมที่อยู่เบื้องหลัง ProofreaderPro เขาเขียนเกี่ยวกับส่วนหนึ่งของกระบวนการที่คนส่วนใหญ่ไม่เคยเห็นมาก่อน เช่น วิธีที่โมเดลภาษาอ่านประโยค ให้คะแนน และตัดสินใจว่าจะเปลี่ยนแปลงอะไร


