
AI Humanizer สำหรับนักวิจัยอิตาลีที่เขียนเป็นภาษาอังกฤษ
AI humanizer สำหรับนักวิจัยชาวอิตาลี ช่วยลดการถูกตั้งค่าสัญญาณเตือนการตรวจจับ AI แบบผิดพลาดสำหรับภาษาอังกฤษที่ได้รับอิทธิพลจากภาษาอิตาลี รักษาความหมายและการอ้างอิงไว้ และเปิดเผยการใช้งานอย่างตรงไปตรงมาตามที่สถาบันและวารสารกำหนด

อิตาลีติดอยู่ในกลุ่มประเทศที่มีผลงานวิจัยมากที่สุดของโลก (ราวกับแปดถึงสิบประเทศ) แต่แทบไม่มีงานเหล่านั้นถูกส่งต่อไปถึงผู้อ่านของตนเองเป็นภาษาอิตาลีเลย นักวิชาการที่นี่ร่างและคิดด้วยภาษาหนึ่ง แล้วจึงตีพิมพ์อีกภาษาหนึ่ง เพราะเส้นทางอาชีพนักวิจัยของอิตาลีเชื่อมโยงกับวารสารภาษาอังกฤษที่ถูกจัดทำดัชนีไว้ในระบบ นักประเมินคุณภาพงานวิจัยอย่าง VQR และคุณสมบัติระดับชาติสำหรับตำแหน่งศาสตราจารย์ของ ASN ต่างอาศัยเกณฑ์เชิงบรรณมิติจาก Scopus และ Web of Science ดังนั้นบทความภาษาอังกฤษในวารสารที่เหมาะสมจึงไม่ใช่ทางเลือก
แรงกดดันนี้กำลังปะทะกับปัญหาใหม่ที่เกิดขึ้นควบคู่กันอยู่ในขณะนี้ นั่นคือ AI humanizer สำหรับนักวิจัยชาวอิตาลีมีอยู่จริง เพราะ “งานเขียนภาษาอังกฤษที่เป็นภาษาที่สองอย่างรอบคอบและถูกต้อง” คือประเภทของร้อยแก้วที่เครื่องมือของ AI ตรวจจับผิดว่าเป็นงานที่สร้างด้วยเครื่องจักร เพื่อนร่วมงานของคุณทำงานทุกขั้นตอน เขียนทุกคำด้วยตนเอง แต่ก็ยังถูกตั้งค่าสัญญาณเตือนอยู่ดี
คำแนะนำในที่นี้ว่าด้วยความเป็นธรรม ไม่ใช่การปลอมตัว เป้าหมายคือทำให้ร่างต้นฉบับที่ช่วยด้วย AI ของคุณ “มีความเป็นมนุษย์” ขึ้น รักษาความหมายและการอ้างอิงให้ครบถ้วน จากนั้นจึงเปิดเผยการใช้ AI อย่างซื่อสัตย์ตามที่สถาบันและวารสารของคุณกำหนด
ตัวทำให้ข้อความเป็นภาษามนุษย์ด้วย AI (AI text humanizer) สำหรับนักวิจัยชาวอิตาลีที่ตีพิมพ์เป็นภาษาอังกฤษ
AI text humanizer ของเรา ช่วยนักวิจัยชาวอิตาลีตีพิมพ์เป็นภาษาอังกฤษ โดยที่งานเขียนที่ถูกต้องไม่ถูกเข้าใจผิดว่าเป็นข้อความที่สร้างโดยเครื่องจักร AI รักษาความหมาย คำศัพท์เชิงเทคนิค และการอ้างอิงไว้ และปรับความหลากหลายของจังหวะการเขียน ตลอดจนตัวเลือกเชิงคำศัพท์
พูดให้เข้าใจง่าย: คุณเป็นผู้เขียนงานวิชาการเอง เครื่องมือนี้ช่วย “เกลี่ย” ลายนิ้วมือเชิงสถิติที่ทำให้ร้อยแก้วของผู้ที่ใช้ภาษาไม่ใช่ภาษาแม่อ่านออกมาเหมือนงานที่สังเคราะห์ขึ้น ไม่มีสิ่งใดเปลี่ยนแปลงในข้อโต้แย้ง ข้อมูล หรือแหล่งอ้างอิงของคุณ สิ่งที่เปลี่ยนคือจังหวะที่สม่ำเสมอและคาดเดาได้ ซึ่งเครื่องมือบางอย่างกลับตีความว่าเป็น “ลายเซ็นของงานที่เป็นเครื่อง”
ร่างเป็นภาษาอิตาลีแล้วหรือ? humanizer ตรวจจับและปรับเขียนใหม่ได้โดยตรง
คุณสามารถทำให้ร่างภาษาอิตาลี “เป็นภาษามนุษย์” ได้โดยไม่ต้องแปลเป็นภาษาอังกฤษก่อน เพียงวางข้อความของคุณ แล้ว ProofreaderPro จะตรวจจับภาษาโดยอัตโนมัติ จากนั้นส่งผ่านโมเดลที่เข้าใจภาษาอิตาลี เพื่อคงเครื่องหมายกำกับเสียง คำศัพท์เฉพาะ และการอ้างอิงไว้ที่เดิม ในฐานะ umanizzatore di testo IA มันจะปรับจังหวะของร้อยแก้วภาษาอิตาลีของคุณ ขณะเดียวกันก็ยังคงการค้นพบและการอ้างอิงทุกรายการไว้ครบถ้วน การตรวจจับอัตโนมัติรองรับมากกว่า 60 ภาษา ดังนั้นภาษาอิตาลีจึงถูกปฏิบัติเป็นภาษาอิตาลีจริง ๆ แทนที่จะถูก “ปรับรูป” ให้กลายเป็นภาษาอังกฤษ
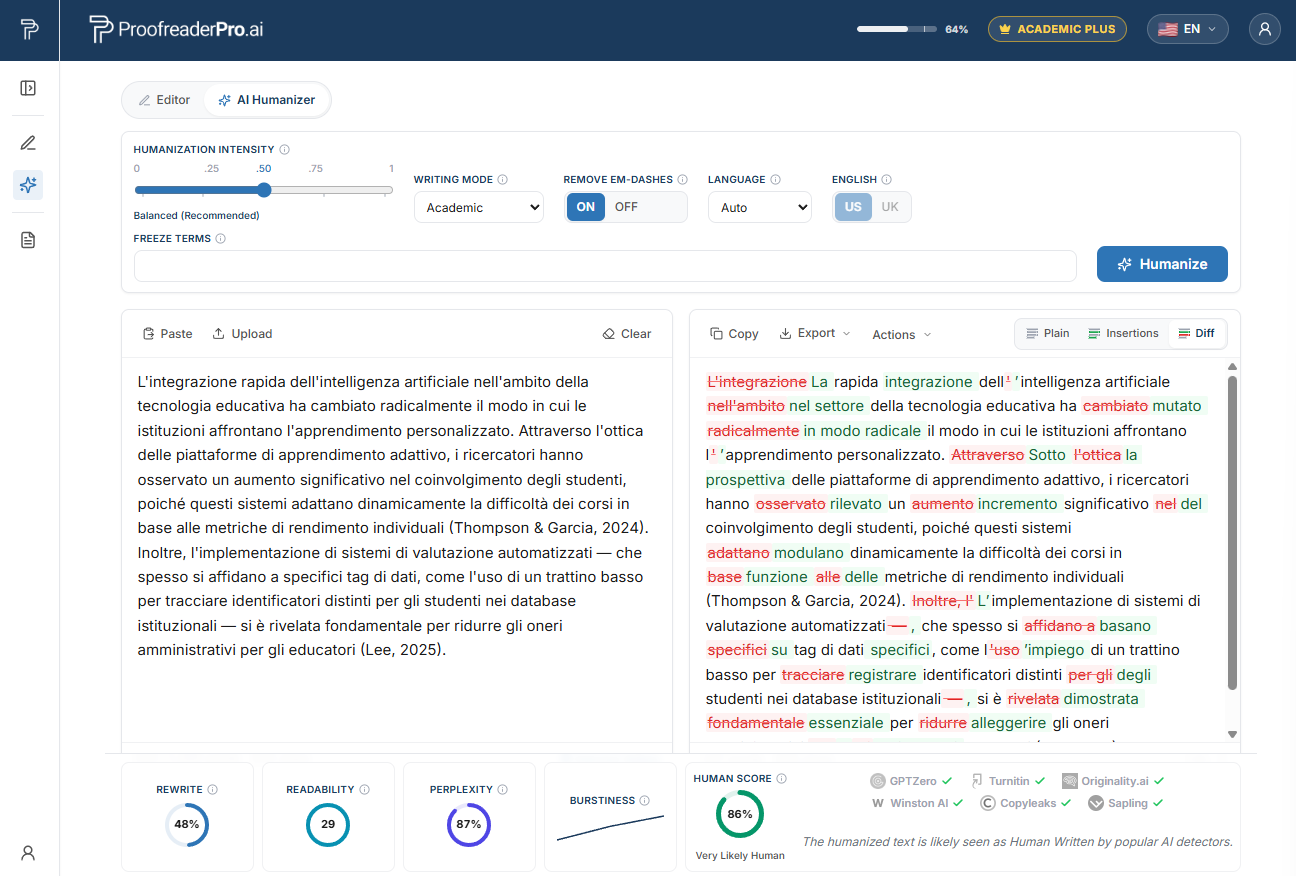
The ProofreaderPro AI Humanizer rewriting Italian academic text. ความแตกต่างก่อนและหลัง (diff) ช่วยคงความหมายและการอ้างอิง และการตรวจสอบของตัวตรวจจับยืนยันว่าการอ่านนั้นเป็นธรรมชาติแบบมนุษย์
เหตุใดนักวิจัยชาวอิตาลีจึงถูกตั้งค่าสัญญาณเตือนโดยเครื่องมือ AI detection
ในปี 2023 ทีมงานจากมหาวิทยาลัยสแตนฟอร์ด นำโดย Liang และคณะ ได้ตีพิมพ์งานวิจัยในวารสาร Cell Press เรื่อง Patterns ด้วยชื่อเรื่องที่ตรงไปตรงมาว่า: GPT detectors are biased against non-native English writers พวกเขานำบทความเรียง TOEFL ที่เขียนโดยมนุษย์จำนวนหนึ่ง ไปผ่านเครื่องมือตรวจจับที่เป็นที่นิยมใช้งานอยู่แล้ว 7 ตัว
ผลลัพธ์นี้ควรทำให้ผู้ที่จะตีพิมพ์ในภาษาที่สองต้องกังวล โดยเฉลี่ยแล้ว บทความที่เขียนโดยผู้ใช้ที่ไม่ใช่เจ้าของภาษา ประมาณ 61% ถูกตั้งค่าว่าเป็น AI ขณะที่บทความของผู้เขียนเจ้าของภาษาอยู่ที่ราว 5% เกือบหนึ่งในห้า หรือประมาณ 19.8% ถูกตั้งค่าพร้อมกันแบบเป็นเอกฉันท์โดยเครื่องมือทุกตัวที่ใช้ และทุกบทความเหล่านั้นเขียนโดยมนุษย์
กลไกนี้เรียกว่า perplexity เครื่องมือตรวจจับจะวัดว่าการเลือกใช้คำแต่ละคำ “น่าประหลาดใจ” ต่อโมเดลภาษามากเพียงใด นักเขียนที่ใช้ภาษาที่สองอย่างรอบคอบจะเลือกคำที่พบได้ทั่วไปและใช้สำนวนที่คาดเดาได้มาตรฐาน ซึ่งทำให้ perplexity อยู่ในระดับต่ำ จึงอ่านออกมาคล้ายข้อความที่มาจากเครื่องจักร “นิสัย” ที่ทำให้งานเขียนภาษาอังกฤษของคุณอ่านชัดเจน คือชุดนิสัยเดียวกับที่เครื่องมือเหล่านี้ถูกฝึกมาให้ลงโทษ เราแยกย่อยประเด็นนี้เพิ่มเติมใน why AI detectors flag non-native writing
รูปแบบภาษาแบบภาษาแรกของอิตาลีที่อยู่เบื้องหลัง false flags
ไม่มีรูปแบบใดด้านล่างนี้ที่เป็นข้อผิดพลาด สิ่งเหล่านี้คือโครงสร้างที่ผู้รู้ชาวอิตาลีเลือกใช้ด้วยความรอบคอบตามแบบตำรา และความสม่ำเสมอนี้เองที่ทำให้ตัวตรวจจับอ่านว่า perplexity ต่ำ
ประโยคแบบ hypotaxis ยาวมาก แนวทางการเขียนเชิงวิชาการของอิตาลีมักนิยมประโยคยาวที่มีอนุประโยคย่อยซ้อนกันหลายชั้น เมื่อแปลเป็นอังกฤษแล้ว โครงสร้างยังคงถูกต้องตามไวยากรณ์ แต่ความแน่นของข้อมูลจะเพิ่มขึ้น และจังหวะที่ดู “ผ่านการปรับอย่างเป็นทางการเกินความจำเป็น” จนคาดเดาได้ ทำให้โมเดลมองว่าเหมือนงานที่ผลิตได้ตามรูปแบบ
การใช้ articles ร่วมกับคำนามเชิงนามธรรม การเขียนเรื่อง nature, the science, หรือ the society ซึ่งในภาษาอังกฤษมักจะละ article ออก เป็นการถ่ายโอนตรงและสม่ำเสมอจากภาษาอิตาลี ความสม่ำเสมอนี้เองคือสัญญาณที่เครื่องมือตรวจจับให้ค่าน้ำหนักสูงด้วยคะแนนต่ำ
การโอนการใช้บุพบท (preposition transfer) depend from for dipendere da หรือ on the basis of in place of based on คือการเลือกที่มีกฎรองรับอย่างเป็นระบบ ตัวเลือกที่เป็นระบบย่อมให้ perplexity ต่ำตามความหมายโดยตรง
การทำให้เป็นคำนาม (nominalization) และสำนวนแบบละติน (Latinate diction) วลีคำนามที่ “หนาแน่น” เช่น the realization of the analysis และการเลือกใช้คำศัพท์เชิงละตินอย่างสม่ำเสมอ เป็นภาษาระดับทางการที่พบทั่วไป และสิ่งที่เป็นทางการและเป็นมาตรฐานคือสิ่งที่เครื่องมือเหล่านี้ทำการตั้งค่าสัญญาณไว้
คำเชื่อมที่แปลตามแบบ (calqued connectors) นอกเหนือจากคำเชื่อมในตอนต้นประโยคอย่าง Moreover, Furthermore และ In fact ซึ่งมักยึดตามเครื่องหมายการพูดในวาทกรรมของภาษาอิตาลี มันจึงสร้างจังหวะที่สม่ำเสมอและเกิดซ้ำ ซึ่งอ่านแล้วลื่นไหลแบบ “เครื่อง”
คำที่ทำให้สับสน (false friends) เช่น Attualmente ที่ถูกปรับไปเป็น actually แทน currently หรือ eventualmente ที่ถูกปรับไปเป็น eventually แทน possibly ซึ่งเป็นการแก้ของผู้เขียนที่รอบคอบเพื่อให้ได้คำที่ดูเป็นมาตรฐานที่สุด คำที่เป็นมาตรฐานที่สุด มักเป็นคำที่ “คาดเดาได้และไม่เซอร์ไพรส์” ที่สุดเช่นกัน
บริบทการตรวจจับ AI ของอิตาลีและ Turnitin
วิทยานิพนธ์และต้นฉบับงานเขียนของอิตาลีมักถูกตรวจคัดกรองความคล้ายคลึงของข้อความเป็นประจำ โดยส่วนใหญ่ใช้ Turnitin หรือ iThenticate และเครื่องมือเหล่านี้ยิ่งมีแนวโน้มที่จะดึงสัญญาณที่เกี่ยวกับ AI ขึ้นมาควบคู่กับคะแนนความคล้ายคลึงที่คุ้นเคยอยู่แล้ว รายงานความคล้ายคลึงเป็นแนวปฏิบัติปกติในระดับโรงเรียนบัณฑิตศึกษาและกระบวนการทำงานของกองบรรณาธิการ และเพียงแค่นั้นก็ไม่ได้บอกอะไรเกี่ยวกับ “ความซื่อสัตย์” ของคุณ
มีอยู่ 2 ประเด็นที่ควรเก็บไว้ในมุมมองให้ดี ประการแรก ตัวชี้วัด AI คือ “ข้อกล่าวอ้าง” ไม่ใช่คำวินิจฉัย Turnitin เองก็ระงับคะแนนในช่วง 1 ถึง 19% และเตือนว่าตัวเลขนั้นไม่ควรเป็นตัวตัดสินเพียงอย่างเดียวสำหรับกรณีด้านความซื่อสัตย์ นอกจากนี้ มหาวิทยาลัยหลายแห่ง รวมถึง Vanderbilt, Michigan State และ UT Austin ได้ปิดการใช้งานเครื่องตรวจจับ AI โดยอ้างเหตุผลเรื่อง false positives และความลำเอียงต่อผู้เขียนที่ไม่ได้ใช้ภาษาอังกฤษเป็นภาษาแม่
ประการที่สอง ทิศทางของการดำเนินการในอิตาลี เช่นเดียวกับที่อื่น ๆ คือการ “เปิดเผย” มากขึ้น ผู้ให้ทุนและวารสารมักขอให้คุณระบุว่าคุณใช้ AI ที่ไหนและใช้อย่างไร ความคาดหวังนี้คือการคุ้มครองของคุณ: การเปิดเผยอย่างครบถ้วน ไม่ใช่คะแนนของตัวตรวจจับที่ “ไร้คราบสัญญาณ” คือสิ่งที่ทำให้คุณอยู่ภายใต้กติกา
ปกป้องงานเขียนของคุณจากข้อกล่าวหาเท็จ
ทำให้ร่างที่คุณเขียนด้วยความช่วยเหลือของ AI เป็นธรรมชาติภายในไม่กี่นาที คงคำอ้างอิงทั้งหมดไว้ จากนั้นเปิดเผยการใช้ให้ครบถ้วน สร้างมาสำหรับภาษาอังกฤษเชิงวิชาการแบบไม่ใช่เจ้าของภาษาที่รอบคอบ
ลองใช้ Humanizer ฟรีมหาวิทยาลัยชั้นนำของอิตาลี และจุดที่มักปรากฏการตรวจ AI
การคัดกรองที่กล่าวถึงข้างต้นเกิดขึ้นทั่วสถาบันชั้นนำในอิตาลี โรงเรียนบัณฑิตศึกษาและสำนักงานกองบรรณาธิการของมหาวิทยาลัยเหล่านี้นำวิทยานิพนธ์และต้นฉบับไปตรวจความคล้ายคลึง และในปัจจุบันยังมีแนวโน้มที่จะประเมินตัวชี้วัด AI เพิ่มขึ้นด้วย:
- Sapienza Università di Roma, in Rome
- Università di Bologna (Alma Mater Studiorum), in Bologna
- Politecnico di Milano and Università degli Studi di Milano (Statale), in Milan
- Università degli Studi di Padova, in Padua
- Università degli Studi di Napoli Federico II, in Naples
- Politecnico di Torino and Università degli Studi di Torino, in Turin
- Università di Pisa, Scuola Normale Superiore, and Scuola Superiore Sant'Anna, in Pisa
- Università degli Studi di Firenze, in Florence
- Università degli Studi di Trento, in Trento
- Università Cattolica del Sacro Cuore, in Milan
ไม่ว่าคุณจะอยู่ที่สถาบันใด ธง (flag) ที่ขึ้นเตือนคือจุดเริ่มต้นของการสนทนาเกี่ยวกับวิธีการของคุณ ไม่ใช่ข้อสรุปเกี่ยวกับความซื่อสัตย์ของคุณ การรู้ว่าการตรวจสอบเหล่านี้เป็นกิจวัตรอยู่แล้ว คือเหตุผลที่จะเตรียมตัว ไม่ใช่ต้องตื่นตระหนก
วิธีการทำงานของ AI humanizer สำหรับนักวิจัยชาวอิตาลี
นี่คือเวิร์กโฟลว์ และลำดับมีความสำคัญ
ขั้นแรก ร่างข้อโต้แย้งของคุณ เขียนเป็นภาษาอิตาลีหากนั่นคือภาษาที่ทำให้การคิดของคุณคมที่สุด จากนั้นจึงแปล หรือร่างโดยตรงเป็นภาษาอังกฤษ ไม่ว่าจะเลือกแบบใด ความคิดและข้อมูลล้วนเป็นของคุณ
ขั้นที่สอง แก้ไวยากรณ์ แก้คำที่เป็น false friends แก้การใช้บุพบท และแก้ความคลาดเคลื่อนของการใช้ article เพื่อให้ภาษาสะอาดและเรียบร้อยก่อนที่สิ่งอื่นจะไปรบกวน เรามีเครื่องมือพิสูจน์อักษรที่ออกแบบมาเพื่อจุดประสงค์นี้โดยเฉพาะ และคุณสามารถดูเวิร์กโฟลว์ที่ใกล้เคียงกันได้ใน AI proofreading for Italian academics
ขั้นที่สาม ทำให้ร้อยแก้วของคุณมีความเป็นมนุษย์ นำร่างที่ช่วยด้วย AI ของคุณไปผ่าน AI text humanizer มันจะปรับจังหวะและการเลือกใช้คำ และลดจังหวะที่ซ้ำ ๆ และ perplexity ต่ำที่มักทำให้ตัวตรวจจับหลงผิด ขณะเดียวกันก็ยังคงความหมาย คำศัพท์เชิงเทคนิค และการอ้างอิงของคุณไว้ครบถ้วน
ตัว humanizer ผ่านการทดสอบกับตัวตรวจจับรายใหญ่ และปรับ “ข้อความที่เป็น AI” ให้กลับมาเป็นรูปแบบที่เป็นมนุษย์มากขึ้น ซึ่งอ่านแล้วเหมือนมนุษย์บน Turnitin, Originality.ai และ GPTZero โดยยังคงความถูกต้องด้านไวยากรณ์ไว้สูงสำหรับงานเขียนเชิงวิชาการ ผลลัพธ์เหล่านี้มาจากการทดสอบ ไม่ใช่คำมั่นสัญญา เราไม่ได้สัญญาว่าจะหลีกเลี่ยงการตรวจจับใด ๆ เพราะตัวตรวจจับจะได้รับการฝึกใหม่ทุก ๆ ไม่กี่เดือน
ขั้นที่สี่ เปิดเผย ระบุการใช้ AI ของคุณในรูปแบบที่สถาบันและวารสารเป้าหมายกำหนด ขั้นตอนสุดท้ายนี่แหละที่แยก “การคุ้มครองที่เป็นธรรมของงานจริง” ออกจากการปลอมตัว
โพสต์นี้เป็นจุดเริ่มต้นหนึ่งใน multilingual AI humanizer hub ของเรา ซึ่งครอบคลุมเวิร์กโฟลว์เดียวกันสำหรับนักวิจัยที่เขียนจากภาษาแรกอื่น ๆ หากความต้องการหลักของคุณคือการแก้ไขภาษาแบบรอบด้านมากกว่าการเน้นความเป็นธรรมต่อเครื่องตรวจจับ ให้เริ่มที่ global academic editing hub
หน่วยงานให้ทุนในพื้นที่ วารสาร และความคาดหวังเรื่องการเปิดเผยการใช้ AI
ทุนวิจัยและการประเมินผลของอิตาลีดำเนินการผ่านหน่วยงานไม่กี่แห่ง และแต่ละแห่งจะเพิ่ม “เดิมพัน” ว่างานของคุณจะถูกตีพิมพ์ที่ใด
MUR (Ministero dell'Università e della Ricerca) ให้ทุนแก่มหาวิทยาลัยและทุนระดับชาติ PRIN (Progetti di Ricerca di Rilevante Interesse Nazionale) คือโครงการแข่งขันระดับชาติหลัก CNR (Consiglio Nazionale delle Ricerche) คือหน่วยงานวิจารธารณะด้านการวิจัยที่ใหญ่ที่สุดของประเทศ ANVUR ดำเนินทั้งการประเมิน VQR และคุณสมบัติของ ASN และยังดูแลรายชื่อวารสารระดับคลาส-A ที่มีน้ำหนักจริงในสาขามนุษยศาสตร์และสังคมศาสตร์
เมื่อพูดถึงการจัดตำแหน่งงานและการตีพิมพ์ (placement) นั่นหมายถึงการจัดทำดัชนีใน Scopus และ Web of Science และสถานะคลาส-A ของ ANVUR ในสาขาที่ไม่ใช่สายบรรณมิติ ต้นฉบับที่มุ่งเข้าสู่วารสารเหล่านี้จะถูกตรวจด้วย Turnitin หรือ iThenticate และจำนวนวารสารและผู้ให้ทุนที่เพิ่มขึ้นเรื่อย ๆ กำหนดให้มี “คำชี้แจงการใช้ AI” อย่างชัดเจน เตรียมคำชี้แจงนั้นตั้งแต่เนิ่น ๆ และหากวันหนึ่งตัวตรวจจับตั้งค่าสัญญาณให้กับงานที่ “สะอาด” ของคุณ ให้ปฏิบัติตามรายงานนั้นเป็นหลักฐานที่โต้แย้งได้ ไม่ใช่คำตัดสิน A final pass ผ่าน AI text humanizer ก่อนส่งต้นฉบับ จะช่วยให้ร้อยแก้วของผู้ใช้ที่ไม่ใช่เจ้าของภาษาได้รับการอ่านอย่างเป็นธรรมขึ้น และการเปิดเผยของคุณจะทำให้กระบวนการทั้งหมดโปร่งใส
คำถามที่พบบ่อย
Q: การใช้ AI humanizer สำหรับนักวิจัยชาวอิตาลี ถือเป็นการโกงหรือไม่?
ไม่ ไม่ใช่ในกรณีที่คุณใช้กับงานของตัวเอง งานวิจัยนั้นคุณเป็นผู้ทำ คุณเพียงแค่ให้เครื่องมือปรับจังหวะและตัวเลือกคำของร้อยแก้วภาษาอังกฤษที่ผู้ใช้ไม่ได้ใช้เป็นภาษาแม่อย่างรอบคอบ เพื่อให้มีโอกาสถูกตีความผิดว่าเป็นข้อความจากเครื่องจักรน้อยลง กฎที่ทำให้ทุกอย่างโปร่งใสคือการเปิดเผย: คุณยังต้องบอกสถาบันและวารสารว่าคุณใช้ AI อย่างไร
Q: humanizer จะเปลี่ยนการอ้างอิงหรือคำศัพท์เชิงเทคนิคของฉันไหม?
ไม่ มันคงการอ้างอิงของคุณ ข้อมูลของคุณ และคำศัพท์เฉพาะตามสาขาของคุณไว้ เป้าหมายคือจังหวะที่ perplexity ต่ำซึ่งตัวตรวจจับตอบสนอง ไม่ใช่เนื้อหาสาระของข้อโต้แย้ง
Q: คุณรับประกันได้ไหมว่าบทความของฉันจะผ่าน Turnitin หรือ GPTZero?
ไม่ได้ และควรระวังเครื่องมือใด ๆ ที่ให้คำสัญญาลักษณะนั้น จากการทดสอบของเรา humanizer จะปรับข้อความที่เป็น AI ให้กลายเป็นรูปแบบที่เป็นมนุษย์มากขึ้น ซึ่งช่วยลดสัญญาณ AI และเพิ่มโอกาสในการแข่งขันกับตัวตรวจจับที่เข้มงวด แต่ตัวตรวจจับจะมีการฝึกใหม่อย่างต่อเนื่อง ดังนั้นเราจึงรายงานผลที่ “ทดสอบแล้ว” แทนการรับประกัน
Q: ทำไมภาษาอังกฤษที่ถูกต้องของฉันถึงถูกตั้งค่าสัญญาณเตือนไปด้วย?
เพราะตัวตรวจจับให้คะแนนว่า “การเลือกใช้คำ” ของคุณคาดเดาได้แค่ไหน คอนสตรักชันมาตรฐานแบบภาษาอิตาลีสู่ภาษาอังกฤษจากตำรา ตั้งแต่การใช้ article ไปจนถึงสำนวนแบบละติน ล้วนคาดเดาได้สูง ซึ่งอ่านแล้วเท่ากับ perplexity ต่ำ และเครื่องมือบางตัวมองว่านี่คือสัญญาณของ AI นี่คือความลำเอียงที่มีเอกสารรองรับต่อการเขียนของผู้ที่ใช้ภาษาอังกฤษเป็นภาษาที่สองอย่างรอบคอบ ไม่ใช่การตัดสินว่างานของคุณดีหรือไม่ดี
Q: ถ้าคณะกรรมการหรือวารสารตั้งค่าสัญญาณให้กับการเขียนของฉัน ฉันควรทำอย่างไร?
ให้ใจเย็นและปฏิบัติตามสัญญาณเตือนนั้นในฐานะ “ข้อกล่าวอ้างที่ต้องตอบ” ไม่ใช่คำตัดสิน เก็บร่างต้นฉบับและโน้ตของคุณไว้ ชี้ไปที่ความลำเอียงที่มีเอกสารรองรับต่อผู้เขียนที่ไม่ใช่เจ้าของภาษา และเปิดเผยการใช้ AI ของคุณ คะแนนจากตัวตรวจจับเป็นหลักฐานที่โต้แย้งได้ ไม่ใช่การยืนยัน
ให้การอ่านที่ยุติธรรมยิ่งขึ้นแก่งานเขียนภาษาอังกฤษของคุณที่ไม่ใช่เจ้าของภาษา คงความหมายและคำอ้างอิงไว้ ลดสัญญาณเตือนว่าเป็น AI แบบผิดพลาด แล้วจึงเปิดเผยการใช้ด้วยความมั่นใจ

Moe เป็นวิศวกร NLP ที่มี PhD ในการประมวลผลภาษาธรรมชาติ งานวิจัยของเขาครอบคลุมภาษาศาสตร์เชิงคำนวณ การวิเคราะห์ข้อความ และการเรียนรู้ของเครื่อง และป้อนโดยตรงไปยังโมเดลการแก้ไขและการทำให้มีมนุษยธรรมที่อยู่เบื้องหลัง ProofreaderPro เขาเขียนเกี่ยวกับส่วนหนึ่งของกระบวนการที่คนส่วนใหญ่ไม่เคยเห็นมาก่อน เช่น วิธีที่โมเดลภาษาอ่านประโยค ให้คะแนน และตัดสินใจว่าจะเปลี่ยนแปลงอะไร


