
영어로 글을 쓰는 루마니아 연구자를 위한 AI 휴머나이저
루마니아 연구자를 위한 AI 휴머나이저입니다. 루마니아의 영향이 반영된 영어에서 발생하는 오탐 AI 탐지 플래그를 줄이되, 의미와 인용은 그대로 유지하고 정직하게 공개하세요.

루마니아는 진지한 과학을 발표합니다. 수학자, 컴퓨터과학자, 물리학자, 화학자들은 매년 Web of Science와 Scopus 저널에 논문을 싣고, CNATDCU가 정한 국내 학술 진흥 기준은 그 압력을 일정하게 유지합니다. 색인된 출판물이 없으면 진전이 없기 때문입니다. 이 연구의 거의 대부분은 루마니아어로 초안이 작성되고, 영어로 정리되어 출판됩니다.
다음은 루마니아 연구자를 위한 AI 휴머나이저가 해결하도록 설계된 문제입니다. 제2언어로서 신중하고 표준적인 학술 영어를 작성하면, AI 탐지기가 이를 기계가 생성한 글로 오독할 수 있습니다. 문법은 깔끔합니다. 표현은 예측 가능합니다. 그리고 예측 가능성은 바로 이러한 도구들이 ‘표적’으로 삼아 탐지하도록 훈련된 특성입니다.
이것은 흔한 단순 오류가 아닙니다. 구조적 편향이며, 가장 오랫동안 분명하고 정확한 영어를 쓰기 위해 노력한 바로 그 연구자들에게 가장 가혹하게 작동합니다.
루마니아어 텍스트를 사람답게 만드는 방식이 루마니아 연구자에게 어떻게 도움이 되는가
AI 텍스트 휴머나이제이션은 루마니아 연구자들이 자신들의 정교하고 정확한 글이 기계가 생성한 텍스트로 오해받지 않으면서 영어로 출판할 수 있도록 돕습니다. Meaning, terminology, citations은 사용자가 배치한 그대로 유지됩니다.
핵심 아이디어는 단순하고 정직합니다. 계속해서 엄밀한 영어로 쓰되, 휴머나이저는 문장의 리듬과 단어 선택을 다양화하여, 예측 가능성을 처벌하도록 조정된 탐지기가 더 이상 쉽게 걸려들지 않도록 합니다. 논증, 데이터, 참고문헌이 변하는 일은 없습니다.
영어뿐 아니라 루마니아어도 직접 휴머나이즈할 수 있습니다
초안을 휴머나이즈하기 전에 영어로 번역할 필요가 없습니다. 루마니아어로 작성된 텍스트를 그대로 붙여 넣으면 ProofreaderPro가 언어를 자동으로 감지하고, 원문의 라틴어(특수문자)·문법·학술적 문체를 존중하는 루마니아어 인식 모델로 라우팅합니다. 의미, 기술 용어, 인용은 온전히 유지되므로, AI 텍스트 휴머나이제이션은 모국어 글쓰기에서도 영어 글쓰기와 마찬가지로 첫 작업부터 작동합니다. 이 휴머나이저는 이러한 방식으로 60개가 넘는 언어를 처리하며, 각 언어를 독립적으로 감지해 ‘일반적인 영어’로 평탄화하지 않고 그 언어 자체로 다시 씁니다.
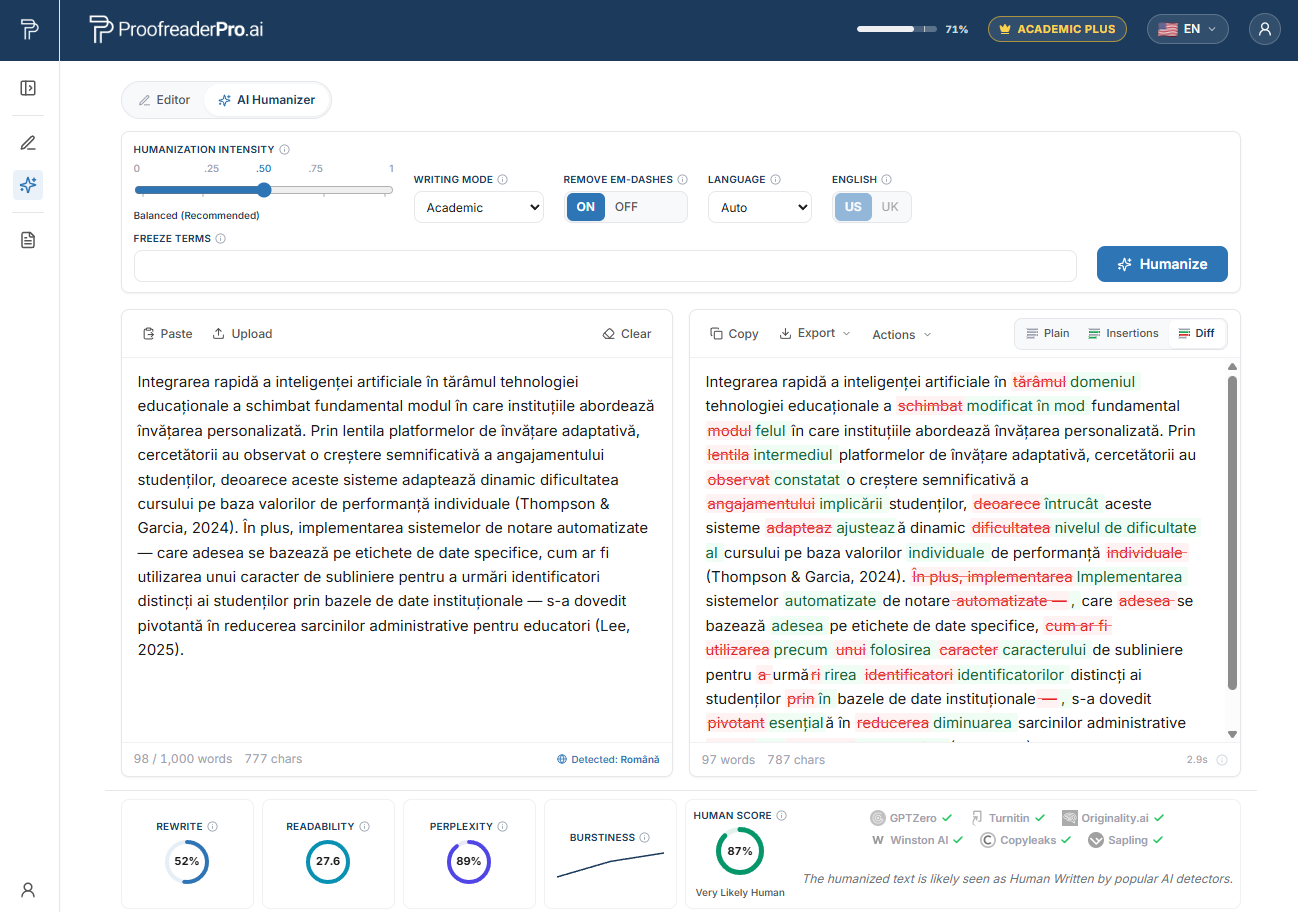
ProofreaderPro AI Humanizer가 루마니아 학술 텍스트를 다시 쓰는 장면입니다. before/after diff는 의미와 인용을 그대로 유지하며, detector checks는 자연스럽고 사람의 글처럼 읽히는지를 확인합니다.
왜 루마니아 연구자는 AI 탐지기에서 플래그가 뜰까
2023년, Stanford의 연구진(Weixin Liang이 이끎)은 Cell Press 저널 Patterns에 “GPT detectors are biased against non-native English writers.”라는 다소 직설적인 제목의 연구를 발표했습니다. 이들은 TOEFL 에세이를(전적으로 사람이 쓴 글) 작성한 뒤, 널리 사용되는 7개의 AI 탐지기에 통과시켰습니다.
결과는 제2언어로 출판하는 누구에게나 걱정을 안겨야 합니다. 평균적으로 비원어민 에세이의 약 61%가 AI-written로 플래그 처리된 반면, 원어민 영어 화자의 에세이는 대략 5% 수준이었습니다. 비원어민 에세이 중 거의 5분의 1, 약 19.8%는 모든 단일 탐지기에 의해 만장일치로 플래그 처리되었습니다. 그리고 그 에세이들은 모두 한 사람이 쓴 글이었습니다.
이 메커니즘은 ‘perplexity’라는 지표로, 특정 언어 모델에서 각 단어 선택이 얼마나 ‘놀랍게’ 나타나는지를 점수화합니다. 제2언어 작성자는 흔한 단어와 표준적이고 안전한 구성을 선택하는 경향이 있어 perplexity가 낮습니다. 낮은 perplexity는 기계 텍스트로 읽힙니다. 루마니아-영어가 명확하고 정확해지도록 만드는 바로 그 습관이, 이 도구들이 신뢰하지 않도록 학습한 습관인 것입니다. 우리는 이 메커니즘을 왜 AI 탐지기가 비원어민 작가를 플래그로 표시하는가에서 자세히 풀어 설명합니다.
허위 플래그의 배경이 되는 ‘루마니아어’의 1차 패턴
루마니아어는 라틴 문자 기반의 로망스 언어로, 영어와는 충분히 가까워 친숙함을 주면서도 동시에 달라 흔적(지문)을 남깁니다. 아래에 제시된 패턴들은 오류가 아닙니다. 올바르고 신중하며 표준적인 선택이며, 탐지기가 낮은 perplexity로 읽는 바로 그 ‘표준성’이 핵심입니다.
‘false friends’가 문체에 식별 가능한 형태를 만듭니다. 루마니아어에서 actual은 현재를 의미하고, eventual은 가능함을 의미하며, a realiza는 달성하거나 수행한다는 뜻입니다. sensibil은 민감한을 뜻하고, a pretinde는 주장한다는 뜻입니다. 이러한 함정을 피해 가는 법을 익힌 신중한 필자는 매번 결국 똑같이 안전한 교과서식 영어 단어로 수렴해, 다양성이 평탄화되고 이것이 탐지기에서 ‘눈에 띄는’ 형태로 나타날 수 있습니다.
정관사는 다르게 작동합니다. 루마니아어는 관사를 명사 앞의 별도 단어로 두기보다 명사 끝에 붙이기 때문에, 영어의 “the”는 쉽게 생략되거나 잘못된 위치에 놓이기 쉽습니다. 과도하게 교정하는 필자는 매우 규칙적인 관사 사용을 만들어내며, 이는 또 다른 균일한 신호가 됩니다.
문장이 길어지고 종속절이 많아집니다. 루마니아의 학술 문체는 겹겹이 쌓인 절과 접속법을 선호하며, 검토자들은 번역된 버전을 때때로 ‘빽빽하고’ 밀도 높다고 읽습니다. 밀도 높은 문장은 구조가 촘촘할수록 탐지기에 통계적으로 ‘매끄럽게’ 보일 가능성도 함께 커집니다.
전치사는 그대로 전이됩니다. “depend of”나 “different of” 같은 구문은 루마니아어 패턴을 그대로 따르며, 관계절을 열 때 “which”에 크게 의존하면 예측 가능한 리듬이 더해집니다.
명사화가 누적됩니다. 동사를 무겁고 밀도 높은 명사구로 바꾸는 것은 형식적인 루마니아어에서도 일반적이며 형식적인 영어에서도 일반적이지만, 이를 연달아 쌓으면 기계적으로 느껴지는 종류의 고른 추상적 리듬이 만들어집니다.
이들을 합치면 정확하고 전문적인 문장이 되지만, AI 탐지기 입장에서는 이상하게 매끄럽게 보이는 글이 됩니다.
루마니아의 AI 탐지 및 Turnitin 맥락
유사도(비슷한 정도) 스크리닝은 루마니아 고등교육 전반에서 일반적인 절차입니다. 박사 학위 논문과 저널 투고 원고는 Turnitin 또는 유사한 시스템으로 흔히 점검되며, 그와 같은 플랫폼들 상당수는 전통적인 유사도 점수와 함께 AI-작성 표시도 이제는 함께 부착합니다.
대학들은 자체적으로 생성형 AI에 대한 가이드를 발표해 왔고, 앞으로의 방향성은 분명합니다. 지원기관과 저널은 점점 더 저자들이 AI 도구를 어떻게 사용했는지 공개할 것을 요구합니다. 이는 충분히 합리적인 요청이며, AI를 전면 금지하는 것과는 분명히 다릅니다.
정직한 입장은 그것을 그대로 유지하는 것입니다. AI를 활용해 초안을 작성하거나 자신의 작업을 다듬는 데 도움을 받되, 모든 주장과 인용은 사실대로 유지하고, 기관과 목표 저널이 요구하는 형식으로 그 사용을 공개하십시오. 탐지기 점수는 ‘판결’이 아니라 이의를 제기할 수 있는 주장에 가깝고, 책임 있는 심사자는 단 하나의 숫자를 부정행위의 증거로 취급해서는 안 됩니다.
오탐 AI 플래그로부터 루마니아어-영어 연구를 보호하십시오
모든 인용문과 기술 용어를 그대로 유지한 채, 본인이 작성한 신중한 학술 초안을 자연스럽게 다듬고, 자신 있게 AI 사용을 공개하십시오.
Humanizer를 무료로 사용해 보세요주요 루마니아 대학과 AI 점검이 등장하는 지점
아래는 루마니아 연구가 작성되고, 심사를 받고, 스크리닝되는 기관들입니다. 각 기관은 학위논문과 원고를 유사도 시스템으로 돌리며, 그 검토 과정에서 점점 더 AI 지표의 가중치를 함께 고려하고 있습니다.
- Universitatea din București (University of Bucharest), Bucharest
- Universitatea Babeș-Bolyai (Babeș-Bolyai University), Cluj-Napoca
- Universitatea Politehnica din București (Politehnica University of Bucharest), Bucharest
- Universitatea Alexandru Ioan Cuza din Iași, Iași
- Universitatea de Vest din Timișoara (West University of Timișoara), Timișoara
- Universitatea de Medicină și Farmacie Carol Davila, Bucharest
- Universitatea Tehnică din Cluj-Napoca (Technical University of Cluj-Napoca), Cluj-Napoca
- Universitatea Transilvania din Brașov (Transilvania University of Brașov), Brașov
- Academia de Studii Economice din București (Bucharest University of Economic Studies, ASE), Bucharest
- Universitatea din Craiova (University of Craiova), Craiova
이들 시스템 중 어느 곳에서든 플래그는 대화의 시작이지 끝이 아닙니다. 당신이 원하는 것은 애초에 그 대화를 불러오지 않는 문장입니다. 왜냐하면, 그것은 이미 당신이 쓰고 있는 신중한 인간의 글처럼 ‘틀림없이’ 읽히기 때문입니다.
루마니아 연구자를 위한 AI 휴머나이저는 어떻게 작동하는가
작동 방식은 정직하며, 당신이 이미 글을 쓰는 방식에 들어맞습니다. 루마니아 연구자를 위한 AI 휴머나이저가 실제로 어떻게 작동하는지 설명하겠습니다.
먼저 논문 초안을 작성합니다. 먼저 루마니아어로 생각하는 것이 도움이 된다면 그렇게 하십시오. 그 다음 번역하여 영어로 작성하거나, AI 어시스턴트를 사용해 첫 초안이 움직이도록 만드세요. 문법과 용어를 교정해 과학이 정확하도록 한 뒤, text humanizer로 당신의 영어를 실행합니다. 이 과정은 문장 길이와 단어 선택을 다양화하고, 탐지기가 처벌하는 획일적인 리듬을 매끈하게 완화하며, 기계 초안인 듯 보이게 만드는 불필요한 em 대시와 반복 표현을 조용히 제거합니다.
의미, 기술 어휘, 인용은 보존됩니다. 비영어 텍스트는 문장 구조를 존중하는 언어 인식 모델로 라우팅되므로, 루마니아어의 영향을 받은 문단이 ‘깨져서’ 나오지 않습니다. 자체 테스트에서, Turnitin, Originality.ai, GPTZero를 포함한 주요 탐지기들이 정교하고 표준적인 비원어민 영어를 오인하는 빈도를 실질적으로 낮추는 데 도움이 되었으며, 학술적 콘텐츠는 그대로 유지됩니다.
우리는 이것을 ‘우리가 본 바에 근거한 것’이라고 설명합니다. 탐지기는 몇 달마다 재학습하며, 어떤 정직한 도구도 100% 탐지 불가라고 주장할 수는 없습니다. 다만 말할 수 있는 것은, 좀 더 다양해진 명확한 인간 문장이 기계로 오인될 가능성이 훨씬 낮다는 점입니다. 이 설명은 우리의 다국어 AI 휴머나이저 허브의 일부이며, 전체 편집 그림 속에서 글로벌 학술 편집 허브와 함께 위치합니다.
마지막 단계는 선택 사항이 아닙니다. 초안이 자연스럽게 읽히면, 기관과 저널이 요구하는 방식대로 AI 사용을 공개하세요. 자신의 작업을 휴머나이즈하는 것은 편향된 플래그로부터 이를 보호합니다. 공개는 규칙 안에 확실히 머무르게 해 줍니다.
지역 지원기관, 저널, 그리고 AI 공개에 대한 기대
루마니아의 경쟁형 연구지원금은 주로 UEFISCDI(고등교육, 연구, 개발 및 혁신 자금 지원을 담당하는 행정기관)를 통해 집행됩니다. 연구평가 정책은 CNCS(국가 과학연구위원회)가 정하며, Academia Română(루마니아 국립학술원)는 전국 단위의 연구기관 네트워크를 운영합니다. 무엇보다 그 위에 CNATDCU가 있으며, 여기서는 최소 진급 기준이 색인 저널의 성과를 보상합니다.
이 ‘색인 압박’은 모두를 같은 목표로 이끕니다. 바로 Web of Science와 Scopus 저널이며, 이곳의 심사자들은 언어에 대해 엄격하고, AI 플래그는 과학 자체가 읽히기도 전에 투고를 멈출 수 있습니다.
AI 공개 요청은 지원 보고서와 저널 투고 시스템 전반으로 계속 확산될 것으로 예상됩니다. 안전한 습관은 공개를 ‘자백’이 아니라 정상적인 관행으로 받아들이는 것입니다. 어떤 도구가 글쓰기에 도움이 되었는지 분명하게 말하고, 데이터와 인용은 사실대로 유지한 다음, 깨끗하고 사람의 글처럼 들리는 원고가 그 작업을 대신하도록 하세요. 초안을 휴머나이저에 통과시키는 것 은 무언가를 숨기는 일이 아니라, 정확한 글쓰기를 방어하는 행위입니다.
자주 묻는 질문
Q: 루마니아 연구자를 위한 AI 휴머나이저가 제 인용이나 기술 용어를 바꾸나요?
아니요. 휴머나이저는 의미, 용어, 그리고 모든 인용을 사용자가 작성한 그대로 보존합니다. 문장 주변의 리듬과 단어 선택을 다양화하므로, 참고문헌과 전문 어휘는 온전히 유지되면서 글은 더 자연스럽게 읽힙니다.
Q: 어떤 휴머나이저라도 제 논문이 AI 탐지기를 통과한다고 보장할 수 있나요?
아니요. 정직한 도구라면 그 누구도 보장을 약속할 수 없고, 그런 약속을 하는 도구를 믿지 않는 편이 좋습니다. 탐지기는 몇 달마다 재학습하므로 어떤 결과도 보장할 수 없고, 100% 탐지 불가라고 부를 수도 없습니다. 다만 우리가 말할 수 있는 것은, 테스트 결과 정교한 비원어민 글을 ‘조금 더 다양하게’ 만들면 주요 탐지기에 오인되는 빈도가 실질적으로 낮아진다는 점입니다.
Q: 제 초안에 umanizarea textului AI를 쓰는 것은 부정행위(치팅)로 간주되나요?
정직하게 사용한다면 그렇지 않습니다. 사용자는 AI의 도움을 받아 자신의 작업을 다듬고, 모든 주장과 인용을 사실대로 유지한 뒤, 대학과 저널이 요구하는 방식으로 AI 사용을 공개합니다. 이것은 진짜 작업을 위한 공정성이며, 무언가를 숨기는 방법이 아닙니다.
Q: 제 올바른 영어가 애초에 왜 AI로 플래그 처리되나요?
탐지기는 예측 가능성을 점수화하고, 신중한 제2언어 글쓰기는 매우 예측 가능합니다. Stanford 연구는 사람이 쓴 비원어민 에세이가 원어민 에세이보다 AI로 플래그 처리되는 비율이 훨씬 더 높다는 것을 발견했습니다. 깔끔하고 표준적인 루마니아-영어는 낮은 perplexity로 읽히며, 이 도구들은 이를 기계 신호로 취급합니다.
Q: 루마니아 대학들은 실제로 AI를 스크리닝하나요?
네, 일반적인 의미에서는 그렇습니다. Turnitin 또는 유사한 시스템을 통한 유사도 점검은 일상적인 절차이며, 그 플랫폼들 다수는 AI-작성 표시도 함께 보여줍니다. 플래그는 ‘판결’이 아니라 검토를 요청하는 주장에 해당하므로, 원고가 애초에 그 질문을 불러오지 않도록 하는 것이 의미가 있습니다.
의미, 용어, 인용문을 그대로 유지하십시오. 탐지기를 혼동시키는 문장 리듬을 바꾼 다음, 자신 있게 AI 사용을 공개하십시오.

Moe는 자연어 처리 분야에 PhD를 갖춘 NLP 엔지니어입니다. 그의 연구는 컴퓨터 언어학, 텍스트 분석 및 기계 학습을 다루며 ProofreaderPro의 편집 및 인간화 모델에 직접 적용됩니다. 그는 대부분의 사람들이 전혀 보지 못하는 프로세스의 일부, 즉 언어 모델이 문장을 읽고 점수를 매기고 무엇을 변경할지 결정하는 방법에 대해 글을 씁니다.


