
영어로 글을 쓰는 그리스 연구자를 위한 AI 휴머나이저
그리스 연구자를 위한 AI 휴머나이저입니다. 그리스적 영향이 반영된 영어에서 발생하는 오탐 AI 탐지 신호를 줄이되, 의미와 인용은 그대로 유지하고 정직하게 공개하세요.

아테네 국립기술대학교(National Technical University of Athens)의 한 물리학자가 영어로 연구방법 섹션을 작성합니다. 모든 논문과 모든 시제를 두 번씩 확인한 뒤, 스코퍼스(Scopus) 색인 저널에 투고합니다. 그런데 몇 주 뒤 공동저자가 편집자 노트를 전달합니다. 원고의 일부가 자동화된 AI 검출기로 기계가 쓴 것으로 표시되었다는 내용이었습니다. 그녀는 모든 문장을 직접 썼습니다.
이제 이런 상황은 흔해져서, 연구자들이 아예 투고를 망설이게 만들 정도로 연구자의 신중함에 영향을 줍니다. 그리스 연구자를 위한 AI 휴머나이저는 이를 해결하기 위해 존재하며, 꼭 필요한 이유는 글쓰기 자체보다 ‘검출기’가 무엇을 어떻게 보는지에 더 많이 달려 있습니다.
그리스 연구는 공학, 컴퓨터과학, 물리학, 의학, 고전 분야에서 강세를 보이고, 그중 상당수는 사고와 1차 초안이 그리스어에서 출발한 뒤 영어로 세계에 전달됩니다. 발전과 단위 평가는 웹 오브 사이언스(Web of Science)와 스코퍼스(Scopus) 게재를 보상하므로, 명확한 영어로 출판해야 한다는 압박은 결코 줄지 않습니다. 문제는, 명확하고 표준적인 제2언어 영어가 바로 이런 도구들이 가장 자주 잘못 읽는 유형의 글이라는 점입니다.
그리스 연구자를 위한 AI 텍스트 인문화 (εξανθρωπισμός κειμένου AI)
저희 휴머나이저는 그리스 학술 문헌을 영어로 출판할 때, 신중하게 다듬어진(네이티브 영향이 반영된) 산문이 기계가 쓴 것처럼 오인되는 일을 줄여줍니다. 사용자의 AI 보조 초안을 바탕으로 의미와 인용은 그대로 유지하면서, 검출기가 고정적으로 집착하는 리듬과 단어 선택을 다양화합니다. 공정하지 않게 플래그가 찍힌 문단은 텍스트 휴머나이저에서 테스트해 볼 수 있습니다.
이 안내서는 더 넓은 다국어 AI 휴머나이저 허브의 한 노드로, 60개가 넘는 언어 전반에 걸쳐 같은 문제를 다룹니다. 학술 영어를 제2언어로 쓰는 사람들이라면 어디서든 ‘오탐 플래그’ 패턴이 반복되기 때문입니다.
그리스어로 초안을 쓰나요? 휴머나이저는 그 또한 감지하고 처리합니다
모든 초안이 영어로 시작되는 것은 아니며, 휴머나이저는 영어 입력을 요구하지도 않습니다. 그리스어 텍스트를 붙여 넣으면 ProofreaderPro가 그리스 알파벳을 자동으로 인식한 뒤, 언어에 민감한 모델로 라우팅하여 용어, 악센트, 인용을 사용자가 적어 둔 그대로 유지합니다. εξανθρωπισμός κειμένου AI로서 휴머나이저는 그리스어 산문을 직접 다시 써 주므로, 번역하기 전에 먼저 인문화할 수 있습니다. 동일한 감지는 60개가 넘는 언어에도 적용되어, 각 언어로 ‘각자 자신처럼’ 다시 작성됩니다.
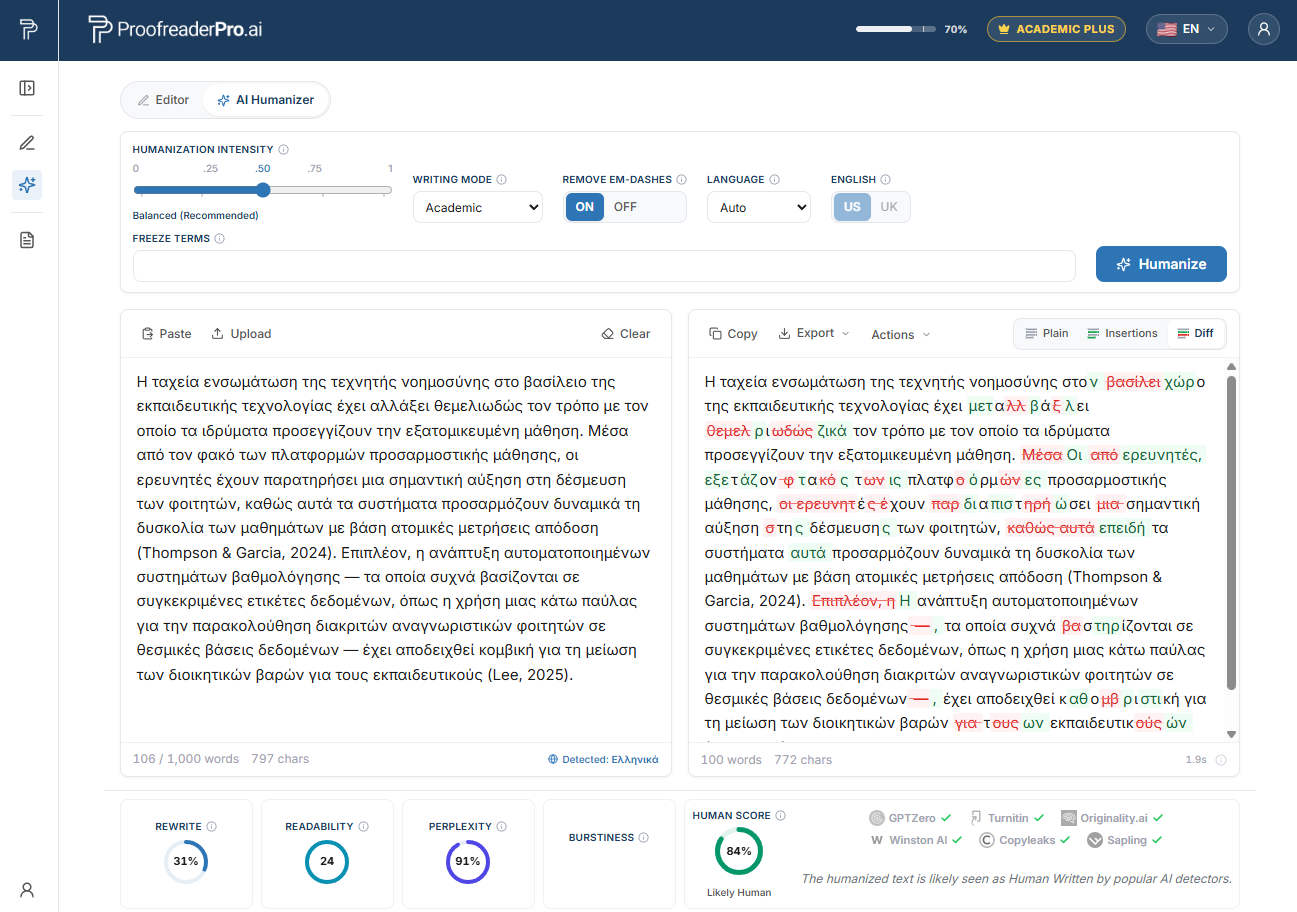
ProofreaderPro AI 휴머나이저가 그리스 학술 텍스트를 재작성하는 과정입니다. 전후 diff는 의미와 인용을 유지하며, 검출기 체크는 자연스러운 ‘사람이 읽는 느낌’을 확인해 줍니다.
왜 그리스 연구자들은 AI 검출기에 플래그가 찍히는가
먼저, 문제를 수치로 보여 준 연구부터 살펴보겠습니다. 2023년 스탠퍼드(Stanford) 팀이 Weixin Liang의 주도로 Cell Press 저널 Patterns에 「GPT detectors are biased against non-native English writers」를 발표했습니다. 이들은 사람이 쓴 TOEFL 에세이를 가져와, 널리 쓰이는 7종의 검출기에 돌렸습니다.
결과는 한쪽으로 쏠렸습니다. 평균적으로 비원어민(Non-native) 작성자의 에세이 약 61%가 AI로 플래그가 된 반면, 원어민(Native English) 작성자의 경우는 약 5%였습니다. 비원어민 에세이 다섯 편 중 한 편 정도, 즉 약 19.8%는 세트에 포함된 모든 검출기에서 만장일치로 플래그가 찍혔습니다. 그리고 그 에세이들 모두에는 사람이 쓴 저자가 있었습니다.
이 메커니즘을 ‘퍼플렉시티(perplexity)’라고 부릅니다. 많은 검출기는 다음에 올 단어가 언어 모델 입장에서 얼마나 ‘놀라운(surprising)’지에 점수를 매깁니다. 즉, 흔한 단어를 예측 가능한 순서로 구성한 텍스트는 점수가 낮게 나옵니다. 퍼플렉시티가 낮으면 기계가 쓴 텍스트로 읽힙니다. 표준 어휘와 안전한 문장 패턴을 선택하는 신중한 그리스 연구자는, 검출기가 신뢰하지 않도록 학습된 바로 그 유형의 산문을 만들고 있는 셈입니다. 이러한 실패 양상에 대해 자세히는 왜 AI 검출기가 비원어민 작가를 플래그로 표시하는가에서 더 깊이 다룹니다.
오탐 플래그 뒤에 있는 그리스어 모국어(1st language) 패턴
아래 습관들은 오류가 아닙니다. 올바르고 표준적인 구성이며, 바로 그렇기 때문에 퍼플렉시티를 낮추고 플래그를 끌어냅니다.
가장 뚜렷한 사례가 관사(Article)입니다. 그리스어는 추상명사, 고유명사, 제네릭(generics)에 대해 정관사를 사용하므로, 그리스어 화자가 쓴 영어는 자연스럽게 ‘the’로 채워집니다. 예를 들면 "the science shows", "the Professor Papadopoulos argued", "the nature of the problem"처럼 말입니다. 각 구절은 문법적으로 맞고, 그것들이 꾸준히 누적되는 양상은 매우 규칙적입니다.
시제와 상(Aspect)도 두 번째 신호를 제공합니다. 그리스어는 영어와 다르게 상을 표시하므로, 현재완료(present perfect)와 단순과거(simple past) 사이, 혹은 단순형과 진행/연속형(simple and continuous forms) 사이의 선택이 문단 전반에서 고르게, 예측 가능하게 나타날 수 있습니다. 검출기는 그 ‘고른 양상’을 사람이 선택하는 과정이라기보다 ‘패턴’으로 읽습니다.
문장 길이도 중요합니다. 그리스 학술 문체는 무거운 접속사(heavy connectives)로 묶인 긴 문장을 선호하므로, "moreover", "furthermore", "in addition" 같은 표현이 논증의 이음새에서 쌓여 올라갑니다. 또한 이 접속사들은 모델이 다음에 보기를 가장 높은 확률로 기대하는 단어들 중 하나이기도 해서, 퍼플렉시티를 더 낮춥니다.
여기에 더해 두 가지 전이 효과가 전체를 완성합니다. 단어 배열(word order)은 어순이 더 자유로운 언어에서 넘어오며, 그 결과 올바르지만 형태가 균일하게 유지되는 주제화(topicalised) 문장이 만들어집니다. 그리고 이름과 기술 용어가 그리스 알파벳에서 벗어나 라틴 문자로 전사(transliteration)될 때의 선택은, 또 다른 층위의 규칙성을 더합니다. 이 모든 특성이 합쳐져, 정직한 그리스-영어(Greek-English)가 검출기에게는 유난히 매끄럽게 보이게 됩니다.
그리스의 AI 탐지, 그리고 Turnitin 맥락
그리스 기관에서 나온 학위논문과 저널 투고 원고는 통상적으로 검토됩니다. 학위논문과 원고에 대해서 Turnitin 또는 iThenticate와의 유사도 검사(similarity checking)는 표준적인 관행이며, 동일한 플랫폼들이 이제 유사도 점수와 함께 AI 작성 지표도 함께 노출합니다.
그리스 전역의 대학들은 자체 생성형 AI 가이드를 발행해 왔고, 앞으로의 방향은 금지 쪽이 아니라 ‘공개’ 쪽을 가리킵니다. 지원 기관과 저널은 점점 더 저자에게 어디에서 어떤 방식으로 AI 도구를 사용했는지 밝히라고 요구합니다. 이 모든 것이 AI 보조가 금지된다는 뜻은 아닙니다. 중요한 것은, 숨기는 것과는 전혀 다른 차원의 ‘정직한 공개’가 기대된다는 점입니다.
기억할 만한 사실 하나가 있습니다. 검출기 점수(detector score)는 판결(verdict)이 아닙니다. Turnitin 자체도 낮은 AI 점수를 억제하고, 그 수치가 단독으로 무결성(integrity) 판단의 근거가 되어서는 안 된다고 경고합니다. 그 밖의 여러 대학도 앞서 문서화된 편향과 정확히 동일한 이유로 AI 검출기를 꺼 버리는 조치를 취했습니다. 플래그는 논쟁할 수 있는 주장이지, 유죄를 확정하는 사실(finding of guilt)이 아닙니다.
편향된 검출기가 연구를 대신 말하게 두지 마세요
플래그가 표시된 문단을 붙여 넣고, 인간답게 다듬기가 의미, 용어, 인용을 보존하면서도 리듬을 잘못 읽는 검출기의 가능성을 다양하게 하는 것을 확인하세요.
Humanizer를 무료로 사용해 보세요AI 체크가 등장하는 주요 그리스 대학들
아래 기관들은 유사도와, 점점 더 AI 지표까지 반영하여 학위논문과 원고를 스크리닝합니다. 그중 어느 곳에 작성해 투고한다면, 논문이나 투고 원고가 이들 시스템 중 하나를 통과하게 될 것으로 예상해야 합니다.
- Εθνικό και Καποδιστριακό Πανεπιστήμιο Αθηνών (National and Kapodistrian University of Athens, NKUA), in Athens
- Αριστοτέλειο Πανεπιστήμιο Θεσσαλονίκης (Aristotle University of Thessaloniki, AUTH), in Thessaloniki
- Εθνικό Μετσόβιο Πολυτεχνείο (National Technical University of Athens, NTUA), in Athens
- Πανεπιστήμιο Πατρών (University of Patras), in Patras
- Πανεπιστήμιο Κρήτης (University of Crete), in Heraklion and Rethymno
- Πανεπιστήμιο Ιωαννίνων (University of Ioannina), in Ioannina
- Πανεπιστήμιο Θεσσαλίας (University of Thessaly), in Volos
- Οικονομικό Πανεπιστήμιο Αθηνών (Athens University of Economics and Business, AUEB), in Athens
- Δημοκρίτειο Πανεπιστήμιο Θράκης (Democritus University of Thrace), in Komotini
이 목록이 그리스 고등교육 전체를 전부 담고 있지는 않지만, 실제로 가장 많은 영어권 연구 글쓰기와 가장 많은 스크리닝이 이뤄지는 곳들을 포괄하고 있습니다.
그리스 연구자를 위한 AI 휴머나이저는 어떻게 작동하는가
작동 흐름(workflow)은 정직하고 단순하며, 사용자를 규칙 안에 그대로 두는 방식입니다.
먼저 초안을 잡습니다. 생각이 가장 명확해지는 지점이 그리스어라면 그리스어로 쓰고 번역하거나, 사용 중인 어떤 보조가 있든 영어로 직접 초안을 작성합니다. 문장이 어떻게 읽히는지를 걱정하기 전에, 논증과 근거를 정확히 맞추세요.
다음으로 문법을 교정합니다. 관사 과다 사용을 바로잡고, 시제를 정리하며, 용어를 점검해 의미가 사용자가 의도한 그대로가 되도록 합니다. 텍스트 휴머나이저는 이 단계를 대체하지 않습니다. 입력이 깔끔할수록 출력이 더 좋아지기 때문입니다.
그리고 사용자의 AI 보조 산문을 직접 인문화하세요. 이 도구는 문장 리듬과 단어 선택을 다양화하고, 낮은 퍼플렉시티로 읽히는 획일적인 리듬을 끊어 주며, 반복되는 접속사와 불필요하게 튀는 em 대시 같은 ‘특징적인 흔적’을 제거합니다. 이 모든 과정에서 의미, 기술 용어, 모든 인용은 보존됩니다. 비영어 텍스트는 언어에 민감한 모델로 라우팅되므로, 그리스어 문단은 평평하게 눌려(평탄화되어) 형태가 사라지지 않고 구조를 유지합니다.
결과에 대해 우리가 정직하게 말할 수 있는 것은 무엇일까요? 자체 테스트에서, 인문화를 하면 Turnitin, Originality.ai, GPTZero 같은 주요 검출기들이 신중하게 작성된 표준 비원어민 영어를 오판하는 빈도를 상당히 줄이면서도, 학술적 의미는 그대로 유지되는 것으로 나타났습니다. 우리는 이를 숫자로 단정하지 않겠습니다. 검출기는 몇 달마다 재학습을 하고, 어떤 도구도 ‘100% 감지 불가’를 약속할 수 없습니다. 그런 것을 보장하는 사람은 무언가를 팔고 있는 것입니다.
마지막으로 공개하세요. AI 사용을 사용자의 지도교수, 기관, 목표 저널이 요구하는 형식에 맞춰 기재하십시오. 인문화는 편향된 플래그로부터 신중한 글쓰기를 보호하고, 공개는 사용자가 받았던 보조에 대해 기록을 정직하게 유지하게 해줍니다. 둘은 함께 가야 합니다. 인문화 이상의 편집 도움을 원한다면, 저희 글로벌 학술 편집 허브에서 언어 지원 리소스를 한곳에 모아 두었습니다.
현지 지원 기관, 저널, 그리고 AI 공개 기대
그리스에서 경쟁 연구비는 주로 HFRI, 즉 그리스 연구·혁신재단(ΕΛΙΔΕΚ)을 통해 집행되며, 이 기관은 연구책임자 주도의 프로젝트에 자금을 지원합니다. 한편 GSRI, 즉 연구·혁신 총국(General Secretariat for Research and Innovation)이 국가 연구 정책을 수립합니다. 또한 많은 그리스 연구팀은 유럽연구위원회(European Research Council, ERC) 보조금을 보유하기도 합니다. 이들 각각은 자체적인 보고 문화가 있고, AI 사용에 대한 공개가 그 일부로 점차 자리 잡아 가는 중입니다.
출판 측면에서 그리스 연구자들은 웹 오브 사이언스(Web of Science)와 스코퍼스(Scopus) 색인 저널을 목표로 합니다. 그리고 국립 문서센터(National Documentation Centre, EKT)는 국가 리포지터리와 연구 통계를 관리합니다. 대부분의 국제 저널은 이제 저자 가이드라인(author guidelines)에 AI 공개 조항을 싣고 있습니다. 안전한 습관은 투고 전에 그 조항을 먼저 읽고, 추론에 맡기기보다는 도구를 설명하는 짧은 진술문을 작성하는 것입니다.
추론의 흐름을 놓치지 마세요. 사용자의 초안을 직접 인문화하는 것은 이 모든 규정을 우회하는 방법이 아닙니다. 문서화된 검출기 편향으로부터 명확한 그리스-영어를 보호하며, 공개는 기록을 바르게 유지합니다. 공정하게 다뤄지는 진짜 작업.
자주 묻는 질문
Q: 제 논문이 제가 직접 썼는데도 플래그가 찍혔다면, AI 휴머나이저가 도움이 될까요?
네, 바로 그 사례를 위해 만들어졌습니다. 신중하게 작성된 비원어민 영어는 퍼플렉시티가 낮게 나와 기계가 쓴 텍스트로 오독되기 쉽고, 인문화는 의미를 유지하면서 플래그를 촉발하는 리듬과 단어 선택을 다양화합니다. 검출기가 불완전하다는 사실을 지울 수는 없지만, 검출기가 과도하게 중요하게 보는 특정 특성은 줄여줍니다.
Q: 그리스 연구자를 위한 AI 텍스트 인문화는 제 인용이나 기술 용어를 바꾸나요?
아니요. 휴머나이저는 인용, 참고문헌, 해당 분야의 용어를 그대로 보존합니다. 그것들을 바꾸면 논문이 손상될 수 있기 때문입니다. 이 도구는 근거(증거)나 전문 어휘가 아니라, 문장 리듬과 표현(프레이징)에 작동합니다.
Q: 그리스 연구자를 위한 AI 휴머나이저를 쓰는 것은 부정행위로 간주되나요?
정직하게 사용할 때는 그렇지 않습니다. 사용자는 본인만의 AI 보조 초안을 인문화하고, 의미와 인용을 유지한 뒤, 기관과 저널이 요구하는 방식으로 AI 사용을 공개합니다. 목표는 실제 글쓰기에 대한 공정성이지, 날조된 작업을 숨기는 ‘위장’이 아닙니다.
Q: 어떤 도구든 제 텍스트가 모든 AI 검출기를 통과한다고 보장할 수 있나요?
아니요. 그렇게 말하는 누구를든 의심해야 합니다. 검출기는 정기적으로 모델을 바꾸기 때문에, 어떤 도구도 100% 감지 불가를 약속할 수 없습니다. 좋은 휴머나이저가 할 수 있는 일은, 정직한 비원어민 산문이 오탐 플래그로 찍히는 빈도를 줄이는 것뿐이며, 우리는 테스트에서 그것을 확인했습니다.
Q: 저는 그리스어로 초안을 작성한 뒤 번역했습니다. 그러면 플래그가 더 잘 찍히나요?
그럴 수 있습니다. 번역된 학술 산문은 대체로 매우 표준적이고 규칙적이어서, 바로 그것이 퍼플렉시티를 낮게 읽히게 만듭니다. 번역된 초안을 인문화하고, 자신의 처리 과정을 공개하는 것은 명확성이 인정되는 글쓰기가 명확하다는 이유로 불이익을 받지 않도록 하는 합리적인 방법입니다.
비원어민 학자를 위해 설계됨, 인용, 용어, 논지를 보존하면서 그리스어-영어의 세심한 글에서 잘못된 AI 플래그를 줄이세요.

Moe는 자연어 처리 분야에 PhD를 갖춘 NLP 엔지니어입니다. 그의 연구는 컴퓨터 언어학, 텍스트 분석 및 기계 학습을 다루며 ProofreaderPro의 편집 및 인간화 모델에 직접 적용됩니다. 그는 대부분의 사람들이 전혀 보지 못하는 프로세스의 일부, 즉 언어 모델이 문장을 읽고 점수를 매기고 무엇을 변경할지 결정하는 방법에 대해 글을 씁니다.


