
영어로 글을 쓰는 헝가리 연구자를 위한 AI 휴머니저
헝가리 연구자를 위한 AI 휴머니저. 헝가리 영향을 받은 영어에서 발생하는 거짓 AI 탐지 플래그를 줄이면서 의미와 인용을 그대로 유지하고, 사용을 정직하게 공개하세요.

헝가리 과학은 기대를 뛰어넘는 성과를 꾸준히 보여 왔습니다. 인구가 천만 명 미만인 나라에서도 수많은 수학자, 물리학자, 화학자, 생명과학자들이 놀라운 계보를 남겼으며, 그 전통은 오늘날에도 대학들의 산출물에서 그대로 드러납니다. 다만 연구는 영어로 작성해야 합니다. 부다페스트나 세게드의 거의 모든 연구자는 먼저 헝가리어로 초안을 쓰고 생각을 정리한 뒤, 문법이 거의 전혀 다른 두 번째 언어로 논지를 옮깁니다. 바로 이 번역의 ‘틈’이, 헝가리 연구자를 위한 AI 휴머니저가 필요한 지점입니다. 신중한 헝가리-영어 문장이 이제는 기계 문장으로 오독되고 있기 때문입니다.
여기 불편한 사실이 있습니다. 영어가 더 깨끗하고 더 표준적일수록, AI 탐지 시스템은 더 많이 플래그를 걸 가능성이 커집니다. 각 단어가 얼마나 “놀랍지 않은지”를 기준으로 텍스트의 점수를 매기는 모델은, 학술적으로 훈련된 연구자의 단정하고 예측 가능한 문장까지도 기계 작성의 신호로 취급합니다. 어려운 제2언어로 명료하게 글을 써서 얻는 보상은, 오히려 거짓 고발이 되는 셈입니다.
우리는 이 특정 문제를 위해 휴머니저를 만들었습니다. 누구의 편법을 숨기기 위해서가 아니라, 진짜 연구자들의 진짜 작업을 보호하기 위해서입니다. 이 가이드는 헝가리의 연구자들이 정직한 출판 워크플로에 어떻게 이 도구를 통합할 수 있는지를 설명합니다.
AI-szöveg humanizálása 헝가리 연구자들에게
AI-szöveg humanizálása는 자신의 인공지능( AI )의 도움을 받는 텍스트를 더 ‘사람 같은’ 리듬으로 바꾸되, 의미와 전문 용어, 인용은 그대로 유지하는 것을 뜻합니다. Our tool is built for Hungarian academics who draft in their own language and then publish in English.
핵심은 무엇인가를 숨기는 것이 아닙니다. 핵심은 헝가리 연구자가 쓴 신중하고 표준적인 영어 문장은, 그것이 신중하고 표준적이라는 이유만으로 의심받아서는 안 된다는 점입니다. text humanizer가 줄이도록 설계된 것이 바로 그 ‘거짓 플래그’입니다.
헝가리어 초안을 먼저 쓰나요? 휴머니저가 직접 감지하고 재작성합니다
영어로 먼저 번역하지 않고도 헝가리어 초안을 ‘휴머니저’ 처리할 수 있습니다. 텍스트를 붙여넣으면 ProofreaderPro가 언어를 자동으로 감지하고, 그다음 긴 모음, 교착형(aggulutinated) 형태, 그리고 글 속 인용을 존중하는 ‘헝가리어에 맞춘’ 모델로 연결합니다. AI-szöveg humanizálása는 헝가리어 산문의 리듬을 변주하되 모든 용어와 참고문헌은 그대로 유지합니다. 자동 감지는 60개가 넘는 언어를 아우르므로, 헝가리어는 영어로 재구성되는 것이 아니라 ‘헝가리어 그대로’ 취급됩니다.
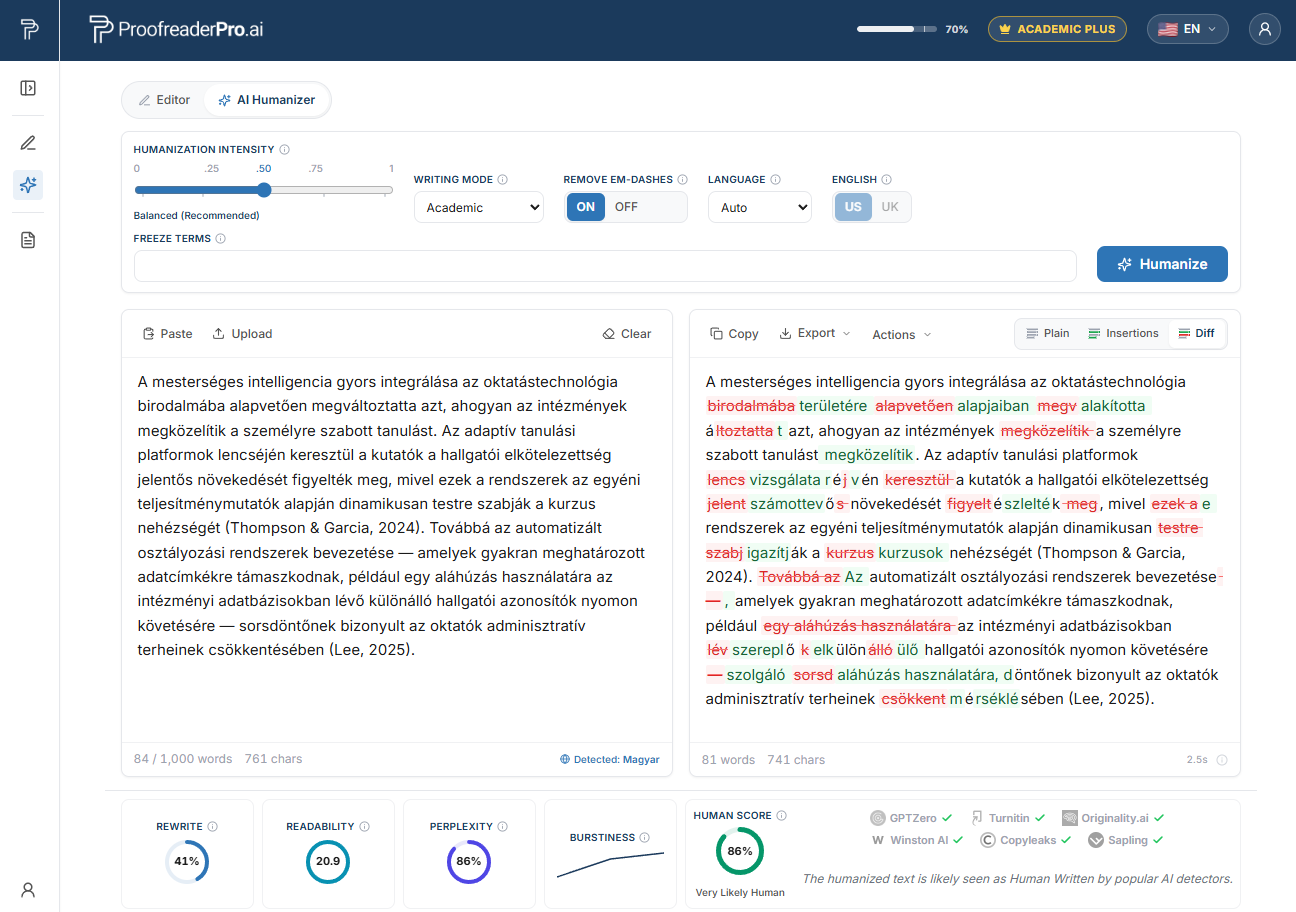
헝가리 학술 텍스트를 재작성하는 ProofreaderPro AI 휴머니저. before/after diff는 의미와 인용을 그대로 유지하며, 탐지 체크는 자연스러운 사람이 읽는 흐름을 확인합니다.
왜 헝가리 연구자는 AI 탐지에서 플래그가 걸리나
2023년, 스탠퍼드 연구진(Weixin Liang이 이끈 그룹)은 사람이 쓴 에세이에서 널리 사용되는 GPT 탐지기 7종을 테스트했습니다. 그 에세이는 TOEFL 시험에서 나온 것이어서, 모두 사람이 작성했으며 동시에 비원어민 영어 작성자라는 공통점이 있었습니다. 평균적으로 약 61%의 에세이가 AI 생성으로 플래그 처리되었습니다. 영어 원어민이 쓴 에세이의 경우 그 수치는 약 5%였습니다. 비원어민 에세이 중에서는 거의 5분의 1, 즉 약 19.8%가 모든 탐지기에 의해 만장일치로 플래그 처리되었습니다.
다시 읽어 보겠습니다. 영어가 ‘작성자의 제2언어’라는 이유만으로, 사람 글쓰기는 열 번이 넘게 더 자주 플래그를 받았습니다.
이 메커니즘을 ‘퍼플렉서티(perplexity)’라고 합니다. 많은 탐지기는 단어 선택이 언어 모델에 비추어 얼마나 예측 가능한지를 추정합니다. 제2언어로 글을 쓰면, 신중한 작가들이 그렇듯 안전하고 흔하며 정확한 구문을 찾게 됩니다. 안전하고 흔함은 낮은 퍼플렉서티를 뜻하고, 낮은 퍼플렉서티는 이 도구들이 ‘기계 문장’으로 읽도록 훈련된 바로 그 지문입니다. 우리는 why AI detectors flag non-native writers에서 이 전체 메커니즘을 자세히 풀어 설명하지만, 짧게 요약하면 잔인할 정도로 단순합니다. 글을 명확하게 만드는 습관이, 곧 그 습관대로 플래그를 만드는 겁니다.
거짓 플래그 뒤에 있는 헝가리어의 첫 언어 패턴
헝가리어는 우랄계(Uralic) 언어로, 주변의 인도유럽 언어들과는 계통이 다르며 그 논리는 영어와 실제로 다릅니다. 이 차이는 헝가리-영어 글에서 ‘지문’을 남깁니다. 이 지문들은 지능의 오류가 아닙니다. 아주 다른 문법의 그림자이며, 그것이 깔끔한 영어로 매끈하게 정리되면 탐지기 입장에서는 평평하고 예측 가능하게 읽힙니다.
남성/여성 대명사 각각의 ‘한 가지 대명사’. 헝가리어에는 단일한 3인칭 대명사가 있고 문법적 성(gender)이 없어서, 영어에서는 "he"와 "she"가 서로 바뀌어 사용됩니다. 이를 교정하려는 글쓴이는 가장 안전한 선택지를 과도하게 쓰거나, "the author"와 "the participant"처럼 표현을 재구성하는 경향이 생기는데, 그러면 변형과 편차가 거의 없는 아주 균일한 저변동(저변화) 문장이 만들어집니다.
관사가 분배되는 방식. 헝가리어에도 관사(a, az, egy)는 존재하지만 영어와는 다른 논리에 따라 배치됩니다. 정관사와 부정관사는 생략되거나 추가되고, 신중하게 고친다면 대개 매번 가장 표준적인 교과서식 관사를 쓰게 됩니다. ‘표준’이란 말은 바로 기계처럼 점수화되는 것과 정확히 일치합니다.
교착(aggutination)과 강한 명사화. 헝가리어는 어간에 접미사를 쌓아 올려 의미를 구축합니다. 이것이 영어로 옮겨지면, 밀도 높은 명사구들과 긴 명사화 연쇄(예: "the implementation of the optimisation of...")가 되어 문법적으로는 완벽하지만 리듬적으로는 단조롭습니다. 탐지기는 단조로움을 좋아합니다.
주제 중심의 어순. 헝가리어는 문장의 주제와 초점을 전면에 내세우기 때문에, 강조가 영어 독자가 기대하는 위치와는 다른 곳에 실립니다. 이를 단순한 주어-동사-목적어(SVO) 영어로 ‘정규화’하면, 결과는 정확하고 질서정연하며 예측 가능합니다.
미래 시제 표지의 부재와 다른 상(aspect) 체계. 헝가리어는 미래를 표시하는 방식이 다르고 상을 처리하는 방식도 나름의 체계를 따르기 때문에, 영어에서의 시제 선택은 불일치하게 나타난 뒤 가장 중립적이고 흔한 시제로 교정되는 흐름이 생깁니다. 가장 안전한 시제는 다시 말해 퍼플렉서티가 가장 낮은 시제입니다.
전치사 대신 후치사(postpositions). 헝가리어는 관계 표지를 명사 뒤에 배치하는 경향이 있어, 영어에서는 전치사 선택에서 실수가 발생하기 쉽습니다. 그 실수를 고치려면 매번 표준 전치사를 찾아 쓰게 되며, ‘표준’이란 바로 탐지기가 생성된 것으로 읽는 신호입니다.
헝가리의 AI 탐지 환경과 Turnitin의 맥락
헝가리 기관에서 제출되는 논문/저널 투고물은 텍스트 유사성 검사가 관행적으로 수행되며, 대부분 Turnitin 또는 이에 준하는 시스템이 사용됩니다. 그리고 AI 지표는 점점 더 그 동일한 심사 과정에 포함되는 추세입니다. 이는 이제 박사학위 방어와 원고 심사에서의 ‘일반적인 절차’이며, 예외적인 단계가 아닙니다.
이 도구들의 한계를 염두에 두는 것이 중요합니다. Vanderbilt를 포함해 해외의 여러 주요 대학은 오탐(거짓 양성)과 비원어민 작성자에 대한 편향 문제 때문에 Turnitin의 AI-글쓰기 탐지기를 끈 바 있습니다. 또한 Turnitin 자체도 가장 낮은 점수를 억제하고, 그 수치가 단독으로 ‘무결성(integrity) 사건’을 결정해서는 안 된다는 경고를 합니다. 탐지기 점수는 당신이 이의를 제기할 수 있는 ‘주장’이지, 최종 판결이 아닙니다.
헝가리 기관들은 생성형 AI에 대한 자체 지침을 발표해 왔고, 지원기관과 저널은 점점 더 저자들에게 이러한 도구가 어떻게 사용되었는지를 공개할 것을 기대하고 있습니다. 정직한 답은 숨기는 것이 아닙니다. 책임 있게 작성하고 편집한 뒤, 사용한 도구를 선언하는 것입니다.
오탐으로부터 본인의 신중한 헝가리어-영어를 보호하십시오
모든 인용문, 용어, 연구 결과를 그대로 유지하면서, 본인의 AI 보조 초안을 자연스럽게 다듬으십시오. 그리고 자신 있게 도구 사용을 공개하십시오.
Humanizer를 무료로 사용해 보세요헝가리의 주요 대학과 AI 점검이 나타나는 지점
유사성 및 AI 지표에 대한 심사는 박사과정 학교부터 저널 편집 사무실에 이르기까지 헝가리 고등교육 전반에 걸쳐 나타납니다. 다음 기관들은 이 나라에서 연구 집약도가 높은 편에 속하며, 이들의 논문과 원고는 이러한 점검을 거칩니다:
- Eötvös Loránd Tudományegyetem (Eötvös Loránd University, ELTE), 부다페스트
- Semmelweis Egyetem (Semmelweis University), 부다페스트(주요 의과대학)
- Szegedi Tudományegyetem (University of Szeged), 세게드
- Debreceni Egyetem (University of Debrecen), 데브레첸
- Budapesti Műszaki és Gazdaságtudományi Egyetem (Budapest University of Technology and Economics, BME), 부다페스트
- Budapesti Corvinus Egyetem (Corvinus University of Budapest), 부다페스트
- Pécsi Tudományegyetem (University of Pécs), 페치
- Pázmány Péter Katolikus Egyetem (Pázmány Péter Catholic University), 부다페스트
- Óbudai Egyetem (Óbuda University), 부다페스트
ELTE에서 방어하는 학위논문이든, Semmelweis에서 나온 임상 원고든 상관없이 동일한 역학이 적용됩니다. 표준적이고 신중한 헝가리-영어 글쓰기는, 퍼플렉서티 기반 플래그에 걸릴 가능성이 가장 높은 글쓰기입니다.
헝가리 연구자를 위한 AI 휴머니저는 어떻게 작동하나
우리가 권장하는 워크플로는 간단하며, 무엇보다 정직합니다. 세 단계로 구성됩니다.
첫째, 초안 작성. 가장 빠르게 생각이 글로 옮겨지도록 논문을 작성하세요. 많은 헝가리 연구자에게는 헝가리어로 초안을 쓰고 번역하는 방식이거나, AI 지원을 받으며 영어로 직접 쓰는 방식이 될 수 있습니다. 어느 쪽이든 괜찮습니다.
둘째, 핵심을 교정합니다. 문법, 전문 용어, 논증을 수정해 과학이 정확하도록 만드세요. 언어 자체에 더 신중한 검토가 필요하다면, global academic editing hub에서 해당 측면을 다룹니다.
셋째, 자신의 초안을 휴머니저 처리합니다. 여기서 text humanizer가 등장합니다. 문장의 길이와 리듬을 변주하고, 교착형 헝가리-영어가 만들어내기 쉬운 단조로운 리듬을 끊어 주며, AI 도구와 제2언어 습관이 남기는 엉뚱한 ‘em dash’와 반복 구조를 제거합니다. 무엇보다 중요한 점은 의미, 기술적 어휘, 그리고 모든 인용을 그대로 보존한다는 것입니다. 비영어 원문은 언어 인식 모델로 연결되며, 도구는 60개가 넘는 언어를 지원합니다.
그 결과 무엇을 얻나요? 우리가 직접 테스트해 본 결과, 신중한 비원어민 초안을 휴머니저 처리하면 주요 탐지기가 그것을 ‘기계가 쓴 글’로 오독하는 빈도가 상당히 줄어듭니다. 다만 이는 약속이 아니라, 테스트에서 우리가 관찰한 바를 설명하는 것입니다. 탐지기는 몇 달마다 재학습하므로, 여기서 어떤 결과를 보장할 수는 없습니다. 또한 ‘100% 탐지 불가’라고 주장하는 서비스는 당신에게 제공할 수 없는 것을 판매하는 셈입니다.
마지막 단계는 ‘공개’입니다. 대학과 목표 저널이 요구하는 형식에 맞춰 AI 사용 진술서를 추가하세요. 자신의 AI 지원 글쓰기를 휴머니저 처리한 뒤 이를 선언하는 것은 요령이 아닙니다. 자신의 신중한 작업이, 제2언어로 명료하게 썼다는 이유로 부당한 플래그를 받는 대신, 그 자체의 장점으로 평가되도록 확인하는 일입니다. 국가별 더 넓은 언어 환경에 대해서는 multilingual AI humanizer hub를 참고하세요.
로컬 지원기관, 저널, 그리고 AI 공개 기대치
헝가리에서의 경쟁력 있는 연구는 주로 **NKFIH (Nemzeti Kutatási, Fejlesztési és Innovációs Hivatal, the National Research, Development and Innovation Office)**를 통해 대규모로 지원되며, **MTA (Magyar Tudományos Akadémia, the Hungarian Academy of Sciences)**는 국가 차원의 학술 기관으로서 기능하고 **HUN-REN (the Hungarian Research Network)**이 공공 연구소를 운영합니다. 이들 모두는 출판되고 인덱싱된 산출물을 보상하기 때문에 연구자들이 영어로 출판해야 한다는 압력이 꾸준히 유지됩니다.
그 산출물은 Web of Science 및 Scopus 인덱스 저널에서 측정되고, **MTMT (Magyar Tudományos Művek Tára, the Hungarian Scientific Bibliography)**에 등록됩니다. 국가 차원의 출판 데이터베이스입니다. 평가 문화는 국제적이고 영어로 출판하는 방식을 보상하는데, 이것이 바로 탐지기가 오독하는 ‘깨끗하고 표준적인 문체’로 헝가리 연구자를 밀어붙이는 정확한 압력입니다.
AI 사용 공개는 연구비 신청 보고와 저널 투고 모두에서 점점 더 일반화될 것으로 예상됩니다. 일상적인 것으로 취급하세요. 어떤 도구를 어떤 방식으로 사용했는지 명확히 쓰고, 데이터와 인용을 정직하게 유지하면, 불공정한 플래그에 맞서면서도 규정의 범위 안에서 편안하게 대응할 수 있습니다.
자주 묻는 질문
Q: 헝가리 연구자를 위한 AI 휴머니저는 제 인용이나 기술 용어를 바꾸나요?
아닙니다. 휴머니저는 사용자가 작성한 의미, 분야별 전문 용어, 그리고 모든 참고문헌을 그대로 보존하도록 설계되어 있습니다. 리듬과 표현은 바뀔 수 있지만, 학문 그 자체나 출처는 바뀌지 않습니다.
Q: 어떤 도구든 제 논문이 모든 AI 탐지기를 통과한다고 보장할 수 있나요?
아니요. 그런 주장을 하는 사람을 믿지 않는 것이 좋습니다. 탐지기는 정기적으로 재학습되므로, 어떤 정직한 서비스도 100% 탐지 불가를 약속할 수 없습니다. 우리가 말할 수 있는 것은, 테스트 결과에서 신중한 비원어민 글을 휴머니저 처리하면 기계가 쓴 글로 오독되는 빈도가 상당히 줄어든다는 점입니다.
Q: 내 초안을 휴머니저 처리하는 것은 일종의 부정행위인가요?
아닙니다. 본인이 직접 AI 지원 글쓰기를 작업하고, 발견(결과)을 정직하게 유지하며, 기관과 저널이 요구하는 대로 도구 사용을 공개하는 한에서는요. 목표는 속임수가 아니라 진짜 작업에 대한 공정성입니다.
Q: 글이 명료한데 왜 약한 글은 플래그가 안 걸리나요?
많은 탐지기는 ‘예측 가능성’을 점수로 매깁니다. 신중한 제2언어 작성자는 안전하고 표준적이며 정확한 구문을 선택하기 때문에, 낮은 퍼플렉서티 텍스트가 만들어지고, 낮은 퍼플렉서티가 바로 이 도구들이 기계 작성과 연결해 인식하는 패턴입니다. 당신의 명료함은 오히려 불리하게 작용합니다.
Q: 저는 먼저 헝가리어로 씁니다. 도구가 그걸 처리하나요?
네. 비영어 텍스트는 언어 인식 모델로 연결되어 60개가 넘는 언어에 걸쳐 문장 구조와 의미를 보존합니다. 그래서 헝가리어로 초안을 쓰고, 번역한 뒤, 영어 버전을 휴머니저 처리하더라도 논지를 잃지 않고 진행할 수 있습니다.
모든 인용문과 연구 결과를 그대로 유지하면서, 신중한 AI 보조 헝가리어-영어 초안을 자연스러운 학술 문장으로 바꾸고, 자신 있게 AI 사용을 공개하십시오.

Moe는 자연어 처리 분야에 PhD를 갖춘 NLP 엔지니어입니다. 그의 연구는 컴퓨터 언어학, 텍스트 분석 및 기계 학습을 다루며 ProofreaderPro의 편집 및 인간화 모델에 직접 적용됩니다. 그는 대부분의 사람들이 전혀 보지 못하는 프로세스의 일부, 즉 언어 모델이 문장을 읽고 점수를 매기고 무엇을 변경할지 결정하는 방법에 대해 글을 씁니다.


