
ইংরেজিতে লিখছেন আর্জেন্টিনার গবেষকদের জন্য AI মানবাইজার
আর্জেন্টিনার গবেষকদের জন্য AI মানবাইজার। স্প্যানিশ-প্রভাবিত ইংরেজিতে যাতে ভুল করে AI-ডিটেকশন সতর্কতা (ফ্ল্যাগ) না আসে, সেইভাবে অর্থ ও উদ্ধৃতি অক্ষুণ্ণ রেখে লেখাকে আরও মানবিক করুন এবং স্বচ্ছভাবে AI ব্যবহার প্রকাশ করুন।

আর্জেন্টিনা বছরে ১৮,০০০ থেকে ২২,০০০টি স্কোপাস-সূচিভুক্ত (Scopus-indexed) গবেষণাপত্র প্রকাশ করে, বিশ্বে আনুমানিক ৪০তম থেকে ৪৫তম স্থানে এবং লাতিন আমেরিকায় কেবল ব্রাজিল ও মেক্সিকোর পরেই। আজ এই কাজের বড় অংশই কোনো না কোনোভাবে AI সহকারীর মাধ্যমে শুরু হচ্ছে: ChatGPT দিয়ে একটি প্রথম খসড়া রূপরেখা, Claude দিয়ে একটি অনুচ্ছেদ আরও টাইট করা, এবং স্প্যানিশ থেকে অনুবাদের ছাপ যেন কমে, এভাবে মসৃণ করা। এটা স্বাভাবিক, এবং আপনি তা প্রকাশ করলে অধিকাংশ জার্নাল তা মেনে নেয়।
কিন্তু এরপরই সমস্যা শুরু হয়। আর্জেন্টিনার গবেষকদের জন্য AI মানবাইজার আছে, কারণ AI ডিটেক্টরগুলো নিয়মিতভাবে সতর্ক দ্বিতীয়-ভাষার (second-language) ইংরেজিকেও মেশিন-লেখা হিসেবে ভুল পড়ে, এবং আর্জেন্টিনার লেখকদের এমন গদ্যই পরিশোধ করে দিতে হয় যা আসলে শুধু পরিষ্কার, মানসম্মত এবং সঠিক।
আর্জেন্টিনা EF English Proficiency Index-এ ৫৬২ স্কোর করে, লাতিন আমেরিকায় সর্বোচ্চ। এই উচ্চ দক্ষতা এখানে আপনাকে রক্ষা করে না। উল্টোভাবে বললে, বহু বছরের আনুষ্ঠানিক অধ্যয়নের ফলে অর্জিত পালিশ করা, টেক্সটবুক-সঠিক ইংরেজি, ডিটেক্টরের চোখে ঠিক সেই ধরনের লেখাই সবচেয়ে বেশি ধরা পড়ে।
Humanizador de texto de IA para investigadores argentinos
Nuestro humanizador de texto de IA ayuda a los investigadores argentinos a publicar en ingles con mayor seguridad. Reescribe tu propio borrador asistido por IA para que tu ingles cuidadoso no sea confundido con texto automatico, conservando tu significado, tu terminologia tecnica y tus citas.
সোজা কথায়: আপনি বিজ্ঞান লেখেন, আপনি অর্থ ধরে রাখেন, এবং text humanizer বাক্য-ছন্দ ও শব্দচয়নে পরিবর্তন আনে, যাতে স্প্যানিশ-প্রভাবিত সতর্ক ইংরেজি সেটাই হয়ে ওঠে, মানুষের কাজ, যা এটি আসলেই। এটি ৬০টিরও বেশি ভাষা সমর্থন করে, এবং অ-ইংরেজি টেক্সট ভাষা-সচেতন একটি মডেলের মাধ্যমে যায়, যা বাক্যগঠন (sentence structure) সংরক্ষণ করে।
এটা কোনো কিছু লুকানোর ব্যাপার নয়। আপনারা পাঠানোর আগে যেন সত্যিকারের কাজটি ন্যায্যভাবে পড়া হয়, এবং আপনারা যে AI ব্যবহার করেছেন তা যেন আপনার প্রতিষ্ঠান ও জার্নালের চাহিদা অনুযায়ী সততার সাথে প্রকাশ করেন, সেটাই লক্ষ্য।
স্প্যানিশ ভাষায় লেখা? এটি স্বয়ংক্রিয়ভাবে শনাক্ত হয়ে সরাসরি মানবিক করে তোলা হয়
আর্জেন্টিনায় অনেক গবেষক ইংরেজিতে লেখার আগে আগে স্প্যানিশে খসড়া তৈরি করেন, এবং মানবাইজার সেই প্রক্রিয়াকে সরাসরি সহায়তা করে। স্প্যানিশ টেক্সট পেস্ট করুন, ProofreaderPro নিজেই ভাষাটি শনাক্ত করে, তারপর সেটিকে এমন একটি স্প্যানিশ-সচেতন মডেলের মাধ্যমে প্রসেস করে যা আপনার টার্মিনোলজি, অ্যাকসেন্ট, এবং উদ্ধৃতি (citations) ঠিক যেমন লেখা ছিল তেমনই ধরে রাখে। Through humanizador de texto de IA আপনার স্প্যানিশ খসড়াটি ইংরেজির মতোই সহজে মানবিক করা হয়, প্রথমে কিছুই অনুবাদ করতে হয় না। একই ডিটেকশন পদ্ধতি ষাটেরও বেশি ভাষায় প্রযোজ্য; প্রতিটি ভাষার লেখাকে তার নিজস্ব ভঙ্গিতেই নতুন করে লেখা হয়।
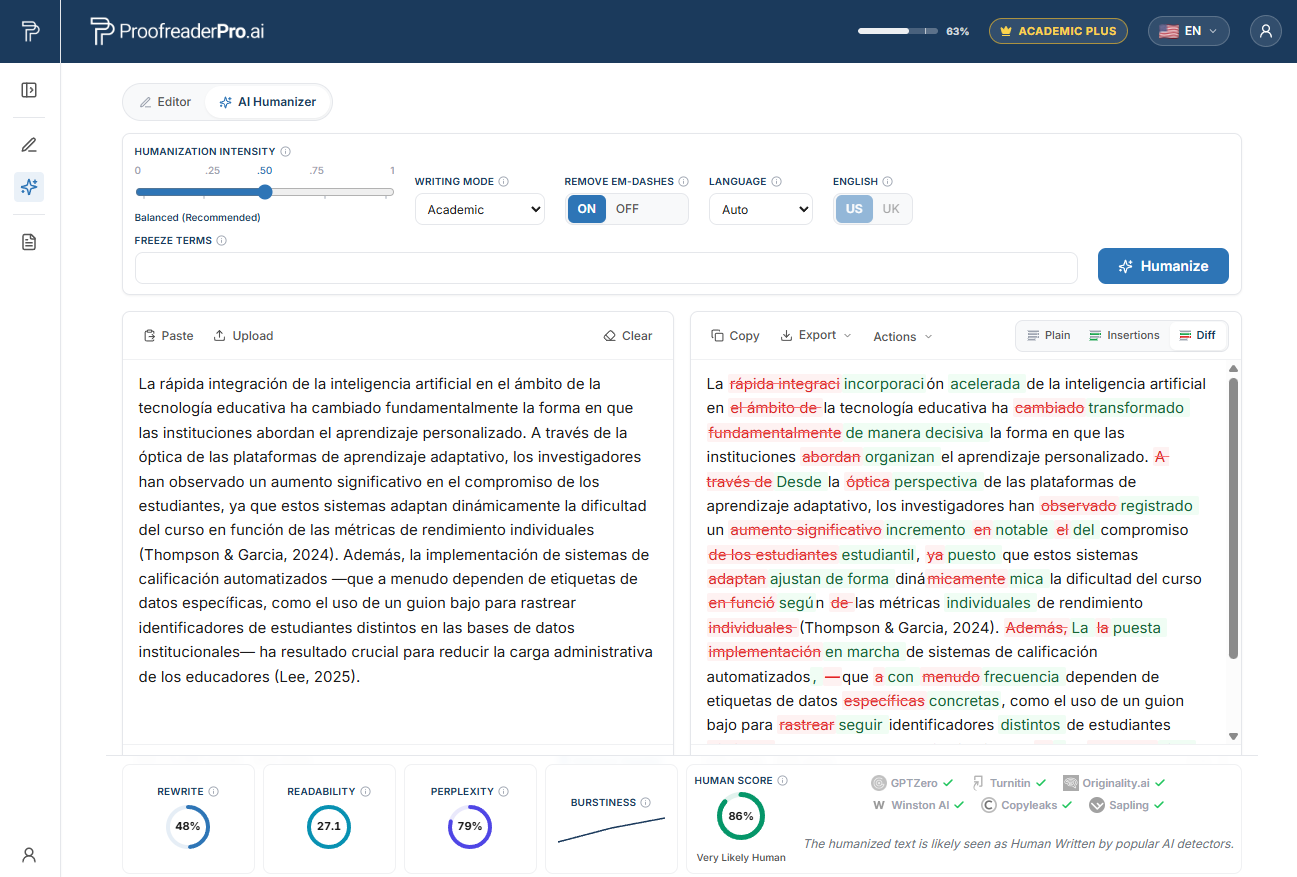
Spanish একাডেমিক টেক্সটকে মানবিক করে দিচ্ছে ProofreaderPro AI Humanizer। before-and-after diff আপনার অর্থ ও উদ্ধৃতি ধরে রাখে, এবং ডিটেক্টর চেকগুলো নিশ্চিত করে যে পাঠটি স্বাভাবিকভাবে মানুষের মতোই পড়া যায়।
কেন আর্জেন্টিনার গবেষকদের AI ডিটেক্টরে ফ্ল্যাগ করা হয়
২০২৩ সালে স্ট্যানফোর্ডের একটি দল, Liang এবং সহকর্মীদের নেতৃত্বে, Cell Press জার্নাল Patterns-এ একটি গবেষণা প্রকাশ করে, শিরোনাম: "GPT detectors are biased against non-native English writers." সেখানে তারা সাতটি বহুল ব্যবহৃত ডিটেক্টরে মানুষ-লেখা TOEFL প্রবন্ধ চালায়। গড়ে, নেটিভ লেখকদের ক্ষেত্রে যেখানে প্রায় ৫% প্রবন্ধ AI হিসেবে ফ্ল্যাগ হয়, সেখানে নন-নেটিভ লেখকদের ক্ষেত্রে সেই হার ছিল প্রায় ৬১%। প্রায় পাঁচটির মধ্যে একটিতে (one in five) নন-নেটিভ প্রবন্ধ, একই সঙ্গে প্রতিটি ডিটেক্টর দ্বারা ফ্ল্যাগ হয়। প্রতিটি প্রবন্ধই একজন মানুষ লিখেছে।
প্রক্রিয়াটি (mechanism) হলো perplexity। অনেক ডিটেক্টর হিসাব করে, কোনো ভাষার মডেলের কাছে প্রতিটি শব্দচয়েস কতটা “অপ্রত্যাশিত” (surprising)। সতর্ক দ্বিতীয়-ভাষার লেখকেরা সাধারণ শব্দে এবং মানসম্মত, পূর্বানুমেয় (predictable) বাক্যরচনায় যান; ফলে perplexity কমে, এবং সেটি মেশিন টেক্সটের মতো পড়ে। আর্জেন্টিনার একাডেমিক গদ্যকে পরিষ্কার ও নিরাপদ করে, এমন অভ্যাসগুলোই হলো সেই অভ্যাস, যা এই টুলগুলোকে বরং সন্দেহ করতে শেখানো হয়েছিল।
আমরা এ ধরনের ব্যর্থতা (failure mode) বিশদভাবে ব্যাখ্যা করেছি why AI detectors flag non-native writers প্রবন্ধে। সংক্ষেপে মূল কথা হলো: ডিটেক্টরের ফ্ল্যাগ হলো শব্দ-প্যাটার্ন বিষয়ে একটি পরিসংখ্যানভিত্তিক অনুমান, আপনার পেপার ঠিক কীভাবে লেখা হয়েছে, তার প্রমাণ নয়।
false flags-এর পেছনের স্প্যানিশ-প্রথমভাষা প্যাটার্ন
আর্জেন্টিনার দক্ষতার স্তর মানে হলো, সেই ভুলগুলো বড় কোনো ন্যক্কারজনক ত্রুটি নয়। এগুলো হলো উন্নত লেখকেরা সঠিক থাকবার জন্য যে যত্নশীল ও মানসম্মত পছন্দগুলো করেন; আর এই মানসম্মততা (standardness) ঠিক এভাবেই perplexity কমায়। নিচে এমন প্যাটার্নগুলো দেওয়া হলো, যেগুলো আর্জেন্টিনার ইংরেজিকে মেশিনের মতো সিগনেচারের দিকে ঠেলে দেয়।
সবচেয়ে নিরাপদ আর্টিকেল নিয়ম, সর্বত্র প্রযোজ্য। স্প্যানিশে নির্দিষ্ট আর্টিকেল (definite articles) বিমূর্ত বিশেষ্যের সাথে ইংরেজির তুলনায় অনেক বেশি স্বাধীনভাবে ব্যবহৃত হয় ("la investigacion demuestra que la desigualdad afecta la educacion")। আর্জেন্টিনার লেখকেরা শেখেন সাধারণ বিবৃতিতে এই আর্টিকেলগুলো বাদ দিতে, তারপর সংশোধিত নিয়মটি একভাবে (uniformly) প্রয়োগ করতে। ফল হয় এমন কিছু noun phrase, যা টেক্সটবুক-অনুমানযোগ্য এবং প্রায় কোনো বৈচিত্র্য নেই, যে ধরনের লেখাই মডেলের প্রত্যাশার সাথে মিলে যায়।
Canonical বিশেষণ-ক্রম। স্প্যানিশে বিশেষণ আসে বিশেষ্যের পরে; ইংরেজিতে বিশেষণ বসে আগে। যেসব লেখক ইংরেজির প্রচলিত রীতিটি অনুশীলন করে ফেলেছেন, তারা "un analisis estadistico multivariado robusto" কে অনুবাদ করে "a robust multivariate statistical analysis" এ পরিণত করেন, এবং পর পর বার একই ক্রম বজায় রাখেন। নির্মাণগতভাবে (construction) কঠোর সঠিকতাই (rigid correctness) কম-সারপ্রাইজড (low-surprise) প্যাটার্ন তৈরি করে।
প্রতিটি ‘ফলস ফ্রেন্ড’-এর জন্য সবচেয়ে নিরাপদ সমার্থক শব্দ। falsos amigos ("actual," "realizar," "eventualmente," "sensible," "pretender") এড়াতে সতর্ক লেখকেরা সবচেয়ে প্রচলিত ও অস্পষ্টতাহীন ইংরেজি শব্দটি বেছে নেন। একই ধরনের উচ্চ-সম্ভাব্য (highest-probability) সমার্থক শব্দ বারবার বেছে নেওয়া, লেক্সিক্যাল ভ্যারিয়েশনকে সমান করে দেয়; যে ভ্যারিয়েশন একজন ডিটেক্টর মানুষের মতো বলে পড়ে।
প্রতিবার একই ‘ডিকশনারি-সঠিক’ প্রিপোজিশন। স্প্যানিশ ট্রান্সফার যে “consist in,” “depend of,” “interested on,” এবং “different to” তৈরি করতে পারে, এ বিষয়টি শেখার পর লেখকেরা “consist of,” “depend on,” “interested in,” এবং “different from” এ স্থির হয়ে যান। সর্বদা একটিই ক্যানোনিকাল collocation, কখনও চমকে দেওয়া বিকল্প নয়।
যান্ত্রিক tense নির্বাচন। Rioplatense স্প্যানিশ সাধারণত simple past-এর ওপর ঝোঁক রাখে; তাই আর্জেন্টিনার লেখকেরা মেথডস ও রেজাল্টস সেকশনে ইংরেজির present-perfect এবং simple-past-এর নিয়মগুলো সচেতনভাবে প্রয়োগ করেন। রুল-বাউন্ড এবং ইচ্ছাকৃতভাবে ধারাবাহিক tense ব্যবহার, পাঠকে low perplexity হিসেবে পড়ায়।
সর্বোচ্চ formality। আর্জেন্টিনার একাডেমিক রেজিস্টার সাধারণত আনুষ্ঠানিকতার দিকেই যায়; ফলে লেখকেরা সবচেয়ে মানসম্মত, সবচেয়ে রক্ষণশীল (conservative) বাক্যাংশ খুঁজে নেন। সবচেয়ে নিরাপদ বাক্যটিও সবচেয়ে প্রত্যাশিত (expected) বাক্য; আর প্রত্যাশিত গদ্যই হলো সেই ধরনের পাঠ, যাকে ডিটেক্টর মেশিন-জেনারেটেড হিসেবে স্কোর করে।
আর্জেন্টিনার AI-ডিটেকশন ও Turnitin প্রসঙ্গ
আর্জেন্টিনায় থিসিস, ক্যারিয়ার-রিপোর্ট এবং জার্নাল সাবমিশনগুলো সাধারণত Turnitin বা iThenticate দিয়ে একসাথে similarity এবং AI-সূচক (AI indicators) দেখে নেওয়া হয়। CONICET মূল্যায়নের কমিটি, বিশ্ববিদ্যালয়ের টেনিউর প্রক্রিয়া, এবং আন্তর্জাতিক জার্নাল, সবাই কোনো না কোনোভাবে একই ধরনের পাইপলাইনে অবস্থান করে; ফলে একজন স্নাতক শিক্ষার্থী এবং একজন সিনিয়র গবেষকও একই ডিটেক্টরের মুখোমুখি হতে পারেন।
ভেন্ডররা তাদের টুল নিয়ে কীভাবে কথা বলে, তা জানা সাহায্য করে। Turnitin ১–১৯% রেঞ্জে AI স্কোরকে কমিয়ে (suppress) দেয়; সংখ্যার বদলে সেখানে একটি অ্যাস্টেরিক্স (asterisk) দেখায়। পাশাপাশি এটি সতর্ক করে যে ইন্টেগ্রিটি সিদ্ধান্তে (integrity decisions) কেবলমাত্র তাদের স্কোরটি একা ব্যবহার করা উচিত নয়। কিছু বিশ্ববিদ্যালয় আরও এগিয়েছে: false positives এবং নন-নেটিভ লেখকদের বিরুদ্ধে bias-এর কারণে ২০২৩ সালে Vanderbilt Turnitin-এর AI detector নিষ্ক্রিয় করে দেয়, এবং Michigan State, UT Austin, Northwestern, Pittsburgh, SMU, ও Waterloo-ও অনুরূপ পদক্ষেপ নেয়।
এই ইতিহাসের ন্যায্য পড়া হলো, ডিটেক্টরগুলো অর্থহীন নয়; বরং একটি স্কোর হলো বিতর্ক করার মতো একটি দাবি (claim to contest), রায় (verdict) নয়। একই সময়ে, ফান্ডার ও জার্নালগুলো ক্রমেই আপনাকে AI সহায়তা প্রকাশ করতে বলছে। দুটো বাস্তবতাই একই দিকে নির্দেশ করে: সতর্ক লেখাকে ভুলভাবে পড়া থেকে রক্ষা করুন, এবং যে টুলগুলো ব্যবহার করেছেন সে সম্পর্কে স্বচ্ছ থাকুন।
আপনার ইংরেজিকে ন্যায্য পাঠ দিন
নিজের AI-সহায়তাপ্রাপ্ত খসড়াকে এমনভাবে মানবিক করুন যাতে যত্নসহকারে স্প্যানিশ-প্রভাবিত লেখাকে মেশিন-লেখা হিসেবে ভুলভাবে পড়া না হয়। অর্থ, পরিভাষা এবং উদ্ধৃতি সংরক্ষিত থাকে। তারপর আত্মবিশ্বাসের সাথে প্রকাশ করুন।
Humanizer ফ্রি করে দেখুনআর্জেন্টিনার শীর্ষ বিশ্ববিদ্যালয় এবং কোথায় AI চেক দেখা যায়
আর্জেন্টিনার সরকারি বিশ্ববিদ্যালয় ব্যবস্থাটি বড় এবং স্নাতক পর্যায়ে নিখরচায়; গবেষণা কেন্দ্রীভূত থাকে জাতীয় বিশ্ববিদ্যালয় ও CONICET ইনস্টিটিউটে, যেগুলো অনেক সময় ক্যাম্পাসে পাশাপাশি অবস্থান করে। এগুলোই দেশের প্রধান গবেষণা উৎপাদক, এবং প্রতিটি প্রতিষ্ঠানই থিসিস ও ম্যানুস্ক্রিপ্টে similarity ও AI-সূচকের জন্য স্ক্রিন করে।
- Universidad de Buenos Aires (UBA), বুয়েনোস আইরেস, জাতীয় আউটপুটে আনুমানিক ৪০% নিয়ে নিঃসন্দেহে সবচেয়ে বড় উৎপাদক।
- Universidad Nacional de Cordoba (UNC), কর্ডোবা, ১৬১৩ সালে প্রতিষ্ঠিত এবং আমেরিকার অন্যতম প্রাচীন; জ্যোতির্বিজ্ঞান, পদার্থবিজ্ঞান ও রসায়নে শক্তিশালী।
- Universidad Nacional de La Plata (UNLP), লা প্লাটা, নির্ভুল ও প্রাকৃতিক বিজ্ঞানে বড় একটি কেন্দ্র, এবং কয়েকটি CONICET গবেষণা ইউনিট রয়েছে।
- Universidad Nacional de Rosario (UNR), রোজারিও, ওষুধ, বায়োকেমিস্ট্রি এবং কৃষি বিজ্ঞানে উল্লেখযোগ্য।
- Universidad Nacional del Litoral (UNL), সান্তা ফে, কেমিক্যাল ইঞ্জিনিয়ারিং, ফুড টেকনোলজি ও বায়োটেকনোলজিতে শক্তিশালী।
- Universidad Nacional de Cuyo (UNCuyo), মেন্ডোজা, পশ্চিম আর্জেন্টিনার প্রধান গবেষণা বিশ্ববিদ্যালয়।
- Universidad Tecnologica Nacional (UTN), বহু-ক্যাম্পাস, নামভর্তি (enrollment) অনুযায়ী দেশের সবচেয়ে বড়, এবং ইঞ্জিনিয়ারিং ও প্রযুক্তিতে ফোকাসড।
- Universidad Austral, বুয়েনোস আইরেস এলাকা, ওষুধ ও বায়োমেডিক্যাল ইঞ্জিনিয়ারিংয়ে শক্তিশালী একটি শীর্ষ বেসরকারি বিশ্ববিদ্যালয়।
- Universidad Nacional del Sur (UNS), বাহিয়া ব্লাঙ্কা, কেমিস্ট্রি, কেমিক্যাল ইঞ্জিনিয়ারিং এবং ভূবিজ্ঞান (geosciences)-এ শক্তিশালী।
- Universidad Nacional de San Martin (UNSAM), বুয়েনোস আইরেস প্রদেশ, বায়োটেকনোলজি ও ন্যানোটেকনোলজিতে দ্রুতগতিতে এগোচ্ছে।
- Instituto Balseiro, বারিলোচে, আর্জেন্টিনার এলিট ফিজিক্স ও নিউক্লিয়ার ইঞ্জিনিয়ারিং ইনস্টিটিউট; ছোট হলেও অসাধারণ উৎপাদনশীল।
- Instituto Tecnologico de Buenos Aires (ITBA), বুয়েনোস আইরেস, কম্পিউটার ও ডেটা সায়েন্সে শক্তিশালী একটি বেসরকারি ইঞ্জিনিয়ারিং প্রতিষ্ঠান।
এই প্রতিটি প্রতিষ্ঠানেই CONICET ক্যারিয়ার উন্নয়ন এবং ANPCyT গ্রান্ট প্রতিযোগিতা ইংরেজি ভাষায় প্রকাশনাকে পেশাগতভাবে বাধ্যতামূলক করে তোলে, অর্থাৎ, প্রতিবছর আরও বেশি ম্যানুস্ক্রিপ্ট আরও বেশি ডিটেক্টরের মধ্য দিয়ে যায়।
কীভাবে আর্জেন্টিনার গবেষকদের জন্য AI মানবাইজার কাজ করে
আর্জেন্টিনার গবেষকদের জন্য AI মানবাইজার হলো ওয়ার্কফ্লোর শেষ ধাপ, কোনো একক শর্টকাট নয়। আমরা যে ক্রমটি সুপারিশ করি তা হলো:
প্রথমে খসড়া করুন। অনেক আর্জেন্টিনার গবেষক স্প্যানিশে আরও স্বাভাবিকভাবে চিন্তা করেন; তাই স্প্যানিশে আপনার যুক্তি রূপরেখা (outline) করুন, তারপর সেটিকে ইংরেজিতে অনুবাদ করুন (আমাদের AI translator উদ্ধৃতিগুলো (citations) অক্ষুণ্ণ রাখে)। দ্বিতীয়ত, ব্যাকরণ প্রুফরিড করুন, যাতে উপরের article, preposition, এবং false-friend প্যাটার্নগুলো সত্যিই সঠিক থাকে। তৃতীয়ত, নিজের AI-সহায়তাপ্রাপ্ত গদ্যকে text humanizer দিয়ে চালান, যাতে সতর্ক, কম-perplexity লেখা ভুল করে মেশিন আউটপুট হিসেবে পড়ার সম্ভাবনা কমে।
মানবাইজার আপনার অর্থ, টেকনিক্যাল টার্মিনোলজি, এবং citations সংরক্ষণ করে। এটি ছন্দ (rhythm) ও শব্দচয়েসে ভিন্নতা আনে, পুনরাবৃত্ত ক্যাডেন্স ভেঙে দেয়, এবং AI খসড়াগুলোতে থাকা stray em dashes সরিয়ে দেয়।
পরীক্ষায় আমরা প্রতিশ্রুতিবাদী (promising) না হয়ে নির্দিষ্ট। প্রধান ডিটেক্টরগুলোর বিরুদ্ধে পরীক্ষা করে আমাদের মানবাইজার AI টেক্সটকে আরও স্বাভাবিক মানুষের মতো রূপে লেখে; এতে AI সিগনাল কমে এবং কঠিন ডিটেক্টরের বিপক্ষে আপনার সম্ভাবনা বাড়ে, তবে একাডেমিক টেক্সটে ব্যাকরণগত নির্ভুলতা উচ্চ রাখে। এগুলো পরীক্ষার ফল, নিশ্চয়তা নয়। ডিটেক্টরগুলো প্রতি কয়েক মাস অন্তর আপডেট/পুনঃপ্রশিক্ষণ (retrain) করে, তাই কোনো বিশ্বাসযোগ্য টুল “অদৃশ্য” হবে এমন প্রতিশ্রুতি দিতে পারে না।
তারপর প্রকাশ করুন। আপনার প্রতিষ্ঠান ও লক্ষ্য জার্নাল যেভাবে চায়, সেই ফরম্যাটে আপনার AI ব্যবহার উল্লেখ করুন। এই সমন্বয়, ভুল ফ্ল্যাগ থেকে সুরক্ষিত সতর্ক লেখা এবং পূর্ণাঙ্গ প্রকাশ, আপনাকে ইন্টেগ্রিটি নিয়মের ভিতরেই রাখে। আপনি যদি এটি মানব-নির্ভর (human-led) সংশোধনের সঙ্গে তুলনা করতে চান, দেখুন academic editing for Argentine researchers, আর পুরো দেশের (country cluster) জন্য ভিজিট করুন multilingual AI humanizer hub।
স্থানীয় অর্থায়ন সংস্থা, জার্নাল, এবং AI-প্রকাশ প্রত্যাশা
দুটি প্রতিষ্ঠান, যে চাপটি প্রথম থেকেই আর্জেন্টিনার গবেষকদের ডিটেক্টরের দিকে টেনে আনে, সেটা মূলত তৈরি করে। CONICET (Consejo Nacional de Investigaciones Cientificas y Tecnicas) পাঁচ স্তরের ক্যারিয়ার সিস্টেমে ১১,০০০-এর বেশি গবেষক নিয়োগ করে, এবং অগ্রগতি নির্ভর করে Scopus ও Web of Science সূচিভুক্ত জার্নালে ধারাবাহিক প্রকাশনার ওপর। ANPCyT (Agencia Nacional de Promocion de la Investigacion, el Desarrollo Tecnologico y la Innovacion) প্রতিযোগিতামূলক গ্রান্ট পরিচালনা করে, সবচেয়ে গুরুত্বপূর্ণভাবে PICT (Proyectos de Investigacion Cientifica y Tecnologica) প্রোগ্রাম, যা প্রতিটি মূল্যায়নে আন্তর্জাতিক প্রকাশনাকে বিশেষভাবে গুরুত্ব দেয়।
আর্জেন্টিনায় আরও রয়েছে একটি শক্তিশালী জার্নাল ঐতিহ্য, যার অনেকটাই SciELO Argentina-তে সূচিভুক্ত, এবং ক্রমেই Scopus ও Web of Science-এও অন্তর্ভুক্ত হচ্ছে। আর্জেন্টিনার লেখকেরা যেসব শিরোনাম খুব ভালোভাবে চেনেন, সেগুলোর মধ্যে আছে:
- Medicina (Buenos Aires), লাতিন আমেরিকার সবচেয়ে সম্মানিত মেডিকেল জার্নালগুলোর একটি; PubMed এবং Scopus-এ সূচিভুক্ত।
- Ecologia Austral, আর্জেন্টাইন ইকোলজিকাল অ্যাসোসিয়েশন থেকে প্রকাশিত।
- Latin American Applied Research, Universidad Nacional del Sur এবং CONICET-এর প্রকাশনা।
- Revista de la Union Matematica Argentina, অঞ্চলটির সবচেয়ে পুরনো গণিত জার্নালগুলোর একটি।
- Ameghiniana, paleontology এবং geological sciences-এ।
- Electronic Journal of Biotechnology, লাতিন আমেরিকান ফোকাসসহ।
যেহেতু এই জার্নালগুলো Scopus সূচিকরণ চায় বা বজায় রাখে, তারা ক্রমেই ইংরেজিকে অগ্রাধিকার দেয়; এবং তাদের আন্তর্জাতিক সমকক্ষদের মতোই, ক্রমেই AI সহায়তা সম্পর্কে একটি বিবৃতি (statement) চায়। প্রকাশনাটি সোজাসাপ্টা লিখুন, টুলগুলোর নাম দিন, এবং সেগুলো কী করেছে তা বর্ণনা করুন। আপনার যত্ন থাকা সত্ত্বেও কোনো ডিটেক্টর যদি সত্যিকারের কাজে ফ্ল্যাগ বসায়, তাহলে appeal a false AI-detection flag প্লেবুকটি প্রমাণ সংগ্রহের প্রক্রিয়া এবং কমিটির সাথে কী ধরনের ভঙ্গিতে কথা বলতে হবে, সবই দেখায়।
Frequently asked questions
Q: Does the AI humanizer for Argentine researchers help me cheat Turnitin?
না। এটি আপনার নিজের AI-সহায়তাপ্রাপ্ত খসড়ার জন্য, এবং কাজ হলো সতর্ক দ্বিতীয়-ভাষার ইংরেজিকে মেশিন টেক্সট হিসেবে ভুলভাবে পড়া থেকে রক্ষা করা। আপনি অর্থ ও citations ধরে রাখবেন, এবং আপনার AI ব্যবহার প্রতিষ্ঠান ও জার্নালে এখনও প্রকাশ করবেন। বাস্তব কাজকে ভুল ফ্ল্যাগ থেকে রক্ষা করা মানেই সেটাকে ছদ্মবেশে ঢেকে ফেলা নয়।
Q: Will humanizing change my meaning, my technical terms, or my citations?
না। মানবাইজার আপনার অর্থ, টেকনিক্যাল টার্মিনোলজি, এবং রেফারেন্সগুলো সংরক্ষণ করে; একই সঙ্গে এটি ছন্দ (rhythm) ও শব্দচয়েসে ভিন্নতা আনে। ডিটেক্টরকে বিভ্রান্ত করে এমন পরিসংখ্যানগত প্যাটার্নগুলো মসৃণ করার জন্য এটি তৈরি, আপনার বিজ্ঞানকে নতুন করে লেখার জন্য নয়, কিংবা আপনার citations সরিয়ে দেওয়ার জন্যও নয়।
Q: How well does it actually pass AI detectors?
প্রধান ডিটেক্টরগুলোর বিরুদ্ধে পরীক্ষা করা হয়েছে; এটি AI টেক্সটকে আরও স্বাভাবিক মানুষের মতো রূপে লেখে, ফলে AI সিগনাল কমে এবং কঠিন ডিটেক্টরের বিপক্ষে সম্ভাবনা বাড়ে, এবং ব্যাকরণগত নির্ভুলতা উচ্চ রাখে। এগুলো টেস্টিং ফল, নিশ্চয়তা নয়। ডিটেক্টরগুলো প্রায়ই আপডেট হয়, তাই কোনো গুরুতর টুলই প্রতিশ্রুতি দিতে পারে না যে আপনাকে কখনও ফ্ল্যাগ করা হবে না।
Q: My English is already strong. Why would a detector flag me?
শক্তিশালী, মানসম্মত ইংরেজি সমস্যার অংশ। ডিটেক্টরগুলো perplexity স্কোর করে, এবং সতর্ক, পূর্বানুমেয়, টেক্সটবুক-সঠিক বাক্যরচনা low perplexity হিসেবে ধরা পড়ে, যেটাকে তারা মেশিন লেখা হিসেবে সম্পর্কিত করে। আর্জেন্টিনার উচ্চ দক্ষতা আপনার গদ্যকে আরও বেশি একরকম (uniform) করে তুলতে পারে, কম নয়, ফলে ফ্ল্যাগ হওয়ার সম্ভাবনা কমে না।
Q: Should I still disclose AI use if I humanize my draft?
হ্যাঁ, সবসময়। প্রকাশ (disclosure) এবং মানবাইজিং দুইটি আলাদা সমস্যা সমাধান করে। মানবাইজিং সতর্ক লেখাকে ভুলভাবে পড়া থেকে রক্ষা করে, এবং প্রকাশ আপনাকে আপনার ফান্ডার, কমিটি, ও জার্নালের কাছে দায়বদ্ধ রাখে। দুটোই করুন, প্রতিবার।
ইংরেজিতে প্রকাশের জন্য আর্জেন্টিনার গবেষকদের উদ্দেশ্যে: আপনার নিজের AI-সহায়তাপ্রাপ্ত কাজে ভুল AI ফ্ল্যাগ কমান, অর্থ, পরিভাষা এবং উদ্ধৃতি অক্ষুণ্ণ রেখে, তারপর আত্মবিশ্বাসের সাথে প্রকাশ করুন।

Moe একজন NLP ইঞ্জিনিয়ার একজন PhD সহ প্রাকৃতিক ভাষা প্রক্রিয়াকরণে। তার গবেষণা কম্পিউটেশনাল ভাষাতত্ত্ব, পাঠ্য বিশ্লেষণ এবং মেশিন লার্নিংকে কভার করে এবং এটি সরাসরি ProofreaderPro-এর পিছনে সম্পাদনা এবং মানবীকরণ মডেলগুলিতে যোগ করে। তিনি প্রক্রিয়াটির অংশ সম্পর্কে লিখেছেন যা বেশিরভাগ লোকেরা কখনই দেখে না: কীভাবে একটি ভাষা মডেল একটি বাক্য পড়ে, স্কোর করে এবং কী পরিবর্তন করতে হবে তা সিদ্ধান্ত নেয়।


