
ইংরেজিতে লিখছেন ইতালীয় গবেষকদের জন্য AI হিউম্যানাইজার
ইতালীয় গবেষকদের জন্য AI হিউম্যানাইজার। ইতালীয়-প্রভাবিত ইংরেজিতে যেন ভুল করে AI শনাক্তকরণের (false AI-detection) ফ্ল্যাগ কমে, অর্থ ও উদ্ধৃতি অক্ষুণ্ণ রেখে, এবং নিজের AI ব্যবহারটি সৎভাবে প্রকাশ করুন।

ইতালি বিশ্বের শীর্ষ আট থেকে দশটি দেশের মধ্যে গবেষণা উৎপাদনের দিক থেকে অবস্থান করলেও, সেই কাজের প্রায় কিছুই পাঠকদের কাছে ইতালীয় ভাষায় পৌঁছায় না। এখানে শিক্ষাবিদেরা এক ভাষায় খসড়া লেখেন ও ভাবেন, আর অন্য ভাষায় প্রকাশ করেন, কারণ একটি ইতালীয় গবেষণা-কেরিয়ার নির্ভর করে ইনডেক্সড ইংরেজি-ভাষার জার্নালগুলোর উপর। VQR গবেষণার গুণগত মান মূল্যায়ন এবং অধ্যাপক পদে জাতীয় যোগ্যতা–সংক্রান্ত ASN, দুটিই Scopus এবং Web of Science-এ থাকা গ্রন্থপঞ্জিগত (bibliometric) সীমারেখার ওপর ঝুঁকে আছে; ফলে সঠিক জার্নালে একটি ইংরেজি প্রবন্ধ প্রকাশ করা ঐচ্ছিক নয়।
এখন এই চাপ নতুন এক সমস্যার সঙ্গে সংঘর্ষে এসেছে। ইতালীয় গবেষকদের জন্য একটি AI হিউম্যানাইজার আছে, কারণ যথাযথ, ভুলহীন দ্বিতীয়-ভাষার ইংরেজি ঠিক সেই ধরনের গদ্য, যাকে AI ডিটেক্টররা মেশিন লেখা হিসেবে ভুল করে। আপনার সহকর্মীই কাজটা করেছেন, প্রতিটি শব্দ লিখেছেন, তারপরও ফ্ল্যাগ পড়েছে।
এই গাইডটি ছদ্মবেশের জন্য নয়; এটি ন্যায্যতার জন্য। লক্ষ্য হলো আপনার নিজস্ব AI-সহায়ক খসড়াটিকে “মানুষের মতো” করে তোলা, যাতে অর্থ ও উদ্ধৃতি অক্ষুণ্ণ থাকে, এবং এরপর আপনার প্রতিষ্ঠান ও জার্নাল যেভাবে দাবি করে সেভাবে আপনার AI ব্যবহারটি সৎভাবে প্রকাশ করা।
ইংরেজিতে প্রকাশ করেন এমন ইতালীয় গবেষকদের জন্য একটি IA টেক্সট হিউম্যানাইজার
আমাদের AI টেক্সট হিউম্যানাইজার ইতালীয় গবেষকদের ইংরেজিতে এমনভাবে প্রকাশ করতে সহায়তা করে যাতে সঠিক লেখাকে মেশিন-উৎপাদিত লেখার সাথে গুলিয়ে না ফেলা হয়। এটি অর্থ, কারিগরি পরিভাষা এবং উদ্ধৃতি সংরক্ষণ করে, একই সঙ্গে ছন্দ ও শব্দচয়নে বৈচিত্র্য আনে।
সহজ ভাষায়: আপনি বিজ্ঞানটা লিখবেন, আর টুলটি পরিসংখ্যানগত “ফিঙ্গারপ্রিন্ট”টা মসৃণ করবে, যে ফিঙ্গারপ্রিন্ট সাধারণ অ-নেটিভ লেখাকে কৃত্রিম (synthetic) বলে মনে করায়। আপনার যুক্তি, আপনার তথ্য বা আপনার রেফারেন্স, কিছুই বদলায় না। বদলায় কেবল সেই সমান, পূর্বানুমেয় ক্যাডেন্স, যাকে কিছু ডিটেক্টর মেশিনের স্বাক্ষর হিসেবে ধরে।
ইতালীয় ভাষায় খসড়া করেন? হিউম্যানাইজার সেটি সরাসরি শনাক্ত করে আবার লেখে
আপনি প্রথমে সেটি ইংরেজিতে অনুবাদ না করেও একটি ইতালীয় খসড়াকে হিউম্যানাইজ করতে পারেন। আপনার লেখা পেস্ট করুন, ProofreaderPro ভাষাটি স্বয়ংক্রিয়ভাবে শনাক্ত করে, তারপর এটিকে ইতালীয়-সচেতন একটি মডেলের মাধ্যমে চালায়, উচ্চারণচিহ্ন (accents), পরিভাষা এবং উদ্ধৃতি ঠিক জায়গাতেই থাকে। একটি umanizzatore di testo IA হিসেবে এটি আপনার ইতালীয় গদ্যের ছন্দ বদলায়, কিন্তু প্রতিটি ফলাফল ও রেফারেন্স সংরক্ষণ করে। স্বয়ংক্রিয় শনাক্তকরণ ষাটেরও বেশি ভাষা জুড়ে পৌঁছায়, তাই ইতালীয়কে ইংরেজিতে “রিশেপ” না করে ইতালীয় হিসেবেই ধরা হয়।
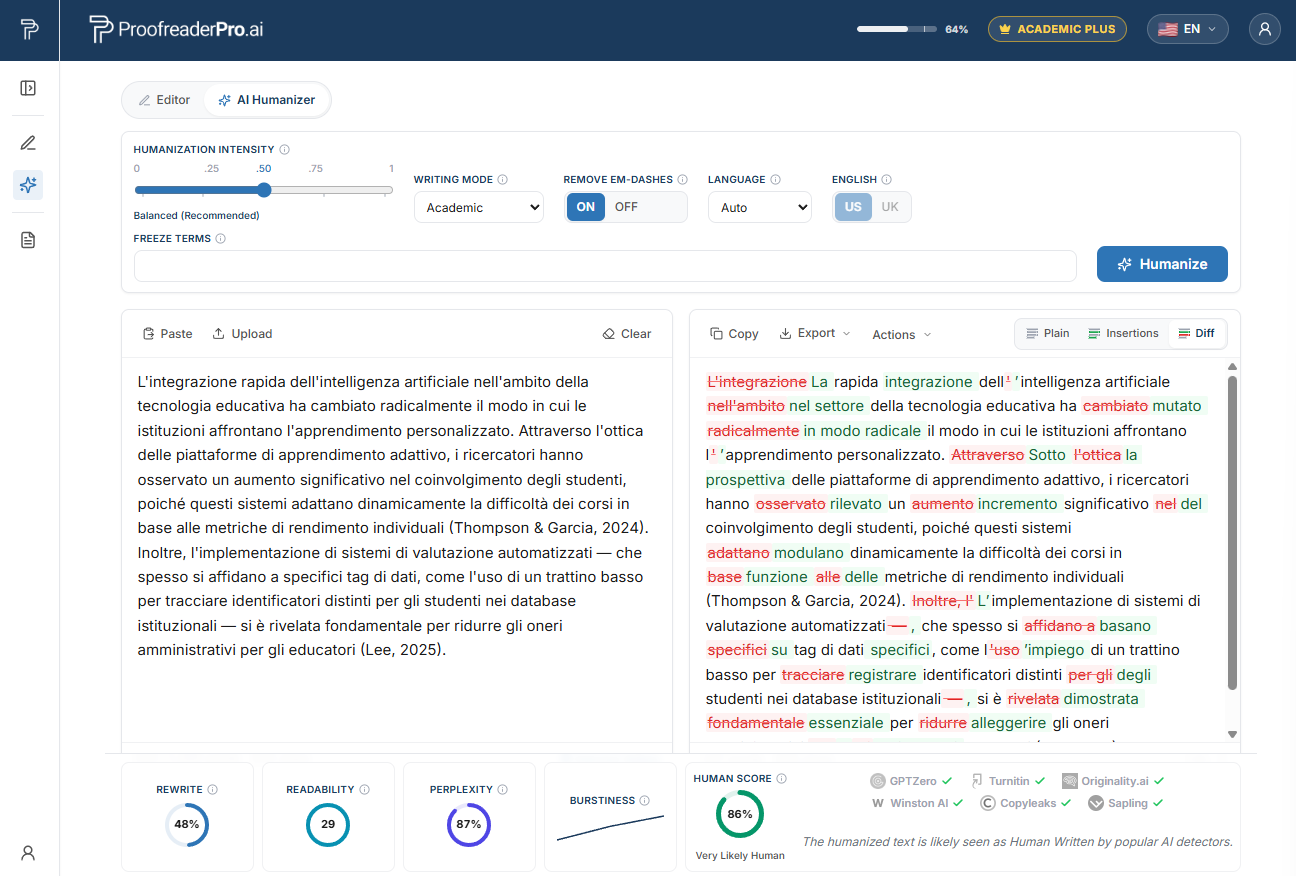
ইতালীয় একাডেমিক টেক্সটকে পুনর্লিখন করছে ProofreaderPro AI Humanizer। আগে-পরের ডিফ আপনার অর্থ ও উদ্ধৃতি ধরে রাখে, আর ডিটেক্টর চেকগুলো নিশ্চিত করে যে পড়াটা স্বাভাবিকভাবে মানুষের মতো।
কেন ইতালীয় গবেষকদের AI ডিটেক্টররা ফ্ল্যাগ করে
২০২৩ সালে Liang এবং সহকর্মীদের নেতৃত্বাধীন এক Stanford টিম Cell Press জার্নাল Patterns-এ একটি সরাসরি শিরোনামের গবেষণা প্রকাশ করে: GPT detectors are biased against non-native English writers। তারা মানব-লিখিত TOEFL প্রবন্ধগুলোকে সাতটি বহুল ব্যবহৃত ডিটেক্টরের মধ্য দিয়ে চালায়।
ফলটি দ্বিতীয় ভাষায় প্রকাশ করছেন, এমন যে কারও জন্যই চিন্তার বিষয়। গড়ে, অ-নেটিভ প্রবন্ধগুলোর প্রায় ৬১% AI হিসেবে ফ্ল্যাগ হয়েছিল; আর নেটিভ লেখকদের জন্য তা ছিল প্রায় ৫%। প্রায় পাঁচজনের মধ্যে একজন নয়, প্রায় ১৯.৮% (প্রায় এক-পঞ্চমাংশ) সব ডিটেক্টর একইভাবে একমত হয়ে ফ্ল্যাগ করেছে। ওই প্রতিটি প্রবন্ধই ছিল একজন মানুষের লেখা।
এখানে প্রক্রিয়াটির নাম হলো perplexity। ডিটেক্টররা হিসাব করে প্রতিটি শব্দচয়েস ভাষা-মডেলের কাছে কতটা “অপ্রত্যাশিত”। সতর্ক দ্বিতীয়-ভাষার লেখকরা সাধারণ শব্দ এবং স্ট্যান্ডার্ড, পূর্বানুমেয় বাক্যগঠন বেছে নেন, ফলে perplexity কমে, আর সেটি মেশিন-লেখার মতো পড়ে। যে অভ্যাসগুলো আপনার ইংরেজিকে পরিষ্কার করে, ঠিক সেই অভ্যাসগুলোই এই টুলগুলো শাস্তি দিতে শেখানো। আমরা আরও বিশদে আলোচনা করেছি why AI detectors flag non-native writing অংশে।
ভুল ফ্ল্যাগের পেছনের “ইতালীয় প্রথম-ভাষা” ধরণসমূহ
নিচের কোনো প্যাটার্নই কোনো ভুল নয়। এগুলো হলো সেই যত্নশীল, পাঠ্যবই-ধাঁচের নির্মাণ, যেগুলোর দিকে একজন ইতালীয় গবেষক সাধারণত ঝোঁকেন, এবং সেই অত্যন্ত নিয়মিতত্বই হলো এমন একটি কারণ, যেটাকে ডিটেক্টর কম perplexity হিসেবে পড়ে।
দীর্ঘ hypotactic বাক্য। ইতালীয় একাডেমিক রীতি দীর্ঘ পিরিয়ডকে পছন্দ করে, যেখানে কয়েকটি নেস্টেড (nested) subordinate clause থাকে। ইংরেজিতে অনুবাদ করলে বাক্যগুলো ব্যাকরণগতভাবে ঠিকই থাকে, কিন্তু ঘন হয়ে যায়; তাদের সমান, অতিরিক্ত যোগ্যতাসম্পন্ন (over-qualified) ছন্দ মডেলের কাছে পূর্বানুমেয় মনে হয়।
অ্যাবস্ট্রাক্ট noun-এর সঙ্গে আর্টিকেল। nature, the science, বা the society লেখা, যেখানে ইংরেজিতে সাধারণত আর্টিকেল বাদ পড়ে, এটি ইতালীয় থেকে ইংরেজিতে সরাসরি ও ধারাবাহিকভাবে স্থানান্তরের (transfer) মতো। এই ধারাবাহিকতাই হলো সেই সংকেত, যেটাকে ডিটেক্টররা কম স্কোর দেওয়ার ক্ষেত্রে “পুরস্কৃত” করে।
প্রীপজিশন ট্রান্সফার। dipendere da থেকে depend from, বা based on-এর স্থানে on the basis of, এগুলো নিয়মতান্ত্রিক (rule-governed) ও পদ্ধতিগত পছন্দ। পদ্ধতিগত পছন্দগুলো, সংজ্ঞা অনুযায়ী, কম perplexity তৈরি করে।
নোমিনালাইজেশন এবং ল্যাটিন-ঘরানার শব্দচয়েস। realization of the analysis-এর মতো ভারী noun phrase, এবং ল্যাটিন-ধাঁচের শব্দভান্ডারের প্রতি ধারাবাহিক ঝোঁক, এসবই মানক আনুষ্ঠানিক রেজিস্টারের অংশ। আনুষ্ঠানিক ও মানক, ঠিক এই জিনিসগুলোকেই এই টুলগুলো ফ্ল্যাগ করে।
Calqued connectors। Moreover, Furthermore, এবং In fact, বাক্যের শুরুতে এগুলোর ঘন ঘন ব্যবহার, যেগুলো ইতালীয় discourse marker থেকে প্রতিফলিত হয়ে আসে, একটি নিয়মিত, পুনরাবৃত্তিমূলক ক্যাডেন্স তৈরি করে, যা মেশিনের মতো মসৃণ (machine-smooth) বলে পড়ে।
False friends। Attualmente-কে actually-এর দিকে ঠেলে দেওয়া, বা eventualmente-কে eventually-এর দিকে ঠেলে দেওয়া, সম্ভবত বা currently নয়, সতর্ক লেখকরা যে ধরনের সংশোধন করেন, সেটিই সবচেয়ে “মানক-দেখতে” (standard-looking) শব্দের দিকে নিয়ে যায়। সবচেয়ে মানক শব্দটিই আবার সাধারণত সবচেয়ে কম অপ্রত্যাশিত।
ইতালির AI-ডিটেকশন ও Turnitin প্রসঙ্গ
ইতালীয় থিসিস ও ম্যানুস্ক্রিপ্টগুলো সাধারণত পাঠ্যগত সাদৃশ্য (textual similarity) যাচাইয়ের মধ্য দিয়ে যায়, বেশিরভাগ সময় Turnitin বা iThenticate দিয়ে। এসব টুল ক্রমেই পরিচিত similarity score-এর পাশাপাশি AI-ইন্ডিকেটরও সামনে আনে। একটি similarity রিপোর্ট করা ডক্টরাল স্কুল ও সম্পাদকীয় ওয়ার্কফ্লোতে স্বাভাবিক চর্চা, এবং একা এটি আপনার সততা সম্পর্কে কিছু বলে না।
দুটি বিষয় দৃষ্টির মধ্যে রাখা মূল্যবান। প্রথমত, একটি AI ইন্ডিকেটর হলো একটি দাবি (claim), চূড়ান্ত রায় (verdict) নয়। Turnitin নিজেই ১ থেকে ১৯% সীমার মধ্যে স্কোর দমন করে এবং সতর্ক করে যে, এর সংখ্যাটি একা আপনার সততার ঘটনায় সিদ্ধান্ত নির্ধারণ করা উচিত নয়। Vanderbilt, Michigan State, এবং UT Austinসহ বেশ কয়েকটি বিশ্ববিদ্যালয় AI ডিটেক্টর পুরোপুরি নিষ্ক্রিয় করেছে, false positives এবং অ-নেটিভ লেখকদের বিরুদ্ধে পক্ষপাতের কথা উল্লেখ করে।
দ্বিতীয়ত, ইতালিতে, যেমন অন্য জায়গাতেও, যে দিকেই গতি, তা হলো প্রকাশ (disclosure)-এর দিকে। ফান্ডার ও জার্নাল ক্রমেই আপনাকে জিজ্ঞেস করে: আপনি কোথায় এবং কীভাবে AI ব্যবহার করেছেন তা উল্লেখ করতে। এই প্রত্যাশাটাই হলো আপনার সুরক্ষা: spotless detector score নয়, বরং পূর্ণ প্রকাশই আপনাকে নিয়মের ভেতরে রাখে।
আপনার নিজের লেখাকে ভুয়া সতর্কতা থেকে সুরক্ষিত করুন
কয়েক মিনিটে আপনার AI সহায়তায় তৈরি খসড়াটিকে মানবিক করুন, প্রতিটি উদ্ধৃতি রেখে দিন, এরপর প্রকাশ করুন। যত্নশীল non-native একাডেমিক ইংরেজির জন্য তৈরি।
Humanizer ফ্রি করে দেখুনশীর্ষ ইতালীয় বিশ্ববিদ্যালয়গুলো এবং সেখানে AI চেক কোথায় দেখা যায়
উপরোক্ত স্ক্রিনিংটি ইতালির প্রধান প্রতিষ্ঠানগুলো জুড়েই ঘটে। এই বিশ্ববিদ্যালয়গুলোর ডক্টরাল স্কুল ও সম্পাদকীয় অফিসগুলো থিসিস ও ম্যানুস্ক্রিপ্টকে similarity checks-এর মধ্য দিয়ে চালায়, এবং ক্রমবর্ধমানভাবে AI ইন্ডিকেটরও বিবেচনায় নেয়:
- Sapienza Università di Roma, in Rome
- Università di Bologna (Alma Mater Studiorum), in Bologna
- Politecnico di Milano and Università degli Studi di Milano (Statale), in Milan
- Università degli Studi di Padova, in Padua
- Università degli Studi di Napoli Federico II, in Naples
- Politecnico di Torino and Università degli Studi di Torino, in Turin
- Università di Pisa, Scuola Normale Superiore, and Scuola Superiore Sant'Anna, in Pisa
- Università degli Studi di Firenze, in Florence
- Università degli Studi di Trento, in Trento
- Università Cattolica del Sacro Cuore, in Milan
এর প্রত্যেকটির ক্ষেত্রে, কোনো ফ্ল্যাগ মানে হলো আপনার পদ্ধতি (methods) নিয়ে আলোচনা শুরুর সংকেত, আপনার সততা সম্পর্কে চূড়ান্ত সিদ্ধান্ত নয়। এই চেকগুলো নিয়মিত, এটা জানাই আতঙ্কের কারণ নয়; প্রস্তুতির কারণ।
ইতালীয় গবেষকদের জন্য AI হিউম্যানাইজার কীভাবে কাজ করে
এখানে ওয়ার্কফ্লোটি আছে, এবং তার ক্রম গুরুত্বপূর্ণ।
প্রথমে, আপনার যুক্তি (argument) খসড়া করুন। আপনি যদি ভাবনাগুলো সবচেয়ে তীক্ষ্ণভাবে তৈরি করেন সেই ভাষায়, তাহলে ইতালীয় ভাষায় লিখুন, তারপর অনুবাদ করুন; অথবা সরাসরি ইংরেজিতে খসড়া করুন। যেভাবেই হোক, আইডিয়া ও ডেটা দুটোই আপনার।
দ্বিতীয়ত, ব্যাকরণ ঠিক করুন। ভুল বন্ধুবন্ধু (false friends), প্রিপজিশন, এবং আর্টিকেলের স্খলন (article slips) সংশোধন করুন, যাতে কোনো কিছুর আগে ভাষাটি পরিষ্কার থাকে। আমাদের proofreading টুলগুলো এই কাজের জন্যই তৈরি, এবং আপনি AI proofreading for Italian academics অংশে একই ধরনের sibling workflow দেখতে পারবেন।
তৃতীয়ত, আপনার নিজের গদ্যকে হিউম্যানাইজ করুন। আপনার AI-সহায়ক খসড়াটিকে AI text humanizer–এ চালান। এটি ছন্দ ও শব্দচয়েসের বৈচিত্র্য আনে, এবং পুনরাবৃত্তিমূলক, কম-perplexity ক্যাডেন্স সরিয়ে দেয়, যা সাধারণত ডিটেক্টরদের বাধা দেয়। একই সঙ্গে এটি আপনার অর্থ, কারিগরি পরিভাষা এবং উদ্ধৃতি সংরক্ষণ করে।
হিউম্যানাইজারটি প্রধান ডিটেক্টরগুলোর বিরুদ্ধে পরীক্ষা করা হয়েছে, এবং এটি AI টেক্সটকে আরও স্বাভাবিক মানুষের মতো আকারে পুনর্গঠন করে, যাতে Turnitin, Originality.ai এবং GPTZero-তে তা মানুষের লেখা হিসেবে বেশি পাঠযোগ্য হয়, এবং একাডেমিক টেক্সটে ব্যাকরণগত নির্ভুলতাও উচ্চ থাকে। ফলাফলগুলো প্রতিশ্রুতি নয়; পরীক্ষার ফল। আমরা কোনো কিছু এড়িয়ে যাওয়ার (bypass) প্রতিশ্রুতি দিই না, কারণ ডিটেক্টরগুলো প্রতি কয়েক মাসে পুনরায় প্রশিক্ষিত হয়।
চতুর্থত, প্রকাশ করুন। আপনার AI ব্যবহারটি আপনার প্রতিষ্ঠান ও লক্ষ্য জার্নাল যেভাবে চায় সেই ফরম্যাটে উল্লেখ করুন। এই শেষ ধাপটাই বাস্তব কাজের ন্যায্য সুরক্ষা (fair protection) আর ছদ্মবেশের মধ্যে পার্থক্য তৈরি করে।
এই পোস্টটি আমাদের multilingual AI humanizer hub-এর একটি অংশ, যেখানে অন্যান্য প্রথম ভাষা থেকে লিখছেন এমন গবেষকদের জন্যও একই ওয়ার্কফ্লো কভার করা হয়েছে। আপনার বড় প্রয়োজন যদি “ডিটেক্টর ফেয়ারনেস” না হয়ে সম্পূর্ণ ভাষা সম্পাদনা (full language editing) হয়, তাহলে শুরু করুন আমাদের global academic editing hub থেকে।
স্থানীয় ফান্ডিং সংস্থা, জার্নাল, এবং AI-বিষয়ক প্রকাশের প্রত্যাশা
ইতালীয় গবেষণা অর্থায়ন ও মূল্যায়ন কয়েকটি প্রতিষ্ঠানের মাধ্যমে পরিচালিত হয়, আর প্রতিটি প্রতিষ্ঠানই আপনার কাজটি কোথায় প্রকাশিত হয়, সে ক্ষেত্রে দায়/ঝুঁকি (stakes) বাড়িয়ে দেয়।
MUR (Ministero dell'Università e della Ricerca) বিশ্ববিদ্যালয় ও জাতীয় গ্রান্ট ফান্ড করে। PRIN (Progetti di Ricerca di Rilevante Interesse Nazionale) হলো প্রধান প্রতিযোগিতামূলক জাতীয় কর্মসূচি। CNR (Consiglio Nazionale delle Ricerche) হলো দেশের বৃহত্তম সরকারি গবেষণা সংস্থা। ANVUR VQR মূল্যায়ন এবং ASN যোগ্যতা, দুটিই পরিচালনা করে, এবং এটি মানবিক ও সামাজিক বিজ্ঞানে বাস্তব গুরুত্ব বহনকারী class-A জার্নালের তালিকাও বজায় রাখে।
স্থাপনের (placement) ক্ষেত্রে এর অর্থ দাঁড়ায় Scopus এবং Web of Science-এ ইনডেক্সিং, এবং non-bibliometric ক্ষেত্রগুলোতে ANVUR-এর class-A স্ট্যাটাস। এসব জার্নালে যেসব ম্যানুস্ক্রিপ্ট যাবে সেগুলো Turnitin বা iThenticate দিয়ে স্ক্রিন করা হয়, এবং ক্রমবর্ধমানসংখ্যক জার্নাল ও ফান্ডার স্পষ্ট AI-use স্টেটমেন্ট চাইছে। সেই স্টেটমেন্টটি আগে থেকেই প্রস্তুত করুন। কোনো ডিটেক্টর যদি কখনও পরিচ্ছন্ন কাজকেও ফ্ল্যাগ করে, তাহলে রিপোর্টটিকে রায় হিসেবে নয়, বরং বিতর্কযোগ্য প্রমাণ (contestable evidence) হিসেবে বিবেচনা করুন। সাবমিশনের আগে AI text humanizer–এর মাধ্যমে একটি চূড়ান্ত পাস দিলে সতর্ক অ-নেটিভ লেখাকে আরও ন্যায্য পড়া (fairer reading) পাওয়ার সুযোগ দেয়, এবং আপনার প্রকাশ পুরো প্রক্রিয়াটিকে স্বচ্ছ রাখে।
প্রায়শই জিজ্ঞাসিত প্রশ্নাবলি
প্রশ্ন: ইতালীয় গবেষকদের জন্য AI হিউম্যানাইজার ব্যবহার করা কি এক ধরনের চিটিং?
না, যদি আপনি এটি আপনার নিজের কাজে ব্যবহার করেন। আপনি গবেষণাটা লিখেছেন; টুলটি শুধু সতর্ক অ-নেটিভ গদ্যের ছন্দ এবং শব্দচয়েস বদলায়, যাতে তা মেশিন-লেখা হিসেবে ভুল পড়ার সম্ভাবনা কমে। এটি স্বচ্ছ রাখার যে নিয়মটি, তা হলো প্রকাশ (disclosure): আপনি আপনার প্রতিষ্ঠান ও জার্নালকে জানাবেন কীভাবে আপনি AI ব্যবহার করেছেন।
প্রশ্ন: হিউম্যানাইজার কি আমার উদ্ধৃতি বা কারিগরি টার্ম পরিবর্তন করবে?
না। এটি আপনার রেফারেন্স, আপনার ডেটা, এবং আপনার ডিসিপ্লিনের পরিভাষা সংরক্ষণ করে। এটি ডিটেক্টরদের প্রতিক্রিয়া তৈরির জন্য যে কম-perplexity ক্যাডেন্স, সেটিকেই লক্ষ্য করে; আপনার যুক্তির মূল বিষয়বস্তু বদলায় না।
প্রশ্ন: আপনি কি গ্যারান্টি দিতে পারবেন যে আমার প্রবন্ধ Turnitin বা GPTZero পাস করবে?
না, আর এমন কোনো টুলকে নিয়েও সতর্ক থাকুন যেটি এটি প্রতিশ্রুতি দেয়। আমাদের পরীক্ষায় হিউম্যানাইজার AI টেক্সটকে আরও স্বাভাবিক মানুষের মতো আকারে রূপান্তর করে, যাতে AI সিগন্যাল কমে এবং কঠিন ডিটেক্টরদের বিপক্ষে আপনার সম্ভাবনা বাড়তে পারে। তবে ডিটেক্টরগুলো ক্রমাগত পুনঃপ্রশিক্ষিত হয়, তাই আমরা গ্যারান্টির বদলে পরীক্ষিত ফলাফল জানাই।
প্রশ্ন: আমার সঠিক ইংরেজিও কেন একেবারে ফ্ল্যাগ হয়?
কারণ ডিটেক্টররা আপনার শব্দচয়েস কতটা পূর্বানুমেয়, সেটাই স্কোর করে। আর্টিকেলের ব্যবহার থেকে শুরু করে ল্যাটিন-ধাঁচের শব্দচয়েস, ইতালীয় থেকে ইংরেজিতে আসা মানক, পাঠ্যবই-ধাঁচের নির্মাণগুলো অত্যন্ত পূর্বানুমেয়; ফলে তা কম perplexity হিসেবে পড়ে, আর কিছু টুল এটিকে AI-এর লক্ষণ হিসেবে ধরে। এটি সতর্ক দ্বিতীয়-ভাষার লেখার বিরুদ্ধে একটি নথিভুক্ত পক্ষপাত (documented bias), আপনার কাজ নিয়ে কোনো বিচার নয়।
প্রশ্ন: কোনো কমিটি বা জার্নাল যদি আমার লেখা ফ্ল্যাগ করে, আমার কী করা উচিত?
শান্ত থাকুন এবং ফ্ল্যাগটিকে এমন একটি দাবি হিসেবে ধরুন, যার উত্তরে আপনি ব্যাখ্যা দেবেন; একে চূড়ান্ত রায় (verdict) মনে করবেন না। আপনার খসড়া ও নোট রাখুন, অ-নেটিভ লেখকদের বিরুদ্ধে নথিভুক্ত পক্ষপাতের দিকে ইঙ্গিত করুন, এবং আপনার AI-use disclosure শেয়ার করুন। একটি ডিটেক্টর স্কোর হলো বিতর্কযোগ্য প্রমাণ, কখনওই চূড়ান্ত প্রমাণ নয়।
আপনার যত্নশীল non-native ইংরেজিকে আরও ন্যায্যভাবে পড়া হোক। অর্থ এবং উদ্ধৃতি সংরক্ষণ করুন, ভুয়া AI সতর্কতা কমান, তারপর আত্মবিশ্বাসের সঙ্গে প্রকাশ করুন।

Moe একজন NLP ইঞ্জিনিয়ার একজন PhD সহ প্রাকৃতিক ভাষা প্রক্রিয়াকরণে। তার গবেষণা কম্পিউটেশনাল ভাষাতত্ত্ব, পাঠ্য বিশ্লেষণ এবং মেশিন লার্নিংকে কভার করে এবং এটি সরাসরি ProofreaderPro-এর পিছনে সম্পাদনা এবং মানবীকরণ মডেলগুলিতে যোগ করে। তিনি প্রক্রিয়াটির অংশ সম্পর্কে লিখেছেন যা বেশিরভাগ লোকেরা কখনই দেখে না: কীভাবে একটি ভাষা মডেল একটি বাক্য পড়ে, স্কোর করে এবং কী পরিবর্তন করতে হবে তা সিদ্ধান্ত নেয়।


