
ইংরেজিতে লেখায় সহায়তার জন্য কলোম্বীয় গবেষকদের AI Humanizer
কলোম্বীয় গবেষকদের জন্য AI humanizer। স্প্যানিশের প্রভাবযুক্ত ইংরেজিতে ভুলভাবে AI-ডিটেকশন ফ্ল্যাগ পড়া কমান, অর্থ ও উদ্ধৃতি বজায় রাখুন, এবং সৎভাবে AI ব্যবহারের কথা জানান।

কলোম্বিয়া প্রতি বছর আনুমানিক ২৫,০০০ থেকে ৩০,০০০টি Scopus-সূচিবদ্ধ গবেষণাপত্র তৈরি করে, ফলে বৈজ্ঞানিক জ্ঞান উৎপাদনে বিশ্বব্যাপী এটি ৪৫ থেকে ৫০ নম্বরের মধ্যে অবস্থান করে। দেশটি এটি করে মোট GDP-এর প্রায় ০.৩% পরিমাণ R&D বিনিয়োগের মাধ্যমে, অর্থাৎ কলোম্বীয় বিজ্ঞানীরা খুব অল্প সম্পদে অনেক কাজ সম্পন্ন করেন। আর এই প্রায় সব কাজই ইংরেজিতে লেখা আন্তর্জাতিক জার্নালে পৌঁছাতে হয়।
সেখানেই কলোম্বীয় গবেষকদের জন্য একটি AI humanizer তার জায়গা করে নেয়। এখানে অনেক একাডেমিক নিজ নিজ ক্ষেত্রে ইংরেজি দারুণভাবে পড়তে পারেন, কিন্তু লিখতে ধীরগতিতে লেখেন। EF English Proficiency Index-এ কলোম্বিয়া অবস্থান করছে ৪৮৫-এ, "Moderate Proficiency" ব্যান্ডে বিশ্বে ৬৯তম। ফলে কলোম্বীয় পান্ডুলিপিতে সতর্ক, মানসম্মত, পাঠ্যবই-সঠিক ইংরেজিই সাধারণ চর্চা।
কিন্তু অস্বস্তিকর সত্যটা হলো, এই সতর্ক নির্ভুলতাকেই AI ডিটেক্টর প্রায়ই যন্ত্রের লেখা হিসেবে ভুল পড়ে। সাধারণ শব্দ দিয়ে গড়া, অনুমানযোগ্য বাক্যগঠন, দ্বিতীয় ভাষায় লেখা হলেও, চ্যাটবট থেকে কপি করা লেখার মতো একই ফ্ল্যাগ ট্রিগার করতে পারে। বাস্তব কাজ, বাস্তব গবেষকের লেখা, ফলে পড়ে যায় একই ফাঁদে।
El humanizador de texto de IA para investigadores colombianos
আমাদের AI টেক্সট humanizer কলোম্বীয় গবেষকদের ইংরেজিতে আরও নিশ্চিন্তভাবে প্রকাশ করতে সহায়তা করে। এটি আপনার পান্ডুলিপির অর্থ, কারিগরি পরিভাষা এবং উদ্ধৃতিগুলো ধরে রাখে, এবং দ্বিতীয় ভাষার একটি যত্নশীল লেখাকে যেন যন্ত্র-উৎপাদিত লেখা হিসেবে ভুলভাবে চিহ্নিত করা না হয়, সেই ঝুঁকি কমায়।
সহজ ভাষায় বললে: আপনি বিজ্ঞানটা লেখেন, আর humanizer আপনার গদ্যকে এমনভাবে পড়ার যোগ্য করে তোলে যেন একজন মানুষ লিখেছে, কারণ সত্যিই একজন মানুষ লিখেছে। এটি কোনো বিষয়বস্তু বানায় না, এবং এটি আপনার AI টুল ব্যবহারের বিষয়টি গোপন করেও না। এটি অন্যায্য ফ্ল্যাগ থেকে সতর্ক লেখাকে রক্ষা করে, তারপর প্রকাশ/ঘোষণার সিদ্ধান্তটা আপনার হাতে ফিরিয়ে দেয়।
লক্ষ্য হলো প্রকৃত কাজের প্রতি ন্যায্যতা, ছদ্মবেশ নয়। আপনি আপনার উদ্ধৃতি রাখবেন, আপনার ফলাফল রাখবেন, এবং আপনার বিশ্ববিদ্যালয় ও লক্ষ্য জার্নাল যেসব অখণ্ডতা-নিয়ম নির্ধারণ করেছে সেগুলোর ভেতরেই থাকবেন।
স্প্যানিশ ভাষায় খসড়া তৈরি করছেন? মানবিককরণ টুলটি এটিও শনাক্ত করে আবার লিখে দেয়
আপনি আগে সেটিকে ইংরেজিতে অনুবাদ না করেও একটি স্প্যানিশ খসড়া humanize করতে পারেন। আপনার লেখা পেস্ট করুন, ProofreaderPro ভাষাটি স্বয়ংক্রিয়ভাবে শনাক্ত করে, তারপর স্প্যানিশ-সচেতন একটি মডেলের মাধ্যমে রাউট করে। একটি humanizador de texto de IA হিসেবে এটি আপনার স্প্যানিশ গদ্যের ছন্দ পরিবর্তন করে, কিন্তু প্রতিটি ফলাফল ও রেফারেন্স অক্ষুণ্ন রাখে। স্বয়ংক্রিয় শনাক্তকরণ ষাটেরও বেশি ভাষা জুড়ে কাজ করে, ফলে স্প্যানিশকে ইংরেজিতে “রিশেপ” করার বদলে স্প্যানিশ হিসেবেই বিবেচনা করা হয়।
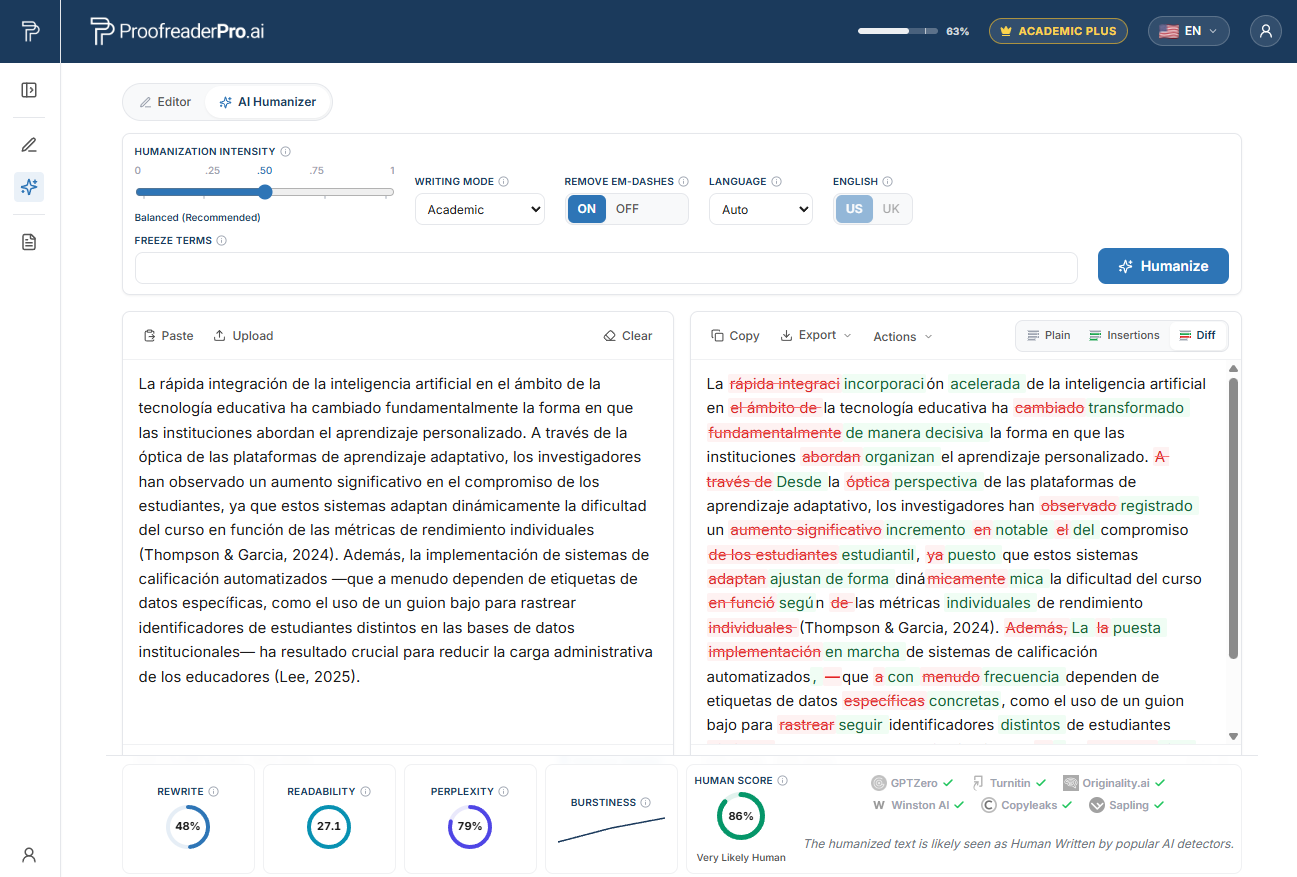
স্প্যানিশ একাডেমিক টেক্সটকে পুনর্লিখন করে ProofreaderPro AI Humanizer। before-and-after diff আপনার অর্থ ও উদ্ধৃতি বজায় রাখে, এবং detector checks দেখায় যে এটি স্বাভাবিকভাবে মানুষের মতো পড়ছে।
Why Colombian researchers get flagged by AI detectors
২০২৩ সালে Liang এবং সহকর্মীদের নেতৃত্বে স্ট্যানফোর্ডের একটি দল Cell Press জার্নাল Patterns-এ একটি গবেষণা প্রকাশ করে, শিরোনাম ছিল "GPT detectors are biased against non-native English writers." তারা মানুষের লেখা TOEFL প্রবন্ধগুলোকে সাতটি বহুল ব্যবহৃত ডিটেক্টরের মধ্যে চালায়। প্রতিটি প্রবন্ধেই একজন মানুষ লেখক ছিলেন।
গড়ে দেখা যায়, নন-নেটিভ প্রবন্ধগুলোর প্রায় ৬১% AI হিসেবে ফ্ল্যাগ হয়, নেটিভ ইংরেজি লেখকদের ক্ষেত্রে সেটি প্রায় ৫%। আরও প্রায় এক-পঞ্চমাংশ নন-নেটিভ প্রবন্ধ, প্রায় ১৯.৮%, একসাথে প্রতিটি ডিটেক্টরেই ফ্ল্যাগ হয়। এগুলো AI প্রবন্ধ ছিল না। এগুলো ছিল মানুষের লেখা, যা যত্নশীল ও মানসম্মত ছিল বলেই ডিটেক্টর ধরা পড়ায়।
প্রক্রিয়াটির মূল হলো "perplexity." অনেক ডিটেক্টর দেখে, ভাষা মডেলের কাছে পরের প্রতিটি শব্দ কতটা “অপ্রত্যাশিত”, অর্থাৎ কতটা বিস্ময়কর। দক্ষ নেটিভ লেখকেরা ইডিয়ম ছিটিয়ে দেন এবং অস্বাভাবিক বাক্য ঘুরিয়ে লেখেন, এতে perplexity বাড়ে। দ্বিতীয় ভাষার লেখকেরা নিরাপদ, সাধারণ, সঠিক শব্দ বেছে নেন, ফলে perplexity কমে। কম perplexity মেশিন টেক্সটের মতো পড়ায়। আমরা why AI detectors flag non-native writers শিরোনামে আরও পূর্ণ ব্যাখ্যা লিখেছিলাম, এবং এটি স্প্যানিশভাষী একাডেমিকদের সাথে প্রায় পুরোপুরি মিলে যায়।
The Spanish first-language patterns behind false flags
ইংরেজিতে স্প্যানিশভাষীরা এলোমেলোভাবে ভুল করে না। তারা তৈরি করে সুনির্দিষ্ট, ধাঁচবদ্ধ নির্মাণ, এবং এর অনেকগুলোই আসলে নিখুঁত ইংরেজি, কিন্তু তা খুব বেশি “স্ট্যান্ডার্ড” শোনায় বলে পড়ে যায় সন্দেহের মধ্যে। perplexity কমিয়ে দেওয়ার যে ধরণগুলো চাপ দেয়, সেগুলো নিচে দেওয়া হলো।
Article discipline with abstract nouns. স্প্যানিশ ভাষা ব্যাপকভাবে নির্দিষ্ট article ব্যবহার করে; তাই কলোম্বীয় লেখক একটি বিমূর্ত বিশেষ্যর আগে প্রতিটি "the" নিয়ে সতর্কভাবে ভাবেন। তারা যখন প্রাকৃতিক ইংরেজিতে স্বয়ং সংশোধন করেন ("poverty affects education," নয় "the poverty affects the education"), তখন সবচেয়ে সরল সম্ভাব্য বাক্যগঠনে গিয়ে দাঁড়ায়। সঠিক, যত্নশীল, এবং কম-perplexity।
Adjective placement. স্প্যানিশে বিশেষণ সাধারণত বিশেষ্যের পরে বসে ("resultados significativos"). যারা সচেতনভাবে ইংরেজি শব্দক্রমে উল্টে দেন, তারা ঝুঁকি নিয়ে অনেকগুলো modifier একসাথে জড়ো করার বদলে রক্ষণশীল, অস্পষ্টতাহীন নির্মাণ বেছে নেওয়ার প্রবণতা রাখেন। নিরাপদ শব্দক্রম ডিটেক্টরের কাছে অনুমানযোগ্য হিসেবে পড়ে।
Avoiding false friends. কারণ "actual" মানে current, "realizar" মানে carry out, "eventualmente" মানে occasionally, এবং "sensible" মানে sensitive, এভাবে কলোম্বীয় যত্নশীল লেখকেরা ঝুঁকিপূর্ণ cognate এড়িয়ে যেতে শেখেন এবং বদলে সোজাসাপ্টা ইংরেজি ক্রিয়াপদটি বেছে নেন। এই ইচ্ছাকৃত, সতর্ক শব্দভাণ্ডারটাই হলো সেই সাধারণ-শব্দের পছন্দ যা perplexity কমায়।
Tense caution. স্প্যানিশ present perfect (he analizado) ইংরেজির simple past-এর সঙ্গে সরাসরি মেলে না। যারা নিজেকে "We collected the data in 2023" ধরনের বাক্য লিখতে প্রশিক্ষিত করেছেন, তারা পরিষ্কার, পাঠ্যবই-স্টাইলের পদ্ধতিগত বাক্য তৈরি করেন। এখানে সমস্যা ব্যাকরণ নয়, সমস্যা পাঠ্যবইয়ের মতো টেমপ্লেট।
Preposition precision. "consist in" বনাম "consist of," অথবা "depend of" বনাম "depend on,", এ ধরনের সংশোধন পাওয়ার পর গবেষকেরা প্রতিবারই মানসম্মত collocation আঁকড়ে ধরে। ধারাবাহিক, সঠিক, এবং অনুমানযোগ্য।
ডিটেক্টর এগুলোর কোনোটাকেই ভুল হিসেবে ধরছে না। এগুলোই হলো শৃঙ্খলাবদ্ধ দ্বিতীয় ভাষার লেখকের লক্ষণ, এবং ডিটেক্টর শৃঙ্খলা বনাম যন্ত্র-আউটপুটের মধ্যে পার্থক্য বলতে পারে না।
Colombia's AI-detection and Turnitin context
কলোম্বীয় থিসিস ও জার্নাল জমা সাধারণত Turnitin বা iThenticate দিয়ে টেক্সট সাদৃশ্য যাচাই করা হয়, এবং উভয় প্ল্যাটফর্মই এখন ঐতিহ্যগত similarity স্কোরের পাশাপাশি AI-writing নির্দেশকও দেখায়। বেশির ভাগ কলোম্বীয় বিশ্ববিদ্যালয় এবং তাদের সম্পাদকীয় বোর্ড ডিফেন্স বা সম্পাদকীয় সিদ্ধান্তের আগে পান্ডুলিপি ও ডিসার্টেশনগুলোকে এরকম একটি সিস্টেমের মধ্য দিয়ে চালায়।
এটা জানা জরুরি যে AI সংখ্যাটি কতটা ভঙ্গুর। ভ্যান্ডারবিল্ট ২০২৩ সালে Turnitin-এর AI ডিটেক্টর নিষ্ক্রিয় করে, কারণ হিসেবে তারা false positives এবং নন-নেটিভ লেখকদের বিরুদ্ধে পক্ষপাতের কথা উল্লেখ করে। একই ধরনের পদক্ষেপ নেয় Michigan State, UT Austin, Northwestern, Pittsburgh, SMU, এবং Waterloo-ও। Turnitin নিজেও ১ থেকে ১৯% রেঞ্জের স্কোর দমন করে, সংখ্যার বদলে অ্যাস্টেরিস্ক দেখায়, এবং সতর্ক করে যে অখণ্ডতার কোনো কেস সিদ্ধান্ত নিতে শুধুমাত্র এর স্কোর ব্যবহার করা উচিত নয়।
সুতরাং একটি ফ্ল্যাগ হলো এমন একটি দাবি যেটিকে আপনি চ্যালেঞ্জ করতে পারেন; এটি কোনো চূড়ান্ত রায় নয়। একই সময়ে, তহবিলদাতা ও জার্নালগুলো ক্রমেই লেখকদের কাছে জিজ্ঞেস করছে তারা কীভাবে AI টুল ব্যবহার করেছেন তা প্রকাশ করতে। সঠিক পথ হলো, একদিকে সতর্ক লেখা যেন ভুলভাবে ফ্ল্যাগ না হয় সেটি নিশ্চিত করা, অন্যদিকে বাস্তব AI সহায়তার কথাও একসাথে প্রকাশ করা।
নিজের খসড়াকে মানবিক করুন, প্রতিটি উদ্ধৃতি বজায় রাখুন
ভুল AI শনাক্তকরণের ফ্ল্যাগ থেকে সাবধানী স্প্যানিশ-থেকে-ইংরেজি লেখাকে সুরক্ষিত করুন। আপনার অর্থ, পরিভাষা এবং রেফারেন্স সংরক্ষণ করুন, তারপর আপনার জার্নাল যেভাবে চায় সেভাবে আপনার AI ব্যবহারটি প্রকাশ করুন।
Humanizer ফ্রি করে দেখুনTop Colombian universities and where AI checks appear
কলোম্বিয়ায় গবেষণা আউটপুট মূলত পরিচিত কিছু পাবলিক ও প্রাইভেট বিশ্ববিদ্যালয়ের একটি গুচ্ছে কেন্দ্রীভূত, এবং প্রতিটিই স্নাতকোত্তর/প্রকাশের আগে থিসিস ও পান্ডুলিপি similarity এবং AI সূচকের জন্য স্ক্রিন করে।
- Universidad Nacional de Colombia (UNAL), Bogota, দেশটির সবচেয়ে বড় ও উৎপাদনশীল গবেষণা বিশ্ববিদ্যালয়; Bogota, Medellin, Manizales, এবং Palmira-তে ক্যাম্পাস রয়েছে।
- Universidad de los Andes (Uniandes), Bogota, শীর্ষস্থানীয় প্রাইভেট বিশ্ববিদ্যালয়; প্রকৌশল, অর্থনীতি, ও পদার্থবিজ্ঞানে শক্তিশালী।
- Universidad de Antioquia (UdeA), Medellin, অনেক Minciencias-শ্রেণিবদ্ধ গবেষণা গ্রুপসহ একটি প্রধান পাবলিক বিশ্ববিদ্যালয়।
- Pontificia Universidad Javeriana, Bogota এবং Cali, জেসুইট ঐতিহ্যের একটি শীর্ষস্থানীয় বিশ্ববিদ্যালয়; চিকিৎসা ও পরিবেশবিজ্ঞানে বিস্তৃত আউটপুট।
- Universidad del Valle (Univalle), Cali, দক্ষিণ-পশ্চিমের প্রধান পাবলিক বিশ্ববিদ্যালয়।
- Universidad Industrial de Santander (UIS), Bucaramanga, প্রকৌশল, পেট্রোলিয়াম বিজ্ঞান, এবং রসায়নের জন্য স্বীকৃত।
- Universidad EAFIT, Medellin, প্রকৌশল ও প্রয়োগিক বিজ্ঞানে ক্রমবর্ধমান কর্মসূচিসহ একটি প্রাইভেট বিশ্ববিদ্যালয়।
- Universidad del Norte (Uninorte), Barranquilla, ক্যারিবীয় উপকূলে শীর্ষস্থানীয় প্রাইভেট বিশ্ববিদ্যালয়।
- Universidad de Caldas, Manizales, কৃষি-বিজ্ঞান ও স্বাস্থ্যক্ষেত্রে শক্তিশালী।
- Universidad del Cauca, Popayan, ক্রমবর্ধমান গবেষণা সক্ষমতা নিয়ে একটি ঐতিহাসিক পাবলিক বিশ্ববিদ্যালয়।
- Escuela de Ingenieria de Antioquia (EIA), Medellin, প্রকৌশল ও বায়োমেডিক্যাল বিজ্ঞানে বিশেষায়িত একটি প্রতিষ্ঠান।
- Universidad del Rosario, Bogota, আমেরিকার সবচেয়ে প্রাচীন বিশ্ববিদ্যালয়গুলোর একটি; আইন, চিকিৎসা, ও অর্থনীতিতে শক্তিশালী।
এই প্রতিটি প্রতিষ্ঠানে চাপ একই: Minciencias শ্রেণিবিন্যাসকে এগিয়ে নিতে ইংরেজি-ভাষার আন্তর্জাতিক জার্নালে প্রকাশ। ফলে একটি ন্যায্য AI-ডিটেকশন ফলাফল এক ধরনের বাস্তব ক্যারিয়ার ইস্যু, একটি বিমূর্ত বিষয় নয়।
কলম্বিয়ার গবেষকদের জন্য AI Humanizer কীভাবে কাজ করে
ওয়ার্কফ্লোটি সহজ, এবং এর কোনো অংশই আপনার কাজকে আড়াল করার সাথে জড়িত নয়। কলোম্বীয় গবেষকদের জন্য AI humanizer বাস্তবে কীভাবে কাজ করে তা নিচে দেওয়া হলো।
প্রথম ধাপ: খসড়া করা। এখানে অনেক গবেষক স্প্যানিশে চিন্তা করেন ও আউটলাইন বানান, যেখানে যুক্তিটি আরও স্বাভাবিকভাবে প্রবাহিত হয়, তারপর সেটিকে ইংরেজিতে অনুবাদ করেন। এটি ঠিক আছে। দ্বিতীয় ধাপ: ব্যাকরণ, article choices, false friends, এবং prepositions ঠিক করুন, যাতে বিজ্ঞানটা পরিচ্ছন্ন হয়। তৃতীয় ধাপ: আপনার নিজস্ব AI-সাহায্যপ্রাপ্ত খসড়াটি the text humanizer দিয়ে চালান। এটি আপনার ছন্দ এবং শব্দচয়ন বদলায়, পুনরাবৃত্তিমূলক cadence ও অযাচিত ড্যাশ সরায়, এবং আপনি যেখানে রেখেছেন ঠিক সেখানেই আপনার অর্থ, কারিগরি পরিভাষা এবং উদ্ধৃতিগুলো ধরে রাখে।
ডিটেক্টর-পক্ষ থেকে আপনি কী আশা করতে পারেন? প্রধান ডিটেক্টরগুলোর বিরুদ্ধে পরীক্ষা করে দেখা যায়, আমাদের humanizer AI টেক্সটকে আরও স্বাভাবিক মানুষের মতো রূপে পুনর্লিখন করে, ফলে AI সিগন্যাল কমে এবং কঠিন ডিটেক্টরগুলোর বিরুদ্ধে সম্ভাবনা উন্নত হয়, যদিও একাডেমিক টেক্সটে ব্যাকরণগত নির্ভুলতা উচ্চ রাখে। এগুলো টেস্টের ফল, গ্যারান্টি নয়। ডিটেক্টর কয়েক মাস পরপর রি-ট্রেন হয়, তাই আমরা যা মেপেছি তা বলি, কোনো ফলাফল নিশ্চিত করার প্রতিশ্রুতি দিই না। আমরা কখনোই কিছু "bypass" করার কথা বলি না বা বলি না যে টেক্সট ১০০% অদৃশ্য।
তারপর ধাপটি হলো প্রকাশ/ঘোষণা। আপনার প্রতিষ্ঠান ও লক্ষ্য জার্নাল যেটি চাইবে, সেই AI-use statement যোগ করুন। নিজের সতর্ক লেখাকে humanize করা এবং আপনার AI ব্যবহারের কথা প্রকাশ করা, এ দুটির মধ্যে কোনো দ্বন্দ্ব নেই। একসাথে তারা অখণ্ডতার নিয়মের মধ্যে আপনাকে রাখে, আর ভুল পজিটিভের হাত থেকে বাস্তব দ্বিতীয়-ভাষার লেখা রক্ষা করে। আপনি যদি আরও “মানুষের সামনে পড়ে বোঝা যায়” এমন ভাষাগত পাসও চান, তাহলে আমাদের academic editing for Colombian researchers গাইডে সেই দিকটি আছে; এবং এই পোস্টটি আমাদের আরও বিস্তৃত multilingual AI humanizer hub-এর অংশ।
Local funding bodies, journals, and AI-disclosure expectations
Minciencias (Ministerio de Ciencia, Tecnologia e Innovacion) কলোম্বিয়ার গবেষক শ্রেণিবিন্যাস ব্যবস্থা পরিচালনা করে, যেখানে একাডেমিকদের Investigador Junior, Asociado, Senior, এবং Emerito, এই চারটি স্তরে ভাগ করা হয়। প্রতিটি ধাপ উপরে উঠতে হলে সূচিবদ্ধ জার্নালে ধারাবাহিকভাবে প্রকাশ করতে হয়; Scopus এবং Web of Science আউটপুটকে সবচেয়ে বেশি ওজন দেওয়া হয়। Minciencias এখন যে Colciencias গবেষণা গ্রুপগুলো প্রশাসন করে সেগুলোকে A1, A, B, C, এবং D, এর মধ্যে অনুরূপ উৎপাদনশীলতা সূচকের ভিত্তিতে র্যাঙ্ক করা হয়, এবং একটি গ্রুপের র্যাঙ্ক নির্ধারণ করে তারা প্রতিযোগিতামূলক তহবিলে কতটা প্রবেশাধিকার পাবে।
আন্তর্জাতিক প্রকাশ পুরো ব্যবস্থার “মুদ্রা” হওয়ায়, আপনার পান্ডুলিপি, গ্রান্ট আবেদন, ও রিভিউয়ারের প্রতিক্রিয়ায় যে ইংরেজি ব্যবহার হয় তা একদিকে যেমন সঠিক হতে হবে, অন্যদিকে তেমনি স্বাভাবিকও হতে হবে। কোনো জমায় ভুলভাবে AI ফ্ল্যাগ পড়লে ঠিক সেই প্রকাশই থেমে যেতে পারে, যেটার উপর ভিত্তি করে শ্রেণিবিন্যাস আপগ্রেড নির্ভর করে।
কলোম্বিয়ায় পরিস্থিতিটি দেখায় যে সিস্টেমটি কতটা “English-first” হয়ে উঠেছে। দেশটিতে খুবই সম্মানিত কিছু জার্নাল আছে। Colombia Medica (Universidad del Valle) PubMed ও Scopus, দুটিতেই দেখা যায়। আরও কিছু উদাহরণ হলো Revista Colombiana de Quimica (Universidad Nacional de Colombia), Ingenieria y Competitividad (Universidad del Valle), Revista Colombiana de Ciencias Pecuarias (Universidad de Antioquia), Universitas Scientiarum (Pontificia Universidad Javeriana), এবং Boletin de Investigaciones Marinas y Costeras (INVEMAR)। SciELO Colombia-তে আরও অনেক জার্নাল রয়েছে। স্প্যানিশ ব্যবহার সত্ত্বেও, বেশির ভাগই Scopus বা Web of Science-এ ঢোকার জন্য জমায় “পালিশড” ইংরেজি দাবি করবে।
এই তহবিলদাতা ও জার্নালগুলোর মধ্যে AI-use disclosure ঐচ্ছিক থেকে প্রত্যাশিত হয়ে উঠছে। আপনার টুল ব্যবহারের কথা সরাসরি লিখে জানানোর পরিকল্পনা করুন। আপনার নিজস্ব খসড়ায় the humanizer চালিয়ে পরে ঘোষণা করাই হলো সেই সমন্বয়, যেটি যাচাইয়ের মুখে টেকে।
Frequently asked questions
Q: Is using an AI humanizer for Colombian researchers considered cheating?
না, যতক্ষণ না আপনি আপনার নিজস্ব AI-সাহায্যপ্রাপ্ত খসড়াকে humanize করেন এবং তারপর আপনার প্রতিষ্ঠান ও জার্নাল যেভাবে AI ব্যবহারের কথা চাইবে সেভাবে তা প্রকাশ করেন। টুলটি আপনার অর্থ ও উদ্ধৃতি বজায় রাখে এবং যত্নশীল দ্বিতীয় ভাষার লেখাকে ভুল ফ্ল্যাগ এড়াতে সাহায্য করে। এটি বানানো/ফ্যাব্রিকেটেড কাজের ছদ্মবেশ দেওয়ার জন্য নয়, কিংবা AI ব্যবহার করেছেন তা লুকানোর জন্যও নয়।
Q: Will the humanizer guarantee my paper passes Turnitin or GPTZero?
না, এবং যে কেউ এমন প্রতিশ্রুতি দেয় তার ব্যাপারে সতর্ক থাকুন। প্রধান ডিটেক্টরগুলোর বিরুদ্ধে পরীক্ষা করে দেখা যায়, আমাদের humanizer AI টেক্সটকে আরও স্বাভাবিক মানুষের মতো রূপে পুনর্লিখন করে, ফলে AI সিগন্যাল কমে এবং কঠিন ডিটেক্টরগুলোর বিরুদ্ধে সম্ভাবনা উন্নত হয়, যদিও কোনো টুলই নির্দিষ্ট ফলাফল গ্যারান্টি দিতে পারে না। ডিটেক্টরগুলো প্রায়ই নতুনভাবে ট্রেন হয়, তাই আমরা কী মেপেছি সেটাই জানাই, ফলাফল নিশ্চিতে প্রতিশ্রুতি দিই না।
Q: Why do detectors flag careful Spanish-to-English academic writing at all?
কারণ অনেক ডিটেক্টর perplexity স্কোর করে, মানে আপনার শব্দচয়ন কতটা অনুমানযোগ্য। শৃঙ্খলাবদ্ধ দ্বিতীয় ভাষার লেখকেরা সাধারণ শব্দ ও মানসম্মত বাক্যগঠন ব্যবহার করেন; ফলে তা কম perplexity হিসেবে পড়ে এবং সেই কারণে মেশিনের মতো লাগে। স্ট্যানফোর্ড গবেষণায় দেখা গেছে, মানব-লেখা নন-নেটিভ প্রবন্ধগুলো প্রায় ৬১% হারে বনাম নেটিভ লেখকদের ক্ষেত্রে প্রায় ৫%, ডিটেক্টেড হয়; যা পক্ষপাতটি স্পষ্ট করে।
Q: Does the humanizer change my citations or technical terms?
না। এটি আপনার রেফারেন্স, আপনার শাখাভিত্তিক পরিভাষা, এবং আপনার ফলাফলগুলো বজায় রাখে, এবং কেবল ছন্দ ও শব্দচয়নে ভিন্নতা আনে। আপনার APA, Vancouver, IEEE, বা অন্যান্য উদ্ধৃতিগুলো অক্ষুণ্ন থাকে, তাই আপনার প্রমাণ বা অ্যাট্রিবিউশনে কিছুই বদলায় না।
Q: Can I draft in Spanish first and still use the humanizer?
হ্যাঁ। অনেক কলোম্বীয় গবেষক স্প্যানিশে আউটলাইন করেন ও যুক্তি নির্মাণ করেন, তারপর polishing করার আগে ইংরেজিতে অনুবাদ করেন। translation ও proofreading-এর পরে আপনার ইংরেজি খসড়ায় humanizer কাজ করে, যুক্তিটি মসৃণ করে, কিন্তু স্প্যানিশে গড়ে তোলা যুক্তিটিকে পুরোপুরি অক্ষুণ্ন রাখে।
নিজের AI-সহায়তাপ্রাপ্ত একাডেমিক খসড়াকে মানবিক করুন, অর্থ এবং উদ্ধৃতিসমূহ সংরক্ষণ করুন, এবং অবিচারপূর্ণ AI-ডিটেকশন ফ্ল্যাগ থেকে সাবধানী স্প্যানিশ-থেকে-ইংরেজি লেখাকে সুরক্ষিত করুন, তারপর আত্মবিশ্বাসের সাথে প্রকাশ করুন।

Moe একজন NLP ইঞ্জিনিয়ার একজন PhD সহ প্রাকৃতিক ভাষা প্রক্রিয়াকরণে। তার গবেষণা কম্পিউটেশনাল ভাষাতত্ত্ব, পাঠ্য বিশ্লেষণ এবং মেশিন লার্নিংকে কভার করে এবং এটি সরাসরি ProofreaderPro-এর পিছনে সম্পাদনা এবং মানবীকরণ মডেলগুলিতে যোগ করে। তিনি প্রক্রিয়াটির অংশ সম্পর্কে লিখেছেন যা বেশিরভাগ লোকেরা কখনই দেখে না: কীভাবে একটি ভাষা মডেল একটি বাক্য পড়ে, স্কোর করে এবং কী পরিবর্তন করতে হবে তা সিদ্ধান্ত নেয়।


