Znakowanie tekstu OpenAI, SynthID i Claude: porównanie znaczników tekstowych
Czy OpenAI znakuje swój tekst, czy istnieje publiczny sprawdzający znacznik OpenAI oraz czym różnią się SynthID i znacznik Claude, porównanie dla autorów akademickich.
OpenAI, Google i Anthropic stworzyły to samo rozwiązanie: statystyczny znacznik dla tekstu generowanego przez AI. OpenAI przez lata wstrzymywało swoją wersję i rozpoczęło jej wdrażanie, jako textGrain, w październiku 2026. Google wbudował SynthID w Gemini i opublikował metodę. Anthropic uczyniło znacznik Claude obowiązkowym dla każdego użytkownika w sierpniu 2026. Jeśli piszesz z pomocą AI w dowolnej formie, te trzy decyzje wpływają dziś na to, jak ocenia się Twoje dokumenty.
Znakowanie przeszło z tematu badawczego do mainstreamowych wiadomości 11 sierpnia 2026, kiedy Anthropic ogłosiło, że każdy nowy model Claude oznacza swój tekst wynikowy. Opisaliśmy to ogłoszenie szczegółowo w naszym wyjaśnieniu znacznika Claude. Ten poradnik obejmuje pełny obraz: czym jest znacznik tekstowy, jak każde z trzech głównych laboratoriów wdrożyło lub wstrzymało to rozwiązanie oraz co każde z systemów pokazuje w odniesieniu do fragmentu pisania.
Co to jest znacznik tekstu AI?
Znacznik tekstu AI to statystyczny wzorzec ukryty w doborze słów w generowanym tekście. Jest wstawiany w chwili generowania tak, aby detektor posiadający odpowiedni klucz mógł później potwierdzić, że tekst pochodzi z konkretnego systemu AI. Nie jest to widoczna naklejka, nie jest to ukryty znak ani metadane dołączone do pliku. Znacznik „żyje” w samych słowach.
Ta różnica ma znaczenie, ponieważ termin „watermark” jest używany swobodnie na określenie trzech różnych rzeczy:
| Co to jest | Gdzie się znajduje | Czy przetrwa kopiowanie i wklejanie? | |
|---|---|---|---|
| Statystyczny znacznik | Wzorzec polegający na tym, że model wybiera określone słowa | Samo treści tekstu | Tak |
| Metadane pliku (C2PA) | Podpisana etykieta pochodzenia | Kontener pliku | Nie, zwykłe kopiowanie w formacie tekstowym je usuwa |
| Znaki o zerowej szerokości | Niewidoczny Unicode wstawiony do tekstu | Między widocznymi znakami | Nie, da się to łatwo usunąć |
Statystyczne znakowanie wodne jest jedynym z tych trzech rozwiązań, które przetrwa kopiowanie, wklejanie, przepisywanie i konwersję formatu do nowego dokumentu. Dlatego wszystkie trzy czołowe laboratoria zbieżnie je wybrały dla tekstu oraz dlaczego „usuwacze watermarków”, które usuwają niewidoczne znaki, nie robią wobec niego nic. Nasza strona darmowego usuwania watermarka Claude opisuje ten scenariusz porażki na podstawie źródeł.
Jak właściwie działa statystyczne znakowanie wodne?
Na każdym etapie pisania zdania model językowy wybiera spośród kilku prawie równoważnych słów, a znakowanie wodne potajemnie „załadowuje” te losowania. Bazowy przepis opublikowali Kirchenbauer i współpracownicy z University of Maryland w styczniu 2023 roku w Watermark for Large Language Models (ICML 2023). Działa to tak:
- Przed wyborem każdego słowa tajny klucz pochodzący z poprzednich słów dzieli słownictwo na zbiór preferowany i zbiór neutralny.
- Model lekko kieruje swój wybór w stronę zbioru preferowanego. „Suggest” zamiast „indicate”. „Across” zamiast „among”. Każdy pojedynczy wybór wygląda całkowicie naturalnie.
- Detektor, który zna klucz, zlicza, jak często tekst trafia do zbiorów preferowanych. Tekst pisany przez człowieka trafia do tego rozkładu zgodnie z oczekiwaniem, przypadkowo. Tekst ze znakiem wodnym trafia tam zdecydowanie częściej, a test statystyczny wykrywa tę rozbieżność.
Żadne pojedyncze słowo nie jest dowodem czegokolwiek. Sygnał ujawnia się dopiero w wielu lub kilkuset kolejnych wyborach, dlatego dłuższe fragmenty łatwiej testować niż krótkie, a wykrywanie ma zawsze charakter probabilistyczny, a nie formę pieczęci tak lub nie.
System produkcyjny Google DeepMind, opublikowany w Nature w październiku 2024 roku jako Skalowalne znakowanie wodne do identyfikowania wyjść dużych modeli językowych, udoskonalił to podejście metodą o nazwie tournament sampling. Dzięki niej jakość tekstu pozostaje na tyle dobra, że można je bezgłośnie uruchamiać w masowej, konsumenckiej aplikacji. Ta praca ma znaczenie wykraczające poza Google: to opublikowana podstawa, na którą wskazuje Anthropic przy wdrożeniu w Claude.
Główna słabość została opublikowana zanim większość wdrożeń miała miejsce. W marcu 2023 roku Krishna i współpracownicy pokazali w Parafraza omija wykrywacze tekstu generowanego przez AI (NeurIPS 2023), że ponowne sformułowanie fragmentu „rozmywa” wykrywanie niezależnie od metody, w tym znakowania wodnego. Sygnał istnieje w dokładnej sekwencji tokenów i nigdzie indziej, więc każda zmiana, która przepisuje tę sekwencję, w tym edycja przez człowieka, usuwa dowód. Każdy dostawca, który dziś wysyła znakowanie wodne, opisuje tę ograniczoność we własnej dokumentacji.
OpenAI: firma, która to wymyśliła i wdrożyła jako ostatnia
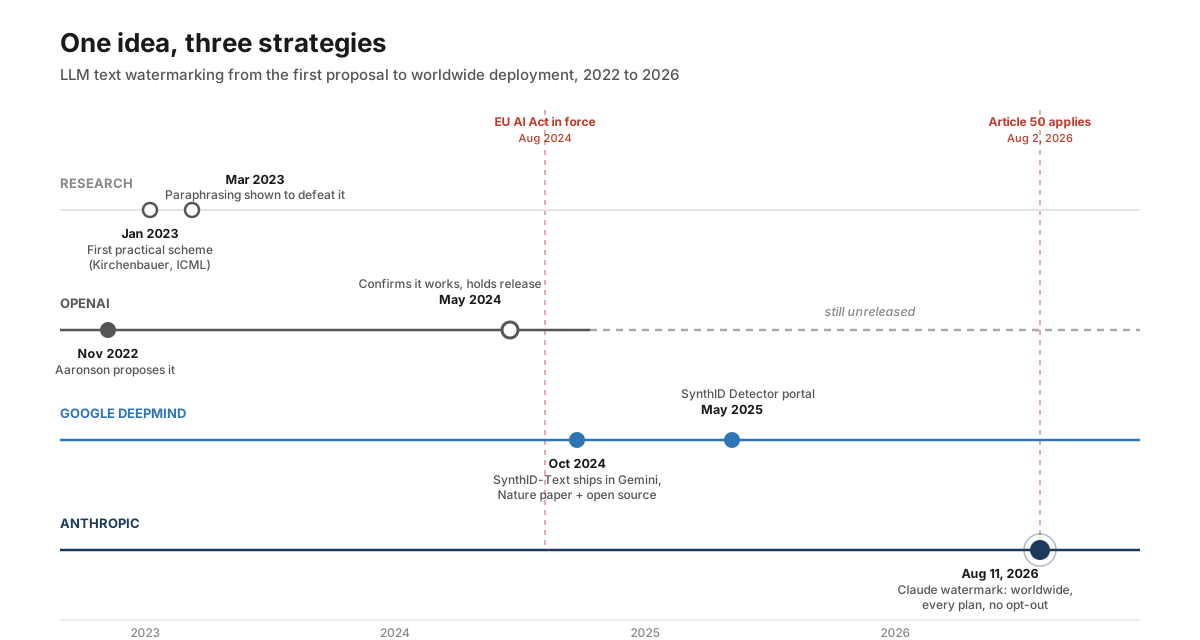
OpenAI miało działające znakowanie wodne tekstu od lat i zdecydowało się go nie udostępniać aż do października 2026. Scott Aaronson, wówczas pracujący nad bezpieczeństwem w OpenAI, po raz pierwszy opisał ten pomysł publicznie na wykładzie z listopada 2022. Metoda skłania wybory modelu pomiędzy prawie równoważnymi słowami za pomocą tajnej funkcji kryptograficznej, więc sam tekst pokazuje, skąd pochodzi. Ten wykład jest starszy niż każde wdrożone systemy.
W maju 2024 roku OpenAI opisało stan projektu w aktualizacji dotyczącej proweniencji, zrozumienie źródła tego, co widzimy i słyszymy w internecie. Firma stwierdziła, że jej metoda znakowania tekstu jest dokładna i skuteczna przy niewielkich edycjach, ale wstrzymywała udostępnienie, ponieważ ważyła plusy i minusy. Dwa z ryzyk, które wymieniło OpenAI, dotyczą bezpośrednio autorów akademickich:
- Łatwe obejście. Przepisywanie lub tłumaczenie tekstu usuwa znacznik, dokładnie tak, jak przewidziano w badaniach z 2023 roku. Znak wodny, który w większości wychwytuje osoby, które nie wiedzą o jego istnieniu, jest słabym narzędziem egzekwowania.
- Nieproporcjonalny wpływ na osoby anglojęzyczne niebędące rodzimymi użytkownikami. OpenAI wskazało, że znakowanie wodne może stygmatyzować uzasadnione korzystanie z AI jako pomocy w pisaniu przez osoby tworzące tekst w drugim języku. Nasz materiał o tym, dlaczego wykrywacze AI flagują autorów niebędących native speakerami omawia ten sam problem z perspektywy wykrywacza.
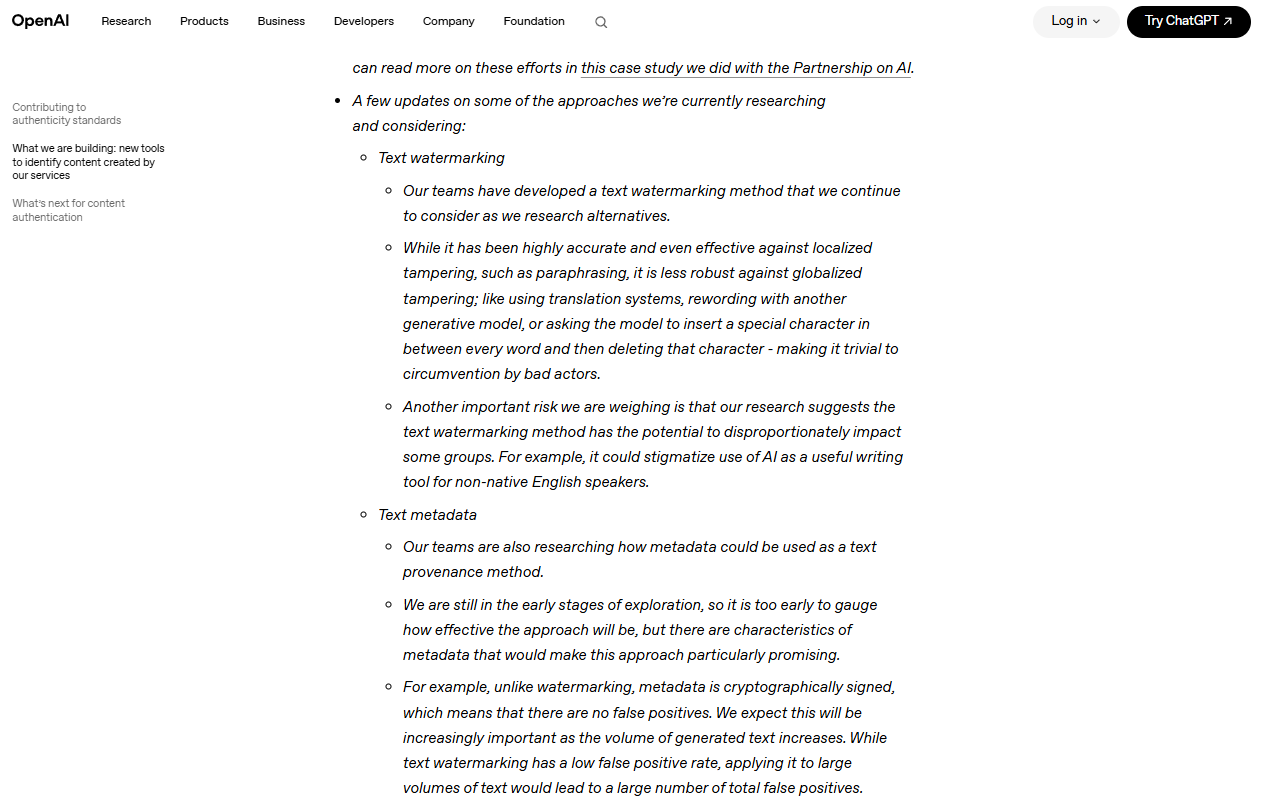
Aktualizacja proweniencji OpenAI z 2024 roku: metoda działa, a firma podaje powody, dla których wstrzymała wdrożenie w tamtym czasie.
Dla obrazów i dźwięku OpenAI obrało inną ścieżkę: metadane proweniencji C2PA w wynikach DALL-E i Sora, czyli etykieta na poziomie pliku, a nie znacznik w treści. W przypadku tekstu wyjście ChatGPT nie miało znaku wodnego aż do października 2026 roku. Firma, która zaproponowała technologię, była ostatnią z trzech, która ją wdrożyła.
Czy OpenAI znakuję teraz tekst?
Tak, OpenAI zaczęło znakować część tekstu 5 października 2026 roku, w odpowiedzi na unijne AI Act. Jego ogłoszenie wprowadza znacznik tekstu o nazwie textGrain, który dodaje niewidoczny sygnał statystyczny do wyborów słów generowanych przez model. Wdrożenie ma trzy elementy, a watermark nie jest domyślnie globalny:
- Klienci API na całym świecie mogą włączyć wyjście znakowane wodnym dla wybranych modeli. Domyślnie pozostaje wyłączone.
- W kolejnych tygodniach kwalifikowane tekstowe wyniki ChatGPT i Codex w Unii Europejskiej otrzymują znak wodny, we wszystkich planach.
- Zatwierdzeni badacze i organizacje eksperckie mogą ubiegać się o dostęp do detektora znaku wodnego dla tekstu.
OpenAI twierdzi, że textGrain dorównywał pozostałym testowanym metodom lub je przewyższał, w tym rozwiązaniu Google do tekstu SynthID. Opublikowało też, gdzie wykrywanie jest słabsze. Przy 1% współczynniku fałszywych alarmów detektor wykrywał znacznik w około 80% fragmentów po 200 tokenów i około 95% fragmentów po 400 tokenów w treściach z psychologii. Wykrywanie było znacznie niższe dla matematyki, gdzie jest mniej swobody w doborze słów.
Edycja szybko osłabia sygnał. W fragmentach po 400 tokenów zastąpienie 10% słów synonimami obniżyło wykrywalność z około 92% do 66%, a zastąpienie 25% obniżyło ją do 17%.
OpenAI sprawdziło też, czy znak wodny zmienia jakość odpowiedzi w Astra, jego najnowszym modelu, i twierdzi, że nie zaobserwowało istotnej różnicy. Oto cztery z opublikowanych przez nie benchmarków:
| Benchmark | Bez znaku wodnego (Astra) | Z znakiem wodnym (Astra) |
|---|---|---|
| Artificial Analysis Intelligence Index | 49,57 punktu | 49,76 punktu |
| GPQA Diamond | 94.44% | 93.94% |
| HealthBench Professional | 64.27% | 64.60% |
| BrowseComp | 87.92% | 87.35% |
Dla studentów liczy się data. Tekst ChatGPT napisany przed wdrożeniem, albo poza UE bez ustawienia w API, nie ma znaku wodnego OpenAI. Nasz poradnik o Turnitin Clarity wyjaśnione wyjaśnia, jak szkoły w międzyczasie ustalają własne polityki dotyczące wykorzystania AI.
Czy istnieje publiczny kontroler znaku wodnego OpenAI?
Nie ma jeszcze publicznego narzędzia do weryfikacji znaczników OpenAI dla tekstu. Darmowe narzędzie do weryfikacji firmy OpenAI sprawdza pliki obrazu i dźwięku pod kątem C2PA Content Credentials oraz znacznika SynthID. OpenAI wbudowuje SynthID w obsługiwane obrazy i dźwięk. OpenAI twierdzi, że narzędzie nie obsługuje tekstu.
W przypadku tekstu OpenAI udostępnia dostęp do detektora indywidualnie, od przypadku do przypadku, zatwierdzonym badaczom i organizacjom eksperckim, za pośrednictwem formularza Content Provenance API. Twierdzi, że nie udostępnia detektora tekstu publicznie na starcie z powodu ryzyka pominiętych znaczników i fałszywych trafień. Detektor raportuje, czy wykrywa znacznik OpenAI, i nie identyfikuje użytkownika ani nie pokazuje jego promptów.
| Co chcesz sprawdzić | Narzędzie | Kto może z niego korzystać |
|---|---|---|
| Plik obrazu lub dźwięku OpenAI | Narzędzie weryfikacyjne OpenAI | Każdy, za darmo |
| Tekst wyjściowy OpenAI (textGrain) | Detektor znaczników tekstu OpenAI | Zatwierdzeni badacze i organizacje eksperckie, na wniosek |
| Tekst wyjściowy Claude | Detektor znaczników Claude | Kwalifikujące się organizacje, na wniosek (zobacz nasz przewodnik po znacznikach Claude). |
OpenAI wyjaśnia też jasno, czego wynik nie potrafi Ci powiedzieć. Wykryty znacznik nie mierzy, jak dużo wniosła dana osoba, i nie identyfikuje, kto napisał albo użył tekstu. Brak znacznika nie dowodzi też autorstwa ludzkiego, ponieważ tekst może być zbyt krótki, edytowany, przetłumaczony albo pochodzić z nieobsługiwanego modelu.
Google: pierwsze do wdrożenia, a potem udostępniło przepis
Google DeepMind jako pierwsze wdrożyło rozwiązanie, w pełni je opublikowało, a następnie udostępniło metodę. Jego system, SynthID, zaczął jako znacznik obrazu w 2023 roku, a w 2024 roku rozszerzył się na tekst. W momencie, gdy we wrześniu 2024 ukazała się praca Nature, SynthID-Text już działał wewnątrz Gemini w produkcji, co uczyniło go pierwszym statystycznym znacznikiem tekstu wdrożonym na skalę konsumencką.
SynthID obejmuje tekst, obrazy, dźwięk i wideo i działa w wyjściach tekstowych Gemini od października 2024.
Następnie Google opublikowało implementację jako open source na Hugging Face, umożliwiając każdemu twórcy zastosowanie tego samego schematu znakowania do własnych modeli. W maju 2025 ogłosiło SynthID Detector, portal weryfikacyjny, w którym można sprawdzać treści pod kątem oznaczeń SynthID w tekście, obrazach, dźwięku i wideo.
Istotne ograniczenie zakresu: SynthID jedynie oznacza i jedynie wykrywa treści pochodzące z modeli samego Google. Nie mówi nic o wyjściu ChatGPT ani Claude, a czysty skan SynthID nie oznacza, że tekst został napisany przez człowieka. Oznacza to jedynie, że modele Google nie napisały tego tekstu, co jest znacznie węższym twierdzeniem.
Anthropic: ostatnie do ruchu, najbardziej rygorystyczna polityka
Anthropic wdrożył to jako ostatni, zapewniając najszerszy obowiązkowy zakres. Każdy model Claude uruchomiony 2 sierpnia 2026 roku lub później osadza statystyczny znacznik w swoim wyjściu tekstowym na całym świecie, na każdym planie, bez możliwości rezygnacji. Firma opisuje mechanizm w swoim wyjaśnieniu, Jak działa znacznik tekstu w Claude, a zakres polityki w artykule w centrum pomocy, Jak Claude oznacza treści generowane przez AI: objęte są Claude API, claude.ai, Claude Code, Claude Cowork i Claude Tag. Modele uruchomione przed datą graniczną są w okresie przejściowym, a Anthropic mówi, że dodaje obsługę oznaczania także dla nich. Oprócz statystycznego znacznika, pliki wygenerowane przez Claude zawierają też metadane C2PA, drugi, niezależny system, który usuwa zwykłe kopiowanie tekstu.
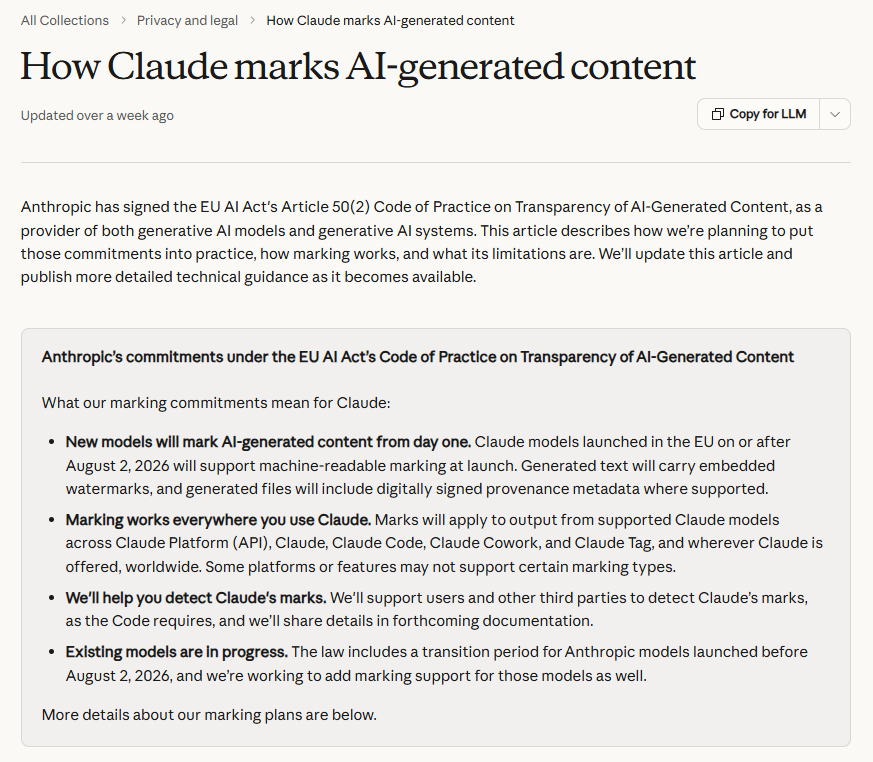
Polityka słowami Anthropic: każdy nowy model, każda platforma, na całym świecie, a starsze modele są dodawane.
Dokumentacja Anthropic mówi to wprost. Detekcja ma charakter probabilistyczny. Znakowanie nie potrafi odróżnić dokumentu, który napisał Claude, od dokumentu napisanego przez człowieka i tylko lekko edytowanego przez Claude. Całkowite przeredagowanie usuwa je. Przejrzeliśmy wszystko, w tym to, co tak naprawdę potwierdza pozytywna detekcja, oraz co zrobić, jeśli Twoje własne teksty zostaną oznaczone, w dedykowanym przewodniku po znaku wodnym Claude.
Czasowanie wynika z regulacji. Anthropic podpisał Artykuł 50(2) Kodeks Praktyk dotyczący przejrzystości treści generowanych przez SI w ramach EU AI Act, który wymaga od dostawców systemów generatywnej SI zapewnienia, że wyniki są "oznaczone w formacie możliwym do odczytu maszynowego i wykrywalne jako sztucznie wygenerowane." Te zobowiązania dotyczące przejrzystości zaczęły obowiązywać 2 sierpnia 2026 roku: dokładna data odcięcia w polityce modeli Anthropic, dziewięć dni przed publicznym ogłoszeniem. Anthropic zdecydował się na zgodność globalną zamiast utrzymywania odrębnego zachowania dla ruchu z UE. Google już było zgodne z założenia. Niezaznaczone wyjście tekstowe OpenAI jest otwartym pytaniem dotyczącym zgodności na 2027 rok.
Trzy podejścia, obok siebie
| OpenAI | Google DeepMind | Anthropic | |
|---|---|---|---|
| Znakowanie tekstu wdrożone? | Tak (textGrain, wdrożenie w UE od 5 października 2026 r.) | Tak (Gemini, od października 2024 r.) | Tak (modele Claude od 2 sierpnia 2026 r.) |
| Technika | textGrain, statystyczny sygnał w wyborze słów | SynthID-Text turniejowy sampling | Statystyczny znacznik, w stylu SynthID |
| Zakres | Kwalifikujące się teksty ChatGPT i Codex w UE; w API opcja dobrowolna globalnie | Modele Google tylko | Wszystkie nowe modele Claude; starsze modele w okresie przejściowym |
| Rezygnacja | Domyślnie wyłączone w API | Nie | Nie |
| Publiczny detektor | Nie | Portal SynthID Detector (2025) | Planowane, jeszcze nieudostępnione |
| Czy schemat opublikowany? | Tylko wykłady koncepcyjne | Artykuł Nature + open source | Wyjaśnienie oparte na opublikowanych materiałach |
| Metadane pliku (C2PA) | Tak, obrazy i audio | Tak, w różnych mediach | Tak, na plikach generowanych |
| Deklarowane ograniczenia | Omijanie, stygmat ESL | Zakres ograniczony do własnych modeli | Probabilistyczne, edycje rozmywają autorstwo |
Wzorzec widoczny w kolumnach: OpenAI traktuje znakowanie wodne tekstu jako nierozwiązany problem polityki, Google jako infrastrukturę do ujednolicenia, a Anthropic jako obowiązek zgodności wdrożyć w pełni.
Co to oznacza dla badaczy i autorów akademickich
Praktyczne konsekwencje zależą od tego, które narzędzia dotykają Twojego tekstu. Jeśli tworzysz z ChatGPT, dziś Twój tekst nie ma znaku wodnego. Jeśli tworzysz z Gemini, ma znacznik SynthID, który potrafi odczytać tylko detektor Google. Jeśli tworzysz lub edytujesz aktualnym modelem Claude, ma znacznik Anthropic, a nie ma ustawienia, które pozwala to wyłączyć.
Trzy rzeczy, które autorzy akademiccy powinni wiedzieć:
Znak wodny identyfikuje narzędzie, nie autora. Każdy dostawca stwierdza to w swojej dokumentacji, i warto to powtarzać, ponieważ polityki instytucjonalne nie zawsze robią tę różnicę. Tekst może zostać oznaczony, ponieważ zrobił go autor AI, ponieważ AI dokonał korekty stylistycznej dwóch zdań, albo dlatego, że oznaczony akapit został zacytowany. Jeśli Twoja instytucja uruchamia testy znaków wodnych, to to, co dowodzi sprawdzian, jest tym, że konkretny model dotknął tekstu w pewnym momencie, nic więcej. Nasz poradnik na odwołanie od błędnej flagi wykrycia AI wyjaśnia, jak zbudować ten argument, gdy ma to znaczenie.
Znaki wodne i detektory AI to różne technologie o różnych trybach awarii. Detektory takie jak Turnitin lub GPTZero zgadują na podstawie statystycznego stylu, z problemami z dokładnością, które udokumentowaliśmy. Wykrywanie znaków wodnych to test oparty o klucze, o bardzo niskim odsetku fałszywych alarmów dla nieoznaczonego ludzkiego tekstu. Asymetria odwraca się dla fałszywych negatywów: sprawdzenie znaku wodnego nie zauważa żadnego tekstu AI pochodzącego z modelu, który nie stosuje znakowania, a dziś obejmuje to wszystkie modele ChatGPT.
Ujawnienie pozostaje Twoją najmocniejszą pozycją. Znakowanie sprawia, że ciche użycie AI jest bardziej ryzykowne, a ujawnione użycie AI bezpieczniejsze, ponieważ ujawniony workflow nie ma nic do stracenia w razie pozytywnego wyniku oznaczenia. Większość czasopism i uczelni ma obecnie jasne polityki dotyczące użycia AI; nasze zasady użycia AI wyjaśniają, gdzie wyznaczamy granice w odniesieniu do naszych własnych narzędzi, i stanowią rozsądny wzorzec tego, jak wygląda transparentne korzystanie.
Co usuwa znak wodny w tekście i co nie
Przeredagowanie usuwa go; przeformatowanie nie. Kopiowanie, wklejanie, zmiana czcionek, konwersja między formatami plików oraz usuwanie niewidocznych znaków pozostawiają znak wodny w pełni nienaruszony statystycznie, ponieważ znacznik jest w doborze słów. To, co go usuwa, to wszystko, co regeneruje brzmienie: głęboka ludzka edycja, tłumaczenie albo rzeczywiste parafrazowanie, co potwierdziły badania nad odpornością z NeurIPS 2023, przeprowadzone zanim jakiekolwiek z tych systemów trafiły na rynek.
Obie strony mają znaczenie. Zniknięcie znacznika nie sprawia, że tekst jest Twój, a przetrwanie znacznika nie sprawia, że tekst nie jest Twój. Przerobiony przez AI szkic nadal jest dokumentem wspomaganym przez AI, do którego stosują się zasady ujawniania obowiązujące w Twojej instytucji. Nasz humanizer AI do tekstu przepisuje szkice wspomagane przez AI na naturalny akademicki rejestr i ponieważ ten proces regeneruje sekwencję tokenów, znaczniki statystyczne nie przetrwają go. W przypadku tekstu dla Claude konkretnie darmowy usuwacz watermarku Claude przepisuje każde zdanie na świeże brzmienie, zachowując niezmienione fakty, liczby i cytowania. Tego, czego nie potrafi zmienić żadne narzędzie, nie da się ruszyć: tego, co jesteś winien(-na) swojemu czytelnikowi, czyli przejrzystości w tym, jak powstał dokument.
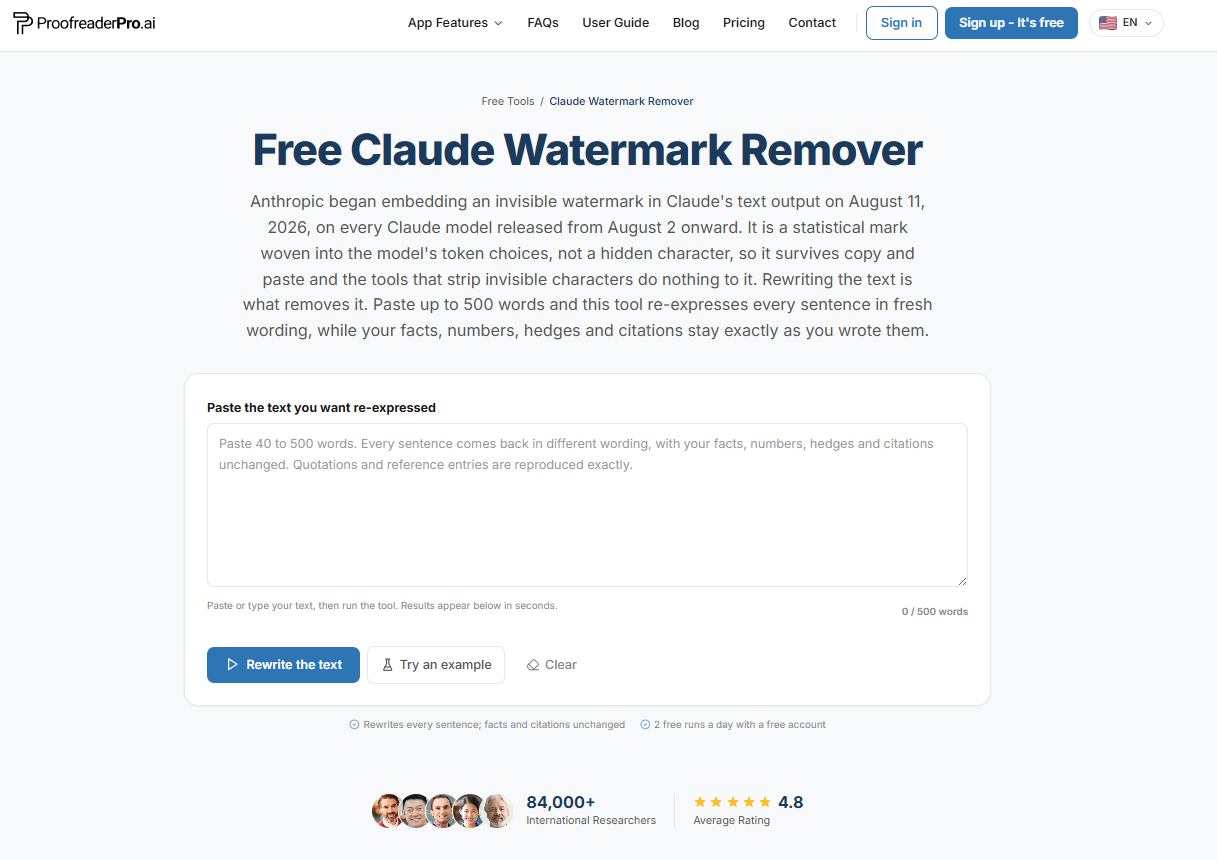
Przerabianie to jedyna operacja, która usuwa znacznik statystyczny, i właśnie to robi to narzędzie, zdanie po zdaniu.
Dokąd to pójdzie dalej
Przyjrzyj się trzem kwestiom do 2027 roku. Po pierwsze, czy OpenAI wyprowadzi textGrain poza EU: zaczęło to tam, ponieważ egzekwowanie przepisów UE dotyczących Artykułu 50 wymaga znaczników w tekście, możliwych do odczytania maszynowo. Po drugie, czy detektory będą się ujednolicać. Jeśli wszystkie duże laboratoria będą dodawać watermarki według opublikowanego schematu, uczelnie będą mogły sprawdzać klucze zamiast zgadywać na podstawie stylu pisania, co byłoby ulepszeniem względem dzisiejszego wykrywania podatnego na fałszywe trafienia. Po trzecie, czy znaczniki staną się kompatybilne. Dziś trzy laboratoria używają trzech różnych znaczników i nie ma jednego testu, który obejmuje je wszystkie. C2PA wypełnia tę lukę dla plików, ale nic jeszcze nie wypełnia jej dla surowego tekstu.
Czy ChatGPT watermarkuje swój tekst?
Tak, częściowo, od 5 października 2026. OpenAI zaczęło dodawać do kwalifikujących się treści ChatGPT i Codex watermark textGrain w Unii Europejskiej, a klienci API na całym świecie mogą włączyć tę funkcję. Watermark jest sygnałem statystycznym w doborze słów, bez ukrytych znaków. OpenAI stosuje też metadane pochodzenia C2PA do plików multimedialnych DALL-E i Sora, co jest osobnym, systemem działającym na poziomie pliku.
Czy Google Gemini watermarkuje swój tekst?
Tak. Wyjście Geminiego nosi watermark tekstowy SynthID-Text firmy Google DeepMind od października 2024. To znacznik statystyczny w doborze słów, niewidoczny dla czytelników i możliwy do sprawdzenia za pomocą detektora SynthID firmy Google. Dotyczy wyłącznie modeli Google, więc wynik negatywny SynthID nie mówi nic o tekście z innych systemów AI.
Czy Claude watermarkuje swój tekst?
Tak. Każdy model Claude uruchomiony 2 sierpnia 2026 lub później osadza znacznik statystyczny w swoim wyjściu tekstowym, na każdej platformie i w każdym planie, bez możliwości wyłączenia, a dodatkowo pliki wygenerowane przez Claude przenoszą metadane C2PA. Modele uruchomione przed tą datą jeszcze nie oznaczają swojego wyjścia; firma Anthropic twierdzi, że dodaje obsługę oznaczania w trakcie okresu przejściowego. Pełne szczegóły znajdują się w naszym wyjaśnieniu dotyczącym watermarku Claude.
Czy uczelnie potrafią wykrywać watermarki AI?
Tylko przy współpracy dostawcy, ponieważ wykrywanie wymaga klucza dostawcy. Google oferuje publiczny portal detekcji dla treści SynthID. Anthropic mówi, że planuje wsparcie wykrywania dla użytkowników i podmiotów trzecich, ale jeszcze nie udostępniło publicznego detektora. Żaden powszechny pakiet do wykrywania plagiatu nie potrafi obecnie weryfikować watermarków statystycznych z żadnego laboratorium, więc dziś „wykrywanie AI” na poziomie instytucji wciąż oznacza zgadywanie oparte na stylu, a nie weryfikację watermarku.
Czy watermarkowanie AI jest wymagane przez prawo?
W UE, tak, w praktyce. Artykuł 50(2) unijnej ustawy o AI zobowiązuje dostawców generatywnej AI do zapewnienia, że wyniki są oznaczone w formacie umożliwiającym odczyt maszynowy i wykrywalne jako sztucznie wygenerowane, przy jednoczesnych obowiązkach w zakresie przejrzystości, obowiązujących od 2 sierpnia 2026. Anthropic podpisał powiązany Kodeks Praktyk i zdecydował się na zgodność na całym świecie. To, jak regulatorzy podejdą do niewyemitowanego przez OpenAI watermarku tekstowego, jest pytaniem do obserwowania w 2027 roku.
Czy watermarki AI przetrwają tłumaczenie?
Nie. Statystyczny watermark żyje w dokładnej sekwencji słów, które wybrał model, a tłumaczenie zastępuje każde słowo. To samo dotyczy głębokiego parafrazowania i intensywnej redakcji przez człowieka. Ograniczenie to jest udokumentowane w literaturze recenzowanej i uznawane przez każdego dostawcę, który wdraża watermark.
Czy istnieje publiczny checker watermarku OpenAI do tekstu?
Nie, publiczne narzędzie OpenAI do weryfikacji sprawdza tylko pliki graficzne i audio, pod kątem metadanych C2PA oraz watermarków SynthID. OpenAI twierdzi, że nie obsługuje tekstu. Wykrywacz watermarku tekstowego jest dostępny wyłącznie dla zatwierdzonych badaczy i organizacji eksperckich, w trybie indywidualnym.
Czym jest textGrain?
textGrain to watermark tekstowy OpenAI ogłoszony 5 października 2026. Dodaje niewidoczny sygnał statystyczny do wyborów słów przez model, więc oznaczenie jest częścią słów, bez ukrytych znaków ani metadanych plików. OpenAI twierdzi, że dorównuje lub przewyższa pozostałe testowane przez nią metody, w tym SynthID do tekstu, oraz że edycja osłabia jego działanie.
Czy badacze mogą ubiegać się o dostęp do wykrywacza watermarku tekstowego OpenAI?
Tak, zatwierdzeni badacze oraz organizacje eksperckie mogą złożyć wniosek przez formularz OpenAI do Content Provenance API. OpenAI udziela dostępu indywidualnie, w ramach unijnego Kodeksu Praktyk. Twierdzi, że będzie wracać do kwestii szerszego dostępu, gdy technologia i dowody będą się rozwijać.
Źródła
- Anthropic, Jak działa watermark tekstowy w Claude, sierpień 2026
- Anthropic Help Center, Jak Claude oznacza treści generowane przez AI, 2026
- OpenAI, Zrozumienie źródła tego, co widzimy i słyszymy w Internecie, maj 2024
- Google DeepMind, SynthID
- Dathathri i in., Skalowalne znakowanie wodne do identyfikowania wyjść dużych modeli językowych, Nature, październik 2024
- Google, Ogłoszenie dotyczące SynthID Detector, maj 2025
- Hugging Face, Introducing SynthID Text, październik 2024
- Kirchenbauer i in., A Watermark for Large Language Models, ICML 2023
- Krishna i in., Parafrazowanie omija detektory tekstu generowanego przez AI, NeurIPS 2023
- Scott Aaronson, Mój wykład o bezpieczeństwie AI dla UT Effective Altruism, listopad 2022
- Unia Europejska, AI Act, Artykuł 50
- C2PA, Koalicja na rzecz pochodzenia i autentyczności treści
Dana jest twórczynią treści w ProofreaderPro, gdzie codziennie prowadzi bloga i zajmuje się pisaniem. Pisze artykuły o tym, jak działa platforma do edycji online i codziennie obsługuje wiadomości od klientów, co potwierdza pięciogwiazdkowa ocena satysfakcji.