
영어로 글을 쓰는 아르헨티나 연구자를 위한 AI 휴머니저
아르헨티나 연구자를 위한 AI 휴머니저입니다. 스페인어 영향이 반영된 영어에서 발생하는 가짜 AI 탐지 경고를 줄이되, 의미와 인용문을 그대로 유지하고 정직하게 공개하세요.

아르헨티나는 매년 Scopus에 등재된 논문을 18,00022,000편 출판하며, 세계 순위는 대략 4045위, 라틴아메리카에서는 브라질과 멕시코에 이어 2위에 해당합니다. 그런데 이 연구의 상당수는 이제 작업 흐름의 어딘가에 AI 어시스턴트가 끼어들며 시작됩니다. 예컨대 ChatGPT로 초안을 잡고, Claude로 문단을 다듬으며, 스페인어에서 온 번역문을 매끈하게 정돈하는 식입니다. 이런 과정은 일반적이고, 대부분의 학술지는 이를 공개한다는 조건 하에 허용합니다.
문제는 그 이후에 시작됩니다. 아르헨티나 연구자를 위한 AI 휴머니저가 필요한 이유는 AI 탐지기가 제2언어에 정교하게 쓴 영어를 기계가 쓴 글로 오독하는 경우가 잦기 때문이며, 아르헨티나의 저자들은 그저 깔끔하고 표준적이며 정확한 산문을 원할 뿐인데도 비용을 지불해야 하기 때문입니다.
아르헨티나는 EF English Proficiency Index에서 562점을 받았는데, 이는 라틴아메리카에서 가장 높은 수치입니다. 하지만 이 높은 숙련도가 여기서는 보호막이 되지 못합니다. 오히려 수년간의 엄격한 정규 학습을 통해 다듬어진, 교과서처럼 매끈하고 문법적으로 정확한 영어가, 탐지기 입장에서는, 가장 먼저 플래그가 찍힐 가능성이 큰 글 유형과 정확히 맞닿아 있습니다.
아르헨티나 연구자를 위한 AI 텍스트 휴머니저
우리의 AI 텍스트 휴머니저는 아르헨티나 연구자가 영어로 더 안전하게 출판할 수 있도록 돕습니다. AI의 도움을 받아 작성한 자신의 초안을 다시 써서, 신중하게 쓴 영어가 자동 생성 텍스트로 오인되지 않도록 하세요. 의미, 기술 용어, 인용문은 그대로 보존합니다.
말 그대로 정리하면: 과학은 사용자가 직접 쓰고, 의미는 유지하며, 텍스트 휴머니저가 리듬과 단어 선택을 달리해 스페인어 영향이 반영된 세심한 영어가 이미 그 자체로 인간의 작업물로 읽히게 합니다. 60개 이상의 언어를 지원하며, 비영어 텍스트는 문장 구조를 보존하는 언어 인식 모델을 통해 처리됩니다.
이 도구는 무언가를 숨기기 위한 것이 아닙니다. 사용자가 보내기 전에 실제 작업물을 공정하게 읽히게 하고, 기관과 저널이 요구하는 방식대로 AI 사용을 정직하게 공개하도록 돕는 것입니다.
스페인어로 먼저 쓰나요? 자동으로 감지되어 바로 휴머니즈됩니다
아르헨티나의 많은 연구자는 영어로 작성하기 전에 스페인어로 초안을 작성한 뒤 정리합니다. 이 휴머니저는 그 과정을 직접적으로 지원합니다. 스페인어 텍스트를 붙여넣으면 ProofreaderPro가 언어를 스스로 인식한 뒤, 스페인어를 고려한 모델을 통해 처리하여 용어, 악센트, 인용문을 사용자가 쓴 그대로 정확히 유지합니다. Through humanizador de texto de IA 당신의 스페인어 초안은 사전에 번역하지 않아도 영어 초안처럼 자연스럽게 휴머니즈됩니다. 동일한 감지 범위는 60개가 넘는 언어에 걸쳐 있으며, 각 언어는 해당 언어의 고유한 목소리로 다시 작성됩니다.
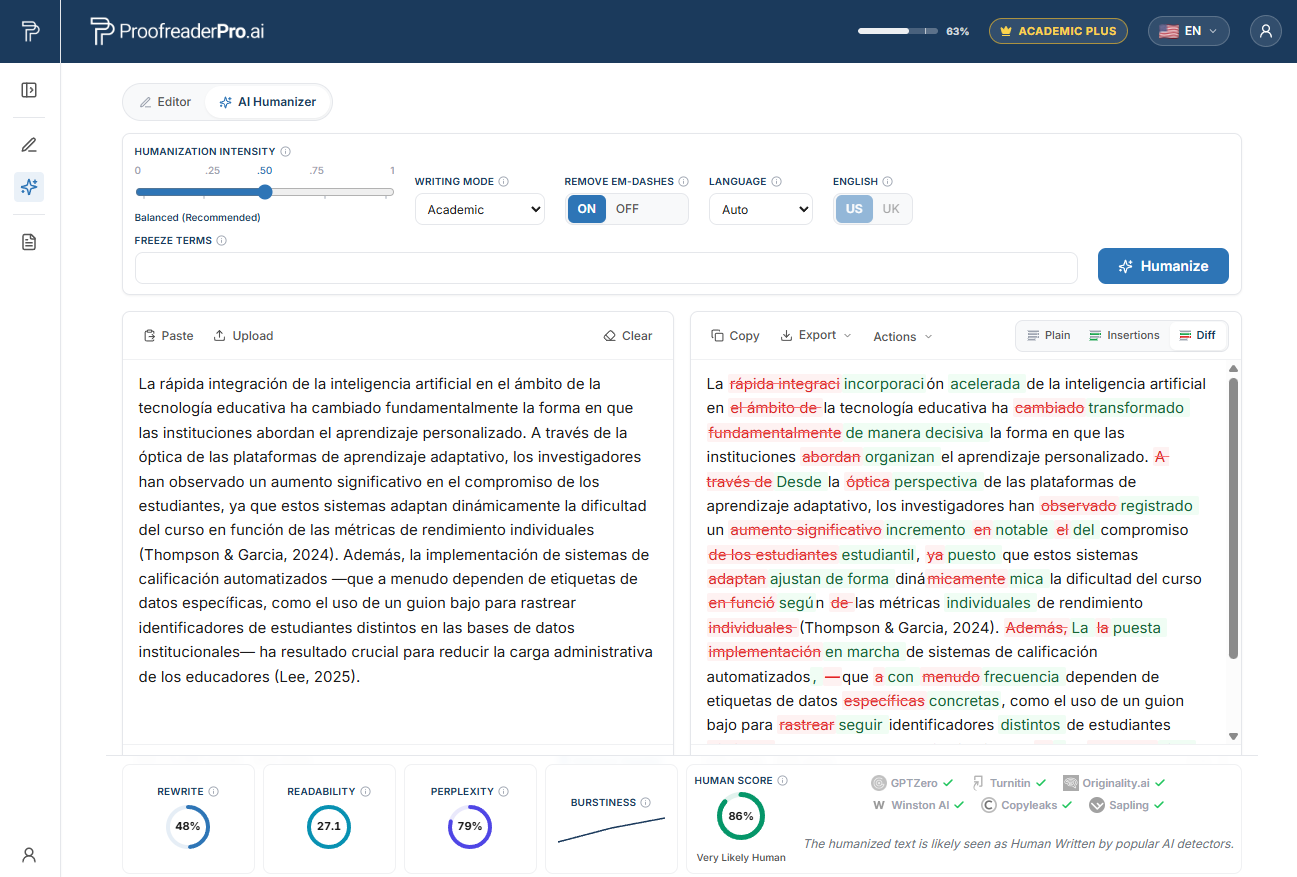
스페인어 학술 텍스트를 재작성하는 ProofreaderPro AI 휴머니저. before/after diff는 의미와 인용문을 유지하고, 탐지기 체크는 자연스럽고 인간이 읽는 톤을 확인합니다.
왜 아르헨티나 연구자는 AI 탐지기에 의해 플래그될 수 있나
2023년, Liang과 동료들이 이끄는 스탠퍼드 팀은 Cell Press 저널 Patterns에 「GPT 탐지기는 비원어민 영어 글쓴이에 대해 편향되어 있다(GPT detectors are biased against non-native English writers)」라는 연구를 발표했습니다. 그들은 널리 사용되는 7개의 AI 탐지기에 사람의 손으로 작성한 TOEFL 에세이를 넣었습니다. 평균적으로 비원어민 에세이의 약 61%가 AI로 플래그된 반면, 원어민 작가의 에세이는 약 5%만 플래그되었습니다. 비원어민 에세이 가운데 거의 5분의 1이 모든 탐지기에 동시에 한 번에 플래그되었습니다. 모든 에세이는 실제로 사람이 작성했습니다.
핵심 메커니즘은 난해성(perplexity)입니다. 많은 탐지기는 언어 모델에 비추어 볼 때 각 단어 선택이 얼마나 ‘놀라운지’ 점수를 매깁니다. 신중한 제2언어 글쓴이는 흔한 단어와 표준적이며 예측 가능한 표현을 선택하는 경향이 있는데, 그러면 난해성이 낮아져 기계가 쓴 텍스트처럼 읽히게 됩니다. 아르헨티나의 학술 산문을 명료하고 안전하게 만드는 바로 그 습관이, 이 도구들이 ‘불신하도록’ 훈련된 습관인 것입니다.
이러한 실패 양상은 왜 AI 탐지기가 비원어민 글쓴이를 플래그하는가에서 자세히 설명합니다. 짧게 요약하면, 탐지기 플래그는 논문 작성 방식에 대한 증거가 아니라 단어 패턴에 관한 통계적 추정일 뿐입니다.
가짜 플래그를 유발하는 스페인어 모국어 패턴
아르헨티나의 숙련도 수준이 높기 때문에, 신호는 대놓고 드러나는 중대한 오류가 아닙니다. 대신, 고급 글쓴이가 정확성을 유지하기 위해 선택하는 신중하고 표준적인 결정들이며, 바로 그 ‘표준성’이 난해성을 낮춥니다. 아래는 아르헨티나식 영어가 기계처럼 보이는 시그니처로 밀어 넣는 패턴들입니다.
가장 안전한 관사 규칙(어디서나 적용). 스페인어는 영어보다 추상명사와 함께 정관사를 훨씬 더 자유롭게 사용합니다(“la investigacion demuestra que la desigualdad afecta la educacion”). 아르헨티나 저자들은 일반 진술에서 그 관사를 제거하는 법을 배우고, 그 수정된 규칙을 동일하게 일관 적용합니다. 그 결과는 거의 변하지 않는, 교과서적으로 예측 가능한 명사구이며, 모델이 정확히 그런 형태를 기대한다는 점이 문제입니다.
전형적인 형용사 어순. 스페인어는 명사 뒤에 형용사를 둡니다. 영어는 그 형용사를 명사 앞에 쌓아 올립니다. 영어 관례를 반복 훈련해 온 글쓴이는 “un analisis estadistico multivariado robusto”를 “a robust multivariate statistical analysis”로 옮기고, 매번 같은 순서를 따르게 됩니다. 이러한 ‘경직된 정확성’은 설계상 낮은 놀람 수준(low-surprise)을 만들어냅니다.
모든 거짓 친구(false friend)에 대한 가장 안전한 동의어. falsos amigos(“actual,” “realizar,” “eventualmente,” “sensible,” “pretender”)를 피하기 위해, 세심한 저자들은 가장 흔하고 모호하지 않은 영어 단어를 선택합니다. 높은 확률의 동의어를 반복해서 고르면, 탐지기가 인간의 어휘 다양성으로 읽을 수 있는 폭이 평탄해집니다.
사전상 정확한 전치사를 매번 하나로 고정. 스페인어 전이가 “consist in,” “depend of,” “interested on,” “different to”를 만들어낸다는 점을 학습한 뒤, 글쓴이는 “consist of,” “depend on,” “interested in,” “different from”에 고정합니다. 언제나 하나의 표준적인 결합(collocation)만 사용하고, ‘놀라운’ 선택은 하지 않습니다.
기계적 시제 선택. 리오플라텐세 스페인어는 단순 과거에 기댈 때가 많아서, 아르헨티나 글쓴이들은 방법(methods)과 결과(results) 섹션에서 영어의 현재완료 및 단순과거 규칙을 의도적으로 적용합니다. 의도적인, 규칙에 묶인 시제 사용은 일관적이고 예측 가능하기 때문에 난해성이 낮게 읽히는 경향이 있습니다.
최대 수준의 격식. 아르헨티나 학술 문체는 격식을 향해 기울기 쉬우므로, 저자들은 가장 표준적이고 가장 보수적인 표현을 선택합니다. 가장 안전한 문장은 곧 가장 ‘예상되는’ 문장이기도 하고, 탐지기는 바로 그 예상 가능한 산문을 기계 생성으로 점수화합니다.
아르헨티나의 AI 탐지와 Turnitin 맥락
아르헨티나에서 학위논문, 진로(커리어) 보고서, 학술지 투고 원고는 유사성 및 AI 지표를 목적으로 Turnitin 또는 iThenticate로 흔히 사전 검토됩니다. CONICET 평가 위원회, 대학의 테뉴어(종신) 심사 절차, 그리고 국제 저널 모두가 그 파이프라인 어딘가에 존재하므로, 대학원생과 선임 연구자가 동일한 탐지기를 만날 수도 있습니다.
업체들이 자기 도구를 어떻게 설명하는지도 아는 것이 도움이 됩니다. Turnitin은 1~19% 범위의 AI 점수를 억제하여 숫자 대신 별표(asterisk)를 표시하고, 그 점수는 단독으로 무결성(integrity) 판단에 사용해서는 안 된다고 경고합니다. 여러 대학은 한층 더 나아가기도 했습니다. 예를 들어 Vanderbilt는 2023년 오탐(false positives)과 비원어민 글쓴이에 대한 편향 문제를 이유로 Turnitin의 AI 탐지기를 비활성화했으며, Michigan State, UT Austin, Northwestern, Pittsburgh, SMU, Waterloo도 유사한 조치를 취했습니다.
이 역사에 대한 공정한 해석은 ‘탐지기가 무의미하다’가 아니라, 점수는 판결(verdict)이 아니라 다투어 볼 수 있는 주장(claim)이라는 점입니다. 동시에 지원기관과 저널은 점점 더 AI 보조를 공개하도록 요구합니다. 이 두 사실이 같은 방향을 가리킨다는 점이 중요합니다. 즉, 세심한 글쓰기는 오독되지 않도록 보호하고, 사용한 도구에 대해 투명해야 합니다.
영어를 공정하게 읽어보세요
본인의 AI 보조 원고를 사람답게 다듬어, 스페인어의 영향을 받은 세심한 글이 기계가 쓴 글로 오해받지 않도록 하세요. 의미, 용어, 인용문은 보존됩니다. 그런 다음 자신 있게 공개하세요.
Humanizer를 무료로 사용해 보세요상위 아르헨티나 대학과 AI 점검이 나타나는 지점
아르헨티나의 공립대 시스템은 학부 수준에서 규모가 크고 무료이며, 연구는 국립대와 CONICET 연구소에 집중되는 경우가 많고, 여러 연구소가 캠퍼스 내에 함께 자리 잡기도 합니다. 이들은 국가를 대표하는 주요 연구 생산 주체들이고, 각 기관은 학위논문과 원고를 유사성과 AI 지표 관점에서 스크리닝합니다.
- Universidad de Buenos Aires (UBA), 부에노스아이레스: 전국 산출의 약 40% 수준으로 압도적으로 가장 큰 생산자.
- Universidad Nacional de Cordoba (UNC), 코르도바: 1613년에 설립되어 아메리카 대륙에서 가장 오래된 대학 중 하나이며, 천문학·물리학·화학 분야가 강함.
- Universidad Nacional de La Plata (UNLP), 라플라타: 정확 및 자연과학 분야의 주요 거점으로, 여러 CONICET 연구 단위가 있음.
- Universidad Nacional de Rosario (UNR), 로사리오: 의학·생화학·농업과학에서 두드러짐.
- Universidad Nacional del Litoral (UNL), 산타페: 화학공학·식품기술·생명공학 분야가 강함.
- Universidad Nacional de Cuyo (UNCuyo), 멘도사: 서부 아르헨티나의 주요 연구 중심 대학.
- Universidad Tecnologica Nacional (UTN), 다캠퍼스: 등록 인원 기준으로 전국 최대 규모이며 공학과 기술에 집중.
- Universidad Austral, 부에노스아이레스 권역: 의학과 생의공학 분야에서 강점이 있는 유수의 사립대.
- Universidad Nacional del Sur (UNS), 바히아 블랑카: 화학·화학공학·지구과학이 강함.
- Universidad Nacional de San Martin (UNSAM), 부에노스아이레스 주: 생명공학과 나노기술 분야에서 빠르게 성장 중.
- Instituto Balseiro, 바릴로체: 아르헨티나의 엘리트 물리학 및 핵공학 연구소로, 규모는 작지만 생산성이 매우 높음.
- Instituto Tecnologico de Buenos Aires (ITBA), 부에노스아이레스: 컴퓨터 및 데이터 과학에서 강점을 가진 사립 공학 기관.
이들 모든 기관에서 CONICET의 커리어 진전과 ANPCyT의 연구비(보조금) 경쟁은 영어권 출판을 사실상 전문적 필수로 만들며, 그 결과 매년 더 많은 원고가 더 많은 탐지기를 통과하게 됩니다.
아르헨티나 연구자를 위한 AI 휴머니저는 어떻게 작동하나
아르헨티나 연구자를 위한 AI 휴머니저는 하나의 ‘지름길’이 아니라 워크플로의 마지막 단계입니다. 우리가 권장하는 순서는 다음과 같습니다.
먼저 초안 작성입니다. 많은 아르헨티나 연구자는 스페인어로 생각하는 편이 더 자연스럽기 때문에, 논증을 스페인어로 개요화한 뒤 영어로 번역합니다(우리의 AI 번역기는 인용문을 그대로 유지합니다). 둘째, 문법을 교정합니다. 앞서 언급한 글 구조, 전치사, 거짓 친구 패턴이 실제로 정확한지 확인해야 합니다. 셋째, AI 도움을 받은 문장을 자신의 작업 흐름에서 텍스트 휴머니저를 통해 다시 실행합니다. 그러면 난해성이 낮은, 세심한 글쓰기가 기계 출력으로 오독될 가능성이 줄어듭니다.
휴머니저는 의미, 기술 용어, 인용문을 보존합니다. 리듬과 단어 선택을 다양화하고 반복적인 리듬을 끊어 주며, AI 초안이 흔히 남기는 ‘뜬 em 대시’도 제거합니다.
테스트에서 우리는 ‘약속’보다 ‘구체성’을 보여드립니다. 주요 탐지기들과 대조해 보면, 우리의 휴머니저는 AI 텍스트를 더 자연스러운 인간 형태로 다시 작성하여 AI 신호를 낮추고, 까다로운 탐지기에 대한 대응 가능성을 높이면서도 학술 텍스트에서 문법 정확성을 높은 수준으로 유지합니다. 이는 보장이 아니라 테스트 결과이며, 탐지기는 몇 달마다 다시 학습되므로, 어떤 도구도 ‘전혀 탐지되지 않음’을 약속할 수는 없습니다.
이후 공개합니다. 기관과 목표 저널이 요구하는 형식에 맞춰 AI 사용을 명시하세요. 이 조합, 가짜 플래그로부터 보호된 세심한 글쓰기와 완전한 공개, 가 여러분을 무결성 규정 안에 머물게 합니다. 사람 중심 교정과의 비교가 필요하다면 아르헨티나 연구자를 위한 학술 편집을 참고하시고, 국가 단위의 전체 클러스터는 다국어 AI 휴머니저 허브를 방문해 보세요.
로컬 지원기관, 저널, 그리고 AI 공개에 대한 기대
아르헨티나 연구자들이 애초에 탐지기로 향하게 만드는 출판 압박은 두 기관이 결정합니다. **CONICET (Consejo Nacional de Investigaciones Cientificas y Tecnicas)**은 5단계 커리어 시스템에서 11,000명 이상의 연구자를 고용하고 있으며, 진급은 Scopus와 Web of Science에 등재된 저널에 지속적으로 출판하는 데 달려 있습니다. **ANPCyT (Agencia Nacional de Promocion de la Investigacion, el Desarrollo Tecnologico y la Innovacion)**는 경쟁형 연구비를 관리하며, 특히 PICT (Proyectos de Investigacion Cientifica y Tecnologica) 프로그램이 모든 평가에서 국제 출판의 비중을 크게 반영합니다.
아르헨티나는 또한 강한 저널 전통을 갖고 있는데, 그중 상당수는 SciELO Argentina에 등재되어 있고, 점점 더 Scopus와 Web of Science에도 등재되고 있습니다. 아르헨티나 저자들이 잘 아는 대표 타이틀은 다음과 같습니다.
- Medicina (Buenos Aires), 라틴아메리카에서 가장 존경받는 의학 저널 중 하나로, PubMed와 Scopus에 등재되어 있습니다.
- Ecologia Austral, 아르헨티나 생태학 협회(Argentine Ecological Association)에서 발행.
- Latin American Applied Research, Universidad Nacional del Sur와 CONICET이 발행.
- Revista de la Union Matematica Argentina, 이 지역에서 가장 오래된 수학 저널 중 하나.
- Ameghiniana, 고생물학 및 지구과학 분야.
- Electronic Journal of Biotechnology, 라틴아메리카 중심의 범위를 가진 저널.
이들 저널이 Scopus 등재를 원하거나 유지하는 과정에서, 점점 더 영어를 선호하게 되고, 국제 저널들과 마찬가지로 AI 보조에 대한 성명서를 요구하는 경우도 늘고 있습니다. 공개 문구는 간단히 쓰고, 도구 이름을 명시하며, 수행한 작업을 설명하세요. 세심한 노력에도 불구하고 탐지기가 진짜 원고에 플래그를 찍는다면, 가짜 AI 탐지 플래그에 대한 이의 제기 플레이북이 증거를 수집하는 절차와 위원회에 전달할 톤까지 안내합니다.
자주 묻는 질문
Q: 아르헨티나 연구자를 위한 AI 휴머니저는 Turnitin을 부정행위로 도와주나요?
아닙니다. 이 도구는 본인의 AI 도움 초안을 위한 것이며, 역할은 신중한 제2언어 영어가 기계 텍스트로 오독되지 않도록 하는 것입니다. 여러분은 의미와 인용문을 계속 유지해야 하고, AI 사용 역시 기관과 저널에 계속 공개해야 합니다. ‘가짜 플래그로부터 실제 작업물을 보호하는 것’은 ‘그것을 위장하는 것’과는 다릅니다.
Q: 휴머니즈하면 제 의미, 기술 용어, 인용문이 바뀌나요?
아닙니다. 휴머니저는 의미, 기술 용어, 참고문헌을 보존하면서 리듬과 단어 선택을 다양화합니다. 이 도구는 탐지기를 걸리게 만드는 통계적 패턴을 매끄럽게 다듬는 데 설계되었지, 과학 내용을 새로 쓰거나 인용문을 이동시키기 위해 존재하는 것은 아닙니다.
Q: 실제로 AI 탐지기를 얼마나 잘 통과하나요?
주요 탐지기들과 대조해 테스트한 결과, AI 텍스트를 더 자연스러운 인간 형태로 다시 작성하여 AI 신호를 낮추고, 어려운 탐지기에 대한 대응 가능성을 향상시켰습니다. 동시에 문법 정확성도 높은 수준으로 유지됩니다. 이는 테스트 결과이지 보장이 아닙니다. 탐지기는 자주 재학습되므로, 어떤 신뢰할 만한 도구도 ‘절대 플래그되지 않는다’를 약속할 수는 없습니다.
Q: 제 영어는 이미 충분히 강한데 왜 탐지기가 플래그하나요?
강하고 표준적인 영어가 오히려 문제의 일부가 될 수 있습니다. 탐지기는 난해성을 점수화하며, 세심하고 예측 가능한 교과서식 표현은 난해성이 낮게 나타나 탐지기가 이를 기계 글쓰기에 연관 지을 가능성이 큽니다. 아르헨티나의 높은 숙련도는 글을 더 균일하게 만들 수 있고, 그 결과 플래그될 가능성을 반드시 낮추지는 못할 수도 있습니다.
Q: 초안을 휴머니즈하면 AI 사용을 여전히 공개해야 하나요?
네, 항상 해야 합니다. 공개와 휴머니즈는 서로 다른 두 가지 문제를 해결합니다. 휴머니즈는 세심한 글쓰기가 오독되는 것을 막아 주고, 공개는 지원기관, 위원회, 저널에 대해 책임을 지게 해 줍니다. 둘 다, 매번 하세요.
영어로 출판하시는 아르헨티나 연구자분들을 위해: 본인의 AI 보조 작업에서 의미, 용어, 인용문을 그대로 유지하면서 잘못된 AI 플래그를 줄이세요. 그런 다음 자신 있게 공개하십시오.

Moe는 자연어 처리 분야에 PhD를 갖춘 NLP 엔지니어입니다. 그의 연구는 컴퓨터 언어학, 텍스트 분석 및 기계 학습을 다루며 ProofreaderPro의 편집 및 인간화 모델에 직접 적용됩니다. 그는 대부분의 사람들이 전혀 보지 못하는 프로세스의 일부, 즉 언어 모델이 문장을 읽고 점수를 매기고 무엇을 변경할지 결정하는 방법에 대해 글을 씁니다.


